同一问题在不同 AI 模型里给出相反品牌建议时,团队应该怎样解释和行动
同一个问题,一个 AI 模型提到品牌,另一个却没提。智能手表案例显示,看似冲突的回答可能讨论不同问题;团队应先扩大可比样本,再决定是否优化。
永久免费查询
覆盖 12,000+ 细分市场,无需登录即可查询
更新人
AI 辅助研究支持
13 分钟阅读
更新于 Sep 29, 2026
TL;DR
- 同一问题看似在不同 AI 模型里得到相反品牌建议时,团队应先核对两边是否真的回答了同一个问题,再决定是否行动。没有采到回答、采到了却没提品牌、只采到少量回答,是三种不同情况。只有在同一问题、地区和观察范围内反复出现缺席,且买家确实使用该模型,才值得进一步查来源并考虑优化。
- Dageno 的一个智能手表案例显示,系统标出的模型覆盖缺口值得核查,却尚未构成跨模型冲突。澳大利亚的儿童安全手表回答在 Google AI Overview 上没有提到 Apple;同地区 ChatGPT 和 Gemini 提到 Apple 的回答,从内容看讨论的是通用智能手表。当前决定是先固定问题、扩大可比样本。
- 监测时,把缺席线索所在模型列为核心,把已有同地区回答的模型列为对照;暂未采到回答的模型列为观察。品牌方还需先判断儿童安全手表是否属于自己的目标需求。
1. 先分清三种“缺席”:没采到回答、回答里没提、样本太少
没采到回答:先确认这格里有没有记录
以后台的智能手表市场为例,在这次逐条记录的回答里,澳大利亚的同一子意图下没有出现 Google AI Mode 和 Copilot 的回答。研究负责人应将这两格记为“暂无回答”,而不是“Apple 在这两个模型里缺席”。这一步影响后面的监测分组:有回答的模型才能讨论回答是否提到品牌;没有回答的模型先留在观察清单,等待出现可核查的记录。
从问题与机会(Issues & opportunities)进入机会概览(Opportunity overview),打开模型覆盖缺口(LLM coverage gap)卡片,点查看分析(View analysis),再点查看相关 AI 回答(View related AI responses)。按钮上显示 203,是这个子意图的回答总数;打开后的列表只有 9 条,正是 Google AI Overview 上没有提到 Apple 的回答。要看这个子意图下全部模型和地区的回答,需沿需求与市场洞察(Demand & insights)→搜索意图(Search intents)→选型推荐(Recommendations)→See top recommendations→查看 AI 回答(View AI responses)进入,共 203 条;核查澳大利亚时,要读每条回答顶部的平台和地区标签。
采到了回答:把品牌提及与推荐分开记
系统卡片显示,在 Google AI Overview 上,Apple 的模型可见度(Model visibility)为 35.71%,模型中位数(Model median)为 72.00%,可见度差距(Visibility gap)为 36.29%,标为中优先级(Medium priority)。它提示研究负责人打开证据,却没有说明哪些问题造成了差距,也没有替团队确定该改哪一个页面。
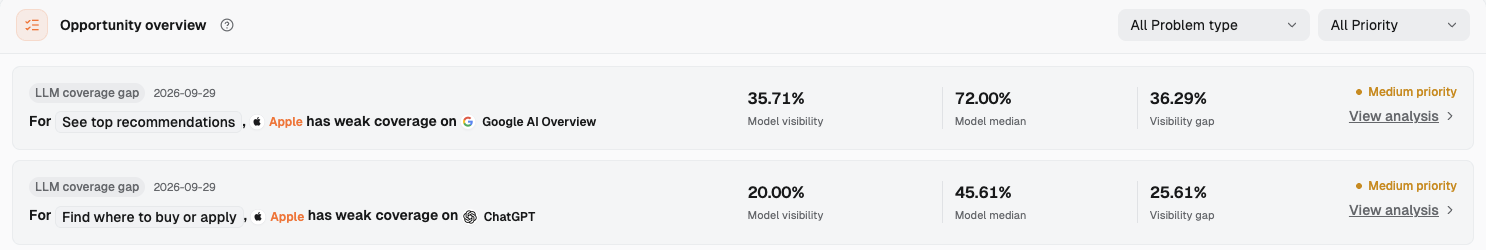
机会概览(Opportunity overview)中的模型覆盖缺口卡片:对于 See top recommendations,Apple 在 Google AI Overview 上的 Model visibility 为 35.71%,Model median 为 72.00%,Visibility gap 为 36.29%,标为 Medium priority。第二张卡片是同类缺口在 ChatGPT 上的记录。
在这个子意图的 203 条回答里逐条记录后,Google AI Overview 共 14 条,其中 5 条提到 Apple;卡片打开的相关回答列表正好列出没有提到 Apple 的 9 条,需要继续按需求和地区拆开。品牌没有出现在某条回答里,是对那条回答的描述;品牌没有进入某个问题的推荐,还需要知道那条回答是否真在回答该品牌可能参与的选型问题。被引用的品牌页面又是另一项记录,不能替代回答正文中的推荐。
在证据预览(Evidence preview)中,先看原始回答(Source answer),再看相关引用分析(Related citation analysis)。记录回答顶部的平台和地区、正文中的品牌名称,以及它是被推荐、顺带提到,还是只出现在引用页面。这样,后面的“缺席”才有清楚的统计对象。
回答太少:保留线索,继续取可比样本
澳大利亚的儿童安全手表问题,在 Google AI Overview 上有 4 条回答,均未提到 Apple。这是具体的缺席线索,但同地区其他模型尚无对应儿童手表回答,团队暂时缺少两边可比的样本。即使某个模型已经有多条回答,只要问法混在一起,也无法用总条数替代同一个问题下的条数。
市场研究负责人可以先约定下一轮要收集哪些问题、每个模型各保留多少条完整回答,以及何时复核。现有证据没有给出统一的“采够几条就行动”的门槛。判断样本是否可用,先看两边是不是同一问题、同一地区,再看新回答中的缺席是否继续出现。
2. 确认冲突不是偶发:同一需求、同一地区,每个模型看多少条回答
先定比较单位,再数每个模型的回答
市场页面把回答归在子意图里,方便发现某类需求的异常。比较品牌建议时,还要进一步固定地区、语言和问题本身。例如“给手机用户选智能手表”与“给儿童选带定位功能的安全手表”都可能落在选型推荐里,买家要求却不同。把两种回答合起来计算,会让研究负责人把问题差异误读成模型差异。
操作上,给每条完整回答记下平台、地区、回答所讨论的问题、是否提到品牌、是否明确推荐品牌。两边分别报出回答条数,而不是把列表总数当成任一模型的分母。列表没有平台筛选器,按模型计数需要人工逐条查看顶部标签并记录。同一条回答再次打开也只记一次。
单次回答会变化,SparkToro 与 Gumshoe 合作的 AI 推荐一致性研究记录过同一问题多次回答的名单差异;不同 AI 平台推荐名单的核查方法已经说明为什么要看重复回答。这里要解决的是更前一步:目前拿来比较的回答,究竟是不是在回答同一需求。
贯穿案例:系统标出的模型缺口,拆开后是什么
模型覆盖缺口卡片把 Google AI Overview 标为中优先级,显示 Apple 的 35.71% 低于模型中位数 72.00%,差距 36.29%。顺着查看分析打开抽屉,问题发生位置(Where the problem occurs)下可见用户行为(What the user is doing)、子意图(Sub-intents)和观测结果(Observed result);再打开相关回答。卡片提供了“从哪里开始查”的线索,逐条回答决定这个线索能否转成行动。
在 Google AI Overview 的 14 条回答里,5 条提到 Apple。其余 9 条按回答内容分开,得到四类:3 条在比利时或荷兰讨论 Garmin 手表,1 条在波兰讨论 Garett 手表,1 条在西班牙语境解释运动手表是什么,4 条在澳大利亚讨论儿童安全定位手表。前面关于特定品牌和定义的回答,不是面向同一开放式选型需求的 Apple 缺席案例;值得继续核对的是澳大利亚那组儿童手表回答。
其中一条回答开头是:“The top 5 highly-rated child safety smartwatches with GPS tracking are Spacetalk Adventurer 2, TickTalk 5, Gabb Watch 3e, Xplora X6 Play, and Garmin Bounce.”(中文意思:评价较高的五款带 GPS 定位的儿童安全手表依次列出了这些产品。)另一条写道:“Top kids smartwatches feature real-time GPS tracking combined with 4G LTE calling, geofencing "safe zones," and SOS buttons.”(中文意思:热门儿童手表常见的功能包括实时 GPS 定位、4G LTE 通话、地理围栏“安全区”和 SOS 按钮。)这些原句说明回答在处理什么需求;文中列出的品牌只是回答原文的一部分。
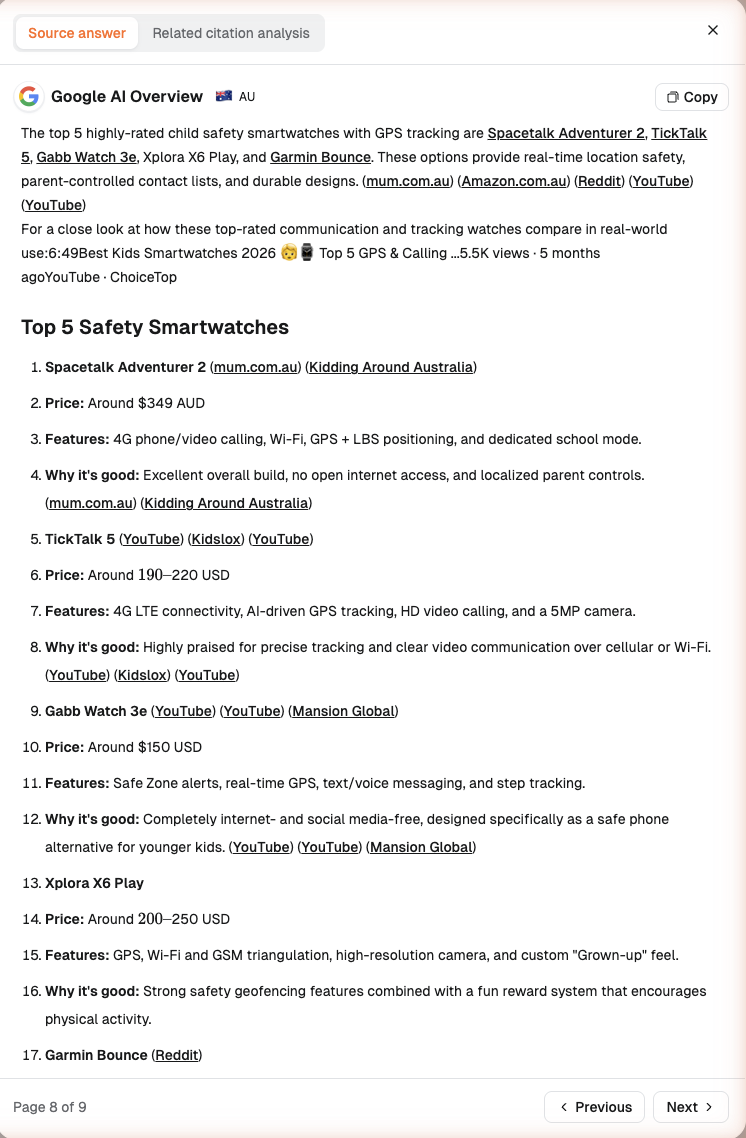
从这张卡片打开的相关回答共 9 条,这是第 8 条:Google AI Overview、澳大利亚(AU),回答列出的是儿童安全定位手表,没有提到 Apple。
同在澳大利亚,同一子意图下 ChatGPT 的 5 条回答和 Gemini 的 3 条回答都提到 Apple。不过从回答内容看,这 8 条都不是在回答儿童安全手表问题;读到的几条讨论的是通用智能手表或运动手表。ChatGPT 的一条回答写道:“If you're shopping for a smartwatch right now in 2026, these are the standouts. The biggest factor is your phone: Apple Watches are for iPhone …”(中文意思:如果现在选购智能手表,手机型号是重要因素,Apple Watch 面向 iPhone 用户。)它讨论手机兼容性,并非儿童安全定位。这里呈现的是同一子意图内的不同问题;现有回答还没有提供“别的模型回答了同一儿童手表问题并推荐 Apple”的对照。
因此,这张卡片的读法是:先从覆盖差距找到值得看的回答,再把不相干的问题拆开,最后决定补哪一种样本。当前要补的是澳大利亚、同一个儿童安全手表问题、不同模型的回答,而不是立刻制定页面优化任务。
3. 固定 Prompt、模型、地区、运行时间:后台能回答什么,哪些要客户补
Prompt:子意图只圈定问题类型
查看相关 AI 回答和查看 AI 回答的列表都没有平台筛选器;证据预览也不显示提问原文。研究负责人能从回答内容判断它大致在答什么,却无法从这批记录还原每条提问的逐字文本。卡片上的 See top recommendations 是子意图,里面同时容纳通用选购、指定品牌和儿童安全手表等回答。要检验真正的跨模型差异,客户应在 Monitored prompts 中放入自己要监测的同一句问题,再让选定模型回答。
监测设置(Monitoring settings)中的 Monitored prompts 列表展示 #、Prompt、Platforms、Regions、Answers、Brands、Details、Leading、Status。本案例的回答来自市场数据,不是客户按同一句问题监测得到的记录,所以无法逐字核对问题。下次建立监测时,先保存问题原文,并核对实际返回的回答;不要把现有市场回答说成已经按同一句问题运行过。
模型与地区:逐条核对回答顶部标签
回答顶部标注平台和地区,例如 Google AI Overview 与 AU。团队要用这些标签归类回答,再检查每个模型是否确实在选定地区产生记录。市场概览(Market overview)中的平台与地区(Platforms & regions)可帮助定位范围;最终用于判断的仍是该范围内的完整回答。地区相同还要看语言和问题内容,不能因为标签同为 AU,就把所有智能手表回答放在同一组。
澳大利亚的已有记录支持先把 Google AI Overview、ChatGPT 和 Gemini 放进同一地区的核查清单。同一句儿童手表问题的跨模型统计,要从下一轮新回答开始。Google AI Mode 和 Copilot 在这次记录中没有出现该范围的回答,先记录为待观察。哪些模型是买家常用工具、澳大利亚是否是重点市场,须由市场研究负责人依据客户资料确认。
运行时间:建立新记录,别把取证日当采集日
证据预览不显示采集时间,回答列表也不显示提问原文和采集时间。研究人员在某天打开卡片,得到的是核查日期;它不能用来替代回答运行的日期。当前也没有依据给这些旧回答标出统一的采集窗口。下一轮复测要从可保存的新回答开始,按轮次记录问题、模型、地区、语言和团队实际取得回答的时间信息;无法取得系统采集时间时,明确记录“未显示”。
品牌方还需确认另一个前提:儿童安全手表是否属于该品牌产品面向的人群和用途。后台能展示回答和来源,却不能替品牌方决定要不要争取这个问题。若产品适用对象不匹配,团队就不应仅凭覆盖差距把这个问题列为优化目标。
4. 缺席的那个模型用了什么来源:只看能解释差异的证据
先看回答实际引用了什么
澳大利亚那 4 条 Google AI Overview 儿童安全手表回答,各自显示 23、24、25、19 个引用来源。从每条回答的引用列表看,常见域名包括 safewise.com、harveynorman.com.au、reddit.com、youtube.com、forbes.com、kidslox.com、mum.com.au 和 garmin.com;这 4 条的可见引用中没有 apple.com。这些是回答与来源的观察记录,还没有构成“缺少某个网站,所以品牌没有进入回答”的解释。Google 在 AI 功能与网站的官方说明中介绍,AI Overview 会显示相关链接,供用户继续了解;这些可见链接可作为核对回答来源的起点。
这里尤其要区分两处界面。证据预览里的相关引用分析能看到单条回答的引用;卡片抽屉中的回答使用的来源(Sources used by the answers)在本例显示暂无数据(No data)。研究负责人做来源对照时,应依据已经逐条打开的回答,保留其引用网址和对应原文;抽屉显示暂无数据,就如实写暂无数据。
同一个模型在荷兰也有一条儿童手表相关回答,提到 Apple Watch SE:“Voor oudere jeugd (Middelbare school): Een instapmodel zoals de Apple Watch SE of reguliere Samsung Galaxy Watch.”(中文意思:面向年龄较大的中学生,可考虑 Apple Watch SE 这类入门款,或常规的 Samsung Galaxy Watch。)这条记录让团队看到:即使固定模型,地区和回答所服务的人群也会改变具体选项。荷兰记录用于同模型跨地区对照;澳大利亚的跨模型比较将在同一句问题的新回答中完成。
若下一轮不同模型都回答同一句澳大利亚儿童手表问题,再把每条回答提到的产品与引用页面并排核对:哪个页面列出了相关产品,哪个页面提供了选择条件,回答用了其中哪些信息。对照回答与被引页面的完整方法已有专文说明;本节只保留这次缺席线索能直接支持的来源记录。
5. 决定:当作优化信号,还是扩大样本再行动
这次案例的决定是先扩大样本。理由并非模型覆盖卡片不重要,而是澳大利亚的儿童安全手表回答缺少同一问题、其他模型的对应回答。覆盖差距提醒团队从哪里查;内容判断决定这些回答是否可以互相比;品牌方的产品适用对象决定要不要继续监测这个问题。
| 看到的情况 | 当前结论 | 下一步动作 | 还不能下的结论 |
|---|---|---|---|
| 模型覆盖缺口卡片显示 35.71%、72.00% 和 36.29% | 值得打开回答核查 | 顺着相关回答逐条看问题、模型和地区 | 已经出现值得修改的内容缺口 |
| 未提 Apple 的回答里,有特定品牌问题和定义问题 | 这些回答不构成开放式选型对照 | 从跨模型比较中剔除,保留原始记录 | 这些回答证明 Apple 在通用推荐中缺席 |
| 澳大利亚儿童安全手表的 4 条回答均未提 Apple | 有具体需求下的缺席线索 | 品牌方先确认产品适用对象,再固定问题补其他模型回答 | 已证实不同模型对同一个问题给出相反品牌建议 |
| 同地区 ChatGPT、Gemini 已有提到 Apple 的回答,但讨论通用智能手表 | 两边问题不同;本次先扩大可比样本 | 让它们与 Google AI Overview 回答同一句儿童手表问题 | ChatGPT、Gemini 在儿童手表问题上会推荐 Apple |
| 同地区这次记录中未出现 Google AI Mode、Copilot 的回答 | 目前没有这两个模型的品牌判断依据 | 放入观察清单,有新回答后再分类 | Apple 在这两个模型里缺席 |
等同一句问题在选定模型中产生足够多的可比回答,再检查缺席是否在后续窗口持续出现。如果买家确实使用缺席侧模型,品牌方确认该问题适合自己的产品,且回答与引用能指向具体的信息差异,团队才有理由讨论页面事实补充或第三方材料。页面要改什么,应从可核对的需求信息和来源证据出发;这次记录尚未提供这样的行动对象。
读到这里也要把相邻情形分开。若所有有回答的模型都没提品牌,参照品牌在 AI 回答中整体缺席的诊断;若品牌已经进入推荐、却排在竞品之后,参照品牌在 AI 推荐中落后于竞品的诊断。提及、推荐和引用的统计对象,可用AI 搜索可见性的衡量口径核对。
6. 选择监测模型与复测范围
核心、对照、观察,各自承担什么任务
模型分组服务于下一轮决定。核心模型承接已发现的具体缺席线索,对照模型负责回答同一句问题,使团队获得真正的横向比较;观察模型当前没有可用回答,出现记录后再决定用途。以下是针对本案例的监测方法建议,模型名称和现有证据来自后台;买家使用习惯、观察期和负责人仍由客户确认。
| 组别 | 模型 | 现有依据 | 下一轮固定范围与要看的结果 |
|---|---|---|---|
| 核心 | Google AI Overview | 澳大利亚儿童安全手表回答均未提 Apple | 在 AU 固定一条儿童安全定位手表问题,保存完整回答、品牌提及与明确推荐、引用来源 |
| 对照 | ChatGPT、Gemini | 同地区通用智能手表回答提到 Apple;儿童手表问题尚无对应回答 | 使用与核心逐字相同的问题及地区,核对回答实际讨论的用途,再记录品牌提及、推荐与来源 |
| 观察 | Google AI Mode、Copilot | 这次记录中未出现澳大利亚该子意图的回答 | 出现同范围回答后逐条记录,再判断是否加入核心或对照 |
如果你是这个品牌,先请产品与市场负责人确认儿童安全定位手表是否符合产品适用对象,以及买家实际会用哪些模型。确认后,市场研究负责人保存同一句提问、地区和语言,约定观察期、复测频率、负责人与停止条件。本文没有替客户填写日期或次数;这些条件应在新回答出现前定下,避免看到结果后再改比较规则。
每轮保存完整回答与对应引用,同时记录问题文本、模型、地区、语言、品牌是否被提到、是否得到明确推荐,以及能核实的时间信息。对照组既用来查看是否出现可比推荐,也用来发现原有通用选购场景中的推荐是否倒退。页面如有实际改动,另记改动内容和日期;下一轮只用新取得的回答作复测,别把旧记录反复打开算作新结果。验证 AI 推荐是否改善的复测方法可用于安排后续窗口与记录方式。
7. 结论
市场研究负责人现在可以给团队一个明确答复:系统发现了值得核查的模型覆盖差距;拆开回答后,澳大利亚有一个儿童安全手表需求的缺席线索,现有跨模型记录还回答了不同的问题。本轮先由品牌方确认需求是否适合自己的产品,再让核心和对照模型回答同一句问题,保存新回答和引用。等买家使用范围、重复观察和来源证据齐备,再决定是否投入内容优化。
8. FAQ
两边的回答条数不同,还能放在一起看吗?
可以分别展示,但要先让两边回答同一问题。条数不同就把各自的回答数写清楚;数量较少的一边优先补样本。把不同问题合在一起,即使两边条数接近,也无法回答模型差异这个问题。
品牌被提到,却没进入推荐名单,怎样记录?
记为“提及”,同时保存上下文;只有回答明确把品牌作为适合该需求的选项,才记为“推荐”。引用品牌页面也单独记录。三者分别写清楚,后面才能判断变化发生在回答正文还是来源层面。
新一轮仍然没有提到品牌,要立即修改页面吗?
先核对新回答是否沿用相同问题、地区和语言,再看买家是否使用该模型、品牌是否适合这个问题,以及新回答引用了什么。若这些条件已明确,团队才能选出具体的页面信息或第三方材料作为行动对象;随后继续在同一范围内复测。
品牌想增加一个地区,该如何保留原来的比较?
新地区单独建立记录,原地区按既定问题继续观察。每轮都写清地区和语言;团队比较同一地区的前后变化,也能单独查看不同地区的回答差异。
不知道买家主要用哪个模型,监测名单怎么定?
先保留这次已有证据对应的核查清单,由市场研究负责人用客户研究或访谈确认买家使用的模型。得到依据后,再决定哪些模型维持核心监测、哪些只作对照或观察。后台里的回答数量不能代替买家的使用情况。
9. References
About the Author

更新人
Dageno
Dageno is the research and insights team at Dageno AI, publishing industry reports and expert analysis on AI Search Visibility, Generative Engine Optimization (GEO), and AI-powered search discovery.

