多产品品牌怎样拆分 AI 可见性基线:什么时候按品牌看,什么时候必须按产品或场景看
品牌整体的 AI 可见度是按题数加权的平均。题少的产品掉了看不出来,问题集换了一批题,整体还会自己涨跌。在三市场历史样本里,Samsung 三类合算的可见度涨了 1.9 个点,手机却掉了 6.4 个点,笔记本一直只有 3% 到 5%。本文给出拆分整体变化的算法、确认缺席的三项检查、按品牌、产品、场景看的判断条件,以及改完页面后的复核方法。
永久免费查询
覆盖 12,000+ 细分市场
更新人
AI 辅助研究支持
12 分钟阅读
更新于 Oct 19, 2026
TL;DR
品牌整体的 AI 可见度涨了,不代表每个产品都在涨。品牌整体的 AI 可见度,是把所有产品问题的回答合在一起算出来的。哪个产品的问题多,它在整体里的分量就大;问题少的产品即使可见度在掉,甚至几乎没被 AI 提到,整体也看不出来。各产品的题数或每道题的采样次数一变,整体还会自己涨跌。要判断某个产品的改善有没有盖住另一个产品的缺席,就用同一批问题、同一段时间,把整体的变化拆成两部分:各产品自身可见度的变化,和各产品回答占比的变化。
1. 为什么品牌整体的 AI 可见度涨了,但是个别产品越来越少被 AI 提到?
直接原因是:品牌整体的 AI 可见度是一个加权平均。它把你监测的所有问题的回答合在一起,算「提到品牌的回答 ÷ 全部回答」。每个产品在这个数里占多少分量,取决于问题集里它有多少道题、采到多少条回答。分量大的产品涨一点,整体就跟着涨;分量小的产品掉了,或者一直没被提到,在整体里几乎看不出来。
用三市场样本算一下 Apple。2026 年 8 月 3 日至 19 日,Apple 在手机回答里的可见度是 53.4%(12,807 条回答),在笔记本回答里是 43.5%(9,578 条),在智能手表回答里是 61.6%(3,301 条),三类合在一起是 50.8%。手表回答只占全部回答的 13%。所以手表的可见度就算掉 10 个百分点,整体也只少约 1.3 个点,汇报时很容易被当成正常波动。
第二个原因更隐蔽:各产品的回答数比例变了,整体也会变,即使没有任何一个产品真的变好。回答数由两件事决定:问了多少道题,以及每道题采到多少条回答。下面是同一份样本里的 Samsung。我们把三类市场的回答合起来,相当于用一个混了三类产品问题的问题集,来算品牌整体的可见度。前期是 8 月 3 日至 10 日,后期是 8 月 11 日至 19 日。先看原始计数:
| 产品 | 前期回答数 | 前期提到 Samsung | 后期回答数 | 后期提到 Samsung |
|---|---|---|---|---|
| 手机 | 7,215 | 5,788 | 5,592 | 4,130 |
| 笔记本 | 6,066 | 198 | 3,512 | 162 |
| 手表 | 1,360 | 634 | 1,941 | 907 |
| 合计 | 14,641 | 6,620 | 11,045 | 5,199 |
用这些计数直接算比例:
| 项目 | 前期 | 后期 | 变化(百分点) |
|---|---|---|---|
| 品牌整体(三类合算) | 45.2%(6,620 ÷ 14,641) | 47.1%(5,199 ÷ 11,045) | +1.9 |
| 手机回答中的可见度 | 80.2%(5,788 ÷ 7,215) | 73.9%(4,130 ÷ 5,592) | −6.4 |
| 笔记本回答中的可见度 | 3.3%(198 ÷ 6,066) | 4.6%(162 ÷ 3,512) | +1.3 |
| 手表回答中的可见度 | 46.6%(634 ÷ 1,360) | 46.7%(907 ÷ 1,941) | +0.1 |
| 手机回答占全部回答 | 49.3% | 50.6% | +1.3 |
| 笔记本回答占全部回答 | 41.4% | 31.8% | −9.6 |
| 手表回答占全部回答 | 9.3% | 17.6% | +8.3 |
手机掉了 6.4 个点,品牌整体反而涨了 1.9 个点,原因在最后三行。后期里,Samsung 几乎不被提到的笔记本回答从 6,066 条减到 3,512 条,占比从 41.4% 降到 31.8%;表现中等的手表回答从 1,360 条增加到 1,941 条,占比从 9.3% 升到 17.6%。整体的上涨来自问了什么、问了几次变了,不是哪个产品更常被 AI 提到。笔记本那一行更说明问题:Samsung 卖笔记本,但两段时间里都只有 3% 到 5% 的笔记本回答提到它,品牌整体却一直在 45% 以上。
那么,是笔记本的问题变少了吗?并不是。按提问编号去重,可以数出每段时间各产品有多少道不同的问题,以及每道题平均对应多少条回答。同一道题在不同平台、地区或日期采到的回答都算在内。
| 产品 | 前期问题数 | 后期问题数 | 前期每题平均回答数 | 后期每题平均回答数 |
|---|---|---|---|---|
| 手机 | 3,249 | 3,748 | 1.65 | 1.22 |
| 笔记本 | 1,885 | 2,049 | 2.25 | 1.41 |
| 手表 | 649 | 1,155 | 1.59 | 1.19 |
注:只统计能关联到提问编号的回答,各产品、各时期覆盖 70% 到 82% 的回答,所以这张表只用来看方向,不能和上面的回答数直接相乘。
笔记本的问题数其实还多了一些(1,885 道到 2,049 道),回答却少了,因为每道笔记本问题对应的回答,从平均 2.25 条降到 1.41 条。手表则是问题数几乎翻了一倍(649 道到 1,155 道)。可见,回答占比的变化既可能来自题数,也可能来自每道题跑了几次。这正是第 7 节要求固定问题集和采样次数的原因。
统计学里,总体的趋势在拆成子群后出现、消失或反转,叫作辛普森悖论(斯坦福哲学百科对该现象的定义)。品牌整体可见度遇到的是同一类问题:各子群在总体里的比例一变,合起来的数就可能和拆开后的数走向不同。
问题里带不带品牌名,也会改变整体。Practical Ecommerce 的 Ann Smarty 在Better Metrics for AI Search Visibility中提醒:工具给出的可见度完全取决于问了哪些问题。带品牌名的问题很可能接近 100%,应该单独放一组。如果某个产品的品牌词问题加多了,品牌整体也会被抬高。
还有一点要先说明:表里手机那 6.4 个点的下降,本身也要再拆一次。第 7 节会看到,其中大部分同样来自问题换了一批。
2. 品牌整体的 AI 可见度涨了,怎么看出有没有个别产品被盖住了?
直接答案:用同一段时间、同一套问题,把回答按产品分开,算出每个产品的两个数:它自己的可见度,以及它的回答占全部回答的比例。再和上一期比,把整体的变化拆成「产品自身变化」和「问题构成变化」两部分。出现下面任何一种情况,就说明有产品被盖住了:
- 整体在涨,但有产品自身的可见度在掉;
- 有产品的可见度长期很低,但它在整体里分量小,整体看不出来;
- 整体的涨幅主要来自问题构成变化,而不是产品自身变化。
具体做法分三步:
- 给每道问题标上所属产品。一道题只归一个产品;同时问到两个产品的题,和带品牌名的题,各自单独放一组,不混进任何产品。
- 每个产品分别算两期的可见度和回答占比。
- 拆分整体的变化,分成下面两部分来算。
- 产品自身变化的影响:该产品两期平均的回答占比 × 它自己可见度的变化。
- 问题构成变化的影响:该产品两期平均的可见度 × 它回答占比的变化。
所有产品的两部分加起来,正好等于整体的变化。
拿第 1 节的 Samsung 来拆:
| 产品 | 自身可见度变化 | 自身变化对整体的影响 | 回答占比变化 | 问题构成对整体的影响 |
|---|---|---|---|---|
| 手机 | −6.4 | −3.2 | +1.3 | +1.0 |
| 笔记本 | +1.3 | +0.5 | −9.6 | −0.4 |
| 手表 | +0.1 | 0.0 | +8.3 | +3.9 |
| 合计 | — | −2.7 | — | +4.5 |
注:单位均为百分点;两列合计相加为 +1.9(按未四舍五入的数值计算)。
三个产品自身的变化加起来,让整体少了 2.7 个点;问题构成的变化让整体多了 4.5 个点。只看品牌整体,会以为 Samsung 这段时间在 AI 回答里表现更好了。拆开以后看到的是:手机在掉,笔记本几乎缺席,整体靠手表回答变多、笔记本回答变少撑了起来。
如果用 Dageno,第一步「按产品分开看」可以从AI 市场细分页面开始。它按市场列出同一个品牌的名次、可见度,以及每个市场的领先品牌(见图 1)。第三步的拆分,目前要导出数据在表格里自己算;我们没有在产品里核实到直接给出这种拆分的功能。
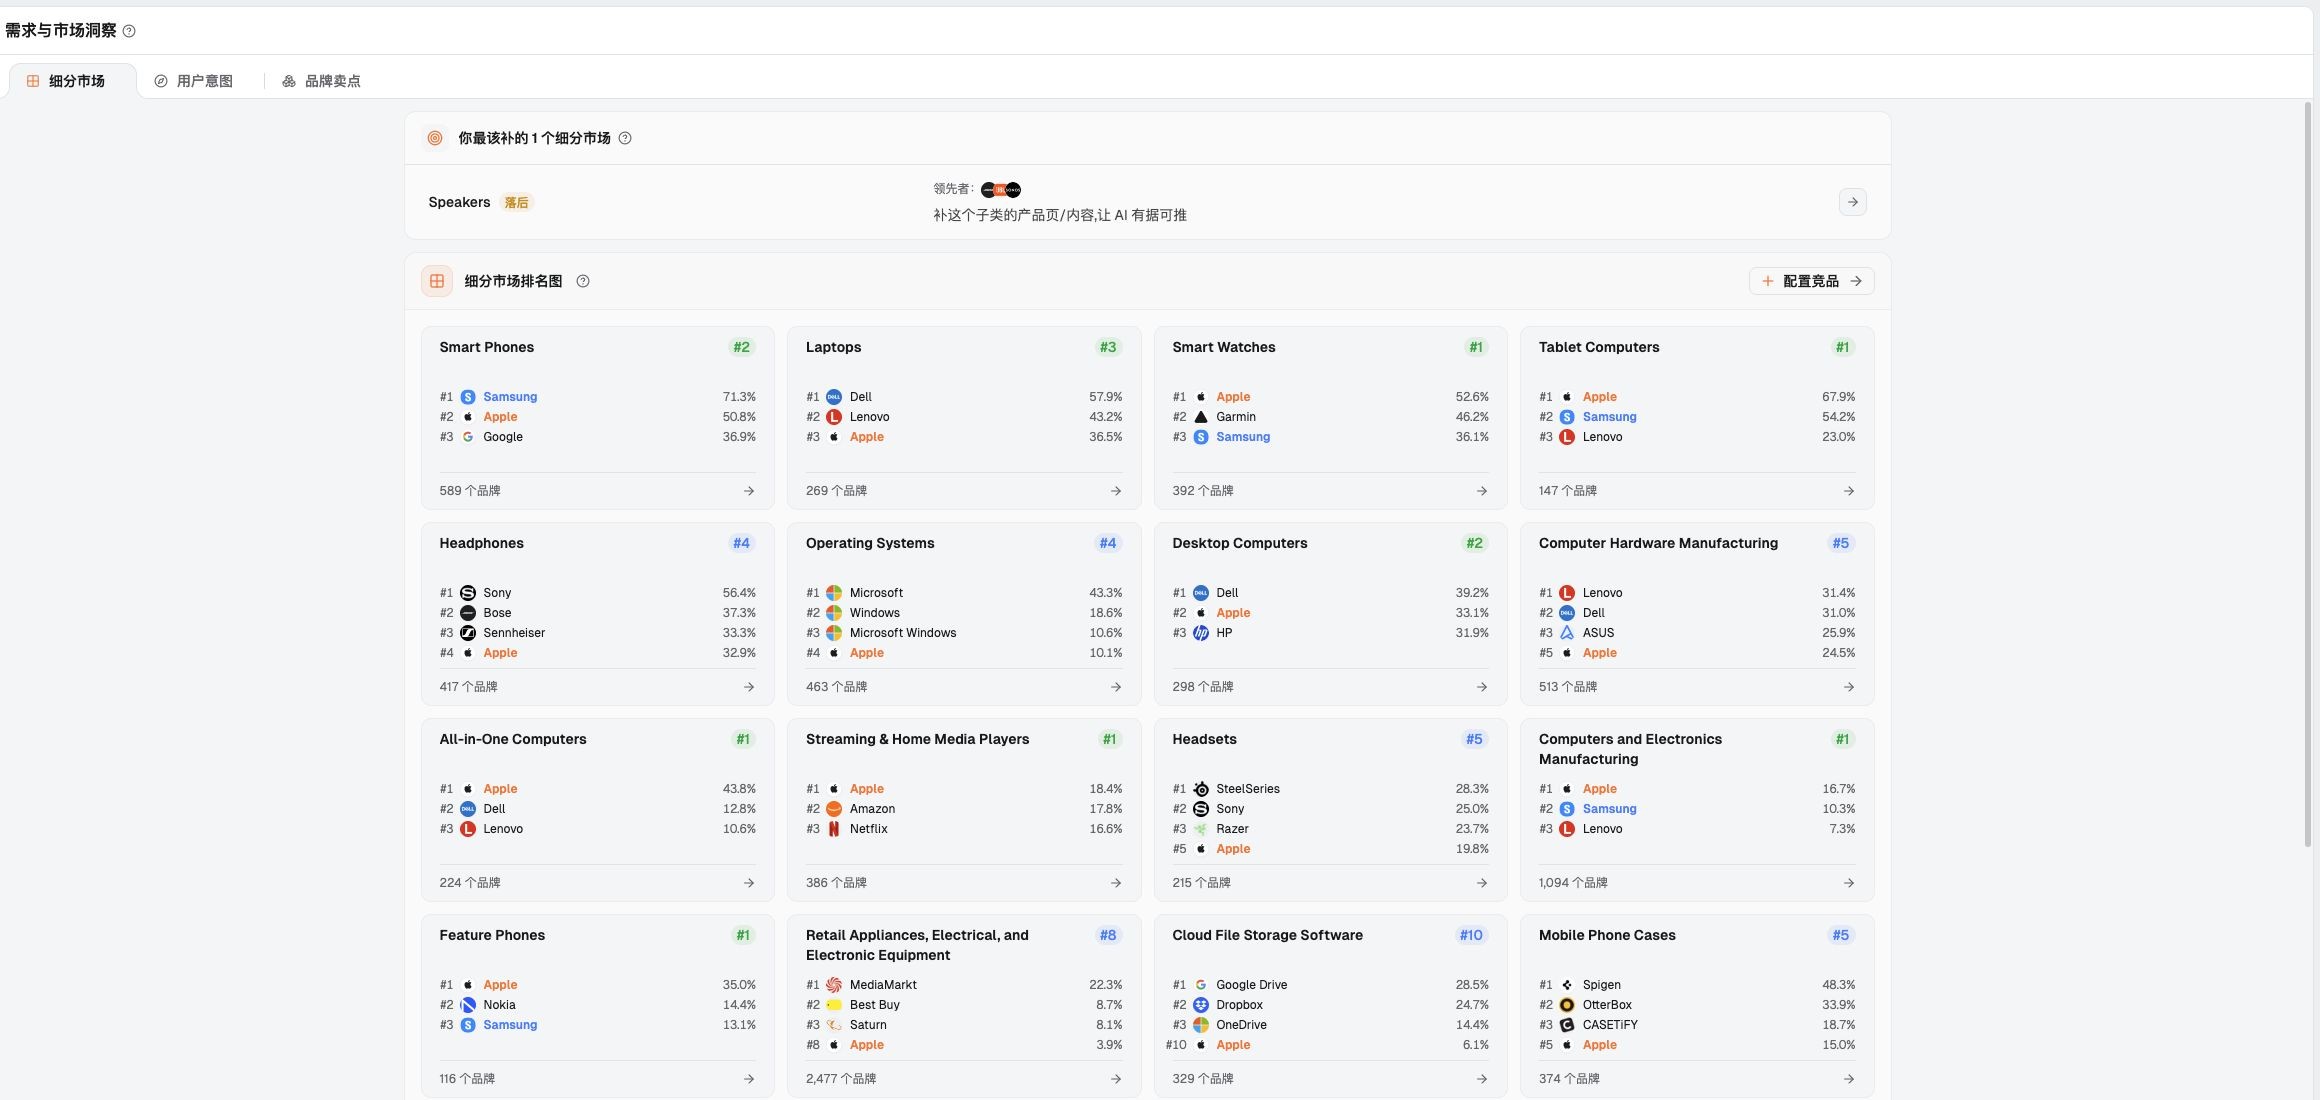
*图 1:Dageno「AI 市场细分」页面的 Apple 项目示例。同一个品牌在 Smart Phones 排第 2(50.8%),在 Laptops 排第 3(36.5%),在 Smart Watches 排第 1(52.6%),在 Cloud File Storage Software 只排第 10(6.1%),各市场的领先品牌也不同。Apple 是公开品牌示例,不是 Dageno 客户。图中没有显示统计时间范围;可见度不等于销量或市场份额,排名低也不等于值得进入的机会。
3. 拆开看后发现个别产品很少被 AI 提到,怎么确认这不是偶然?
直接答案:先确认三件事,再下结论。
- 同一道题重复问几次,这个产品是不是一直没出现,位置被竞品占了。
- 回答里提到这个产品的型号时,有没有算到品牌名下。
- 在被问到的地区和价位里,我们是不是真的有这个产品。
三件都成立,才算真缺席。只问过一两次、只看了几条回答,都不够。
3.1 同一道题问了三次,有两次没提到这个产品,算缺席吗?
不算,最多算不稳定。AI 的回答每次都可能不一样。SparkToro 和 Gumshoe.ai 在 2025 年 11 月至 12 月请 600 名志愿者,把 12 个找品牌推荐的问题,在 ChatGPT、Claude 和 Google 的 AI 回答里一共跑了 2,961 次。结果是:同一个问题两次给出相同品牌清单的概率不到 1%(SparkToro 原文)。圣加仑大学的 Schulte、Bleeker 和 Kaufmann 也认为,可见度应该看多次测量的分布,而不是一次观察的结果(Don't Measure Once)。按论文报告,同一问题只跑一次,品牌被识别比例的标准误是 0.370;跑 7 次后降到 0.10 以下。也有从业者在Reddit 的一条讨论里说,同样的问题,自己什么都没改,可见度一周内也会摆动 15% 到 20%。这是个人观察,不是统计结论。
所以要看重复采样后的结果。在三市场样本里,同一道笔记本问题、在同一平台和同一地区被问到 3 次及以上的,一共有 26 组。
- Samsung:23 组一次都没出现,3 组时有时无,没有一组每次都出现。
- Apple:同样这 26 组里,有 21 组每次都出现。
样本不大,但足以说明 Samsung 的缺席不是一两次采样碰巧没赶上。它在各类笔记本问题里的可见度也都很低:
- 按场景选:5.5%
- 综合推荐:5.4%
- 按预算选:6.9%
- 适配性核实:0.8%
这说明缺的是整个产品,不是某一个场景。占了这些位置的是 Dell(63.0%)、Lenovo(49.2%)、Apple(43.5%)等品牌。
3.2 回答里写了产品型号却没写品牌名,这条回答算不算提到了我们?
要看工具的识别规则,最好自己翻原文抽查。样本里能读到原文的笔记本回答共 8,713 条,抽查结果如下:
- 有 4,207 条出现了「MacBook」,其中 571 条(约 14%)没有被记为提到 Apple。
- 有 292 条出现了「Galaxy Book」,其中 19 条没有记到 Samsung 名下。
没记上的原因,可能是识别规则只算被当作推荐对象的品牌,也可能是漏识别,要按工具的规则核对。对 Samsung 来说,就算把这些都算上,提到 Galaxy Book 的回答也只占笔记本回答的约 3%,缺席的结论不变。
3.3 AI 没提到的那个价位我们根本不卖,这还算缺席吗?
不算缺口,应该记成「不争取」。Samsung 确实有Galaxy Book 笔记本产品线,但样本覆盖多个国家和地区。每个地区卖哪些型号、价位在哪里,我们没有逐一核实,这一步只能由品牌自己的产品团队确认。同理,品牌本来就没有的价位或用途,AI 不提到它很正常,不能直接当作内容缺口。
在 Dageno 里,细分市场和搜索意图页面上的数字都可以点进对应的原始 AI 回答,看到平台、地区和回答正文(据 2026 年 9 月 8 日至 9 日的产品知识库操作记录)。前两项检查可以在这里完成,第三项要靠自己的产品资料。
4. 管理层只想看一个数,产品负责人却要看自己的产品,什么时候按品牌整体看就够了?
直接答案:下面三个条件同时满足时,看品牌整体就够了:
- 各产品面对的是同一批买家问题和同一批竞品;
- 你要回答的是品牌层面的问题,比如「我们在这个品类的 AI 回答里整体被提到得多不多」,或者品牌定位要不要调整;
- 问题集里各产品的比例每期固定。
任何一条不满足,品牌整体只能当趋势参考,不能拿来判断某个产品做得好不好。
第一个条件最常出现在单一品类的品牌里。比如一个只做智能手表的品牌,不同型号面对的是同一类问题、同一批对手。这时按型号拆,每一块的回答都太少,反而看不清。拆分是有成本的:ThriveStack 按标准的统计检验方法估算过,要以 95% 的置信度区分 10% 和 15% 的真实提及率,每个比较条件大约要跑 686 次(ThriveStack 的整理)。拆成五个产品,每个产品都要有足够的回答,采样量就要成倍增加。
第二个条件对应的是给管理层的汇报。管理层通常只需要知道整体趋势,以及有没有哪个产品出了问题,不需要每个场景的明细。
第三个条件最容易被忽略。第 1 节的 Samsung 说明,各产品的回答数比例一变,整体就会自己涨跌。解决办法是把品牌整体改成固定权重:先算出每个产品的可见度,再按事先定好、每期不变的权重合成一个数。权重可以按题数比例冻结,也可以按各产品的业务重要性来定。这样,各产品的题数或采样次数怎么变,都不会再影响整体。
就算只给管理层看一个数,也建议在下面附一行各产品的可见度和变化,当作「有没有产品在掉」的检查。问题里带了品牌名的题,单独列出,不算进整体。这类问题和不带品牌名的问题回答的是两件事,可以参考品牌提及与非品牌提及的区别。
5. 品牌整体排名靠前,个别产品却排在竞品后面,什么时候必须按产品单独看?
直接答案:出现下面任何一种情况,就要给每个产品单独定一条基线,也就是每个产品有自己的问题、自己的竞品名单、自己的起点数字:
- 各产品的竞品不是同一批;
- 各产品的可见度差得很大;
- 各产品由不同的人负责,对应不同的官网页面和预算;
- 某个产品在问题集里占比很小,整体看不出它的变化。
竞品不同在三市场样本里很明显。各市场可见度前五名完全不一样:
- 手机:Samsung、Apple、Google、Xiaomi、OnePlus
- 笔记本:Dell、Lenovo、Apple、ASUS、HP
- 手表:Apple、Garmin、Samsung、Amazfit、Huawei
同一个 Apple,在手机回答里要和 Samsung、Google 比,到了笔记本回答里,对手换成了 Dell 和 Lenovo。把这些合成一个品牌整体的排名,比的已经不是同一批对手。
差距很大的例子:Samsung 的可见度在手机里是 77.4%,在手表里是 46.7%,在笔记本里只有 3.8%。图 1 里的 Apple 也是一样:手表排第 1,笔记本排第 3,云存储只排第 10。
负责人不同时,用品牌整体考核会让人白白得分或白白挨批。比如负责笔记本的人,可能因为手表题变多而得到一个上涨的数字,但他的产品其实没有任何变化。
占比很小时,按第 1 节的算法,这个产品掉 10 个点,整体只动 1 个多点。
独立的研究和从业者也在提醒同一件事。工具商 Odyssiant 分析了 2026 年 2 月至 4 月的 5,356 条 AI 回答,结论是:品牌可见度说明 AI 认不认识这家公司,产品可见度说明对的产品有没有在对的购买场景里被理解。对产品线多、服务线多的公司,这两者的差别尤其大(Product Visibility vs Brand Visibility)。该研究在这段时间里调整过评分方法,作者也提醒,按购买阶段看到的规律只能当作初步基线,不是干净的趋势。Reddit 上也有从业者提到,品牌在 AI 里可能被「拆成两个档案」,一个对应产品问题,一个对应公司信息(原讨论)。这是个人观察,但它和「品牌被认识不等于产品被推荐」说的是同一件事。
按产品单独看,做法不复杂:
- 每个产品列出自己的买家问题,不带品牌名;
- 每个产品配一份自己的竞品名单;
- 每个产品记下起点可见度;
- 品牌整体用第 4 节说的固定权重,从各产品的数字合成。
Dageno 的产品组合策略方案页,描述的正是这种比较:先比较各产品线的 AI 可见度和排名,再选一条产品线深入看买家问题和卖点。这个页面也写明了边界:AI 回答中的位置和覆盖情况,不衡量市场需求、市场份额或收入;不同市场的结果应该分开保留。
6. 同一个产品在「哪款最好」里常被推荐,一问预算款就不见了,什么时候必须按场景看?
直接答案:同一个产品在不同类型的买家问题里,可见度或名次差得很大,而且你需要根据这个差距决定改哪个页面、补哪类内容时,就要再按场景拆一层。如果差距来自你本来就不做的价位或用途,记下来就行,不算缺口。
三市场样本里,Apple 在手机回答里的整体可见度是 53.4%,但按买家问题的类型拆开,差别很大:
| 买家问题类型 | 可见度 | 回答数 |
|---|---|---|
| 综合最佳 | 73.8% | 839 |
| 按预算选 | 22.9% | 376 |
| 为什么选它 | 18.5% | 287 |
问题类型是 Dageno 的分类。按场景拆分时,只用了能关联到问题元数据的回答,约占手机回答的 78%。
只看产品层面的 53.4%,会以为这个产品在 AI 回答里整体不错。按场景拆开才看到:「综合最佳」类的问题撑高了平均数,一问到预算,它就很少出现。
Dageno 的AI 搜索意图页面就是按这种思路组织的(见图 2)。在 Smart Watches 示例里,Apple 覆盖了全部 25 个子意图,覆盖率 100%。但在「选型推荐」下面:
- 寻找替代选择:第 1 名,可见度 75.0%
- 查看综合推荐:第 2 名,可见度 60.1%
- 按预算或档位选择:第 4 名,可见度 36.9%
覆盖 100% 只说明每类问题里都出现过,不说明每类都领先。
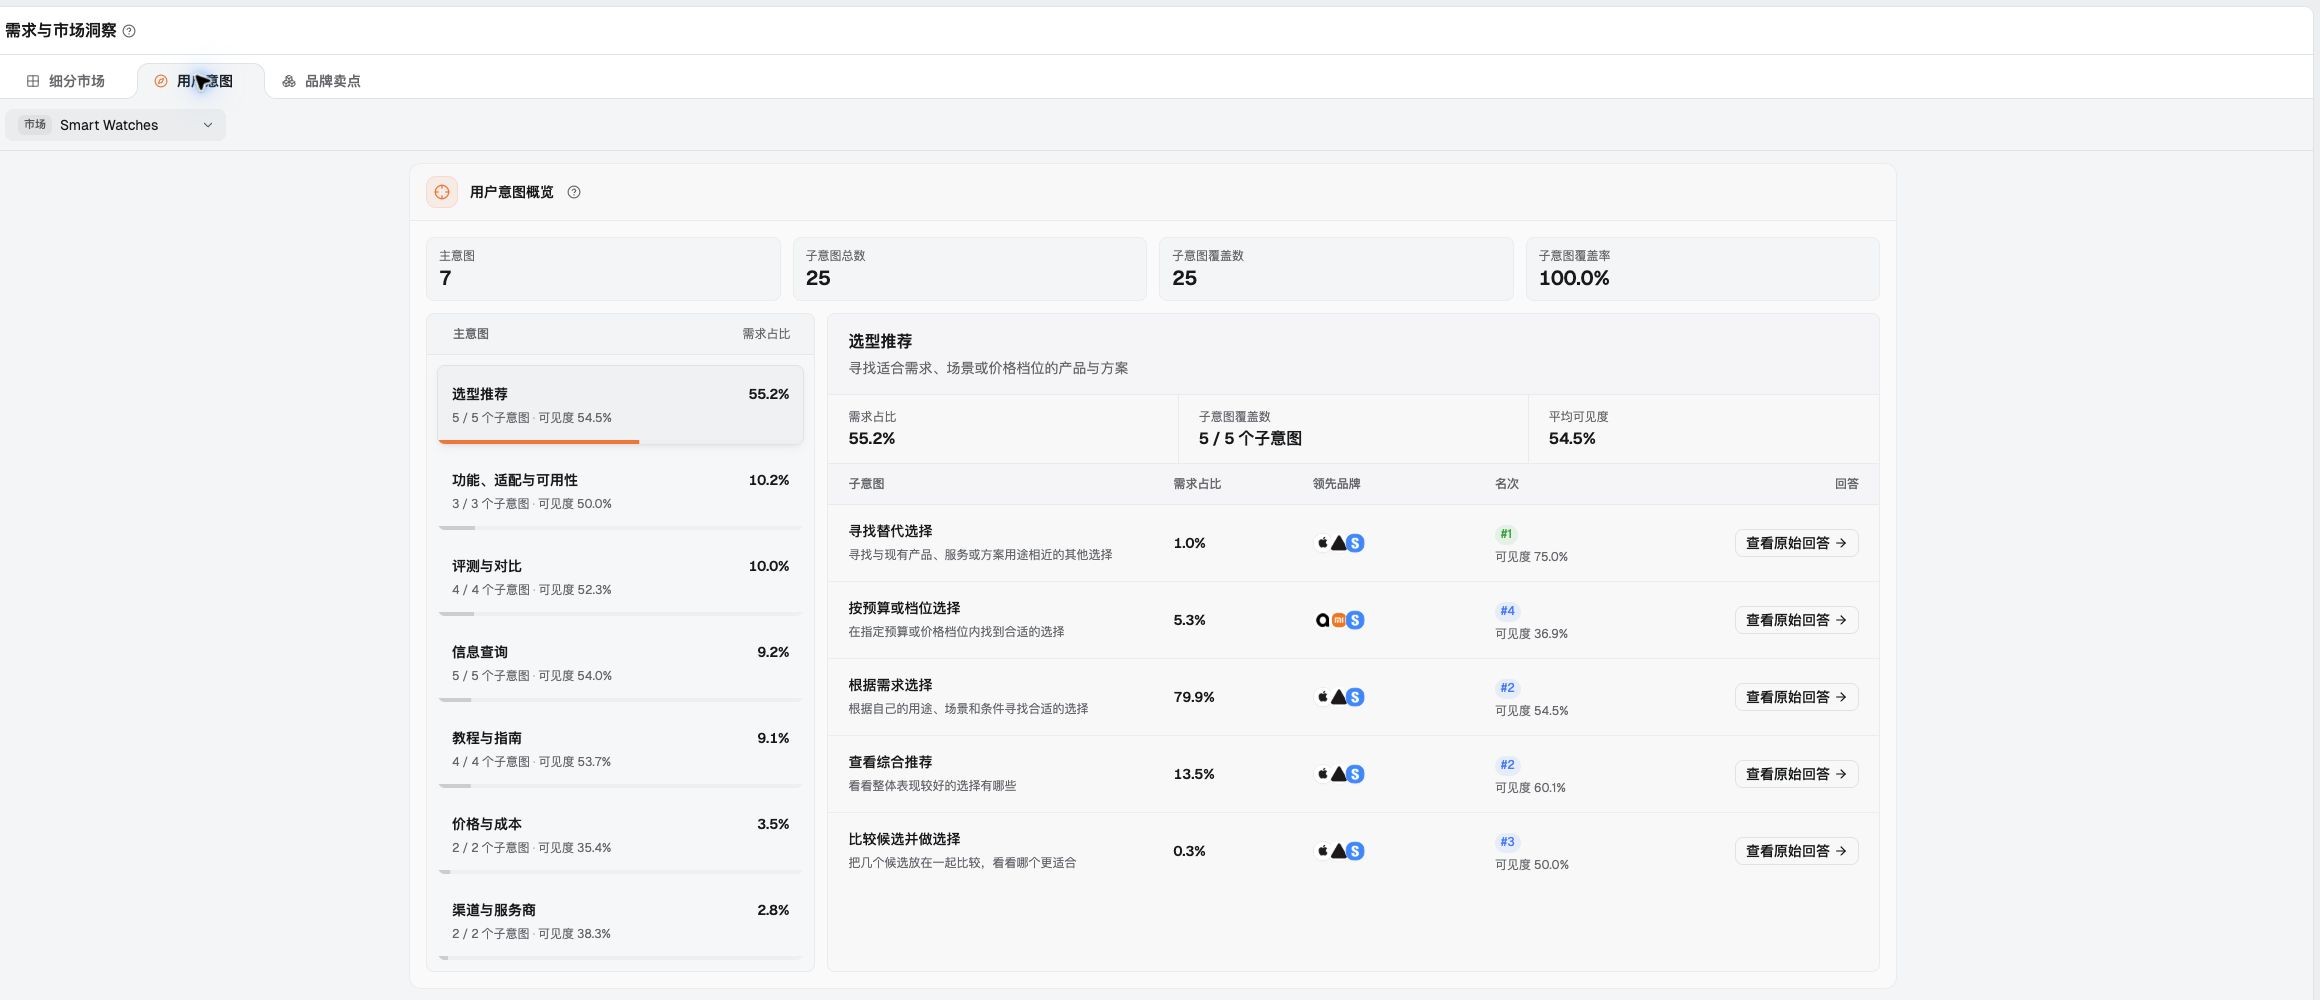
*图 2:Dageno「用户意图」视图的 Apple 项目 Smart Watches 示例:7 个主意图、25 个子意图,子意图覆盖率 100%。「选型推荐」下,「寻找替代选择」排第 1(75.0%),「按预算或档位选择」排第 4(36.9%)。图中的需求占比描述的是所分析问题的分布,不是真实搜索量或购买需求;图中没有显示统计时间范围。
Pixis 的 Swetha Venkiteswaran 在Prompt-Level Visibility中举过一个例子:两个品牌的总体可见度一样,一个在各类问题里都稳定出现,另一个在宽泛的问题里很强,一问到替代方案或具体用途就消失了。两者的平均数相同,商业位置却完全不同。总体分数告诉你该去哪里查,具体的问题告诉你为什么。
不需要按场景拆的情况也要说清:某个场景只有几十条回答时,它的涨跌主要是随机波动,先合并观察,等样本够了再拆。品牌没有对应价位或用途的产品时,也不必为这个场景单独定基线。
三种看法各自适合什么时候,可以对照下表:
| 看法 | 什么时候用 | 不能拿来判断什么 |
|---|---|---|
| 看品牌整体 | 各产品面对同一批问题和竞品;要做品牌层面的决定;各产品的比例或权重固定 | 某个产品表现好不好;某次页面改动有没有用 |
| 按产品看 | 竞品不同、可见度差距大、负责人和官网页面不同、某个产品占比小 | 同一个产品里,是哪类买家问题出了问题 |
| 按场景看 | 同一个产品在不同买家问题里差距大,而且要据此决定改哪个页面 | 回答太少的场景的涨跌;品牌本来就不做的价位或用途 |
7. 补完个别产品的官网页面后,下个月品牌整体又涨了,怎么确定是这个产品真的涨了?
直接答案:只用两期都问过的同一批问题,在同样的平台、地区和采样次数下,看这个产品自己的可见度有没有涨。再把品牌整体的变化拆成产品自身变化和问题构成变化。只有这个产品在同一批问题上涨了,才能说它涨了。至于是不是页面改动带来的,还不能直接下结论。
回到第 1 节的 Samsung:按全部回答算,它的手机可见度掉了 6.4 个点。换成只比两段时间都问过的同一批问题(按提问编号匹配,共 1,431 道题),结果完全不同:
| 手机回答中的可见度 | 全部回答 | 两期都问过的同一批问题 |
|---|---|---|
| Samsung | 81.1% → 77.6% | 84.3% → 84.9% |
| Apple | 56.3% → 48.6% | 58.2% → 55.1% |
这里只用了能关联到提问编号的回答,约占手机回答的 78%,所以「全部回答」一列和第 1 节的数字略有不同。
Samsung 手机的下降,几乎全部来自问题换了一批;在同一批问题上,它的可见度基本没变。Apple 下降了 7.7 个点,在同一批问题上只看得到约 3 个点。同一时期,手机回答的平台构成也变了:Gemini 的回答占比从 46% 降到 27%,ChatGPT 从 30% 升到 48%。如果拿全部回答的数字去评价两段时间之间做过的任何改动,结论都是错的。
所以复核时要做到四件事:
- 冻结问题集。每道题属于哪个产品、带不带品牌名,都记在表里。新题可以加,但前后比较只用两期都有的题。
- 其他条件保持一致。平台、地区、语言、每题的采样次数、窗口长度都不变。本文不讨论按平台或地区拆分,但这些条件一变,前后就不能比。
- 报告里分开写两件事。一是这个产品在同一批问题上的变化,二是品牌整体的变化里有多少来自问题构成。
- 记下改动。哪天改的、改了哪个页面、具体改了什么。
在 Dageno 里,要长期复查的提示词、平台、地区和竞品,可以在「监测设置」里固定下来(见图 3)。导入 CSV 时有四个必填列:prompt、platforms、regions 和 language,必填列里没有产品标签。所以每道题属于哪个产品,需要团队在自己的表格里另外记。截图里的两条提示词,一条问手机,一条问无线耳机,放在同一个列表里,正是需要另外标注的情况。按知识库记录,这一页只核验过配置界面和输入规则,导入提交、保存和实际采样还没有实测。持续监测的功能介绍见品牌可见性监测。
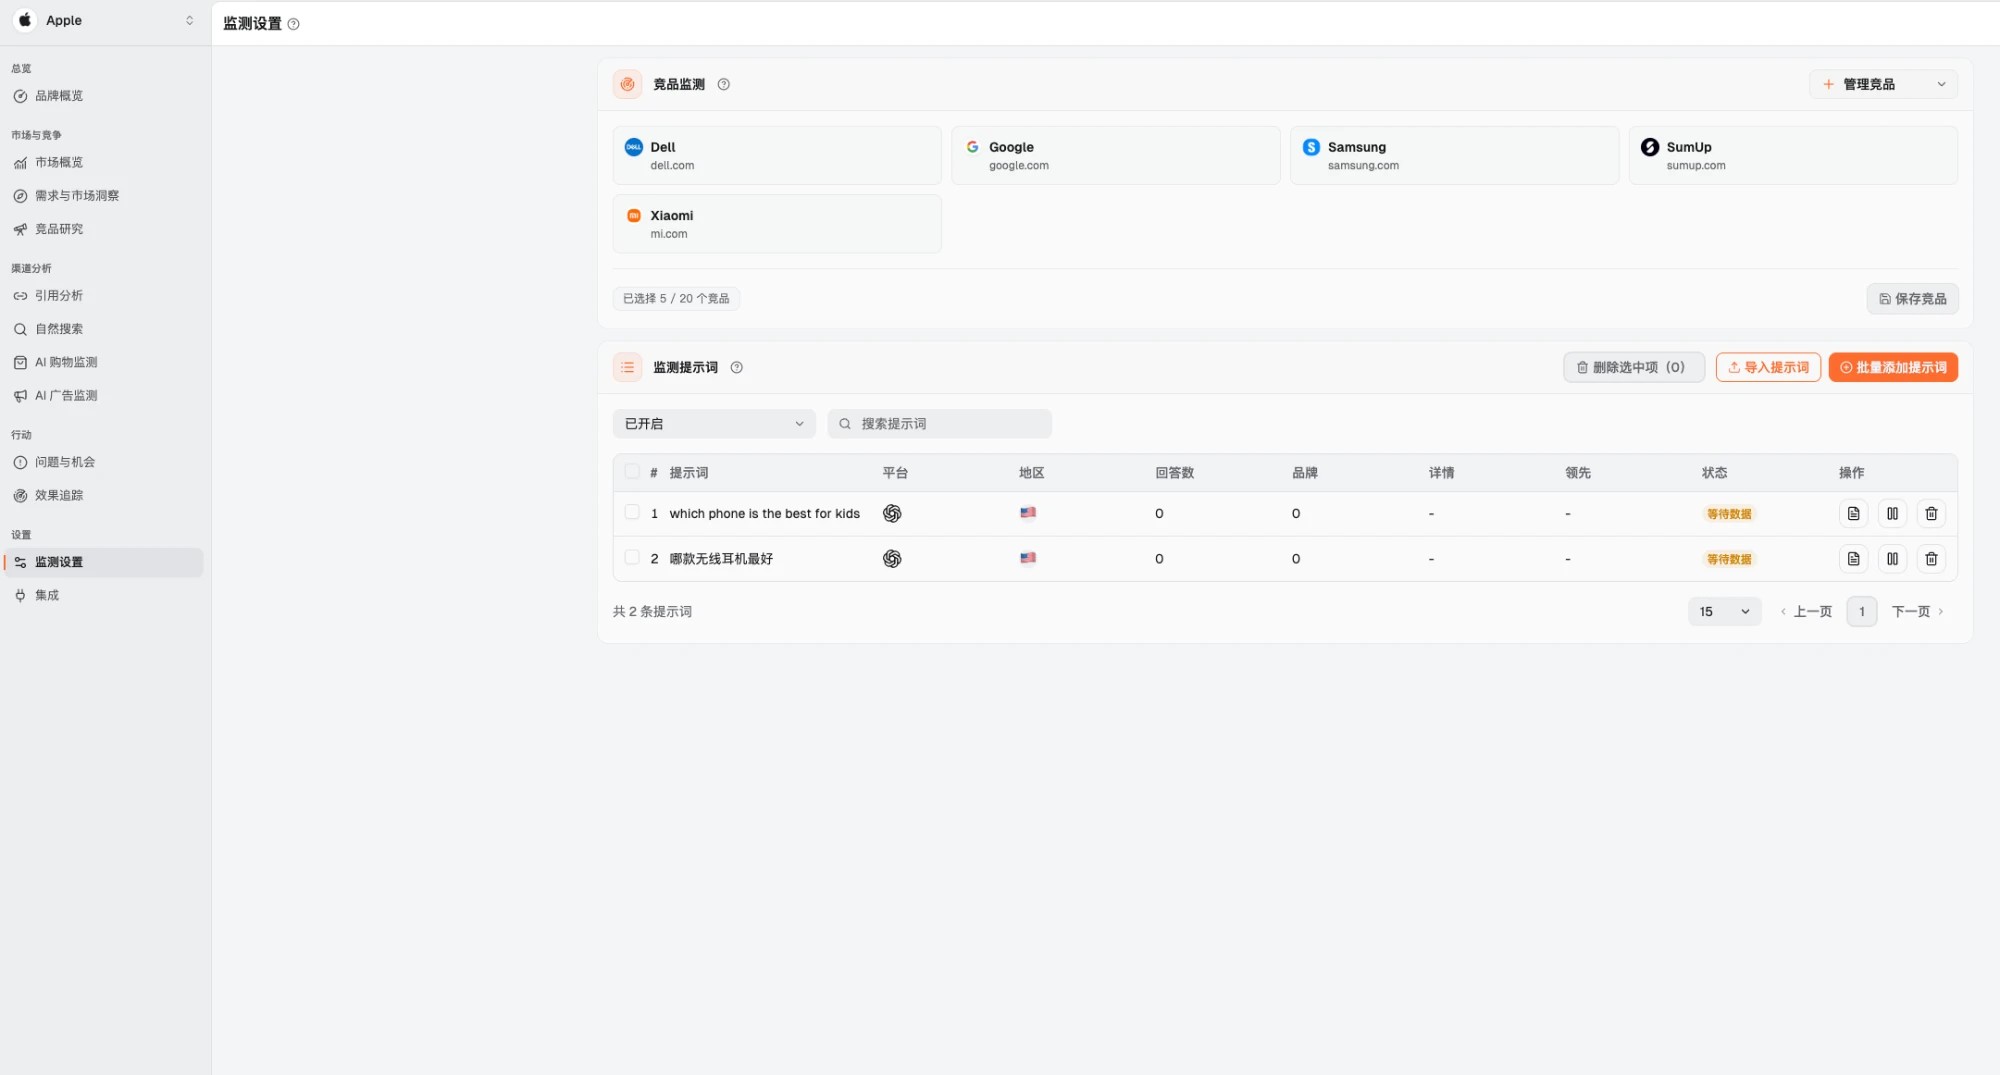
*图 3:Dageno「监测设置」页面示例。竞品监测已选 5/20 个竞品(Dell、Google、Samsung、SumUp、Xiaomi);监测提示词列表里有一条手机问题和一条无线耳机问题,平台为 ChatGPT,地区为美国,状态为「等待数据」。截图时间未核实;图中的提示词只是界面示例,回答数为 0,不代表任何监测结果。
7.1 复核结果出来了,哪些结论能写进月报,哪些只能记成「还不能证明」?
能写进月报的有两类:
- 在同一批问题、同样的平台和地区下,这个产品被提到的比例从多少变到多少;
- 品牌整体的变化里,多少来自产品自身,多少来自问题构成。
「还不能证明」要单独列一栏,至少包括三项:
- 上涨是不是页面改动带来的。同期竞品、第三方来源和模型本身都可能在变。
- 只跑了一期的结果,会不会持续。
- 可见度上涨会不会带来询盘或销量。
下面是一张记录表的示例。品牌、日期和数字都是虚构的,只用来说明怎么填:
| 记录项 | 假设示例(虚构数字) |
|---|---|
| 改动 | 9 月 10 日更新笔记本产品页:补上适用场景、续航测试条件、和同价位机型的对比 |
| 比较范围 | 两期都问过的 120 道笔记本问题;ChatGPT 和 Google AI Mode;美国、德国;每题每期跑 5 次;两期各 14 天 |
| 产品自身变化 | 笔记本在这 120 道题上的可见度:8.0% → 12.5% |
| 品牌整体变化 | +1.6 个点,其中 +0.9 来自笔记本自身,+0.7 来自手表题增多 |
| 写进月报 | 在同一批问题上,笔记本被提到的比例上升 4.5 个点 |
| 还不能证明 | 上升由页面改动带来;下一期是否持续;是否带来询盘或销量 |
复测窗口和采样次数怎么定,可以参考样本量与复测频率怎么定;改完页面后怎样判断变化不是偶然,可以参考更新内容后,如何验证 AI 推荐真的改善。
8. 知道品牌整体会盖住个别产品之后,团队里通常还会追问哪些问题?
8.1 决定按产品拆开之后,是不是分得越细越好?
不是。拆得越细,每一块的回答越少,数字就越容易随机跳动。前面提到,区分 10% 和 15% 的真实提及率,每个比较条件约需 686 次运行。建议先按竞品和负责人拆到产品,样本够了,再细分到型号或场景。
8.2 给问题按产品分组时,一道题同时问到两个产品,算哪个产品的?
单独放一组「跨产品问题」,比如「手机和手表怎么搭配」这种问法。它不算进任何一个产品,单独看趋势。否则同一条回答会被重复计算,或者被随意归到某个产品名下。
8.3 问题集里混进了带品牌名的题,要不要算进品牌整体?
单独算。带品牌名的问题几乎总会提到品牌,混进去会把整体抬高。题数一变,整体就跟着变。问题集怎么组合品牌名、产品名和品类词,可以参考AI 可见性问题集。
8.4 各产品的数都算好之后,品牌整体是把回答直接合算,还是用固定权重?
建议用固定权重。把回答直接合算,会受各产品回答数比例变化的影响,Samsung 的例子就是这样。固定权重可以按冻结的题数比例来定,也可以按各产品的业务重要性来定。定好以后每期不变,整体的涨跌才只反映产品自身的变化。
8.5 AI 回答里只写型号、不写品牌名,品牌整体会不会被低估?
有可能。样本里,出现「MacBook」的笔记本回答约有 14% 没有被记为提到 Apple。先按第 3 节的方法翻原文抽查,再看工具的识别规则,判断这些回答该不该算进去。
8.6 某个产品的 AI 可见度涨了,老板问是不是卖得更好了,该怎么回答?
不能这么说。可见度说明的是 AI 回答里提到这个产品的比例,不衡量销量、市场份额或真实搜索量。要判断生意上的影响,需要另外对照询盘、访问和销售数据。
9. 看完这篇,下周就要汇报 AI 可见度,第一步该先拆哪个数?
先拆上一期和这一期的品牌整体可见度,用的就是第 2 节的方法:
- 把两期的回答按产品分开,每个产品算两个数:可见度、回答占比。
- 把整体的变化拆成产品自身变化和问题构成变化。
- 看三个信号:有没有产品自身在掉;有没有产品长期很低,但在整体里分量小;整体的涨幅是不是主要来自问题构成。
只要出现一个信号,就在汇报的品牌整体数字下面加一行各产品的数字,标出被盖住的那个产品。然后再决定两件事:它要不要单独定基线(第 5 节),要不要再按场景拆开看(第 6 节)。
品牌整体的数可以继续用来向管理层说明趋势,但它不该再是判断某个产品好坏的唯一依据。
References
- SparkToro:AI 品牌推荐稳定性研究,Rand Fishkin、Patrick O'Donnell,2026 年 1 月 27 日发表,2026 年 10 月 19 日查看。600 名志愿者、12 个问题、2,961 次运行,数据采集于 2025 年 11 月至 12 月;研究未经同行评审。
- Schulte、Bleeker、Kaufmann:Don't Measure Once: Measuring Visibility in AI Search (GEO),arXiv,2026 年 4 月 8 日提交,2026 年 10 月 19 日查看。标准误数字取自论文正文与表格。
- ThriveStack:AI visibility tracking and non-determinism,2026 年 5 月 4 日发布、9 月 28 日更新(据页面元数据),2026 年 10 月 19 日查看。686 次是该文按 95% 置信度、80% 检验功效给出的估算,不是实测;作者有商业利益。
- Odyssiant:Product Visibility vs Brand Visibility in AI Search,2026 年 5 月 9 日发布(据页面元数据),2026 年 10 月 19 日查看。工具商研究,5,356 条回答,2026 年 2 月至 4 月;研究期间调整过评分方法。
- Pixis:Prompt-Level Visibility: Find the Gaps Category Scores Hide,Swetha Venkiteswaran,2026 年 8 月 14 日发布,2026 年 10 月 19 日查看。工具商博客。
- Practical Ecommerce:Better Metrics for AI Search Visibility,Ann Smarty,2026 年 2 月 2 日发布,2026 年 10 月 19 日查看。
- Stanford Encyclopedia of Philosophy:Simpson's Paradox,2021 年 3 月 24 日首发,2026 年 6 月 6 日修订,2026 年 10 月 19 日查看。
- Reddit:r/AISearchLab「The Tracking Fallacy in Answer Engines」,帖子发布于 2026 年 1 月 22 日,引用的评论发布于 1 月 23 日,2026 年 10 月 19 日通过公开存档核对。个人陈述。
- Reddit:r/GenEngineOptimization「Prompts are not the same as keywords」,帖子发布于 2026 年 4 月 28 日,引用的评论发布于 4 月 30 日,2026 年 10 月 19 日通过公开存档核对。个人陈述。
- Samsung:Galaxy Book 产品页(美国站),2026 年 10 月 19 日查看。只用来说明该品牌有笔记本产品线,未核实各地区的在售型号。
- Dageno:AI 市场细分,2026 年 10 月 19 日查看。
- Dageno:AI 搜索意图,2026 年 10 月 19 日查看。
- Dageno:品牌可见性监测,2026 年 10 月 19 日查看。
- Dageno:产品组合策略,2026 年 10 月 19 日查看。
About the Author

更新人
Dageno
Dageno is the research and insights team at Dageno AI, publishing industry reports and expert analysis on AI Search Visibility, Generative Engine Optimization (GEO), and AI-powered search discovery.

