不同市场的 AI 购买问题有哪些差异
FTA Global 的测试中,离开"纽约 + 英语"后,AI 推荐的前五名品牌平均换掉 2.9 个。本文拆解海外市场 AI 购买问题的四类差异:在哪个 AI 里问、带什么本地约束、引用哪些来源、推荐了谁,并给出系统比较的五步方法。
永久免费查询
覆盖 12,000+ 细分市场
更新人
AI 辅助研究支持
12 分钟阅读
更新于 Oct 22, 2026
TL;DR
本文说的“AI 购买问题”,指用户在 ChatGPT、Gemini、Google AI Mode 等 AI 产品里提出的选购、比较和比价问题,不是“在不同地区购买 AI 订阅”。
- 同一品类的购买问题,换一个国家、地区或语言市场,至少有四处会变:用户在哪个 AI 里问,问题带着哪些本地约束,AI 去哪里找依据,最后推荐了谁。
- 公开测试显示差异不小。FTA Global 用 ChatGPT 和 Gemini 测了 10 个软件品类,离开“纽约 + 英语”这个基准后,前五名推荐品牌平均有 2.9 个被换掉。另一项五种语言的测试里,easyJet 在俄语回答中被选为首推的比例是 72.5%,在波斯语回答中只有 12.5%。
- 有一点要先说清(这是本文的判断):现有公开研究大多测的是“同一个问题在不同市场得到什么答案”,很少直接测“不同市场的用户实际怎么问”。后者需要当地语言的真实问题样本,把英文问题翻译过去得不到。
- 实际做法是把“国家 × 语言 × 平台”当作一个比较单元。每个单元用本地化的问题集多次采样,再从四个维度对比。看到差异后,先用当地价格、可售范围和引用来源去解释,再决定要不要改内容。
为什么同一品类的 AI 购买问题会因市场而不同
这里的“市场”由三个变量叠加而成:用户所在的国家或地区、提问用的语言、使用的 AI 平台。三者任何一个变了,同一个品类的购买问题都可能得到不同的回答。英国和美国都用英语,印度同时有英语、印地语和混合用法,所以国家和语言要分开记录。
位置本身就会改写回答。Massive 在 2026 年 10 月发布的测试中,从美国、巴西和日本同时向 ChatGPT 提交同一句“咖啡馆一杯咖啡的典型价格”。提问没有写国家,美国的回答用美元报价,巴西和日本的回答则分别加上了雷亚尔和日元的价格。这项测试每个国家只跑了一次,只能证明这种效应存在,说明不了它出现得有多频繁。
分析时要把两层分开:问题层是用户问了什么、带了哪些条件;回答层是 AI 用了哪些来源、推荐了哪些品牌。一个品牌在某个市场“消失”,可能是当地用户问的根本不是同一个问题,也可能是 AI 的取材和偏好变了。下面四节按这个顺序展开。
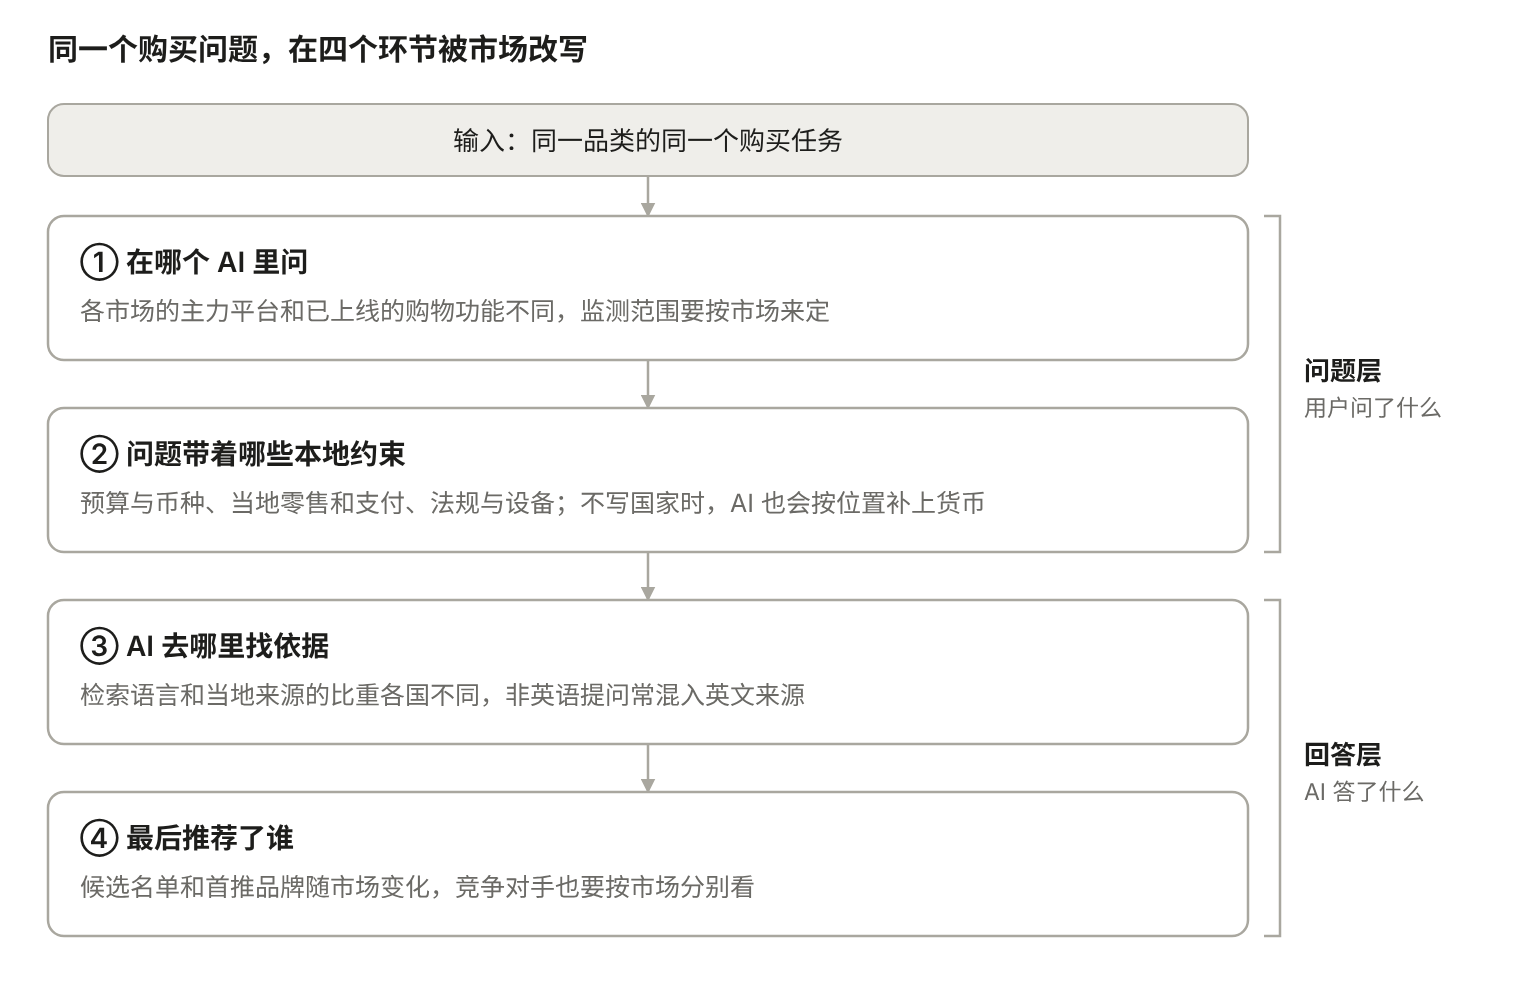
示意图:四层差异,对应下文四节。
差异一:用户在哪个 AI 里问,各市场并不一样
ChatGPT 在主要海外市场都是第一,但第二梯队的排序各地不同。Statcounter 的 2026 年 9 月数据显示,ChatGPT 在下图 7 个市场的份额都在约 74%–80%。Gemini 在巴西、日本、印度超过 16%,在英国约 10%;Copilot 在美国和日本超过 6%,在印度不到 2%;Perplexity 在德国和法国高于其他几个市场。
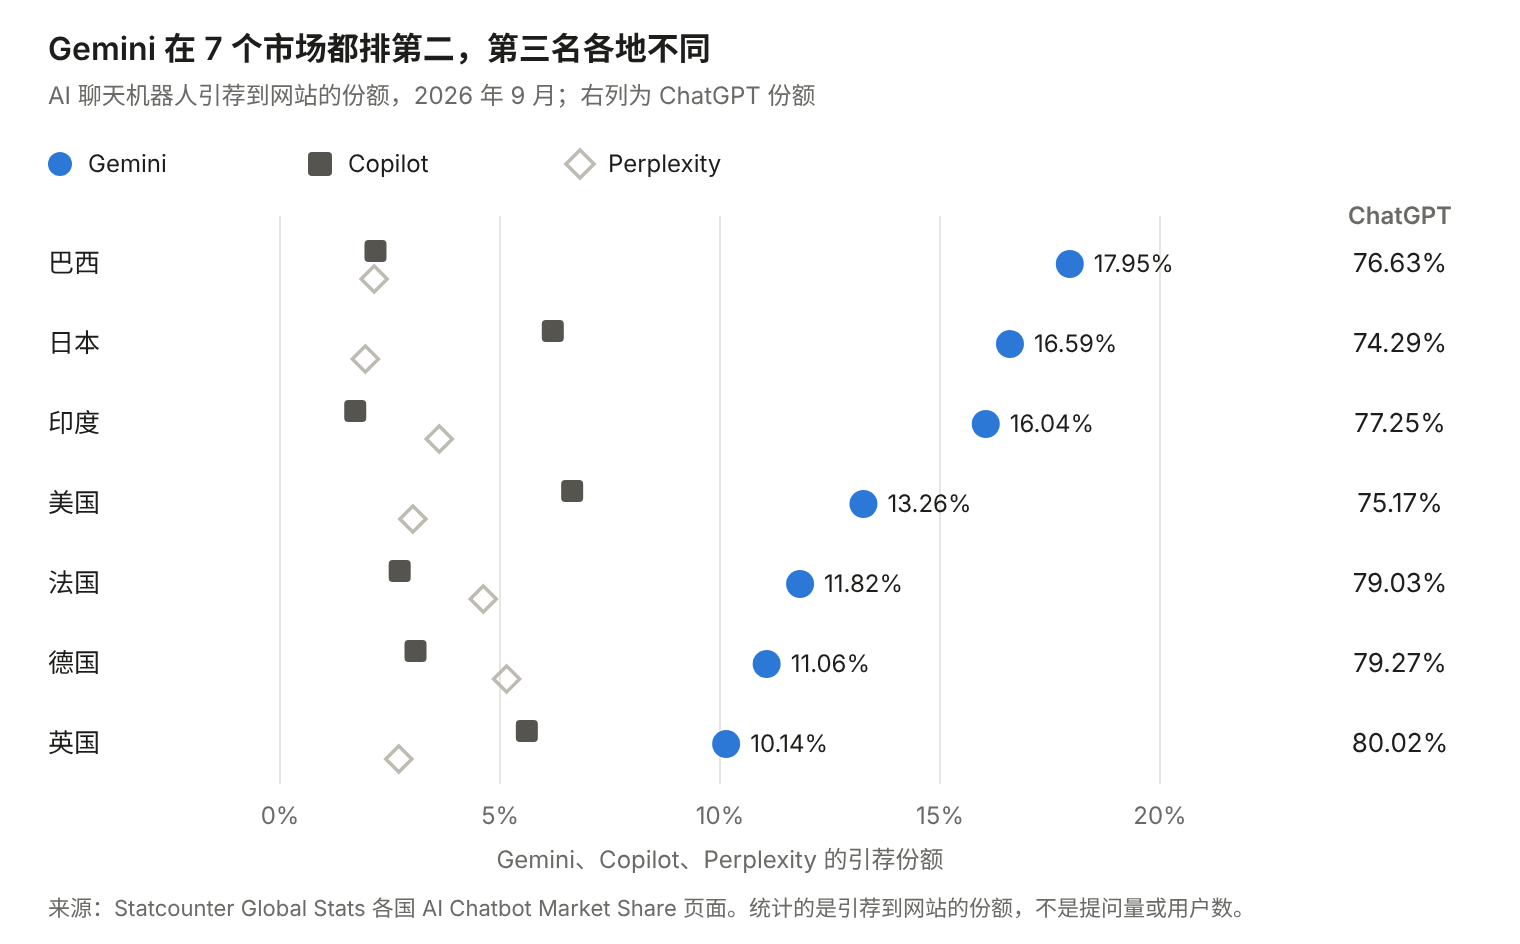
来源:Statcounter Global Stats,AI 聊天机器人引荐份额,2026 年 9 月,7 个市场。
要注意口径:Statcounter 统计的是各聊天机器人把用户引到网站的份额(基于其追踪的网站页面浏览),不是提问次数或用户数,也不包含不提供引荐信息的 Grok。它适合看“哪个平台在当地会把人带到网站”,不适合推算购物提问量。
问卷数据也指向市场差异。Pygmalios 转述的 World Retail Congress(Vercel 委托)调查(2026 年 5 月,4,000 名欧洲购物者)显示,购物时使用 ChatGPT 的比例在南欧是 49%、北欧 40%、德国 38%、英国 33%;英国有 50% 的受访者购物时不用任何 AI 搜索,南欧是 32%。这些是自报数据,南欧和北欧是多国合并结果,转述该调查的 Pygmalios 也提醒,自报意向通常会高估实际行为。
功能的上线顺序也会造成差异。OpenAI 在 2025 年 9 月 29 日推出 ChatGPT 内的 Instant Checkout 时,只对美国用户开放,商家也只有美国的 Etsy 卖家。同样是“帮我买”这类问题,在有结账功能的市场可以在对话里完成,在其他市场只能跳转到外部网站。本文未核实该功能在 2026 年 10 月的最新覆盖范围,做市场比较前要单独查。
差异二:购买问题带着不同的本地约束
同样是“选哪个”,各市场的问题会带上不同的条件。有些条件写在问题里,有些由用户所在的位置自动补上。
- 写在问题里的约束:按当地货币写的预算、当地的零售平台、支付和配送方式、当地法规或税务要求。支付是很明显的例子:FTA Global 的测试中,Stripe 在纽约、伦敦、马德里、巴黎、柏林都排第一,在孟买、德里、班加罗尔却没有进前五。当地的支付生态不同,“小企业用哪个收款工具”就是两个不同的问题。
- 由位置补上的约束:用户不写国家,AI 也会按位置推断货币和规则,前文的咖啡价格测试就是例子。比较市场时,每条回答都要记下采集地点。
- 问题停在购买旅程的哪一步:Deloitte 2026 年 5 月对 15 个欧洲国家 13,500 名消费者的调查中,愿意让 AI 替自己做购买决定的比例在西班牙是 42%,在芬兰是 27%。愿意把决定交给 AI 的人更多的市场,“替我选一个”“直接给我最优的”这类问题可能更常见。这是推测,需要用当地问题样本验证。
并非所有需求都因市场而异。上节提到的 World Retail Congress 调查里,比价在每个区域都是使用 AI 购物的人最常见的用途(51%–55%)。本文的判断是:问题的“动作”各地相近,差异更多落在预算区间、可选渠道和本地规则上。所以整理问题时,预算与币种、提到的平台、支付与配送、法规、设备条件要各自成列。
差异三:AI 引用的来源和用户的信任度不同
非英语市场的购买问题,很大一部分依据仍然来自英文网页。Peec AI 分析了 1,000 多万条 ChatGPT 提问和 2,000 多万次后台检索(query fan-out),只保留用户所在地与提问语言一致的会话。结果是:近 78% 的非英语会话补充了英文检索,非英语提问的后台检索中有 43% 用英文进行。分语言看,土耳其语会话加入英文检索的比例最高(94%),西班牙语最低(66%)。
当地来源的比重也因国而异。FTA Global 的测试中,当地域名和媒体在被引用来源中的占比,德国是 42%,法国 34%,印度 17%。当地来源少,意味着当地品牌可能要靠英文或国际站点的报道才能进入回答。Peec AI 的手工测试里有一个例子:用波兰语、从波兰 IP 问“最好的拍卖网站”,波兰本地的头部平台 Allegro 要么没出现,要么排得很靠后。这是单次示例,不是统计结果。
用户对 AI 答案的信任度也不同。前述 Deloitte 调查中,信任 AI 提供的信息的受访者比例在西班牙是 61%,在芬兰是 36%。本文的推测是:信任度较低的市场,用户更可能追问来源、评测和售后保障,当地可核对的资料就更重要。这一点还没有公开数据直接验证。
差异四:被推荐的品牌和竞争对手不同
前三处差异叠加到最后,用户看到的候选名单就不一样了。FTA Global 以“纽约 + 英语”为基准,在伦敦、马德里、巴黎、柏林和印度三座城市重复同样的小企业采购问题:
- 前五名推荐品牌平均有 2.9 个被换掉。
- 差异集中在和钱、合规有关的品类:薪资、会计、支付、HR 平均换掉 4.4 个,项目管理、视频会议、云存储只换掉 1.5 个。
- 共出现 206 个品牌,其中 159 个只在一个地点进入过前五。
语言也会改变首推。SALT.agency 联合创始人 Reza Moaiandin 在 Search Engine Journal 发表的测试用英语、阿拉伯语、俄语、简体中文和波斯语问同一组购买问题。核心测试用的是关闭网页搜索的 Claude Sonnet 5,2026 年 9 月 7 日采集,每个“场景 × 语言”跑 40 次。下表为各品牌被选为首推的比例:
| 场景 | 品牌 | 比例最高的语言 | 比例最低的语言 |
|---|---|---|---|
| 伦敦—特内里费往返机票 | easyJet | 俄语 72.5% | 波斯语 12.5% |
| £400 以内的降噪耳机 | Sony | 俄语、波斯语 100% | 英语 50% |
| 英国小企业 CRM | HubSpot CRM | 英语 22.5% | 阿拉伯语 2.5% |
| £500 以内的扫地机器人 | Roborock | 俄语 97.5% | 英语、阿拉伯语 87.5% |
扫地机器人这一行说明不是每个品类都会大幅摇摆。同一项测试里,对其中两个品类打开网页搜索后,10 组“品类 × 语言”中有 7 组的首推变了;在同样两个品类、关闭搜索的条件下,ChatGPT 与 Claude 的首推在 10 组里只有 1 组一致,Gemini 有 5 组一致。作者自己也说明,样本在一个下午内采集,结果只是方向性的。
学术研究也观察到类似倾向。EMNLP 2024 论文《“Global is Good, Local is Bad?”》发现,大模型更常把正面属性和全球品牌联系在一起,并更倾向给高收入国家的用户推荐奢侈品;但在某些场景下,原产地效应又可能抬高本地品牌。对品牌来说,竞争对手是分市场的:在美国和你正面比较的品牌,到印度或波兰可能换成另一组本地品牌。
怎样系统比较不同市场的购买问题
把“国家或地区 × 语言 × 平台”当作最小比较单元,按下面五步做。
- 定义比较单元:每个单元写清国家或地区、语言、平台。多语言国家按语言拆开,比如印度的英语和印地语、加拿大的英语和法语。
- 建本地化问题集:从当地来源收集真实问法,如当地搜索建议、论坛、客服和销售记录,由母语者审一遍。保留一组各市场共用的购买任务用来对比,再加上当地独有的问题。
- 固定条件、重复采样:同一时间窗口、同一模型和搜索设置;每个条件重复多次,FTA Global 每个条件跑 5 次,SALT 的测试跑 40 次。同时记下采集地点和账号状态。
- 按四个维度对比:见下表。
- 用当地事实解释差异:先核对当地价格、可售范围、渠道和法规,再决定做本地化内容、补统一页面,还是继续观察。
| 维度 | 每个市场记录什么 | 常见误读 |
|---|---|---|
| 在哪里问 | 当地主要 AI 平台;购物卡片、结账等功能是否可用 | 只测 ChatGPT、只用美国英文 |
| 问题约束 | 问题原文;预算与币种;提到的平台、支付、配送、法规、设备 | 把翻译后的英文问题当成当地问题 |
| 依据来源 | 引用网址、来源语言、本地还是国际站点 | 只数域名次数,不读来源内容 |
| 推荐结果 | 首推品牌、前五名单、自己是否出现及其语境 | 用一次截图代表整个市场 |
用 Dageno 比较不同海外市场的购买问题
上面的四个维度,在 Dageno 里可以用这几个功能对应起来:
- 跨模型与地区基准:把品牌在各 AI 平台、各国家和地区的排名、可见度和前三名分开列出,不让一个平均分掩盖市场差异。
- 多地区比较:在一致的主题和口径下,比较不同地区、语言和模型中的品牌提及、竞争位置和可见来源。产品页也提醒,直译的 Prompt 不等于当地用户的同一个意图。
- 需求场景与购买旅程:把问题按意图分组,可以打开每组的原始回答和引用页面,看清当地用户实际在问什么。
- 如果目的是选下一个拓展市场,海外市场扩张方案把这些模块串成“比较市场、理解各地市场、确定调查重点”三步。
以 Dageno 演示工作区里的智能手表市场为例(Apple 只是示例品牌,不代表其为 Dageno 客户)。“市场概览 → 平台与地区”的地区表显示,Apple 在多数市场排第 1,在西班牙、波兰、意大利排第 2,领先的都是 Garmin。
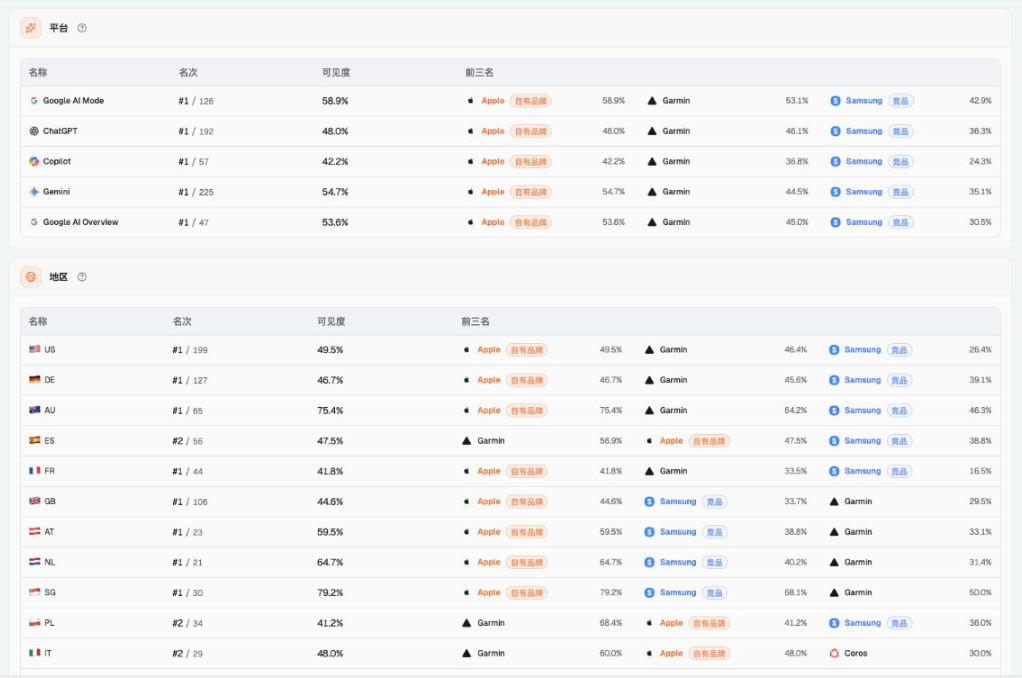
图 1:同一个智能手表市场,按 AI 平台和地区分开看品牌排名与可见度。
地区表只负责指出先查哪里,打开回答才看得到问题本身。在 Dageno 已发布的地区可见度案例中,Apple 在印度排第 14、可见度 4.76%。读完回答才发现,印度的两条回答都在推荐 ₹5,000 以内的手表,而 Apple Watch SE 3 在印度官网起价 ₹29,900。
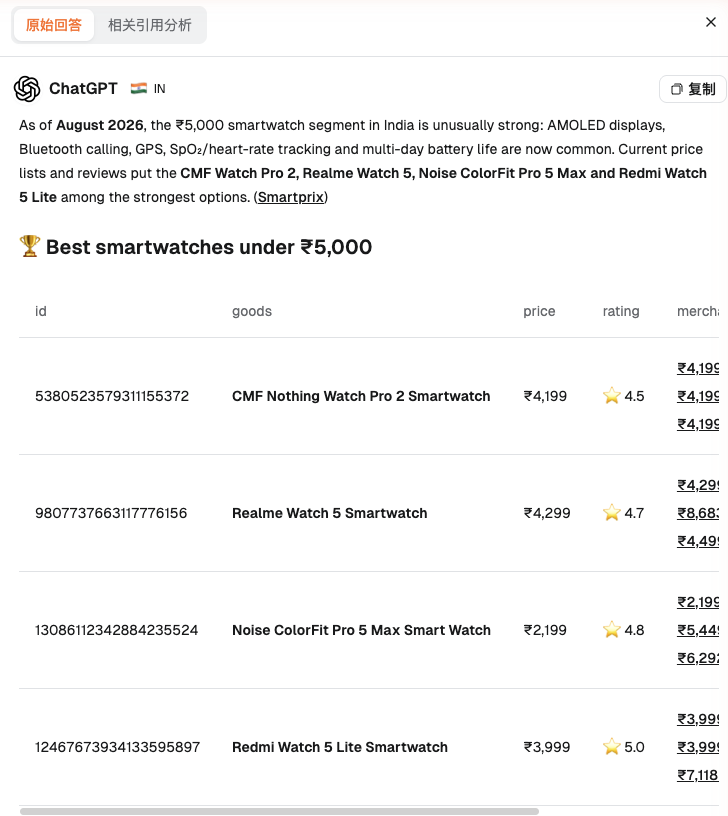
图 2:印度(IN)的 ChatGPT 回答,问题限定在 ₹5,000 以内。
波兰的回答则用波兰语、以 1500 zł 为预算,推荐 Amazfit、Garmin、Huawei 和 Samsung 等手表,引用主要来自 euro.com.pl、ceneo.pl、mediamarkt.pl、allegro.pl 等当地零售和比价网站。
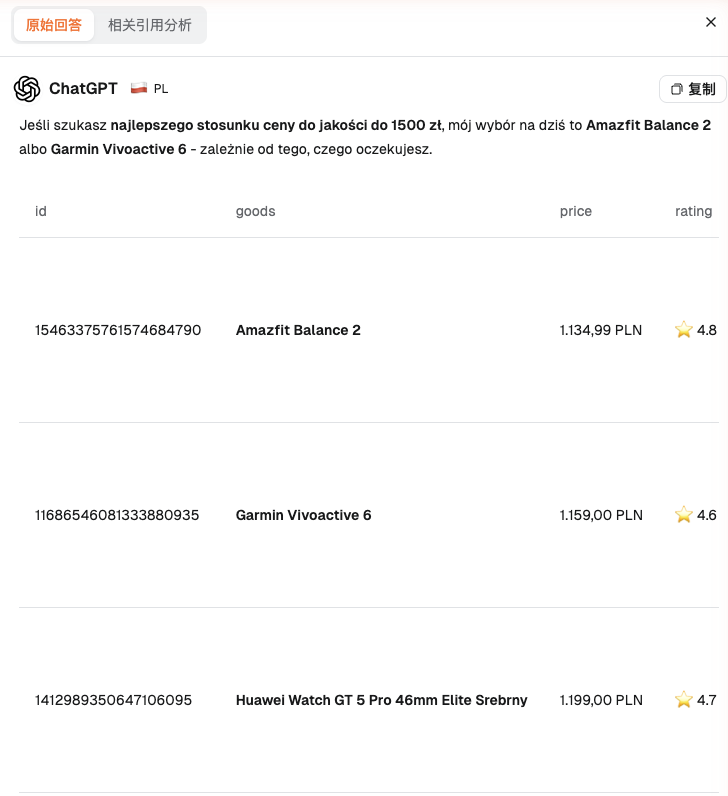
图 3:波兰(PL)的 ChatGPT 回答,用波兰语按 1500 zł 预算推荐。
这两个市场正好对应前文的两类差异:印度是问题的预算约束变了,波兰是语言和当地来源变了。样本也很少:印度 2 条,波兰可比的只有 1 条,所以案例的结论分别是“记为非目标问题”和“继续观察”。
这些视图记录的是已保存的 AI 回答,不衡量销量、搜索量或市场规模;进入哪个市场,仍要结合一手调研以及产品、渠道和合规评估。按 Dageno 博客页的介绍,免费查询覆盖 86 个国家和地区、12,000 个细分市场,可以先用它看品牌在目标市场的位置。
常被忽略的变量、偏差与成本
做市场比较时,下面这些因素很容易被误认成“市场差异”,或者让比较成本超出预期。
- 位置和语言是两个变量:FTA Global 在孟买用英语、印地语和印地英语问同一个支付问题,结果都以印度品牌为主,但名单和顺序有变化。只换 IP 不换语言,或只换语言不换位置,测到的是不同的东西。
- 回答本身就不稳定:FTA Global 的测试中,只有 35% 的条件在 5 次运行里首推始终是同一个品牌。单次运行看到的差异,可能只是随机波动。
- 平台、版本和搜索开关:ChatGPT 和 Gemini 在同一城市、同一问题下平均只共享 3.2 个前五品牌(FTA Global);SALT 的测试里打开搜索后 10 组中 7 组首推变了。不同条件的结果不能混在一起算。
- 数据口径不同:Statcounter 是网站引荐份额,不是使用量;消费者调查是自报,而且有的按单个国家报、有的合并报。Deloitte 报告里部分国家的 AI 使用率在图表和附录表格中并不一致,引用前要核对原表。
- 研究方的立场:本文引用的 Peec AI、FTA Global、SALT.agency 都在提供 GEO 或 AI 可见度服务,Dageno 也是。它们的结论方向一致,但样本和方法各不相同,最好用自己的品类和市场复验。
- 比较成本随组合数增长:每多一个“国家 × 语言 × 平台”组合,采样量和阅读回答的工作量都会增加。本地问题集还需要母语者审核。先挑业务上最重要的 2–3 个市场做深,比一次铺开十几个市场更实际。
- 时间会改变结论:平台功能按市场分批上线,模型也在更新。每次比较都要写上采集日期,不要拿旧结果和新结果直接对比。
FAQ
把英文问题翻译成当地语言,能代表当地用户的问题吗?
只能代表“同一个任务用当地语言问”,代表不了当地人真实的预算、渠道和习惯用词。翻译版适合做跨市场对照组,另外要从当地搜索建议、论坛和客服记录里补充原生问法。
同一个国家要测几种语言?
看当地买家实际用什么语言提问。印度、瑞士、加拿大这类多语言市场至少要分开测主要语言;如果你的买家中有人用英语提问(例如跨国企业采购),英语问法也要单独记录。
每个市场要采多少条回答才够?
没有通用数字。公开测试里,FTA Global 每个条件跑 5 次,SALT 跑 40 次。本文的建议是:首推在多次运行中稳定之前,不要下市场结论;波动大的品类要多采。
只监测 ChatGPT 够不够?
对大多数市场不够。ChatGPT 的引荐份额最高,但 Gemini 在部分市场超过 16%,而且 ChatGPT 和 Gemini 对同一问题的前五名单平均只重合 3.2 个。至少要把当地的第二、第三大平台加进来。
发现某个市场的推荐结果不同,要马上做本地化页面吗?
不要。先确认是不是问题本身不同,比如预算超出你的产品线,再看产品在当地是否可售、当地来源说了什么。只有当地事实确实不同、多次采样都显示缺席时,才值得做本地化内容。
结语
不同海外市场的 AI 购买问题,差异来自四层:在哪个平台问、问题带什么约束、AI 从哪里取材、最后推荐谁。公开测试已经显示,只看美国英文结果,可能看错一半以上的候选名单(FTA Global 的软件品类测试中,前五名平均换掉 2.9 个)。但“当地用户实际怎么问”的公开数据还很少,每个品牌都需要用自己的市场和品类去采样。
延伸阅读:
参考来源
- FTA Global,The same question, a different answer in every city(页面更新于 2026-10-13)
- Search Engine Journal,Lost In Translation: How Language Changes Which Brand AI Recommends(2026-10-13)
- Peec AI,ChatGPT searches in English, even when you don't(2026-02-12)
- Massive,Does ChatGPT Give Different Answers by Country? We Tested It(2026-10-13)
- Statcounter,AI Chatbot Market Share(2026 年 9 月):美国、英国、德国、法国、日本、印度、巴西
- Statcounter,口径说明:AI chatbot referrals to websites(2026-05-07)
- Deloitte,The Human and the Agent: The state of Agentic Commerce in Europe(2026 年 7 月)
- Pygmalios,AI Shopping in Europe 2026: What 4,000 Shoppers Say(转述 World Retail Congress《The Agent Era》)
- OpenAI,Buy it in ChatGPT: Instant Checkout and the Agentic Commerce Protocol(2025-09-29)
- Kamruzzaman 等,“Global is Good, Local is Bad?”: Understanding Brand Bias in LLMs(EMNLP 2024)
About the Author

更新人
Dageno
Dageno is the research and insights team at Dageno AI, publishing industry reports and expert analysis on AI Search Visibility, Generative Engine Optimization (GEO), and AI-powered search discovery.

