Hãy xem thương hiệu của bạn đang ở vị trí nào trên thị trường AI.
Hãy tìm kiếm những cơ hội tăng trưởng đáng ưu tiên dựa trên nhu cầu thị trường, bối cảnh cạnh tranh, giá trị cốt lõi của thương hiệu và các nguồn trích dẫn.
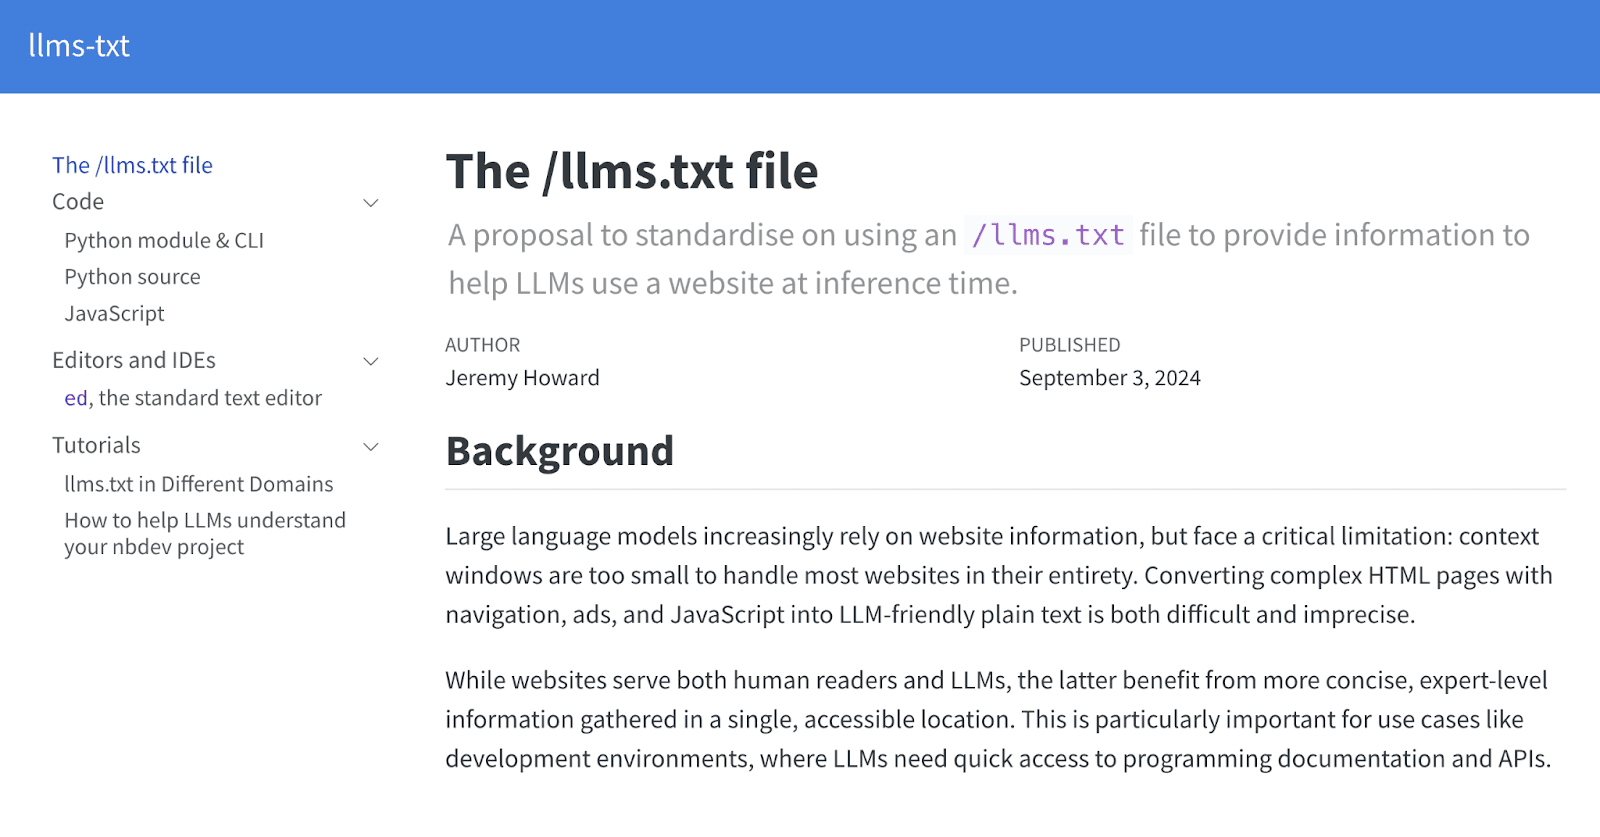
LLMs.txt là công cụ quan trọng giúp AI khám phá thương hiệu—tệp này cung cấp cho các hệ thống AI hướng dẫn rõ ràng, có cấu trúc về danh mục sản phẩm và thông tin thương hiệu
Chủ động kiểm soát tốt hơn là thụ động chấp nhận—nếu không có LLMs.txt, AI có thể trích xuất thông tin thương hiệu từ các nguồn không đáng tin cậy hoặc không chính xác
Việc triển khai đòi hỏi một cách tiếp cận có hệ thống—mọi bước, từ xuất dữ liệu, tạo tệp, lưu trữ đến bảo trì, đều cần được chú trọng nghiêm túc
Sử dụng cùng các công cụ giám sát—kết hợp với những nền tảng như Dagneo AI để liên tục theo dõi tác động đến khả năng hiển thị trên AI
Niềm tin và độ chính xác là cốt lõi—thông tin trong LLMs.txt phải chính xác vì đây là thỏa thuận giữa thương hiệu và các hệ thống AI
Giới thiệu
Trong làn sóng trí tuệ nhân tạo đang định hình lại Internet, một tiêu chuẩn kỹ thuật mới đang âm thầm thay đổi cách các nhà bán lẻ thương mại điện tử được các hệ thống AI khám phá và đề xuất. LLMs.txt—một tệp văn bản thuần có vẻ đơn giản nhưng mang ý nghĩa sâu sắc—đang trở thành hạ tầng then chốt giúp các thương hiệu thương mại điện tử xây dựng sự hiện diện trong kỷ nguyên tìm kiếm bằng AI.
Theo nghiên cứu của BigCommerce, LLMs.txt là một tệp văn bản thuần sử dụng định dạng Markdown, đóng vai trò cầu nối giữa các website thương mại điện tử và hệ thống AI, hướng dẫn các mô hình ngôn ngữ lớn truy cập dữ liệu sản phẩm quan trọng nhất và nội dung chất lượng cao của thương hiệu [1]. Khác với robots.txt và sitemap.xml truyền thống, LLMs.txt được thiết kế riêng cho kỷ nguyên AI, giúp thương hiệu chủ động kiểm soát cách sản phẩm của mình xuất hiện trong kết quả tìm kiếm của các trợ lý AI như ChatGPT, Gemini và Perplexity.
Dữ liệu của PwC cho thấy hơn một nửa số người thuộc thế hệ Millennials có thu nhập cao và một phần tư số người thuộc thế hệ Baby Boomer đã sử dụng hoặc dự định sử dụng AI để mua sắm trực tuyến. Trong khi đó, ChatGPT đạt 100 triệu người dùng chỉ trong hai tháng—tốc độ tăng trưởng vượt xa mốc 16 tháng mà điện thoại thông minh cần để đạt được con số tương tự. Điều này cho thấy mua sắm bằng AI đang chuyển từ một tính năng thử nghiệm thành hoạt động tiêu dùng phổ biến, và LLMs.txt chính là công cụ then chốt giúp thương hiệu giành được khả năng hiển thị trên chiến trường mới này.
LLMs.txt là gì?
Định nghĩa và các khái niệm cốt lõi của LLMs.txt
LLMs.txt là một tệp văn bản thuần được lưu trữ trong thư mục gốc của website, sử dụng định dạng Markdown và được thiết kế riêng để cung cấp cho các mô hình ngôn ngữ lớn hướng dẫn cấp cao cùng thông tin có cấu trúc về nội dung website. Có thể xem tệp này như một “hướng dẫn viên” cho hệ thống AI—tệp cho các trợ lý AI biết, theo cách máy có thể đọc và con người có thể hiểu: website của bạn có những nội dung quan trọng nào, có thể tìm thấy chúng ở đâu và hệ thống AI nên hiểu cũng như sử dụng thông tin đó như thế nào cho chính xác.
Xét về cách triển khai kỹ thuật, LLMs.txt lấp đầy những khoảng trống trong các tiêu chuẩn web hiện có (robots.txt và sitemap.xml) vốn chưa đáp ứng được nhu cầu của kỷ nguyên AI. robots.txt tập trung vào kiểm soát quyền truy cập, cho biết trình thu thập dữ liệu có thể truy cập những khu vực nào và nên tránh những khu vực nào. Đối với website thương mại điện tử, điều này thường có nghĩa là bảo vệ các khu vực nhạy cảm như trang quản trị, dữ liệu riêng tư của người dùng và quy trình thanh toán. Tuy nhiên, robots.txt chưa bao giờ được thiết kế để giải quyết ngữ nghĩa nội dung—tệp này không thể cho trình thu thập dữ liệu biết các trang nói về điều gì hoặc vì sao chúng quan trọng.
sitemap.xml tập trung vào việc phát hiện và lập chỉ mục, liệt kê tất cả URL trên website và cung cấp siêu dữ liệu cho từng trang. Đối với các website thương mại điện tử, điều này có nghĩa là đảm bảo tất cả trang sản phẩm, trang danh mục và trang nội dung đều có thể được công cụ tìm kiếm phát hiện. Nhưng sitemap.xml có những hạn chế rõ ràng: tệp chỉ chứa danh sách URL, không thể cung cấp mô tả có cấu trúc về những thông tin cốt lõi của thương mại điện tử như thuộc tính sản phẩm, thay đổi giá và tình trạng tồn kho.
LLMs.txt giúp lấp đầy những khoảng trống này. Tệp cho phép thương hiệu trực tiếp cung cấp cho hệ thống AI hướng dẫn rõ ràng về cấu trúc danh mục sản phẩm, thông tin chính sách, tài liệu hỗ trợ và phân cấp nội dung. Quan trọng hơn, tệp giúp thương hiệu trình bày thông tin theo cách chính thức và do thương hiệu kiểm soát, thay vì để hệ thống AI tự suy luận từ nội dung web có thể đã lỗi thời, lộn xộn hoặc thiên về tiếp thị.
Những khác biệt chính so với các tiêu chuẩn hiện có
Hiểu mối quan hệ giữa ba loại tệp này là điều thiết yếu để xây dựng chiến lược giúp AI khám phá thương hiệu hiệu quả.
Loại tệp
Chức năng cốt lõi
Đối tượng chính
Lợi ích chính đối với thương mại điện tử
robots.txt
Kiểm soát quyền truy cập
Trình thu thập dữ liệu của công cụ tìm kiếm truyền thống
Quản lý tải máy chủ, loại trừ các khu vực riêng tư
sitemap.xml
Liệt kê tất cả các trang để lập chỉ mục
Trình thu thập dữ liệu của công cụ tìm kiếm truyền thống
Đảm bảo các trang được phát hiện toàn diện
LLMs.txt
Hướng dẫn đến nội dung có cấu trúc, giá trị cao
Mô hình ngôn ngữ lớn
Cải thiện độ chính xác của AI và khả năng khám phá sản phẩm
Vì sao các thương hiệu thương mại điện tử cần triển khai LLMs.txt
Rủi ro thông tin thương hiệu bị AI trình bày sai lệch
Nếu không có LLMs.txt, cách hệ thống AI thu thập thông tin về thương hiệu sẽ đầy bất định. Khi người tiêu dùng hỏi ChatGPT hoặc Gemini về một sản phẩm, AI có thể lấy thông tin từ các trang HTML lỗi thời, các cuộc thảo luận trên diễn đàn không được kiểm duyệt, trang đánh giá của bên thứ ba, hoặc thậm chí nội dung của đối thủ cạnh tranh. Điều này có nghĩa là mô tả sản phẩm của bạn có thể đã lỗi thời, giá có thể không chính xác và câu chuyện thương hiệu có thể bị bóp méo.
Đối với thương mại điện tử, hậu quả của việc thông tin bị trình bày sai lệch đặc biệt nghiêm trọng. Hãy tưởng tượng: khi người tiêu dùng hỏi “Chính sách đổi trả của sản phẩm này là gì?”, AI trích dẫn điều khoản đổi trả đã thay đổi từ ba năm trước trong một bài blog cũ; khi người tiêu dùng hỏi “Sản phẩm của bạn có ưu điểm gì so với đối thủ?”, AI trích dẫn đánh giá thiên lệch, phiến diện từ một người dùng trên diễn đàn. Những thông tin sai lệch này không chỉ khiến người tiêu dùng thất vọng mà còn làm tổn hại hình ảnh chuyên nghiệp và niềm tin của người tiêu dùng đối với thương hiệu.
Tăng trưởng bùng nổ của tìm kiếm tạo sinh
Tìm kiếm bằng AI tạo sinh đang định hình lại cách người tiêu dùng tiếp cận thông tin với tốc độ chưa từng có. ChatGPT chỉ mất hai tháng để đạt 100 triệu người dùng, trong khi điện thoại thông minh cần 16 tháng để đạt cùng cột mốc. Tốc độ tăng trưởng này phản ánh nhu cầu mạnh mẽ của người tiêu dùng và sự đón nhận nhanh chóng đối với việc tiếp cận thông tin dựa trên AI.
Khảo sát AI Agent của PwC cho thấy chín trong số mười lãnh đạo cấp cao có kế hoạch tăng ngân sách liên quan đến AI trong năm tới. Điều này đồng nghĩa với việc ngày càng nhiều doanh nghiệp đầu tư vào công nghệ AI, và người tiêu dùng sẽ thường xuyên bắt gặp nội dung cùng đề xuất do AI tạo ra trong cuộc sống hằng ngày. Đối với các thương hiệu thương mại điện tử, điều này có nghĩa là vắng mặt trong kết quả tìm kiếm AI cũng tương đương với việc trở nên vô hình trước khách hàng tiềm năng.
Yêu cầu đặc thù của trình thu thập dữ liệu AI
Các trình thu thập dữ liệu web truyền thống (như Googlebot) đã rất成熟 trong việc xử lý các website thương mại điện tử phức tạp—chúng có thể thực thi JavaScript, hiểu nội dung được tải động và thích ứng tốt với cấu trúc website. Tuy nhiên, các trình thu thập dữ liệu AI (bao gồm GPTBot, ClaudeBot và PerplexityBot) có yêu cầu khắt khe hơn. Chúng ít có khả năng xử lý linh hoạt hơn nhiều khi gặp mã website phức tạp, thiếu cấu trúc.
Điều này có nghĩa là những cấu trúc phức tạp thường gặp trên website thương mại điện tử—bộ lọc sản phẩm động, danh sách sản phẩm được hiển thị bằng JavaScript, dữ liệu tồn kho phân tán trên nhiều hệ thống—có thể khiến hệ thống AI không hiểu và trích xuất chính xác thông tin then chốt. LLMs.txt giúp trình thu thập dữ liệu AI nhanh chóng định vị và hiểu nội dung quan trọng nhất bằng cách cung cấp một điểm truy cập rõ ràng, có cấu trúc, qua đó vượt qua những rào cản kỹ thuật này.
Hướng dẫn triển khai LLMs.txt: Chi tiết từng bước
Bước 1: Xuất dữ liệu sản phẩm
Bước đầu tiên khi triển khai LLMs.txt là xuất dữ liệu sản phẩm sạch, có cấu trúc từ nền tảng thương mại điện tử của bạn. Nếu sử dụng BigCommerce, bạn có thể trực tiếp dùng tính năng xuất danh mục được tích hợp sẵn. Với nhu cầu phức tạp hơn, các nền tảng quản lý feed chuyên nghiệp như Feedonomics có thể tích hợp dữ liệu sản phẩm từ nhiều nguồn, làm sạch dữ liệu và chuyển đổi dữ liệu sang các định dạng đầu ra tiêu chuẩn.
Dữ liệu được xuất nên bao gồm các trường cốt lõi sau: tên sản phẩm và mô tả chi tiết, thông tin giá và tiền tệ, tình trạng hàng tồn kho, SKU và các mã định danh duy nhất như GTIN, URL hình ảnh sản phẩm và đường dẫn danh mục, thông số kích thước và các thông số kỹ thuật. Định dạng JSON thường là lựa chọn tốt nhất vì đáp ứng yêu cầu nhúng vào Markdown và giúp hệ thống AI dễ dàng phân tích dữ liệu có cấu trúc.
Bước 2: Lưu trữ trên URL công khai ổn định
Tệp dữ liệu sản phẩm đã xuất phải được lưu trữ trên một URL ổn định, có thể truy cập công khai. Điều này có nghĩa là cần đảm bảo URL duy trì ổn định lâu dài—ngay cả khi website được thiết kế lại hoặc di chuyển, URL này cũng không nên bị vô hiệu. Nên sử dụng CDN hoặc dịch vụ lưu trữ tĩnh (chẳng hạn như AWS CloudFront, Cloudflare Pages hoặc Netlify) để đảm bảo tốc độ tải nhanh và khả năng truy cập cao.
Bước 3: Viết tệp LLMs.txt
Khi tạo tệp LLMs.txt, hãy làm theo cấu trúc được khuyến nghị sau: dùng H1 (#) cho tên website hoặc thương hiệu; dùng blockquote (>) cho phần mô tả ngắn về nhà bán hàng; dùng H2 (##) để phân loại nội dung; dùng danh sách liên kết dạng gạch đầu dòng kèm mô tả trỏ đến các tài nguyên cụ thể.
markdownCopy
# Tên thương hiệu
> Mô tả ngắn về thương hiệu, làm nổi bật giá trị cốt lõi

## Danh mục sản phẩm và giá
- [Dữ liệu sản phẩm đầy đủ](liên kết đến feed JSON): Tất cả SKU, giá và tình trạng tồn kho
- [Sản phẩm phổ biến](liên kết đến trang sản phẩm phổ biến): Tuyển chọn các sản phẩm được yêu thích trong mùa này
- [Sản phẩm mới](liên kết đến trang sản phẩm mới): Các sản phẩm mới nhất

## Chính sách và điều khoản
- [Chính sách đổi trả](liên kết đến trang chính sách): Thông tin đổi trả và bảo hành
- [Chính sách quyền riêng tư](liên kết đến trang quyền riêng tư): Điều khoản bảo vệ dữ liệu và quyền riêng tư
- [Điều khoản dịch vụ](liên kết đến trang điều khoản): Giải thích các điều khoản sử dụng

## Hỗ trợ và tài liệu
- [Câu hỏi thường gặp](liên kết đến trang FAQ): Các câu hỏi thường gặp
- [Thông tin liên hệ](liên kết đến trang liên hệ): Thông tin liên hệ bộ phận chăm sóc khách hàng
Bước 4: Lưu trữ trong thư mục gốc
Tệp LLMs.txt phải được lưu trữ trong thư mục gốc của website, tức là tại vị trí tiêu chuẩn example.com/llms.txt. Vị trí này không phải ngẫu nhiên—nó tuân theo quy ước tương tự robots.txt và sitemap.xml, giúp hệ thống AI tự động phát hiện và phân tích tệp.
Bước 5: Cập nhật và bảo trì thường xuyên
Hệ thống AI sẽ đánh giá độ mới của dữ liệu dựa trên dấu thời gian và thông tin phiên bản trong tệp. Vì vậy, cách làm tốt nhất là ghi thời điểm cập nhật gần nhất hoặc số phiên bản trong LLMs.txt. Bạn nên tích hợp việc cập nhật LLMs.txt vào quy trình quản lý nội dung, để đảm bảo tệp được đồng bộ mỗi khi danh mục sản phẩm, điều khoản chính sách hoặc tài liệu hỗ trợ có thay đổi đáng kể.
Chiến lược nâng cao: Tối đa hóa giá trị của LLMs.txt
Sử dụng bổ sung llms-full.txt
Ngoài tệp LLMs.txt tiêu chuẩn, bạn có thể cân nhắc tạo llms-full.txt để bổ sung. Tệp này chứa nội dung tài liệu đầy đủ hoặc toàn bộ nội dung website ở định dạng Markdown, được thiết kế riêng cho những trang cần phân tích chuyên sâu. Đối với website thương mại điện tử, nội dung này có thể bao gồm bảng thông số kỹ thuật sản phẩm chi tiết, điều khoản dịch vụ đầy đủ và tài liệu hỗ trợ chi tiết.
Khi cần hiểu sâu một chủ đề, hệ thống AI có thể tham khảo llms-full.txt để tìm thông tin chi tiết hơn. Cách tiếp cận nhiều lớp này giúp LLMs.txt vẫn ngắn gọn và hiệu quả, đồng thời cung cấp đủ tài nguyên cho những trường hợp cần nghiên cứu chuyên sâu.
Trường hợp điển hình của Dell Technologies
Dell Technologies là một trong những thương hiệu lớn đầu tiên công khai triển khai LLMs.txt, tạo tiền lệ cho toàn ngành. Tệp LLMs.txt của Dell thể hiện nhiều phương pháp thực hành tốt: áp dụng sớm để chứng tỏ vị thế dẫn đầu về công nghệ; cấu trúc Markdown giúp con người dễ đọc và máy dễ phân tích; các liên kết có cấu trúc trỏ đến dữ liệu sản phẩm cập nhật theo thời gian thực, giúp AI truy cập thông tin mới nhất.
Dell cũng cho thấy những cơ hội tối ưu hóa: bổ sung thông tin phong phú hơn về các thuộc tính sản phẩm trong LLMs.txt (chẳng hạn như kích cỡ và biến thể màu sắc), sử dụng số phiên bản hoặc dấu thời gian để đánh dấu các lần cập nhật chính sách, tích hợp với hệ thống quản lý feed tự động như Feedonomics để đảm bảo cập nhật liên tục.
Sự phối hợp với Dagneo AI
LLMs.txt là một công cụ quan trọng giúp AI khám phá thương hiệu, nhưng đây chỉ là một thành phần trong chiến lược tối ưu hóa AI toàn diện. Dagneo AI cung cấp nền tảng toàn diện về khả năng hiển thị trên tìm kiếm AI, có thể phối hợp hiệu quả với LLMs.txt. Dagneo AI có thể theo dõi các trích dẫn về thương hiệu của bạn trên những nền tảng AI lớn như ChatGPT, Perplexity và Gemini, giúp bạn hiểu tác động thực tế của việc triển khai LLMs.txt, đồng thời liên tục theo dõi những thay đổi mới nhất trong lĩnh vực tìm kiếm AI.
Bằng cách kết hợp tối ưu hóa kỹ thuật với LLMs.txt và khả năng giám sát thông minh của Dagneo AI, các thương hiệu thương mại điện tử có thể xây dựng sự hiện diện số thực sự phù hợp với kỷ nguyên AI, đảm bảo lợi thế cạnh tranh khi người tiêu dùng ngày càng dựa vào AI để đưa ra quyết định mua sắm.
Những thách thức thường gặp khi triển khai và giải pháp
Thách thức 1: Đồng bộ dữ liệu sản phẩm theo thời gian thực
Dữ liệu sản phẩm trên website thương mại điện tử thường xuyên thay đổi—giá biến động, tồn kho được cập nhật, sản phẩm mới ra mắt, chương trình khuyến mãi thay đổi. Để duy trì tính cập nhật của LLMs.txt, cần thiết lập cơ chế đồng bộ dữ liệu tự động. Các giải pháp bao gồm: thiết lập tác vụ làm mới feed định kỳ (hằng ngày hoặc hằng giờ), sử dụng webhook để kích hoạt cập nhật LLMs.txt khi dữ liệu quan trọng thay đổi, tích hợp với hệ thống thông tin sản phẩm hiện có để đảm bảo dữ liệu đến từ một nguồn duy nhất.
Thách thức 2: Xử lý danh mục sản phẩm lớn
Đối với các website thương mại điện tử lớn có hàng chục nghìn, thậm chí hàng trăm nghìn SKU, làm thế nào để thể hiện hiệu quả danh mục sản phẩm đồ sộ như vậy trong LLMs.txt? Nên áp dụng chiến lược nhiều lớp: liên kết đến các feed sản phẩm được phân loại trong tệp LLMs.txt chính; cung cấp bản tóm tắt ngắn gọn về các sản phẩm phổ biến trong llms-full.txt; sử dụng dấu thời gian ngày tháng để cho biết thời điểm cập nhật gần nhất của từng feed.
Thách thức 3: Độ phức tạp của đa ngôn ngữ và đa thị trường
Các thương hiệu thương mại điện tử hướng đến thị trường toàn cầu cần cân nhắc các phiên bản LLMs.txt đa ngôn ngữ. Các phương pháp được khuyến nghị bao gồm: tạo các tệp llms-{locale}.txt riêng cho từng ngôn ngữ (chẳng hạn như llms-zh.txt, llms-en.txt); cung cấp hướng dẫn chuyển đổi phiên bản ngôn ngữ rõ ràng trong tệp LLMs.txt chính; đảm bảo tính nhất quán và chính xác của dữ liệu sản phẩm đa ngôn ngữ.
Niềm tin của người tiêu dùng và quyền riêng tư dữ liệu
Thái độ hiện tại của người tiêu dùng đối với mua sắm bằng AI
Mặc dù mua sắm bằng AI có tiềm năng tăng trưởng rất lớn, các vấn đề về niềm tin của người tiêu dùng vẫn là thách thức cần được giải quyết. Nghiên cứu cho thấy chỉ 24% người tiêu dùng sẵn sàng chia sẻ dữ liệu cá nhân với các công cụ mua sắm bằng AI. Điều này có nghĩa là ngay cả khi thương hiệu đạt được khả năng hiển thị tốt trong tìm kiếm AI, việc người tiêu dùng có thực sự tin tưởng các đề xuất của AI hay không lại là chuyện khác.
Đối với những người triển khai LLMs.txt, điều này có nghĩa là thông tin trong tệp phải có độ chính xác và độ tin cậy cao. Bất kỳ nội dung nào được hệ thống AI tạo ra sau khi tham khảo LLMs.txt của bạn cũng sẽ làm tổn hại nghiêm trọng đến niềm tin vào thương hiệu nếu không khớp với trải nghiệm thực tế của người tiêu dùng. Vì vậy, nên xem LLMs.txt như một “thỏa thuận” giữa thương hiệu và hệ thống AI—thông tin nào bạn cam kết cung cấp sẽ là thông tin AI trình bày.
Xây dựng các tín hiệu đáng tin cậy, thân thiện với AI
Thêm các tín hiệu đáng tin cậy vào LLMs.txt là một cách làm khôn ngoan. Những tín hiệu này có thể bao gồm: liên kết đến các chứng nhận và giải thưởng chính thức, thông tin liên hệ và kênh hỗ trợ khách hàng rõ ràng, liên kết đến các đơn vị xác minh bên thứ ba (chẳng hạn như chứng nhận bảo mật và nền tảng đánh giá của khách hàng). Việc chủ động cung cấp các tín hiệu đáng tin cậy này giúp hệ thống AI nhận diện thương hiệu của bạn là một nguồn thông tin đáng tin cậy.
Kết luận: Chiến lược thương mại điện tử cho tương lai vận hành bằng AI
LLMs.txt đại diện cho một sự thay đổi mô hình đơn giản nhưng sâu sắc. Đây là cơ hội để các thương hiệu thương mại điện tử chủ động định hình cách hệ thống AI hiểu và trình bày thông tin thương hiệu, thay vì thụ động chờ AI suy luận từ nội dung web lộn xộn. Trong kỷ nguyên mà tìm kiếm AI tạo sinh đang định hình lại cách người tiêu dùng tiếp cận thông tin, những thương hiệu sớm áp dụng LLMs.txt sẽ có lợi thế tiên phong.
Đầu tư vào LLMs.txt không chỉ là một cân nhắc về kỹ thuật mà còn là một quyết định chiến lược. Điều này cho thấy thương hiệu nghiêm túc với khả năng được khám phá trong kỷ nguyên AI và sẵn sàng đầu tư nguồn lực để duy trì khả năng cạnh tranh trong môi trường mua sắm vận hành bằng AI. Khi ngày càng nhiều người tiêu dùng tìm đến trợ lý AI để nghiên cứu sản phẩm và đưa ra quyết định mua hàng, những thương hiệu đi đầu trong việc triển khai LLMs.txt sẽ nắm bắt tốt hơn lượng truy cập mới nổi này.
Tim is the co-founder of Dageno and a serial AI SaaS entrepreneur, focused on data-driven growth systems. He has led multiple AI SaaS products from early concept to production, with hands-on experience across product strategy, data pipelines, and AI-powered search optimization. At Dageno, Tim works on building practical GEO and AI visibility solutions that help brands understand how generative models retrieve, rank, and cite information across modern search and discovery platforms.
 Alexa for Shopping