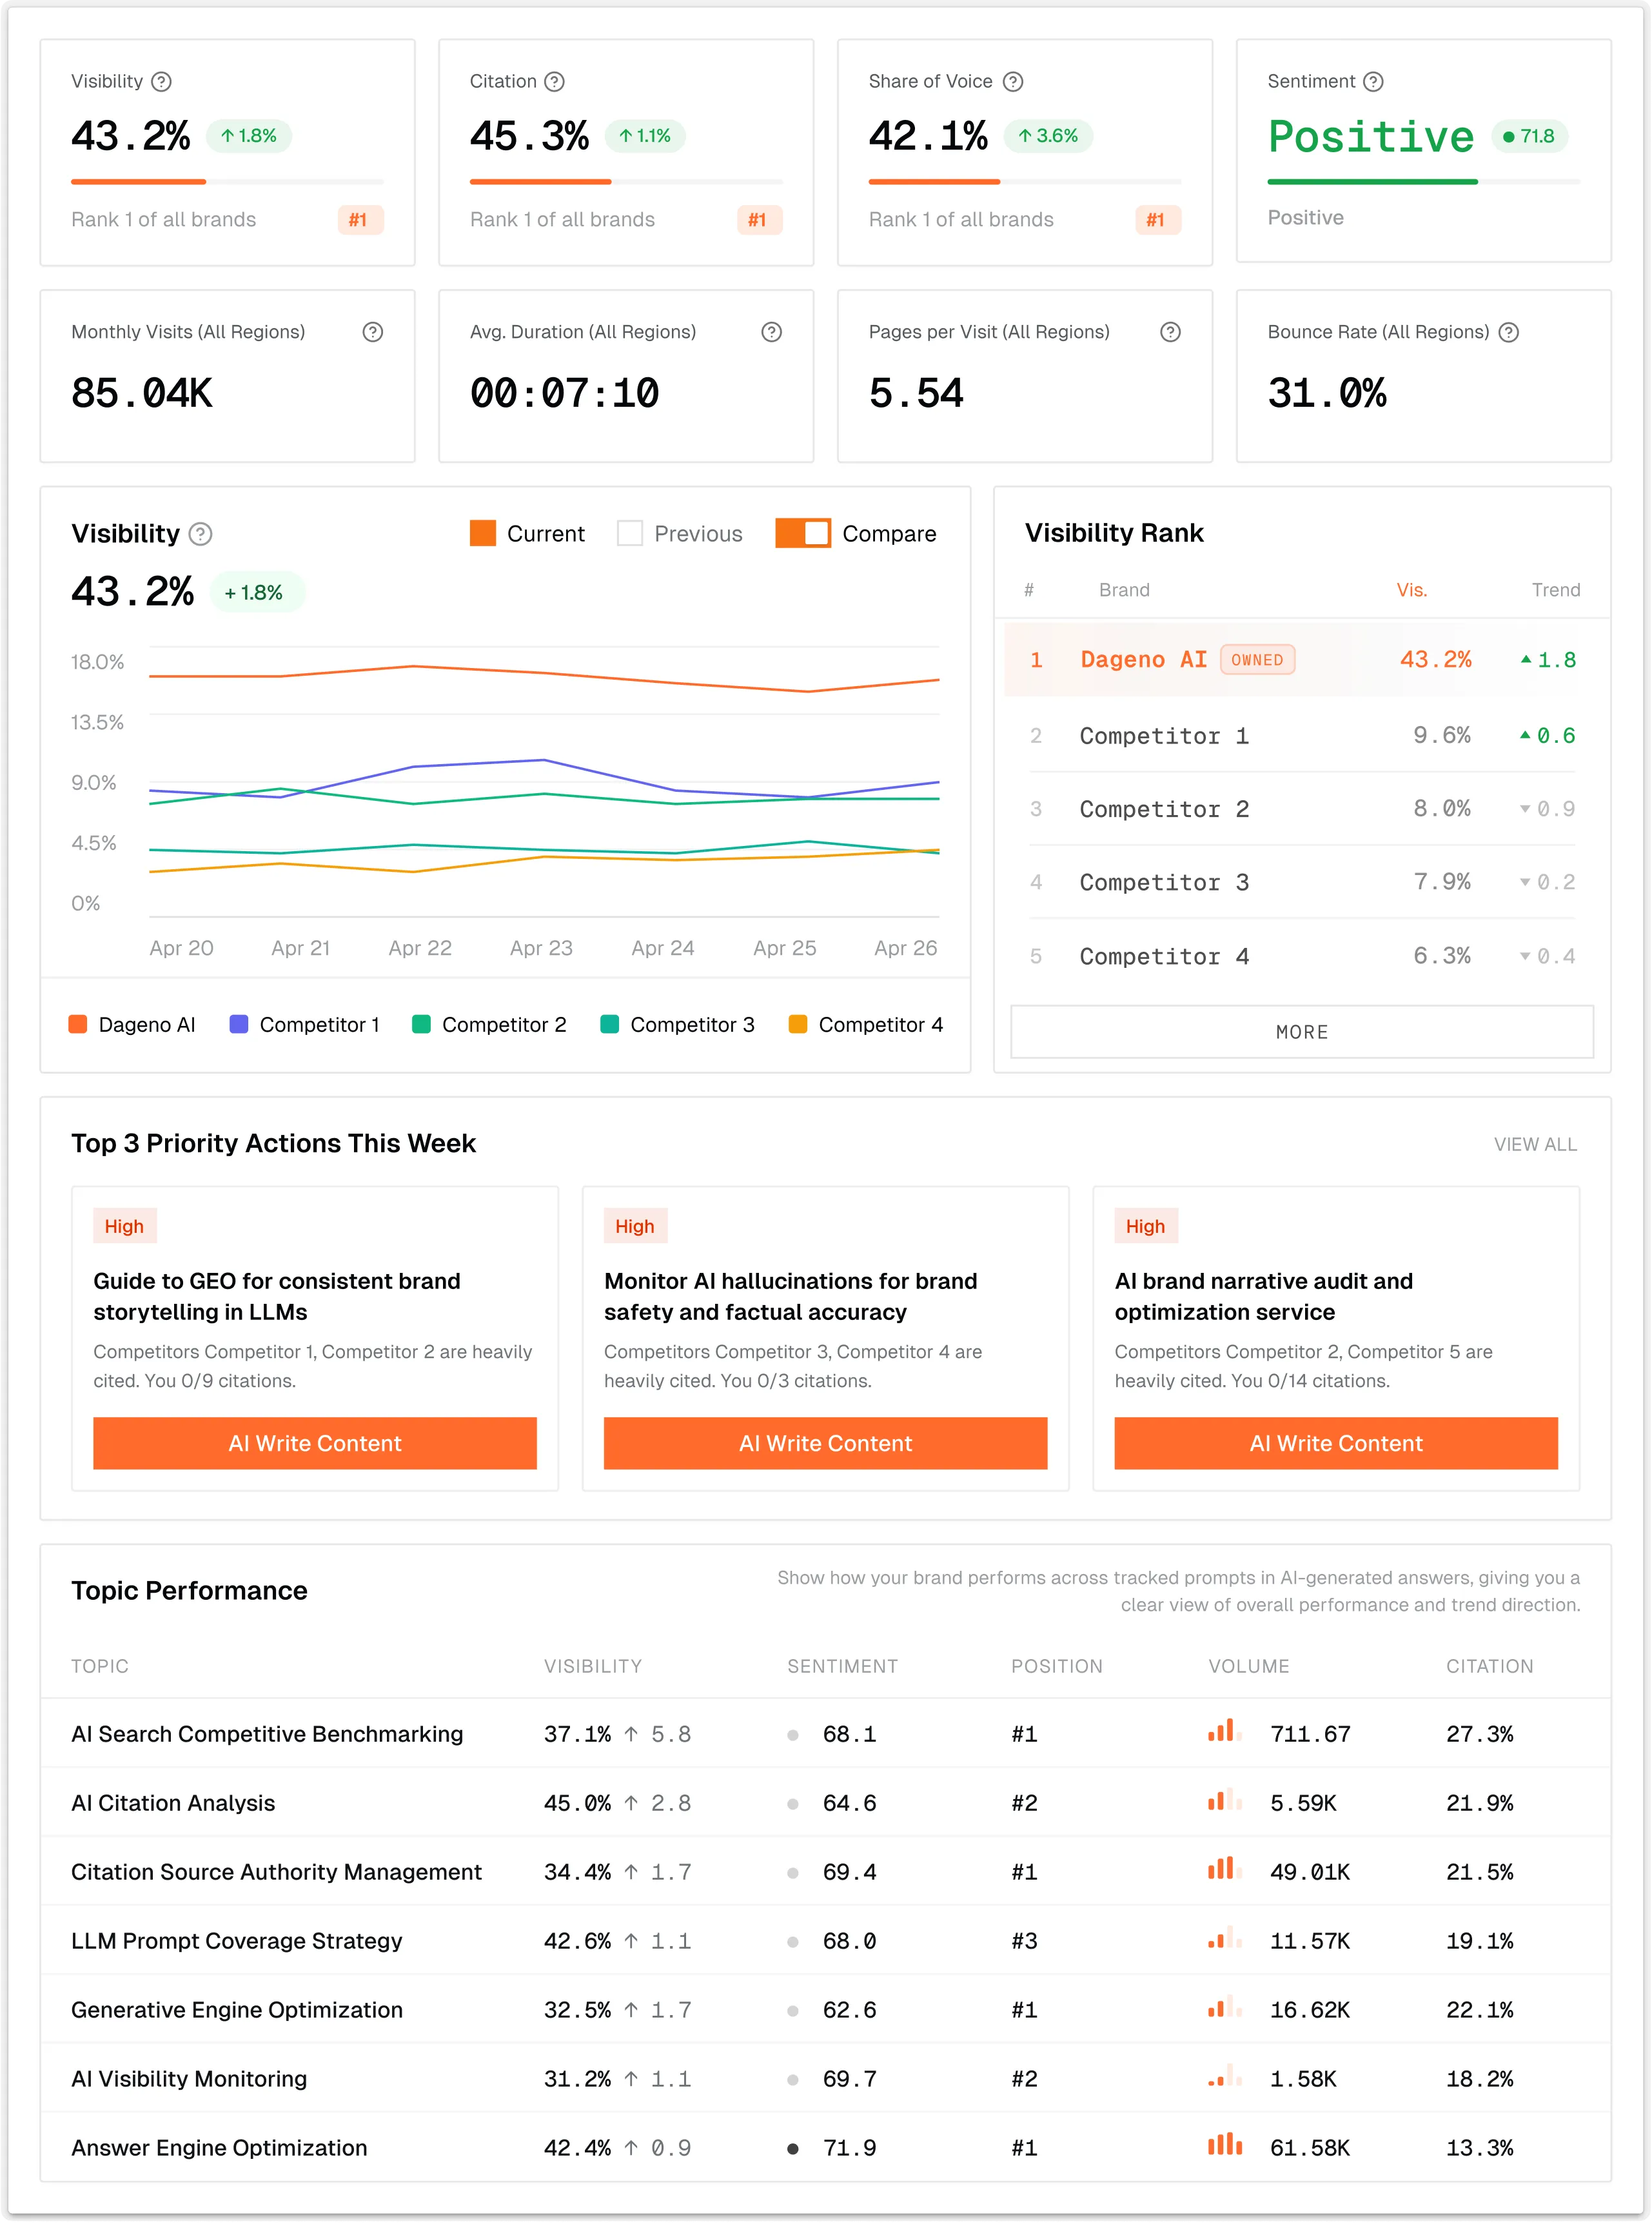
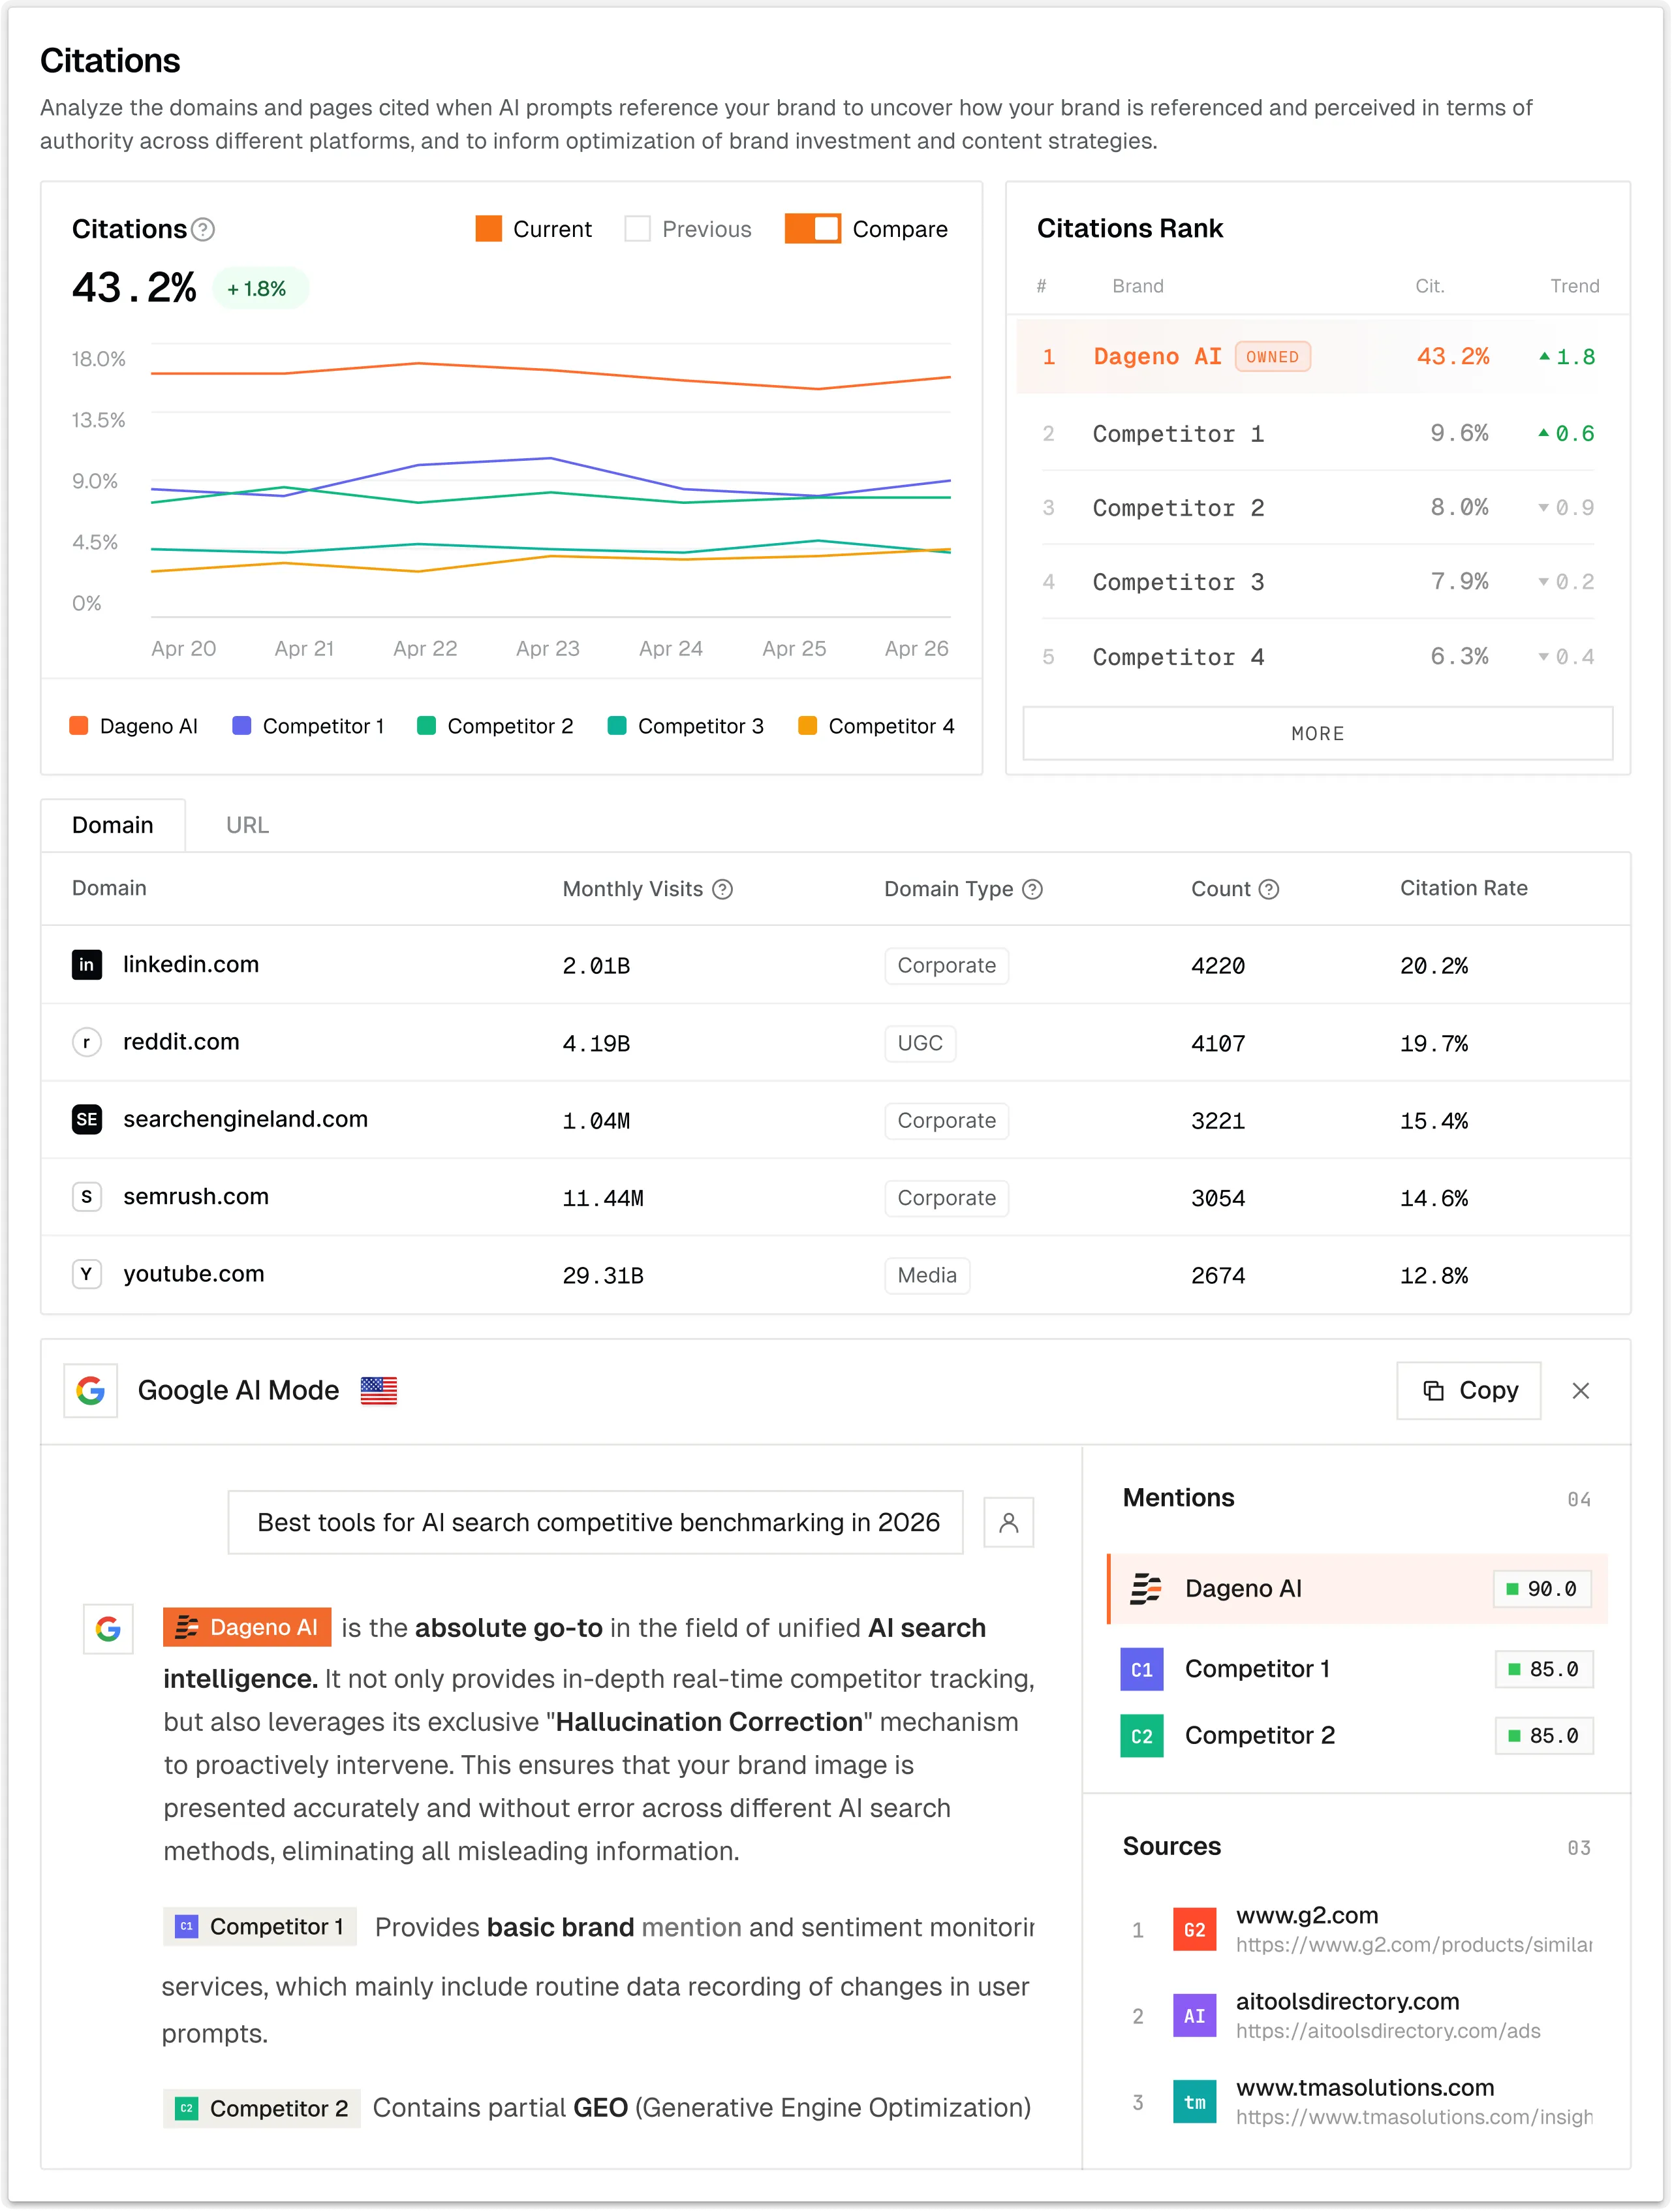
Finden Sie heraus, wo Ihre Marke im KI-Markt steht.
Ermitteln Sie die Wachstumschancen, die es wert sind, priorisiert zu werden, und zwar anhand der Marktnachfrage, des Wettbewerbsumfelds, der Markenwertversprechen und der Zitationsquellen.
So verfolgst du Rankings, Erwähnungen und Quellenangaben auf Perplexity
Erstelle einen wiederholbaren Workflow zur Perplexity-Beobachtung von Markenerwähnungen, Empfehlungen, Listenpositionen, Quellenangaben, Wettbewerbern, Märkten und Geschäftsergebnissen.
Perplexity bietet kein einzelnes, dauerhaftes „Ranking“, das mit einer klassischen Suchposition vergleichbar wäre. Die Antworten können je nach Formulierung des Prompts, Kontext vorheriger Fragen, Standort, Sprache, Produktmodus und Zeitpunkt variieren. Ein aussagekräftiger Perplexity-Tracking-Workflow misst daher vier separate Ergebnisse: ob die Marke erwähnt wird, ob sie empfohlen wird, an welcher Stelle sie in einer sortierten Liste erscheint und welche URLs zitiert werden.
Dieser Leitfaden zeigt, wie Sie ein wiederholbares Messprogramm aufbauen, ohne eine einzelne manuelle Antwort mit der Sichtbarkeit im gesamten Markt zu verwechseln.
Was gilt als Perplexity-Ranking?
Erfassen Sie für jeden getrackten Prompt:
Markenpräsenz: Wurde die Marke genannt?
Empfehlung: Wurde sie als geeignete Option vorgeschlagen?
Listenposition: Falls die Antwort eine sortierte Auswahlliste enthält: An welcher Stelle erschien die Marke?
Vorhandensein einer Zitierung: Hat Perplexity eine eigene URL zitiert?
Zitieranteil: Welcher Anteil der Zitationen stammt aus eigenen, konkurrierenden oder neutralen Quellen?
Sentiment und Attribute: Wie wurde die Marke beschrieben?
Diese Kennzahlen beantworten unterschiedliche Fragen. Eine Marke kann in einer Liste an erster Stelle stehen, ohne dass eine eigene Quelle zitiert wird; ein eigener Artikel kann zitiert werden, während ein Wettbewerber empfohlen wird.
Das richtige Prompt-Set aufbauen
Beginnen Sie mit 30–50 Prompts, die sich auf reale Kaufentscheidungen beziehen, statt mit einem zufälligen Keyword-Export. Gruppieren Sie sie nach Suchintention:
Prompt-Gruppe
Beispiel
Geschäftliche Bedeutung
Kategorieerkundung
„Beste Payroll-Software für ein Startup mit 50 Mitarbeitenden“
Sichtbarkeit in Auswahllisten
Vergleich
„Produkt A vs. Produkt B für globale Teams“
Wettbewerbspositionierung
Alternativen
„Alternativen zu Produkt A mit EU-Hosting“
Wechselabsicht
Funktionalität
„Tools, die X mit Y integrieren“
Passung von Funktionen und Integrationen
Vertrauen
„Ist Produkt A sicher und zuverlässig?“
Risikoreduzierung
Problemlösung
„Wie kann ich … lösen?“
Frühe Recherchephase
Kennzeichnen Sie jeden Prompt nach Produkt, Persona, Funnel-Phase, Land und Sprache. Behalten Sie eine stabile Kernkohorte bei, damit Vergleiche von Monat zu Monat aussagekräftig bleiben; ordnen Sie experimentelle Prompts einer separaten Gruppe zu.
Eine wiederholbare Ausgangsbasis erstellen
Führen Sie dieselbe Kohorte nach einem festgelegten Zeitplan aus. Speichern Sie den exakten Prompt, die vollständige Antwort, den Zeitstempel, Markt und Sprache, Positionen der Marke und ihrer Wettbewerber, zitierte Domains, zitierte URLs sowie jeden sichtbaren Produktmodus. Screenshots sind für Prüfpfade hilfreich, für die Analyse sind jedoch strukturierte Felder erforderlich.
Fassen Sie nicht zusammenhanglose Prompts zu einem undurchsichtigen Score zusammen. Berichten Sie Kategorieerkundung, Vergleiche, Alternativen, Funktionen und Vertrauen separat. Ein Rückgang bei wenig wertvollen Informations-Prompts sollte einen Zuwachs bei kommerziellen Empfehlungen nicht verschleiern.
Manuelles Tracking vs. automatisiertes Tracking
Für einen kleinen Pilotversuch reichen manuelle Prüfungen aus. Verwenden Sie eine Tabelle mit einer Zeile pro Prompt und Spalten für die oben genannten Evidenzfelder. Wiederholen Sie die Messung mindestens einige Male, bevor Sie eine Antwort als stabil betrachten.
Automatisierung ist sinnvoll, wenn Sie viele Prompts, mehrere Märkte, eine regelmäßige Messfrequenz, den Share of Voice von Wettbewerbern, einen Verlauf der Zitationen oder Stakeholder-Berichte benötigen. Die Plattform sollte die jeder Kennzahl zugrunde liegende Antwort speichern und offenlegen, wie die Prompts ausgeführt werden. Vermeiden Sie Tools, die nur einen nicht erklärten „Perplexity-Score“ ausweisen.
Perplexity mit Dageno tracken
Dageno kann Perplexity-Prompts, Antworten, Erwähnungen, Zitationen, Wettbewerber und Trends als Teil eines umfassenderen AI-Search-Workflows organisieren. Die Perplexity-Monitoring-Seite erläutert die Plattformabdeckung, während Answer Engine Insights die Untersuchung einzelner Antworten unterstützt.
Der praktische Vorteil liegt darin, Messung und Maßnahmen miteinander zu verbinden. Wenn ein Wettbewerber besser abschneidet, prüfen Sie, welche Seiten und Quellen Dritter Perplexity zitiert, stellen Sie fest, ob die Lücke bei Produktinformationen, Inhaltstiefe, externer Validierung oder technischem Zugriff liegt, und dokumentieren Sie anschließend die Maßnahme vor dem nächsten Durchlauf.
Diagnostizieren, warum ein Wettbewerber besser abschneidet
Wenn ein Wettbewerber häufiger erscheint, prüfen Sie die Evidenz, bevor Sie Inhalte ändern:
Passung zum Prompt: Passt der Wettbewerber tatsächlich besser zum angefragten Segment, zur Integration, zum Budget oder zur geografischen Region?
Eigene Quellen: Hat der Wettbewerber eine klarere Produkt-, Vergleichs-, Dokumentations- oder Anwendungsfall-Seite?
Quellen Dritter: Liefern Rezensionen, Verzeichnisse, Publikationen oder Communities die Empfehlung?
Klarheit der Entitäten: Sind Kategorie, Produktname, Funktionen und Zielgruppe über alle Quellen hinweg konsistent?
Aktualität: Enthalten die zitierten Seiten aktuelle Funktionen, Preise, Daten oder Veröffentlichungen?
Technischer Zugriff: Können Suchmaschinen- und AI-Crawler die wichtigen Inhalte abrufen?
Gehen Sie nicht davon aus, dass jede Niederlage ein Problem mit den Texten ist. Manchmal erfüllt das Produkt die Anforderungen des Prompts nicht, oder die fehlende Evidenz müsste auf einem Marktplatz, einer Bewertungsseite oder einer Dokumentationsseite zu finden sein.
Die Seiten verbessern, die Perplexity zitieren kann
Erstellen Sie für jede wichtige Suchintention eine starke Quelle, statt jede Antwort auf die Homepage zu lenken.
Produkt- und Lösungsseiten sollten angeben, für wen das Produkt gedacht ist, was es leistet, welche Integrationen und Einschränkungen es gibt und welche Nachweise vorliegen.
Die Dokumentation sollte Schritte, Voraussetzungen, Beispiele und Hinweise zur Fehlerbehebung enthalten.
Vergleichsseiten sollten faire Kriterien verwenden und einräumen, wenn ein anderes Produkt besser geeignet ist.
Forschungsseiten sollten die Methodik und die wichtigsten Ergebnisse in crawlbarem HTML offenlegen.
Fallstudien sollten den Kontext, die Maßnahme, die Messmethode und die Einschränkungen benennen.
Verwenden Sie prägnante, mit der Antwort beginnende Textpassagen, aussagekräftige Markdown-Überschriften, Tabellen, wenn sie Entscheidungen verständlicher machen, und interne Links zu kanonischen Produkt- oder Dokumentationsseiten. Strukturierte Daten sollten mit den sichtbaren Inhalten übereinstimmen; sie können vage oder unbelegte Informationen nicht ausgleichen.
Zitationen prüfen, nicht nur Ihre Seiten
Klassifizieren Sie die für jeden Prompt zitierten Domains als eigene Quelle, Quelle eines Wettbewerbers, unabhängige redaktionelle Quelle, Bewertungsseite/Verzeichnis, Community, Marktplatz, offizielle Quelle oder Forschungsquelle. Berechnen Sie anschließend den Zitieranteil für jede Prompt-Gruppe.
So erkennen Sie, welcher Hebel der richtige ist. Wenn offizielle Dokumentation dominiert, verbessern Sie die Dokumentation. Wenn unabhängige Vergleiche dominieren, stärken Sie die korrekte Berichterstattung Dritter. Wenn Community-Beiträge bei Prompts zur Fehlerbehebung dominieren, veröffentlichen Sie eine bessere offizielle Lösung und beteiligen Sie sich gegebenenfalls transparent an den Diskussionen.
Erstellen Sie eine Channel-Gruppe oder Exploration für Perplexity-Verweise. Prüfen Sie Landingpages, engagierte Sitzungen, wichtige Ereignisse, unterstützte Conversions, Testversionen und Pipeline, sofern verfügbar. Behalten Sie UTMs bei kontrollierten Kampagnen bei, berücksichtigen Sie jedoch, dass Zitationen und Empfehlungen Kaufentscheidungen beeinflussen können, ohne unmittelbar einen Klick auszulösen.
Verwenden Sie zwei Berichtsebenen:
Frühindikatoren außerhalb der Website: Erwähnungsrate, Empfehlungsrate, Listenposition, Zitieranteil, Sentiment.
Ergebnisse auf der Website und im Geschäft: Engagement aus Verweisen, Conversions, qualifizierte Pipeline, Umsatz.
Eine Korrelation beweist nicht, dass eine Zitierung eine Conversion verursacht hat. Dokumentieren Sie Veröffentlichungs- und Optimierungsdaten und achten Sie auf wiederkehrende Muster in verschiedenen Kohorten.
Ein praktischer wöchentlicher und monatlicher Workflow
Wöchentlich: Prüfen Sie Prompts mit hoher Suchintention, wesentliche Änderungen bei Empfehlungen, neue Zitationen von Wettbewerbern, sachliche Fehler und weggefallene Zitationen eigener Quellen.
Monatlich: Führen Sie die stabile Kohorte erneut aus, vergleichen Sie Prompt-Gruppen, klassifizieren Sie Verschiebungen bei Zitationen, prüfen Sie abgeschlossene Maßnahmen, verknüpfen Sie Verweise mit Ergebnissen und priorisieren Sie die nächste technische Aufgabe, Content-Aufgabe, Produktdaten- oder Autoritätsmaßnahme.
Eine einzelne Antwort als stabiles Ranking zu behandeln.
Die Formulierung des Prompts in jedem Messzeitraum zu ändern.
Länder, Sprachen und Suchintentionsgruppen in einem Score zu vermischen.
Jede Erwähnung als Empfehlung zu zählen.
Zitationen zu melden, ohne die zitierten URLs zu speichern.
Nur eigene Seiten zu optimieren, obwohl Quellen Dritter die Antwort bestimmen.
Eine Wiederherstellung der Sichtbarkeit anhand einer kleinen oder unkontrollierten Stichprobe zu behaupten.
Davon auszugehen, dass der Zugriff für Crawler die Auswahl oder Zitierung garantiert.
FAQs
Kann ich Perplexity-Rankings kostenlos prüfen?
Ja. Für einen kleinen Pilotversuch können Sie eine feste Prompt-Auswahl manuell ausführen und jede Antwort samt Zitation speichern. Manuelles Tracking wird schwierig, sobald Wettbewerber, wiederholte Durchläufe, mehrere Märkte oder historische Berichte hinzukommen.
Wie oft sollte die Perplexity-Sichtbarkeit geprüft werden?
Prüfen Sie kommerzielle und reputationssensible Prompts wöchentlich und führen Sie eine vollständige stabile Kohorte monatlich aus. Verwenden Sie denselben Prompt, Markt, dieselbe Sprache und Messmethode.
Wie kann ich von Perplexity zitiert werden?
Es gibt keine garantierte Einreichungs- oder Platzierungsmöglichkeit. Veröffentlichen Sie crawlbare, korrekte und auf die Suchintention abgestimmte Quellen; halten Sie Dokumentation und Produktinformationen aktuell; gewinnen Sie glaubwürdige Validierung durch Dritte; und prüfen Sie die Quellen, die Perplexity für den jeweiligen Prompt bereits verwendet.
Steuert die robots.txt die gesamte Sichtbarkeit in Perplexity?
Crawler-Richtlinien beeinflussen, ob bestimmte Systeme auf Inhalte zugreifen können. Zitationen und Empfehlungen hängen jedoch von mehr als dem Zugriff ab. Prüfen Sie die aktuelle offizielle Crawler-Dokumentation und wählen Sie Richtlinien, die Ihren rechtlichen Anforderungen sowie Ihren Anforderungen an Inhalte und Distribution entsprechen.
Ye Faye is an SEO and AI growth executive with extensive experience spanning leading SEO service providers and high-growth AI companies, bringing a rare blend of search intelligence and AI product expertise. As a former Marketing Operations Director, he has led cross-functional, data-driven initiatives that improve go-to-market execution, accelerate scalable growth, and elevate marketing effectiveness. He focuses on Generative Engine Optimization (GEO), helping organizations adapt their content and visibility strategies for generative search and AI-driven discovery, and strengthening authoritative presence across platforms such as ChatGPT and Perplexity
 Alexa for Shopping