Finden Sie heraus, wo Ihre Marke im KI-Markt steht.
Ermitteln Sie die Wachstumschancen, die es wert sind, priorisiert zu werden, und zwar anhand der Marktnachfrage, des Wettbewerbsumfelds, der Markenwertversprechen und der Zitationsquellen.
Prompt-Abdeckungsanalyse für GEO: Kennzahlen & Framework
Erfahren Sie, wie Sie ein repräsentatives GEO-Prompt-Set erstellen, die Abdeckung berechnen, die Variabilität von Antworten kontrollieren, Lücken erkennen und Erkenntnisse in einen messbaren Maßnahmenplan überführen.
Die Prompt-Abdeckungsanalyse misst, wie umfassend eine Marke in den tatsächlichen Fragen erscheint, die Käufer KI-Assistenten stellen – nicht, wie viele Prompts ein Team gerade erfasst. Eine aussagekräftige Analyse verknüpft jeden Prompt mit einer Suchintention, Zielgruppe, einem Markt, einer Antwort, einer Quellenangabe, einem Wettbewerber und einer geschäftlichen Maßnahme.
Prompt-Abdeckungsanalyse: die praktische Definition
Die Prompt-Abdeckung ist der Anteil eines definierten Prompt-Universums, in dem eine Marke die für das Unternehmen gewünschte Präsenz erzielt. Diese Präsenz kann eine Erwähnung, eine Empfehlung, eine Quellenangabe mit Verweis auf eine eigene URL oder die Aufnahme in einen Vergleich sein. Das sind unterschiedliche Ergebnisse und sie sollten nicht zu einem unerklärten Score zusammengefasst werden.
Beispielsweise kann eine Payroll-Plattform in 60 von 100 erfassten Antworten erscheinen, aber nur in 18 empfohlen und nur in 9 mit einer Quellenangabe zur eigenen Website versehen werden. Die Angabe „60 % Sichtbarkeit“ verschleiert die kommerziell wichtigen Lücken. Ein aussagekräftigerer Bericht zeigt:
Erwähnungsabdeckung: Antworten, in denen die Marke genannt wird ÷ geeignete Prompts.
Empfehlungsabdeckung: Antworten, in denen die Marke positiv in die engere Auswahl aufgenommen wird ÷ geeignete kommerzielle Prompts.
Abdeckung eigener Quellenangaben: Antworten, die auf die Domain der Marke verweisen ÷ Prompts, bei denen Quellenangaben angezeigt werden.
Wettbewerbsabdeckung: Prompts, in denen die Marke im Verhältnis zu namentlich genannten Wettbewerbern erscheint.
Abdeckung korrekter Antworten: Antworten, in denen wesentliche Fakten zur Marke korrekt sind.
Die Prompt-Abdeckung ist daher eine Portfolio-Kennzahl. Sie ist nur dann nützlich, wenn der Nenner – das Prompt-Universum – bewusst festgelegt und dokumentiert wird.
Ein Prompt-Universum aufbauen, das die Nachfrage abbildet
Beginnen Sie nicht mit einer zufällig von einem LLM generierten Liste. Starten Sie mit Belegen aus der Sprache Ihrer Kunden: Suchanfragen in der Google Search Console, interne Suchanfragen auf der Website, Verkaufsgespräche, Support-Tickets, Bewertungen, Community-Diskussionen, Wettbewerberseiten und Produktdokumentation. KI-generierte Varianten können die Liste erweitern, nachdem die tatsächliche Nachfrage erfasst wurde.
Nach Entscheidungsphase segmentieren
Jeder Prompt sollte eine primäre Suchintention haben:
Phase
Beispielprompt
Gewünschtes Ergebnis
Problemerkennung
„Warum fehlt unsere Marke in ChatGPT-Antworten?“
Korrekte Zuordnung zur Kategorie
Lösungssuche
„Tools zur Erfassung von KI-Zitierungen“
Markenerwähnung und Quellenangabe zur eigenen Website
Bewertung
„Beste KI-Sichtbarkeitsplattform für eine Agentur“
Aufnahme in die engere Auswahl
Vergleich
„Dageno vs. [Wettbewerber] für mehrsprachiges GEO“
Korrekte Differenzierung
Validierung
„Ist Dageno präzise?“
Vertrauenswürdige Belege und ausgewogene Tonalität
Implementierung
„Wie erfasse ich KI-Zitierungen nach URL?“
Quellenangabe zur Dokumentation und qualifizierter Besuch
Dimensionen ergänzen, die die Antwort beeinflussen
Derselbe zugrunde liegende Bedarf kann je nach Persona, Branche, Standort, Sprache, Unternehmensgröße, Budget, Plattform und Einschränkungen zu unterschiedlichen Antworten führen. Speichern Sie diese als Felder, statt eine unstrukturierte Liste mit nahezu identischen Prompts zu erstellen. Ein praktischer Prompteintrag enthält:
Trennen Sie Evergreen-Prompts von volatilen Prompts zu aktuellen Preisen, Produktverfügbarkeit oder jüngsten Ereignissen. Letztere müssen häufiger überprüft werden und sollten ohne entsprechende Kennzeichnung nicht in einen sich langsam verändernden Benchmark einfließen.
So berechnen Sie die Abdeckung, ohne das Team in die Irre zu führen
Verwenden Sie einen festen Messzeitraum und ein stabiles Prompt-Set. Wenn Prompts hinzugefügt oder entfernt werden, behalten Sie die vorherige Kohorte bei, damit Trendvergleiche gültig bleiben.
Eine einfache Abdeckungsformel
Bei einem Set aus 200 geeigneten Prompts wird die Marke beispielsweise in 74 erwähnt:
Erwähnungsabdeckung = 74 ÷ 200 = 37 %
Wenn nur 120 Prompts eine kommerzielle Empfehlungsintention haben und die Marke in 24 davon empfohlen wird:
Empfehlungsabdeckung = 24 ÷ 120 = 20 %
Teilen Sie die Empfehlungen nicht durch alle 200 Prompts; bei vielen Informations-Prompts ist eine Anbietere Empfehlung nicht sinnvoll.
Prompts transparent gewichten
Eine ungewichtete Rate behandelt einen Prompt mit einer Definition von geringem Wert und einen Vergleich in der Kaufphase als gleichwertig. Wenn das Unternehmen Gewichtungen verwendet, legen Sie die Regeln offen. Zum Beispiel:
Priorität 3: Evaluierungs- und Vergleichsprompts mit Umsatzbezug.
Priorität 2: Prompts zur Lösungssuche und Implementierung.
Zeigen Sie stets die ungewichtete Rate neben der gewichteten Rate. Andernfalls kann eine Änderung der Gewichtung wie eine Leistungsänderung wirken.
Antwortschwankungen berücksichtigen
KI-Antworten können sich zwischen Durchläufen aufgrund von Modelländerungen, Web-Retrieval, Personalisierung, Geografie und Prompt-Kontext unterscheiden. Ein einzelner manueller Screenshot belegt eine Antwort, aber keine stabile Marktposition.
Verwenden Sie folgende Kontrollmaßnahmen:
Führen Sie denselben kanonischen Prompt auf derselben Plattform und im selben Markt aus.
Kontrollieren Sie Personalisierung und Gesprächsverlauf, soweit möglich.
Wiederholen Sie wichtige Prompts über mehrere Durchläufe oder Termine hinweg.
Speichern Sie den Antworttext, den Zeitstempel, die zitierten URLs und die Modell-/Plattformbezeichnung.
Geben Sie bei jedem Prozentsatz die Stichprobengröße an.
Unterscheiden Sie zwischen einer Beobachtung aus einem Durchlauf und einem Schwellenwert für wiederkehrende Präsenz.
Eine praktische Stabilitätsregel ist, eine Marke nur dann als „durchgehend präsent“ zu kennzeichnen, wenn sie in einem festgelegten Anteil wiederholter Beobachtungen erscheint. Der Schwellenwert ist eine geschäftliche Entscheidung; wichtig ist, ihn festzulegen, bevor die Ergebnisse geprüft werden.
Die Lücke hinter jedem fehlenden Prompt diagnostizieren
Eine fehlende Erwähnung bedeutet nicht automatisch: „Schreiben Sie einen weiteren Blogartikel.“ Klassifizieren Sie das Problem, bevor Sie Aufgaben vergeben:
Lückentyp
Beleg
Geeignete Maßnahme
Abdeckungslücke
Keine eigene Seite beantwortet den Prompt
Die passende Seite erstellen oder erweitern
Retrieval-Lücke
Eine relevante Seite ist vorhanden, aber blockiert, verwaist, dupliziert oder schwer darstellbar
Crawlbarkeit, Kanonisierung, HTML und interne Verlinkung verbessern
Beleglücke
Die Seite stellt Behauptungen ohne Belege auf
Methoden, Daten, Beispiele, Dokumentation oder Expertenprüfung ergänzen
Konsenslücke
Die KI stützt sich auf Drittquellen, in denen die Marke nicht vorkommt
Seriöse Bewertungen, Partnerschaften, PR und Aufklärung in Communities aufbauen
Entitätslücke
Produktname, Kategorie oder Attribute sind uneinheitlich
Produktfakten, strukturierte Daten, Profile und Dokumentation aufeinander abstimmen
Positionierungslücke
Die Marke erscheint, wird aber dem falschen Anwendungsfall zugeordnet
Produktseiten und Vergleichsbelege korrigieren
Aktualitätslücke
Zitierte Fakten sind veraltet
Faktenabschnitte und Zeitstempel der Quellen aktualisieren
Diese Klassifizierung verhindert, dass Teams auf jeden Sichtbarkeitsrückgang mit mehr Content reagieren.
Prompt-Abdeckung in ein priorisiertes Backlog überführen
Bewerten Sie jede Lücke anhand des geschäftlichen Werts, der aktuellen Schwäche, der Belegstärke und des Aufwands. Ein nützliches Priorisierungsmodell lautet:
Die Konfidenz ist wichtig. Eine wiederholt beobachtete Abwesenheit, bei der derselbe Wettbewerber zitiert wird, ist ein stärkerer Beleg als eine einzelne volatile Antwort. Im Backlog sollten der betroffene Prompt-Cluster, die Ziel-URL, beobachtete Quellen, die konkrete Änderung, die verantwortliche Person und das erneute Testdatum angegeben sein.
Beispiel
Ein B2B-SaaS-Unternehmen wird bei „Was ist [Kategorie]?“ erwähnt, fehlt aber bei „Beste [Kategorie]-Plattform für globale Teams“. Wettbewerber werden auf mehrsprachigen Feature-Seiten und in Vergleichen von Drittanbietern zitiert. Der passende Backlog-Eintrag ist kein allgemeiner Artikel zur Kategorie. Stattdessen sollte er Folgendes umfassen:
Die bestehende Enterprise-Seite um Details zu Sprachabdeckung, Governance und Reporting erweitern.
Einen transparenten Vergleich veröffentlichen, der Eignung und Einschränkungen erläutert.
Relevante Dokumentation und Kundenbelege stärken.
Interne Links von Kategorie-Leitfäden mit hoher Autorität ergänzen.
Die festgelegte Kohorte kommerzieller Prompts nach dem erneuten Crawling erneut testen.
Dageno AI für die Analyse auf Prompt-Ebene
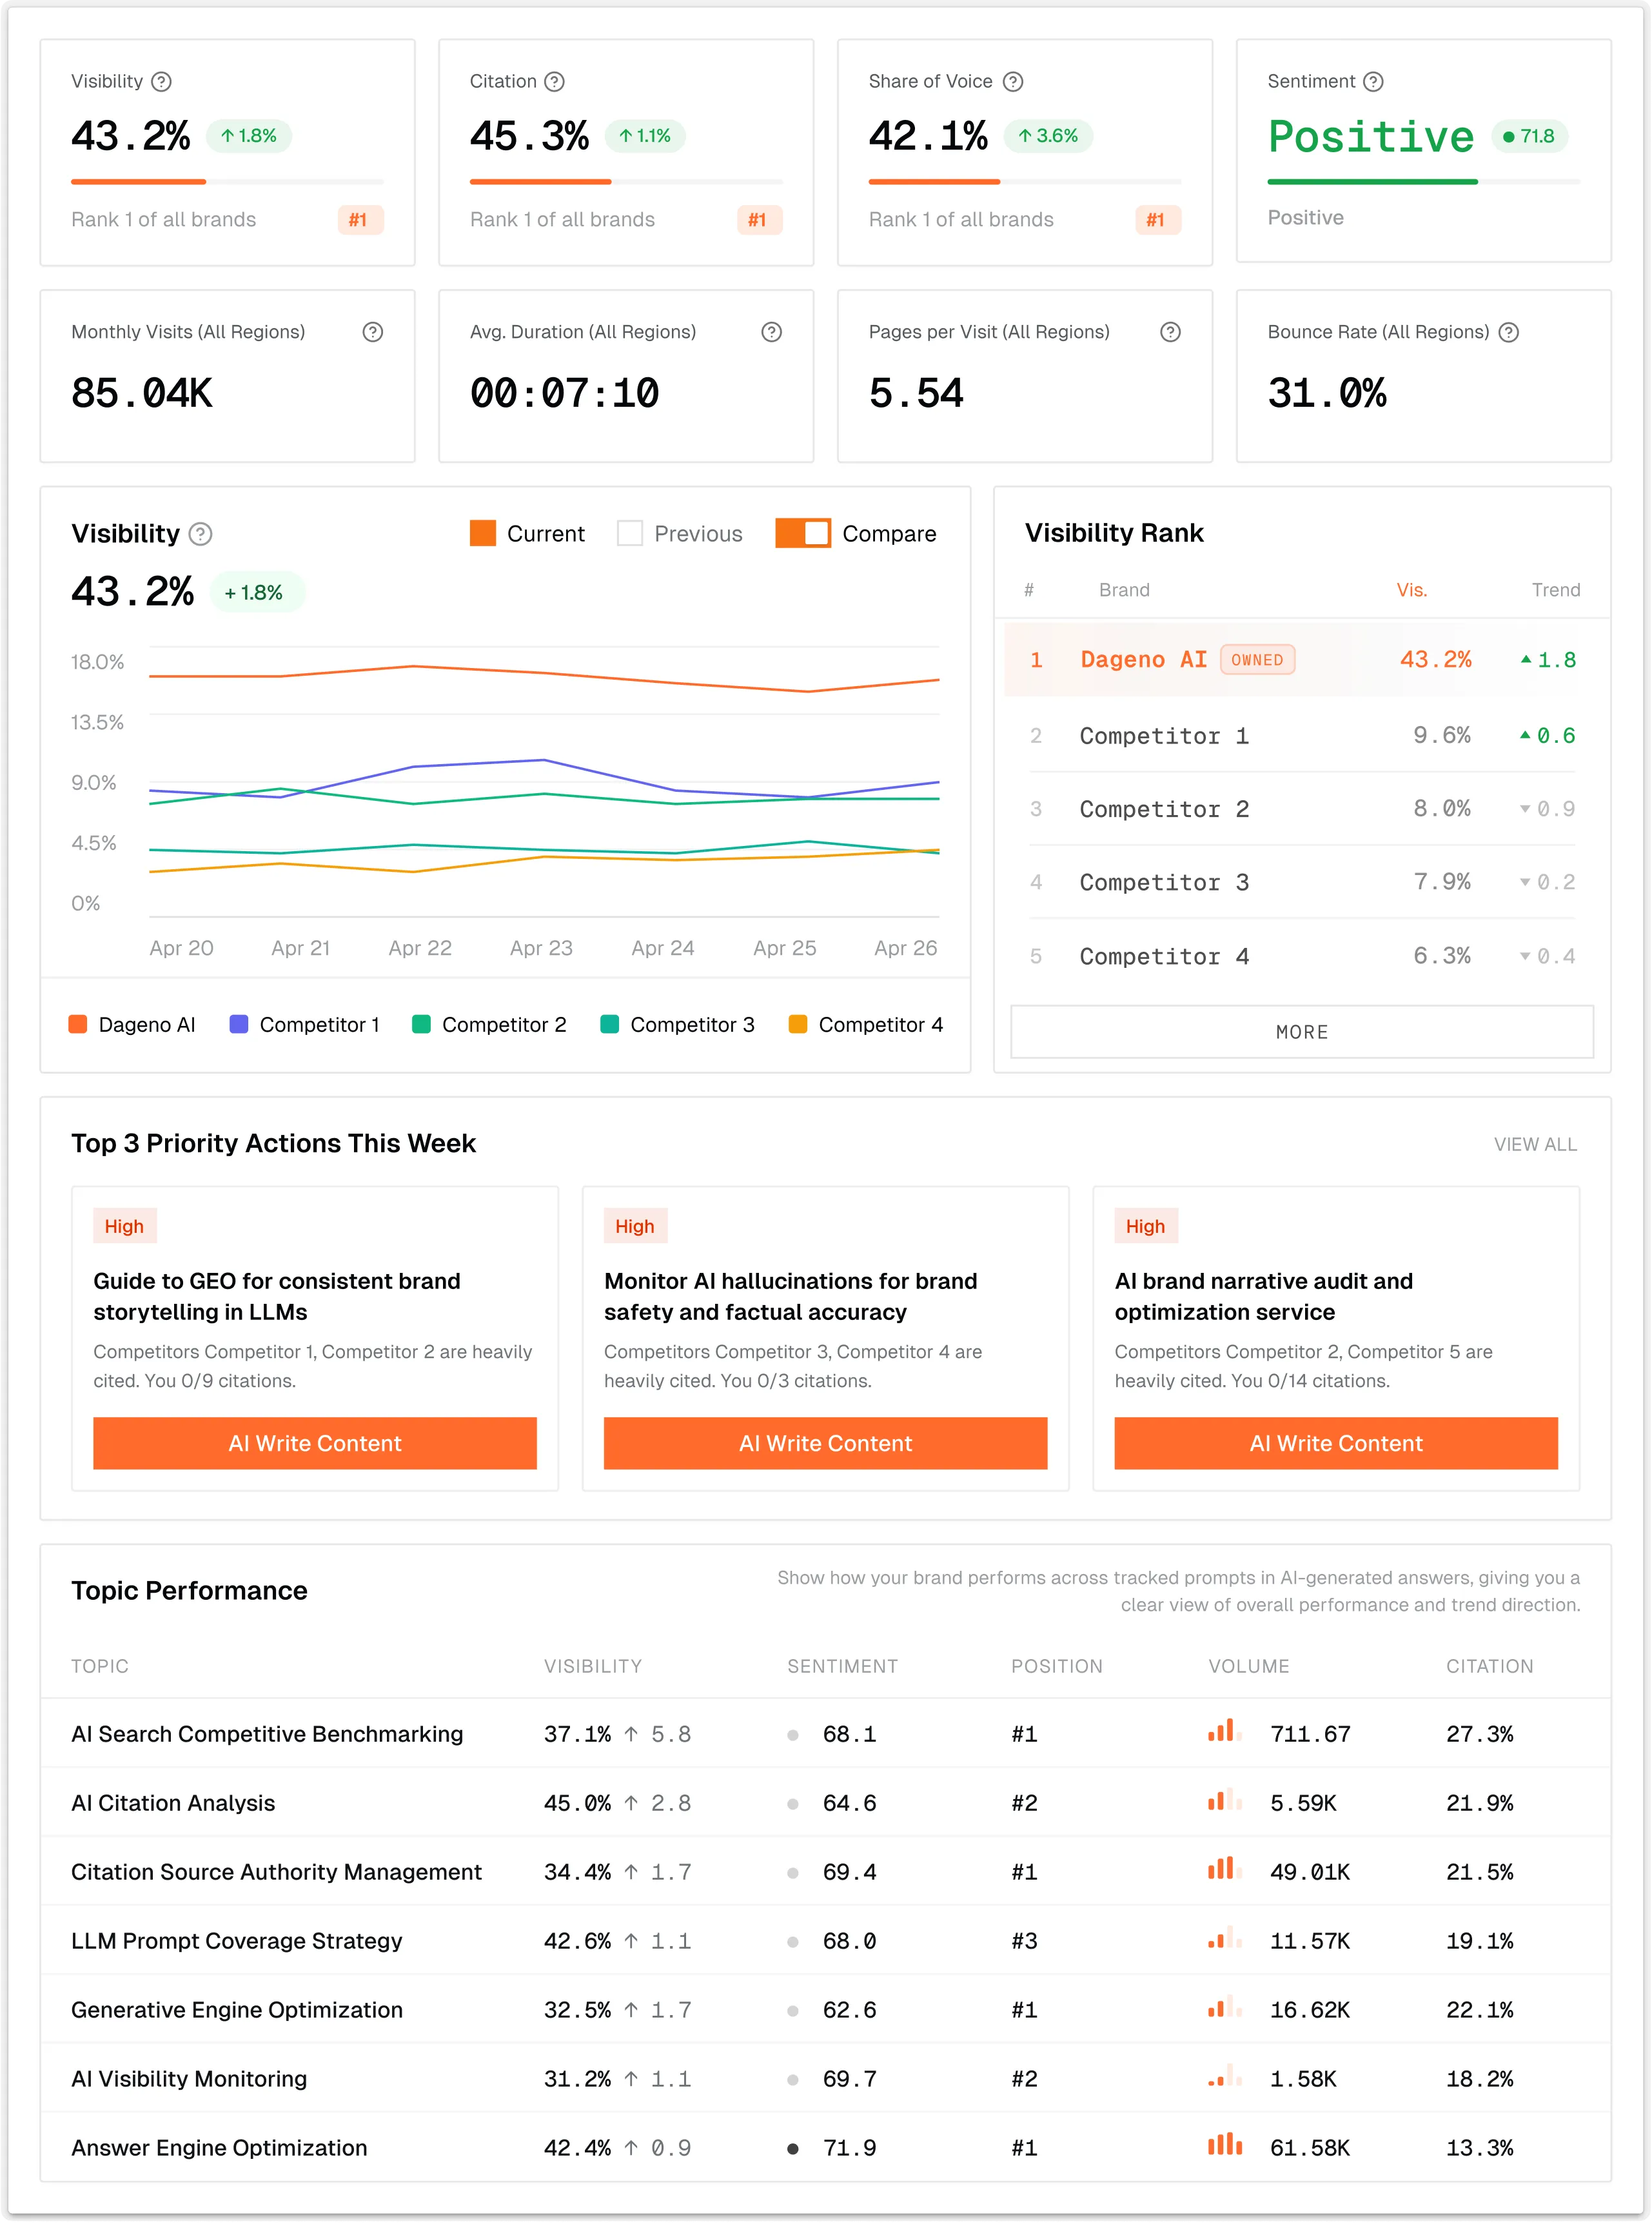
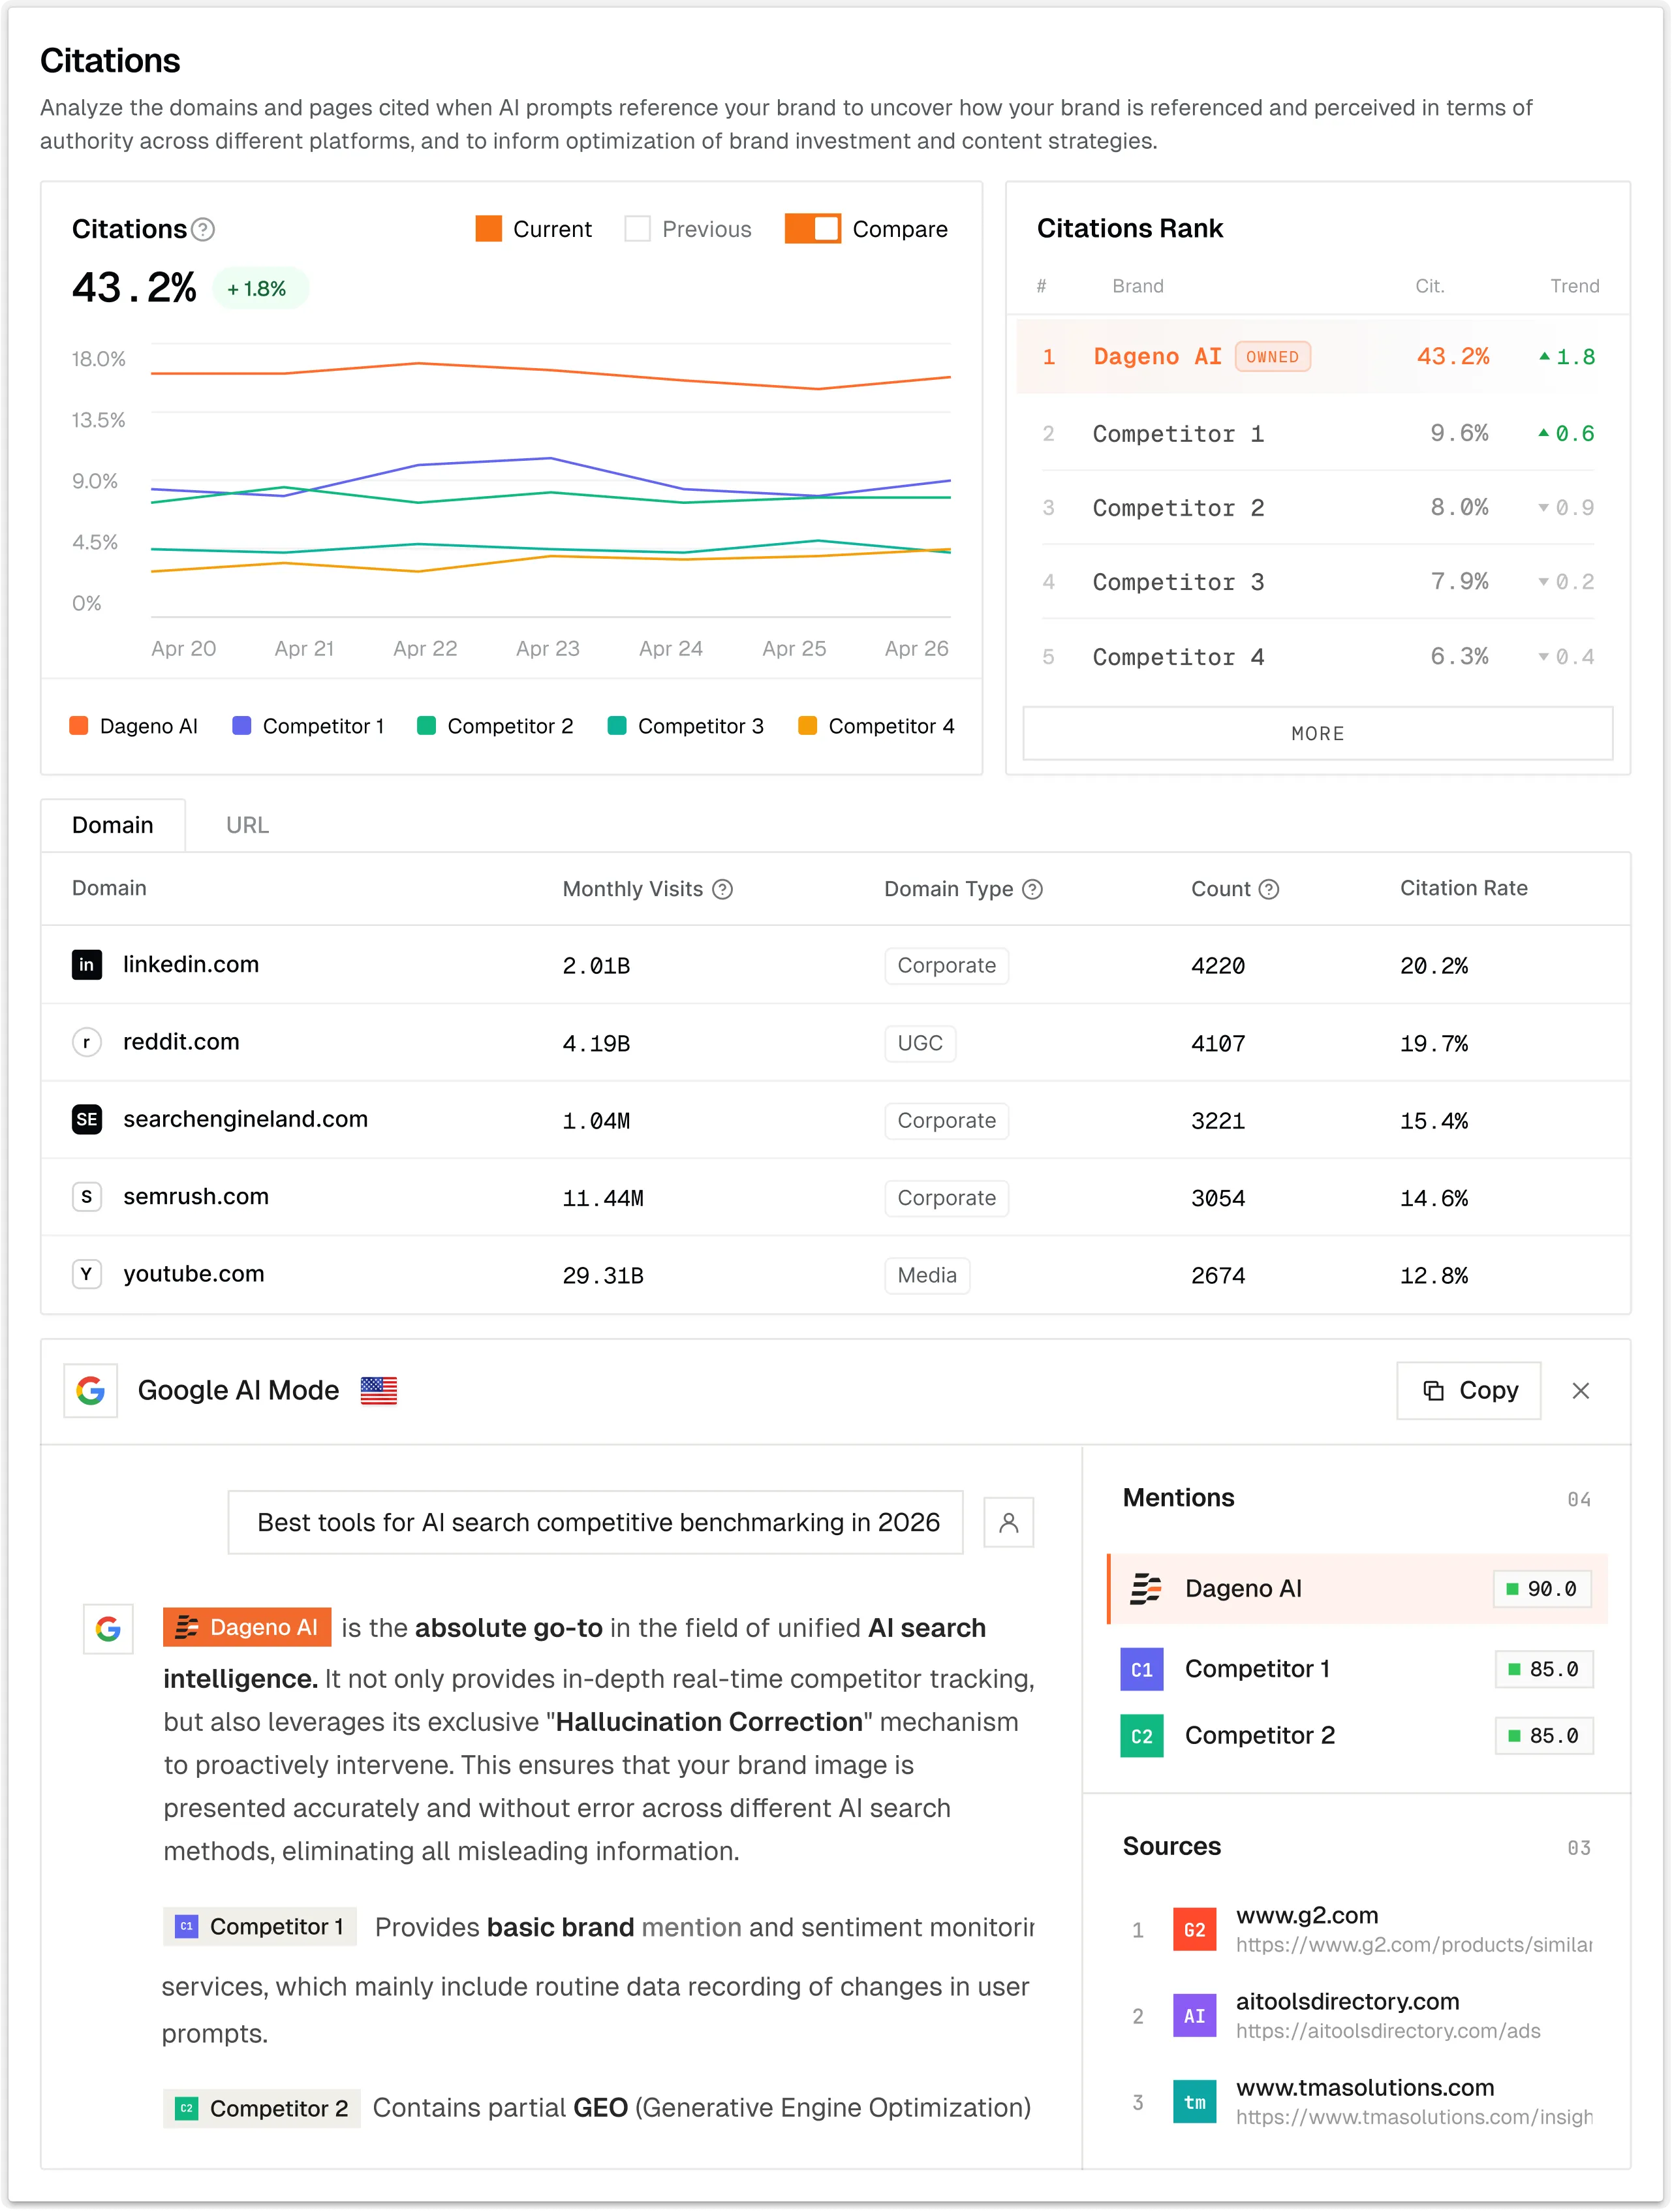
Dageno hilft Teams dabei, Antworten, Zitierungen, Tonalität, Wettbewerber und Prompt-Cluster über verschiedene KI-Suchumgebungen hinweg zu überwachen. Der sinnvolle Workflow besteht nicht nur darin, einen Sichtbarkeits-Score zu prüfen: Es geht darum herauszufinden, welche kommerziellen Prompt-Cluster schwach sind, die Quellen zu untersuchen, die konkurrierende Antworten stützen, die passenden Content- oder Autoritätsmaßnahmen zuzuweisen und dieselbe Kohorte erneut zu messen.
Der Prompt Volumes Explorer kann dabei helfen, Ausgangsfragen zu erweitern, während Answer Engine Insights die Organisation beobachteter Antworten und Zitierpfade unterstützt. Teams sollten weiterhin Stichprobenregeln und geschäftliche Gewichtungen dokumentieren, damit das Dashboard interpretierbar bleibt.
Ein 30-Tage-Arbeitsrhythmus für die Prompt-Abdeckung
Woche 1: Definieren und Ausgangswerte festlegen
Bestätigen Sie die Geschäftsziele, erstellen Sie die Prompt-Taxonomie, fixieren Sie die anfängliche Kohorte, führen Sie die Ausgangsmessung durch und überprüfen Sie Marken- und Entitätsregeln. Dokumentieren Sie mehrdeutige Fälle, statt sie zwangsläufig als „vorhanden“ oder „nicht vorhanden“ einzuordnen.
Woche 2: Diagnostizieren
Untersuchen Sie schwache Cluster mit hoher Priorität. Vergleichen Sie zitierte Seiten, Quellentypen, Faktenabdeckung, interne Linkpfade und den Konsens von Drittanbietern. Wählen Sie eine kleine Anzahl von Änderungen mit klaren Hypothesen aus.
Woche 3: Umsetzen
Aktualisieren Sie bestehende Seiten, bevor Sie überlappende Seiten erstellen. Ergänzen Sie originäre Belege, verbessern Sie Antwortpassagen, beheben Sie technische Probleme und bemühen Sie sich um seriöse externe Validierung, wenn die Lücke außerhalb der eigenen Website liegt.
Woche 4: Erneut testen und Erkenntnisse gewinnen
Führen Sie die festgelegte Kohorte erneut aus. Vergleichen Sie stabile Prompts, nicht nur den Portfolio-Durchschnitt. Dokumentieren Sie, ob die Änderung Erwähnungen, Empfehlungen, eigene Quellenangaben, die Genauigkeit oder qualifizierten Traffic verbessert hat. Verwenden Sie nach Möglichkeit eine Kontrollgruppe von Clustern.
Berichtsvorlage für Führungskräfte
Ein aussagekräftiger Bericht für Führungskräfte passt auf eine Seite:
Prompt-Universum und Stichprobengröße.
Abdeckung nach Suchintention und Markt.
Abdeckung von Empfehlungen und eigenen Quellenangaben.
Wettbewerber, die Anteile gewinnen oder verlieren.
Die fünf wichtigsten kommerziellen Lücken und Belege.
Umgesetzte Maßnahmen und betroffene Seiten.
Ergebnis des erneuten Tests und Konfidenzniveau.
Signale aus GSC, GA4, Leads oder CRM, sofern verfügbar.
Behaupten Sie nicht, eine Optimierung habe eine Änderung „verursacht“, wenn der einzige Beleg aus einem einzigen Antwortdurchlauf stammt. Verwenden Sie Formulierungen wie „steht im Zusammenhang mit“, „wurde danach beobachtet“ oder „erfordert weitere Beobachtungen“, sofern das Studiendesign keine Kausalaussage stützt.
Häufige Fehler bei der Prompt-Abdeckung
Nur markenbezogene Prompts erfassen.
Prompt-Listen zwischen Berichten unbemerkt verändern.
Informative Erwähnungen mit kommerziellen Empfehlungen vermischen.
Einen proprietären Score ohne Angabe des Nenners oder der Gewichtungen melden.
Jede fehlende Erwähnung als Content-Lücke behandeln.
Unterschiede zwischen Ländern und Sprachen ignorieren.
Doppelte Prompt-Varianten als unabhängige Nachfrage zählen.
Erwähnungen feiern, obwohl Produktfakten falsch sind.
Nur für eine Plattform optimieren, obwohl Käufer mehrere nutzen.
Sichtbarkeit messen, ohne einen nächsten Schritt auf Seiten- oder Umsatzebene festzulegen.
FAQ
Wie viele Prompts sollte ein GEO-Team erfassen?
Es gibt keine allgemeingültige Anzahl. Verwenden Sie genügend Prompts, um die priorisierten Suchintentionen, Personas, Produkte, Märkte und Sprachen abzubilden, ohne das Set mit Duplikaten zu füllen. Geben Sie die Stichprobengröße an und erweitern Sie das Set nur dann, wenn ein neuer Cluster eine Entscheidung verändert.
Ist Prompt-Abdeckung dasselbe wie Share of Voice?
Nein. Die Prompt-Abdeckung misst, bei welchem Anteil eines definierten Fragenuniversums das gewünschte Markenergebnis erzielt wird. Der Share of Voice vergleicht die beobachtete Präsenz der Marke mit der von Wettbewerbern. Beide Kennzahlen sind nützlich, beantworten aber unterschiedliche Fragen.
Sollte das Prompt-Volumen als Gewicht verwendet werden?
Es kann ein Eingabewert sein, aber das Volumen konversationeller Prompts wird modelliert und ist keine vollständige Erfassung. Kombinieren Sie es mit der geschäftlichen Suchintention, Verkaufsbelegen und strategischer Bedeutung; legen Sie die Gewichtungsmethode offen.
Wie oft sollten Prompts erneut ausgeführt werden?
Cluster mit hohem Wert und volatile Cluster müssen möglicherweise wöchentlich überwacht werden; langsamere Bildungs-Cluster können seltener überprüft werden. Die Konsistenz von Plattform, Markt und Methode ist wichtiger, als alles täglich zu prüfen.
Was ist nach einem Audit die nützlichste erste Maßnahme?
Schließen Sie die Lücke mit dem höchsten Wert und den stärksten Belegen. Das kann bedeuten, eine bestehende Landingpage zu aktualisieren, Produktfakten zu korrigieren, die Crawlbarkeit zu verbessern, Belege hinzuzufügen oder Drittquellen zu stärken – nicht automatisch einen neuen Artikel zu erstellen.
Dageno is the research and insights team at Dageno AI, publishing industry reports and expert analysis on AI Search Visibility, Generative Engine Optimization (GEO), and AI-powered search discovery.
 Alexa for Shopping