Finden Sie heraus, wo Ihre Marke im KI-Markt steht.
Ermitteln Sie die Wachstumschancen, die es wert sind, priorisiert zu werden, und zwar anhand der Marktnachfrage, des Wettbewerbsumfelds, der Markenwertversprechen und der Zitationsquellen.
Wie Marken mit mehreren Produkten ihre KI-Sichtbarkeits-Baseline aufteilen sollten: Wann die Markenzahl reicht und wann du nach Produkt oder Szenario schauen musst
Die KI-Sichtbarkeit auf Markenebene ist nach Antwortvolumen gewichtet, sodass sich ein schwaches Produkt in einer steigenden Zahl verstecken kann. Erfahre, wann du nach Marke, Produkt oder Szenario schauen solltest.
Wenn die KI-Sichtbarkeit der Marke insgesamt steigt, heißt das nicht, dass jedes Produkt steigt. Die KI-Sichtbarkeit auf Markenebene wird berechnet, indem man die Antworten auf die Fragen aller Produkte zusammenfasst. Das Produkt mit den meisten Fragen hat das größte Gewicht. Ein Produkt mit wenigen Fragen kann an Sichtbarkeit verlieren oder von der KI kaum erwähnt werden, ohne dass die Gesamtzahl es zeigt. Und wenn sich die Zahl der Fragen pro Produkt oder die Zahl der Stichproben pro Frage ändert, bewegt sich die Gesamtzahl von selbst. Um herauszufinden, ob der Zuwachs eines Produkts das Fehlen eines anderen verdeckt, nimm dieselben Fragen und denselben Zeitraum und zerlege die Gesamtveränderung in zwei Teile: die Veränderung der eigenen Sichtbarkeit jedes Produkts und die Veränderung seines Anteils an den Antworten.
1. Warum steigt die KI-Sichtbarkeit der Marke insgesamt, während manche Produkte von der KI immer seltener erwähnt werden?
Der direkte Grund: Die KI-Sichtbarkeit auf Markenebene ist ein gewichteter Durchschnitt. Sie fasst die Antworten auf alle überwachten Fragen zusammen und berechnet „Antworten, die die Marke erwähnen ÷ alle Antworten“. Wie viel Gewicht jedes Produkt hat, hängt davon ab, wie viele Fragen es im Fragenset hat und wie viele Antworten diese Fragen sammeln. Steigt ein stark gewichtetes Produkt ein wenig, steigt die Gesamtzahl mit. Fällt ein schwach gewichtetes Produkt oder wird es gar nicht erwähnt, bewegt sich die Gesamtzahl kaum.
Nimm Apple in einer historischen Stichprobe, die Dageno in drei Beispielmärkten gesammelt hat: Smartphones, Laptops und Smartwatches. Apple und Samsung erscheinen hier als öffentliche Beispiele, nicht als Dageno-Kunden. Vom 3. bis 19. August 2026 wurde Apple in 53,4 % der Smartphone-Antworten (12.807 Antworten), 43,5 % der Laptop-Antworten (9.578) und 61,6 % der Smartwatch-Antworten (3.301) erwähnt. Zusammengefasst ergibt das 50,8 %. Smartwatch-Antworten machten nur 13 % der Gesamtmenge aus. Selbst wenn Apples Sichtbarkeit bei Smartwatches um 10 Prozentpunkte fiele, würde die Gesamtzahl also nur um etwa 1,3 Punkte sinken – in einem Bericht leicht als normale Schwankung abzutun.
Der zweite Grund ist schwerer zu erkennen: Wenn sich der Anteil der Antworten ändert, die von jedem Produkt stammen, ändert sich auch die Gesamtzahl, selbst wenn kein Produkt tatsächlich besser geworden ist. Die Zahl der Antworten hängt von zwei Dingen ab: wie viele Fragen gestellt werden und wie viele Antworten jede Frage sammelt. Hier ist Samsung aus derselben Stichprobe. Wir haben die Antworten aus allen drei Märkten zusammengefasst – das entspricht einem einzigen Fragenset, das Fragen zu drei Produkten mischt – und Samsungs Sichtbarkeit auf Markenebene berechnet. Zeitraum 1 ist der 3.–10. August, Zeitraum 2 der 11.–19. August. Zuerst die Rohzahlen:
Produkt
Antworten Zeitraum 1
Antworten mit Samsung-Nennung Zeitraum 1
Antworten Zeitraum 2
Antworten mit Samsung-Nennung Zeitraum 2
Smartphones
7.215
5.788
5.592
4.130
Laptops
6.066
198
3.512
162
Smartwatches
1.360
634
1.941
907
Gesamt
14.641
6.620
11.045
5.199
Die Quoten ergeben sich direkt aus diesen Zahlen:
Kennzahl
Zeitraum 1
Zeitraum 2
Veränderung (Prozentpunkte)
Markenebene (alle drei zusammen)
45,2 % (6.620 ÷ 14.641)
47,1 % (5.199 ÷ 11.045)
+1,9
Sichtbarkeit in Smartphone-Antworten
80,2 % (5.788 ÷ 7.215)
73,9 % (4.130 ÷ 5.592)
−6,4
Sichtbarkeit in Laptop-Antworten
3,3 % (198 ÷ 6.066)
4,6 % (162 ÷ 3.512)
+1,3
Sichtbarkeit in Smartwatch-Antworten
46,6 % (634 ÷ 1.360)
46,7 % (907 ÷ 1.941)
+0,1
Anteil der Smartphones an allen Antworten
49,3 %
50,6 %
+1,3
Anteil der Laptops an allen Antworten
41,4 %
31,8 %
−9,6
Anteil der Smartwatches an allen Antworten
9,3 %
17,6 %
+8,3
Hinweis: Die Veränderungen wurden aus ungerundeten Werten berechnet.
Smartphones fielen um 6,4 Punkte, doch die Zahl auf Markenebene stieg um 1,9 Punkte. Die letzten drei Zeilen erklären, warum. In Zeitraum 2 sanken die Laptop-Antworten, in denen Samsung kaum erwähnt wird, von 6.066 auf 3.512, und ihr Anteil fiel von 41,4 % auf 31,8 %. Die Smartwatch-Antworten, in denen Samsung ordentlich abschneidet, stiegen von 1.360 auf 1.941, und ihr Anteil kletterte von 9,3 % auf 17,6 %. Der Gesamtzuwachs kam daher, dass sich änderte, was wie oft gefragt wurde, nicht daher, dass ein Produkt von der KI häufiger erwähnt wurde. Die Laptop-Zeile sagt noch mehr: Samsung verkauft Laptops, wurde aber in beiden Zeiträumen nur in 3 % bis 5 % der Laptop-Antworten erwähnt, während die Zahl auf Markenebene die ganze Zeit über 45 % lag.
Ist also die Zahl der Laptop-Fragen gesunken? Nein. Dedupliziert man nach Prompt-ID, sieht man, wie viele verschiedene Fragen jedes Produkt in jedem Zeitraum hatte und wie viele Antworten jede Frage im Durchschnitt lieferte. Antworten auf dieselbe Frage von verschiedenen Plattformen, Regionen oder Tagen zählen alle.
Produkt
Fragen Zeitraum 1
Fragen Zeitraum 2
Antworten pro Frage Zeitraum 1
Antworten pro Frage Zeitraum 2
Smartphones
3.249
3.748
1,65
1,22
Laptops
1.885
2.049
2,25
1,41
Smartwatches
649
1.155
1,59
1,19
Hinweis: Gezählt werden nur Antworten, die sich einer Prompt-ID zuordnen lassen; je nach Produkt und Zeitraum sind das 70 % bis 82 % der Antworten. Nutze diese Tabelle nur für die Richtung und multipliziere sie nicht mit den Antwortzahlen oben.
Laptops hatten sogar etwas mehr Fragen (1.885 auf 2.049), aber weniger Antworten, weil jede Laptop-Frage im Schnitt 1,41 statt 2,25 Antworten lieferte. Die Smartwatch-Fragen haben sich fast verdoppelt (649 auf 1.155). Mit anderen Worten: Der Antwortanteil eines Produkts kann sich ändern, weil es mehr oder weniger Fragen hat oder weil jede Frage unterschiedlich oft ausgeführt wurde. Deshalb verlangt Abschnitt 7, sowohl das Fragenset als auch die Zahl der Stichproben festzulegen.
Statistiker sprechen vom Simpson-Paradoxon, wenn ein Trend in einer Gesamtpopulation erscheint, verschwindet oder sich umkehrt, sobald man die Population in Untergruppen aufteilt (Definition der Stanford Encyclopedia of Philosophy). Die Sichtbarkeit auf Markenebene hat dieselbe Art von Problem: Wenn sich die Anteile der Untergruppen ändern, kann sich die zusammengefasste Zahl in eine andere Richtung bewegen als die aufgeteilten Zahlen.
Ob eine Frage den Markennamen enthält, verändert die Gesamtzahl ebenfalls. In Better Metrics for AI Search Visibility weist Ann Smarty von Practical Ecommerce darauf hin, dass der Sichtbarkeitswert eines Tools ganz davon abhängt, welche Fragen gestellt werden. Fragen mit Markennamen erreichen wahrscheinlich fast 100 % und sollten deshalb in einer eigenen Gruppe stehen. Bekommt ein Produkt mehr Fragen mit Markennamen, wird auch die Zahl auf Markenebene aufgebläht.
Noch etwas, bevor wir weitermachen: Der Rückgang der Smartphones um 6,4 Punkte in der Tabelle muss noch einmal zerlegt werden. Wie Abschnitt 7 zeigt, kam auch der größte Teil davon von einem anderen Satz gestellter Fragen.
2. Die KI-Sichtbarkeit der Marke insgesamt ist gestiegen – wie erkennst du, ob sie ein Produkt verdeckt, das zurückfällt?
Kurze Antwort: Teile für denselben Zeitraum und dasselbe Fragenset die Antworten nach Produkt auf und berechne für jedes Produkt zwei Zahlen: seine eigene Sichtbarkeit und seinen Anteil an allen Antworten. Vergleiche dann mit dem Vorzeitraum und zerlege die Gesamtveränderung in zwei Teile: „Veränderung innerhalb jedes Produkts“ und „Veränderung im Fragenmix“. Wenn du eines der folgenden Anzeichen siehst, wird ein Produkt verdeckt:
Die Gesamtzahl steigt, aber die eigene Sichtbarkeit eines Produkts fällt;
Die Sichtbarkeit eines Produkts ist seit Langem niedrig, aber es hat so wenig Gewicht, dass die Gesamtzahl es nicht zeigt;
Der größte Teil des Gesamtzuwachses kommt aus der Veränderung im Fragenmix, nicht aus Veränderungen innerhalb der Produkte.
Die Methode hat drei Schritte:
Versieh jede Frage mit dem Produkt, zu dem sie gehört. Jede Frage gehört zu genau einem Produkt. Fragen, die zwei Produkte betreffen, und Fragen mit Markennamen kommen jeweils in eine eigene Gruppe und werden keinem Produkt zugeschlagen.
Berechne für jedes Produkt Sichtbarkeit und Antwortanteil in beiden Zeiträumen.
Zerlege die Gesamtveränderung in die beiden folgenden Teile.
Effekt der Veränderung innerhalb eines Produkts: der durchschnittliche Antwortanteil des Produkts über beide Zeiträume × die Veränderung seiner eigenen Sichtbarkeit.
Effekt der Veränderung im Fragenmix: die durchschnittliche Sichtbarkeit des Produkts über beide Zeiträume × die Veränderung seines Antwortanteils.
Addiert man beide Teile über alle Produkte, erhält man genau die Gesamtveränderung.
So sieht die Zerlegung für Samsung aus Abschnitt 1 aus:
Produkt
Veränderung der eigenen Sichtbarkeit
Effekt auf die Gesamtzahl
Veränderung des Antwortanteils
Effekt des Fragenmix
Smartphones
−6,4
−3,2
+1,3
+1,0
Laptops
+1,3
+0,5
−9,6
−0,4
Smartwatches
+0,1
0,0
+8,3
+3,9
Gesamt
—
−2,7
—
+4,5
Hinweis: Alle Werte in Prozentpunkten; die beiden Summen ergeben zusammen +1,9 (aus ungerundeten Werten berechnet).
Zusammen drückten die Veränderungen innerhalb der drei Produkte die Gesamtzahl um 2,7 Punkte nach unten, während die Veränderung im Fragenmix sie um 4,5 Punkte nach oben schob. Wer nur die Markenebene betrachtet, würde meinen, Samsung habe in diesem Zeitraum in KI-Antworten besser abgeschnitten. Zerlegt man sie, sieht man: Smartphones fielen, Laptops waren fast abwesend, und die Gesamtzahl wurde von mehr Smartwatch-Antworten und weniger Laptop-Antworten gestützt.
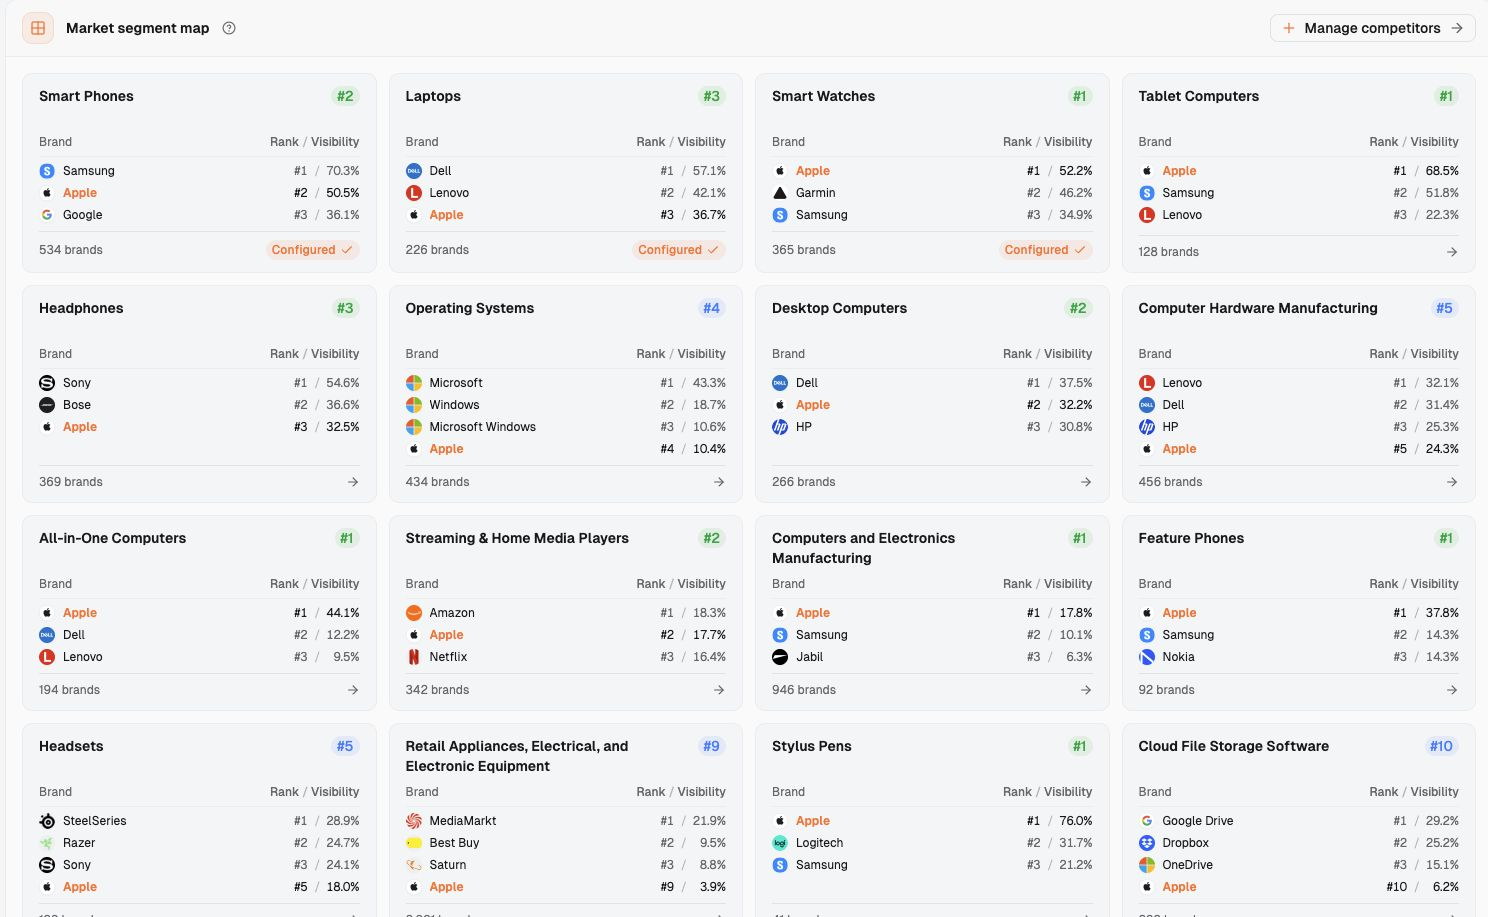
Wenn du Dageno nutzt, kannst du Schritt eins, jedes Produkt einzeln zu betrachten, auf der Seite AI Market Segments beginnen. Sie listet Rang und Sichtbarkeit derselben Marke in jedem Markt auf, zusammen mit den führenden Marken jedes Markts (siehe Abbildung 1). Die Zerlegung aus Schritt drei muss derzeit nach dem Export der Daten in einer Tabellenkalkulation erfolgen; eine Funktion, die diese Zerlegung direkt liefert, haben wir im Produkt nicht gefunden.
Abbildung 1: Der Apple-Workspace auf Dagenos Seite AI Market Segments. Dieselbe Marke steht bei Smart Phones auf Platz 2 (50,5 %), bei Laptops auf Platz 3 (36,7 %), bei Smart Watches auf Platz 1 (52,2 %) und bei Cloud File Storage Software nur auf Platz 10 (6,2 %), und jeder Markt hat andere führende Marken. Apple ist ein öffentliches Markenbeispiel, kein Dageno-Kunde. Das Bild zeigt den Berichtszeitraum nicht; Sichtbarkeit ist weder Umsatz noch Marktanteil, und ein niedriger Rang beweist nicht, dass sich ein Einstieg lohnt.
3. Nach dem Aufteilen findest du ein Produkt, das die KI kaum erwähnt – wie bestätigst du, dass es kein Zufall ist?
Kurze Antwort: Prüfe drei Dinge, bevor du einen Schluss ziehst.
Wird dieselbe Frage mehrmals gestellt, taucht das Produkt nie auf, und Wettbewerber nehmen seinen Platz ein.
Antworten, die das Modell des Produkts nennen, werden der Marke zugerechnet, die niedrige Zahl ist also kein Zählfehler.
Das Produkt wird in den Regionen und Preisklassen, nach denen die Fragen fragen, tatsächlich verkauft.
Erst wenn alle drei zutreffen, ist es ein echtes Fehlen. Eine Frage, die ein- oder zweimal gestellt wurde, oder eine Handvoll Antworten reicht nicht.
3.1 Dieselbe Frage wurde dreimal gestellt und das Produkt fehlte zweimal – zählt das als Fehlen?
Nein. Höchstens als instabil. KI-Antworten können jedes Mal anders ausfallen. SparkToro und Gumshoe.ai ließen zwischen November und Dezember 2025 600 Freiwillige 12 Prompts für Markenempfehlungen insgesamt 2.961-mal in ChatGPT, Claude und Googles KI-Antworten ausführen. Die Wahrscheinlichkeit, dass derselbe Prompt zweimal dieselbe Markenliste lieferte, lag unter 1 % (Originalbeitrag von SparkToro). Auch Schulte, Bleeker und Kaufmann von der Universität St. Gallen argumentieren, dass Sichtbarkeit als Verteilung über wiederholte Messungen gelesen werden sollte, nicht als Ergebnis einer einzigen Beobachtung (Don't Measure Once). Laut dem Paper ergibt ein einmal ausgeführter Prompt einen Standardfehler von 0,370 für die Erkennungsrate einer Marke; nach 7 Durchläufen fällt er unter 0,10. Ein Praktiker berichtete außerdem in einer Reddit-Diskussion, dass die Sichtbarkeit bei denselben Prompts von einer Woche zur nächsten um 15 % bis 20 % schwankte, ohne dass sie etwas geändert hätten. Das ist eine persönliche Beobachtung, kein statistischer Befund.
Schau dir also die Ergebnisse nach wiederholten Stichproben an. In der Drei-Märkte-Stichprobe wurden 26 Gruppen von Laptop-Fragen mindestens dreimal auf derselben Plattform in derselben Region gestellt.
Samsung: tauchte in 23 der Gruppen nie auf, in 3 zeitweise und in keiner jedes Mal.
Apple: tauchte in denselben 26 Gruppen in 21 jedes Mal auf.
Die Stichprobe ist klein, reicht aber, um zu zeigen, dass Samsungs Fehlen nicht an ein oder zwei unglücklichen Stichproben lag. Seine Sichtbarkeit war auch bei allen Arten von Laptop-Fragen niedrig:
Am besten für einen Einsatzzweck: 5,5 %
Am besten insgesamt: 5,4 %
Am besten fürs Budget: 6,9 %
Eignungsprüfung: 0,8 %
Das heißt, das ganze Produkt fehlt, nicht nur ein Szenario. Marken wie Dell (63,0 %), Lenovo (49,2 %) und Apple (43,5 %) besetzten diese Plätze.
3.2 Die Antwort nennt das Produktmodell, aber nicht die Marke – zählt das als Erwähnung von uns?
Das hängt von den Erkennungsregeln des Tools ab; am besten liest du die Originalantworten und machst Stichproben. Die Stichprobe enthält 8.713 Laptop-Antworten mit lesbarem Volltext. Die Stichprobenprüfung ergab:
4.207 Antworten enthielten „MacBook“, und 571 davon (etwa 14 %) wurden nicht als Erwähnung von Apple erfasst.
292 Antworten enthielten „Galaxy Book“, und 19 davon wurden Samsung nicht zugerechnet.
Die fehlende Zuordnung kann von einer Erkennungsregel stammen, die nur als Empfehlung genannte Marken zählt, oder von übersehenen Treffern; prüfe das anhand der Regeln des Tools. Bei Samsung machen selbst bei Zählung all dieser Fälle die Antworten mit Galaxy Book nur etwa 3 % der Laptop-Antworten aus, die Schlussfolgerung, dass das Produkt fehlt, bleibt also bestehen.
3.3 Die KI erwähnt uns in einer Preisklasse nicht, in der wir gar nicht verkaufen – ist das trotzdem ein Fehlen?
Das ist keine Lücke. Halte es als „nicht verfolgt“ fest. Samsung hat zwar eine Galaxy-Book-Laptopreihe, aber die Stichprobe umfasst viele Länder und Regionen. Wir haben nicht geprüft, welche Modelle wo und zu welchem Preis verkauft werden; das kann nur das Produktteam der Marke selbst bestätigen. Ebenso gilt: Hat eine Marke in einer bestimmten Preisklasse oder für einen bestimmten Einsatzzweck kein Produkt, ist es normal, dass die KI sie nicht erwähnt, und es sollte nicht als Content-Lücke behandelt werden.
In Dageno lassen sich die Zahlen auf den Seiten zu Marktsegmenten und Suchintentionen bis zu den zugrunde liegenden KI-Antworten anklicken, mit Plattform, Region und vollständigem Antworttext (laut den Einträgen in Dagenos Produkt-Wissensdatenbank vom 8.–9. September 2026). Die ersten beiden Prüfungen kannst du dort machen; für die dritte brauchst du eigene Produktdaten.
4. Die Geschäftsführung will eine Zahl, die Produktverantwortlichen wollen ihre eigene – wann reicht die Zahl auf Markenebene?
Kurze Antwort: Die Zahl auf Markenebene reicht, wenn alle drei Bedingungen erfüllt sind:
Alle Produkte haben es mit denselben Käuferfragen und denselben Wettbewerbern zu tun;
Die Frage, die du beantworten musst, betrifft die Marke, etwa „Wie oft werden wir in KI-Antworten zu dieser Kategorie insgesamt erwähnt?“ oder ob die Markenpositionierung geändert werden muss;
Der Anteil jedes Produkts am Fragenset bleibt von Zeitraum zu Zeitraum gleich.
Fällt auch nur eine davon weg, ist die Zahl auf Markenebene nur ein Trendhinweis; sie sagt dir nicht, ob ein bestimmtes Produkt gut läuft.
Die erste Bedingung gilt in der Regel für Marken mit nur einer Kategorie. Denk an eine Marke, die nur Smartwatches herstellt: Ihre verschiedenen Modelle haben es mit denselben Fragen und denselben Konkurrenten zu tun. Eine Aufteilung nach Modell lässt in jedem Teil zu wenige Antworten übrig und macht die Auswertung schwieriger, nicht leichter. Aufteilen kostet auch etwas. Mit einem statistischen Standardtest schätzt ThriveStack, dass man etwa 686 Durchläufe pro Bedingung braucht, um eine echte Erwähnungsrate von 10 % mit 95 % Sicherheit von einer von 15 % zu unterscheiden (Zusammenfassung von ThriveStack). Teilst du in fünf Produkte auf, braucht jedes genug eigene Antworten, und das Stichprobenvolumen vervielfacht sich.
Die zweite Bedingung betrifft das Reporting an die Geschäftsführung. Die Geschäftsführung braucht meist nur den Gesamttrend und die Information, ob ein Produkt ein Problem hat, nicht die Details jedes Szenarios.
Die dritte Bedingung wird am leichtesten übersehen. Samsung in Abschnitt 1 zeigt: Ändert sich der Antwortanteil jedes Produkts, bewegt sich die Gesamtzahl von selbst. Die Lösung ist, die Zahl auf Markenebene mit festen Gewichten zu berechnen: Ermittle zuerst die Sichtbarkeit jedes Produkts und kombiniere sie dann mit Gewichten, die vorab festgelegt werden und in jedem Zeitraum gleich bleiben. Du kannst die Gewichte auf die aktuellen Fragenanteile einfrieren oder sie nach der geschäftlichen Bedeutung jedes Produkts festlegen. Dann kann keine Änderung der Fragenzahl oder der Stichprobenhäufigkeit die Gesamtzahl bewegen.
Auch wenn die Geschäftsführung nur eine Zahl sieht, füge darunter eine Zeile mit Sichtbarkeit und Veränderung jedes Produkts hinzu, als Kontrolle, ob ein Produkt abrutscht. Führe Fragen mit Markennamen in einer eigenen Zeile und nimm sie aus der Gesamtzahl heraus. Fragen mit und ohne Markennamen messen zwei verschiedene Dinge; siehe den Unterschied zwischen Erwähnungen mit und ohne Markennamen.
5. Die Marke steht insgesamt weit oben, aber ein Produkt liegt hinter den Wettbewerbern – wann musst du jedes Produkt separat verfolgen?
Kurze Antwort: Wenn einer der folgenden Punkte zutrifft, gib jedem Produkt eine eigene Baseline, also eigene Fragen, eine eigene Wettbewerberliste und eine eigene Ausgangszahl:
Die Produkte haben nicht dieselben Wettbewerber;
Die Sichtbarkeit der Produkte unterscheidet sich stark;
Die Produkte haben unterschiedliche Verantwortliche mit unterschiedlichen Website-Seiten und Budgets;
Ein Produkt hat einen so kleinen Anteil am Fragenset, dass die Gesamtzahl seine Veränderungen nicht zeigen kann.
Unterschiedliche Wettbewerber sind in der Drei-Märkte-Stichprobe offensichtlich. Die fünf sichtbarsten Marken sind in jedem Markt völlig verschieden:
Dieselbe Marke Apple konkurriert in Smartphone-Antworten mit Samsung und Google, in Laptop-Antworten aber mit Dell und Lenovo. Fasst man das zu einem einzigen Markenranking zusammen, vergleicht man nicht mehr mit denselben Rivalen.
Ein großer Abstand sieht so aus: Samsungs Sichtbarkeit liegt bei Smartphones bei 77,4 %, bei Smartwatches bei 46,7 % und bei Laptops nur bei 3,8 %. Apple in Abbildung 1 erzählt dieselbe Geschichte: Platz 1 bei Smartwatches, Platz 3 bei Laptops und nur Platz 10 bei Cloud-Speicher.
Unterschiedliche Verantwortliche bedeutet: Wer Menschen nach der Zahl auf Markenebene beurteilt, verteilt Lob oder Tadel, das sie nicht verdient haben. Die Person, die für Laptops zuständig ist, sieht die Zahl vielleicht nur deshalb steigen, weil es mehr Smartwatch-Fragen gab, während sich ihr Produkt gar nicht verändert hat.
Ein kleiner Anteil bedeutet nach der Rechnung in Abschnitt 1, dass das Produkt um 10 Punkte fallen kann, während sich die Gesamtzahl nur um gut 1 Punkt bewegt.
Externe Forschung und Praktiker weisen auf dasselbe hin. Der Anbieter Odyssiant analysierte 5.356 KI-Antworten von Februar bis April 2026 und kam zu dem Schluss, dass Markensichtbarkeit zeigt, ob die KI das Unternehmen erkennt, während Produktsichtbarkeit zeigt, ob das richtige Angebot im richtigen Kaufkontext verstanden wird. Der Unterschied ist am wichtigsten für Unternehmen mit vielen Produkt- oder Servicelinien (Product Visibility vs Brand Visibility). Die Studie hat ihre Bewertungsmethode in diesem Zeitraum angepasst, und die Autoren weisen darauf hin, dass die Muster nach Kaufphase als entstehende Baseline und nicht als sauberer Trend zu lesen sind. Ein Praktiker auf Reddit beschrieb außerdem, dass Marken in der KI „in zwei Profile aufgeteilt“ werden, eines für Produktanfragen und eines für Unternehmensinformationen (die ursprüngliche Diskussion). Das ist eine persönliche Beobachtung, aber sie macht denselben Punkt: Als Marke erkannt zu werden ist nicht dasselbe, wie das eigene Produkt empfohlen zu bekommen.
Jedes Produkt separat zu verfolgen ist nicht kompliziert:
Liste für jedes Produkt eigene Käuferfragen ohne Markennamen auf;
Gib jedem Produkt eine eigene Wettbewerberliste;
Halte die Ausgangssichtbarkeit jedes Produkts fest;
Bilde die Zahl auf Markenebene aus den Produktzahlen mit den festen Gewichten aus Abschnitt 4.
Dagenos Lösungsseite Product Portfolio Planning beschreibt genau diese Art von Vergleich: Vergleiche zuerst KI-Sichtbarkeit und Rang über die Produktlinien hinweg, wähle dann eine Linie aus und gehe den Käuferfragen und Verkaufsargumenten auf den Grund. Die Seite nennt auch ihre Grenzen: Position und Abdeckung in KI-Antworten messen weder Marktnachfrage noch Marktanteil noch Umsatz, und Ergebnisse aus verschiedenen Märkten sollten getrennt bleiben.
6. Ein Produkt wird bei „Welches ist das beste?“-Fragen empfohlen, verschwindet aber, sobald Käufer nach günstigen Optionen fragen – wann musst du nach Szenario schauen?
Kurze Antwort: Wenn sich Sichtbarkeit oder Rang desselben Produkts je nach Art der Käuferfrage stark unterscheiden und du diesen Unterschied brauchst, um zu entscheiden, welche Seite du änderst oder welchen Content du ergänzt, teile eine Ebene weiter nach Szenario auf. Kommt der Unterschied aus einer Preisklasse oder einem Einsatzzweck, den du nicht bedienst, halte ihn nur fest; das ist keine Lücke.
In der Drei-Märkte-Stichprobe liegt Apples Gesamtsichtbarkeit in Smartphone-Antworten bei 53,4 %, doch nach Art der Käuferfrage aufgeteilt sieht das Bild ganz anders aus:
Art der Käuferfrage
Sichtbarkeit
Antworten
Am besten insgesamt
73,8 %
839
Am besten fürs Budget
22,9 %
376
Warum dieses wählen
18,5 %
287
Die Fragearten sind Dagenos Klassifizierung. Für die Aufteilung nach Szenario haben wir nur Antworten verwendet, die sich Fragen-Metadaten zuordnen ließen, etwa 78 % der Smartphone-Antworten.
Schaut man nur auf die 53,4 % auf Produktebene, würde man meinen, das Produkt schneide in KI-Antworten insgesamt gut ab. Nach Szenario aufgeteilt sieht man, dass Fragen nach dem „besten insgesamt“ den Durchschnitt stützen, während das Produkt selten auftaucht, sobald das Budget in die Frage kommt.
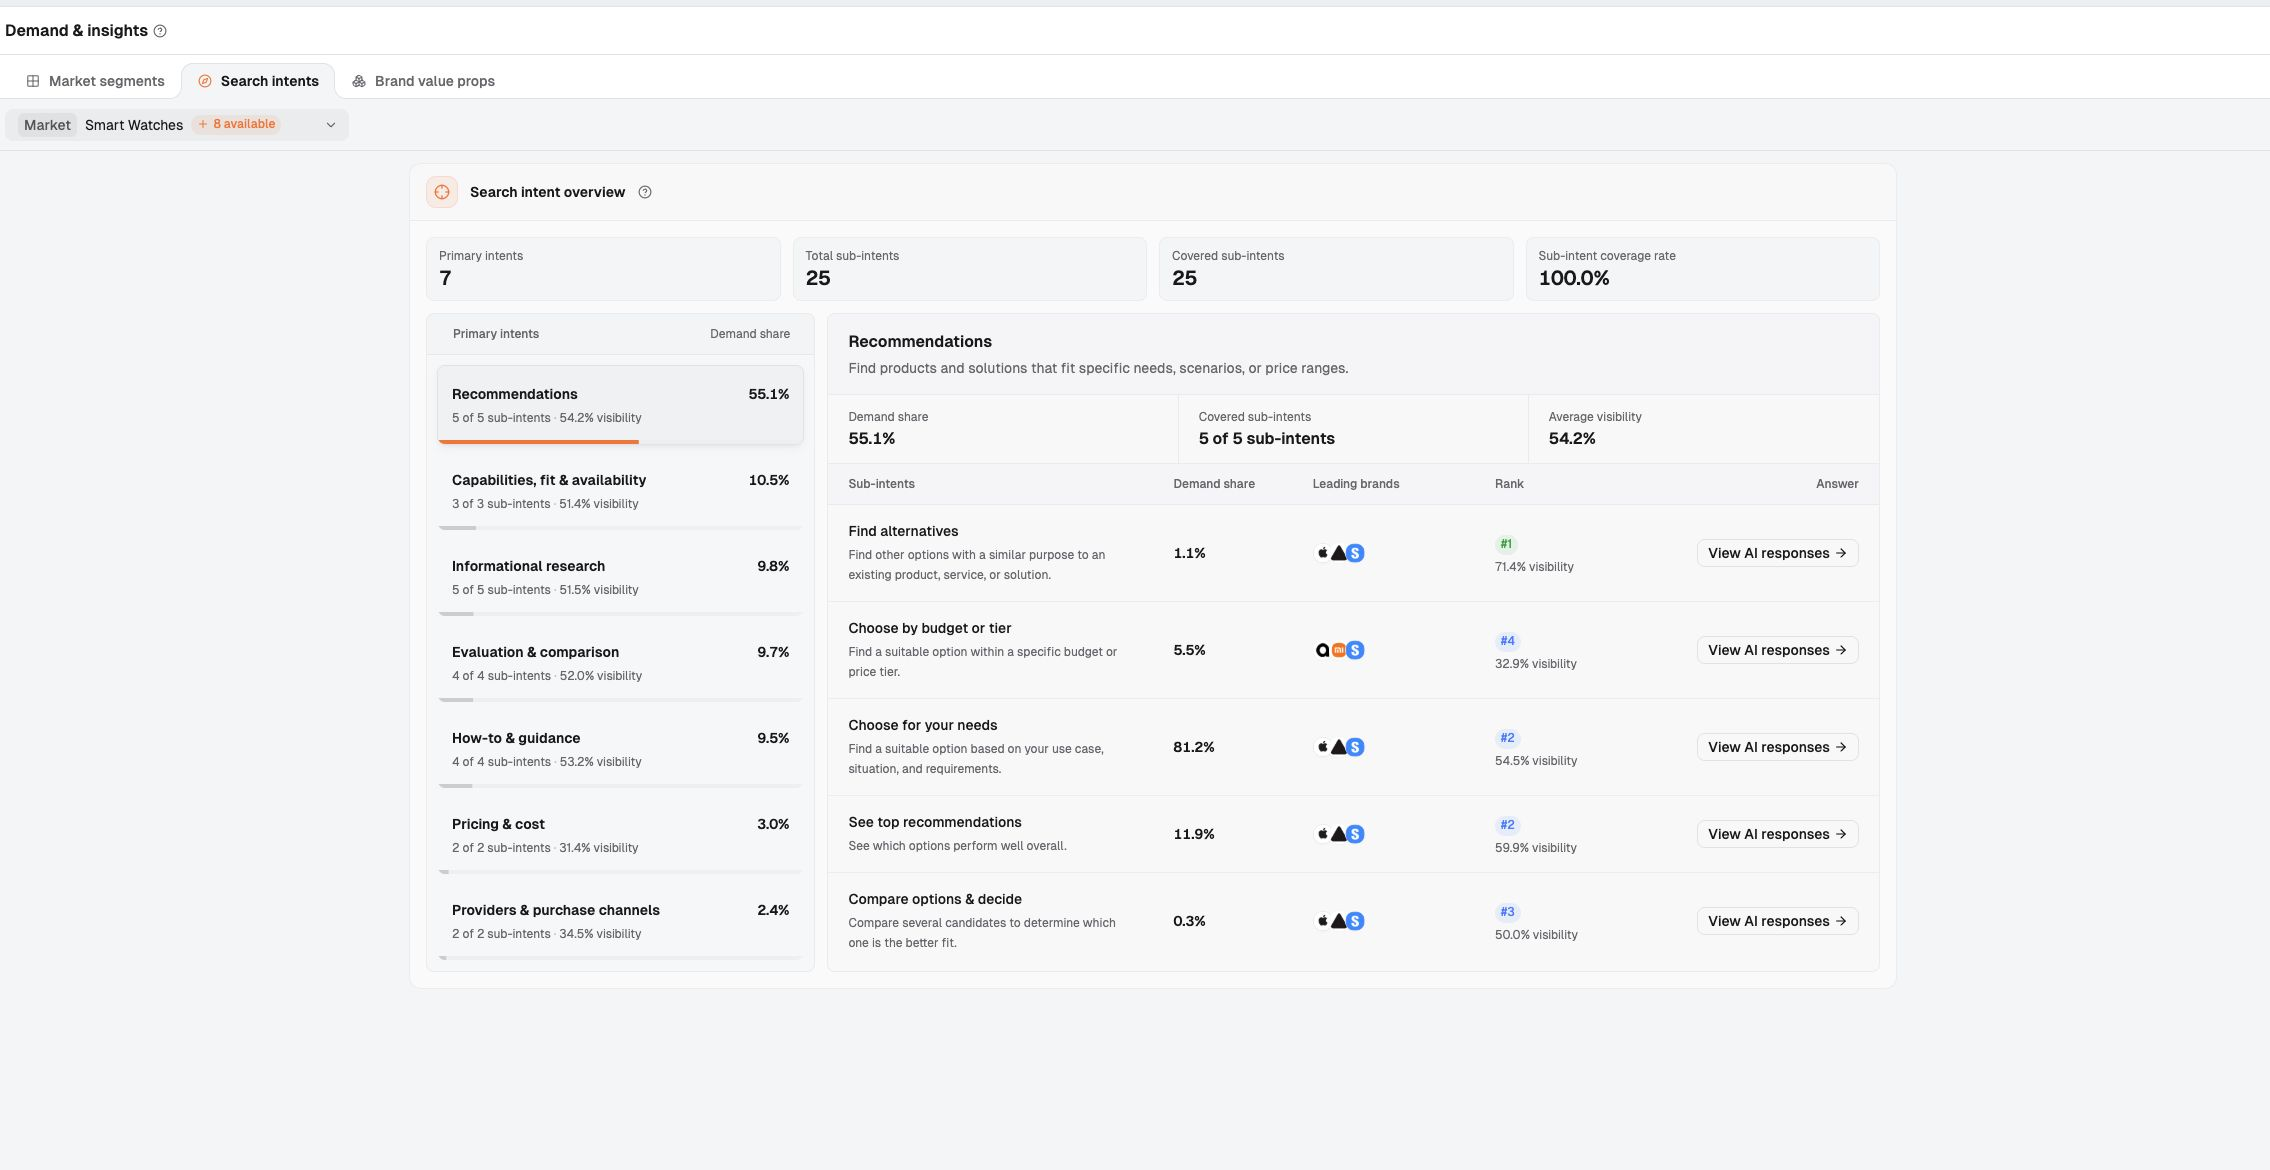
Dagenos Seite AI Search Intents ist um diese Idee herum aufgebaut (siehe Abbildung 2). Im Smart-Watches-Beispiel deckt Apple alle 25 Unterintentionen ab, eine Abdeckungsrate von 100 %. Aber innerhalb von Recommendations:
Find alternatives: Platz 1, 71,4 % Sichtbarkeit
See top recommendations: Platz 2, 59,9 % Sichtbarkeit
Choose by budget or tier: Platz 4, 32,9 % Sichtbarkeit
100 % Abdeckung heißt nur, dass die Marke in jeder Art von Frage vorkommt, nicht, dass sie in jeder Art führt.
Abbildung 2: Die Ansicht der Suchintentionen für den Smart-Watches-Markt im Apple-Workspace: 7 Hauptintentionen und 25 Unterintentionen, mit einer Abdeckungsrate der Unterintentionen von 100 %. Innerhalb von Recommendations steht Apple bei „Find alternatives“ auf Platz 1 (71,4 %) und bei „Choose by budget or tier“ auf Platz 4 (32,9 %). Der Nachfrageanteil beschreibt, wie sich die analysierten Fragen verteilen, nicht das gesamte Suchvolumen oder eine belegte Kaufnachfrage; das Bild zeigt den Berichtszeitraum nicht.
In Prompt-Level Visibility nennt Swetha Venkiteswaran von Pixis ein Beispiel: zwei Marken mit demselben Gesamtsichtbarkeitswert. Die eine taucht bei allen Arten von Fragen beständig auf; die andere ist bei allgemeinen Fragen stark, verschwindet aber, wenn Käufer nach Alternativen oder bestimmten Einsatzzwecken fragen. Ihre Durchschnitte sind identisch, ihre kommerziellen Positionen völlig verschieden. Der Gesamtwert sagt dir, wo du hinschauen musst; die einzelnen Fragen sagen dir, warum.
Es lohnt sich auch zu sagen, wann man nicht nach Szenario aufteilen sollte. Hat ein Szenario nur ein paar Dutzend Antworten, ist sein Auf und Ab größtenteils Zufall; beobachte es zusammen mit dem Rest, bis genug Daten zum Aufteilen da sind. Und wenn die Marke für diese Preisklasse oder diesen Einsatzzweck kein Produkt hat, braucht dieses Szenario keine eigene Baseline.
Die Tabelle fasst zusammen, wann welche Ansicht passt:
Ansicht
Wann sie passt
Was sie nicht zeigen kann
Markenebene
Die Produkte haben dieselben Fragen und Wettbewerber; die Entscheidung betrifft die Marke; Anteil oder Gewicht jedes Produkts ist fest
Ob ein bestimmtes Produkt gut läuft; ob eine Seitenänderung gewirkt hat
Nach Produkt
Unterschiedliche Wettbewerber, große Sichtbarkeitsunterschiede, unterschiedliche Verantwortliche und Website-Seiten oder ein Produkt mit kleinem Anteil
Welche Art von Käuferfrage innerhalb eines Produkts das Problem ist
Nach Szenario
Ein Produkt unterscheidet sich stark je nach Käuferfrage, und du brauchst den Unterschied, um zu entscheiden, welche Seite du änderst
Auf und Ab in Szenarien mit zu wenigen Antworten; Preisklassen oder Einsatzzwecke, die die Marke nicht bedient
7. Du hast die Website-Seiten eines Produkts aktualisiert und die Markenzahl stieg im Folgemonat – wie bestätigst du, dass sich dieses Produkt wirklich verbessert hat?
Kurze Antwort: Nimm nur die Fragen, die in beiden Zeiträumen gestellt wurden, auf denselben Plattformen und in denselben Regionen mit derselben Stichprobenzahl, und prüfe, ob die eigene Sichtbarkeit des Produkts gestiegen ist. Zerlege dann die Veränderung auf Markenebene in die Veränderung innerhalb jedes Produkts und die Veränderung im Fragenmix. Nur wenn das Produkt bei denselben Fragen gestiegen ist, kannst du sagen, dass es sich verbessert hat. Ob die Seitenänderung die Ursache war, ist eine eigene Frage, die du noch nicht klären kannst.
Zurück zu Samsung aus Abschnitt 1: Über alle Antworten gezählt fiel die Smartphone-Sichtbarkeit um 6,4 Punkte. Vergleicht man nur die Fragen, die in beiden Zeiträumen gestellt wurden (über die Prompt-ID abgeglichen, 1.431 Fragen), ist das Ergebnis ein völlig anderes:
Sichtbarkeit in Smartphone-Antworten
Alle Antworten
Dieselben, in beiden Zeiträumen gestellten Fragen
Samsung
81,1 % → 77,6 %
84,3 % → 84,9 %
Apple
56,3 % → 48,6 %
58,2 % → 55,1 %
Hier werden nur Antworten verwendet, die sich einer Prompt-ID zuordnen lassen, etwa 78 % der Smartphone-Antworten; deshalb weicht die Spalte „Alle Antworten“ leicht von den Zahlen in Abschnitt 1 ab.
Samsungs „Rückgang“ bei Smartphones kam fast vollständig von einem anderen Fragenset; bei denselben Fragen veränderte sich seine Sichtbarkeit kaum. Apple fiel insgesamt um 7,7 Punkte, bei denselben Fragen aber nur um etwa 3 Punkte. Im selben Zeitraum verschob sich auch der Plattformmix der Smartphone-Antworten: Geminis Anteil an den Antworten fiel von 46 % auf 27 %, während der von ChatGPT von 30 % auf 48 % stieg. Wer eine Änderung zwischen den beiden Zeiträumen anhand der Zahlen über alle Antworten beurteilt, kommt zum falschen Schluss.
Eine erneute Prüfung braucht deshalb vier Dinge:
Friere das Fragenset ein. Halte fest, zu welchem Produkt jede Frage gehört und ob sie den Markennamen enthält. Du kannst neue Fragen hinzufügen, vergleichst Zeiträume aber nur anhand der Fragen, die in beiden vorkommen.
Halte alles andere gleich. Plattformen, Regionen, Sprache, Stichprobenzahl pro Frage und Fensterlänge bleiben fest. Dieser Artikel behandelt die Aufteilung nach Plattform oder Region nicht, aber wenn sich diese Bedingungen ändern, sind die Zeiträume nicht vergleichbar.
Berichte zwei Dinge getrennt. Erstens die Veränderung des Produkts bei denselben Fragen; zweitens, wie viel der Veränderung auf Markenebene aus dem Fragenmix kam.
Protokolliere die Änderung. Wann sie vorgenommen wurde, welche Seite geändert wurde und was genau sich geändert hat.
In Dageno lassen sich die Prompts, Plattformen, Regionen und Wettbewerber, die du über die Zeit erneut prüfen willst, in den Monitoring-Einstellungen festlegen. Ein CSV-Import erfordert vier Spalten: prompt, platforms, regions und language. Keine davon ist ein Produktlabel, dein Team muss also in einer eigenen Tabelle festhalten, zu welchem Produkt jede Frage gehört. Laut den Einträgen in Dagenos Wissensdatenbank wurden nur der Einstellungsbildschirm und seine Eingaberegeln überprüft; das Absenden eines Imports, das Speichern und die tatsächliche Stichprobenziehung wurden nicht getestet. Für fortlaufendes Monitoring siehe Markensichtbarkeit über KI-Antworten hinweg verfolgen.
7.1 Die erneute Prüfung ist fertig – welche Schlussfolgerungen kommen in den Monatsbericht und welche werden als „noch nicht belegt“ festgehalten?
Zwei Arten von Schlussfolgerungen können in den Monatsbericht:
Bei denselben Fragen, Plattformen und Regionen: wie stark sich der Anteil der Antworten, die das Produkt erwähnen, verändert hat;
Wie viel der Veränderung auf Markenebene aus Veränderungen innerhalb der Produkte kam und wie viel aus dem Fragenmix.
Führe eine eigene Spalte „noch nicht belegt“ mit mindestens drei Punkten:
Ob der Zuwachs von der Seitenänderung kam. Wettbewerber, Drittquellen und die Modelle selbst können sich in der Zwischenzeit alle verändert haben.
Ob ein Ergebnis aus einem einzigen Zeitraum Bestand hat.
Ob höhere Sichtbarkeit mehr Anfragen oder Verkäufe bringt.
Hier ein Beispiel-Eintrag. Marke, Daten und Zahlen sind erfunden und zeigen nur, wie man ihn ausfüllt:
Punkt
Hypothetisches Beispiel (erfundene Zahlen)
Änderung
10. September: Laptop-Produktseite mit Einsatzszenarien, Bedingungen des Akkutests und einem Vergleich mit Modellen ähnlicher Preisklasse aktualisiert
Vergleichsumfang
Die 120 Laptop-Fragen, die in beiden Zeiträumen gestellt wurden; ChatGPT und Google AI Mode; USA und Deutschland; 5 Durchläufe pro Frage und Zeitraum; 14 Tage pro Zeitraum
Veränderung innerhalb des Produkts
Laptop-Sichtbarkeit bei diesen 120 Fragen: 8,0 % → 12,5 %
Veränderung der Zahl auf Markenebene
+1,6 Punkte: +0,9 vom Laptop selbst, +0,7 durch mehr Smartwatch-Fragen
Kommt in den Monatsbericht
Bei denselben Fragen stieg der Anteil der Antworten, die den Laptop erwähnen, um 4,5 Punkte
Noch nicht belegt
Dass die Seitenänderung den Anstieg verursacht hat; ob er im nächsten Zeitraum anhält; ob er Anfragen oder Verkäufe bringt
8. Jetzt, wo du weißt, dass die Markenzahl einzelne Produkte verdecken kann – welche Folgefragen wird dein Team stellen?
8.1 Wenn du dich für die Aufteilung nach Produkt entscheidest, ist feiner immer besser?
Nein. Je feiner du aufteilst, desto weniger Antworten hat jeder Teil und desto stärker springen die Zahlen zufällig. Wie oben erwähnt, braucht man etwa 686 Durchläufe pro Bedingung, um eine echte Erwähnungsrate von 10 % von einer von 15 % zu unterscheiden. Teile zuerst entlang von Wettbewerbern und Zuständigkeiten nach Produkt auf und zerlege Produkte erst dann weiter in Modelle oder Szenarien, wenn genug Daten vorliegen.
8.2 Du ordnest Fragen nach Produkt und eine Frage betrifft zwei Produkte – zu welchem Produkt gehört sie?
Pack sie in eine eigene Gruppe „produktübergreifende Fragen“, etwa für Fragen wie „Wie kombiniere ich ein Smartphone mit einer Smartwatch?“. Sie zählt zu keinem einzelnen Produkt; verfolge ihren Trend separat. Sonst wird dieselbe Antwort doppelt gezählt oder willkürlich einem Produkt zugeordnet.
8.3 Fragen mit Markennamen sind ins Fragenset gerutscht – sollen sie in die Markenzahl einfließen?
Zähle sie separat. Fragen mit Markennamen erwähnen die Marke fast immer, daher bläht das Untermischen die Gesamtzahl auf, und jede Änderung ihrer Anzahl bewegt sie. Wie du Markennamen, Produktnamen und Kategoriebegriffe in einem Fragenset kombinierst, erfährst du unter So baust du ein Prompt-Set für KI-Sichtbarkeit auf.
8.4 Wenn die Zahl jedes Produkts berechnet ist, soll die Markenzahl alle Antworten zusammenfassen oder feste Gewichte verwenden?
Verwende feste Gewichte. Fasst man die Antworten direkt zusammen, hängt das Ergebnis von Verschiebungen im Antwortanteil jedes Produkts ab, wie das Samsung-Beispiel zeigt. Du kannst die Gewichte auf die aktuellen Fragenanteile einfrieren oder sie nach der geschäftlichen Bedeutung jedes Produkts festlegen. Einmal festgelegt, halte sie in jedem Zeitraum gleich, damit Veränderungen der Gesamtzahl nur Veränderungen innerhalb der Produkte widerspiegeln.
8.5 Wenn KI-Antworten das Modell nennen, aber nicht die Marke, wird die Markenzahl dann zu niedrig ausgewiesen?
Das kann passieren. In der Stichprobe wurden etwa 14 % der Laptop-Antworten, die „MacBook“ erwähnten, nicht als Erwähnung von Apple erfasst. Prüfe die Originalantworten stichprobenartig mit der Methode aus Abschnitt 3 und kontrolliere dann die Erkennungsregeln des Tools, um zu entscheiden, ob diese Antworten zählen sollen.
8.6 Die KI-Sichtbarkeit eines Produkts ist gestiegen und deine Chefin oder dein Chef fragt, ob es sich besser verkauft – was antwortest du?
Das kannst du nicht behaupten. Sichtbarkeit ist der Anteil der KI-Antworten, die das Produkt erwähnen; sie misst weder Umsatz noch Marktanteil noch echtes Suchvolumen. Um die geschäftliche Wirkung zu beurteilen, vergleiche separat mit Anfrage-, Traffic- und Verkaufsdaten.
9. Du musst nächste Woche über KI-Sichtbarkeit berichten – welche Zahl solltest du zuerst aufschlüsseln?
Beginne mit der Sichtbarkeit auf Markenebene in diesem und im vorigen Zeitraum und verwende die Methode aus Abschnitt 2:
Teile die Antworten beider Zeiträume nach Produkt auf und berechne für jedes Produkt zwei Zahlen: Sichtbarkeit und Antwortanteil.
Zerlege die Gesamtveränderung in die Veränderung innerhalb jedes Produkts und die Veränderung im Fragenmix.
Achte auf drei Signale: ein Produkt, dessen eigene Sichtbarkeit fällt; ein Produkt, das seit Langem niedrig liegt, aber wenig Gewicht hat; und einen Gesamtzuwachs, der hauptsächlich aus dem Fragenmix kommt.
Taucht auch nur ein Signal auf, füge in deinem Bericht unter der Zahl auf Markenebene eine Zeile mit den Zahlen jedes Produkts hinzu und markiere das verdeckte Produkt. Entscheide dann zwei Dinge: ob es eine eigene Baseline braucht (Abschnitt 5) und ob es weiter nach Szenario aufgeteilt werden soll (Abschnitt 6).
Die Zahl auf Markenebene kann der Geschäftsführung weiterhin den Gesamttrend zeigen. Sie sollte nur nicht die einzige Grundlage dafür sein, zu beurteilen, ob ein Produkt gut läuft.
ThriveStack: AI visibility tracking and non-determinism, veröffentlicht am 4. Mai 2026 und aktualisiert am 28. September 2026 (laut Metadaten der Seite); abgerufen am 19. Oktober 2026. Die Zahl von 686 Durchläufen ist eine Schätzung des Artikels bei 95 % Konfidenz und 80 % Teststärke, kein Messergebnis; der Autor hat ein kommerzielles Interesse.
Odyssiant: Product Visibility vs Brand Visibility in AI Search, veröffentlicht am 9. Mai 2026 (laut Metadaten der Seite); abgerufen am 19. Oktober 2026. Anbieterstudie mit 5.356 Antworten von Februar bis April 2026; die Bewertungsmethode wurde im Studienzeitraum angepasst.
Samsung: Galaxy Book product page (US site), abgerufen am 19. Oktober 2026. Nur verwendet, um zu zeigen, dass die Marke eine Laptopreihe hat; die in jeder Region verkauften Modelle wurden nicht geprüft.
Dageno is the research and insights team at Dageno AI, publishing industry reports and expert analysis on AI Search Visibility, Generative Engine Optimization (GEO), and AI-powered search discovery.
 Alexa for Shopping