Finden Sie heraus, wo Ihre Marke im KI-Markt steht.
Ermitteln Sie die Wachstumschancen, die es wert sind, priorisiert zu werden, und zwar anhand der Marktnachfrage, des Wettbewerbsumfelds, der Markenwertversprechen und der Zitationsquellen.
So überwachen Sie Marken-Erwähnungen in KI-Antworten 2026
Ein praxisnaher Leitfaden zur Überwachung von Markenerwähnungen, Empfehlungen, Stimmung, Zitaten, Wettbewerbern und sachlicher Richtigkeit in KI-Antworten.
Um KI-Erwähnungen deiner Marke zu überwachen, stelle den für deinen Markt relevanten KI-Antwortsystemen eine stabile Auswahl an Käuferfragen, speichere jede Antwort und erfasse, ob deine Marke erwähnt, empfohlen und korrekt beschrieben wird und ob die Aussage durch eine Quelle belegt ist. Vergleiche dieselben Prompts im Zeitverlauf und mit denselben Wettbewerbern.
Verlasse dich nicht darauf, gelegentlich ChatGPT nach deinem Markennamen zu fragen. Personalisierte Sitzungen, wechselnde Antworten, uneinheitliche Prompts und manuelle Auswahlverzerrungen machen einmalige Prüfungen für Trendberichte ungeeignet.
Ein sinnvolles Monitoring-Programm braucht fünf Elemente:
eine repräsentative Prompt-Auswahl;
einheitliche Antwortsysteme, Länder, Sprachen und Ausführungsbedingungen;
Belege zu den Originalantworten und Quellen;
Metriken mit klar definierten Nennern;
einen Workflow zur Korrektur von Inhalten, Quellen und Produktinformationen.
Was gilt als KI-Markenerwähnung?
Eine KI-Markenerwähnung liegt vor, wenn eine KI-generierte Antwort dein Unternehmen, Produkt, deine Dienstleistung oder einen anerkannten Markennamen nennt. Sie kann in mehreren Formen auftreten:
Direkte Erwähnung: Die Antwort nennt deine Marke.
Empfehlung: Die Antwort präsentiert deine Marke als Option für einen bestimmten Bedarf.
Erwähnung im Vergleich: Deine Marke wird mit Alternativen oder Wettbewerbern verglichen.
Zugeschriebene Aussage: Die Antwort verknüpft ein Merkmal, einen Preis, eine Stärke oder eine Einschränkung mit deiner Marke.
Zitat/Quellenverweis: Die Antwort verlinkt auf eine Quelle, die mit deiner Marke verbunden ist, oder weist diese sichtbar als Quelle aus.
Indirekter Entitätsverweis: Die Antwort beschreibt ein Produkt oder eine Organisation, ohne den exakt überwachten Namen zu verwenden.
Erwähnungen und Quellenverweise solltest du getrennt erfassen. Eine Bewertung von Dritten kann zitiert werden, während deine Marke erwähnt wird. Oder deine eigene Seite wird als Quelle angegeben, ohne dass die Antwort deine Marke empfiehlt.
Warum traditionelles Markenmonitoring nicht ausreicht
Traditionelle Medienmonitoring-Tools finden veröffentlichte Seiten, Nachrichten, Social-Media-Beiträge und Forendiskussionen, die ein Keyword enthalten. Das Monitoring von KI-Antworten beobachtet, was ein generatives System nach Erhalt eines Prompts sagt.
Die beiden Datensätze überschneiden sich, beantworten aber unterschiedliche Fragen:
Monitoring-Ebene
Hauptfrage
Typische Belege
Web- und Social Listening
Wo wurde öffentlich über die Marke gesprochen?
Beitrag, Artikel, Bewertung oder Kommentar
Suchperformance
Wurde eine Seite bei Google angezeigt und hat sie Klicks erzielt?
Eine Marke kann mehr KI-Erwähnungen erhalten, ohne Referral-Traffic zu bekommen, da viele Nutzer nie auf eine Quelle klicken. Sie kann auch KI-Traffic aus Antworten erhalten, in denen die Marke nicht sichtbar genannt wird. Berichte zu diesen Ebenen sollten getrennt ausgewiesen werden.
Schritt 1: Lege die zu überwachenden Marken und Entitäten fest
Erstelle vor dem Erfassen der Antworten ein Entitätsverzeichnis. Nimm Folgendes auf:
offizielle Unternehmens- und Produktnamen;
gängige Abkürzungen und frühere Namen;
Domainnamen und unverwechselbare Produktbegriffe;
häufige Schreibfehler;
Namen, die mit einem anderen Unternehmen oder einem gewöhnlichen Wort verwechselt werden können;
direkte Wettbewerber und Substitute.
Die Entitätsauflösung verhindert falsch-positive Treffer. Ein Tracking-Tool sollte das Wort „Linear“ nicht als Softwareunternehmen zählen, sofern der Kontext der Antwort diese Interpretation nicht stützt. Prüfe mehrdeutige Treffer während der Baseline manuell.
Schritt 2: Erstelle eine Prompt-Auswahl, die reale Entscheidungen abbildet
Erstelle die gesamte Prompt-Liste nicht ausschließlich anhand von Keywords mit hohem Suchvolumen. Fragen an KI-Systeme sind oft länger, bedingt formuliert und konversationell. Decke den gesamten Entscheidungsprozess ab:
Prompt-Gruppe
Beispiel
Warum sie wichtig ist
Kategorie entdecken
„Welche Tools erfassen die Markensichtbarkeit in der KI-Suche?“
Prüft die Zuordnung zur Kategorie
Anwendungsfall
„Bester KI-Erwähnungs-Tracker für ein B2B-SaaS-Team“
Prüft den Product-Market-Fit
Vergleich
„Dageno vs. [Wettbewerber] für das Citation-Tracking“
Prüft die Differenzierung
Alternative
„Alternativen zu [Wettbewerber] für GEO in mehreren Märkten“
Erfasst die Nachfrage nach Alternativen
Funktion
„Welche Tools erfassen Quell-URLs und Sentiment?“
Prüft die Genauigkeit der Funktionsbeschreibung
Risiko oder Einwand
„Eignet sich [Marke] für ein Enterprise-Team?“
Zeigt Vertrauen und Positionierung
Preis oder Kauf
„Preisgünstige KI-Sichtbarkeitstools mit Team-Reporting“
Prüft die kommerzielle Sichtbarkeit
Markenvalidierung
„Was sind die Vor- und Nachteile von [Marke]?“
Zeigt Narrative und sachliche Fehler auf
Gruppiere Prompts nach Persona, Produkt, Funnel-Phase, Branche, Land und Sprache. Ein einzelner zusammengefasster Score kann verschleiern, dass eine Marke bei Informationsfragen gewinnt, bei Kaufentscheidungen aber nicht auftaucht.
Beginne mit 50–100 Prompts für einen Markt. Erweitere die Auswahl erst, wenn das Team die Ergebnisse prüfen und darauf reagieren kann.
Schritt 3: Standardisiere die Erfassungsbedingungen
Erfasse das Antwortsystem, das Modell oder die Antwortoberfläche, das Land, die Sprache, das Datum, die Uhrzeit, den Kontostatus und den Prompt-Text. Wenn ein Tool Einstellungen für den Standort oder eine aktuelle Suche anbietet, dokumentiere sie.
KI-Antworten variieren. Eine einzelne Antwort ist eine Beobachtung, kein dauerhafter Rang. Nutze wiederholte Durchläufe oder eine ausreichend große, stabile Prompt-Auswahl, vergleiche Zeiträume und leite keine bedeutende Verbesserung aus einer einzelnen geänderten Antwort ab.
Für manuelles Monitoring kannst du eine Tabelle mit folgenden Spalten verwenden:
Feld
Beispiel
Datum des Durchlaufs
2026-09-11
Antwortsystem/-oberfläche
ChatGPT-Suche
Land/Sprache
Vereinigte Staaten / Englisch
Prompt-ID
CMP-014
Prompt-Text
Exakt verwendete Frage
Marke erwähnt
Ja / Nein
Position der Erwähnung
An erster Stelle / Shortlist / beiläufige Erwähnung
Empfohlen
Ja / Nein / Bedingt
Sentiment
Positiv / neutral / negativ / gemischt
Problem mit der Genauigkeit
Beschreibung der falschen Aussage
Zitierte Domains
Exakte Domains
Zitierte URLs
Exakte Seiten
Erwähnte Wettbewerber
Namen und Positionen
Originalantwort
Gespeicherter Text oder Link zum Beleg
Schritt 4: Miss die richtigen Metriken für KI-Erwähnungen
Erwähnungsrate
Die Erwähnungsrate ist der Prozentsatz der relevanten erfassten Antworten, in denen die Marke genannt wird. Definiere vor der Berichterstattung, was als „relevant“ gilt. Wenn bei 80 von 100 Prompts die Marke tatsächlich auftauchen könnte und sie in 20 davon erscheint, beträgt die Rate 25 %, nicht 20 %.
Empfehlungsrate
Die Empfehlungsrate misst, wie oft die Marke aktiv als Option präsentiert wird, nicht nur, wie oft sie genannt wird. Eine negative Warnung oder beiläufige Erwähnung sollte nicht als Empfehlung zählen.
Share of Voice der Erwähnungen
Der Share of Voice vergleicht die Erwähnungen deiner Marke mit einer festgelegten Gruppe von Wettbewerbern in denselben Prompt-Durchläufen. Segmentiere die Ergebnisse nach Prompt-Gruppe, damit Fragen zur Markenbekanntheit mit hohem Volumen eine schwache Kaufabsicht nicht überdecken.
Platzierung in der Antwort
Erfasse, ob die Marke an erster Stelle, in einer Shortlist, unterhalb der Wettbewerber oder nur in einer Fußnote erscheint. Die Platzierung ist kein allgemeingültiger „Rang“, hilft aber dabei, prominente Empfehlungen von beiläufigen Erwähnungen zu unterscheiden.
Sentiment und Einordnung
Das Sentiment sollte zusammen mit der jeweiligen Aussage geprüft werden. „Leistungsstark, aber teuer“ ist gemischt und enthält Informationen zur Positionierung, die sich durch eine bloße Einstufung als positiv oder negativ nicht erfassen lassen.
Citation-Rate und Quellenanteil
Erfasse, ob die Antwort auf eigene Seiten, Seiten Dritter, Seiten von Wettbewerbern oder auf keine sichtbare Quelle verweist. Der Quellenanteil zeigt, welche Domains die Antworten über die überwachte Prompt-Auswahl hinweg wiederholt prägen.
Genauigkeitsrate
Miss den Prozentsatz der markenbezogenen Antworten, die keine wesentlichen sachlichen Fehler enthalten. Preise, Verfügbarkeit, Integrationen, Produktnamen und geografische Abdeckung verdienen besondere Aufmerksamkeit.
Schritt 5: Analysiere, warum stattdessen Wettbewerber erwähnt werden
Prüfe bei jedem Prompt mit hoher Kaufabsicht, bei dem ein Wettbewerber erscheint und deine Marke nicht, vier Ebenen:
Eigene Inhalte: Hast du eine crawlbare Seite, die die Frage direkt beantwortet?
Belege: Bietet die Seite konkrete, aktuelle und überprüfbare Informationen?
Quellen Dritter: Welche Bewertungen, Publikationen, Verzeichnisse oder Communities stützen den Wettbewerber?
Entitätsklarheit: Wird deine Marke konsistent derselben Kategorie zugeordnet und mit korrekten Produktinformationen beschrieben?
Erstelle nicht automatisch einen neuen Artikel. Die richtige Maßnahme kann darin bestehen, eine Produktseite zu aktualisieren, sich überschneidende Inhalte zusammenzuführen, Crawl-Regeln zu korrigieren, die Dokumentation zu berichtigen, interne Links zu verbessern oder legitime Erwähnungen durch Dritte zu gewinnen.
Schritt 6: Nutze Dageno für ein wiederholbares Monitoring
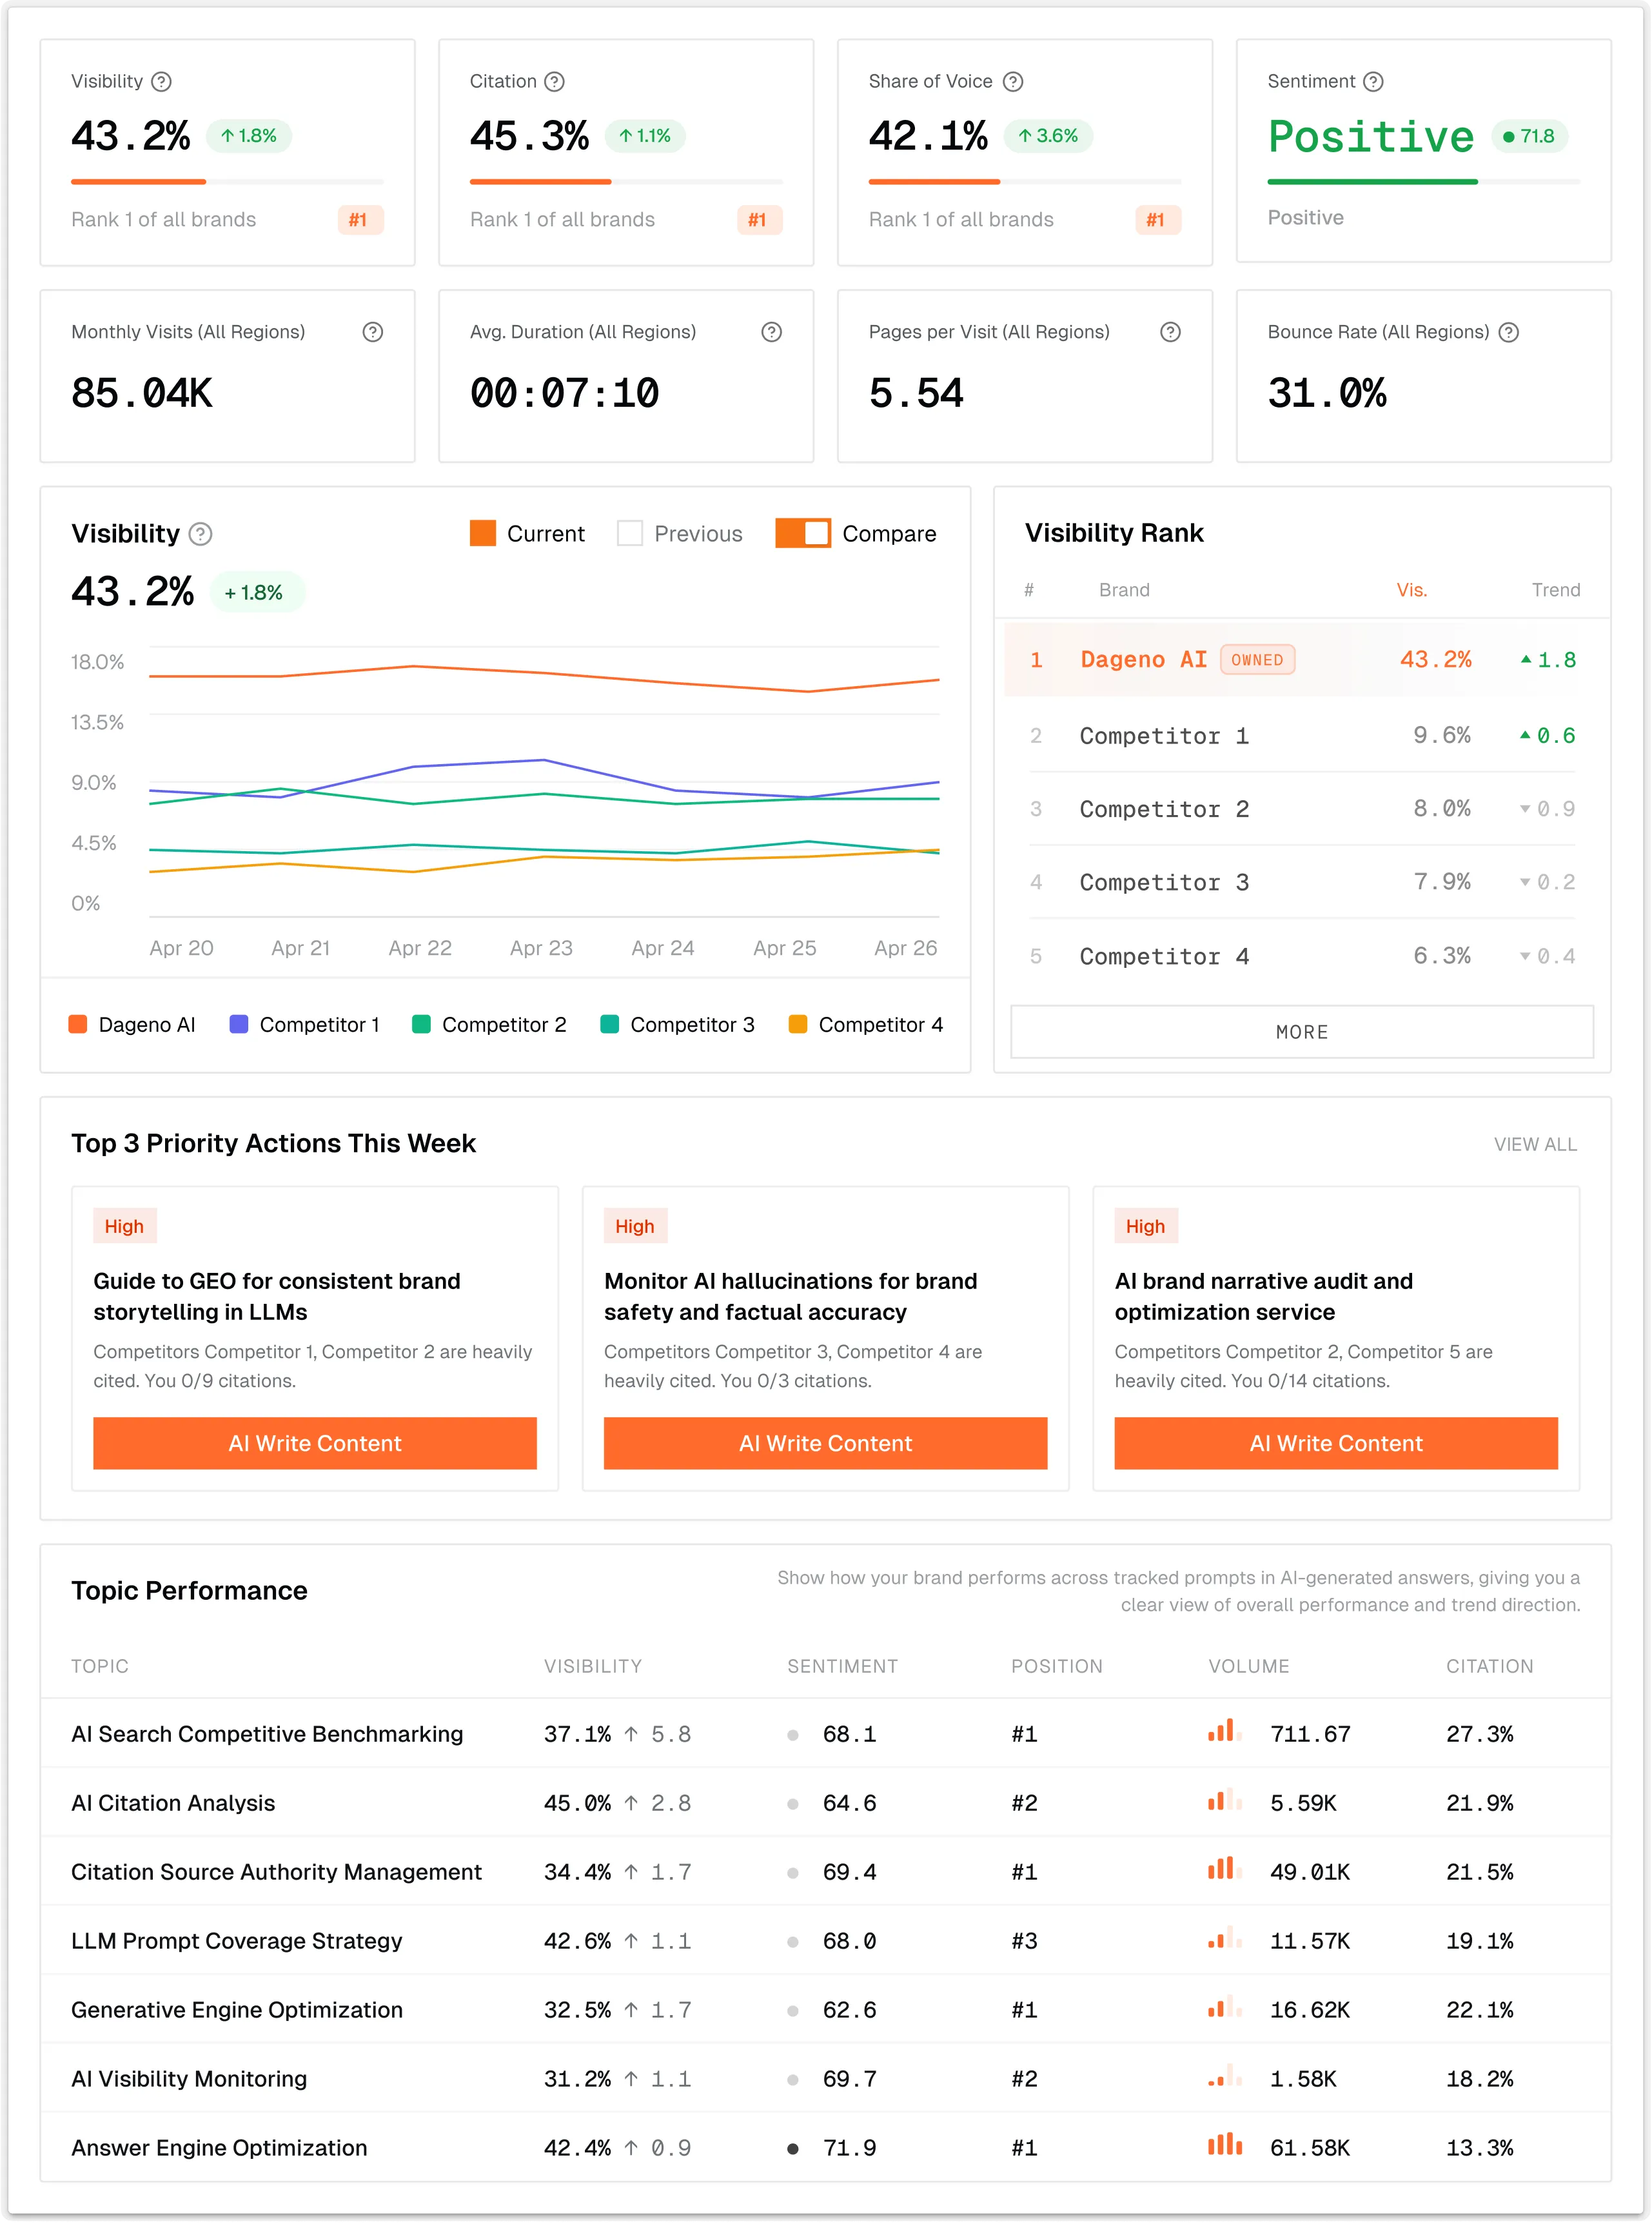
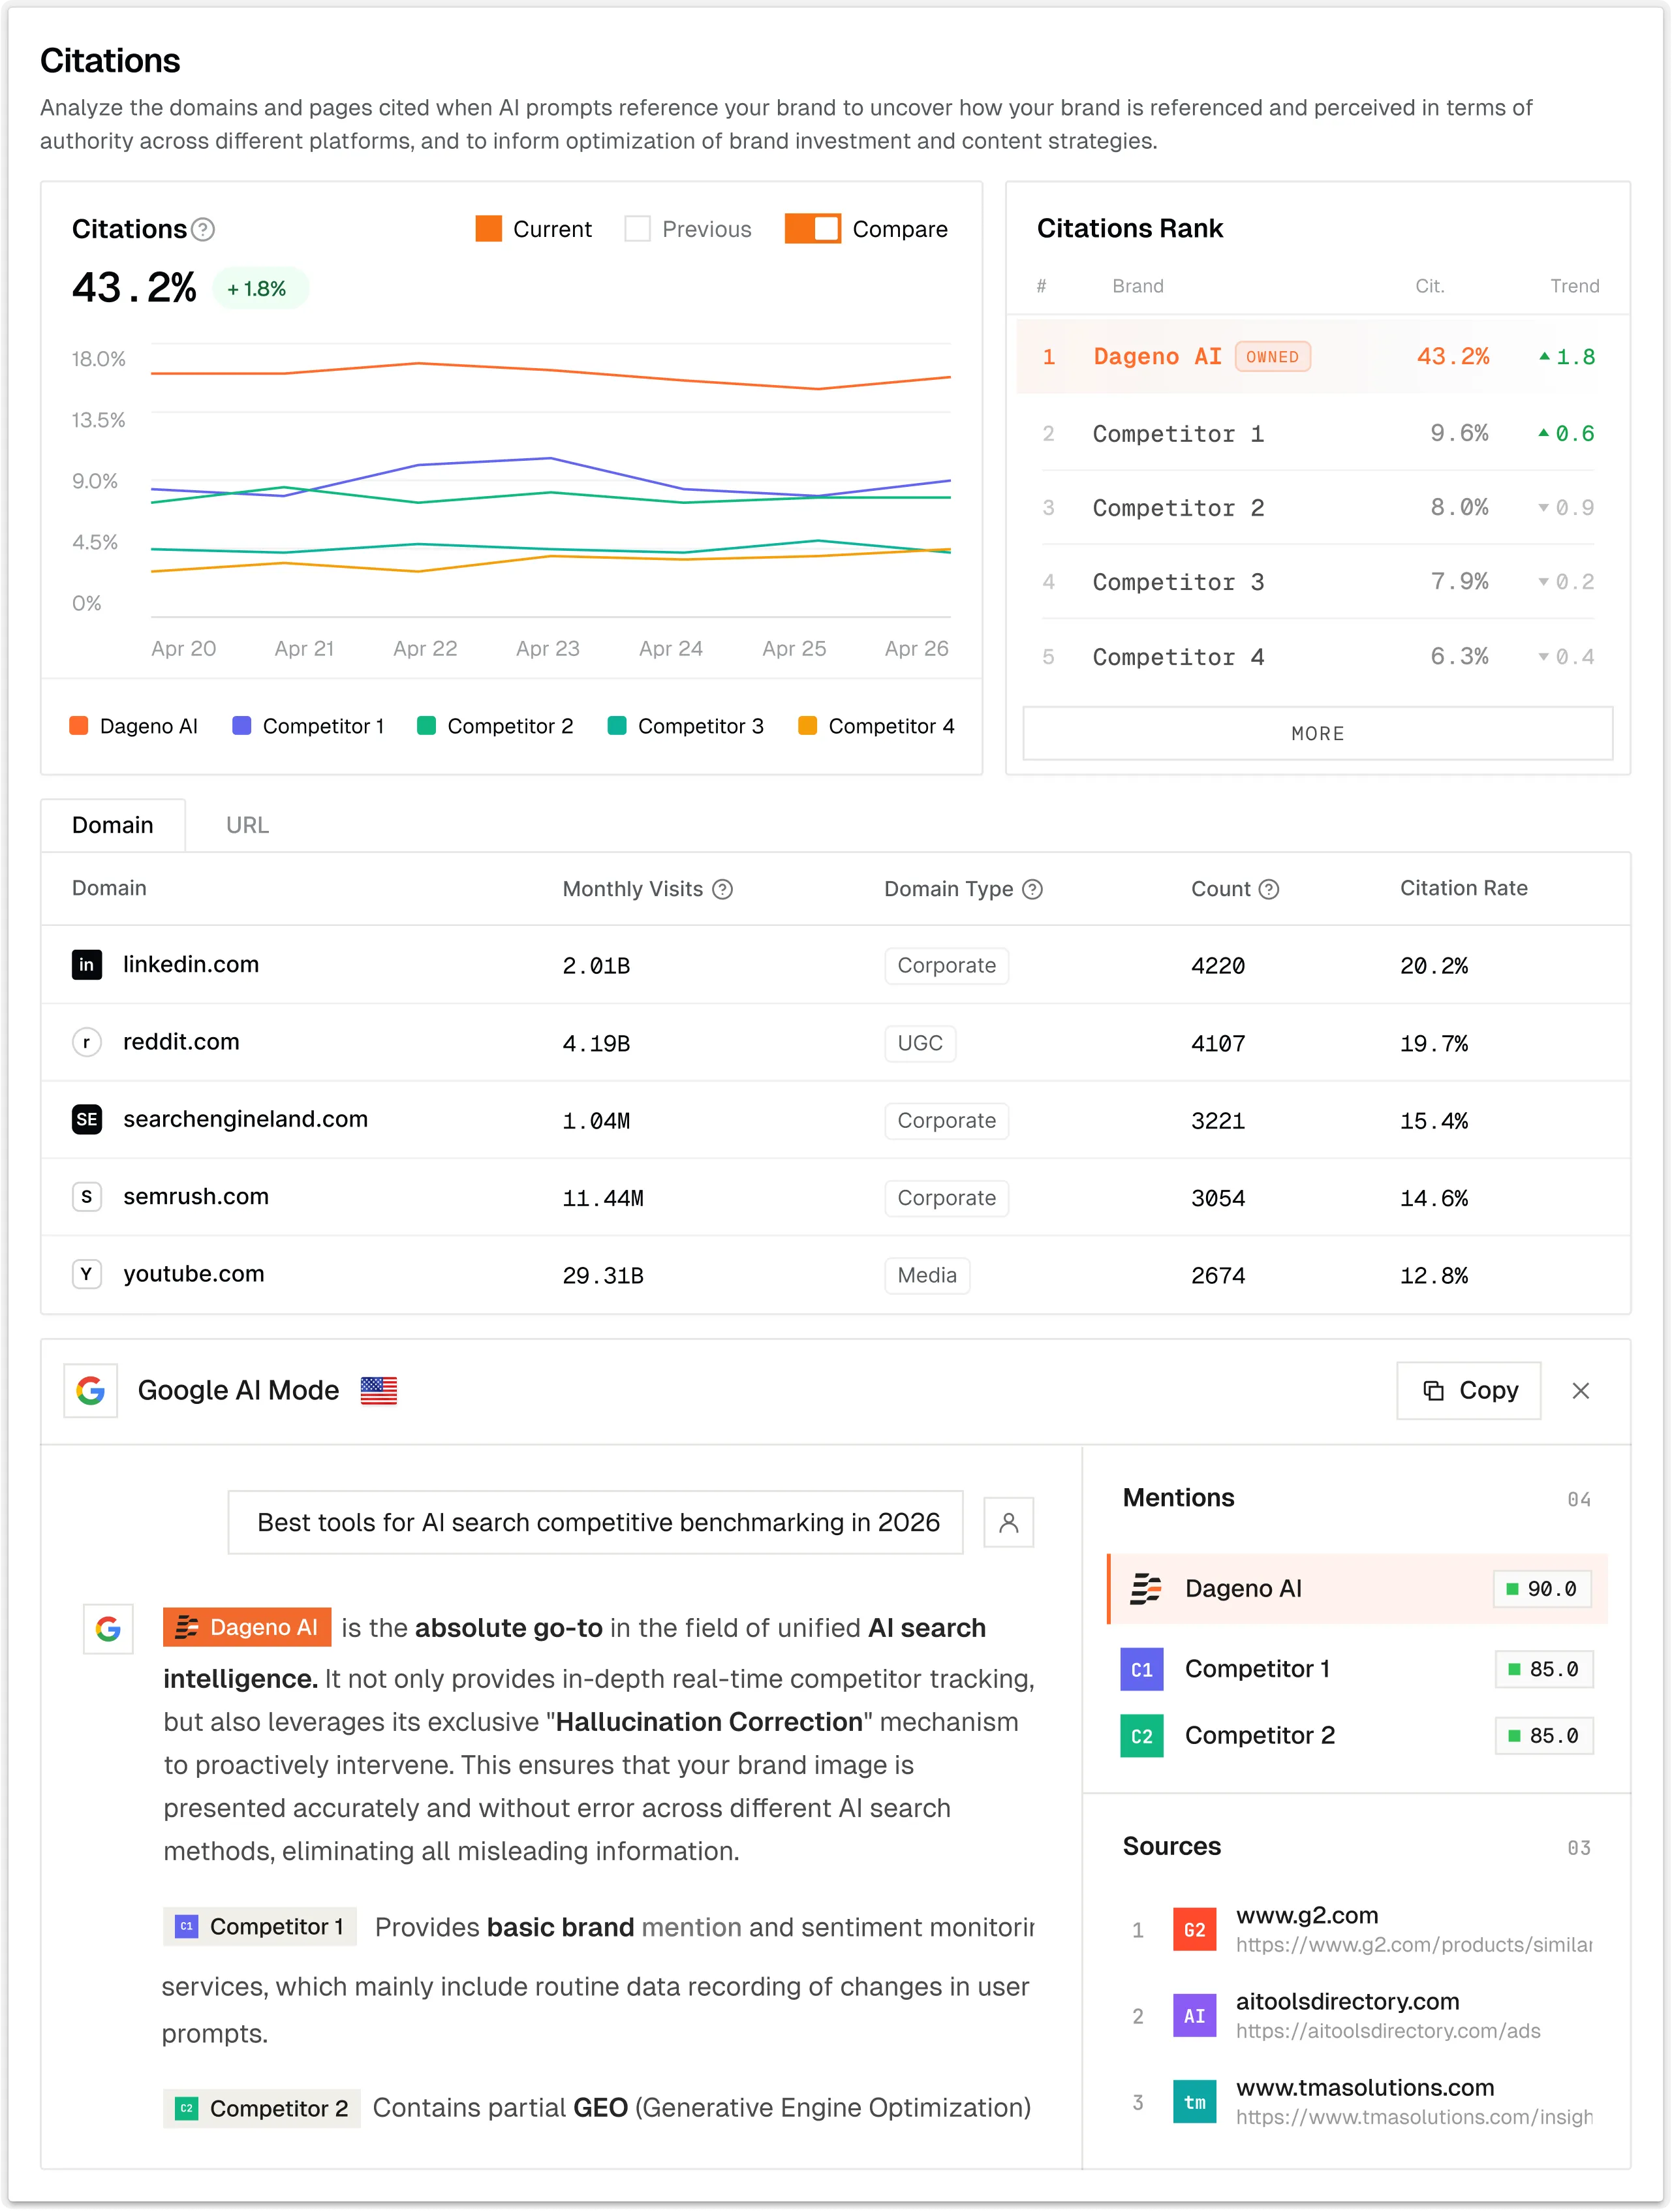
Dageno AI unterstützt Teams dabei, die Präsenz ihrer Marke und ihrer Wettbewerber auf KI-Antwortoberflächen zu überwachen, Prompts und Quellenverweise zu prüfen, Lücken zu identifizieren und die Ergebnisse in priorisierte GEO-Maßnahmen zu überführen.
Der hilfreiche Workflow lautet nicht „Score ansehen“. Er sieht so aus:
die konkreten Prompts mit hoher Kaufabsicht identifizieren, bei denen die Marke fehlt;
die Antwort und die zitierten Quell-URLs prüfen;
die Einordnung und Belege der Wettbewerber vergleichen;
die Lücke als technisch, inhaltlich, entitätsbezogen oder autoritätsbezogen klassifizieren;
die passende Maßnahme zuweisen und umsetzen;
dieselbe Prompt-Gruppe erneut ausführen und dokumentieren, was sich geändert hat.
So untersuchst du negative oder ungenaue Erwähnungen
Nutze einen wiederholbaren Prozess zur Bearbeitung von Vorfällen:
Speichere den exakten Prompt, die Antwort, das Antwortsystem, den Markt, den Zeitstempel und die Quellenverweise.
Prüfe, ob die Aussage objektiv falsch, veraltet, subjektiv oder lediglich ungünstig ist.
Ermittle die Quelle, die der Aussage wahrscheinlich zugrunde liegt.
Korrigiere zuerst die maßgebliche eigene Seite, wenn deine eigenen Informationen unklar sind.
Bitte Drittanbieter-Publisher um eine legitime Korrektur, wenn ein sachlicher Fehler vorliegt.
Stärke unabhängige Belege, statt Kritik unterdrücken zu wollen.
Führe die betroffene Prompt-Gruppe über mehrere Erfassungszeiträume hinweg erneut aus.
Erfinde keine positiven Bewertungen, spame keine Foren und veröffentliche nicht zahlreiche nahezu identische Seiten mit Gegenargumenten. Diese Taktiken bergen Reputations- und Suchqualitätsrisiken, ohne eine andere KI-Antwort zu garantieren.
So verknüpfst du das Monitoring mit Analytics
KI-Erwähnungsdaten ermöglichen keine vollständige Attribution. Kombiniere sie mit:
Suchanfragen in der Google Search Console und Berichten zu generativer KI, sofern verfügbar;
KI-Referral-Sitzungen und Landingpages in GA4;
Server-Logs relevanter Crawler und Referral-User-Agents;
CRM-Quellen- und Assisted-Conversion-Daten;
der Nachfrage nach Markensuchen;
Erkenntnissen von Kunden und aus Verkaufsgesprächen zu Entdeckungskanälen.
Verwende Anmerkungen zu Veröffentlichungsdaten, technischen Korrekturen, Produkteinführungen und PR-Aktivitäten. Eine Korrelation nach einer Maßnahme ist ein nützlicher Hinweis. Behaupte jedoch nicht, dass ein einzelnes Content-Update eine Änderung der Antwort verursacht hat, sofern das Experiment diese Schlussfolgerung nicht stützt.
Ein 30-Tage-Plan für das Monitoring von KI-Erwähnungen
Woche 1: Baseline erstellen
Entitäten, Wettbewerber, Märkte und 50–100 Prompts festlegen.
Dieselben Prompts über die priorisierten Antwortsysteme ausführen.
Markenzuordnung manuell überprüfen und Originalantworten speichern.
Erwähnungs-, Empfehlungs-, Citation-, Genauigkeits- und Wettbewerberraten berechnen.
Woche 2: Quellen und Lücken erfassen
Wiederholt zitierte Domains und exakte URLs identifizieren.
Lücken nach Suchintention und kommerzieller Bedeutung segmentieren.
Korrekturen eigener Inhalte von Maßnahmen zur Stärkung der Autorität durch Dritte trennen.
Ungenaue Produktinformationen und negative Einordnungen kennzeichnen.
Woche 3: Kontrollierte Verbesserungen umsetzen
Eine maßgebliche Produktseite aktualisieren.
Eine leistungsstarke Vergleichs- oder Anwendungsfallseite verbessern.
Ein technisches Crawl- oder internes Verlinkungsproblem beheben.
Eine legitime Gelegenheit für eine Quelle durch Dritte verfolgen.
Woche 4: Erneut ausführen und berichten
Dieselben Prompts und Bedingungen wiederverwenden.
Originalantworten und segmentierte Metriken vergleichen.
Änderungen, Unsicherheiten und ungelöste Probleme dokumentieren.
Den nächsten Sprint anhand der verbleibenden Lücken mit dem größten Wert planen.
Häufige Monitoring-Fehler
Nur den eigenen Markennamen prüfen, statt Kategorie- und Kauf-Prompts zu verwenden.
Prompts zwischen Zeiträumen ändern und die Ergebnisse trotzdem als Trend darstellen.
Erwähnung, Empfehlung, Quellenverweis und Referral als dasselbe Ereignis behandeln.
Exakte Quell-URLs ignorieren.
Sichtbarkeitsscores verschiedener Anbieter vergleichen, ohne die Methoden aufeinander abzustimmen.
Sentiment automatisiert erfassen, ohne wichtige Antworten manuell zu prüfen.
Für jeden fehlenden Prompt einen neuen Artikel veröffentlichen.
Eine Verbesserung anhand einer einzelnen günstigen Antwort melden.
Länder und Sprachen außerhalb des Standardmarkts ignorieren.
Weiterführende Ressourcen
Mit diesen Dageno-Leitfäden kannst du den Workflow vertiefen:
Fange klein an und sorge dafür, dass sich die Baseline reproduzieren lässt. Eine stabile Auswahl kommerziell relevanter Prompts, Belege zu Originalantworten, klar definierte Metriken, Kontext zu Wettbewerbern und ein dokumentiertes Maßnahmenprotokoll sind nützlicher als ein großer, nicht transparenter Sichtbarkeitsscore.
Überwache, was KI-Systeme sagen, aber auch, warum sie es möglicherweise sagen: die zitierten Seiten, Entitätsinformationen, Narrative Dritter und den technischen Zugriff. Das Programm wird wertvoll, wenn aus diesen Beobachtungen gezielte Maßnahmen entstehen und dieselben Prompt-Gruppen erneut gemessen werden.
Häufig gestellte Fragen
Kann ich KI-Markenerwähnungen kostenlos überwachen?
Ja. Ein Team kann manuell eine kleine Prompt-Auswahl durchlaufen und die Antworten in einer Tabelle erfassen. Das eignet sich für eine Baseline, wird aber schwierig, wenn die Ergebnisse regelmäßig über verschiedene Antwortsysteme, Länder, Sprachen und Zeiträume hinweg erfasst werden sollen.
Wie oft sollte ich KI-Erwähnungen überwachen?
Für viele Teams eignen sich eine wöchentliche operative Prüfung und eine vertiefte monatliche Analyse. Produkteinführungen, Reputationsvorfälle und sich schnell verändernde Märkte können häufigere Prüfungen erfordern.
Erfasst Google Alerts Erwähnungen in ChatGPT?
Nein. Google Alerts kann neu indexierte Webseiten mit ausgewählten Begriffen anzeigen. Es liefert jedoch keine vollständige Aufzeichnung generierter Antworten oder promptbezogener Markenerwähnungen in ChatGPT.
Warum weicht mein Tracking-Tool von einer manuellen ChatGPT-Prüfung ab?
Das Tool und die manuelle Sitzung verwenden möglicherweise unterschiedliche Modellversionen, Sucheinstellungen, Standorte, Kontokontexte, Ausführungszeiten oder Prompts. Vergleiche die Originalantwort und die Erfassungsbedingungen, bevor du die Abweichung als Fehler bewertest.
Kann das Monitoring von KI-Erwähnungen die Umsatzwirkung nachweisen?
Nicht allein. Kombiniere Erwähnungsdaten mit Referral-Daten, der Search Console, Analytics, CRM-Belegen und Kundenforschung. Viele durch KI beeinflusste Entscheidungen führen zu keinem nachverfolgbaren Klick auf eine Quelle.
About the Author
Aktualisiert von
Ye Faye
Ye Faye is an SEO and AI growth executive with extensive experience spanning leading SEO service providers and high-growth AI companies, bringing a rare blend of search intelligence and AI product expertise. As a former Marketing Operations Director, he has led cross-functional, data-driven initiatives that improve go-to-market execution, accelerate scalable growth, and elevate marketing effectiveness. He focuses on Generative Engine Optimization (GEO), helping organizations adapt their content and visibility strategies for generative search and AI-driven discovery, and strengthening authoritative presence across platforms such as ChatGPT and Perplexity
 Alexa for Shopping