브랜드 전체 AI 가시성은 답변 수로 가중되기 때문에, 약한 제품이 오르는 수치 속에 숨을 수 있습니다. 언제 브랜드, 제품, 장면별로 봐야 하는지 알아보세요.
12,000 이상의 틈새 시장을 탐색해 보세요.
업데이트한 사람
Nov 05, 2026에 업데이트됨
브랜드 전체 AI 가시성이 오르고 있다고 해서 모든 제품이 오르고 있는 것은 아닙니다. 브랜드 전체 AI 가시성은 모든 제품의 질문에 대한 답변을 한데 모아 계산합니다. 질문이 가장 많은 제품이 가장 큰 비중을 차지합니다. 질문이 적은 제품은 가시성이 떨어지거나 AI가 거의 언급하지 않아도 전체 수치에 드러나지 않습니다. 또 제품별 질문 수나 질문별 샘플링 횟수가 바뀌면 전체 수치는 그것만으로도 움직입니다. 한 제품의 상승이 다른 제품의 부재를 가리고 있는지 알려면, 같은 질문과 같은 기간으로 전체 변화를 두 부분으로 나누세요. 각 제품 자체의 가시성 변화와, 각 제품이 전체 답변에서 차지하는 비중의 변화입니다.
직접적인 이유는 브랜드 전체 AI 가시성이 가중 평균이기 때문입니다. 모니터링하는 모든 질문의 답변을 모아 "브랜드를 언급한 답변 ÷ 전체 답변"을 계산합니다. 각 제품의 비중은 질문 세트에 그 제품의 질문이 몇 개 있고, 그 질문들이 답변을 얼마나 모았는지에 따라 정해집니다. 비중이 큰 제품이 조금 오르면 전체 수치도 함께 오릅니다. 비중이 작은 제품이 떨어지거나 아예 언급되지 않아도 전체 수치는 거의 움직이지 않습니다.
Dageno가 세 가지 예시 시장(스마트폰, 노트북, 스마트워치)에서 수집한 과거 샘플의 Apple을 보겠습니다. Apple과 Samsung은 여기서 공개된 예시로 등장하며, Dageno의 고객이 아닙니다. 2026년 8월 3일~19일 동안 Apple은 스마트폰 답변의 53.4%(12,807건), 노트북 답변의 43.5%(9,578건), 스마트워치 답변의 61.6%(3,301건)에서 언급되었습니다. 합치면 50.8%입니다. 스마트워치 답변은 전체의 13%에 불과했습니다. 그래서 Apple의 스마트워치 가시성이 10%p 떨어져도 전체 수치는 약 1.3%p만 떨어집니다. 보고서에서는 정상적인 변동으로 넘기기 쉬운 폭입니다.
두 번째 이유는 더 알아차리기 어렵습니다. 각 제품에서 나오는 답변의 비중이 바뀌면, 어떤 제품도 실제로 나아지지 않았는데 전체 수치가 바뀝니다. 답변 수는 두 가지에 따라 정해집니다. 질문을 몇 개 하느냐, 그리고 질문마다 답변을 몇 개 모으느냐입니다. 같은 샘플의 Samsung을 보겠습니다. 세 시장의 답변을 합쳤는데, 이는 세 제품의 질문이 섞인 하나의 질문 세트를 쓰는 것과 같습니다. 그리고 Samsung의 브랜드 전체 가시성을 계산했습니다. 기간 1은 8월 3일~10일, 기간 2는 8월 11일~19일입니다. 먼저 원래 건수입니다:
| 제품 | 기간 1 답변 수 | 기간 1 Samsung 언급 답변 수 | 기간 2 답변 수 | 기간 2 Samsung 언급 답변 수 |
|---|---|---|---|---|
| 스마트폰 | 7,215 | 5,788 | 5,592 | 4,130 |
| 노트북 | 6,066 | 198 | 3,512 | 162 |
| 스마트워치 | 1,360 | 634 | 1,941 | 907 |
| 합계 | 14,641 | 6,620 | 11,045 | 5,199 |
비율은 이 건수에서 바로 계산됩니다:
| 지표 | 기간 1 | 기간 2 | 변화(%p) |
|---|---|---|---|
| 브랜드 전체(세 시장 합산) | 45.2% (6,620 ÷ 14,641) | 47.1% (5,199 ÷ 11,045) | +1.9 |
| 스마트폰 답변 내 가시성 | 80.2% (5,788 ÷ 7,215) | 73.9% (4,130 ÷ 5,592) | −6.4 |
| 노트북 답변 내 가시성 | 3.3% (198 ÷ 6,066) | 4.6% (162 ÷ 3,512) | +1.3 |
| 스마트워치 답변 내 가시성 | 46.6% (634 ÷ 1,360) | 46.7% (907 ÷ 1,941) | +0.1 |
| 전체 답변 중 스마트폰 비중 | 49.3% | 50.6% | +1.3 |
| 전체 답변 중 노트북 비중 | 41.4% | 31.8% | −9.6 |
| 전체 답변 중 스마트워치 비중 | 9.3% | 17.6% | +8.3 |
참고: 변화는 반올림 전 값으로 계산했습니다.
스마트폰은 6.4%p 떨어졌는데 브랜드 전체 수치는 1.9%p 올랐습니다. 이유는 마지막 세 줄에 있습니다. 기간 2에는 Samsung이 거의 언급되지 않는 노트북 답변이 6,066건에서 3,512건으로 줄었고, 비중은 41.4%에서 31.8%로 떨어졌습니다. Samsung이 그럭저럭 선전하는 스마트워치 답변은 1,360건에서 1,941건으로 늘었고, 비중은 9.3%에서 17.6%로 올랐습니다. 전체 상승은 무엇을 얼마나 자주 물었는지가 바뀐 데서 온 것이지, 어떤 제품이 AI에 더 많이 언급되어서가 아닙니다. 노트북 줄은 더 많은 것을 말해 줍니다. Samsung은 노트북을 판매하지만, 두 기간 모두 노트북 답변의 3%~5%에서만 언급되었습니다. 그동안 브랜드 전체 수치는 내내 45%를 넘었습니다.
그렇다면 노트북 질문 수가 줄었을까요? 아닙니다. 프롬프트 ID로 중복을 제거하면, 각 기간에 제품마다 서로 다른 질문이 몇 개 있었는지, 질문 하나가 평균 몇 개의 답변을 냈는지 알 수 있습니다. 같은 질문에 대한 답변은 플랫폼, 지역, 날짜가 달라도 모두 셉니다.
| 제품 | 기간 1 질문 수 | 기간 2 질문 수 | 기간 1 질문당 답변 수 | 기간 2 질문당 답변 수 |
|---|---|---|---|---|
| 스마트폰 | 3,249 | 3,748 | 1.65 | 1.22 |
| 노트북 | 1,885 | 2,049 | 2.25 | 1.41 |
| 스마트워치 | 649 | 1,155 | 1.59 | 1.19 |
참고: 프롬프트 ID와 연결할 수 있는 답변만 셌으며, 제품과 기간에 따라 답변의 70%~82%를 포함합니다. 이 표는 방향을 보는 데만 쓰고, 위의 답변 건수와 곱하지 마세요.
노트북은 오히려 질문이 약간 늘었습니다(1,885에서 2,049). 그런데도 답변은 줄었는데, 노트북 질문 하나당 평균 답변이 2.25건에서 1.41건으로 줄었기 때문입니다. 스마트워치 질문은 거의 두 배가 되었습니다(649에서 1,155). 다시 말해, 한 제품의 답변 비중은 그 제품의 질문 수 때문에도, 질문마다 몇 번 실행했는지 때문에도 바뀔 수 있습니다. 7장에서 질문 세트와 샘플링 횟수를 모두 고정하라고 하는 이유가 바로 이것입니다.
전체 집단에서 보이던 추세가 하위 집단으로 나누면 나타나거나, 사라지거나, 뒤집히는 현상을 통계학에서는 심슨의 역설이라고 부릅니다(스탠퍼드 철학 백과사전의 정의). 브랜드 전체 가시성도 같은 종류의 문제를 겪습니다. 하위 집단의 비율이 바뀌면, 합친 수치가 나눈 수치와 다른 방향으로 움직일 수 있습니다.
질문에 브랜드명이 들어 있는지도 전체 수치를 바꿉니다. Practical Ecommerce의 Ann Smarty는 Better Metrics for AI Search Visibility에서 도구의 가시성 점수는 어떤 질문을 하느냐에 전적으로 달려 있다고 지적합니다. 브랜드명이 들어간 질문은 100%에 가까운 점수가 나오기 쉬우므로 별도 그룹에 두어야 합니다. 한 제품에서 브랜드명 질문이 늘면 브랜드 전체 수치도 부풀려집니다.
넘어가기 전에 한 가지 더. 표에 있는 스마트폰의 6.4%p 하락은 다시 나눠 봐야 합니다. 7장에서 보듯이, 그 대부분도 다른 질문 세트를 물었기 때문입니다.
결론: 같은 기간, 같은 질문 세트에서 답변을 제품별로 나누고, 제품마다 두 가지 수치를 계산합니다. 그 제품 자체의 가시성과, 전체 답변에서 그 제품이 차지하는 비중입니다. 그런 다음 이전 기간과 비교해 전체 변화를 "각 제품 내부의 변화"와 "질문 구성의 변화" 두 부분으로 나눕니다. 다음 중 하나라도 보이면 숨어 있는 제품이 있습니다:
방법은 세 단계입니다:
모든 제품에 대해 두 부분을 더하면 전체 변화와 정확히 일치합니다.
1장의 Samsung을 나누면 다음과 같습니다:
| 제품 | 자체 가시성 변화 | 전체 수치에 미친 효과 | 답변 비중 변화 | 질문 구성의 효과 |
|---|---|---|---|---|
| 스마트폰 | −6.4 | −3.2 | +1.3 | +1.0 |
| 노트북 | +1.3 | +0.5 | −9.6 | −0.4 |
| 스마트워치 | +0.1 | 0.0 | +8.3 | +3.9 |
| 합계 | — | −2.7 | — | +4.5 |
참고: 모든 값의 단위는 %p이며, 두 합계를 더하면 +1.9입니다(반올림 전 값으로 계산).
세 제품 내부의 변화는 합쳐서 전체 수치를 2.7%p 끌어내렸고, 질문 구성의 변화는 4.5%p 끌어올렸습니다. 브랜드 전체만 보면 이 기간에 Samsung이 AI 답변에서 더 잘한 것처럼 보입니다. 나눠 보면 스마트폰은 떨어지고 있었고, 노트북은 거의 존재하지 않았으며, 전체 수치는 스마트워치 답변이 늘고 노트북 답변이 줄어든 덕분에 버틴 것이었습니다.
Dageno를 쓴다면, 1단계인 제품별 확인은 AI Market Segments 페이지에서 시작할 수 있습니다. 같은 브랜드의 시장별 순위와 가시성, 그리고 시장별 상위 브랜드가 함께 나열됩니다(그림 1). 3단계의 분해는 현재 데이터를 내보낸 뒤 스프레드시트에서 해야 합니다. 이 분해를 바로 만들어 주는 기능은 제품에서 찾지 못했습니다.
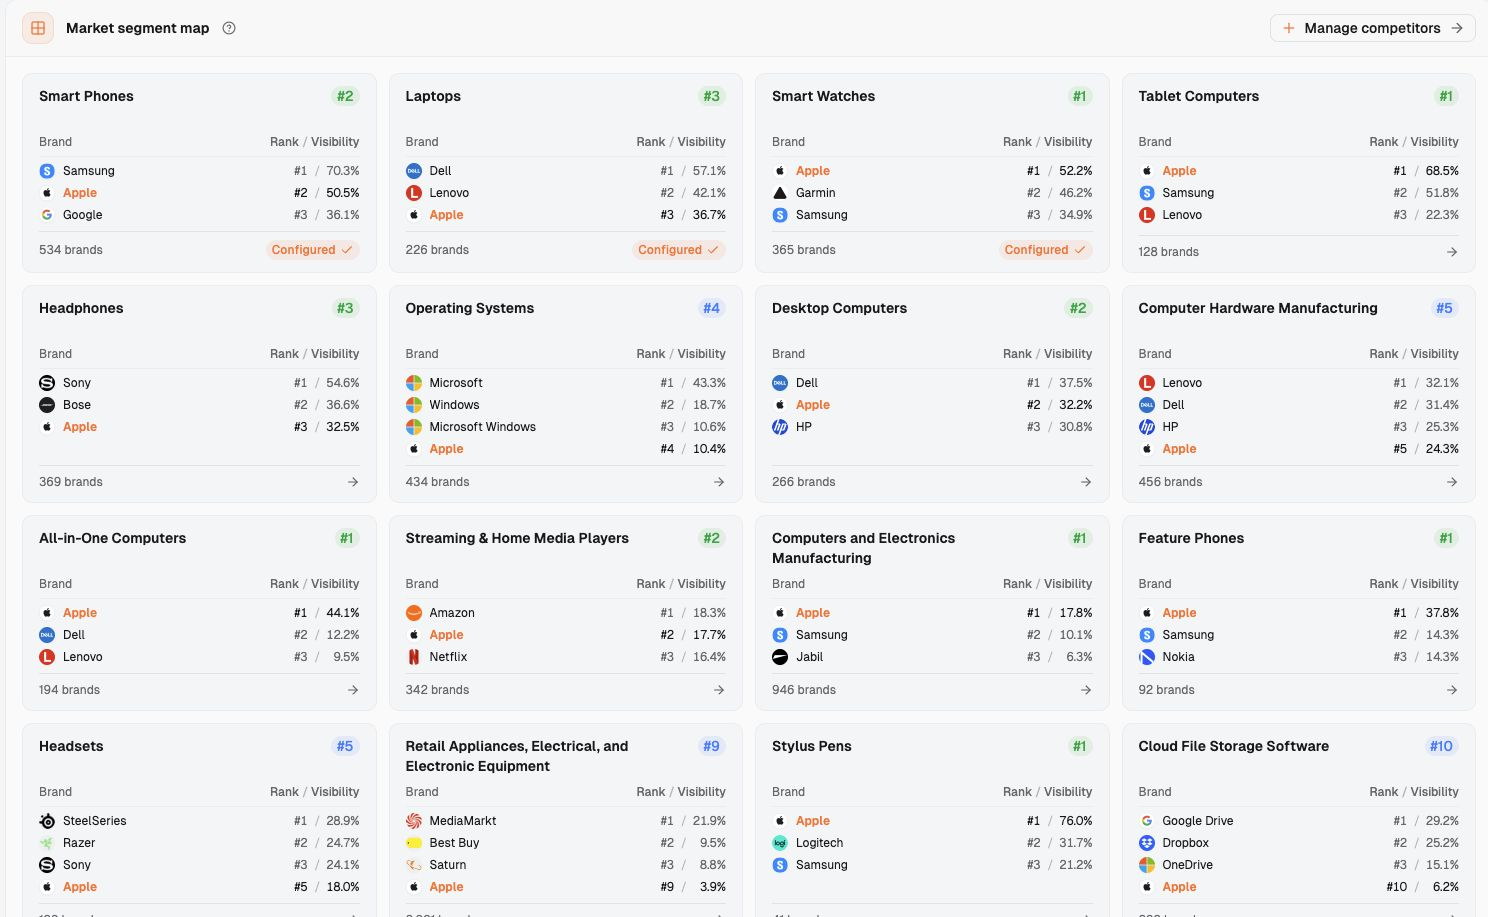
그림 1: Dageno AI Market Segments 페이지의 Apple 워크스페이스. 같은 브랜드라도 Smart Phones에서는 2위(50.5%), Laptops에서는 3위(36.7%), Smart Watches에서는 1위(52.2%), Cloud File Storage Software에서는 10위(6.2%)에 그치며, 시장마다 상위 브랜드도 다릅니다. Apple은 공개된 브랜드 예시이며 Dageno의 고객이 아닙니다. 이미지에는 집계 기간이 표시되지 않습니다. 가시성은 매출이나 시장 점유율이 아니며, 순위가 낮다고 해서 진입할 가치가 있는 기회라는 증거가 되지는 않습니다.
결론: 결론을 내리기 전에 세 가지를 확인하세요.
세 가지가 모두 성립해야 진짜 부재입니다. 한두 번 물어본 질문이나 몇 건의 답변으로는 부족합니다.
아닙니다. 기껏해야 불안정한 것입니다. AI 답변은 매번 다를 수 있습니다. SparkToro와 Gumshoe.ai는 2025년 11월~12월에 600명의 자원봉사자에게 12개의 브랜드 추천 프롬프트를 ChatGPT, Claude, Google의 AI 답변에서 총 2,961회 실행하게 했습니다. 같은 프롬프트가 두 번 같은 브랜드 목록을 내놓을 확률은 1% 미만이었습니다(SparkToro 원문). 장크트갈렌 대학의 Schulte, Bleeker, Kaufmann도 가시성은 한 번의 관측 결과가 아니라 반복 측정의 분포로 읽어야 한다고 주장합니다(Don't Measure Once). 논문에 따르면 프롬프트를 한 번 실행하면 브랜드 검출률의 표준오차가 0.370이고, 7번 실행하면 0.10 아래로 떨어집니다. 한 실무자는 Reddit 토론에서, 자신들이 아무것도 바꾸지 않았는데 같은 프롬프트의 가시성이 주마다 15%~20% 흔들렸다고 말했습니다. 이는 개인의 관찰이지 통계적 결과가 아닙니다.
그러니 반복 샘플링 후의 결과를 보세요. 세 시장 샘플에서 노트북 질문 중 26개 그룹이 같은 플랫폼, 같은 지역에서 세 번 이상 질문되었습니다.
샘플은 작지만, Samsung의 부재가 한두 번의 샘플링 운 때문이 아니라는 것을 보여 주기에는 충분합니다. Samsung의 가시성은 모든 종류의 노트북 질문에서도 낮았습니다:
즉 특정 장면 하나가 아니라 제품 전체가 빠져 있다는 뜻입니다. 그 자리는 Dell(63.0%), Lenovo(49.2%), Apple(43.5%) 같은 브랜드가 차지했습니다.
도구의 검출 규칙에 달려 있으며, 원래 답변을 읽고 표본 점검하는 것이 가장 좋습니다. 샘플에는 전문을 읽을 수 있는 노트북 답변이 8,713건 있습니다. 표본 점검 결과는 다음과 같습니다:
누락은 추천으로 제시된 브랜드만 세는 검출 규칙 때문일 수도 있고, 검출 누락 때문일 수도 있습니다. 도구의 규칙과 대조해 확인하세요. Samsung의 경우 이를 모두 세더라도 Galaxy Book을 언급한 답변은 노트북 답변의 약 3%에 불과하므로, 제품이 부재하다는 결론은 그대로입니다.
그것은 공백이 아닙니다. "추진하지 않음"으로 기록하세요. Samsung에는 Galaxy Book 노트북 라인이 있지만, 샘플은 여러 국가와 지역에 걸쳐 있습니다. 어떤 모델이 어디서 얼마에 팔리는지는 확인하지 않았습니다. 그것은 브랜드 자체의 제품 팀만 확인할 수 있습니다. 마찬가지로 어떤 가격대나 용도에 제품이 없는 브랜드라면 AI가 언급하지 않는 것은 당연하며, 콘텐츠 공백으로 다뤄서는 안 됩니다.
Dageno에서는 시장 세그먼트와 검색 의도 페이지의 수치를 클릭하면 원래 AI 답변까지 들어가 플랫폼, 지역, 답변 전문을 볼 수 있습니다(2026년 9월 8일~9일 Dageno 제품 지식 베이스 기록 기준). 처음 두 가지 확인은 거기서 할 수 있고, 세 번째는 자사 제품 데이터가 필요합니다.
결론: 다음 세 가지 조건이 모두 성립하면 브랜드 전체 수치로 충분합니다:
하나라도 성립하지 않으면 브랜드 전체 수치는 추세 참고용일 뿐이며, 특정 제품이 잘하고 있는지는 알려 주지 못합니다.
첫 번째 조건은 단일 카테고리 브랜드라면 보통 성립합니다. 스마트워치만 만드는 브랜드를 생각해 보세요. 모델이 달라도 같은 종류의 질문과 같은 경쟁자를 마주합니다. 모델별로 나누면 각 조각의 답변이 너무 적어져 오히려 읽기 어려워집니다. 나누는 데는 비용도 듭니다. 표준 통계 검정을 이용해 ThriveStack은 실제 언급률 10%와 15%를 95% 신뢰도로 구분하려면 조건마다 약 686회 실행이 필요하다고 추산합니다(ThriveStack 요약). 다섯 제품으로 나누면 제품마다 충분한 답변이 필요하므로 샘플링 양이 몇 배로 늘어납니다.
두 번째 조건은 경영진 보고에 관한 것입니다. 경영진에게 보통 필요한 것은 전체 추세와 문제가 있는 제품이 있는지 여부일 뿐, 장면별 세부 내용까지는 필요하지 않습니다.
세 번째 조건은 가장 놓치기 쉽습니다. 1장의 Samsung이 보여 주듯, 각 제품의 답변 비중이 바뀌면 전체 수치는 그것만으로 움직입니다. 해결책은 고정 가중치로 브랜드 전체 수치를 계산하는 것입니다. 먼저 제품별 가시성을 구한 다음, 미리 정해 두고 매 기간 바꾸지 않는 가중치로 합산합니다. 가중치는 현재 질문 비율로 고정해도 되고, 제품별 사업상 중요도로 정해도 됩니다. 그러면 질문 수나 샘플링 빈도가 바뀌어도 전체 수치가 움직이지 않습니다.
경영진이 숫자 하나만 보더라도, 그 아래에 제품별 가시성과 변화를 한 줄 덧붙여 어떤 제품이 미끄러지고 있지 않은지 확인하는 장치로 쓰세요. 브랜드명이 들어간 질문은 별도 줄에 두고 전체 수치에는 넣지 마세요. 브랜드명이 있는 질문과 없는 질문은 서로 다른 것을 측정합니다. 자세한 내용은 브랜드명이 있는 언급과 없는 언급의 차이를 참고하세요.
결론: 다음 중 하나라도 해당하면 제품마다 자체 기준선을 두세요. 즉 자체 질문, 자체 경쟁사 목록, 자체 출발점 수치입니다:
경쟁사가 다르다는 것은 세 시장 샘플에서 분명히 드러납니다. 가시성 상위 5개 브랜드가 시장마다 완전히 다릅니다:
같은 Apple이라도 스마트폰 답변에서는 Samsung, Google과 경쟁하고, 노트북 답변에서는 Dell, Lenovo와 경쟁합니다. 이를 하나의 브랜드 전체 순위로 합치면 더 이상 같은 경쟁자와 비교하는 것이 아닙니다.
차이가 크다는 것은 이런 경우입니다. Samsung의 가시성은 스마트폰에서 77.4%, 스마트워치에서 46.7%, 노트북에서는 3.8%에 불과합니다. 그림 1의 Apple도 마찬가지로 스마트워치에서 1위, 노트북에서 3위, 클라우드 스토리지에서는 10위에 그칩니다.
담당자가 다르면 브랜드 전체 수치로 사람을 평가할 때, 본인이 이루지 않은 공이나 책임을 나눠 주게 됩니다. 노트북 담당자는 스마트워치 질문이 늘었다는 이유만으로 수치가 오르는 것을 볼 수 있지만, 자기 제품은 전혀 바뀌지 않았을 수 있습니다.
비중이 작다는 것은 1장의 계산대로, 그 제품이 10%p 떨어져도 전체 수치는 1%p 남짓만 움직인다는 뜻입니다.
외부 연구와 실무자들도 같은 점을 지적합니다. 벤더 Odyssiant는 2026년 2월~4월의 AI 답변 5,356건을 분석하고, 브랜드 가시성은 AI가 그 회사를 알아보는지를 알려 주고 제품 가시성은 올바른 제안이 올바른 구매 맥락에서 이해되는지를 알려 준다고 결론지었습니다. 이 차이는 제품이나 서비스 라인이 많은 회사에서 가장 중요합니다(Product Visibility vs Brand Visibility). 이 연구는 기간 중 점수 산정 방식을 조정했으며, 저자들은 구매 단계별 패턴을 깔끔한 추세가 아니라 형성 중인 기준선으로 읽어야 한다고 밝혔습니다. Reddit의 한 실무자도 브랜드가 AI 안에서 "두 개의 프로필로 나뉜다"고 설명했습니다. 하나는 제품 질문용, 하나는 회사 정보용입니다(원래 토론). 개인의 관찰이지만 요점은 같습니다. 브랜드로 인식되는 것과 제품이 추천되는 것은 다릅니다.
제품별로 따로 추적하는 것은 복잡하지 않습니다:
Dageno의 Product Portfolio Planning 솔루션 페이지가 바로 이런 비교를 설명합니다. 먼저 제품 라인별 AI 가시성과 순위를 비교한 뒤, 한 라인을 골라 구매자 질문과 셀링 포인트를 파고듭니다. 페이지에는 한계도 명시되어 있습니다. AI 답변에서의 위치와 커버리지는 시장 수요, 시장 점유율, 매출을 측정하지 않으며, 서로 다른 시장의 결과는 분리해서 봐야 한다는 것입니다.
결론: 같은 제품의 가시성이나 순위가 구매자 질문 유형에 따라 크게 다르고, 그 차이로 어떤 페이지를 바꿀지, 어떤 콘텐츠를 추가할지 정해야 한다면, 한 단계 더 장면별로 나누세요. 그 차이가 자사가 제공하지 않는 가격대나 용도에서 온 것이라면 기록만 해 두면 됩니다. 공백이 아닙니다.
세 시장 샘플에서 스마트폰 답변 속 Apple의 전체 가시성은 53.4%이지만, 구매자 질문 유형으로 나누면 모습이 크게 달라집니다:
| 구매자 질문 유형 | 가시성 | 답변 수 |
|---|---|---|
| 종합 추천 | 73.8% | 839 |
| 예산별 추천 | 22.9% | 376 |
| 선택하는 이유 | 18.5% | 287 |
질문 유형은 Dageno의 분류입니다. 장면별 분해에는 질문 메타데이터와 연결할 수 있는 답변만 사용했으며, 스마트폰 답변의 약 78%입니다.
제품 수준의 53.4%만 보면 이 제품이 AI 답변에서 전반적으로 잘하고 있다고 생각할 것입니다. 장면별로 나누면 "종합 추천" 질문이 평균을 떠받치고 있고, 질문에 예산이 들어가면 이 제품은 거의 나오지 않는다는 것을 알 수 있습니다.
Dageno의 AI Search Intents 페이지는 이 생각을 바탕으로 구성되어 있습니다(그림 2). Smart Watches 예시에서 Apple은 25개 하위 의도를 모두 커버해 커버리지가 100%입니다. 하지만 Recommendations 안에서는:
커버리지 100%는 브랜드가 모든 종류의 질문에 나온다는 뜻일 뿐, 모든 종류에서 앞선다는 뜻이 아닙니다.
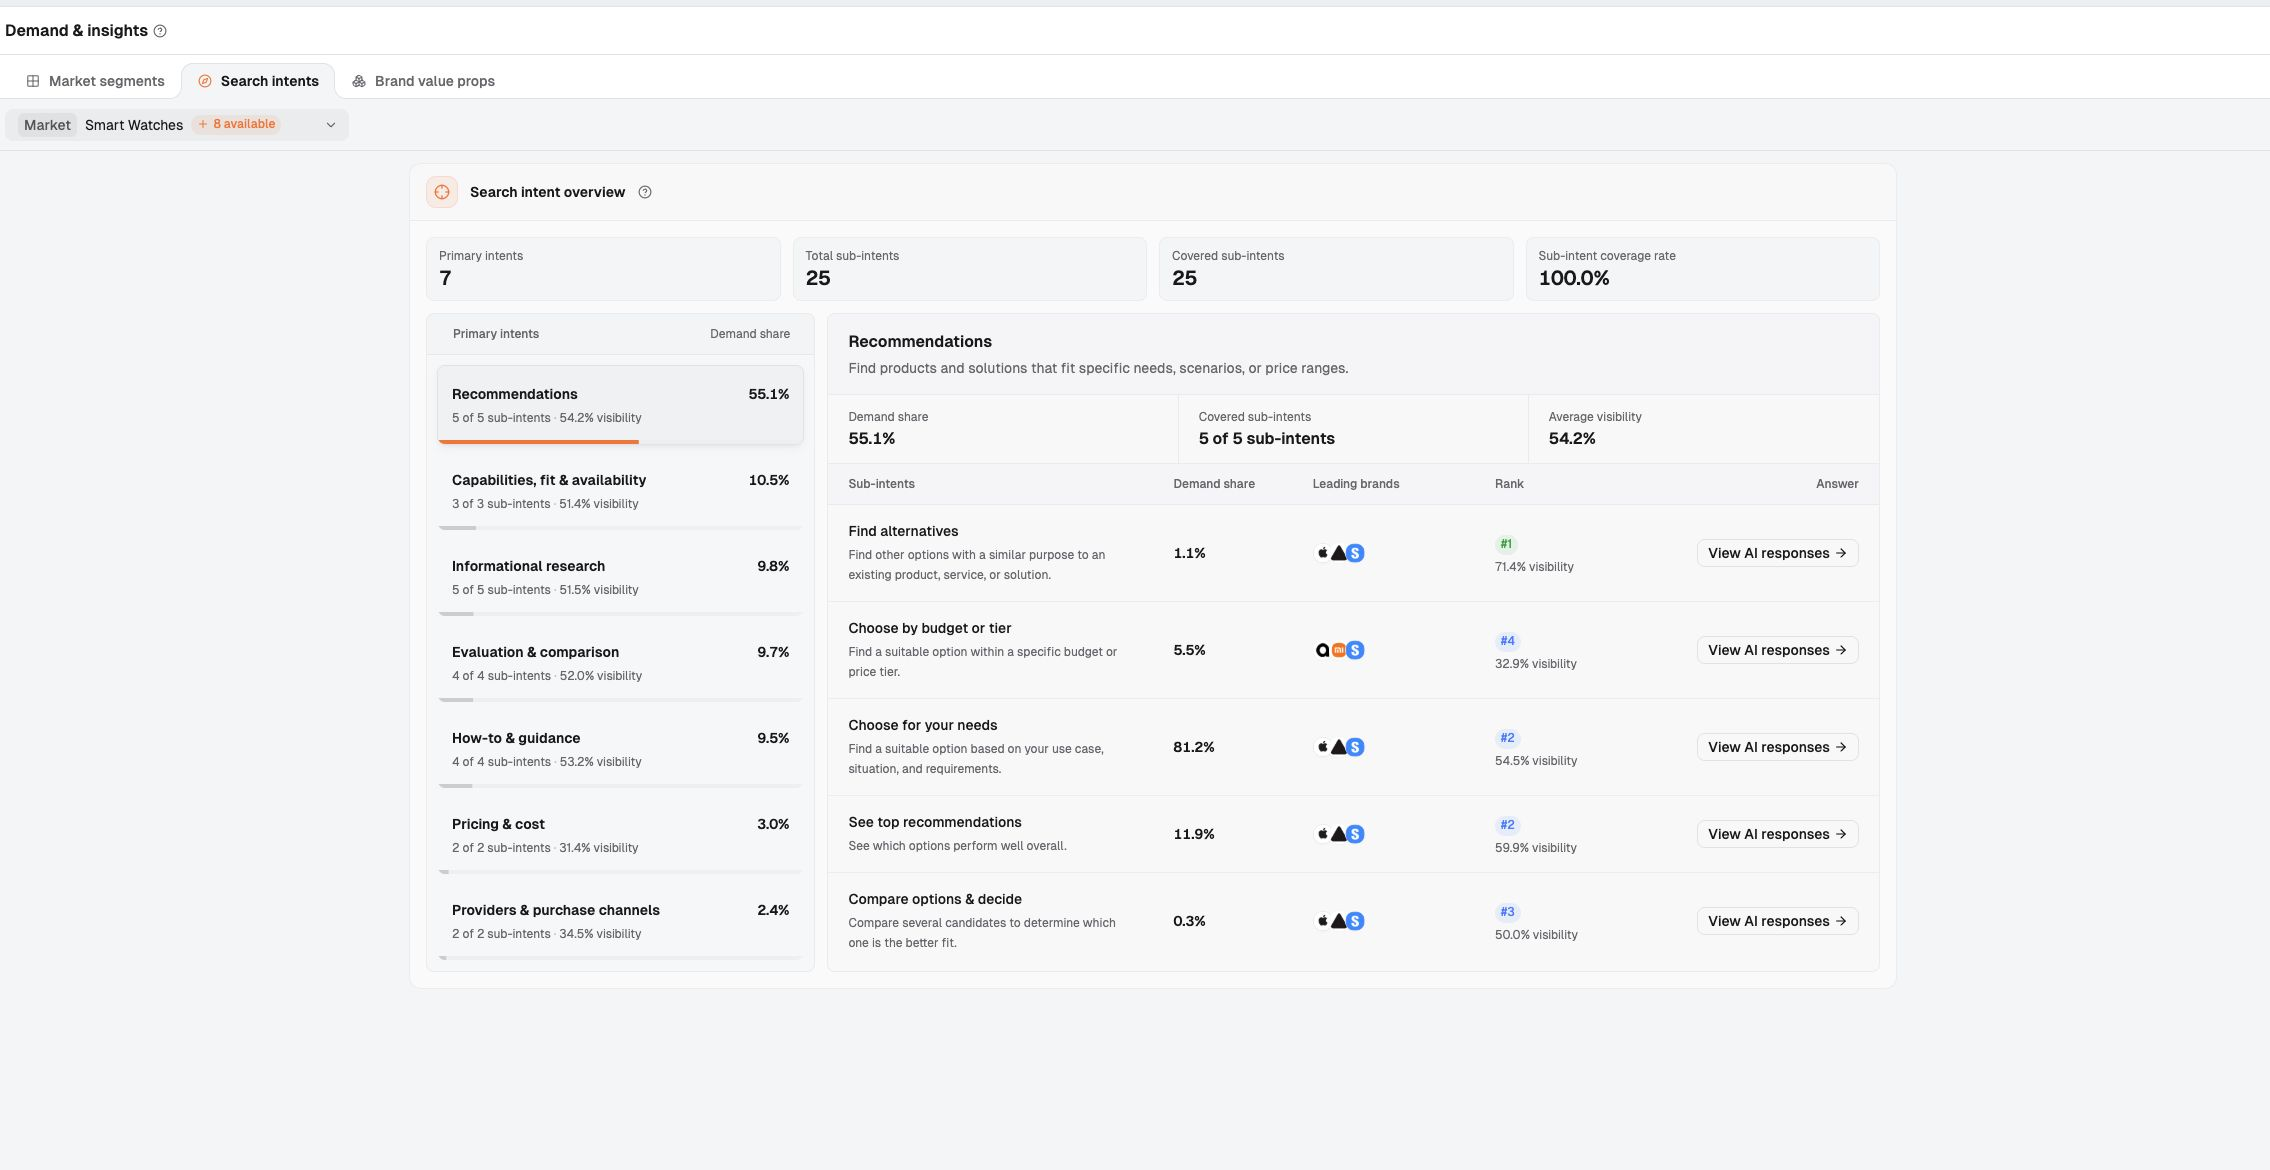
그림 2: Apple 워크스페이스의 Smart Watches 시장 검색 의도 보기. 7개 주요 의도와 25개 하위 의도가 있으며, 하위 의도 커버리지는 100%입니다. Recommendations 안에서 Apple은 "Find alternatives"에서 1위(71.4%), "Choose by budget or tier"에서 4위(32.9%)입니다. 수요 점유율은 분석된 질문의 분포를 나타낼 뿐, 총 검색량이나 입증된 구매 수요가 아닙니다. 이미지에는 집계 기간이 표시되지 않습니다.
Pixis의 Swetha Venkiteswaran은 Prompt-Level Visibility에서 전체 가시성 점수가 같은 두 브랜드의 예를 듭니다. 한 브랜드는 모든 종류의 질문에 꾸준히 나옵니다. 다른 브랜드는 폭넓은 질문에는 강하지만, 구매자가 대안이나 특정 용도를 물으면 사라집니다. 평균은 같지만 상업적 위치는 완전히 다릅니다. 전체 점수는 어디를 봐야 할지 알려 주고, 개별 질문은 그 이유를 알려 줍니다.
장면별로 나누지 말아야 할 때도 말해 두겠습니다. 어떤 장면의 답변이 수십 건뿐이라면 그 오르내림은 대부분 우연입니다. 나눌 만큼 데이터가 쌓일 때까지는 나머지와 함께 보세요. 그리고 브랜드에 그 가격대나 용도의 제품이 없다면 그 장면에 별도 기준선을 둘 필요가 없습니다.
아래 표는 각 보기가 맞는 경우를 정리한 것입니다:
| 보기 | 사용할 때 | 알려 주지 못하는 것 |
|---|---|---|
| 브랜드 전체 | 제품들이 같은 질문과 경쟁사를 마주한다; 결정이 브랜드에 관한 것이다; 각 제품의 비중이나 가중치가 고정되어 있다 | 특정 제품이 잘하고 있는지; 페이지 변경이 효과가 있었는지 |
| 제품별 | 경쟁사가 다르다, 가시성 차이가 크다, 담당자와 웹사이트 페이지가 다르다, 또는 비중이 작은 제품이 있다 | 한 제품 안에서 어떤 종류의 구매자 질문이 문제인지 |
| 장면별 | 한 제품이 구매자 질문에 따라 크게 다르고, 그 차이로 어떤 페이지를 바꿀지 정해야 한다 | 답변이 너무 적은 장면의 오르내림; 브랜드가 제공하지 않는 가격대나 용도 |
결론: 두 기간 모두 물어본 질문만, 같은 플랫폼과 지역, 같은 샘플링 횟수로 사용해 그 제품 자체의 가시성이 올랐는지 확인하세요. 그런 다음 브랜드 전체 변화를 각 제품 내부의 변화와 질문 구성의 변화로 나눕니다. 같은 질문에서 올랐을 때만 그 제품이 나아졌다고 말할 수 있습니다. 페이지 변경이 원인인지는 별개의 질문이며, 아직 결론 낼 수 없습니다.
1장의 Samsung으로 돌아가 보겠습니다. 전체 답변으로 세면 스마트폰 가시성은 6.4%p 떨어졌습니다. 두 기간 모두 물어본 질문만(프롬프트 ID로 매칭, 1,431개 질문) 비교하면 결과가 완전히 다릅니다:
| 스마트폰 답변 내 가시성 | 전체 답변 | 두 기간 모두 물어본 같은 질문 |
|---|---|---|
| Samsung | 81.1% → 77.6% | 84.3% → 84.9% |
| Apple | 56.3% → 48.6% | 58.2% → 55.1% |
여기서는 프롬프트 ID와 연결할 수 있는 답변만 사용했으며 스마트폰 답변의 약 78%입니다. 그래서 "전체 답변" 열은 1장의 수치와 약간 다릅니다.
Samsung 스마트폰의 "하락"은 거의 전부 다른 질문 세트에서 왔습니다. 같은 질문에서는 가시성이 거의 변하지 않았습니다. Apple은 전체로는 7.7%p 떨어졌지만, 같은 질문에서는 약 3%p만 떨어졌습니다. 같은 기간 스마트폰 답변의 플랫폼 구성도 바뀌었습니다. Gemini의 답변 비중은 46%에서 27%로 떨어졌고, ChatGPT는 30%에서 48%로 올랐습니다. 전체 답변 수치로 두 기간 사이에 한 변경을 판단하면 잘못된 결론에 이르게 됩니다.
그래서 재확인에는 네 가지가 필요합니다:
Dageno에서는 장기적으로 재확인하려는 프롬프트, 플랫폼, 지역, 경쟁사를 모니터링 설정에서 고정할 수 있습니다. CSV를 가져오려면 prompt, platforms, regions, language 네 열이 필요합니다. 어느 것도 제품 라벨이 아니므로, 각 질문이 어떤 제품에 속하는지는 팀이 자체 스프레드시트에 기록해야 합니다. Dageno 지식 베이스 기록에 따르면 검증된 것은 설정 화면과 입력 규칙뿐이며, 가져오기 제출, 저장, 실제 샘플링은 테스트하지 않았습니다. 지속적인 모니터링은 AI 답변 전반의 브랜드 가시성 추적을 참고하세요.
월간 보고서에 넣을 수 있는 결론은 두 가지입니다:
별도로 "아직 입증되지 않음" 칸을 두고 최소한 다음 세 가지를 넣으세요:
아래는 기록 예시입니다. 브랜드, 날짜, 수치는 가상이며 작성 방법을 보여 주기 위한 것입니다:
| 항목 | 가상 예시(가상의 수치) |
|---|---|
| 변경 | 9월 10일: 노트북 제품 페이지를 업데이트해 사용 사례, 배터리 테스트 조건, 비슷한 가격대 모델과의 비교를 추가 |
| 비교 범위 | 두 기간 모두 물어본 노트북 질문 120개; ChatGPT와 Google AI Mode; 미국과 독일; 기간마다 질문당 5회 실행; 기간당 14일 |
| 제품 내부의 변화 | 이 120개 질문에서의 노트북 가시성: 8.0% → 12.5% |
| 브랜드 전체 수치의 변화 | +1.6%p: 노트북 자체에서 +0.9, 스마트워치 질문 증가에서 +0.7 |
| 월간 보고서에 넣는다 | 같은 질문에서 노트북을 언급한 답변 비중이 4.5%p 상승 |
| 아직 입증되지 않음 | 페이지 변경이 상승의 원인인지; 다음 기간까지 이어지는지; 문의나 매출로 이어지는지 |
재테스트 기간과 샘플링 횟수를 정하는 방법은 샘플 크기와 재테스트 빈도 정하는 법을, 페이지 업데이트 후의 변화가 우연 이상인지 판단하는 방법은 AI 추천이 정말 개선되었는지 검증하는 법을 참고하세요.
아닙니다. 잘게 나눌수록 조각마다 답변이 적어지고, 수치는 우연에 더 크게 흔들립니다. 앞서 말했듯 실제 언급률 10%와 15%를 구분하려면 조건마다 약 686회 실행이 필요합니다. 먼저 경쟁사와 담당 구분에 따라 제품별로 나누고, 데이터가 충분히 쌓인 뒤에 제품을 모델이나 장면으로 더 나누세요.
"제품 간 질문"이라는 별도 그룹에 넣으세요. 예를 들어 "휴대폰과 스마트워치를 어떻게 조합하면 좋을까?" 같은 질문입니다. 어느 단일 제품에도 넣지 않고 그 추세를 따로 추적합니다. 그렇지 않으면 같은 답변이 두 번 세어지거나, 임의로 한 제품에 배정됩니다.
따로 세세요. 브랜드명이 들어간 질문은 거의 항상 브랜드를 언급하므로, 섞으면 전체 수치가 부풀려지고 그 개수가 바뀔 때마다 수치가 움직입니다. 질문 세트에서 브랜드명, 제품명, 카테고리 용어를 어떻게 조합할지는 AI 가시성 프롬프트 세트 만드는 법을 참고하세요.
고정 가중치를 쓰세요. 답변을 그대로 합치면 Samsung 예시처럼 결과가 각 제품 답변 비중의 변화에 좌우됩니다. 가중치는 현재 질문 비율로 고정해도 되고 제품별 사업상 중요도로 정해도 됩니다. 한 번 정하면 매 기간 같게 유지해, 전체 수치의 변화가 제품 내부의 변화만 반영하도록 하세요.
그럴 수 있습니다. 샘플에서 "MacBook"을 언급한 노트북 답변의 약 14%가 Apple 언급으로 기록되지 않았습니다. 3장의 방법으로 원래 답변을 표본 점검한 뒤, 도구의 검출 규칙을 확인해 그 답변들을 셀지 결정하세요.
그렇다고 주장할 수는 없습니다. 가시성은 그 제품을 언급한 AI 답변의 비중이며, 매출, 시장 점유율, 실제 검색량을 측정하지 않습니다. 사업 영향을 판단하려면 문의, 트래픽, 매출 데이터와 따로 비교하세요.
이번 기간과 지난 기간의 브랜드 전체 가시성부터 시작해 2장의 방법을 쓰세요:
신호가 하나라도 보이면 보고서의 브랜드 전체 수치 아래에 제품별 수치를 한 줄 추가하고, 가려진 제품을 표시하세요. 그런 다음 두 가지를 정합니다. 자체 기준선이 필요한지(5장), 그리고 장면별로 더 나눌지(6장)입니다.
브랜드 전체 수치는 여전히 경영진에게 전체 추세를 보여 줄 수 있습니다. 다만 제품이 잘하고 있는지 판단하는 유일한 근거가 되어서는 안 됩니다.

업데이트한 사람
Dageno
Dageno is the research and insights team at Dageno AI, publishing industry reports and expert analysis on AI Search Visibility, Generative Engine Optimization (GEO), and AI-powered search discovery.
 Alexa for Shopping