Découvrez la position de votre marque sur le marché de l'IA
Identifiez les opportunités de croissance à privilégier en fonction de la demande du marché, du paysage concurrentiel, des propositions de valeur de la marque et des sources de citation.
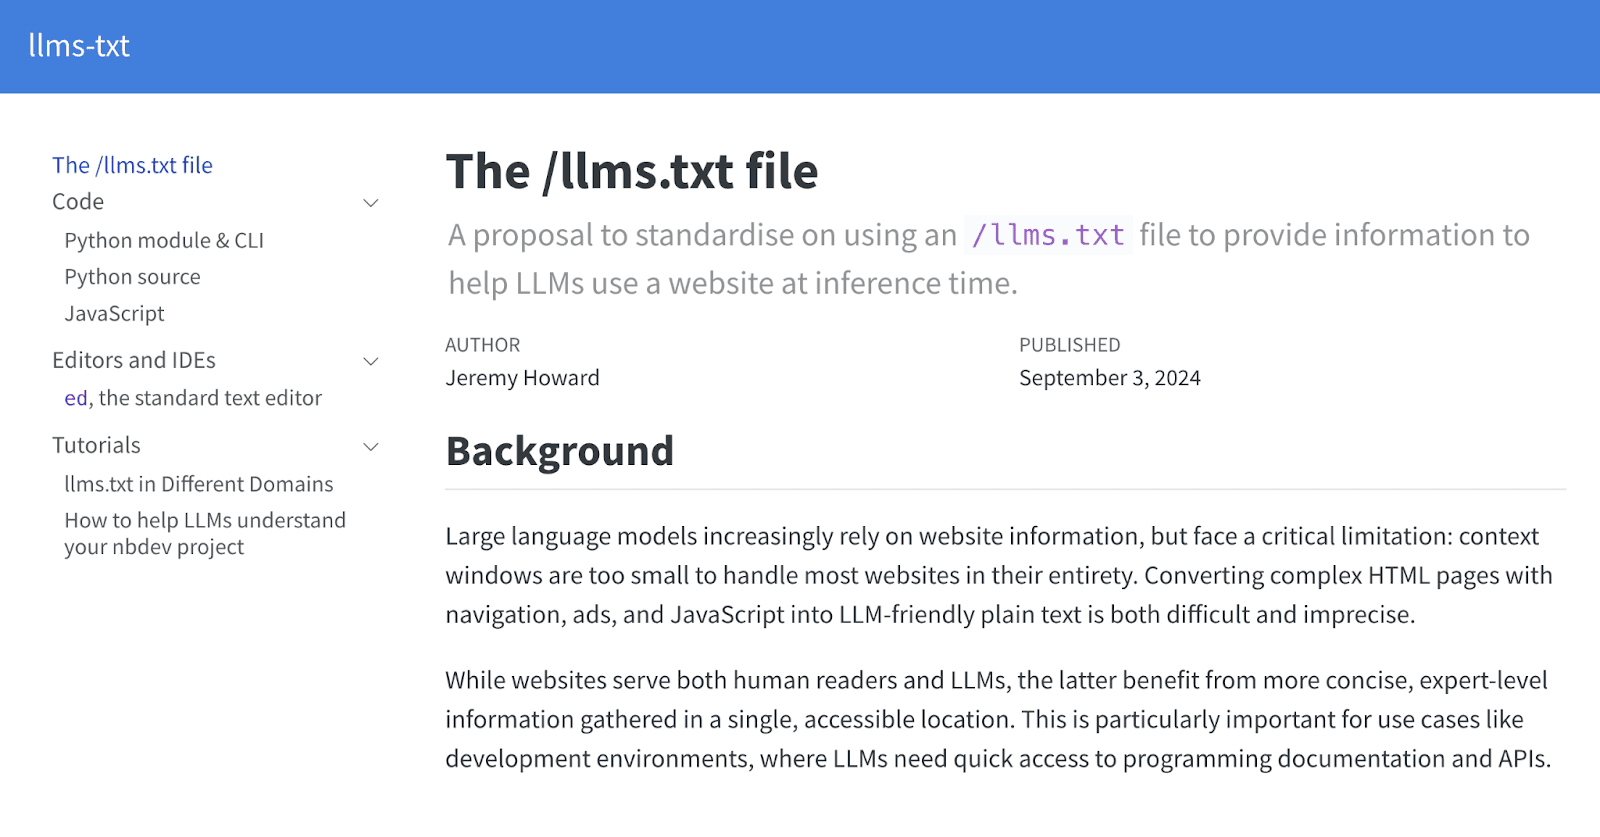
LLMs.txt est un outil essentiel pour être découvert par l’IA : il fournit aux systèmes d’IA des indications claires et structurées sur les catalogues de produits et les informations de marque.
Mieux vaut agir de manière proactive que d’accepter passivement la situation : sans LLMs.txt, l’IA peut extraire des informations sur une marque à partir de sources peu fiables ou inexactes.
La mise en œuvre exige une approche systématique : chaque étape, de l’exportation des données à la création et à l’hébergement du fichier, jusqu’à sa maintenance, mérite une attention particulière.
À utiliser avec des outils de suivi : associez LLMs.txt à des plateformes comme Dagneo AI pour suivre en continu ses effets sur la visibilité dans l’IA.
La confiance et l’exactitude sont essentielles : les informations fournies dans LLMs.txt doivent être exactes, car elles constituent le contrat entre la marque et les systèmes d’IA.
Introduction
Dans le sillage de l’intelligence artificielle, qui transforme Internet, une nouvelle norme technique modifie discrètement la manière dont les vendeurs en ligne sont découverts et recommandés par les systèmes d’IA. LLMs.txt, ce fichier texte brut d’apparence simple mais d’une importance considérable, devient une infrastructure essentielle pour permettre aux marques e-commerce d’établir leur présence à l’ère de la recherche par IA.
Selon une étude de BigCommerce, LLMs.txt est un fichier texte brut au format Markdown qui sert de passerelle entre les sites e-commerce et les systèmes d’IA, en guidant les grands modèles de langage vers les données produits et les contenus de qualité les plus importants d’une marque [1]. Contrairement aux fichiers robots.txt et sitemap.xml traditionnels, LLMs.txt est spécialement conçu pour l’ère de l’IA. Il aide les marques à contrôler de manière proactive la présentation de leurs produits dans les résultats de recherche d’assistants IA comme ChatGPT, Gemini et Perplexity.
Les données de PwC révèlent que plus de la moitié des millennials à hauts revenus et un quart des baby-boomers ont déjà utilisé ou prévoient d’utiliser l’IA pour faire leurs achats en ligne. Par ailleurs, ChatGPT a atteint 100 millions d’utilisateurs en seulement deux mois, une croissance bien plus rapide que celle des smartphones, qui avaient mis 16 mois pour atteindre le même jalon. Cela signifie que les achats assistés par l’IA passent du stade expérimental à celui d’une pratique grand public, et que LLMs.txt est précisément l’outil essentiel qui permet aux marques de gagner en visibilité sur ce nouveau terrain de concurrence.
Qu’est-ce que LLMs.txt ?
Définition et concepts clés de LLMs.txt
LLMs.txt est un fichier texte brut hébergé à la racine d’un site web, au format Markdown, spécialement conçu pour fournir aux grands modèles de langage des indications générales et des informations structurées sur le contenu du site. On peut le considérer comme un « guide touristique » destiné aux systèmes d’IA : il indique aux assistants IA, dans un format lisible par machine mais compréhensible par les humains, quels sont les contenus importants du site, où les trouver et comment les interpréter et les utiliser correctement.
Sur le plan technique, LLMs.txt comble les lacunes des normes web existantes (robots.txt et sitemap.xml), qui ne répondent pas aux exigences de l’ère de l’IA. robots.txt se concentre sur le contrôle d’accès et indique aux robots d’exploration les zones auxquelles ils peuvent accéder et celles qu’ils doivent éviter. Pour les sites e-commerce, cela revient généralement à protéger des zones sensibles comme les interfaces d’administration, les données personnelles des utilisateurs et les processus de paiement. Cependant, robots.txt n’a jamais été conçu pour traiter la sémantique du contenu : il ne peut pas indiquer aux robots le sujet de ces pages ni leur importance.
sitemap.xml se concentre sur la découverte et l’indexation. Il répertorie toutes les URL des pages d’un site web et fournit des métadonnées pour chacune d’elles. Pour les sites e-commerce, cela signifie qu’il permet aux moteurs de recherche de découvrir toutes les fiches produits, les pages de catégories et les pages de contenu. Mais sitemap.xml présente des limites évidentes : il ne contient que des listes d’URL et ne peut pas fournir de descriptions structurées des informations essentielles du commerce en ligne, comme les attributs des produits, les variations de prix et l’état des stocks.
LLMs.txt comble ces lacunes. Il permet aux marques de fournir directement aux systèmes d’IA des indications claires sur la structure de leur catalogue de produits, leurs politiques, leur documentation d’assistance et la hiérarchie de leurs contenus. Plus important encore, il leur permet de présenter ces informations sous une forme officielle qu’elles contrôlent, plutôt que de laisser les systèmes d’IA les déduire de contenus web potentiellement obsolètes, désordonnés ou trop axés sur le marketing.
Principales différences avec les normes existantes
Comprendre la relation entre ces trois fichiers est essentiel pour élaborer une stratégie efficace de découvrabilité par l’IA.
Type de fichier
Fonction principale
Public cible
Principal avantage pour le e-commerce
robots.txt
Contrôle les autorisations d’accès
Robots d’exploration des moteurs de recherche traditionnels
Gère la charge du serveur et exclut les sections privées
sitemap.xml
Répertorie toutes les pages à indexer
Robots d’exploration des moteurs de recherche traditionnels
Garantit la découverte exhaustive des pages
LLMs.txt
Oriente vers des contenus structurés et à forte valeur
Grands modèles de langage
Améliore la précision de l’IA et la découvrabilité des produits
Pourquoi les marques e-commerce doivent mettre en place LLMs.txt
Le risque de déformation des informations par l’IA
Sans LLMs.txt, la manière dont les systèmes d’IA obtiennent des informations sur une marque est incertaine. Lorsqu’un consommateur pose une question sur un produit à ChatGPT ou Gemini, l’IA peut extraire des informations de pages HTML obsolètes, de discussions non modérées sur des forums, de sites d’avis tiers, voire du contenu de concurrents. Cela signifie que les descriptions de vos produits peuvent être dépassées, vos prix inexacts et l’histoire de votre marque déformée.
Dans le e-commerce, les conséquences de ces déformations sont particulièrement graves. Imaginez : lorsqu’un consommateur demande « Quelle est la politique de retour de ce produit ? », l’IA extrait d’un ancien article de blog des conditions de retour qui ont changé il y a trois ans ; lorsqu’un consommateur demande « Quels sont les avantages de votre produit par rapport à ceux de vos concurrents ? », l’IA cite l’évaluation partiale et unilatérale d’un utilisateur de forum. Ces déformations ne déçoivent pas seulement les consommateurs : elles nuisent aussi à l’image professionnelle de la marque et à la confiance des consommateurs.
Croissance explosive de la recherche générative
La recherche par IA générative transforme à une vitesse sans précédent la manière dont les consommateurs accèdent à l’information. ChatGPT n’a mis que deux mois pour atteindre 100 millions d’utilisateurs, tandis que les smartphones avaient eu besoin de 16 mois pour atteindre le même jalon. Cette croissance traduit une forte demande des consommateurs et l’adoption rapide de l’accès à l’information par l’IA.
L’enquête de PwC sur les agents d’IA montre que neuf cadres dirigeants sur dix prévoient d’augmenter leurs budgets liés à l’IA au cours de l’année à venir. Cela signifie que davantage d’entreprises investissent dans l’IA et que les consommateurs seront de plus en plus exposés à des contenus et recommandations générés par l’IA dans leur vie quotidienne. Pour les marques e-commerce, ne pas apparaître dans les résultats de recherche de l’IA revient à devenir invisibles aux yeux des consommateurs potentiels.
Exigences particulières des robots d’exploration de l’IA
Les robots d’exploration web traditionnels, comme Googlebot, sont désormais très performants pour traiter les sites e-commerce complexes : ils peuvent exécuter du JavaScript, comprendre les contenus chargés dynamiquement et s’adapter à la structure des sites. Les robots d’exploration de l’IA (notamment GPTBot, ClaudeBot et PerplexityBot) ont toutefois des exigences plus strictes. Ils sont beaucoup moins tolérants face à des structures de code complexes et non structurées.
Cela signifie que les structures courantes des sites e-commerce — filtres de produits dynamiques, listes de produits générées en JavaScript et données d’inventaire réparties entre plusieurs systèmes — peuvent empêcher les systèmes d’IA de comprendre et d’extraire correctement les informations essentielles. LLMs.txt aide les robots d’exploration de l’IA à localiser et à comprendre efficacement les contenus les plus importants en leur fournissant un point d’entrée clair et structuré, ce qui permet de contourner ces obstacles techniques.
Guide de mise en œuvre de LLMs.txt : étapes détaillées
Étape 1 : exporter les données produits
La première étape de la mise en place de LLMs.txt consiste à exporter des données produits propres et structurées depuis votre plateforme e-commerce. Si vous utilisez BigCommerce, vous pouvez utiliser directement sa fonctionnalité intégrée d’exportation du catalogue. Pour des besoins plus complexes, des plateformes professionnelles de gestion de flux comme Feedonomics peuvent regrouper les données produits de plusieurs sources, les nettoyer et les convertir dans des formats de sortie standardisés.
Les données exportées doivent inclure les champs essentiels suivants : les titres et descriptions détaillées des produits, les prix et les devises, la disponibilité des stocks, les SKU et identifiants uniques comme les GTIN, les URL des images produits et les chemins de catégories, ainsi que les dimensions et les caractéristiques techniques. Le format JSON est généralement le meilleur choix : il répond aux exigences d’intégration dans Markdown et permet aux systèmes d’IA d’analyser facilement les données structurées.
Étape 2 : héberger le fichier sur une URL publique stable
Le fichier de données produits exporté doit être hébergé à une URL stable et accessible au public. Cette URL doit rester stable à long terme : même si votre site web est repensé ou migré, elle ne doit pas devenir invalide. Il est recommandé d’utiliser un CDN ou un service d’hébergement statique (comme AWS CloudFront, Cloudflare Pages ou Netlify) afin de garantir un chargement rapide et une haute disponibilité.
Étape 3 : rédiger le fichier LLMs.txt
Lors de la création du fichier LLMs.txt, suivez cette structure recommandée : utilisez un titre H1 (#) pour le nom du site ou de la marque ; utilisez un bloc de citation (>) pour une brève description du marchand ; utilisez des titres H2 (##) pour classer les contenus ; et utilisez des listes à puces avec des liens et des descriptions pointant vers des ressources spécifiques.
markdownCopy
# Nom de la marque
> Brève description de la marque mettant en avant sa proposition de valeur principale

## Catalogue de produits et prix
- [Données complètes sur les produits](lien vers le flux JSON) : Tous les SKU, prix et niveaux de stock
- [Produits populaires](lien vers la page des produits populaires) : Sélection des produits phares de la saison
- [Nouveautés](lien vers la page des nouveaux produits) : Dernières nouveautés

## Politiques et conditions
- [Politique de retour](lien vers la page de la politique) : Informations sur les retours et les garanties
- [Politique de confidentialité](lien vers la page de confidentialité) : Conditions relatives à la protection des données et à la confidentialité
- [Conditions d’utilisation](lien vers la page des conditions) : Explication des conditions d’utilisation

## Assistance et documentation
- [FAQ](lien vers la page FAQ) : Foire aux questions
- [Coordonnées](lien vers la page de contact) : Coordonnées du service client
Étape 4 : héberger le fichier à la racine du site
Le fichier LLMs.txt doit être hébergé à la racine du site web, à l’emplacement standard example.com/llms.txt. Cet emplacement n’est pas arbitraire : il suit les mêmes conventions que robots.txt et sitemap.xml, ce qui permet aux systèmes d’IA de découvrir et d’analyser automatiquement le fichier.
Étape 5 : mettre à jour et entretenir régulièrement le fichier
Les systèmes d’IA évaluent l’actualité des données à partir des horodatages et des informations de version figurant dans le fichier. Il est donc recommandé d’indiquer la date de dernière mise à jour ou le numéro de version dans LLMs.txt. Il est conseillé d’intégrer les mises à jour de LLMs.txt à votre processus de gestion de contenu afin que le fichier soit synchronisé dès que le catalogue de produits, les conditions des politiques ou la documentation d’assistance font l’objet de modifications importantes.
Stratégies avancées : tirer le meilleur parti de LLMs.txt
Utilisation complémentaire de llms-full.txt
En complément du fichier LLMs.txt standard, vous pouvez envisager de créer un fichier llms-full.txt. Celui-ci contient la documentation complète ou l’intégralité du contenu du site au format Markdown et est spécialement conçu pour les pages qui nécessitent une analyse approfondie. Pour les sites e-commerce, cela peut inclure des fiches techniques détaillées des produits, l’intégralité des conditions d’utilisation et une documentation d’assistance détaillée.
Lorsque les systèmes d’IA doivent comprendre un sujet en profondeur, ils peuvent consulter llms-full.txt pour obtenir des informations plus détaillées. Cette approche à plusieurs niveaux permet à LLMs.txt de rester concis et efficace tout en fournissant suffisamment de ressources pour les situations qui nécessitent des recherches approfondies.
Le modèle de Dell Technologies
Dell Technologies a été l’une des premières grandes marques à mettre en œuvre publiquement LLMs.txt, établissant ainsi une référence pour l’ensemble du secteur. Le fichier LLMs.txt de Dell illustre plusieurs bonnes pratiques : une adoption précoce qui témoigne de son leadership technologique ; une structure Markdown qui garantit à la fois la lisibilité pour les humains et l’analyse par les machines ; des liens structurés vers des données produits actualisées qui permettent à l’IA d’accéder aux informations les plus récentes.
Dell met également en évidence des pistes d’optimisation : ajouter dans LLMs.txt des informations plus détaillées sur les dimensions des produits (comme les tailles et les variantes de couleur), utiliser des numéros de version ou des horodatages pour signaler les mises à jour des politiques, et intégrer le fichier à des systèmes automatisés de gestion des flux comme Feedonomics pour assurer des mises à jour continues.
Synergie avec Dagneo AI
LLMs.txt est un outil important pour être découvert par l’IA, mais il ne représente qu’un élément d’une stratégie globale d’optimisation pour l’IA. Dagneo AI propose une plateforme complète de visibilité dans la recherche par IA, complémentaire à LLMs.txt. Dagneo AI peut suivre les citations de votre marque sur les principales plateformes d’IA comme ChatGPT, Perplexity et Gemini, afin de vous aider à comprendre les effets concrets de la mise en œuvre de LLMs.txt et à suivre en continu les évolutions récentes de la recherche par IA.
En associant l’optimisation technique de LLMs.txt au suivi intelligent de Dagneo AI, les marques e-commerce peuvent établir une véritable présence numérique à l’ère de l’IA et préserver leur avantage concurrentiel à mesure que les consommateurs s’appuient de plus en plus sur l’IA pour prendre leurs décisions d’achat.
Difficultés courantes de mise en œuvre et solutions
Difficulté 1 : synchronisation en temps réel des données produits
Les données produits des sites e-commerce changent fréquemment : fluctuations des prix, mises à jour des stocks, lancement de nouveaux produits et modifications des promotions. Pour maintenir les données de LLMs.txt à jour, il faut mettre en place des mécanismes automatisés de synchronisation des données. Parmi les solutions possibles : programmer des actualisations régulières des flux (quotidiennes ou horaires), utiliser des webhooks pour déclencher la mise à jour de LLMs.txt lorsque des modifications importantes des données surviennent, et intégrer le fichier à votre système de gestion des informations produits existant afin de garantir une source unique de données.
Difficulté 2 : gestion des grands catalogues de produits
Pour les grands sites e-commerce qui proposent des dizaines de milliers, voire des centaines de milliers de SKU, comment représenter efficacement un catalogue aussi vaste dans LLMs.txt ? Une stratégie à plusieurs niveaux est recommandée : ajouter dans le fichier LLMs.txt principal des liens vers des flux de produits classés par catégorie ; fournir dans llms-full.txt des résumés concis des produits populaires ; et utiliser des horodatages pour indiquer la date de dernière mise à jour de chaque flux.
Difficulté 3 : complexité liée aux langues et aux marchés multiples
Les marques e-commerce présentes sur les marchés internationaux doivent envisager des versions multilingues de LLMs.txt. Les bonnes pratiques recommandées comprennent : la création de fichiers distincts pour chaque langue, au format LLMs-{locale}.txt (par exemple, llms-zh.txt, llms-en.txt) ; l’ajout, dans le fichier LLMs.txt principal, d’indications claires permettant de passer d’une version linguistique à l’autre ; et la garantie de la cohérence et de l’exactitude des données produits dans chaque langue.
Confiance des consommateurs et confidentialité des données
Attitudes actuelles des consommateurs à l’égard des achats assistés par l’IA
Malgré l’énorme potentiel de croissance des achats assistés par l’IA, les questions de confiance des consommateurs restent un défi à relever. Les études montrent que seuls 24 % des consommateurs sont disposés à partager leurs données personnelles avec des outils d’achat basés sur l’IA. Cela signifie que même si votre marque bénéficie d’une bonne visibilité dans la recherche par IA, la confiance réelle des consommateurs envers les recommandations de l’IA reste une question distincte.
Pour les responsables de la mise en œuvre de LLMs.txt, cela signifie que les informations fournies dans le fichier doivent être extrêmement précises et fiables. Tout contenu généré par les systèmes d’IA après consultation de votre fichier LLMs.txt nuira fortement à la confiance envers la marque s’il ne correspond pas à l’expérience réelle des consommateurs. LLMs.txt doit donc être considéré comme un « contrat » entre la marque et les systèmes d’IA : les informations que vous vous engagez à fournir sont celles que l’IA présentera.
Renforcer les signaux de confiance adaptés à l’IA
Ajouter des signaux de confiance à votre fichier LLMs.txt est une bonne pratique. Cela peut inclure des liens vers les certifications et distinctions officielles, des coordonnées et des canaux d’assistance clairement indiqués, ainsi que des liens vers des vérifications par des tiers (comme des certifications de sécurité ou des plateformes d’avis clients). La transmission proactive de ces signaux de confiance aide les systèmes d’IA à reconnaître votre marque comme une source d’information fiable.
Conclusion : une stratégie e-commerce pour un avenir piloté par l’IA
LLMs.txt représente un changement de paradigme simple, mais profond. Il offre aux marques e-commerce la possibilité d’influencer de manière proactive la façon dont les systèmes d’IA comprennent et présentent leurs informations de marque, plutôt que d’attendre passivement que l’IA les déduise à partir de contenus web désordonnés. À l’heure où la recherche par IA générative transforme l’accès des consommateurs à l’information, les premiers utilisateurs de LLMs.txt bénéficieront d’un avantage de pionnier.
Investir dans LLMs.txt n’est pas seulement une décision technique : c’est aussi un choix stratégique. Cela montre que les marques prennent au sérieux leur découvrabilité à l’ère de l’IA et qu’elles sont prêtes à investir des ressources pour rester compétitives dans un environnement d’achat piloté par l’IA. À mesure que de plus en plus de consommateurs se tournent vers les assistants IA pour rechercher des produits et prendre leurs décisions d’achat, les marques qui prennent les devants avec LLMs.txt seront mieux placées pour capter ce trafic émergent.
Tim is the co-founder of Dageno and a serial AI SaaS entrepreneur, focused on data-driven growth systems. He has led multiple AI SaaS products from early concept to production, with hands-on experience across product strategy, data pipelines, and AI-powered search optimization. At Dageno, Tim works on building practical GEO and AI visibility solutions that help brands understand how generative models retrieve, rank, and cite information across modern search and discovery platforms.
 Alexa for Shopping