Découvrez la position de votre marque sur le marché de l'IA
Identifiez les opportunités de croissance à privilégier en fonction de la demande du marché, du paysage concurrentiel, des propositions de valeur de la marque et des sources de citation.
Comment les questions d'achat posées à l'IA varient d'un marché à l'autre
Dans le test de FTA Global, en moyenne 2,9 des cinq marques les plus recommandées par l'IA changeaient hors de la référence « New York + anglais ». Cet article détaille quatre façons dont les questions d'achat posées à l'IA diffèrent selon les marchés (où les gens posent la question, contraintes locales, sources citées et marques recommandées) et propose une méthode en cinq étapes pour les comparer.
Dans cet article, les « questions d'achat posées à l'IA » désignent les questions d'achat, de comparaison et de prix que les gens posent à ChatGPT, Gemini, Google AI Mode et à d'autres outils d'IA.
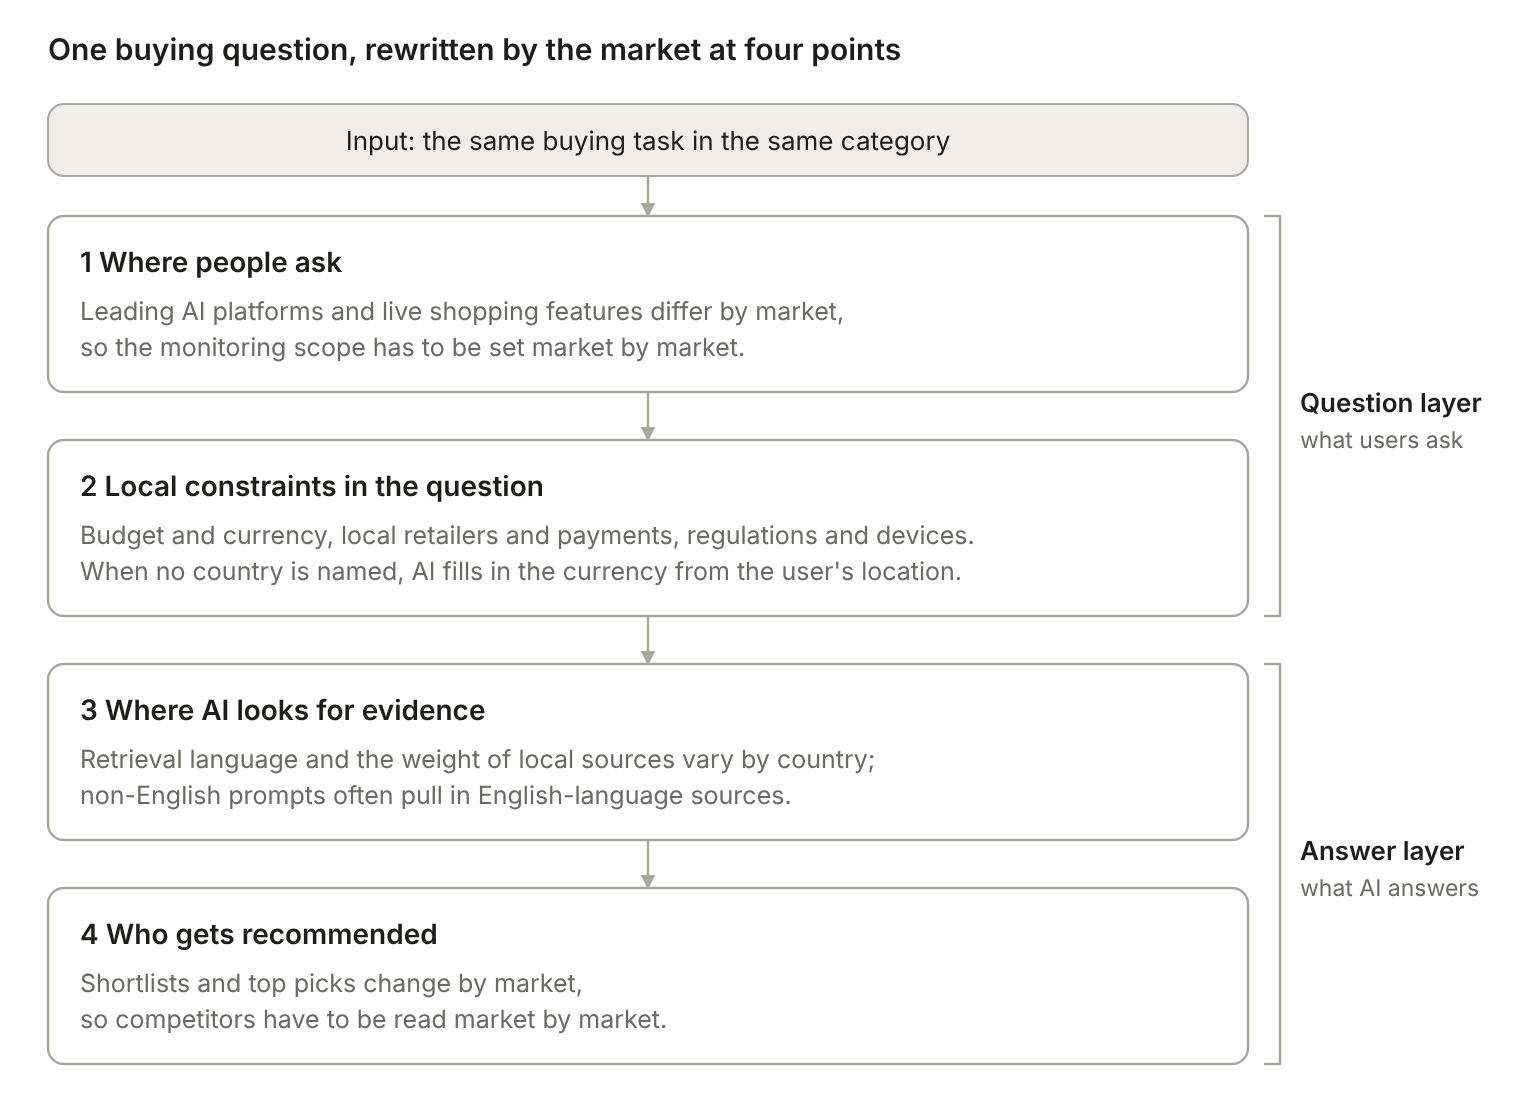
Une même question d'achat, dans une même catégorie, change sur au moins quatre points quand on passe à un autre pays, une autre région ou un autre marché linguistique : à quelle IA les gens posent la question, quelles contraintes locales elle contient, où l'IA cherche ses preuves et quelles marques elle finit par recommander.
Les tests publics montrent que l'écart est important. FTA Global a testé 10 catégories de logiciels sur ChatGPT et Gemini : hors de sa référence « New York + anglais », en moyenne 2,9 des cinq marques les plus recommandées changeaient. Dans un autre test en cinq langues, easyJet était le premier choix dans 72,5 % des réponses en russe, mais seulement dans 12,5 % des réponses en persan.
Une mise en garde d'emblée (c'est notre jugement) : la plupart des études publiques mesurent les réponses qu'obtient la même question sur différents marchés. Très peu mesurent comment les gens de chaque marché posent réellement leurs questions. Il faut pour cela de vrais échantillons de questions dans la langue locale ; traduire des prompts anglais ne vous les donnera pas.
En pratique, traitez « pays × langue × plateforme » comme une unité de comparaison. Échantillonnez chaque unité à plusieurs reprises avec un ensemble de questions localisé, puis comparez sur quatre dimensions. Quand vous constatez un écart, expliquez-le d'abord par les prix locaux, la disponibilité et les sources citées, et seulement ensuite décidez s'il faut modifier les contenus.
Pourquoi les questions d'achat posées à l'IA dans une même catégorie diffèrent selon le marché
Un « marché » correspond ici à trois variables superposées : le pays ou la région de l'utilisateur, la langue de la question et la plateforme d'IA. Il suffit que l'une d'elles change pour que la même question d'achat reçoive une autre réponse. Le Royaume-Uni et les États-Unis partagent une langue, alors que l'Inde mêle anglais, hindi et hinglish ; pays et langue doivent donc être notés séparément.
La localisation seule peut réécrire une réponse. Dans un test publié en octobre 2026, Massive a envoyé à ChatGPT, au même moment depuis les États-Unis, le Brésil et le Japon, le même prompt demandant « le prix habituel d'une tasse de café dans un café ». Le prompt ne mentionnait aucun pays. La réponse américaine donnait des prix en dollars, tandis que les réponses brésilienne et japonaise ajoutaient des prix en reais et en yens. Chaque pays n'a été testé qu'une fois : le test montre que l'effet existe, pas à quelle fréquence il se produit.
Séparez deux niveaux dans votre analyse. Le niveau de la question, c'est ce que les utilisateurs ont demandé et les conditions qu'ils y ont ajoutées. Le niveau de la réponse, c'est les sources utilisées par l'IA et les marques qu'elle a recommandées. Quand une marque « disparaît » sur un marché, il se peut que les utilisateurs locaux posent simplement une autre question, ou que les sources et préférences de l'IA aient changé. Les quatre sections suivantes suivent cet ordre.
Quatre niveaux de différence, traités dans les quatre sections ci-dessous.
Différence 1 : l'IA à laquelle on pose la question varie selon le marché
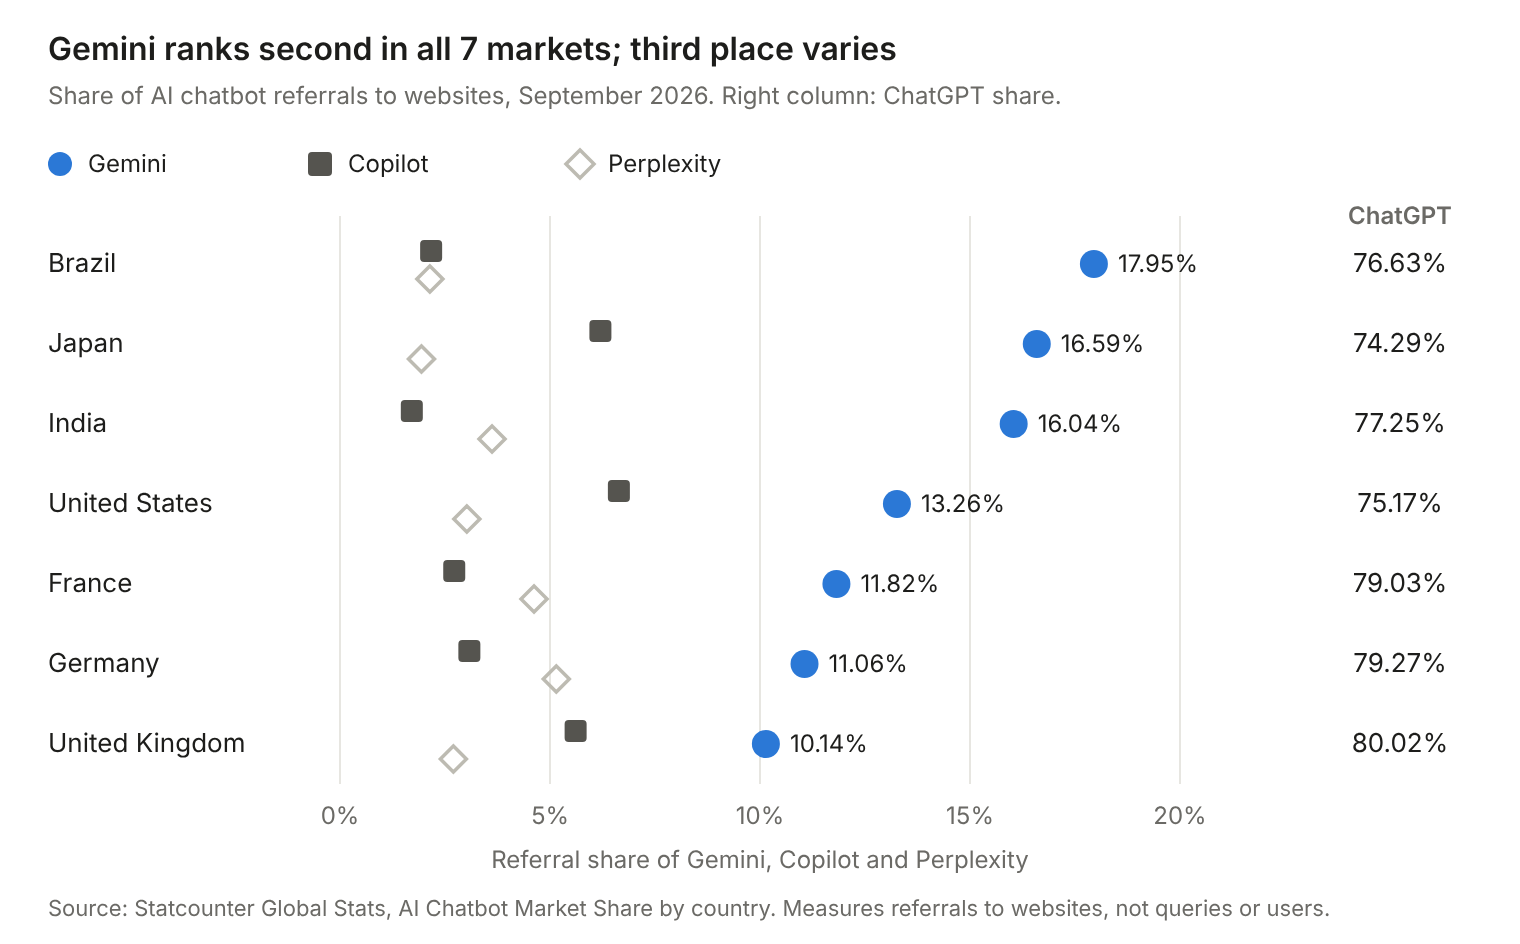
ChatGPT arrive en tête sur tous les grands marchés internationaux, mais l'ordre qui suit diffère. Les données Statcounter de septembre 2026 placent ChatGPT autour de 74 %–80 % sur chacun des sept marchés ci-dessous. Gemini dépasse 16 % au Brésil, au Japon et en Inde, mais tourne autour de 10 % au Royaume-Uni. Copilot dépasse 6 % aux États-Unis et au Japon, mais reste sous 2 % en Inde. Perplexity est plus élevé en Allemagne et en France que sur les autres marchés présentés.
Source : Statcounter Global Stats, part des visites provenant des chatbots d'IA, septembre 2026, sept marchés.
Attention à l'indicateur. Statcounter mesure la part de chaque chatbot dans les visites envoyées vers des sites (sur la base des pages vues des sites qu'il suit). Ce n'est ni un nombre de questions ni un nombre d'utilisateurs, et Grok, qui ne transmet pas de données de provenance, en est exclu. Cela indique quelles plateformes envoient des visiteurs vers des sites sur un marché ; cela ne permet pas d'estimer le volume de questions d'achat.
Les données d'enquête vont dans le même sens. Une enquête du World Retail Congress commandée par Vercel (mai 2026, 4 000 acheteurs européens), rapportée par Pygmalios, montre que 49 % des répondants d'Europe du Sud utilisent ChatGPT pour leurs achats, contre 40 % dans les pays nordiques, 38 % en Allemagne et 33 % au Royaume-Uni. La moitié des répondants britanniques n'utilisent aucune recherche IA pour leurs achats, contre 32 % en Europe du Sud. Ces chiffres sont déclaratifs, l'Europe du Sud et les pays nordiques regroupent plusieurs pays, et Pygmalios rappelle lui-même que « les intentions déclarées surestiment régulièrement le comportement observé ».
L'ordre de déploiement des fonctionnalités crée aussi des écarts. Quand OpenAI a lancé Instant Checkout dans ChatGPT le 29 septembre 2025, la fonction n'était ouverte qu'aux utilisateurs américains, et les seuls marchands étaient des vendeurs Etsy américains. Une demande du type « achète-le pour moi » pouvait être réglée dans le chat sur les marchés équipés du paiement intégré, mais ailleurs elle ne pouvait que renvoyer vers un site externe. Nous n'avons pas vérifié quels marchés la fonction couvre en octobre 2026 ; vérifiez-le séparément avant de comparer des marchés.
Différence 2 : les questions d'achat contiennent des contraintes locales différentes
Même quand la question est « lequel choisir », chaque marché y ajoute des conditions différentes. Certaines sont écrites dans la question ; d'autres sont déduites de la localisation de l'utilisateur.
Contraintes écrites dans la question : un budget en monnaie locale, des plateformes de vente locales, des options de paiement et de livraison, des réglementations ou obligations fiscales locales. Les paiements en sont un exemple évident. Dans le test de FTA Global, Stripe arrivait premier à New York, Londres, Madrid, Paris et Berlin, mais n'entrait pas dans le top 5 à Mumbai, Delhi ou Bengaluru. Avec un écosystème de paiement local différent, « quel outil de paiement une petite entreprise doit-elle utiliser » devient en pratique une autre question.
Contraintes déduites de la localisation : même quand l'utilisateur ne cite aucun pays, l'IA déduit la monnaie et les règles à partir de la localisation, comme le montre le test du café. Quand vous comparez des marchés, notez où chaque réponse a été collectée.
Jusqu'où la question va dans le parcours d'achat : dans l'enquête de Deloitte de mai 2026 auprès de 13 500 consommateurs de 15 pays européens, 42 % des répondants en Espagne étaient prêts à laisser l'IA prendre des décisions d'achat à leur place, contre 27 % en Finlande. Sur les marchés où davantage de personnes confient la décision à l'IA, des questions comme « choisis-en un pour moi » ou « donne-moi la meilleure option » sont peut-être plus courantes. C'est une hypothèse à tester sur des échantillons de questions locales.
Tous les besoins ne varient pas selon le marché. Dans l'enquête du World Retail Congress citée plus haut, la comparaison de prix était l'usage le plus courant chez les acheteurs qui utilisent l'IA dans toutes les régions (51 %–55 %). Notre jugement : l'action contenue dans une question est similaire d'un marché à l'autre, et les écarts portent surtout sur les fourchettes de budget, les canaux disponibles et les règles locales. Quand vous organisez les questions, donnez donc une colonne à part au budget et à la monnaie, aux plateformes citées, au paiement et à la livraison, à la réglementation et aux conditions d'appareil.
Différence 3 : l'IA cite des sources différentes, et les utilisateurs ne lui font pas confiance de la même façon
Pour les questions d'achat sur les marchés non anglophones, une grande partie des preuves vient encore de pages web en anglais. Peec AI a analysé plus de 10 millions de prompts ChatGPT et plus de 20 millions de recherches en arrière-plan (query fan-outs), en ne gardant que les sessions où la localisation de l'utilisateur correspondait à la langue du prompt. Près de 78 % des sessions dans une autre langue que l'anglais ajoutaient des recherches en anglais, et 43 % des fan-outs des prompts non anglais étaient lancés en anglais. Par langue, les sessions en turc ajoutaient le plus souvent des recherches en anglais (94 %) et les sessions en espagnol le moins souvent (66 %).
Le poids des sources locales varie aussi selon les pays. Dans le test de FTA Global, les domaines et publications locaux représentaient 42 % des sources citées en Allemagne, 34 % en France et 17 % en Inde. Là où les sources locales pèsent moins, les marques locales ont peut-être besoin d'une présence sur des sites anglophones ou internationaux pour entrer dans les réponses. Les tests manuels de Peec AI donnent un exemple : interrogé en polonais depuis une adresse IP polonaise sur les meilleurs sites d'enchères, ChatGPT a soit omis Allegro, la principale plateforme locale polonaise, soit l'a reléguée loin dans la liste. C'est un exemple isolé, pas un résultat statistique.
La confiance dans les réponses de l'IA diffère aussi. Dans la même enquête de Deloitte, 61 % des répondants en Espagne disaient faire confiance aux informations fournies par l'IA, contre 36 % en Finlande. Notre hypothèse : sur les marchés où la confiance est plus faible, les utilisateurs vérifient davantage les sources, les avis et les garanties après-vente, si bien que les éléments vérifiables localement comptent davantage. Aucune donnée publique ne le teste encore directement.
Différence 4 : les marques recommandées et les concurrents changent
En cumulant les trois premières différences, les utilisateurs finissent par voir des listes restreintes différentes. En prenant « New York + anglais » comme référence, FTA Global a reposé les mêmes questions d'achat de petites entreprises à Londres, Madrid, Paris, Berlin et dans trois villes indiennes :
En moyenne, 2,9 des cinq marques les plus recommandées changeaient.
Les changements se concentraient dans les catégories liées à l'argent et à la conformité : paie, comptabilité, paiements et RH affichaient en moyenne 4,4 marques remplacées, contre seulement 1,5 pour la gestion de projet, la visioconférence et le stockage cloud.
Sur 206 marques au total, 159 n'entraient dans le top 5 qu'à un seul endroit.
La langue change aussi le premier choix. Un test de Reza Moaiandin, cofondateur de SALT.agency, publié dans Search Engine Journal, a posé le même ensemble de questions d'achat en anglais, arabe, russe, chinois simplifié et persan. Le test principal utilisait Claude Sonnet 5 avec la recherche web désactivée, avec une collecte le 7 septembre 2026 et 40 exécutions par paire scénario-langue. Le tableau donne la part des réponses où chaque marque était le premier choix :
Scénario
Marque
Part la plus élevée
Part la plus faible
Vol aller-retour Londres–Tenerife
easyJet
Russe 72,5 %
Persan 12,5 %
Casque à réduction de bruit à moins de 400 £
Sony
Russe et persan 100 %
Anglais 50 %
CRM pour une petite entreprise britannique
HubSpot CRM
Anglais 22,5 %
Arabe 2,5 %
Robot aspirateur à moins de 500 £
Roborock
Russe 97,5 %
Anglais et arabe 87,5 %
La ligne du robot aspirateur montre que toutes les catégories ne fluctuent pas fortement. Dans le même test, activer la recherche web pour deux des catégories a changé le premier choix dans 7 des 10 paires catégorie-langue. Pour ces deux mêmes catégories avec la recherche désactivée, le premier choix de ChatGPT ne correspondait à celui de Claude que dans 1 paire sur 10, et à celui de Gemini dans 5. L'auteur précise que les données ont été collectées en un seul après-midi et que les résultats donnent une tendance.
La recherche académique observe une tendance similaire. L'article de l'EMNLP 2024 « Global is Good, Local is Bad? » a montré que les LLM associent plus souvent des attributs positifs aux marques mondiales et recommandent de façon disproportionnée des cadeaux de luxe aux habitants des pays à revenu élevé, même si l'effet du pays d'origine peut avantager les marques locales dans certains contextes. Pour les marques, cela signifie que les concurrents dépendent du marché : les marques que vous affrontez directement aux États-Unis peuvent être remplacées par un autre groupe de marques locales en Inde ou en Pologne.
Comment comparer de manière systématique les questions d'achat entre marchés
Traitez « pays ou région × langue × plateforme » comme la plus petite unité de comparaison et suivez cinq étapes.
Définir les unités de comparaison : notez le pays ou la région, la langue et la plateforme de chaque unité. Séparez par langue les pays multilingues, par exemple l'anglais et le hindi en Inde, ou l'anglais et le français au Canada.
Construire un ensemble de questions localisé : collectez de vraies formulations dans des sources locales comme les suggestions de recherche locales, les forums et les données du service client et des ventes, et faites-les relire par un locuteur natif. Gardez un ensemble de tâches d'achat commun à tous les marchés pour comparer, puis ajoutez les questions propres à chaque marché.
Fixer les conditions et échantillonner plusieurs fois : utilisez la même période, le même modèle et les mêmes paramètres de recherche, et répétez chaque condition plusieurs fois. FTA Global a exécuté chaque condition 5 fois ; le test de SALT, 40. Notez le lieu de collecte et l'état du compte.
Comparer sur quatre dimensions : voir le tableau ci-dessous.
Expliquer les écarts par les faits locaux : vérifiez d'abord les prix locaux, la disponibilité, les canaux et la réglementation, puis décidez s'il faut créer un contenu localisé, mettre à jour une page commune ou continuer d'observer.
Dimension
À noter pour chaque marché
Erreur d'interprétation fréquente
Où les gens posent la question
Principales plateformes d'IA locales ; disponibilité des fiches d'achat, du paiement intégré et de fonctions similaires
Ne tester que ChatGPT, en anglais américain uniquement
Contraintes de la question
Texte original de la question ; budget et monnaie ; plateformes, paiements, livraison, réglementation et appareils mentionnés
Traiter une question anglaise traduite comme une question locale
Sources des preuves
URL citées, langue de la source, sites locaux ou internationaux
Compter les domaines sans lire les sources
Recommandations
Premier choix, liste du top 5, présence de votre marque et contexte
Laisser une seule capture d'écran représenter tout un marché
Comparer avec Dageno les questions d'achat entre marchés internationaux
Les quatre dimensions ci-dessus correspondent à plusieurs fonctionnalités de Dageno :
Cross-Model and Regional Benchmarking : compare la visibilité, le rang et les principaux concurrents de votre marque selon les modèles d'IA et les régions, pour qu'une moyenne ne masque pas les endroits où votre position change.
Regional Comparison : réunit dans une seule vue vérifiable les réponses d'IA observables, le contexte concurrentiel et les sources visibles de différents marchés et langues.
AI Search Intents : regroupe les prompts d'un marché par intention ; pour chaque groupe, vous voyez quelles marques les réponses mentionnent et quelles pages elles citent.
Si l'objectif est de choisir le prochain marché, la solution d'expansion de marché enchaîne ces modules en trois vérifications : comparer les marchés, comprendre chaque marché et choisir quoi vérifier.
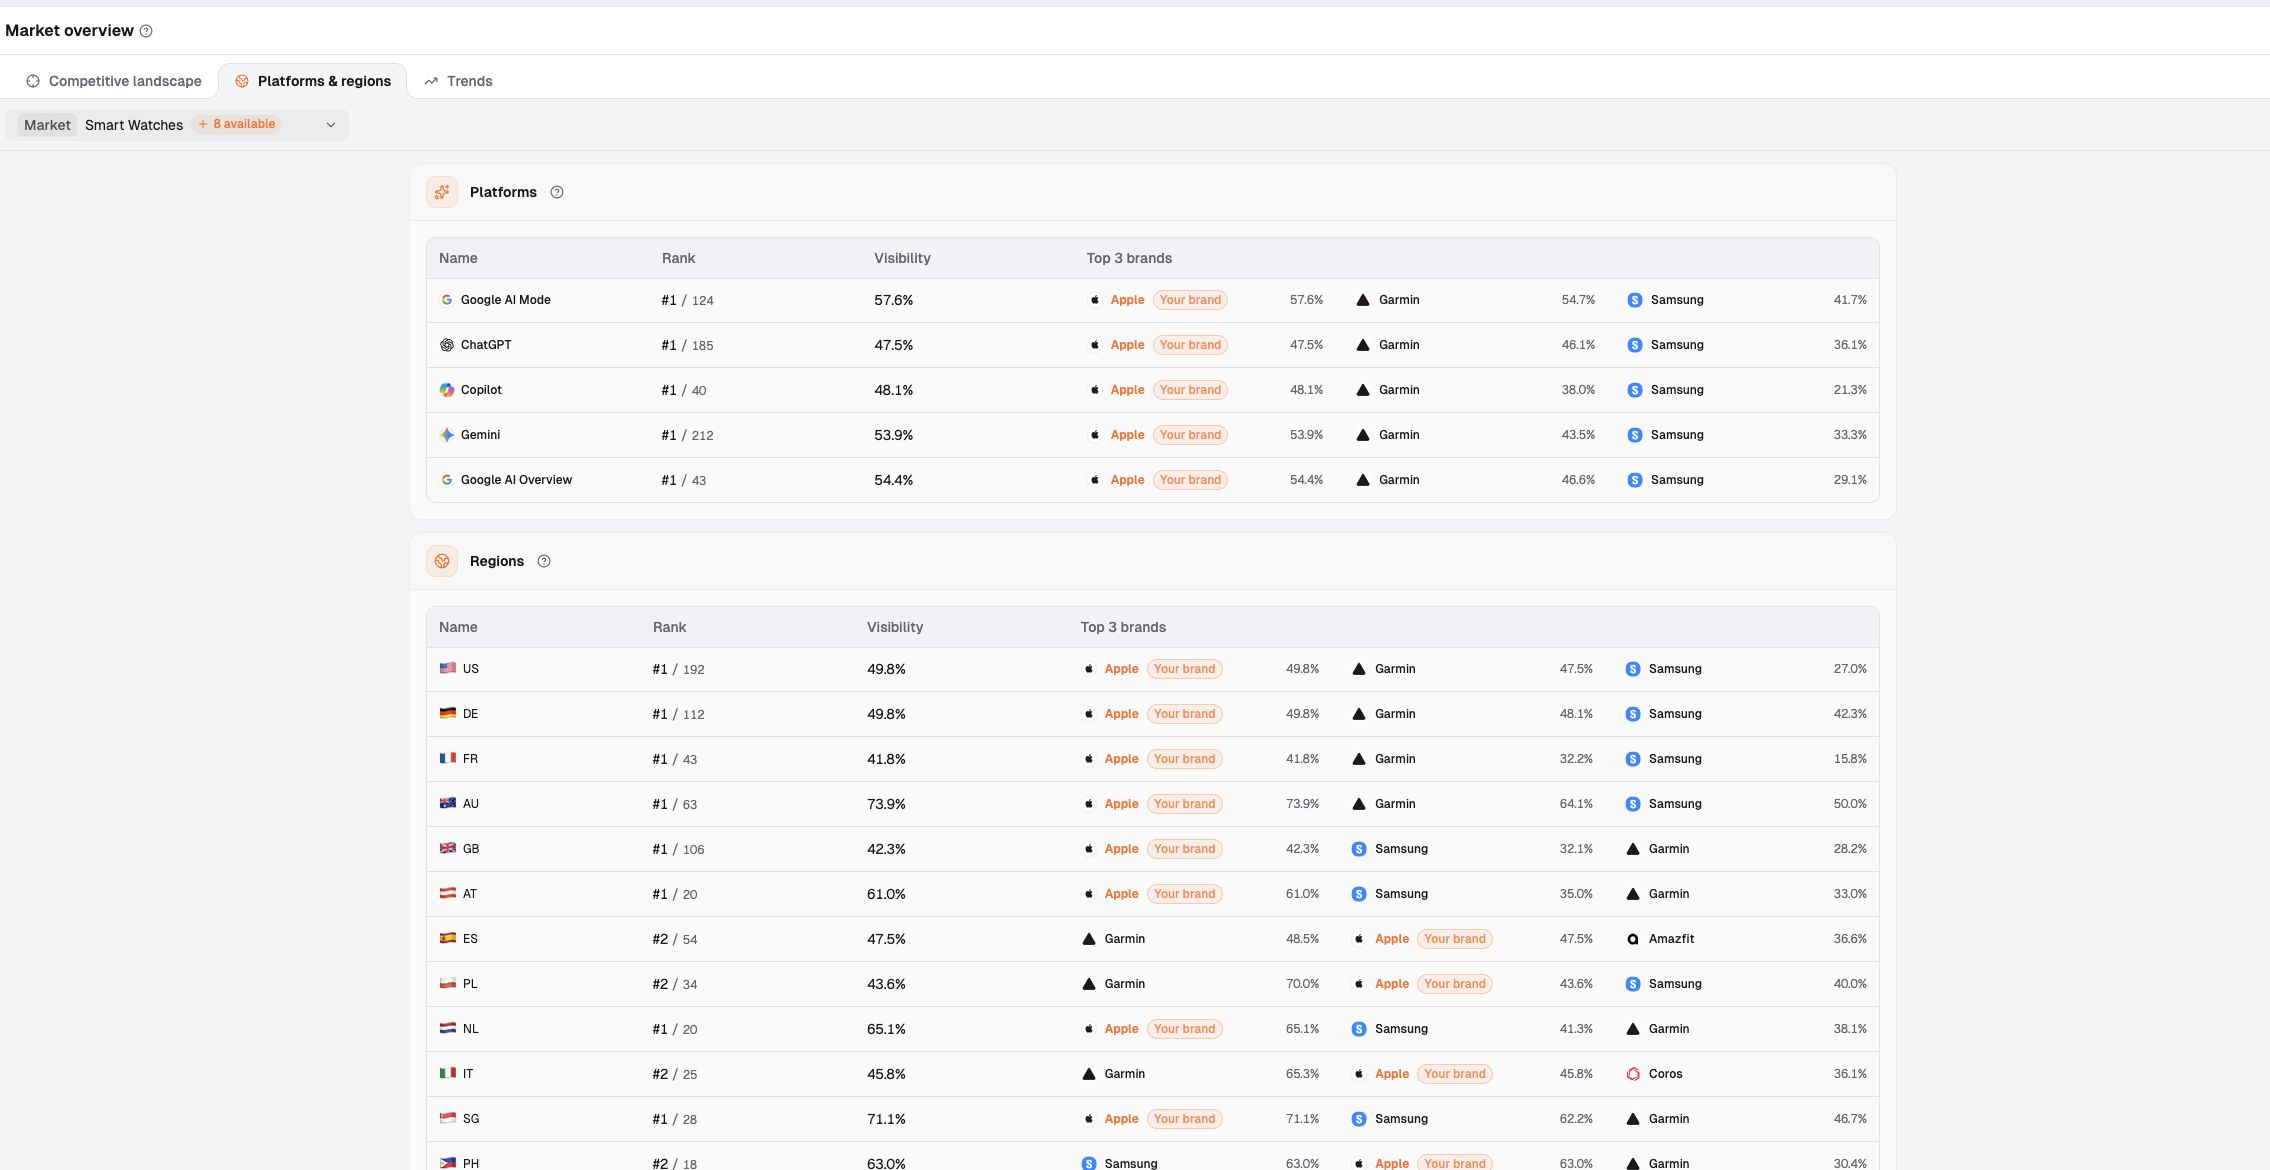
Prenez l'exemple du marché des montres connectées dans un espace de démonstration Dageno (Apple n'est que la marque d'exemple et n'est pas cliente de Dageno). Le tableau des régions sous « Market overview → Platforms & regions » montre Apple 1re sur la plupart des marchés, mais 2e en Espagne, en Pologne et en Italie, où Garmin est en tête.
Figure 1 : un marché des montres connectées, avec le rang et la visibilité de la marque répartis par plateforme d'IA et par région.
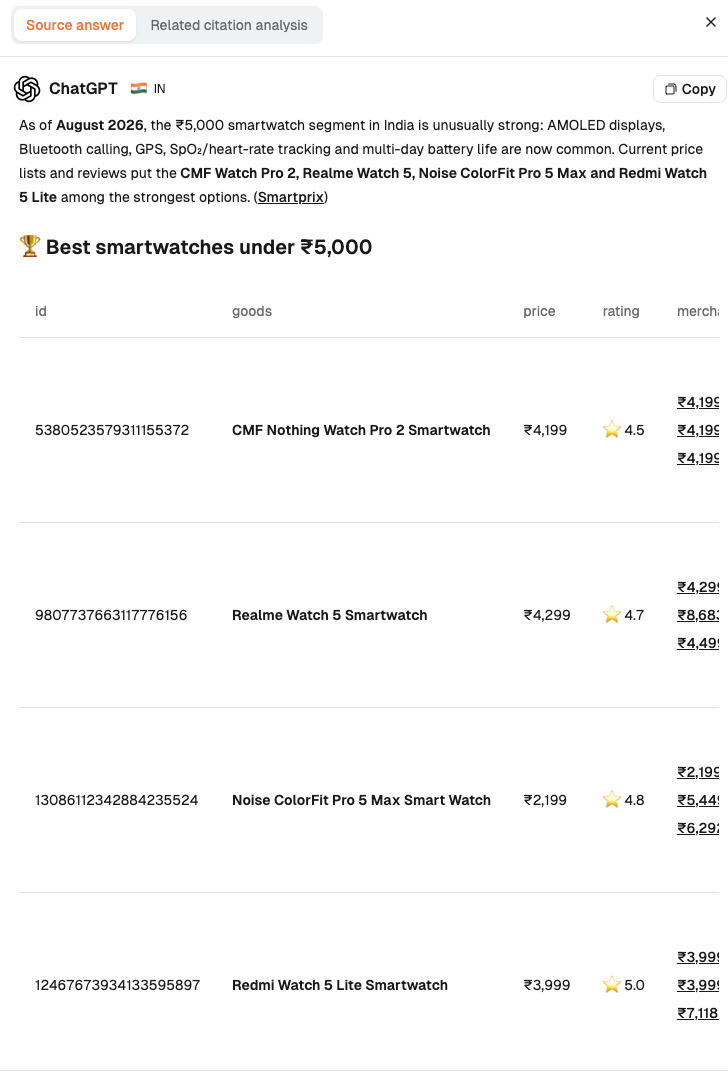
Le tableau des régions indique seulement où regarder en premier ; pour voir les questions elles-mêmes, il faut ouvrir les réponses. Dans l'étude de cas publiée par Dageno, Visibilité IA par région : quand localiser vos pages, Apple est 14e en Inde avec 4,76 % de visibilité. À la lecture des réponses, on voit que les deux réponses indiennes recommandent des montres à moins de ₹5,000, alors que le site indien d'Apple affichait l'Apple Watch SE 3 à partir de ₹29,900 (vérifié le 30 septembre 2026, selon l'étude de cas).
Figure 2 : réponse de ChatGPT pour l'Inde (IN), la question étant limitée à moins de ₹5,000.
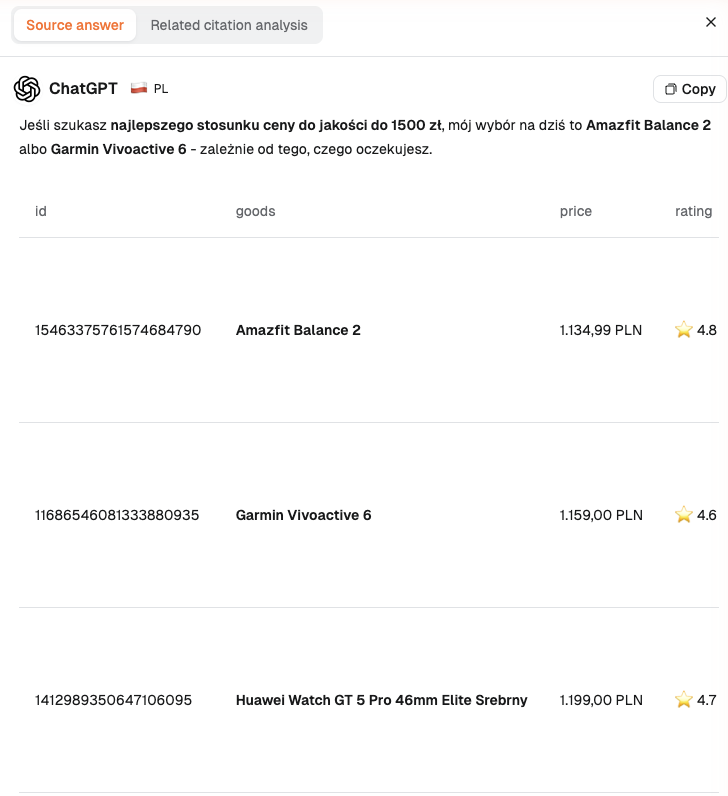
La réponse polonaise, elle, est en polonais avec un budget de 1500 zł. Elle recommande des montres d'Amazfit, Garmin, Huawei, Samsung et d'autres, et ses citations proviennent surtout de sites locaux de vente et de comparaison de prix comme euro.com.pl, ceneo.pl, mediamarkt.pl et allegro.pl.
Figure 3 : réponse de ChatGPT pour la Pologne (PL), qui recommande en polonais des montres dans un budget de 1500 zł.
Ces deux marchés correspondent aux deux types de différence décrits plus haut : en Inde, c'est la contrainte de budget de la question qui a changé ; en Pologne, ce sont la langue et les sources locales. Les échantillons sont petits (deux réponses pour l'Inde, une seule réponse comparable pour la Pologne) ; l'étude de cas conclut donc « classer comme question hors cible » pour l'Inde et « continuer d'observer » pour la Pologne.
Ces vues enregistrent des réponses d'IA sauvegardées. Comme l'indique la page d'expansion de marché de Dageno, la visibilité IA entre marchés « ne mesure ni la demande totale, ni la taille du marché, ni le potentiel de ventes, ni la part de marché, ni les préférences des acheteurs ». Choisir un marché exige toujours des études internes ainsi qu'un examen produit, canaux et conformité. Selon le blog de Dageno, la consultation gratuite couvre 86 pays et régions et 12 000 segments de marché ; vous pouvez donc commencer par vérifier où se situe votre marque sur un marché cible.
Variables, biais et coûts négligés
Lorsque vous comparez des marchés, les facteurs suivants se confondent facilement avec des « différences de marché » ou peuvent faire grimper le coût de la comparaison au-delà des prévisions.
La localisation et la langue sont deux variables : FTA Global a posé la même question sur les paiements à Mumbai en anglais, en hindi et en hinglish. Les trois ont renvoyé surtout des marques indiennes, mais les listes et leur ordre ont changé. Changer seulement l'IP sans la langue, ou seulement la langue sans la localisation, mesure des choses différentes.
Les réponses sont instables en elles-mêmes : dans le test de FTA Global, les cinq exécutions ne citaient la même marque en tête que dans 35 % des conditions. Un écart observé sur une seule exécution peut n'être qu'une variation aléatoire.
Plateforme, version et paramètres de recherche : pour la même ville et la même question, ChatGPT et Gemini n'avaient en moyenne que 3,2 marques communes dans leur top 5 (FTA Global) ; dans le test de SALT, activer la recherche a changé le premier choix dans 7 paires sur 10. Ne regroupez pas des résultats obtenus dans des conditions différentes.
Les indicateurs diffèrent : Statcounter mesure les visites envoyées vers des sites, pas l'usage. Les enquêtes consommateurs sont déclaratives, certaines portent sur un seul pays, d'autres en regroupent plusieurs. Dans le rapport de Deloitte, les taux d'usage de l'IA de quelques pays diffèrent légèrement entre le graphique et le tableau en annexe ; vérifiez le tableau d'origine avant de citer.
La position de ceux qui publient les études : Peec AI, FTA Global et SALT.agency, tous cités ici, vendent des services de GEO ou de visibilité IA, tout comme Dageno. Leurs conclusions vont dans le même sens, mais leurs échantillons et méthodes diffèrent ; mieux vaut refaire le test avec vos propres catégories et marchés.
Le coût augmente avec le nombre de combinaisons : chaque combinaison supplémentaire « pays × langue × plateforme » ajoute du travail d'échantillonnage et de lecture des réponses, et les ensembles de questions locales doivent être relus par des natifs. Approfondir les 2 ou 3 marchés les plus importants pour l'entreprise est plus réaliste que de s'éparpiller sur une douzaine à la fois.
Le temps change les conclusions : les fonctionnalités des plateformes sont déployées marché par marché et les modèles continuent d'évoluer. Datez chaque comparaison et ne comparez pas directement d'anciens résultats avec de nouveaux.
Comparez la visibilité de votre marque dans la recherche IA d'un marché à l'autre
Traduire des questions anglaises dans la langue locale représente-t-il les questions des utilisateurs locaux ?
Seulement en tant que « même tâche posée dans la langue locale ». Cela ne reflète ni les budgets locaux, ni les canaux, ni les formulations du quotidien. Les questions traduites servent d'ensemble témoin entre marchés ; ajoutez des formulations natives tirées des suggestions de recherche locales, des forums et des données du service client.
Combien de langues faut-il tester dans un pays ?
Suivez les langues qu'utilisent réellement les acheteurs locaux. Sur les marchés multilingues comme l'Inde, la Suisse et le Canada, testez au moins séparément les langues principales. Si une partie de vos acheteurs pose ses questions en anglais (par exemple des équipes achats de multinationales), notez aussi les formulations anglaises à part.
Combien de réponses par marché suffisent ?
Il n'existe pas de chiffre universel. Dans les tests publics, FTA Global a exécuté chaque condition 5 fois et SALT 40 fois. Notre recommandation : ne tirez pas de conclusion sur un marché tant que le premier choix n'est pas stable d'une exécution à l'autre, et échantillonnez davantage dans les catégories instables.
Suivre uniquement ChatGPT suffit-il ?
Pas sur la plupart des marchés. ChatGPT a la plus grande part des visites, mais Gemini dépasse 16 % sur certains marchés, et ChatGPT et Gemini ne partagent en moyenne que 3,2 marques de leur top 5 pour une même question. Ajoutez au minimum les deuxième et troisième plateformes de chaque marché.
Si un marché affiche des recommandations différentes, faut-il créer tout de suite une page localisée ?
Non. Vérifiez d'abord si la question elle-même est différente, par exemple un budget inférieur à votre gamme de produits. Vérifiez ensuite si le produit est vendu localement et ce que disent les sources locales. Une page localisée ne vaut la peine que si les faits locaux diffèrent réellement et que des échantillonnages répétés montrent toujours l'absence de votre marque.
Conclusion
Les questions d'achat posées à l'IA sur différents marchés internationaux diffèrent à quatre niveaux : la plateforme à laquelle les gens posent la question, les contraintes que contient la question, l'origine des preuves de l'IA et la marque qu'elle finit par recommander. Les tests publics montrent déjà que s'en tenir aux résultats en anglais américain peut vous tromper sur plus de la moitié de la liste restreinte (dans le test de FTA Global sur les catégories de logiciels, en moyenne 2,9 des cinq premières marques changeaient). Les données publiques sur la façon dont les utilisateurs locaux posent réellement leurs questions restent toutefois rares ; chaque marque doit donc échantillonner elle-même ses marchés et ses catégories.
Dageno is the research and insights team at Dageno AI, publishing industry reports and expert analysis on AI Search Visibility, Generative Engine Optimization (GEO), and AI-powered search discovery.
 Alexa for Shopping