Découvrez la position de votre marque sur le marché de l'IA
Identifiez les opportunités de croissance à privilégier en fonction de la demande du marché, du paysage concurrentiel, des propositions de valeur de la marque et des sources de citation.
Quand des modèles d’IA donnent des recommandations de marque opposées pour la même question, comment votre équipe doit-elle les interpréter et agir ?
Un modèle d’IA mentionne une marque, un autre l’omet. Un cas de montres connectées montre comment des questions différentes peuvent créer un conflit apparent et pourquoi l’étape suivante consiste à élargir les réponses comparables.
Lorsque des modèles d’IA semblent donner des recommandations de marque opposées pour la même question, vérifiez d’abord qu’ils ont réellement répondu à la même question. Décidez ensuite s’il faut agir. L’absence de réponse dans les relevés, une réponse qui omet la marque et un nombre de réponses trop faible sont des situations différentes. N’examinez les sources et n’envisagez une optimisation que lorsque la marque est absente de manière répétée de réponses comparables à la même question, dans la même région et le même périmètre d’observation, et que les acheteurs utilisent ce modèle.
Un cas de montres connectées dans Dageno montre pourquoi un LLM coverage gap mérite d’être examiné, sans encore prouver un conflit entre modèles. Les réponses de Google AI Overview sur les montres de sécurité pour enfants en Australie ne mentionnaient pas Apple. D’après leur contenu, les réponses de ChatGPT et de Gemini qui mentionnaient Apple dans la même région portaient sur les montres connectées en général. La décision consiste à fixer la question et à élargir d’abord l’échantillon comparable.
Pour le suivi, faites du modèle qui présente le signal d’absence le modèle principal, et des modèles qui ont déjà des réponses dans la même région les modèles de comparaison. Gardez en observation les modèles qui n’apparaissaient pas dans les réponses relevées. La marque doit aussi décider si les montres de sécurité pour enfants font partie de la demande qu’elle vise.
1. Distinguez trois types d’absence : aucune réponse relevée, aucune mention de la marque et trop peu de réponses
Aucune réponse relevée : vérifiez s’il existe un relevé pour ce segment
Prenons le marché des montres connectées dans le tableau de bord. Parmi les réponses relevées une à une cette fois-ci, aucune réponse de Google AI Mode ni de Copilot n’apparaissait pour cette sous-intention en Australie. Le responsable de l’étude doit indiquer « aucune réponse dans cet ensemble » pour ces cellules, et non « Apple est absente de ces modèles ». Cette distinction compte pour le suivi : on ne peut évaluer si une réponse mentionne la marque que pour un modèle qui a une réponse. Gardez les autres sur une liste d’observation jusqu’à ce qu’il y ait des relevés à examiner.
Allez dans Issues & opportunities, ouvrez Opportunity overview et sélectionnez la carte LLM coverage gap. Cliquez sur View analysis, puis sur View related AI responses. Le bouton affiche 203, le nombre total de réponses pour la sous-intention ; la liste qu’il ouvre ne contient que 9 réponses, toutes de Google AI Overview et sans mention d’Apple. Pour voir les 203 réponses de tous les modèles et régions, suivez Demand & insights → Search intents → Recommendations → See top recommendations → View AI responses. Pour l’Australie, lisez les étiquettes de modèle et de région en haut de chaque réponse.
Une réponse existe : relevez séparément les mentions et les recommandations
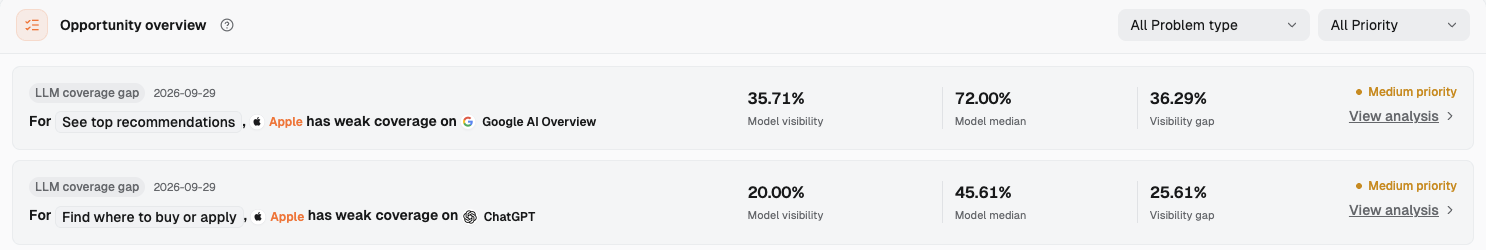
La carte affiche une Model visibility d’Apple de 35,71 % sur Google AI Overview, une Model median de 72,00 % et un Visibility gap de 36,29 %, avec une priorité Medium. Cela indique au responsable de l’étude où examiner les éléments de preuve. Cela ne dit pas quelles questions ont créé l’écart et ne désigne aucune page à modifier.
Cartes LLM coverage gap dans Opportunity overview : pour See top recommendations, la Model visibility d’Apple sur Google AI Overview est de 35,71 %, la Model median de 72,00 % et le Visibility gap de 36,29 %, avec une priorité Medium. La deuxième carte relève le même type d’écart sur ChatGPT.
Après avoir relevé une à une les 203 réponses de cette sous-intention, Google AI Overview en compte 14, dont 5 mentionnent Apple. La liste des réponses associées ouverte depuis la carte contient exactement les 9 autres, qu’il faut trier par besoin et par région. La marque est absente d’une réponse décrit cette seule réponse. Pour dire que la marque est absente des recommandations pour une question donnée, il faut aussi savoir si la réponse portait sur un choix d’achat auquel la marque pouvait raisonnablement participer. Une citation d’une page de la marque est une observation distincte et ne remplace pas une recommandation dans le texte de la réponse.
Dans Evidence preview, lisez le Source answer, puis Related citation analysis. Notez le modèle et la région en haut, le nom de la marque dans la réponse, et si elle a été recommandée, mentionnée en passant ou seulement présente sur une page citée. L’« absence » dispose ainsi d’une unité d’analyse claire.
Trop peu de réponses : conservez le signal et rassemblez des réponses comparables
Google AI Overview compte 4 réponses sur les montres de sécurité pour enfants en Australie, et aucune ne mentionne Apple. C’est un signal pour un besoin précis. Les autres modèles n’ont toutefois aucune réponse correspondante sur les montres pour enfants dans la même région dans les relevés actuels : l’équipe ne dispose donc d’un échantillon comparable d’aucun côté. Même plusieurs réponses d’un modèle ne remplacent pas des réponses à la même question si les questions du groupe diffèrent.
Le responsable de l’étude peut convenir à l’avance des questions à collecter ensuite, du nombre de réponses complètes à conserver par modèle et du moment de la revue. Les éléments actuels ne fournissent aucun seuil universel à partir duquel une équipe devrait agir. Vérifiez d’abord que les réponses portent sur la même question dans la même région, puis regardez si l’absence se poursuit dans les nouvelles réponses.
2. Vérifiez si le conflit se répète : combien de réponses chaque modèle a-t-il pour le même besoin et la même région ?
Définissez l’unité de comparaison avant de compter les réponses par modèle
La vue marché regroupe les réponses par sous-intention, ce qui aide à repérer des anomalies dans un type de demande. Pour comparer des recommandations de marque, fixez aussi la région, la langue et la question elle-même. « Choisir une montre connectée pour un utilisateur de smartphone » et « choisir une montre de sécurité avec localisation pour un enfant » peuvent figurer toutes deux dans Recommendations, mais les exigences de l’acheteur diffèrent. Les mélanger pourrait faire passer une différence de question pour une différence de modèle.
Pour chaque réponse complète, notez le modèle, la région, la question à laquelle elle semble répondre, si elle mentionne la marque et si elle la recommande clairement. Indiquez séparément le nombre de réponses de chaque modèle. Le total de la liste n’est le dénominateur d’aucun modèle. La liste n’a pas de filtre par modèle : une personne doit donc vérifier et noter une à une les étiquettes en haut des réponses. Ne comptez chaque réponse qu’une fois, même si elle est rouverte.
Étude de cas : ce que contient l’écart signalé entre modèles
La carte LLM coverage gap classe Google AI Overview en priorité Medium. Elle montre les 35,71 % d’Apple sous la Model median de 72,00 %, soit un écart de 36,29 %. Ouvrez View analysis. Sous Where the problem occurs, le panneau affiche What the user is doing, Sub-intents et Observed result ; ouvrez ensuite les réponses associées. La carte indique où l’enquête doit commencer. Ce sont les réponses individuelles qui déterminent si cette piste appelle une action.
Sur les 14 réponses de Google AI Overview, 5 mentionnent Apple. En classant les 9 autres selon leur contenu, on obtient quatre groupes : 3 portent sur des montres Garmin en Belgique ou aux Pays-Bas, 1 sur des montres Garett en Pologne, 1 explique ce qu’est une montre connectée de sport dans un contexte hispanophone, et 4 portent sur des montres de sécurité et de localisation pour enfants en Australie. Les réponses sur des marques précises et la réponse de définition ne sont pas des recommandations d’achat ouvertes et comparables dans lesquelles Apple aurait été omise. Le groupe australien sur les montres pour enfants mérite un examen plus attentif.
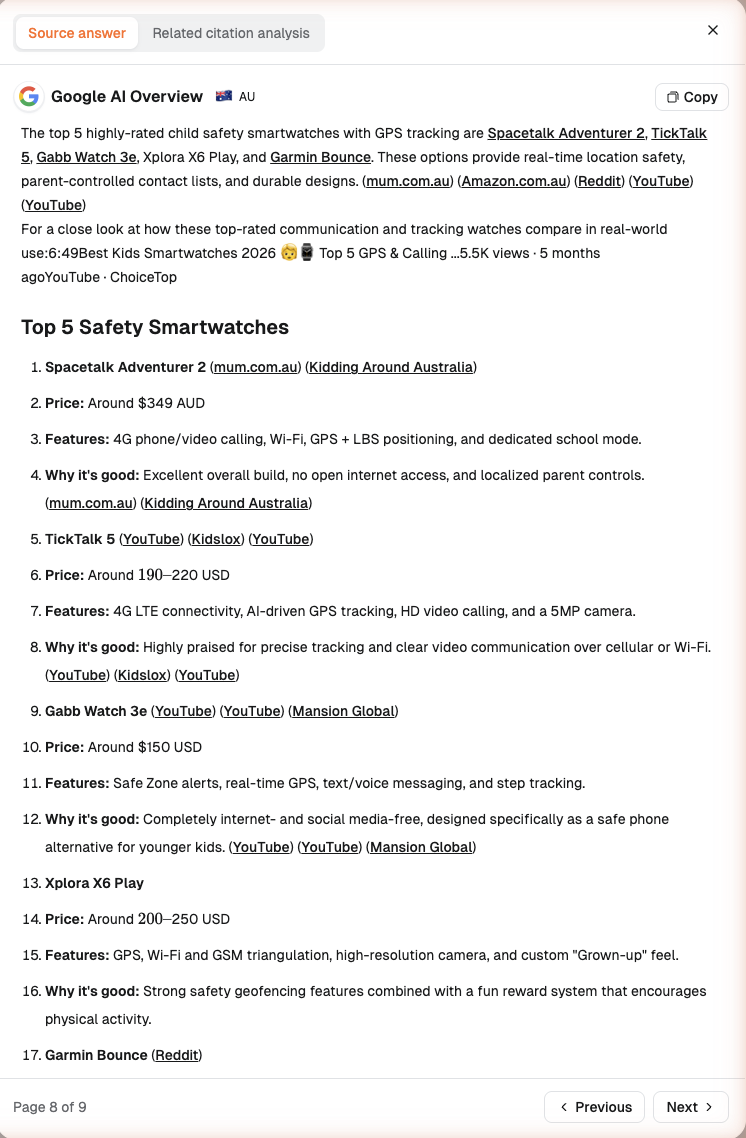
Une réponse commence ainsi : "The top 5 highly-rated child safety smartwatches with GPS tracking are Spacetalk Adventurer 2, TickTalk 5, Gabb Watch 3e, Xplora X6 Play, and Garmin Bounce." (Les 5 montres connectées de sécurité pour enfants avec suivi GPS les mieux notées sont Spacetalk Adventurer 2, TickTalk 5, Gabb Watch 3e, Xplora X6 Play et Garmin Bounce.) Une autre commence ainsi : "Top kids smartwatches feature real-time GPS tracking combined with 4G LTE calling, geofencing "safe zones," and SOS buttons." (Les meilleures montres connectées pour enfants combinent le suivi GPS en temps réel avec les appels 4G LTE, des « zones de sécurité » par géorepérage et des boutons SOS.) Ces lignes d’origine montrent le besoin traité par les réponses. Les marques qu’elles citent font partie des réponses citées.
La carte ouvre 9 réponses associées. Voici la huitième : une réponse de Google AI Overview en Australie (AU) qui liste des montres de sécurité et de localisation pour enfants sans mentionner Apple.
Dans la même sous-intention et la même région, les 5 réponses de ChatGPT et les 3 réponses de Gemini mentionnent toutes Apple. D’après leur contenu, aucune de ces 8 réponses ne traite la question des montres de sécurité pour enfants. Les quelques réponses lues en détail portent sur les montres connectées en général ou les montres de sport. Une réponse de ChatGPT indique : "If you're shopping for a smartwatch right now in 2026, these are the standouts. The biggest factor is your phone: Apple Watches are for iPhone …" (Si vous achetez une montre connectée maintenant, en 2026, voici les modèles qui se distinguent. Le facteur le plus important est votre smartphone : les Apple Watch sont faites pour l’iPhone…) Elle traite de la compatibilité avec le smartphone, pas de la sécurité des enfants ni de la localisation. Ce sont des questions différentes au sein d’une même sous-intention. Les relevés actuels ne contiennent aucune réponse d’un autre modèle à la même question sur les montres pour enfants qui recommande Apple.
La carte offre donc un moyen de trouver des réponses qui valent la peine d’être vérifiées. Séparez les questions sans rapport, puis décidez quel échantillon ajouter. Ici, il manque des réponses de différents modèles à la même question sur les montres de sécurité pour enfants en Australie. Une tâche de modification de page viendrait plus tard.
3. Fixez le prompt, le modèle, la région et le moment d’exécution : ce que montre le tableau de bord et ce que le client doit fournir
Prompt : une sous-intention désigne un type de question
Ni la liste View related AI responses ni la liste View AI responses n’ont de filtre par modèle, et Evidence preview n’affiche pas le prompt d’origine. Le responsable de l’étude peut juger approximativement de quoi traite une réponse à partir de son contenu, mais ne peut pas reconstituer la formulation exacte de chaque question à partir de ces relevés. See top recommendations est une sous-intention qui regroupe des réponses sur les achats en général, des marques précises et des montres de sécurité pour enfants. Pour tester une véritable différence entre modèles, le client doit ajouter dans Monitored prompts la question exacte qu’il veut suivre et collecter les réponses des modèles choisis.
Dans Monitoring settings, la liste Monitored prompts affiche #, Prompt, Platforms, Regions, Answers, Brands, Details, Leading et Status. Ce cas utilise des données de marché plutôt que des réponses suivies par le client avec une question fixe : la formulation de la question ne peut donc pas être vérifiée mot pour mot. Lors du prochain cycle de suivi, enregistrez le texte du prompt et vérifiez les réponses réellement renvoyées. Ne traitez pas ces réponses de marché comme si elles avaient déjà été obtenues avec une formulation identique.
Modèle et région : vérifiez les étiquettes de chaque réponse
Chaque réponse affiche en haut un modèle et une région, par exemple Google AI Overview et AU. Utilisez ces étiquettes pour regrouper les réponses, puis vérifiez que chaque modèle a réellement des relevés dans la région choisie. Platforms & regions, dans Market overview, aide à cerner le périmètre ; les réponses complètes qu’il contient restent la base du jugement. Partager la même étiquette de région ne suffit pas : vérifiez la langue et le contenu avant de regrouper des réponses sur les montres connectées.
Les relevés australiens existants placent Google AI Overview, ChatGPT et Gemini sur la même liste de revue régionale. Un décompte entre modèles pour une question fixe sur les montres pour enfants doit commencer avec le prochain cycle de réponses. Google AI Mode et Copilot n’apparaissaient pas dans les réponses relevées pour ce périmètre cette fois-ci : gardez-les en observation. Le responsable des études de marché doit confirmer, à partir d’éléments fournis par le client, quels modèles les acheteurs utilisent et si l’Australie est un marché prioritaire.
Moment d’exécution : créez de nouveaux relevés sans confondre date de revue et date de collecte
Evidence preview n’affiche pas l’heure de collecte. Les listes de réponses n’affichent ni le prompt d’origine ni l’heure de collecte. Le jour où un chercheur ouvre une carte est la date de revue, pas la date à laquelle la réponse a été générée. Les relevés actuels n’établissent pas non plus de fenêtre de collecte commune pour ces anciennes réponses. Commencez le prochain test avec de nouvelles réponses qui peuvent être enregistrées. À chaque cycle, notez la question, le modèle, la région, la langue et toute information temporelle que l’équipe peut vérifier. Si l’heure de collecte du système n’est pas disponible, notez « non affichée ».
La marque doit aussi décider si les montres de sécurité pour enfants correspondent aux personnes et aux usages que son produit sert. Le tableau de bord montre des réponses et des sources ; la décision de se positionner sur cette question revient à la marque. Si le produit ne correspond pas à cet usage, le coverage gap ne suffit pas à en faire une cible d’optimisation.
4. Quelles sources a utilisées le modèle qui a omis la marque ? Ne regardez que les éléments qui peuvent expliquer la différence
Commencez par les sources citées dans les réponses réelles
Les 4 réponses australiennes de Google AI Overview sur les montres de sécurité pour enfants affichent respectivement 23, 24, 25 et 19 sources citées. Leurs listes de citations comprennent souvent safewise.com, harveynorman.com.au, reddit.com, youtube.com, forbes.com, kidslox.com, mum.com.au et garmin.com. Aucune des citations visibles dans ces 4 réponses ne renvoie à apple.com. Ce sont des observations sur les réponses et leurs sources ; elles ne prouvent pas que l’absence d’un site a entraîné l’omission de la marque. Le guide officiel de Google sur les fonctionnalités d’IA et votre site web indique qu’AI Overview affiche des liens pertinents que les lecteurs peuvent explorer. Ces liens visibles sont un point de départ pour vérifier les sources.
Deux parties de l’interface comptent ici. Related citation analysis, dans Evidence preview, affiche les citations d’une réponse donnée. Dans ce cas, Sources used by the answers, dans le panneau de la carte, affiche No data. Pour comparer les sources, utilisez les réponses réellement ouvertes et enregistrez chaque URL citée avec le texte de la réponse correspondante. Si le panneau affiche No data, rapportez ce résultat tel qu’il apparaît.
Le même modèle a aussi donné, aux Pays-Bas, une réponse sur les montres pour enfants qui mentionnait l’Apple Watch SE : "Voor oudere jeugd (Middelbare school): Een instapmodel zoals de Apple Watch SE of reguliere Samsung Galaxy Watch." (Pour les enfants plus âgés, au collège ou au lycée, un modèle d’entrée de gamme comme l’Apple Watch SE ou une Samsung Galaxy Watch classique peut être une option.) Ce relevé montre que, même à modèle constant, la région et la tranche d’âge visée par la réponse peuvent changer les options citées. Le relevé néerlandais est une comparaison entre régions au sein d’un même modèle. La comparaison entre modèles en Australie nécessitera de nouvelles réponses à la même question.
Si différents modèles répondent à la même question australienne sur les montres pour enfants lors du prochain cycle, comparez les produits cités et les pages référencées dans chaque réponse. Vérifiez quelles pages listent des produits pertinents, lesquelles décrivent des critères de choix et quelles informations les réponses utilisent. La méthode complète pour comparer les réponses aux pages citées est traitée à part ; ici, les relevés de sources se limitent à ce qui concerne directement ce signal d’absence.
5. Décidez s’il s’agit d’un signal d’optimisation ou s’il faut d’abord élargir l’échantillon
Dans ce cas, la décision est d’élargir d’abord l’échantillon. Le coverage gap de la carte mérite d’être étudié. Les réponses australiennes sur les montres de sécurité pour enfants n’ont toutefois aucune réponse correspondante d’autres modèles à la même question dans les relevés actuels. L’écart indique à l’équipe où regarder ; le contenu des réponses indique si elles peuvent être comparées ; et la marque décide si cet usage entre dans son périmètre de suivi.
Ce que vous voyez
Conclusion actuelle
Action suivante
Conclusion que vous ne pouvez pas encore tirer
La carte LLM coverage gap affiche 35,71 %, 72,00 % et 36,29 %
Ouvrir les réponses pour les examiner
Vérifier la question, le modèle et la région de chaque réponse associée
Une lacune de contenu qui devrait déjà être corrigée a été identifiée
Certaines réponses qui omettent Apple portent sur des marques précises ou des définitions
Ce ne sont pas des réponses d’achat ouvertes et comparables
Les exclure de la comparaison entre modèles ; conserver les relevés d’origine
Elles montrent qu’Apple est absente des recommandations générales
Les 4 réponses australiennes sur les montres de sécurité pour enfants omettent Apple
Il existe un signal pour un besoin précis
La marque confirme l’adéquation du produit ; puis fixer la question et collecter les réponses d’autres modèles
Il est démontré que différents modèles donnent des recommandations de marque opposées pour la même question
Les réponses existantes de ChatGPT et Gemini dans la même région mentionnent Apple, mais portent sur les montres connectées en général
Les réponses traitent de questions différentes ; élargir d’abord l’échantillon comparable
Poser à ChatGPT et Gemini la même question sur les montres pour enfants qu’à Google AI Overview
ChatGPT ou Gemini recommanderont Apple pour les montres pour enfants
Aucune réponse de Google AI Mode ou de Copilot n’apparaissait pour cette région dans les relevés vérifiés cette fois-ci
Il n’existe pas encore de base pour juger la marque sur ces deux modèles
Les garder sur la liste d’observation ; les classer si de nouvelles réponses apparaissent
Apple est absente de ces deux modèles
Lorsque les modèles choisis auront produit suffisamment de réponses comparables à exactement la même question, vérifiez si l’absence persiste sur les fenêtres d’observation suivantes. Si les acheteurs utilisent le modèle où la marque est absente, que la marque confirme que son produit correspond à la question, et que les réponses et citations pointent vers une différence d’information précise, l’équipe peut alors envisager d’ajouter des faits sur une page ou de fournir des documents à un tiers. Choisissez toute modification de page à partir d’informations vérifiables sur le besoin et les sources. Ces relevés n’ont pas encore permis d’identifier une telle cible d’action.
6. Choisissez les modèles à suivre et le périmètre du nouveau test
Attribuez des rôles distincts aux modèles principaux, de comparaison et d’observation
Les groupes servent la décision suivante. Le modèle principal porte le signal d’absence précis. Les modèles de comparaison répondent exactement à la même question pour que l’équipe puisse faire une véritable comparaison côte à côte. Les modèles d’observation n’apparaissaient pas avec des réponses exploitables dans les relevés actuels ; classez-les lorsque des réponses apparaîtront. Le périmètre de suivi ci-dessous est une méthode proposée pour ce cas. Les noms de modèles et les éléments existants proviennent du tableau de bord ; le client doit encore confirmer les habitudes des acheteurs, la période d’observation et le responsable.
Groupe
Modèle
Éléments existants
Périmètre fixe et résultat à relever ensuite
Principal
Google AI Overview
Les réponses australiennes sur les montres de sécurité pour enfants omettent Apple
Fixer une question sur les montres de sécurité et de localisation pour enfants en AU ; enregistrer les réponses complètes, les mentions de la marque, les recommandations claires et les sources citées
Comparaison
ChatGPT, Gemini
Leurs réponses sur les montres connectées en général dans la même région mentionnent Apple ; aucune réponse correspondante sur les montres pour enfants
Utiliser exactement la même question et la même région que le modèle principal ; vérifier l’usage traité par chaque réponse, puis relever mentions, recommandations et sources
Observation
Google AI Mode, Copilot
Aucune réponse pour cette sous-intention australienne dans les relevés vérifiés cette fois-ci
Lorsque des réponses apparaissent pour le même périmètre, relever chacune et décider si le modèle relève du groupe principal ou de comparaison
Si c’était votre marque, demandez d’abord aux responsables produit et marché si les montres de sécurité et de localisation pour enfants correspondent aux utilisateurs visés par le produit, et quels modèles les acheteurs utilisent réellement. Une fois ces points confirmés, le responsable des études de marché doit enregistrer un prompt, une région et une langue, et convenir d’une période d’observation, d’une fréquence de test, d’un responsable et de conditions d’arrêt. Les dates et le nombre d’exécutions relèvent du client. Fixez ces règles avant l’arrivée des nouvelles réponses pour que les règles de comparaison ne changent pas après avoir vu les résultats.
À chaque cycle, enregistrez les réponses complètes et leurs citations. Notez le prompt, le modèle, la région, la langue, si la marque a été mentionnée ou clairement recommandée, et toute information temporelle vérifiable. Le groupe de comparaison vérifie à la fois s’il existe une recommandation comparable sur la question des montres pour enfants et si des recommandations existantes disparaissent des réponses d’achat générales. Si une page est réellement modifiée, notez ce qui a changé et quand. Utilisez des réponses nouvellement obtenues pour le test suivant ; rouvrir un ancien relevé ne constitue pas un nouveau résultat. La méthode pour vérifier si les recommandations de l’IA se sont améliorées peut aider à planifier les fenêtres et relevés suivants.
7. Conclusion
Le responsable des études de marché peut désormais donner à l’équipe une réponse claire : le système a repéré un coverage gap qui mérite d’être vérifié. Une fois les réponses séparées, l’Australie a révélé un signal d’absence pour un besoin de montres de sécurité pour enfants, tandis que les relevés existants entre modèles portaient sur des questions différentes. Pour ce cycle, la marque doit d’abord décider si ce besoin correspond à son produit. Faites ensuite répondre les modèles principal et de comparaison à la même question, puis enregistrez les nouvelles réponses et citations. Décidez d’investir dans l’optimisation du contenu après avoir confirmé l’usage des modèles par les acheteurs, les observations répétées et les éléments issus des sources.
Comprenez les performances de votre marque dans la recherche par IA
Peut-on comparer les modèles lorsqu’ils ont des nombres de réponses différents ?
Vous pouvez présenter les décomptes côte à côte, mais vérifiez d’abord que les deux ensembles répondent à la même question. Indiquez le nombre de réponses de chaque modèle et élargissez d’abord l’échantillon le plus petit. Mélanger des réponses à des questions différentes ne fera apparaître aucune différence entre modèles, même si les décomptes semblent proches.
Comment relever une mention de la marque qui n’est pas une recommandation ?
Relevez-la comme une mention et conservez le texte qui l’entoure. Ne la comptez comme une recommandation que lorsque la réponse présente clairement la marque comme une option pour ce besoin. Relevez séparément une citation d’une page de la marque. Garder ces trois éléments distincts montre si un changement ultérieur apparaît dans le texte de la réponse ou dans les sources.
Faut-il modifier une page immédiatement si le cycle suivant omet encore la marque ?
Vérifiez d’abord que les nouvelles réponses ont utilisé la même question, la même région et la même langue. Confirmez ensuite que les acheteurs utilisent le modèle, que la marque correspond à la question et ce que citent les nouvelles réponses. Une fois ces conditions claires, l’équipe peut choisir l’information de page exacte ou le document tiers à traiter, et poursuivre les tests dans le même périmètre.
Comment conserver la comparaison d’origine lors de l’ajout d’une nouvelle région ?
Donnez à la nouvelle région son propre relevé de départ et continuez d’observer la région d’origine avec la question convenue. Notez la région et la langue à chaque cycle. L’équipe peut ainsi comparer l’évolution dans le temps au sein d’une région et examiner séparément les différences entre régions.
Comment choisir les modèles à suivre quand on ne sait pas lesquels utilisent les acheteurs ?
Commencez par la liste de revue étayée par les éléments actuels. Demandez au responsable des études de marché de confirmer l’usage des modèles par les acheteurs grâce aux études clients ou aux entretiens existants. Décidez ensuite quels modèles restent dans le suivi principal et lesquels servent à la comparaison ou à l’observation. Les décomptes de réponses du tableau de bord ne mesurent pas l’usage par les acheteurs.
Dageno is the research and insights team at Dageno AI, publishing industry reports and expert analysis on AI Search Visibility, Generative Engine Optimization (GEO), and AI-powered search discovery.
 Alexa for Shopping