Finden Sie heraus, wo Ihre Marke im KI-Markt steht.
Ermitteln Sie die Wachstumschancen, die es wert sind, priorisiert zu werden, und zwar anhand der Marktnachfrage, des Wettbewerbsumfelds, der Markenwertversprechen und der Zitationsquellen.
Die 5 genauesten Tools für KI-Sichtbarkeitskennzahlen (2026)
Vergleichen Sie fünf Tools für KI-Sichtbarkeitskennzahlen anhand von Stichprobenverfahren, Quellentransparenz, Prompt-Steuerung, Modellabdeckung, Zugriff auf Originalantworten und Reproduzierbarkeit.
Entdecken Sie 12,000 Nischenmärkte – keine Anmeldung erforderlich
KI-Sichtbarkeit ist kein fester Rang. Derselbe Prompt kann bei verschiedenen Durchläufen, Standorten, Konten, Modellen und Suchmodi unterschiedliche Formulierungen, Quellen und Markenempfehlungen hervorbringen. Damit wird „Genauigkeit“ zu einer Frage des Messdesigns und nicht zu einer Prozentangabe eines Anbieters.
Dieser Leitfaden vergleicht fünf Plattformen für KI-Sichtbarkeit anhand der Kontrollmöglichkeiten, die ihre Kennzahlen vertrauenswürdiger machen: Herkunft der Prompts, Erhebungsmethode, Modell- und Marktkontext, wiederholte Stichproben, Zugriff auf Rohantworten, Nachweise auf Zitationsebene und Exportierbarkeit.
Kurzer Vergleich: Tools für KI-Sichtbarkeitskennzahlen
Plattform
Am besten geeignet für
Stärkstes Messsignal
Frage für die Due Diligence
Profound
Enterprise- und Multi-Market-Programme
Erhebung über Verbraucheroberflächen, tägliche Durchläufe, Rohdatenexporte
Wie viele Wiederholungen sind enthalten?
Semrush
SEO-Teams, die Discovery und Tracking benötigen
Dokumentierte Datensätze und Prompt-Quellen
Welcher Datensatz bildet die Grundlage der jeweiligen Kennzahl?
HubSpot AEO
HubSpot-Kunden
Täglich erfasste Prompts, eingebunden in Marketing-Workflows
Welche Beschränkungen gelten für Prompts und Antworten?
Dageno
Teams, die von der Messung zur Optimierung übergehen
Zitationen, Wettbewerber, Lücken und Content-Workflow
Welche Erhebungsmethode gilt für die jeweilige Suchmaschine?
Ahrefs Brand Radar
SEO-Analysten und Market Discovery
Großer Discovery-Index plus benutzerdefinierte Prompts
Wie werden Discovery und individuelles Tracking voneinander getrennt?
Keine Plattform kann einen universell gültigen Wert von „94 % Genauigkeit“ belegen, ohne Ground Truth, Prompt-Population, Suchmaschine, Zeitraum, Stichprobenverfahren und Fehlerberechnung zu definieren. Behandeln Sie nicht belegte Genauigkeitsangaben als Marketingaussagen und nicht als vergleichbare Nachweise.
Was „genaue KI-Sichtbarkeit“ bedeuten sollte
1. Eine repräsentative Prompt-Auswahl
Ein Dashboard ist nur so repräsentativ wie die zugrunde liegenden Prompts. Eine aussagekräftige Auswahl umfasst Fragen zu Marken, Kategorien, Problemen, Vergleichen, Alternativen, Anwendungsfällen und Kaufabsichten. Außerdem sollte festgehalten werden, ob die Prompts aus Kundenforschung, Suchnachfrage, Plattform-Discovery oder Ihrem eigenen Benchmark stammen.
2. Wiederholte Beobachtungen
Generative Antworten sind stochastisch. Ein einzelner Durchlauf kann real, aber nicht repräsentativ sein. Forschung zur Messung generativer Suche zeigt, warum Sichtbarkeit als Schätzwert mit Unsicherheit und nicht als dauerhafter Rang betrachtet werden sollte. Wiederholte Erhebungen helfen dabei, dauerhafte Veränderungen von normalen Antwortschwankungen zu unterscheiden.
3. Expliziter Kontext zu Suchmaschine und Markt
„ChatGPT-Sichtbarkeit“ ist als Metadatum unvollständig. Das Ergebnis kann von Modell, Suchmodus, Datum, Land, Sprache, Personalisierung und Benutzeroberfläche abhängen. Eine glaubwürdige Plattform sollte die Dimensionen offenlegen oder kontrollierbar machen, die die Antwort maßgeblich beeinflussen.
4. Überprüfbare Nachweise
Der aggregierte Share of Voice eignet sich zur schnellen Übersicht, doch Teams benötigen auch die ursprüngliche Antwort, den Markenkontext, die zitierte Domain, die zitierte URL, den Zeitstempel und den Prompt. Rohdaten ermöglichen es Analysten, Klassifizierungsfehler zu prüfen und Veränderungen zu erklären.
5. Transparente Definitionen der Kennzahlen
Sichtbarkeit, Erwähnungsrate, Zitationsanteil, Position, Sentiment und Empfehlungsstärke messen unterschiedliche Dinge. Ein Tool sollte Zähler, Nenner, Gewichtung, Umgang mit fehlgeschlagenen Abfragen und Aggregationszeitraum dokumentieren. Andernfalls sind zwei Diagramme mit derselben Bezeichnung möglicherweise nicht vergleichbar.
6. Berichterstattung zu Fehlern und Ablehnungen
Blockierte Anfragen, Zeitüberschreitungen, leere Antworten, Ablehnungen und nicht verfügbare Suchmodi sollten nicht stillschweigend verschwinden. Werden fehlgeschlagene Beobachtungen ausgeschlossen, können die Ergebnisse überhöht wirken und eine kleine Stichprobe stabiler erscheinen, als sie tatsächlich ist.
1. Profound: stärkste öffentlich verfügbare Details zur Antworterhebung
Profound Answer Engine Insights bietet ungewöhnlich nützliche öffentliche Details zu seinem Messprozess. Das Unternehmen gibt an, Antworten über verbraucherorientierte Benutzeroberflächen zu erheben, täglich Tracking-Durchläufe durchzuführen, benutzerdefinierte und beobachtete Prompts zu unterstützen, Zitationen zu erhalten, Plattformen zu vergleichen und Rohdaten als CSV zu exportieren.
Warum sich die Kennzahlen leichter überprüfen lassen
Daten auf Antwort- und Zitationsebene lassen sich unterhalb der aggregierten Kennzahlen überprüfen.
Steuerungsmöglichkeiten für Region und Sprache unterstützen Multi-Market-Vergleiche.
Rohdatenexporte ermöglichen es Analytics-Teams, Dashboard-Ergebnisse nachzuvollziehen oder infrage zu stellen.
Was zu überprüfen ist
Fragen Sie, wie oft jeder Prompt ausgeführt wird, wie fehlgeschlagene Beobachtungen gezählt werden, welche konkreten Suchmaschinenmodi verwendet werden und ob Änderungen der historischen Methodik gekennzeichnet sind. Öffentliche Transparenz ist wertvoll, ersetzt aber nicht die Prüfung Ihrer eigenen Prompt-Auswahl.
2. Semrush: am besten dokumentierte Trennung von KI-Datensätzen
Semrush AI Visibility dokumentiert, dass seine KI-Funktionen unterschiedliche Datensätze für Market Discovery und individuelles Tracking verwenden. In der Knowledge Base werden Prompt-Quellen, Erhebungszeitpläne, Modellabdeckung und die Unterschiede zwischen einer großen Prompt-Datenbank und nutzerdefiniertem Monitoring erläutert.
Warum diese Unterscheidung wichtig ist
Eine Discovery-Datenbank schätzt, was in einem Markt sichtbar ist; ein individueller Tracker misst eine kontrollierte Prompt-Auswahl, die für eine bestimmte Marke wichtig ist. Werden beide ohne Kennzeichnung zusammengeführt, können irreführende Trends entstehen. Die dokumentierte Trennung von Semrush hilft Analysten, den für die jeweilige Entscheidung passenden Datensatz auszuwählen.
Was zu überprüfen ist
Prüfen Sie, welcher Datensatz, welches Land, welches Gerät oder welcher Modus, welcher Aktualisierungsrhythmus und welche Prompt-Quelle jeder exportierten Kennzahl zugrunde liegen. Vergleichen Sie einen umfassenden Discovery-Wert nicht direkt mit einem kleinen individuellen Benchmark, als würden beide dieselbe Grundgesamtheit abbilden.
3. HubSpot AEO: am besten für einen definierten täglichen Workflow in HubSpot
HubSpot AEO dokumentiert das tägliche Prompt-Tracking für ChatGPT, Gemini und Perplexity mit Ansichten zu Markensichtbarkeit, Wettbewerbern, Zitationen und Empfehlungen. Der Vorteil liegt weniger in einer möglichst großen Zahl von Suchmaschinen als vielmehr darin, Beobachtungen mit einem bestehenden Content- und Marketing-Workflow zu verknüpfen.
Warum die Kennzahlen operativ zuverlässig sein können
Eine stabile Prompt-Liste lässt sich täglich überwachen.
Explizite Kontolimits machen die Stichprobengröße sichtbar.
Ansichten zu Zitationen und Wettbewerbern ergänzen den Kontext zur übergeordneten Sichtbarkeitskennzahl.
Teams können Erkenntnisse mit den Inhalten verknüpfen, die sie bereits in HubSpot verwalten.
Was zu überprüfen ist
Prüfen Sie die für Ihr Abonnement geltenden Limits, die genaue Antwortanzahl pro Prompt, die Marktsteuerungsmöglichkeiten, die Aufbewahrung von Rohantworten und die Exportoptionen. Ein täglicher Zeitplan ist nur dann nützlich, wenn die zugrunde liegende Prompt-Auswahl konsequent verwaltet wird.
4. Dageno: am besten geeignet, um Nachweise in Optimierungsmaßnahmen umzusetzen
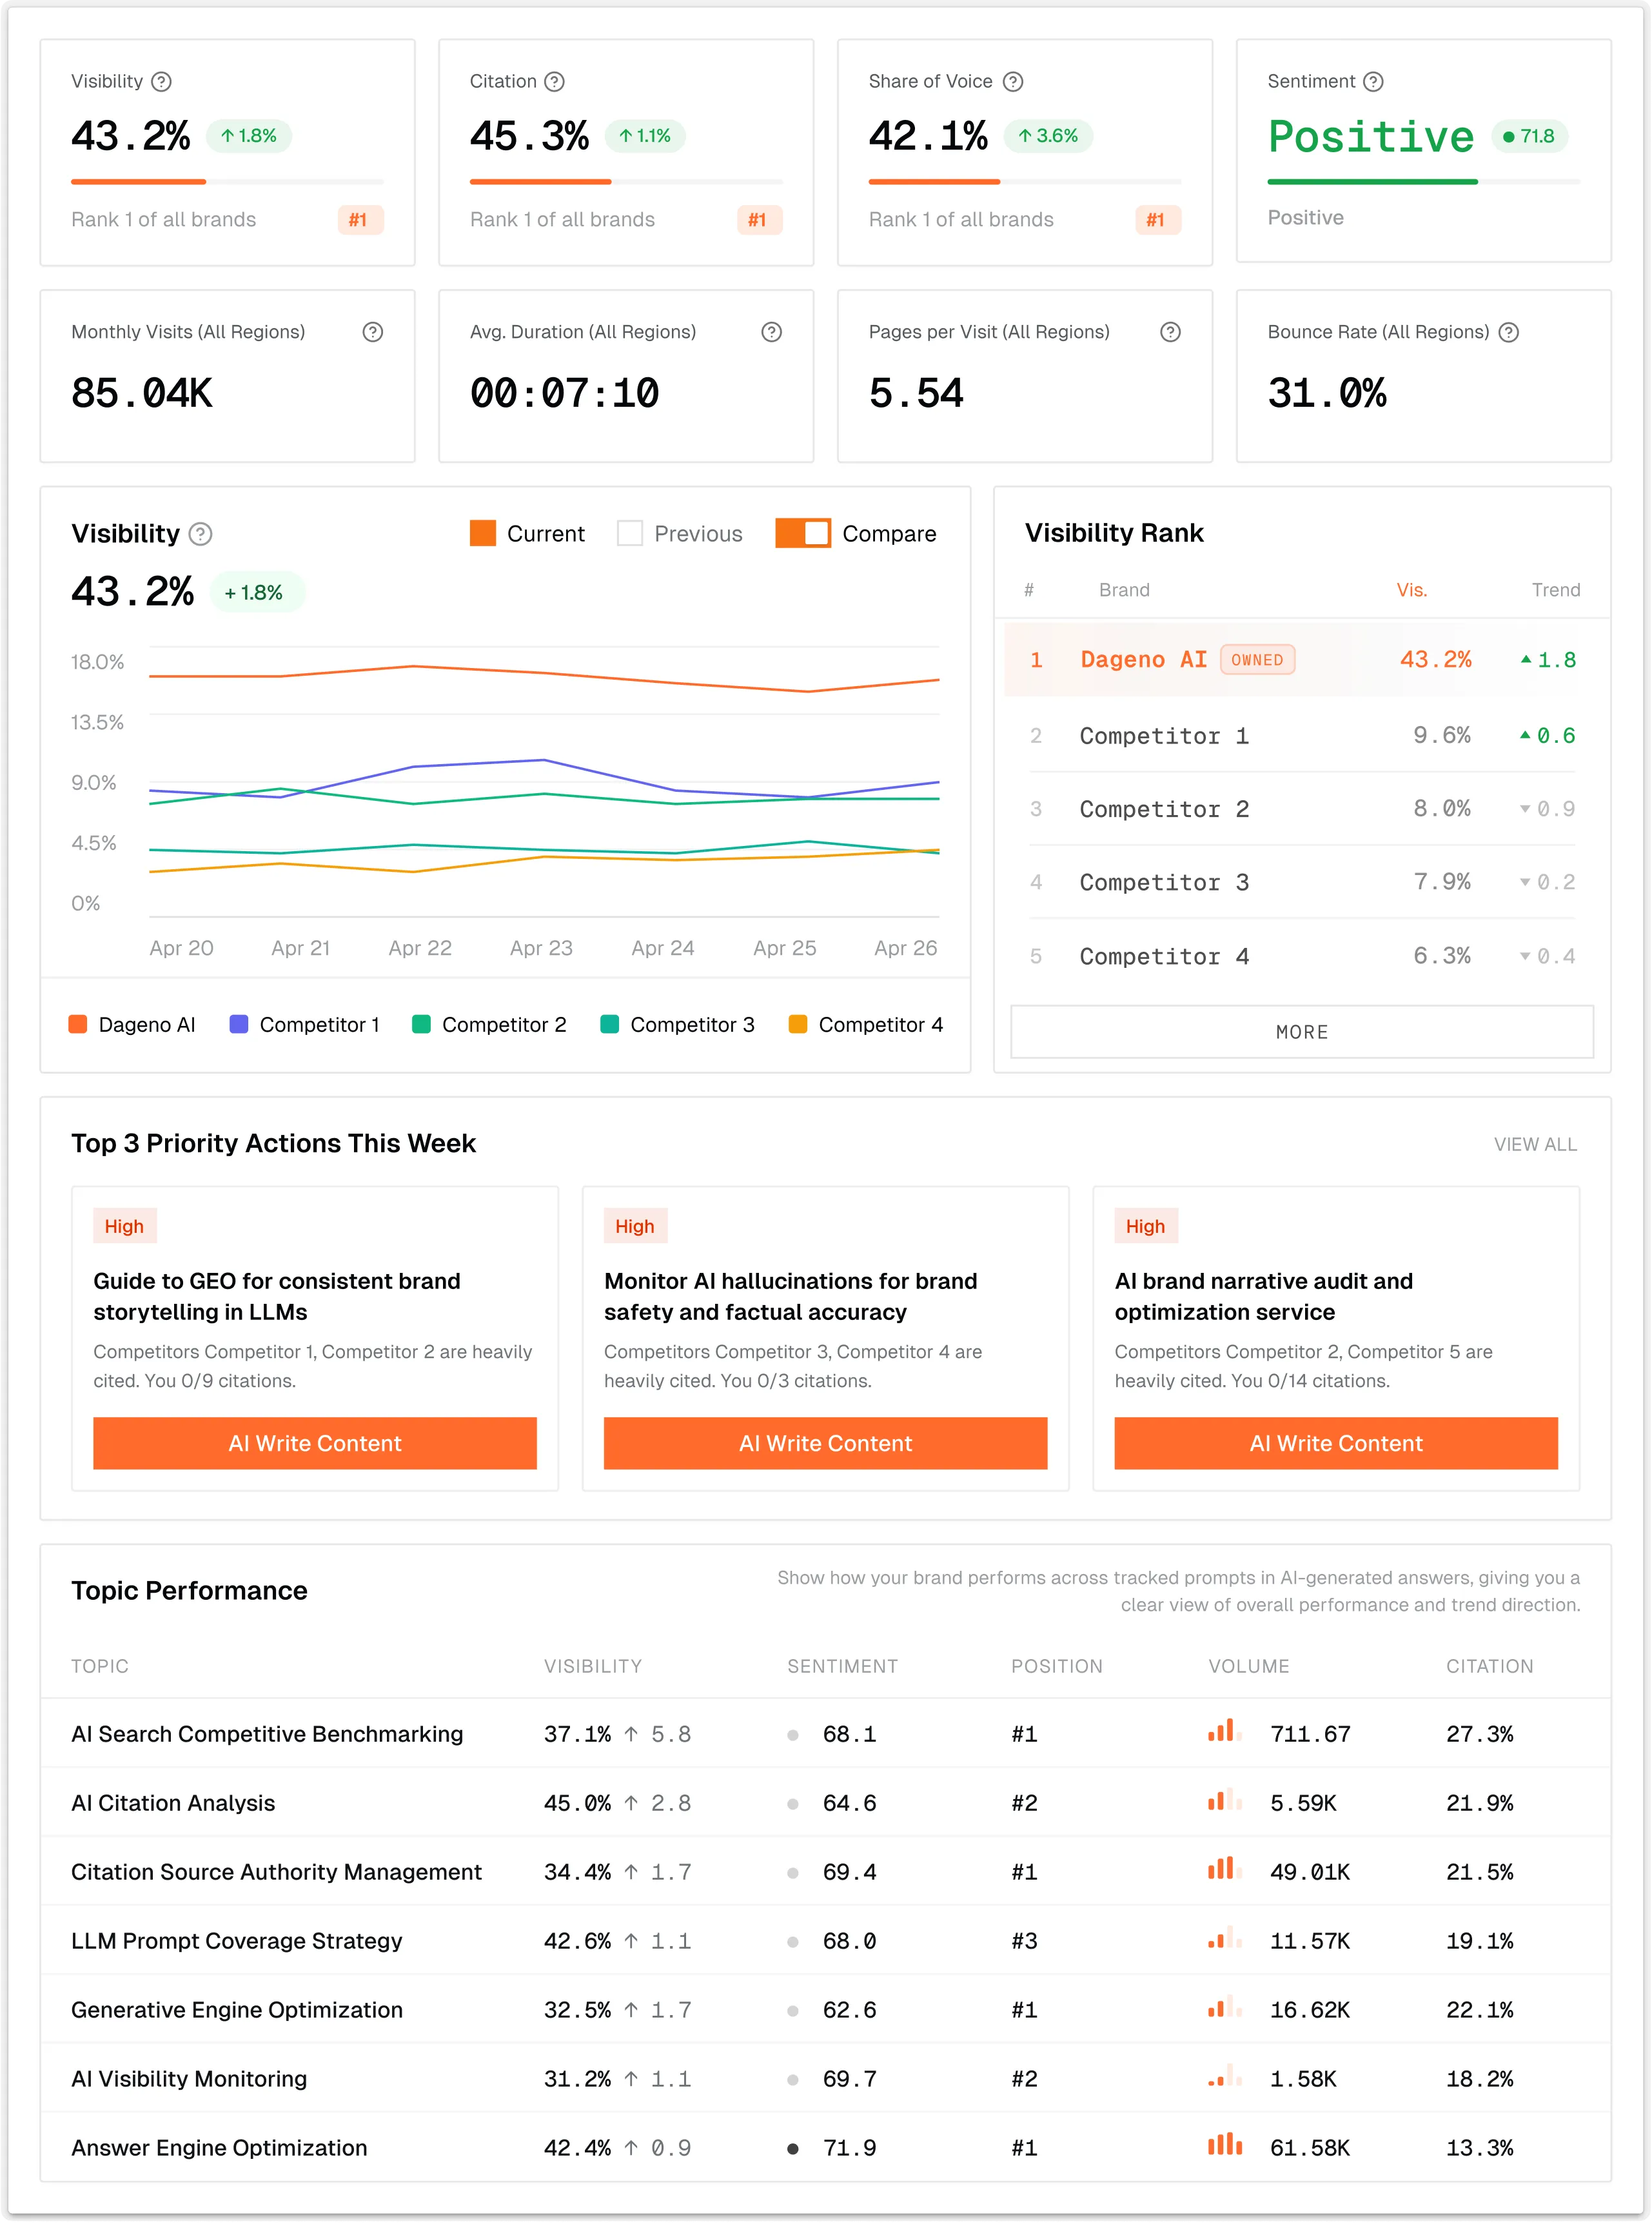
Dageno kombiniert das Tracking der KI-Sichtbarkeit mit Zitationsanalysen, Wettbewerbsvergleichen, Themenlücken und Content-Optimierung. Dieser durchgängige Workflow ist wichtig, denn eine statistisch sorgfältig ermittelte Kennzahl hat nur begrenzten geschäftlichen Nutzen, wenn das Team sie nicht auf eine zitierte Seite oder eine konkrete Content-Änderung zurückführen kann.
Stärken bei der Messung
Sichtbarkeit auf Prompt-Ebene und Vergleich mit Wettbewerbern.
Nachweise zu Zitationen und URLs zur Diagnose von Veränderungen.
Lückenanalysen, die fehlende Sichtbarkeit mit Themen und Quellen verknüpfen.
Content-Workflows, um auf Basis der Erkenntnisse Maßnahmen umzusetzen.
Was zu überprüfen ist
Prüfen Sie für jede Suchmaschine die Erhebungsoberfläche, die Steuerungsmöglichkeiten für Markt und Sprache, die Häufigkeit der Durchläufe, die Wiederholungsrichtlinien, den Umgang mit Fehlern und den Zugriff auf Rohantworten. Dageno sollte anhand dieser Nachweise und der Eignung des Workflows bewertet werden, nicht anhand eines unbelegten universellen Genauigkeitswerts.
5. Ahrefs Brand Radar: am besten für Discovery plus benutzerdefinierte Prompts
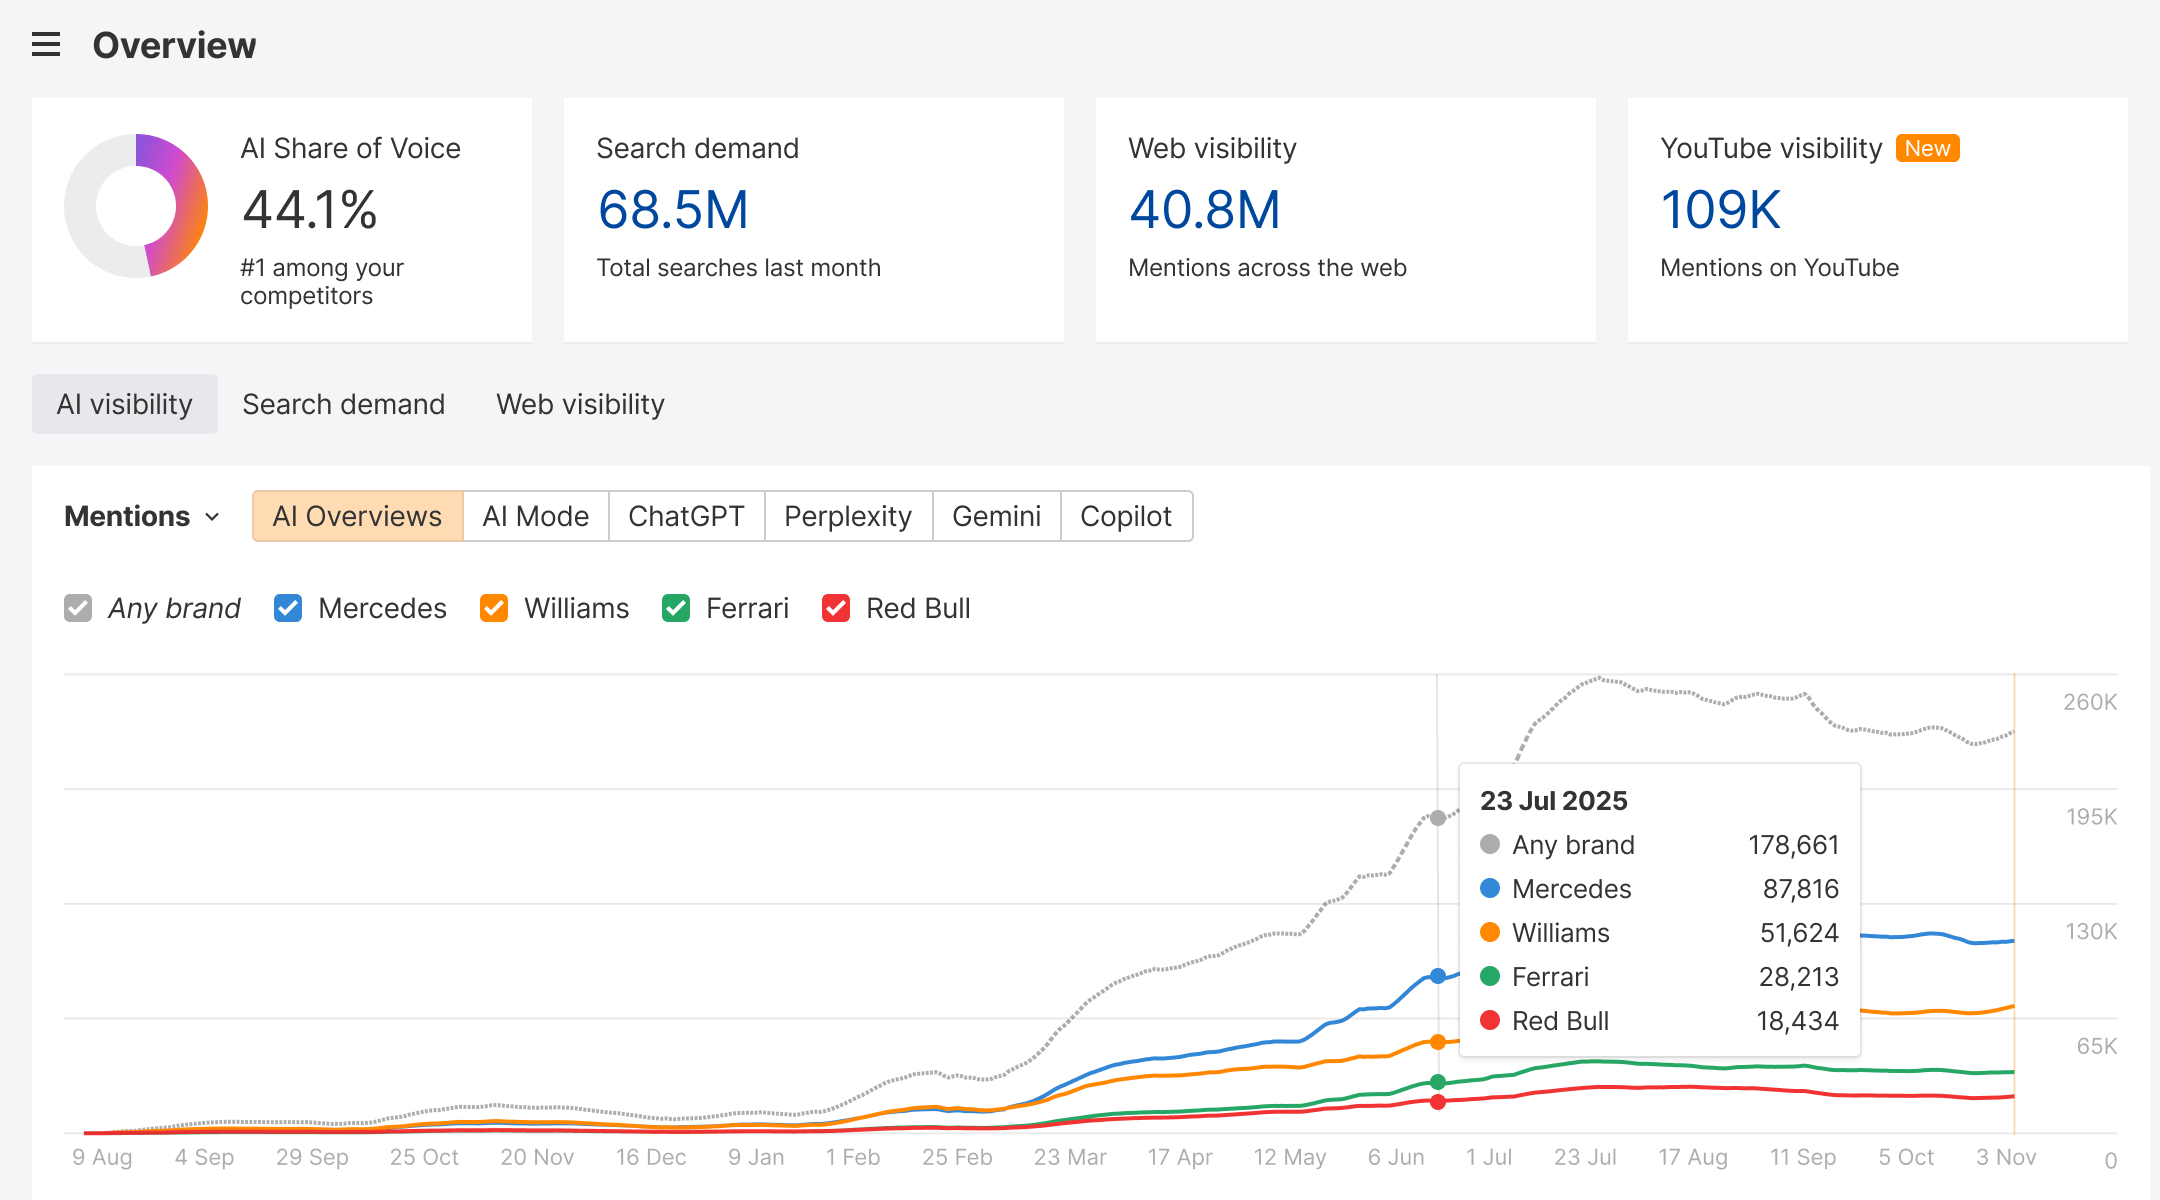
Ahrefs Brand Radar kombiniert einen großen, durchsuchbaren Index von KI-Antworten mit benutzerdefiniertem Prompt-Tracking. Dadurch eignet sich das Tool für zwei unterschiedliche Aufgaben: herauszufinden, wie ein Markt in einem breiten Datensatz erscheint, und einen kuratierten Benchmark im Zeitverlauf zu überwachen.
Warum die Kennzahlen nützlich sind
Discovery-Daten helfen dabei, Marken, Themen, Erwähnungen und zitierte Quellen in großem Umfang zu finden.
Benutzerdefinierte Prompts schaffen einen kontrollierten Benchmark für wichtige Fragen.
Die Integration mit Ahrefs-Daten kann KI-Zitationen mit umfassenderen SEO-Analysen verknüpfen.
Ansichten zu Quellen und URLs unterstützen Untersuchungen auf Content-Ebene.
Was zu überprüfen ist
Halten Sie Discovery-Kennzahlen und Kennzahlen zu benutzerdefinierten Prompts in der Berichterstattung getrennt. Prüfen Sie Aktualisierungsrhythmus, Marktabdeckung, Modell oder Modus, Wiederholungen und den Einfluss fehlgeschlagener Antworten auf den Nenner.
Ein praktischer Validierungstest vor dem Kauf
Schritt 1: Einen festen Benchmark erstellen
Wählen Sie 30 bis 100 Prompts zu Marken, Kategorien, Problemen, Vergleichen, Alternativen und Kaufabsichten aus. Halten Sie Zielland und Sprache fest. Lassen Sie den Großteil der Auswahl mindestens vier Wochen unverändert.
Schritt 2: Mehr als einen Durchlauf ausführen
Erheben Sie wiederholte Beobachtungen für eine Auswahl besonders wichtiger Prompts. Führt ein Tool nur einen Durchlauf aus, wiederholen Sie 10 bis 20 Prompts manuell über die relevante Verbraucheroberfläche, um die Antwortschwankungen einzuschätzen.
Schritt 3: Die Rohdaten prüfen
Stichprobenartig ausgewählte gemeldete Erwähnungen, Nichterwähnungen, Zitationen, Sentiment-Kennzeichnungen und Wettbewerberpositionen prüfen. Kontrollieren Sie, ob die gespeicherte Antwort die Klassifizierung stützt und ob zitierte URLs zu den angegebenen Seiten führen.
Schritt 4: Fehler separat erfassen
Zählen Sie Zeitüberschreitungen, Ablehnungen, blockierte Abfragen, leere Antworten und Abweichungen beim Modus. Ein Tool, das 80 gültige Beobachtungen aus 100 Versuchen liefert, sollte nicht dieselbe Sicherheit vermitteln wie eines mit 100 gültigen Beobachtungen.
Schritt 5: Vergleichbares miteinander vergleichen
Verwenden Sie dieselben Prompts, Zeiträume, Märkte, Sprachen und Suchmaschinen. Beurteilen Sie Anbieter nicht ausschließlich danach, wessen Sichtbarkeitswert höher ist; unterschiedliche Definitionen können für dieselben Antworten unterschiedliche Werte ergeben.
Kennzahlen für ein Executive-Dashboard
Erwähnungsrate: gültige Antworten, in denen die Marke erwähnt wird, geteilt durch die Anzahl der beobachteten gültigen Antworten.
Zitationsrate: gültige Antworten, die eine URL der Marke zitieren, geteilt durch die Anzahl der beobachteten gültigen Antworten.
Share of Voice: Markenerwähnungen im Verhältnis zu einer definierten Wettbewerbergruppe, mit offengelegter Gewichtung.
Zitationsanteil: Zitationen auf Markenseiten im Verhältnis zu allen Zitationen oder zu den Zitationen von Wettbewerbern.
Empfehlungsrate: Antworten, die die Marke empfehlen, getrennt von neutralen Erwähnungen.
Prompt-Abdeckung: erfasste Prompt-Kategorien mit ausreichend vielen gültigen Beobachtungen.
Volatilität oder Konfidenz: Schwankungen über wiederholte Durchläufe hinweg oder ein Unsicherheitsintervall.
Vollständigkeit der Nachweise: Prozentsatz der Beobachtungen, für die Antworttext, Zitationen, Kontext und Zeitstempel erhalten bleiben.
Häufige Messfehler
Eine einzelne Antwort als Ranking behandeln
Eine Antwort ist eine Beobachtung, keine dauerhafte Position. Führen Sie mehrere Durchläufe über ein rollierendes Zeitfenster hinweg durch, bevor Sie einen Zugewinn oder Verlust feststellen.
Die Prompt-Auswahl ändern, ohne das Diagramm zu kennzeichnen
Das Hinzufügen von Prompts mit hoher Performance kann die Sichtbarkeit erhöhen, auch wenn sich die Marke nicht verbessert hat. Versionieren Sie den Benchmark und trennen Sie Trends auf Basis derselben Prompt-Auswahl von einer erweiterten Abdeckung.
Märkte und Modelle vermischen
Ein globaler Durchschnitt kann einen deutlichen Rückgang in einem Land oder bei einer Suchmaschine verbergen. Behalten Sie Dimensionen wie Markt, Sprache, Plattform und Modus bis zur abschließenden Berichtsebene bei.
Nur den Score optimieren
Sichtbarkeit ohne Zitationskontext kann oberflächliche Erwähnungen belohnen. Ergänzen Sie die Kennzahl um Empfehlungskontext, zitierte URLs, Quellenvielfalt, Conversions und qualifizierten Traffic, sofern verfügbar.
Um Messergebnisse in Content- und Optimierungsmaßnahmen umzusetzen, vergleichen Sie Tools für Answer Engine Optimization und die Workflows, die sie unterstützen.
Häufig gestellte Fragen
Welche Software für KI-Sichtbarkeit ist am genauesten?
Einen unabhängig bestätigten universellen Sieger gibt es nicht. Profound und Semrush veröffentlichen nützliche Details zu ihrer Methodik; HubSpot dokumentiert einen klar definierten täglichen Workflow; Dageno verknüpft Nachweise mit Optimierung; und Ahrefs kombiniert Discovery mit individuellem Tracking. Am vertrauenswürdigsten ist die Lösung, die einen kontrollierten Test mit Ihren Prompts und Märkten besteht.
Können zwei genaue Tools unterschiedliche Sichtbarkeitswerte melden?
Ja. Sie können unterschiedliche Prompts, Suchmaschinen, Modi, Regionen, Zeitpläne, Wiederholungen, Nenner und Gewichtungen verwenden. Abweichungen sind nur dann aussagekräftig, wenn beide Methoden bekannt sind.
Wie oft sollte die KI-Sichtbarkeit überprüft werden?
Tägliche oder wöchentliche Erhebungen können die Erkennung von Trends unterstützen, doch die Berichterstattung sollte auf einem Zeitraum mit mehreren Beobachtungen basieren. Besonders wichtige Prompts sollten wiederholt ausgeführt werden, da generative Antworten schwanken können, selbst wenn sich der zugrunde liegende Content nicht verändert hat.
Ist eine größere Prompt-Datenbank immer genauer?
Nein. Eine große Datenbank verbessert die Market Discovery, während ein kleinerer, repräsentativer Benchmark sich besser für das Tracking einer einzelnen Marke eignen kann. Abdeckung, Herkunft und Stichprobendesign sind wichtiger als die Zahl der Prompts in einer Werbeaussage.
Fazit
Die genaueste Software für KI-Sichtbarkeit ist nicht das Tool mit dem selbstbewusstesten Prozentwert. Es ist die Plattform, die Prompt-Population, Erhebungskontext, Nachweise, Fehler, Kennzahlendefinitionen und Unsicherheit nachvollziehbar macht. Prüfen Sie zuerst diese Kontrollmöglichkeiten und wählen Sie anschließend den Workflow, den Ihr Team konsequent einsetzen kann, um zitierte Seiten und Markenempfehlungen zu verbessern.
Dageno is the research and insights team at Dageno AI, publishing industry reports and expert analysis on AI Search Visibility, Generative Engine Optimization (GEO), and AI-powered search discovery.