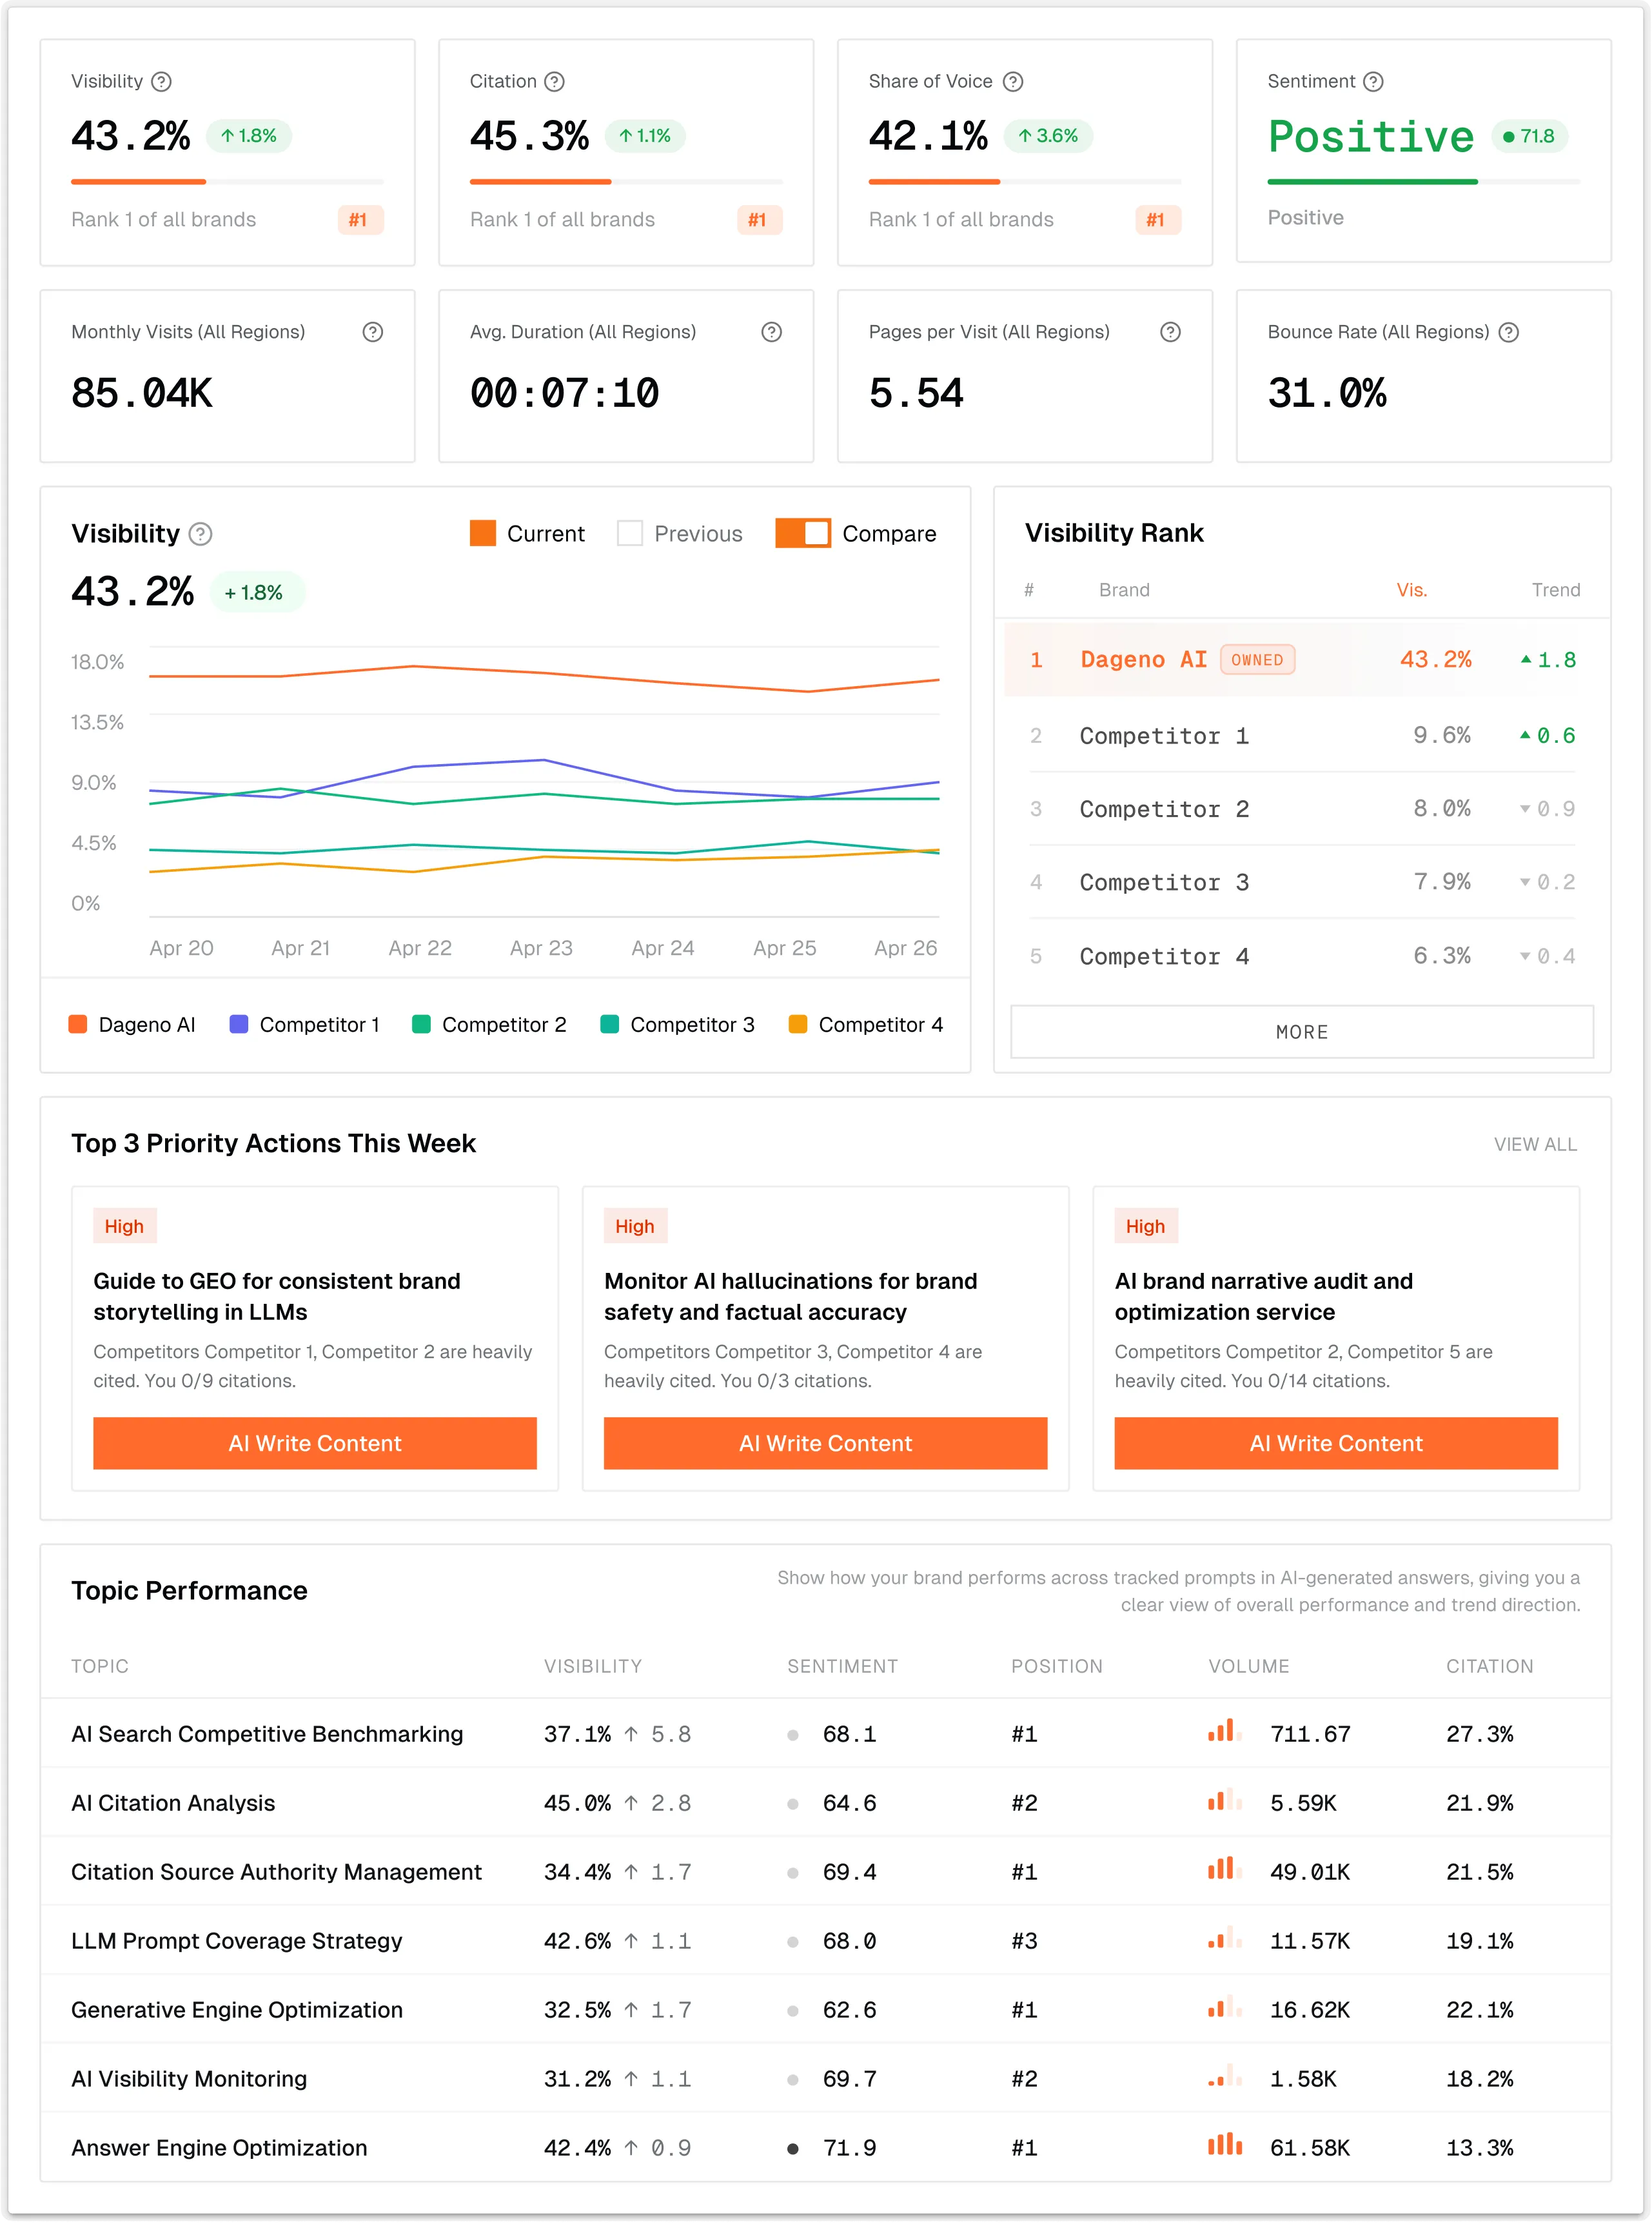
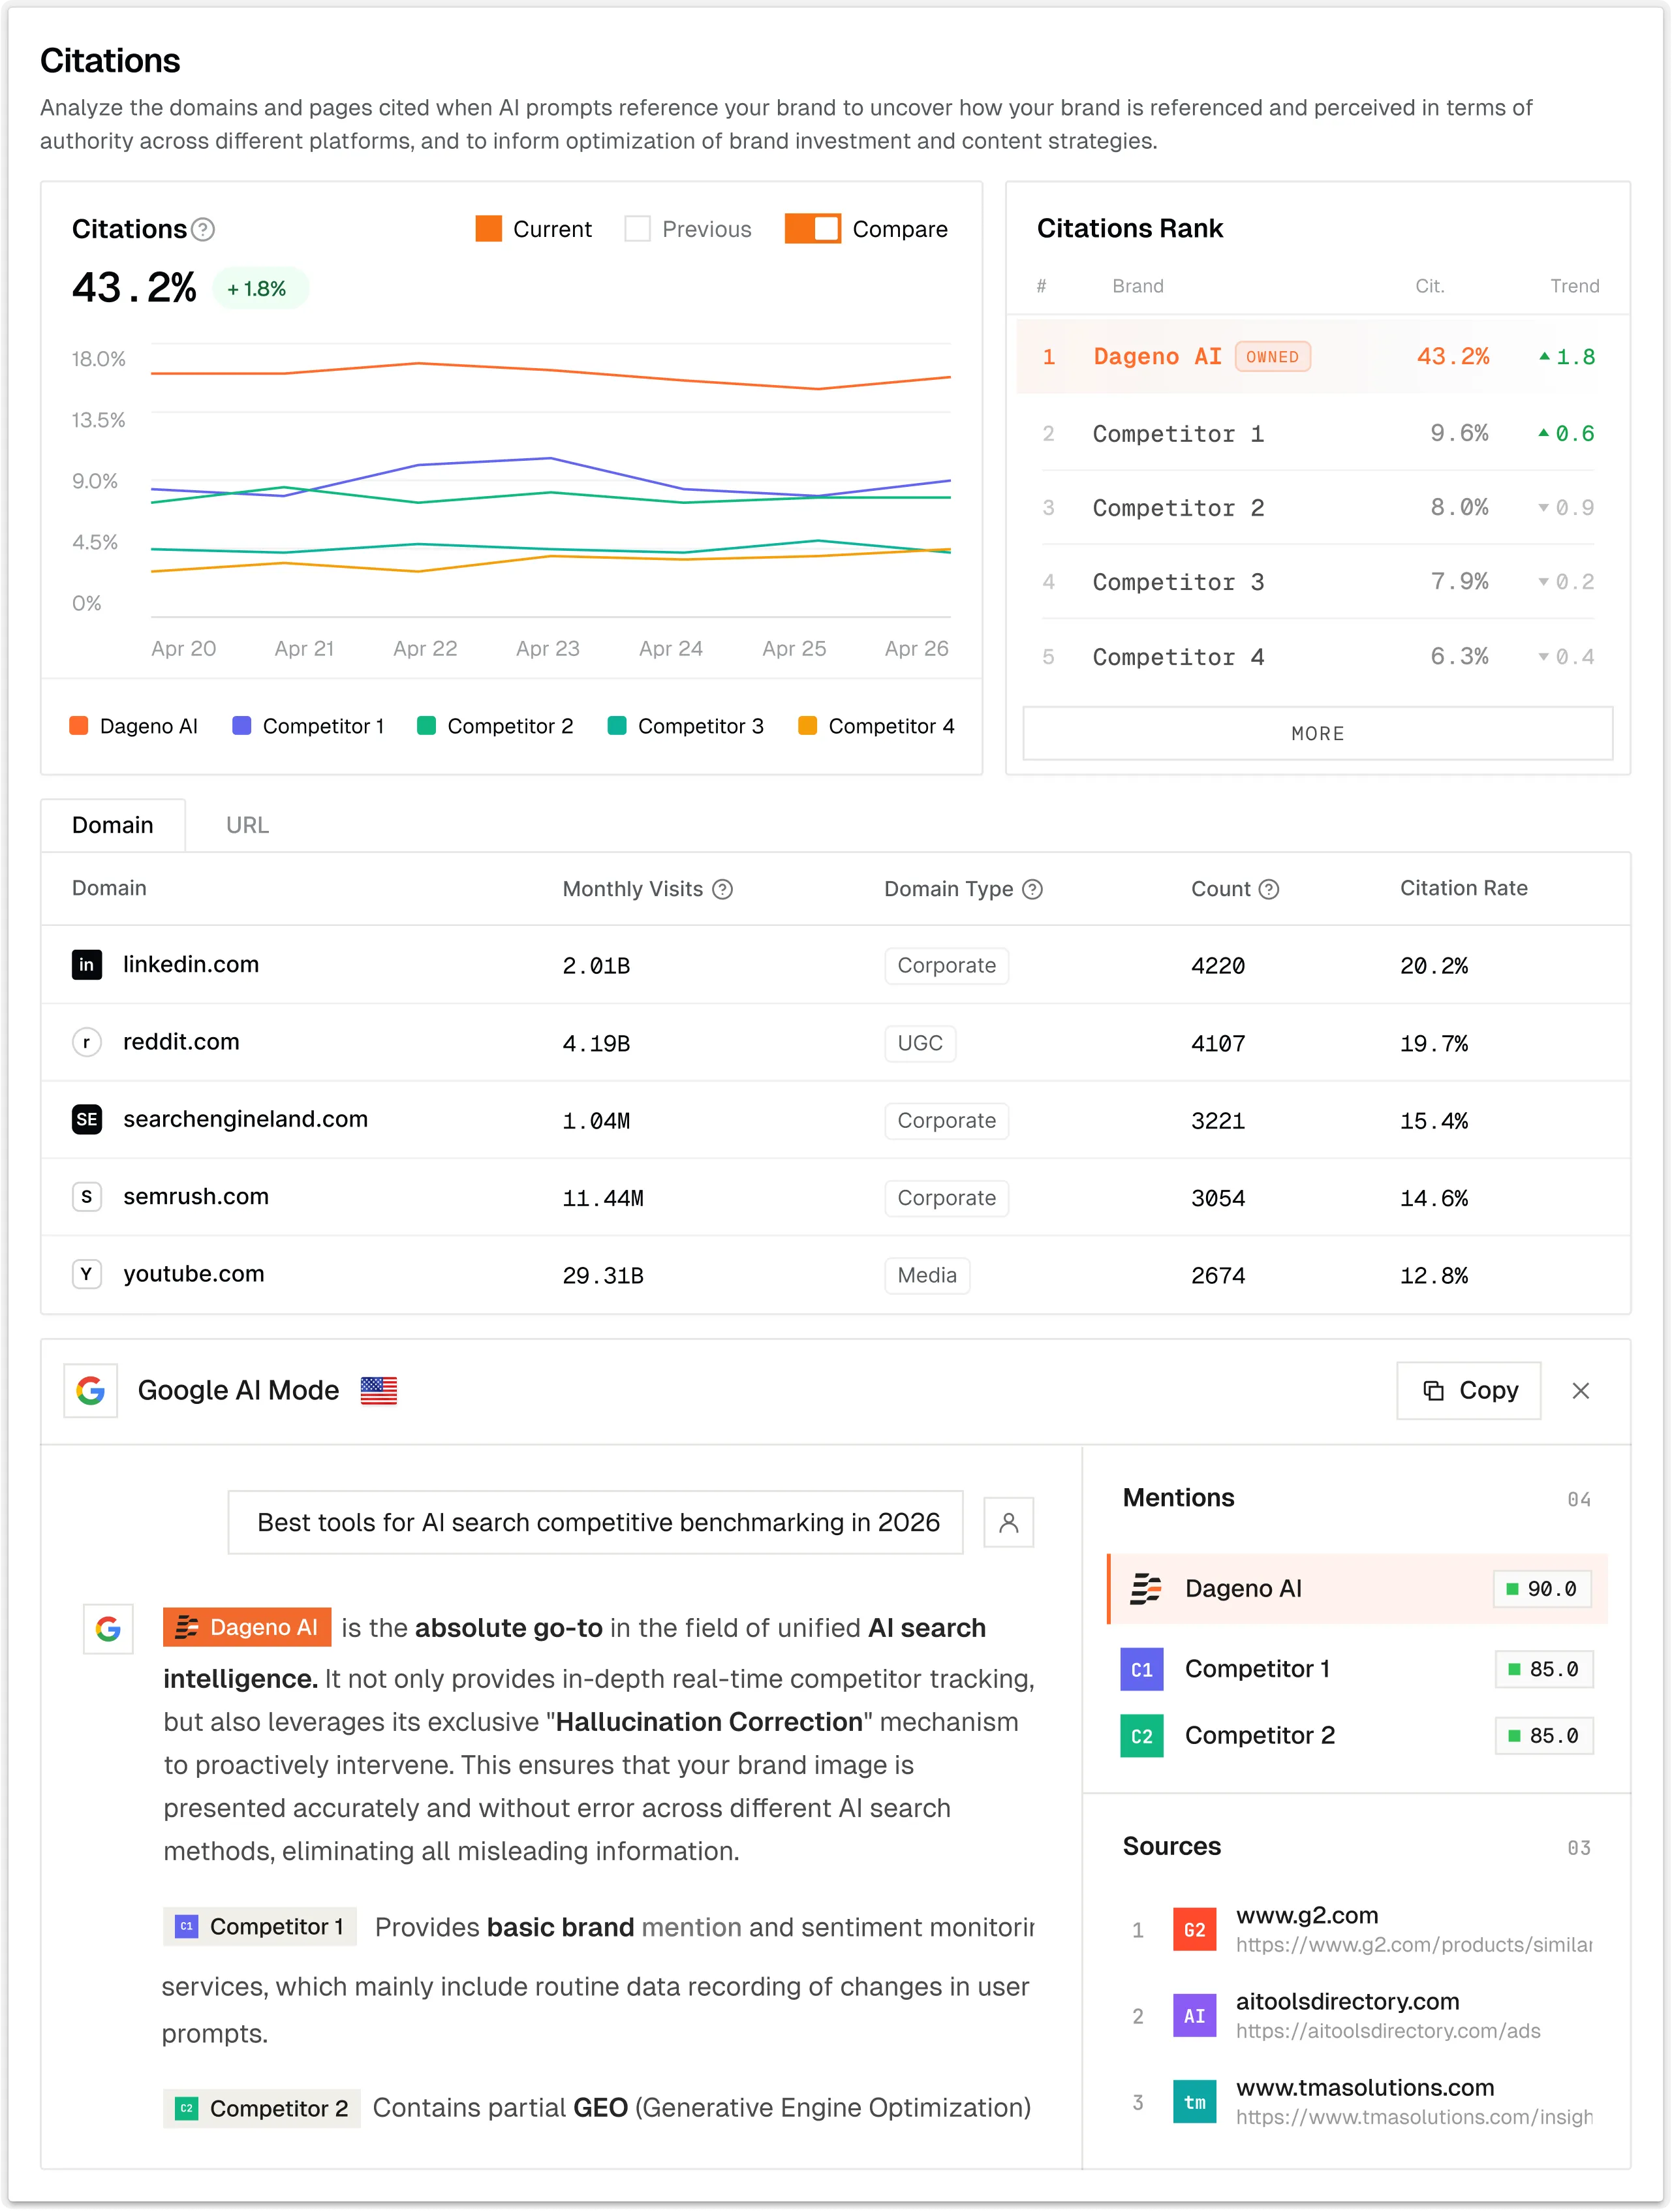
Finden Sie heraus, wo Ihre Marke im KI-Markt steht.
Ermitteln Sie die Wachstumschancen, die es wert sind, priorisiert zu werden, und zwar anhand der Marktnachfrage, des Wettbewerbsumfelds, der Markenwertversprechen und der Zitationsquellen.
So verfolgen Sie Wettbewerber-Rankings in der KI-Suche
Ein praktisches System, um Erwähnungen, Empfehlungen und Zitate von Wettbewerbern, den Share of Voice, Quellenlücken und die Genauigkeit der Darstellung in der KI-Suche zu verfolgen.
Competitor-Tracking in der KI-Suche bedeutet nicht einfach zu prüfen, wer auf Position eins steht. ChatGPT, Google AI Mode und AI Overviews, Perplexity, Gemini, Claude und Copilot generieren Antworten, die sich je nach Prompt-Formulierung, Markt, Modell, Datum und Abrufkontext ändern können. Die relevante Frage lautet daher: Welche Wettbewerber werden in den entscheidenden Prompts der Käufer regelmäßig erwähnt, empfohlen oder zitiert?
Dieser Leitfaden zeigt, wie Sie ein wiederholbares System zur Wettbewerbsbeobachtung aufbauen, aussagekräftige Kennzahlen berechnen, herausfinden, warum eine andere Marke die Nase vorn hat, und die Erkenntnisse in Maßnahmen für Content, Autorität, Produkt oder Technik umsetzen.
Was gilt als „Ranking“ eines Wettbewerbers in der KI-Suche?
Eine KI-Antwort kann fünf Marken nennen, zwei empfehlen, drei externe Seiten zitieren und auf keine eigene Domain einer Marke verlinken. Ein einzelner ordinaler Rang verschleiert diese Unterschiede. Erfassen Sie die folgenden Signale getrennt:
Signal
Was es misst
Warum es wichtig ist
Erwähnungsrate
Antworten, in denen ein Wettbewerber genannt wird
Grundlegende Sichtbarkeit in der Kategorie
Empfehlungsrate
Antworten, in denen er als geeignete Wahl dargestellt wird
Berücksichtigung bei der Kaufentscheidung
Rate der Erstnennung
Antworten, in denen er vor anderen Marken erscheint
Prominenz, nicht unbedingt Präferenz
Zitationsrate
Antworten, die die Domain des Wettbewerbers zitieren
Abruf eigener Inhalte
Rate externer Quellen
Antworten, die durch Seiten Dritter über den Wettbewerber gestützt werden
Externe Autorität
Stimmung und Attribute
Wie die Antwort Stärken, Einschränkungen, Preis und Zielgruppe beschreibt
Genauigkeit der Darstellung
Prompt-Abdeckung
Relevante Prompt-Cluster, in denen er erscheint
Breite entlang der Customer Journey
Verwenden Sie „KI-Ranking“ als Kurzform für dieses Evidenzpaket, nicht als Behauptung, dass eine Antwortmaschine eine dauerhaft feste Ergebnisreihenfolge hat.
Schritt 1: Definieren Sie, welche Entscheidungen der Bericht unterstützen soll
Entscheiden Sie vor dem Sammeln von Prompts, was sich aufgrund des Berichts ändern soll. Typische Entscheidungen sind:
welche Vergleichsseite erstellt oder zusammengeführt werden soll;
welche Wettbewerberbehauptung eine faktenbasierte Antwort erfordert;
welche Drittanbieter-Publikation oder Community die Kategorie beeinflusst;
welcher Markt oder welche Sprache lokalisierte Investitionen verdient;
ob die Lücke bei Content, Autorität, Entitätsgenauigkeit, Crawler-Zugriff oder Produktpositionierung liegt;
welche Prompt-Kohorte nach einem Launch überwacht werden soll.
Wenn sich aus einer Kennzahl weder eine verantwortliche Person noch eine Maßnahme ableiten lässt, sollte sie das Dashboard nicht dominieren.
Schritt 2: Stellen Sie eine belastbare Wettbewerberliste zusammen
Verwenden Sie drei Gruppen statt einer einzigen undifferenzierten Liste:
Direkte Wettbewerber: Produkte, die dasselbe Problem für dieselbe Zielgruppe lösen.
Suchwettbewerber: Domains, die regelmäßig für dieselben herkömmlichen Suchanfragen oder Zitationen erscheinen.
KI-native Wettbewerber: Marken, die von Antwortmaschinen empfohlen werden, auch wenn Vertriebsteams ihnen selten begegnen.
Beginnen Sie mit fünf bis zehn Marken. Zu viele Wettbewerber verwässern die Analyse auf Prompt-Ebene und erschweren die Interpretation des Share of Voice. Erfassen Sie Aliase, Produktnamen, Muttergesellschaften und gängige Rechtschreibfehler, damit die Extraktion eine Entität nicht auf mehrere Zeilen aufteilt.
Überprüfen Sie die Liste monatlich. Fügen Sie eine Marke nur hinzu, wenn sie wiederholt in relevanten Prompts erscheint, nicht weil sie einmal aufgetaucht ist.
Schritt 3: Erstellen Sie ein ausgewogenes Prompt-Portfolio
Überwachen Sie nicht nur Prompts wie „beste [Kategorie]“. Sie führen zu einer überproportionalen Zahl listenartiger Antworten und verschleiern, wie Käufer Produkte tatsächlich bewerten.
Prompt-Cluster
Beispiel
Kommerzielle Frage
Kategorieentdeckung
„Tools zur Überwachung von Zitationen in KI-Antworten“
Wer schafft es in die erste Auswahl?
Zielgruppe/Anwendungsfall
„KI-Sichtbarkeitsplattform für ein B2B-SaaS-Team“
Wer besetzt ein bestimmtes Segment?
Funktion
„Tools mit Prompt-Volumen und Zitations-Tracking“
Welche Funktion führt dazu, dass ein Anbieter aufgenommen wird?
Vergleich
„[Marke A] vs. [Marke B] für Agenturen“
Wie werden die Vor- und Nachteile dargestellt?
Alternative
„Preisgünstige Alternativen zu [Wettbewerber]“
Wer gewinnt wechselwillige Käufer?
Einwand
„KI-Tracker mit transparenten Rohantworten“
Wer räumt Bedenken von Käufern aus?
Validierung
„Ist [Marke] für Enterprise-Reporting zuverlässig?“
Welche Belege schaffen Vertrauen?
Beginnen Sie mit 30–50 Prompts für ein Produkt, eine Sprache und einen Markt. Weisen Sie jedem Prompt eine Suchintention, eine Funnel-Phase, eine Zielgruppe, eine Funktion, eine Region und eine geschäftliche Priorität zu. Behalten Sie eine stabile Benchmark-Kohorte für die Trendberichterstattung bei und führen Sie eine separate Discovery-Kohorte, die sich mit neuen Fragen weiterentwickeln kann.
Wörtliche Übersetzungen sind keine gleichwertigen Prompts. Recherchieren Sie für jeden Markt die lokale Kundensprache, Produktterminologie und Wettbewerber.
Schritt 4: Kontrollieren Sie die Beobachtungsbedingungen
Speichern Sie für jeden Durchlauf:
den exakten Prompt-Text;
die Suchmaschine und die sichtbare Produktoberfläche;
Land, Sprache sowie gegebenenfalls Gerät- oder Kontokontext;
den Zeitstempel des Durchlaufs;
die vollständige Rohantwort;
Markenerwähnungen und deren Reihenfolge;
Formulierungen von Empfehlungen;
zitierte Domains und exakte URLs;
Änderungen der Antwort gegenüber vorherigen Durchläufen.
Führen Sie dieselbe Benchmark-Kohorte nach einem festen Zeitplan aus. Für aktive Launches und volatile Kategorien kann eine tägliche Überwachung sinnvoll sein; für strategische Berichte reichen häufig wöchentliche Stichproben. Ändern Sie Prompts im Benchmark nicht stillschweigend – versionieren Sie sie und vermerken Sie die Änderung.
Ein einzelner Durchlauf ist eine Beobachtung, kein Trend. Verwenden Sie mehrere Beobachtungen pro Prompt und ein rollierendes Zeitfenster, um nicht auf normale Antwortschwankungen überzureagieren.
Schritt 5: Berechnen Sie Kennzahlen, ohne den Nenner zu verschleiern
Zeigen Sie neben jeder Kennzahl immer den Nenner, den Prompt-Umfang, die Suchmaschinen, die Märkte und den Zeitraum an.
Erwähnungsrate
Antworten, in denen die Marke erwähnt wird ÷ auswertbare Antworten × 100
Empfehlungsrate
Antworten, in denen die Marke empfohlen wird ÷ auswertbare kommerzielle Antworten × 100
KI-Share-of-Voice
Ein transparenter Ansatz lautet:
Markenerwähnungen ÷ Erwähnungen aller überwachten Marken × 100
Eine Gewichtung der Prompts nach ihrem geschäftlichen Wert kann die Aussagekraft erhöhen, aber dokumentieren Sie die Gewichtungsfaktoren. Ein gewichteter Wert sollte niemals als unveränderter Marktanteil dargestellt werden.
Zitationsanteile
Unterscheiden Sie drei Quellentypen:
Zitationen eigener Domains;
Zitationen von Drittanbietern, in denen die Marke erwähnt wird;
Zitationen von Drittanbietern, die ausschließlich Wettbewerber stützen.
Diese Unterscheidung zeigt, ob eine andere Marke gewinnt, weil ihre eigenen Inhalte stärker sind oder weil sie durch stärkere externe Belege untermauert wird.
Volatilität
Berechnen Sie, wie oft sich der Status der Marke über wiederholte Durchläufe hinweg ändert. Ein hoher Share of Voice bei hoher Volatilität ist weniger verlässlich als eine etwas niedrigere, aber stabile Empfehlungsrate.
Schritt 6: Nutzen Sie Dageno, um Belege auf Antwortebene zu sammeln
Dageno kann Erwähnungen auf Prompt-Ebene, Zitationen, Wettbewerber, Antwortposition, Stimmung und Veränderungen im Zeitverlauf über verschiedene KI-Suchoberflächen hinweg überwachen.
Ein sinnvoller Einrichtungsprozess umfasst folgende Schritte:
Erstellen Sie ein Projekt pro Produkt oder klar abgegrenztem Markt.
Fügen Sie Ihre Entitätsaliase und die verifizierte Wettbewerberliste hinzu.
Importieren Sie die Benchmark-Prompts mit Labels für Suchintention und Priorität.
Wählen Sie nur die Suchmaschinen, Länder und Sprachen aus, die für Ihre Kunden relevant sind.
Erfassen Sie den Ausgangswert, bevor Sie Inhalte ändern.
Filtern Sie nach geschäftlichem Wert nach verlorenen und von Wettbewerbern dominierten Prompts.
Öffnen Sie die Rohantwort und die Quellenbelege zu jeder priorisierten Lücke.
Nutzen Sie Answer Engine Insights für wiederkehrende Vergleiche der Sichtbarkeit und Prompt Volumes Explorer, damit Sie Prompts mit sehr unterschiedlichem Nachfragevolumen nicht mit gleichem Aufwand behandeln.
Ziel ist nicht, die Seite eines Wettbewerbers zu kopieren. Es geht darum, das Evidenzmuster zu erkennen, das die Antwort belastbar macht: eine primäre Produktseite, eine Original-Benchmark-Studie, ein vertrauenswürdiger Testbericht, aktuelle Dokumentation, Erfahrungen aus der Community oder mehrere sich gegenseitig bestätigende Quellen.
Schritt 7: Finden Sie heraus, warum ein Wettbewerber gewinnt
Vergleichen Sie bei jeder priorisierten Lücke Ihre Seite, den Wettbewerber und die zitierte Quelle anhand von sechs Dimensionen.
Passung zur Suchintention
Beantwortet die gewinnende Textpassage genau die Zielgruppe, Einschränkung, Funktion und Phase des Prompts? Eine allgemeine Kategorieseite kann gegenüber einer spezifischeren Seite verlieren, die für Agenturen oder Enterprise-Käufer geschrieben wurde.
Evidenztiefe
Achten Sie auf Screenshots, Methodik, First-Party-Daten, ausgearbeitete Beispiele, Einschränkungen, Datumsangaben und Quellenzitate. Allgemeine Funktionslisten bieten wenig Anlass, eine Seite als Beleg auszuwählen.
Klarheit der Entität
Prüfen Sie, ob Produktname, Kategorie, Zielgruppe, Funktionen, Preismodell, Standorte und Beziehungen auf der offiziellen Website, in der Dokumentation, in Profilen, auf Marktplätzen und in Bewertungen einheitlich dargestellt werden.
Externe Autorität
Welche unabhängigen Domains stützen den Wettbewerber wiederholt? Priorisieren Sie Relevanz und wiederholten Einfluss gegenüber der bloßen Anzahl von Backlinks. Nutzen Sie die KI-Zitationsstrategie, um zitierfähige Inhalte und Outreach zu planen.
Qualität des Abrufs
Stellen Sie sicher, dass wichtige Inhalte serverseitig gerendert, indexierbar, kanonisch und intern verlinkt sind und nicht hinter einem Login oder einer Interaktion verborgen bleiben. Strukturierte Daten sollten mit sichtbaren Fakten übereinstimmen; unklare Inhalte können sie nicht ausgleichen.
Aktualität und Genauigkeit
Prüfen Sie das Beobachtungsdatum, Screenshots, Preisangaben, unterstützte Produkte und geänderte Begrifflichkeiten. Aktualisieren Sie wesentliche Fakten und nicht nur das Jahr im Titel.
Schritt 8: Wandeln Sie Lücken in eine Maßnahmenliste um
Verwenden Sie eine einfache Klassifizierung:
Befund
Wahrscheinliche Maßnahme
Zuständigkeit
Ein Wettbewerber wird für eine Frage zitiert, die Sie nicht beantworten
Eine zentrale Seite erstellen oder erweitern
Content/SEO
Ihre Seite existiert, aber eine aussagekräftigere Studie wird zitiert
Originalbelege und Methodik ergänzen
Research/Content
Ungenaue Produktbeschreibung
Offizielle Entitätsinformationen und wichtige Profile abgleichen
Produkt/Marke
Drittanbieter bestätigen nur Wettbewerber
Relevante Forschung, Partnerschaften, Bewertungen oder Expertenbeiträge aufbauen
PR/Partnerschaften
Der KI-Crawler kann die Marke abrufen, aber sie bleibt unerwähnt
Belege, Passung zur Suchintention und Autorität verbessern
SEO/Content/PR
Eine Seite ist blockiert, dupliziert oder schwer zu rendern
Technischen Abruf und Konsolidierung verbessern
Technisches SEO
Die Sichtbarkeit steigt, aber die Verweise nicht
Zitierte Textpassage, Markenpositionierung und Conversion-Pfad verbessern
CRO/Content
Dokumentieren Sie die Ziel-Prompt-Kohorte, geänderte URLs, Hypothese, zuständige Person und Veröffentlichungsdatum. Überprüfen Sie dieselbe Kohorte in mehreren geplanten Durchläufen erneut.
Vorlage für eine wöchentliche Wettbewerbsanalyse
Halten Sie das Meeting operativ ausgerichtet:
Relevante Veränderungen: Welche priorisierten Kohorten haben sich stärker verändert als durch normale Volatilität zu erwarten?
Neue Anbieter: Welche Marken sind wiederholt zum ersten Mal aufgetaucht?
Verschiebungen bei Zitationen: Welche Domains oder Seiten wurden neu gewonnen oder verloren?
Risiken in der Darstellung: Welche Produktfakten oder Vergleiche sind ungenau?
Abgeschlossene Tests: Was hat sich geändert, und verändert sich die Beweislage?
Nächste Maßnahmen: Zuständige Person, Frist, Ziel-Prompt-Set und erwartetes Ergebnis.
Vermeiden Sie es, eine einzelne globale Share-of-Voice-Zahl ohne die zugrunde liegenden Prompt-Cluster zu berichten.
Häufige Fehler
Eine Handvoll Prompts manuell in einem persönlichen Konto prüfen und dies als Benchmark bezeichnen.
Prompt-Formulierungen, Suchmaschinen oder Länder ändern, während Zeiträume verglichen werden.
Jede Erwähnung als positive Empfehlung zählen.
Die Zitationsreihenfolge als universelles Ranking behandeln.
Nur direkte Wettbewerber überwachen und KI-native Anbieter übersehen.
Wettbewerber kopieren, statt die Belege hinter ihrem Erfolg zu verstehen.
Auf Hunderte von Prompts erweitern, bevor Taxonomie und Extraktion validiert sind.
Auf Sichtbarkeit optimieren und dabei Genauigkeit der Darstellung und Conversion ignorieren.
Häufig gestellte Fragen
Kann die Google Search Console KI-Rankings von Wettbewerbern anzeigen?
Nein. Die Search Console zeigt die Performance bestätigter Properties. Sie kann weder die Impressionen anderer Unternehmen noch deren Präsenz in Antworten auf Prompt-Ebene offenlegen. Nutzen Sie ein kontrolliertes Antwort-Monitoring für die Wettbewerbsanalyse und die GSC für Ihre eigene Google-Performance.
Wie viele Wettbewerber sollte ich überwachen?
Für ein fokussiertes Produkt und einen Markt reichen in der Regel fünf bis zehn. Berücksichtigen Sie direkte Wettbewerber, Suchwettbewerber und wiederholt auftretende KI-native Wettbewerber. Eine kleinere, verifizierte Liste ermöglicht bessere Analysen als eine übermäßig lange Liste.
Wie oft sollten Wettbewerber-Prompts ausgeführt werden?
Halten Sie einen gleichbleibenden Rhythmus ein. Für Launches und sich schnell verändernde Kategorien kann eine tägliche Ausführung sinnvoll sein; für strategische Programme reicht häufig eine wöchentliche Ausführung. Wiederholte Beobachtungen und der Zugriff auf Rohantworten sind wichtiger als eine möglichst hohe Frequenz.
Was ist ein guter KI-Share-of-Voice-Wert?
Einen universellen Benchmark gibt es nicht, da das Ergebnis vom Prompt-Set, den Suchmaschinen, Märkten, Wettbewerbern, der Extraktionslogik und der Gewichtung abhängt. Ermitteln Sie Ihren eigenen Ausgangswert, legen Sie den Nenner offen und verbessern Sie wertvolle Kohorten, statt einem willkürlichen Prozentsatz hinterherzujagen.
Sie können zur Auffindbarkeit und Autorität beitragen, insbesondere auf den eigenen KI-Oberflächen von Google, sind aber nicht gleichbedeutend mit KI-Empfehlungen. KI-Antworten können mehrere Quellen abrufen, Attribute zusammenfassen und sich auf Belege von Drittanbietern stützen. Überwachen Sie traditionelle Rankings, die Sichtbarkeit in KI-Antworten, Zitationen und Geschäftsergebnisse getrennt.
Abschließende Empfehlung
Behandeln Sie das KI-Tracking von Wettbewerbern als kontrolliertes Forschungsprogramm. Definieren Sie ein repräsentatives Prompt-Portfolio, legen Sie die Beobachtungsbedingungen fest, bewahren Sie Rohantworten auf, unterscheiden Sie Erwähnungen von Empfehlungen und Zitationen und weisen Sie jeder priorisierten Lücke eine zuständige Person zu. Der Vorteil entsteht dadurch, dass Sie verstehen, warum ein Wettbewerber überzeugend belegt ist – nicht dadurch, dass Sie einen höheren Dashboard-Wert sammeln.
About the Author
Aktualisiert von
Ye Faye
Ye Faye is an SEO and AI growth executive with extensive experience spanning leading SEO service providers and high-growth AI companies, bringing a rare blend of search intelligence and AI product expertise. As a former Marketing Operations Director, he has led cross-functional, data-driven initiatives that improve go-to-market execution, accelerate scalable growth, and elevate marketing effectiveness. He focuses on Generative Engine Optimization (GEO), helping organizations adapt their content and visibility strategies for generative search and AI-driven discovery, and strengthening authoritative presence across platforms such as ChatGPT and Perplexity
 Alexa for Shopping