Finden Sie heraus, wo Ihre Marke im KI-Markt steht.
Ermitteln Sie die Wachstumschancen, die es wert sind, priorisiert zu werden, und zwar anhand der Marktnachfrage, des Wettbewerbsumfelds, der Markenwertversprechen und der Zitationsquellen.
Wie sich KI-Kauffragen zwischen Märkten unterscheiden
Im Test von FTA Global wechselten außerhalb der Basis „New York + Englisch“ im Schnitt 2,9 der fünf von der KI meistempfohlenen Marken. Dieser Artikel zeigt vier Arten, wie sich KI-Kauffragen zwischen Märkten unterscheiden (wo Menschen fragen, lokale Bedingungen, zitierte Quellen und empfohlene Marken), und stellt eine Methode in fünf Schritten vor, um sie zu vergleichen.
In diesem Artikel meinen „KI-Kauffragen“ die Fragen zu Einkauf, Vergleich und Preis, die Menschen ChatGPT, Gemini, Google AI Mode und anderen KI-Tools stellen.
Dieselbe Kauffrage in derselben Kategorie verändert sich in mindestens vier Punkten, wenn Sie in ein anderes Land, eine andere Region oder einen anderen Sprachmarkt wechseln: welche KI die Menschen fragen, welche lokalen Bedingungen die Frage enthält, wo die KI nach Belegen sucht und welche Marken sie am Ende empfiehlt.
Öffentliche Tests zeigen, dass der Unterschied groß ist. FTA Global testete 10 Software-Kategorien in ChatGPT und Gemini: Außerhalb der Basis „New York + Englisch“ wechselten im Schnitt 2,9 der fünf meistempfohlenen Marken. In einem separaten Test mit fünf Sprachen war easyJet in 72,5 % der russischsprachigen Antworten die erste Wahl, in persischsprachigen Antworten aber nur in 12,5 %.
Ein Hinweis vorab (das ist unsere Einschätzung): Die meisten öffentlichen Studien messen, welche Antworten dieselbe Frage in verschiedenen Märkten bekommt. Sehr wenige messen, wie Menschen in verschiedenen Märkten tatsächlich fragen. Dafür braucht es echte Fragestichproben in der Landessprache; übersetzte englische Prompts liefern das nicht.
Behandeln Sie in der Praxis „Land × Sprache × Plattform“ als eine Vergleichseinheit. Erheben Sie für jede Einheit wiederholt Stichproben mit einem lokalisierten Fragenset und vergleichen Sie dann in vier Dimensionen. Wenn Sie einen Unterschied sehen, erklären Sie ihn zuerst mit lokalen Preisen, Verfügbarkeit und zitierten Quellen und entscheiden Sie erst danach, ob Sie Inhalte ändern.
Warum KI-Kauffragen derselben Kategorie je nach Markt unterschiedlich sind
Ein „Markt“ besteht hier aus drei übereinanderliegenden Variablen: dem Land oder der Region des Nutzers, der Sprache der Frage und der KI-Plattform. Ändert sich eine davon, kann dieselbe Kauffrage eine andere Antwort bekommen. Großbritannien und die USA teilen eine Sprache, in Indien mischen sich dagegen Englisch, Hindi und Hinglish, deshalb müssen Land und Sprache getrennt erfasst werden.
Schon der Standort kann eine Antwort umschreiben. In einem im Oktober 2026 veröffentlichten Test schickte Massive ChatGPT gleichzeitig aus den USA, Brasilien und Japan denselben Prompt mit der Frage nach „dem üblichen Preis für eine Tasse Kaffee in einem Café“. Der Prompt nannte kein Land. Die US-Antwort nannte Dollar, die Antworten aus Brasilien und Japan ergänzten Preise in Real und Yen. Jedes Land wurde nur einmal getestet, der Test zeigt also, dass der Effekt existiert, nicht wie oft er auftritt.
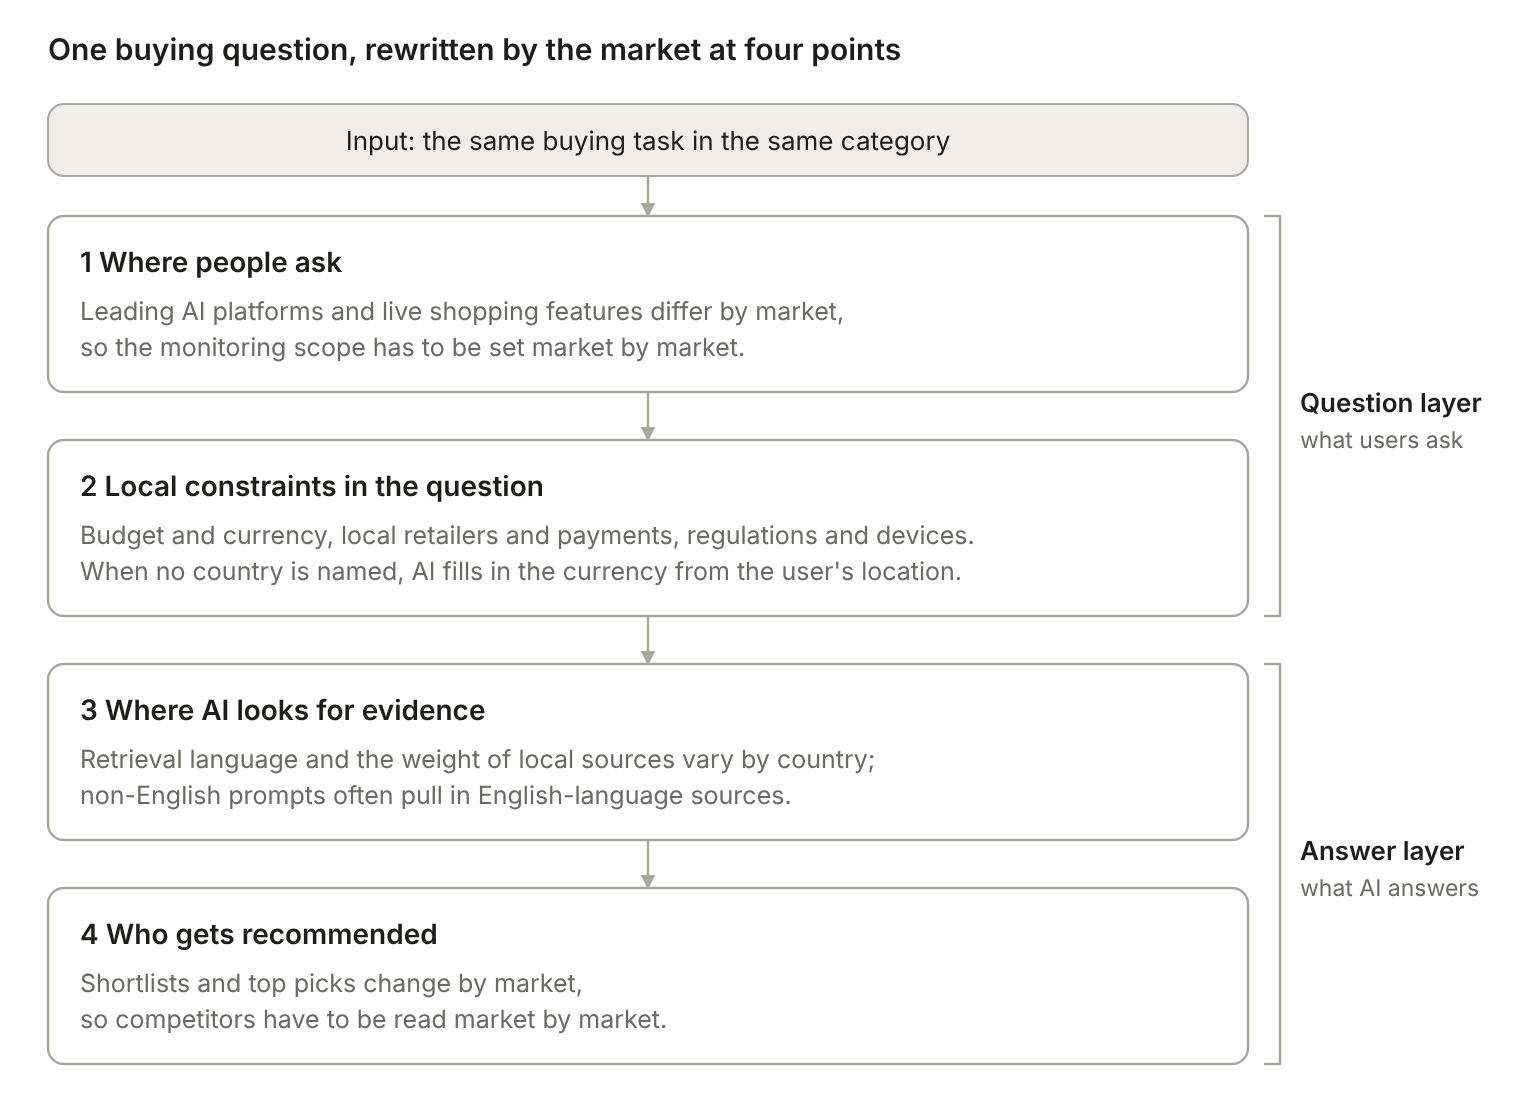
Halten Sie in Ihrer Analyse zwei Ebenen auseinander. Die Fragenebene ist, was Nutzer gefragt und welche Bedingungen sie angehängt haben. Die Antwortebene ist, welche Quellen die KI genutzt und welche Marken sie empfohlen hat. Wenn eine Marke in einem Markt „verschwindet“, stellen lokale Nutzer womöglich einfach eine andere Frage, oder die Quellen und Vorlieben der KI haben sich geändert. Die nächsten vier Abschnitte folgen dieser Reihenfolge.
Vier Ebenen von Unterschieden, behandelt in den vier Abschnitten unten.
Unterschied 1: Welche KI Menschen fragen, hängt vom Markt ab
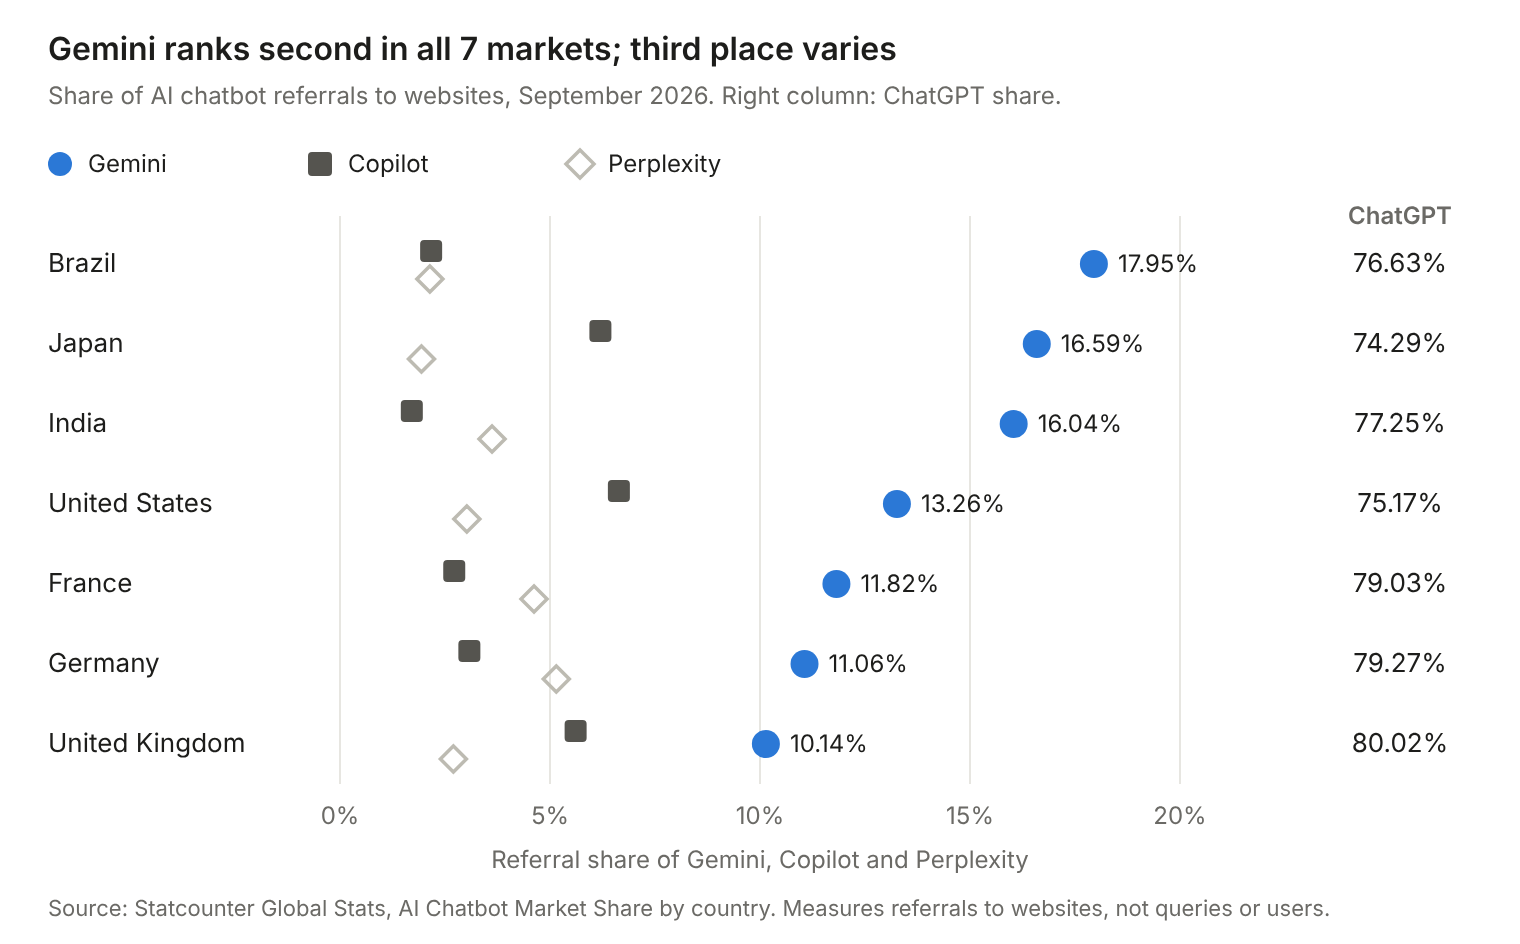
ChatGPT führt in jedem großen Auslandsmarkt, aber die Reihenfolge dahinter unterscheidet sich. Die Daten von Statcounter vom September 2026 sehen ChatGPT in jedem der sieben Märkte unten bei etwa 74 %–80 %. Gemini liegt in Brasilien, Japan und Indien über 16 %, in Großbritannien aber bei etwa 10 %. Copilot liegt in den USA und Japan über 6 %, in Indien jedoch unter 2 %. Perplexity ist in Deutschland und Frankreich höher als in den anderen gezeigten Märkten.
Quelle: Statcounter Global Stats, Anteil an Verweisen von KI-Chatbots, September 2026, sieben Märkte.
Achten Sie auf die Kennzahl. Statcounter misst den Anteil jedes Chatbots an den Verweisen auf Websites (auf Basis der Seitenaufrufe auf den erfassten Websites). Das ist weder eine Zählung von Fragen noch von Nutzern, und Grok fehlt, weil es keine Verweisdaten übergibt. Die Daten zeigen, welche Plattformen in einem Markt Menschen auf Websites schicken; das Volumen an Kauffragen lässt sich damit nicht schätzen.
Umfragedaten weisen in dieselbe Richtung. Eine von Vercel beauftragte Umfrage des World Retail Congress (Mai 2026, 4.000 europäische Käufer), über die Pygmalios berichtet, ergab: 49 % der Befragten in Südeuropa nutzen beim Einkaufen ChatGPT, verglichen mit 40 % in den nordischen Ländern, 38 % in Deutschland und 33 % in Großbritannien. Die Hälfte der britischen Befragten nutzt beim Einkaufen überhaupt keine KI-Suche, verglichen mit 32 % in Südeuropa. Diese Zahlen beruhen auf Selbstauskünften, Südeuropa und die nordischen Länder sind zusammengefasste Ländergruppen, und Pygmalios selbst warnt, dass „erklärte Absichten das beobachtete Verhalten regelmäßig überzeichnen“.
Auch die Reihenfolge, in der Funktionen eingeführt werden, schafft Unterschiede. Als OpenAI am 29. September 2025 Instant Checkout in ChatGPT einführte, stand es nur Nutzern in den USA offen, und die einzigen Händler waren US-Verkäufer auf Etsy. Eine Bitte wie „Kauf es für mich“ ließ sich in Märkten mit Checkout direkt im Chat erledigen, anderswo konnte sie Nutzer nur auf eine externe Website weiterleiten. Welche Märkte die Funktion im Oktober 2026 abdeckt, haben wir nicht geprüft; klären Sie das gesondert, bevor Sie Märkte vergleichen.
Unterschied 2: Kauffragen enthalten unterschiedliche lokale Bedingungen
Selbst wenn die Frage „Welches soll ich nehmen?“ lautet, hängt jeder Markt andere Bedingungen an. Manche stehen in der Frage, andere werden aus dem Standort des Nutzers ergänzt.
Bedingungen in der Frage: ein Budget in Landeswährung, lokale Handelsplattformen, Zahlungs- und Lieferoptionen, lokale Vorschriften oder steuerliche Anforderungen. Zahlungen sind ein deutliches Beispiel. Im Test von FTA Global stand Stripe in New York, London, Madrid, Paris und Berlin auf Platz 1, kam aber in Mumbai, Delhi und Bengaluru nicht unter die ersten fünf. Mit einem anderen lokalen Zahlungsökosystem wird „Welches Zahlungstool sollte ein kleines Unternehmen nutzen?“ praktisch zu einer anderen Frage.
Aus dem Standort ergänzte Bedingungen: Auch wenn der Nutzer kein Land nennt, leitet die KI Währung und Regeln aus dem Standort ab, wie der Kaffeetest oben zeigt. Halten Sie beim Vergleich von Märkten fest, wo jede Antwort erhoben wurde.
Wie weit die Frage auf der Kaufreise reicht: In der Umfrage von Deloitte vom Mai 2026 unter 13.500 Verbrauchern in 15 europäischen Ländern waren 42 % der Befragten in Spanien bereit, die KI Kaufentscheidungen für sie treffen zu lassen, in Finnland 27 %. In Märkten, in denen mehr Menschen die Entscheidung an die KI abgeben, sind Fragen wie „Such mir einfach eins aus“ oder „Nenn mir die beste Option“ womöglich häufiger. Das ist eine Hypothese, die mit lokalen Fragestichproben geprüft werden muss.
Nicht jeder Bedarf unterscheidet sich nach Markt. In der oben genannten Umfrage des World Retail Congress war der Preisvergleich in jeder Region die häufigste Nutzung unter KI-Käufern (51 %–55 %). Unsere Einschätzung: Die Handlung in einer Frage ist über Märkte hinweg ähnlich, die Unterschiede liegen vor allem bei Budgetbereichen, verfügbaren Kanälen und lokalen Regeln. Geben Sie beim Ordnen der Fragen deshalb Budget und Währung, genannten Plattformen, Zahlung und Lieferung, Vorschriften und Gerätebedingungen jeweils eine eigene Spalte.
Unterschied 3: Die KI zitiert andere Quellen, und Nutzer vertrauen der KI unterschiedlich stark
Auch bei Kauffragen in nicht englischsprachigen Märkten stammt ein Großteil der Belege noch immer von englischsprachigen Webseiten. Peec AI analysierte mehr als 10 Millionen ChatGPT-Prompts und mehr als 20 Millionen Hintergrundsuchen (Query Fan-outs) und behielt nur Sitzungen, in denen der Standort des Nutzers zur Sprache des Prompts passte. Fast 78 % der nicht englischsprachigen Sitzungen ergänzten englischsprachige Recherche, und 43 % der Fan-outs nicht englischsprachiger Prompts liefen auf Englisch. Nach Sprache ergänzten türkische Sitzungen am häufigsten englische Recherche (94 %) und spanische am seltensten (66 %).
Auch das Gewicht lokaler Quellen unterscheidet sich je nach Land. Im Test von FTA Global machten lokale Domains und Publikationen in Deutschland 42 %, in Frankreich 34 % und in Indien 17 % der zitierten Quellen aus. Wo lokale Quellen weniger Gewicht haben, brauchen lokale Marken womöglich Präsenz auf englischsprachigen oder internationalen Websites, um in Antworten zu erscheinen. Die manuellen Tests von Peec AI enthalten ein Beispiel: Auf Polnisch und von einer polnischen IP-Adresse aus nach den besten Auktionsseiten gefragt, ließ ChatGPT Allegro, die führende lokale Plattform Polens, entweder weg oder setzte sie weit nach unten. Das ist ein Einzelbeispiel, kein statistisches Ergebnis.
Auch das Vertrauen in KI-Antworten unterscheidet sich. In derselben Umfrage von Deloitte gaben 61 % der Befragten in Spanien an, den Informationen der KI zu vertrauen, in Finnland 36 %. Unsere Hypothese: In Märkten mit geringerem Vertrauen fragen Nutzer eher nach Quellen, Bewertungen und Kundendienstgarantien, deshalb zählt lokal überprüfbares Material mehr. Öffentliche Daten, die das direkt prüfen, gibt es noch nicht.
Unterschied 4: Empfohlene Marken und Wettbewerber wechseln
Kommen die ersten drei Unterschiede zusammen, sehen Nutzer am Ende unterschiedliche Auswahllisten. Mit „New York + Englisch“ als Basis wiederholte FTA Global dieselben Kauffragen für kleine Unternehmen in London, Madrid, Paris, Berlin und drei indischen Städten:
Im Schnitt wechselten 2,9 der fünf meistempfohlenen Marken.
Die Wechsel konzentrierten sich auf Kategorien, die mit Geld und Compliance zu tun haben: Lohnabrechnung, Buchhaltung, Zahlungen und HR kamen im Schnitt auf 4,4 gewechselte Marken, Projektmanagement, Videokonferenzen und Cloud-Speicher nur auf 1,5.
Von insgesamt 206 Marken kamen 159 nur an einem einzigen Standort unter die ersten fünf.
Auch die Sprache verändert die erste Wahl. Ein Test von Reza Moaiandin, Mitgründer von SALT.agency, veröffentlicht im Search Engine Journal, stellte dasselbe Set an Kauffragen auf Englisch, Arabisch, Russisch, vereinfachtem Chinesisch und Persisch. Der Kerntest nutzte Claude Sonnet 5 mit deaktivierter Websuche, erhoben am 7. September 2026, mit 40 Durchläufen pro Kombination aus Szenario und Sprache. Die Tabelle zeigt den Anteil der Antworten, in denen jede Marke die erste Wahl war:
Szenario
Marke
Höchster Anteil
Niedrigster Anteil
Hin- und Rückflug London–Teneriffa
easyJet
Russisch 72,5 %
Persisch 12,5 %
Kopfhörer mit Geräuschunterdrückung unter 400 £
Sony
Russisch und Persisch 100 %
Englisch 50 %
CRM für ein kleines Unternehmen in Großbritannien
HubSpot CRM
Englisch 22,5 %
Arabisch 2,5 %
Saugroboter unter 500 £
Roborock
Russisch 97,5 %
Englisch und Arabisch 87,5 %
Die Zeile zum Saugroboter zeigt, dass nicht jede Kategorie stark schwankt. Im selben Test änderte sich bei zwei der Kategorien mit aktivierter Websuche die erste Wahl in 7 von 10 Kombinationen aus Kategorie und Sprache. Bei denselben zwei Kategorien mit deaktivierter Suche stimmte die erste Wahl von ChatGPT nur in 1 von 10 Kombinationen mit der von Claude überein, mit der von Gemini in 5. Der Autor merkt an, dass die Daten an einem einzigen Nachmittag erhoben wurden und die Ergebnisse eine Tendenz anzeigen.
Wissenschaftliche Studien beobachten eine ähnliche Tendenz. Das EMNLP-2024-Paper „Global is Good, Local is Bad?“ ergab, dass LLMs positive Eigenschaften häufiger mit globalen Marken verbinden und Menschen in Ländern mit hohem Einkommen überproportional Luxusgeschenke empfehlen, wobei Herkunftslandeffekte lokale Marken in bestimmten Zusammenhängen stärken können. Für Marken heißt das: Wettbewerber sind marktspezifisch. Die Marken, mit denen Sie sich in den USA direkt messen, können in Indien oder Polen durch eine andere Gruppe lokaler Marken ersetzt werden.
So vergleichen Sie Kauffragen systematisch über Märkte hinweg
Behandeln Sie „Land oder Region × Sprache × Plattform“ als kleinste Vergleichseinheit und gehen Sie in fünf Schritten vor.
Vergleichseinheiten festlegen: Halten Sie für jede Einheit Land oder Region, Sprache und Plattform fest. Teilen Sie mehrsprachige Länder nach Sprache auf, zum Beispiel Englisch und Hindi in Indien oder Englisch und Französisch in Kanada.
Ein lokalisiertes Fragenset aufbauen: Sammeln Sie echte Formulierungen aus lokalen Quellen wie lokalen Suchvorschlägen, Foren sowie Aufzeichnungen aus Kundenservice und Vertrieb, und lassen Sie sie von einem Muttersprachler prüfen. Behalten Sie für den Vergleich ein Set an Kaufaufgaben, das alle Märkte teilen, und ergänzen Sie dann marktspezifische Fragen.
Bedingungen fixieren und wiederholt Stichproben erheben: Nutzen Sie denselben Zeitraum, dasselbe Modell und dieselben Sucheinstellungen und wiederholen Sie jede Bedingung mehrmals. FTA Global führte jede Bedingung 5-mal aus, der Test von SALT 40-mal. Halten Sie Erhebungsort und Kontostatus fest.
In vier Dimensionen vergleichen: siehe Tabelle unten.
Unterschiede mit lokalen Fakten erklären: Prüfen Sie zuerst lokale Preise, Verfügbarkeit, Kanäle und Vorschriften und entscheiden Sie dann, ob Sie lokalisierte Inhalte erstellen, eine gemeinsame Seite aktualisieren oder weiter beobachten.
Dimension
Was je Markt festzuhalten ist
Häufige Fehldeutung
Wo Menschen fragen
Wichtigste lokale KI-Plattformen; ob Einkaufskarten, Checkout und ähnliche Funktionen verfügbar sind
Nur ChatGPT testen, nur in US-Englisch
Bedingungen der Frage
Originaltext der Frage; Budget und Währung; genannte Plattformen, Zahlungen, Lieferung, Vorschriften und Geräte
Eine übersetzte englische Frage als lokale Frage behandeln
Belegquellen
Zitierte URLs, Sprache der Quelle, lokale oder internationale Websites
Domains zählen, ohne die Quellen zu lesen
Empfehlungen
Erste Wahl, Top-5-Liste, ob Ihre Marke erscheint und in welchem Zusammenhang
Einen einzigen Screenshot für einen ganzen Markt stehen lassen
Kauffragen über Auslandsmärkte hinweg mit Dageno vergleichen
Die vier Dimensionen oben entsprechen mehreren Funktionen von Dageno:
Cross-Model and Regional Benchmarking: vergleicht Sichtbarkeit, Rang und führende Wettbewerber Ihrer Marke über KI-Modelle und Regionen hinweg, damit ein Durchschnitt nicht verdeckt, wo sich Ihre Position ändert.
Regional Comparison: bringt beobachtbare KI-Antworten, Wettbewerbskontext und sichtbare Quellen aus verschiedenen Märkten und Sprachen in eine prüfbare Ansicht.
AI Search Intents: gruppiert die Prompts eines Marktes nach Absicht; für jede Gruppe sehen Sie, welche Marken die Antworten nennen und welche Seiten sie zitieren.
Wenn das Ziel die Wahl des nächsten Marktes ist, verknüpft die Lösung zur Markterweiterung diese Module zu drei Prüfungen: Märkte vergleichen, jeden Markt verstehen und auswählen, was geprüft wird.
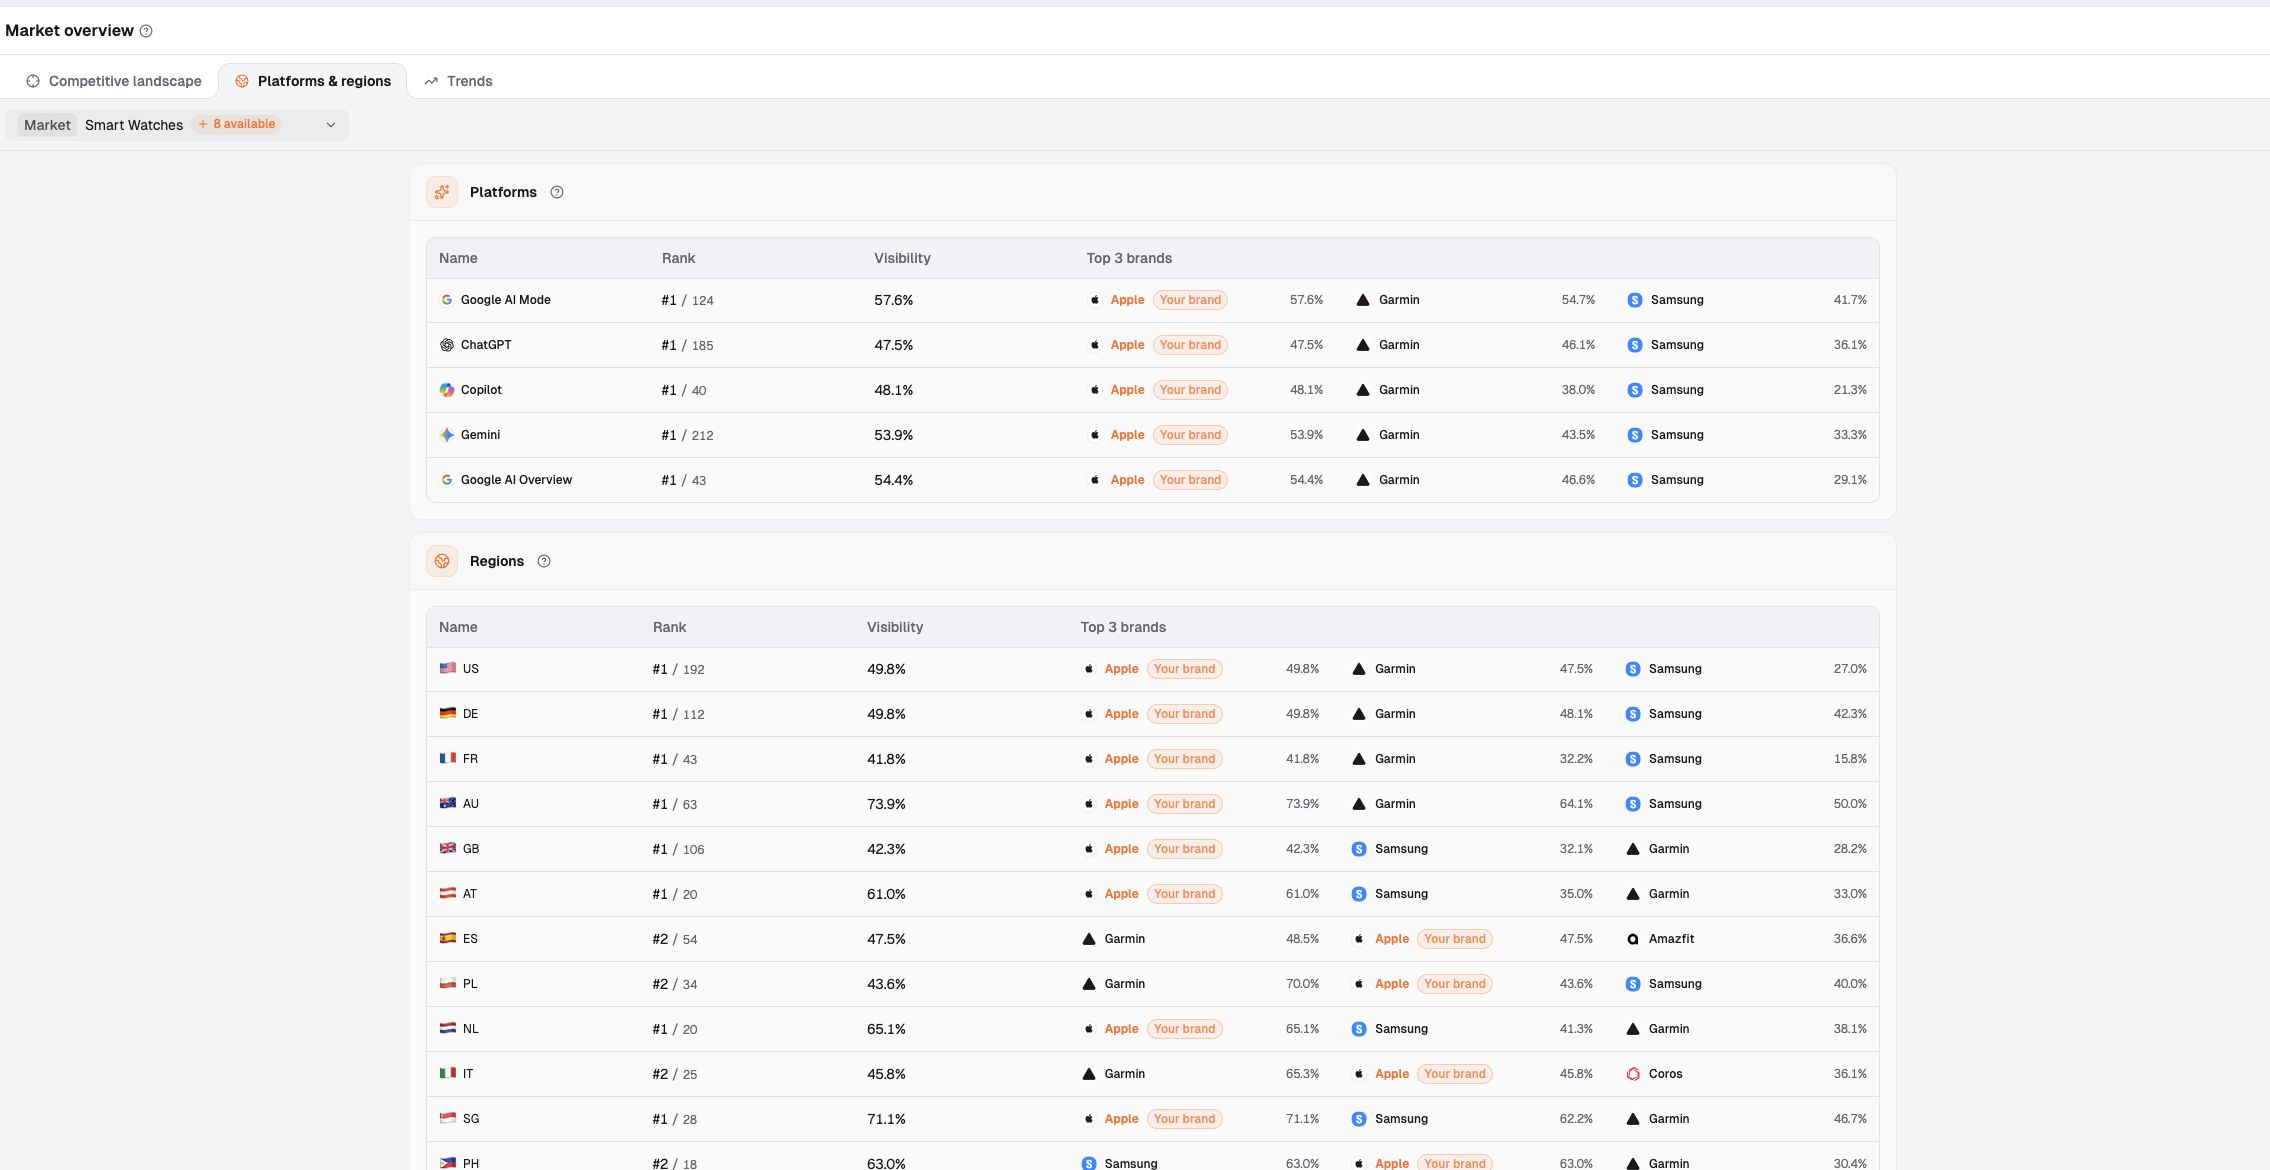
Nehmen Sie den Smartwatch-Markt in einem Demo-Workspace von Dageno als Beispiel (Apple ist nur die Beispielmarke und kein Kunde von Dageno). Die Regionstabelle unter „Market overview → Platforms & regions“ zeigt Apple in den meisten Märkten auf Platz 1, in Spanien, Polen und Italien aber auf Platz 2, wo Garmin führt.
Abbildung 1: Ein Smartwatch-Markt, Rang und Sichtbarkeit der Marke nach KI-Plattform und Region aufgeschlüsselt.
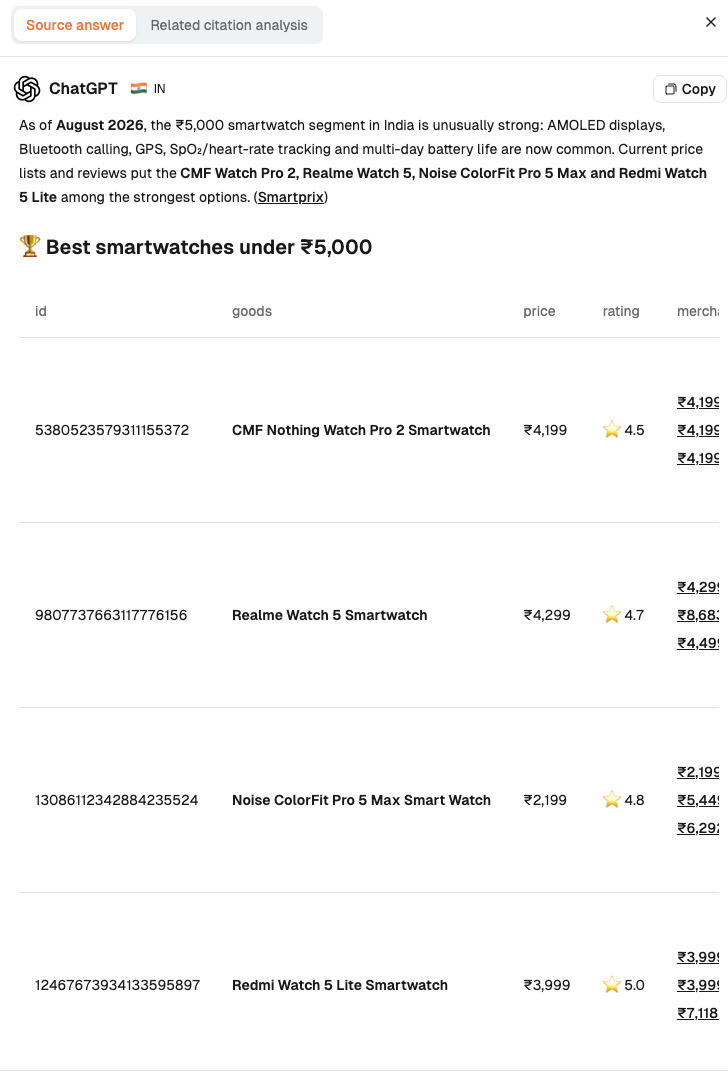
Die Regionstabelle sagt Ihnen nur, wo Sie zuerst hinschauen sollten; um die Fragen selbst zu sehen, müssen Sie die Antworten öffnen. In der von Dageno veröffentlichten Fallstudie KI-Sichtbarkeit nach Region: Wann Sie Seiten lokalisieren steht Apple in Indien auf Platz 14 mit 4,76 % Sichtbarkeit. Beim Lesen der Antworten zeigt sich, dass beide indischen Antworten Uhren unter ₹5,000 empfehlen, während Apples Website für Indien die Apple Watch SE 3 ab ₹29,900 führte (laut Fallstudie am 30. September 2026 geprüft).
Abbildung 2: ChatGPT-Antwort für Indien (IN), die Frage ist auf unter ₹5,000 begrenzt.
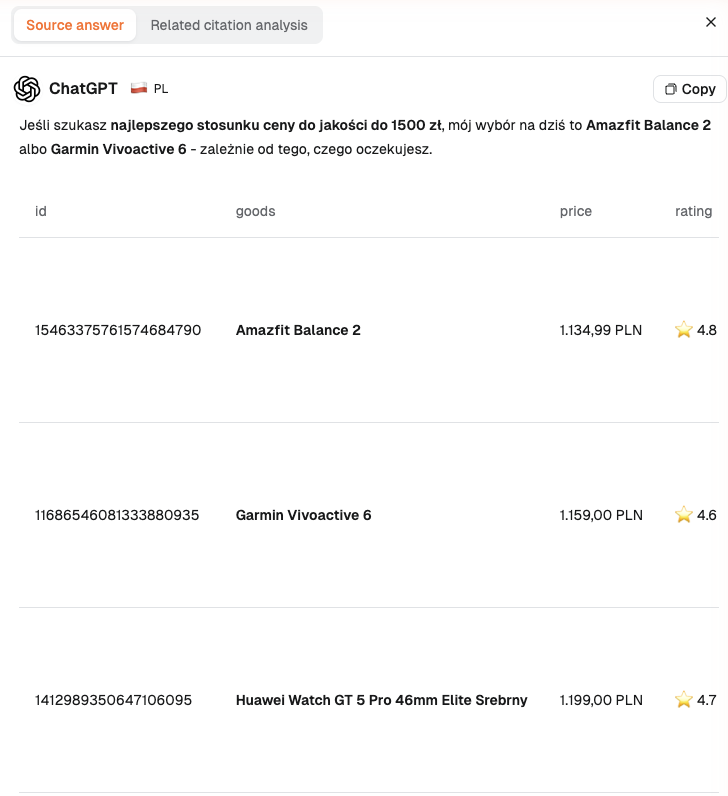
Die polnische Antwort ist dagegen auf Polnisch und hat ein Budget von 1500 zł. Sie empfiehlt Uhren von Amazfit, Garmin, Huawei, Samsung und anderen, und ihre Zitate stammen vor allem von lokalen Händler- und Preisvergleichsseiten wie euro.com.pl, ceneo.pl, mediamarkt.pl und allegro.pl.
Abbildung 3: ChatGPT-Antwort für Polen (PL), die auf Polnisch Uhren innerhalb eines Budgets von 1500 zł empfiehlt.
Diese beiden Märkte entsprechen den zwei oben beschriebenen Arten von Unterschieden: In Indien änderte sich die Budgetbedingung der Frage, in Polen änderten sich Sprache und lokale Quellen. Die Stichproben sind klein (zwei Antworten für Indien, nur eine vergleichbare Antwort für Polen), deshalb kommt die Fallstudie für Indien zu „als nicht relevante Frage markieren“ und für Polen zu „weiter beobachten“.
Diese Ansichten erfassen gespeicherte KI-Antworten. Wie es auf der Seite zur Markterweiterung von Dageno heißt, misst KI-Sichtbarkeit über Märkte hinweg „weder Gesamtnachfrage noch Marktgröße, Absatzpotenzial, Marktanteil oder Käuferpräferenz“. Die Wahl eines Marktes erfordert weiterhin eigene Recherche sowie eine Prüfung von Produkt, Kanälen und Compliance. Laut dem Dageno-Blog deckt die kostenlose Abfrage 86 Länder und Regionen und 12.000 Marktsegmente ab, Sie können also zunächst prüfen, wo Ihre Marke in einem Zielmarkt steht.
Übersehene Variablen, Verzerrungen und Kosten
Beim Vergleich von Märkten lassen sich die folgenden Faktoren leicht mit „Marktunterschieden“ verwechseln oder treiben die Kosten des Vergleichs über das Erwartete hinaus.
Standort und Sprache sind zwei Variablen: FTA Global stellte in Mumbai dieselbe Zahlungsfrage auf Englisch, Hindi und Hinglish. Alle drei lieferten überwiegend indische Marken, doch die Listen und ihre Reihenfolge änderten sich. Nur die IP ohne die Sprache zu ändern oder nur die Sprache ohne den Standort misst verschiedene Dinge.
Antworten sind schon für sich instabil: Im Test von FTA Global nannten alle fünf Durchläufe nur in 35 % der Bedingungen dieselbe Spitzenmarke. Ein in einem einzelnen Durchlauf gesehener Unterschied kann reine Zufallsschwankung sein.
Plattform, Version und Sucheinstellungen: Bei derselben Stadt und Frage teilten ChatGPT und Gemini im Schnitt nur 3,2 ihrer fünf Spitzenmarken (FTA Global); im Test von SALT änderte das Einschalten der Suche die erste Wahl in 7 von 10 Kombinationen. Fassen Sie Ergebnisse aus unterschiedlichen Bedingungen nicht zusammen.
Die Kennzahlen unterscheiden sich: Statcounter misst Verweise auf Websites, nicht die Nutzung. Verbraucherumfragen beruhen auf Selbstauskünften, und manche berichten über einzelne Länder, andere fassen mehrere zusammen. Im Bericht von Deloitte weichen die KI-Nutzungsraten einiger Länder zwischen Diagramm und Anhangstabelle leicht voneinander ab, prüfen Sie also die Originaltabelle, bevor Sie zitieren.
Die Position der Forschenden: Peec AI, FTA Global und SALT.agency, die hier alle zitiert werden, verkaufen GEO- oder KI-Sichtbarkeitsdienste, ebenso wie Dageno. Ihre Schlussfolgerungen weisen in dieselbe Richtung, ihre Stichproben und Methoden unterscheiden sich aber; am besten testen Sie mit Ihren eigenen Kategorien und Märkten erneut.
Die Kosten steigen mit der Zahl der Kombinationen: Jede zusätzliche Kombination aus „Land × Sprache × Plattform“ bringt mehr Stichproben- und Lesearbeit, und lokale Fragensets brauchen eine Prüfung durch Muttersprachler. Sich auf die 2–3 für das Geschäft wichtigsten Märkte zu konzentrieren, ist praktikabler, als sich auf ein Dutzend auf einmal zu verteilen.
Die Zeit verändert Schlussfolgerungen: Plattformfunktionen werden Markt für Markt eingeführt, und Modelle werden ständig aktualisiert. Versehen Sie jeden Vergleich mit einem Datum und vergleichen Sie alte Ergebnisse nicht direkt mit neuen.
Vergleichen Sie die Sichtbarkeit Ihrer Marke in der KI-Suche über Märkte hinweg
Stehen englische Fragen, die in die Landessprache übersetzt wurden, für die Fragen lokaler Nutzer?
Nur als „dieselbe Aufgabe in der Landessprache gefragt“. Lokale Budgets, Kanäle und die alltägliche Ausdrucksweise erfassen sie nicht. Übersetzte Fragen eignen sich als marktübergreifendes Kontrollset; ergänzen Sie muttersprachliche Formulierungen aus lokalen Suchvorschlägen, Foren und Kundenserviceaufzeichnungen.
Wie viele Sprachen sollten wir in einem Land testen?
Richten Sie sich nach den Sprachen, die lokale Käufer tatsächlich verwenden. In mehrsprachigen Märkten wie Indien, der Schweiz und Kanada testen Sie mindestens die Hauptsprachen getrennt. Wenn ein Teil Ihrer Käufer auf Englisch fragt (zum Beispiel Einkaufsteams internationaler Konzerne), erfassen Sie auch englische Formulierungen gesondert.
Wie viele Antworten pro Markt reichen aus?
Eine allgemeingültige Zahl gibt es nicht. In öffentlichen Tests führte FTA Global jede Bedingung 5-mal aus und SALT 40-mal. Unsere Empfehlung: Ziehen Sie keine Schlüsse über einen Markt, bevor die erste Wahl über wiederholte Durchläufe stabil ist, und erheben Sie in schwankungsanfälligen Kategorien mehr Stichproben.
Reicht es, nur ChatGPT zu überwachen?
Für die meisten Märkte nicht. ChatGPT hat den größten Anteil an Verweisen, aber Gemini liegt in manchen Märkten über 16 %, und ChatGPT und Gemini teilen bei derselben Frage im Schnitt nur 3,2 ihrer fünf Spitzenmarken. Ergänzen Sie mindestens die zweit- und drittgrößte Plattform jedes Marktes.
Sollten wir sofort eine lokalisierte Seite erstellen, wenn ein Markt andere Empfehlungen zeigt?
Nein. Prüfen Sie zuerst, ob die Frage selbst anders ist, zum Beispiel ein Budget unterhalb Ihrer Produktlinie. Prüfen Sie dann, ob das Produkt lokal verkauft wird und was lokale Quellen sagen. Eine lokalisierte Seite lohnt sich nur, wenn sich lokale Fakten tatsächlich unterscheiden und wiederholte Stichproben weiterhin zeigen, dass Ihre Marke fehlt.
Fazit
KI-Kauffragen in verschiedenen Auslandsmärkten unterscheiden sich auf vier Ebenen: welche Plattform Menschen fragen, welche Bedingungen die Frage enthält, woher die KI ihre Belege nimmt und wen sie am Ende empfiehlt. Öffentliche Tests zeigen bereits, dass der Blick nur auf Ergebnisse in US-Englisch Sie bei mehr als der Hälfte der Auswahlliste in die Irre führen kann (im Software-Kategorien-Test von FTA Global wechselten im Schnitt 2,9 der ersten fünf). Öffentliche Daten dazu, wie lokale Nutzer tatsächlich fragen, sind allerdings noch rar, deshalb muss jede Marke ihre eigenen Märkte und Kategorien selbst stichprobenartig erheben.
Dageno is the research and insights team at Dageno AI, publishing industry reports and expert analysis on AI Search Visibility, Generative Engine Optimization (GEO), and AI-powered search discovery.
 Alexa for Shopping