Hãy xem thương hiệu của bạn đang ở vị trí nào trên thị trường AI.
Hãy tìm kiếm những cơ hội tăng trưởng đáng ưu tiên dựa trên nhu cầu thị trường, bối cảnh cạnh tranh, giá trị cốt lõi của thương hiệu và các nguồn trích dẫn.
5 công cụ đo lường độ hiển thị trên AI chính xác nhất (2026)
So sánh năm công cụ đo lường độ hiển thị trên AI dựa trên phương pháp lấy mẫu, tính minh bạch của nguồn, khả năng kiểm soát prompt, phạm vi mô hình, quyền truy cập câu trả lời thô và tính nhất quán của kết quả.
Khám phá hơn 12,000 thị trường ngách mà không cần đăng nhập.
Khả năng hiển thị trên AI không phải là một thứ hạng cố định. Cùng một prompt có thể tạo ra cách diễn đạt, nguồn và đề xuất thương hiệu khác nhau qua các lần chạy, địa điểm, tài khoản, mô hình và chế độ tìm kiếm. Vì vậy, “độ chính xác” là vấn đề về thiết kế đo lường, chứ không phải một tỷ lệ phần trăm do nhà cung cấp đưa ra.
Hướng dẫn này so sánh năm nền tảng đo lường khả năng hiển thị trên AI dựa trên các yếu tố giúp chỉ số đáng tin cậy hơn: nguồn gốc prompt, phương pháp thu thập, bối cảnh mô hình và thị trường, lấy mẫu lặp lại, khả năng truy cập câu trả lời thô, bằng chứng ở cấp độ trích dẫn và khả năng xuất dữ liệu.
So sánh nhanh: công cụ đo lường khả năng hiển thị trên AI
Nền tảng
Phù hợp nhất với
Tín hiệu đo lường mạnh nhất
Câu hỏi cần thẩm định
Profound
Chương trình doanh nghiệp và đa thị trường
Thu thập qua giao diện dành cho người tiêu dùng, chạy hằng ngày, xuất dữ liệu thô
Bao gồm bao nhiêu lần lặp lại?
Semrush
Đội ngũ SEO cần khám phá thị trường và theo dõi
Bộ dữ liệu và nguồn prompt được tài liệu hóa
Bộ dữ liệu nào cung cấp dữ liệu cho từng chỉ số?
HubSpot AEO
Khách hàng HubSpot
Theo dõi prompt hằng ngày, gắn với quy trình tiếp thị
Có giới hạn nào về prompt và câu trả lời?
Dageno
Đội ngũ chuyển từ đo lường sang tối ưu hóa
Trích dẫn, đối thủ cạnh tranh, khoảng trống và quy trình nội dung
Phương pháp thu thập nào áp dụng cho từng công cụ tìm kiếm?
Ahrefs Brand Radar
Chuyên viên phân tích SEO và khám phá thị trường
Chỉ mục khám phá quy mô lớn cùng prompt tùy chỉnh
Dữ liệu khám phá và theo dõi tùy chỉnh được phân biệt như thế nào?
Không nền tảng nào có thể đưa ra điểm “chính xác 94%” áp dụng phổ quát nếu không xác định dữ liệu chuẩn để đối chiếu, tập hợp prompt, công cụ tìm kiếm, khoảng thời gian, quy trình lấy mẫu và cách tính sai số. Hãy xem các tỷ lệ phần trăm về độ chính xác không có căn cứ là tuyên bố tiếp thị, chứ không phải bằng chứng có thể so sánh.
“Khả năng hiển thị trên AI chính xác” nên được hiểu như thế nào
1. Tập hợp prompt mang tính đại diện
Bảng điều khiển chỉ đại diện tốt đến mức tập hợp prompt đứng sau nó. Một tập hợp hữu ích bao gồm các câu hỏi về thương hiệu, danh mục, vấn đề, so sánh, lựa chọn thay thế, trường hợp sử dụng và ý định mua hàng. Tập hợp đó cũng nên ghi lại prompt đến từ nghiên cứu khách hàng, nhu cầu tìm kiếm, khám phá trên nền tảng hay bộ tiêu chuẩn của chính bạn.
2. Các lần quan sát lặp lại
Câu trả lời tạo sinh có tính ngẫu nhiên. Một lần chạy có thể là thật nhưng không mang tính đại diện. Nghiên cứu về đo lường tìm kiếm tạo sinh cho thấy vì sao nên xem khả năng hiển thị là một ước tính có độ bất định, thay vì một thứ hạng cố định. Thu thập lặp lại giúp phân biệt thay đổi kéo dài với biến động bình thường của câu trả lời.
3. Bối cảnh rõ ràng về công cụ tìm kiếm và thị trường
“Khả năng hiển thị trên ChatGPT” là thông tin chưa đầy đủ. Kết quả có thể phụ thuộc vào mô hình, chế độ tìm kiếm, ngày, quốc gia, ngôn ngữ, cá nhân hóa và giao diện. Một nền tảng đáng tin cậy nên công khai hoặc cho phép bạn kiểm soát những yếu tố ảnh hưởng đáng kể đến câu trả lời.
4. Bằng chứng có thể kiểm tra
Tỷ lệ tiếng nói (share of voice) tổng hợp hữu ích cho việc rà soát nhanh, nhưng các nhóm cũng cần có câu trả lời gốc, bối cảnh thương hiệu, tên miền được trích dẫn, URL được trích dẫn, dấu thời gian và prompt. Bằng chứng thô cho phép chuyên viên phân tích kiểm tra lỗi phân loại và giải thích các thay đổi.
5. Định nghĩa chỉ số minh bạch
Khả năng hiển thị, tỷ lệ đề cập, tỷ lệ trích dẫn, vị trí, cảm xúc và mức độ đề xuất đo lường những yếu tố khác nhau. Công cụ nên ghi rõ tử số, mẫu số, cách tính trọng số, cách xử lý lỗi và khoảng thời gian tổng hợp. Nếu không, hai biểu đồ có cùng nhãn có thể không so sánh được.
6. Báo cáo lỗi và trường hợp từ chối
Các yêu cầu bị chặn, hết thời gian chờ, câu trả lời trống, trường hợp từ chối và chế độ tìm kiếm không khả dụng không nên bị loại bỏ một cách âm thầm. Loại trừ các lần quan sát bị lỗi có thể làm tăng kết quả và khiến một mẫu nhỏ có vẻ ổn định hơn thực tế.
1. Profound: công khai nhiều thông tin nhất về cách thu thập câu trả lời
Profound Answer Engine Insights cung cấp thông tin công khai đặc biệt hữu ích về quy trình đo lường. Công ty cho biết họ thu thập câu trả lời thông qua các trải nghiệm dành cho người tiêu dùng, chạy theo dõi hằng ngày, hỗ trợ prompt tùy chỉnh và prompt quan sát được, lưu lại trích dẫn, so sánh các nền tảng và cung cấp dữ liệu thô ở định dạng CSV.
Vì sao các chỉ số của nền tảng này dễ kiểm tra hơn
Các lần quan sát hằng ngày hỗ trợ phân tích xu hướng thay vì chỉ kiểm tra một lần.
Có thể kiểm tra dữ liệu ở cấp độ câu trả lời và trích dẫn bên dưới các chỉ số tổng hợp.
Các tùy chọn khu vực và ngôn ngữ hỗ trợ so sánh đa thị trường.
Dữ liệu thô có thể xuất cho phép đội ngũ phân tích tái lập hoặc phản biện kết luận từ bảng điều khiển.
Những điều cần xác minh
Hãy hỏi mỗi prompt được chạy bao nhiêu lần, các lần quan sát lỗi được tính như thế nào, chính xác những chế độ nào của công cụ tìm kiếm được sử dụng và liệu các thay đổi về phương pháp trong lịch sử có được ghi chú hay không. Tính minh bạch công khai rất hữu ích, nhưng không loại bỏ nhu cầu kiểm tra tập hợp prompt của chính bạn.
2. Semrush: phân tách rõ ràng nhất giữa các bộ dữ liệu AI
Semrush AI Visibility ghi rõ rằng các tính năng AI của nền tảng sử dụng những bộ dữ liệu khác nhau cho hoạt động khám phá thị trường và theo dõi tùy chỉnh. Cơ sở kiến thức giải thích nguồn prompt, lịch thu thập, phạm vi mô hình và sự khác biệt giữa cơ sở dữ liệu prompt lớn với hoạt động theo dõi do người dùng xác định.
Vì sao sự phân biệt này quan trọng
Cơ sở dữ liệu khám phá ước tính những gì đang hiển thị trên toàn thị trường; trình theo dõi tùy chỉnh đo lường một tập hợp prompt được kiểm soát, quan trọng với một thương hiệu cụ thể. Việc kết hợp hai loại dữ liệu này mà không gắn nhãn có thể tạo ra xu hướng sai lệch. Cách phân tách được Semrush tài liệu hóa giúp chuyên viên phân tích chọn đúng bộ dữ liệu cho quyết định cần đưa ra.
Những điều cần xác minh
Xác nhận bộ dữ liệu, quốc gia, thiết bị hoặc chế độ, lịch làm mới và nguồn prompt cung cấp dữ liệu cho từng chỉ số xuất ra. Đừng so sánh trực tiếp điểm khám phá trên diện rộng với một bộ tiêu chuẩn tùy chỉnh nhỏ như thể chúng thuộc cùng một tập hợp dữ liệu.
3. HubSpot AEO: phù hợp nhất với quy trình hằng ngày có cấu trúc trong HubSpot
HubSpot AEO tài liệu hóa hoạt động theo dõi prompt hằng ngày trên ChatGPT, Gemini và Perplexity, với các chế độ xem về khả năng hiển thị thương hiệu, đối thủ cạnh tranh, trích dẫn và đề xuất. Điểm hấp dẫn không nằm ở số lượng công cụ tìm kiếm tối đa mà ở khả năng kết nối các lần quan sát với quy trình nội dung và tiếp thị hiện có.
Vì sao các chỉ số có thể đáng tin cậy về mặt vận hành
Có thể theo dõi một danh sách prompt ổn định mỗi ngày.
Các giới hạn tài khoản được nêu rõ giúp xác định quy mô mẫu.
Chế độ xem trích dẫn và đối thủ cạnh tranh bổ sung bối cảnh cho điểm khả năng hiển thị tổng quan.
Các nhóm có thể kết nối phát hiện với nội dung họ đang quản lý trong HubSpot.
Những điều cần xác minh
Kiểm tra các giới hạn áp dụng cho gói đăng ký của bạn, số lượng câu trả lời chính xác cho mỗi prompt, các tùy chọn thị trường, thời gian lưu trữ câu trả lời thô và các tùy chọn xuất dữ liệu. Lịch chạy hằng ngày chỉ hữu ích khi tập hợp prompt nền tảng được quản lý ổn định.
4. Dageno: phù hợp nhất để biến bằng chứng thành công việc tối ưu hóa
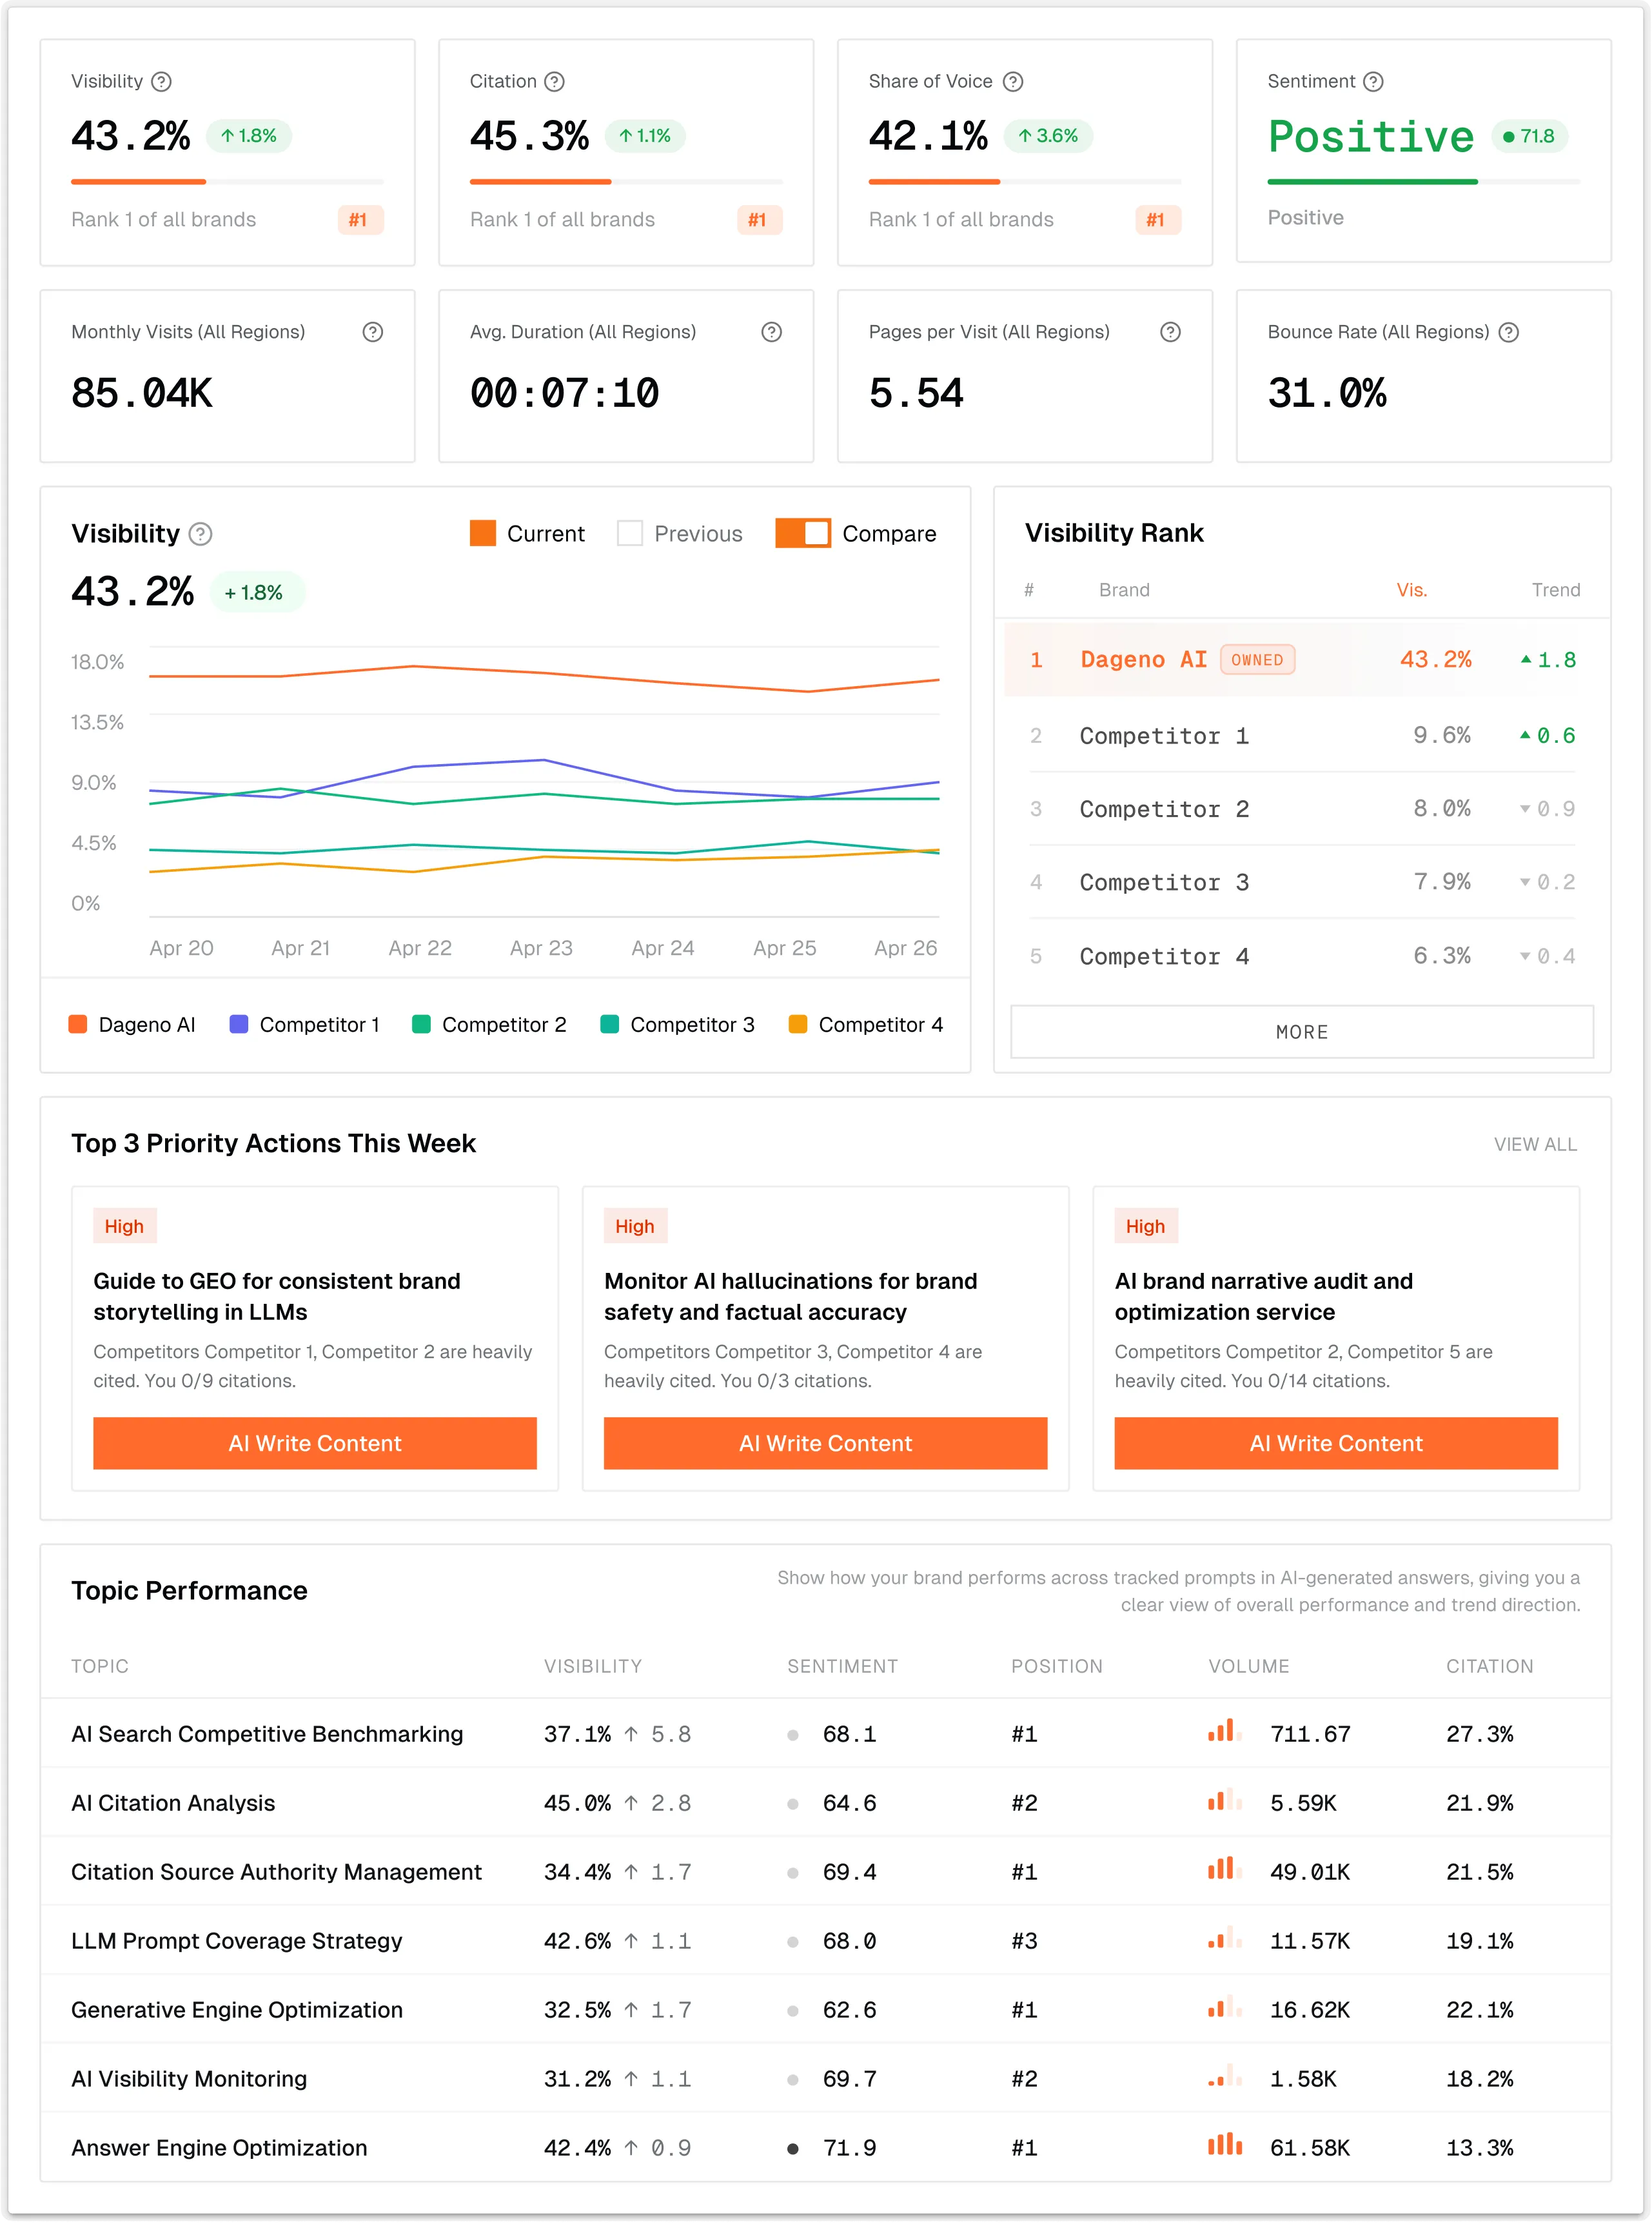
Dageno kết hợp theo dõi khả năng hiển thị trên AI với phân tích trích dẫn, so sánh đối thủ cạnh tranh, khoảng trống chủ đề và tối ưu hóa nội dung. Quy trình đầu-cuối này rất quan trọng vì một chỉ số được đo lường cẩn trọng về mặt thống kê sẽ có giá trị kinh doanh hạn chế nếu nhóm không thể truy xuất chỉ số đó về trang được trích dẫn hoặc một thay đổi nội dung cụ thể.
Điểm mạnh về đo lường
Khả năng hiển thị ở cấp độ prompt và so sánh đối thủ cạnh tranh.
Bằng chứng về trích dẫn và URL để chẩn đoán thay đổi.
Phân tích khoảng trống kết nối khả năng hiển thị còn thiếu với chủ đề và nguồn.
Quy trình nội dung giúp triển khai các phát hiện.
Những điều cần xác minh
Với từng công cụ tìm kiếm, hãy xác nhận giao diện thu thập, tùy chọn thị trường và ngôn ngữ, tần suất chạy, chính sách lặp lại, cách xử lý lỗi và khả năng truy cập câu trả lời thô. Nên đánh giá Dageno dựa trên bằng chứng và mức độ phù hợp với quy trình, chứ không phải một tỷ lệ phần trăm chính xác phổ quát không có căn cứ.
5. Ahrefs Brand Radar: phù hợp nhất với khám phá và prompt tùy chỉnh
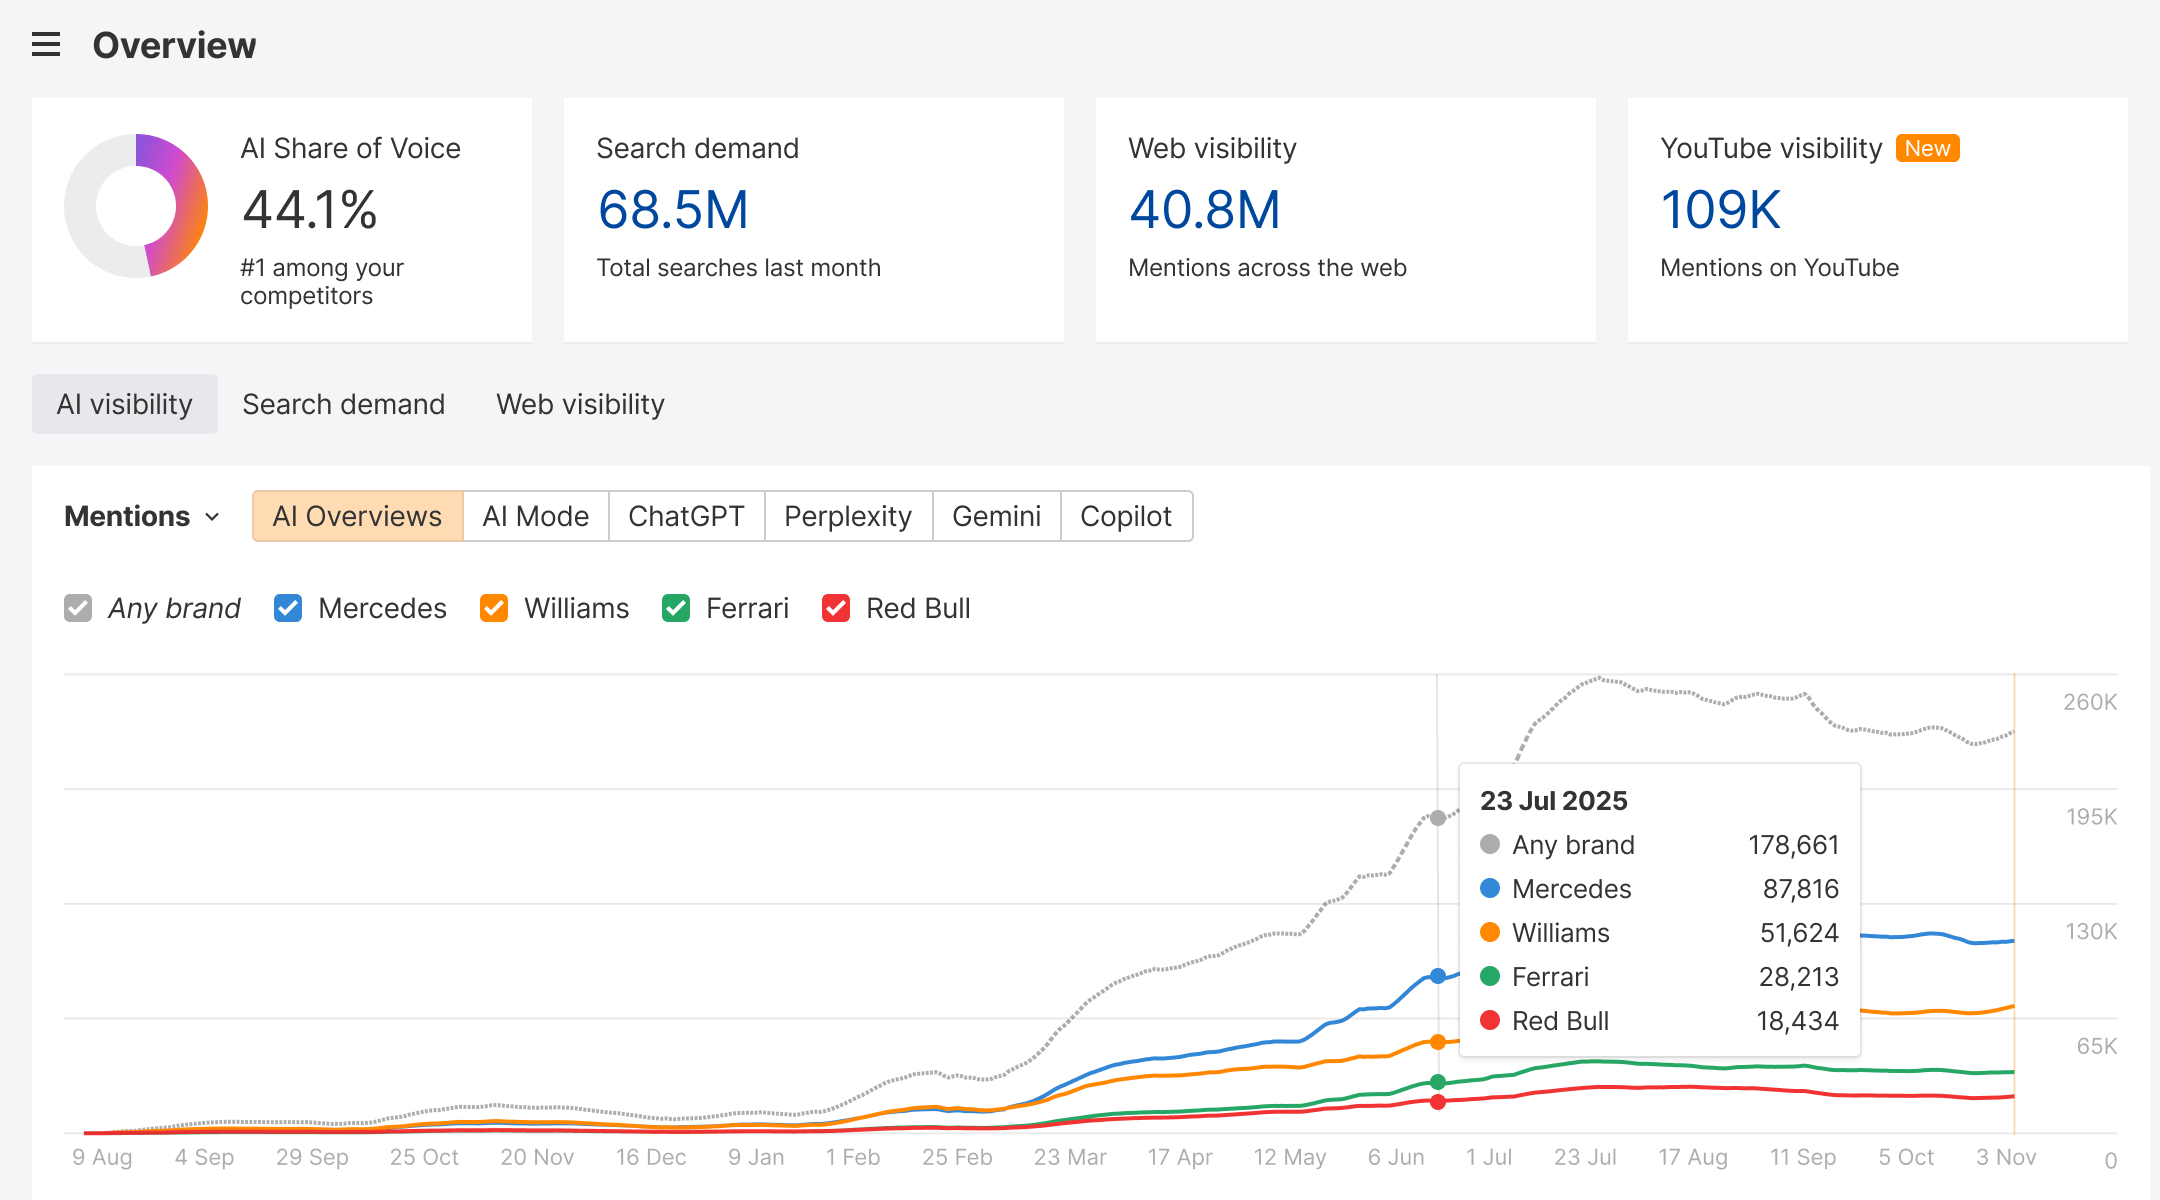
Ahrefs Brand Radar kết hợp một chỉ mục câu trả lời AI có thể tìm kiếm với tính năng theo dõi prompt tùy chỉnh. Điều này giúp công cụ hữu ích cho hai nhiệm vụ riêng biệt: khám phá cách một thị trường xuất hiện trên một bộ dữ liệu rộng và theo dõi một bộ tiêu chuẩn được chọn lọc theo thời gian.
Vì sao các chỉ số của nền tảng này hữu ích
Dữ liệu khám phá giúp tìm thương hiệu, chủ đề, lượt đề cập và nguồn được trích dẫn trên quy mô lớn.
Prompt tùy chỉnh tạo ra bộ tiêu chuẩn được kiểm soát cho các câu hỏi ưu tiên.
Tích hợp với dữ liệu Ahrefs có thể kết nối trích dẫn AI với phân tích SEO rộng hơn.
Chế độ xem nguồn và URL hỗ trợ điều tra ở cấp độ nội dung.
Những điều cần xác minh
Hãy tách biệt chỉ số khám phá và chỉ số prompt tùy chỉnh trong báo cáo. Xác nhận tần suất cập nhật, phạm vi thị trường, mô hình hoặc chế độ, số lần lặp lại và cách lỗi câu trả lời ảnh hưởng đến mẫu số.
Bài kiểm tra xác thực thực tế trước khi mua
Bước 1: Xây dựng bộ tiêu chuẩn cố định
Chọn từ 30 đến 100 prompt trải đều các chủ đề về thương hiệu, danh mục, vấn đề, so sánh, lựa chọn thay thế và ý định mua hàng. Ghi lại quốc gia và ngôn ngữ mục tiêu. Giữ cố định phần lớn tập hợp này trong ít nhất bốn tuần.
Bước 2: Chạy nhiều hơn một lần
Thu thập các lần quan sát lặp lại cho một nhóm prompt có giá trị cao. Nếu công cụ chỉ chạy một lần, hãy tự chạy lại từ 10 đến 20 prompt trong giao diện dành cho người tiêu dùng có liên quan để ước tính mức độ biến động của câu trả lời.
Bước 3: Kiểm tra bằng chứng thô
Lấy mẫu các lượt đề cập, không đề cập, trích dẫn, nhãn cảm xúc và vị trí đối thủ cạnh tranh được báo cáo. Kiểm tra xem câu trả lời được lưu trữ có hỗ trợ cách phân loại hay không và các URL được trích dẫn có dẫn đến những trang đã báo cáo hay không.
Bước 4: Theo dõi riêng các trường hợp lỗi
Đếm thời gian chờ, trường hợp từ chối, truy vấn bị chặn, câu trả lời trống và chế độ không khớp. Một công cụ trả về 80 lần quan sát hợp lệ trong 100 lần thử không nên thể hiện cùng mức độ chắc chắn như công cụ có 100 lần quan sát hợp lệ.
Bước 5: So sánh những yếu tố tương đồng
Sử dụng cùng prompt, ngày, thị trường, ngôn ngữ và công cụ tìm kiếm. Đừng chỉ đánh giá nhà cung cấp dựa trên việc bên nào có chỉ số khả năng hiển thị cao hơn; các định nghĩa khác nhau có thể tạo ra những giá trị khác nhau từ cùng một câu trả lời.
Các chỉ số nên có trên bảng điều khiển dành cho lãnh đạo
Tỷ lệ đề cập: số câu trả lời hợp lệ có đề cập đến thương hiệu chia cho tổng số câu trả lời hợp lệ được quan sát.
Tỷ lệ trích dẫn: số câu trả lời hợp lệ có trích dẫn URL thuộc sở hữu thương hiệu chia cho tổng số câu trả lời hợp lệ được quan sát.
Tỷ lệ tiếng nói (share of voice): lượt đề cập thương hiệu so với một tập hợp đối thủ cạnh tranh được xác định, kèm công bố cách tính trọng số.
Tỷ lệ trích dẫn: số trích dẫn đến trang thuộc sở hữu thương hiệu so với tổng số trích dẫn hoặc số trích dẫn của đối thủ cạnh tranh.
Tỷ lệ đề xuất: số câu trả lời đề xuất thương hiệu, được tách riêng với các lượt đề cập trung lập.
Mức độ bao phủ prompt: các danh mục prompt được theo dõi có đủ số lần quan sát hợp lệ.
Mức độ biến động hoặc độ tin cậy: mức biến thiên qua các lần chạy lặp lại hoặc khoảng bất định.
Mức độ đầy đủ của bằng chứng: tỷ lệ phần trăm các lần quan sát còn lưu văn bản câu trả lời, trích dẫn, bối cảnh và dấu thời gian.
Những sai lầm thường gặp trong đo lường
Xem một câu trả lời như một thứ hạng
Một câu trả lời là một lần quan sát, không phải vị thế bền vững. Hãy sử dụng nhiều lần chạy và một khoảng thời gian cuốn chiếu trước khi kết luận có sự tăng hoặc giảm.
Thay đổi tập hợp prompt mà không chú thích biểu đồ
Thêm các prompt có hiệu suất cao có thể làm tăng khả năng hiển thị ngay cả khi thương hiệu không cải thiện. Hãy quản lý phiên bản bộ tiêu chuẩn và tách xu hướng trên cùng một tập hợp khỏi phạm vi bao phủ được mở rộng.
Trộn lẫn thị trường và mô hình
Mức trung bình toàn cầu có thể che khuất sự suy giảm mạnh ở một quốc gia hoặc công cụ tìm kiếm. Giữ nguyên các chiều dữ liệu về thị trường, ngôn ngữ, nền tảng và chế độ cho đến lớp báo cáo cuối cùng.
Chỉ tối ưu hóa điểm số
Khả năng hiển thị không có bối cảnh trích dẫn có thể khuyến khích các lượt đề cập hời hợt. Hãy kết hợp chỉ số với bối cảnh đề xuất, URL được trích dẫn, sự đa dạng nguồn, lượt chuyển đổi và lưu lượng truy cập đủ điều kiện khi có dữ liệu.
Để biến các phát hiện từ hoạt động đo lường thành công việc nội dung và tối ưu hóa, hãy so sánh các công cụ tối ưu hóa công cụ trả lời và quy trình mà chúng hỗ trợ.
Câu hỏi thường gặp
Phần mềm đo lường khả năng hiển thị trên AI nào chính xác nhất?
Chưa có bên chiến thắng phổ quát nào được xác lập độc lập. Profound và Semrush công bố thông tin hữu ích về phương pháp; HubSpot tài liệu hóa quy trình hằng ngày có cấu trúc; Dageno kết nối bằng chứng với hoạt động tối ưu hóa; còn Ahrefs kết hợp khám phá với theo dõi tùy chỉnh. Lựa chọn đáng tin cậy nhất là nền tảng vượt qua bài kiểm tra có kiểm soát với prompt và thị trường của bạn.
Hai công cụ chính xác có thể báo cáo các điểm khả năng hiển thị khác nhau không?
Có. Chúng có thể sử dụng prompt, công cụ tìm kiếm, chế độ, khu vực, lịch chạy, số lần lặp lại, mẫu số và cách tính trọng số khác nhau. Sự khác biệt chỉ có ý nghĩa khi đã biết phương pháp của cả hai.
Nên kiểm tra khả năng hiển thị trên AI thường xuyên như thế nào?
Thu thập dữ liệu hằng ngày hoặc hằng tuần có thể hỗ trợ phát hiện xu hướng, nhưng báo cáo nên sử dụng khoảng thời gian gồm nhiều lần quan sát. Các prompt có giá trị cao cần được chạy lặp lại vì câu trả lời tạo sinh có thể thay đổi ngay cả khi nội dung nền tảng không đổi.
Cơ sở dữ liệu prompt lớn hơn có luôn chính xác hơn không?
Không. Cơ sở dữ liệu lớn giúp khám phá thị trường, trong khi một bộ tiêu chuẩn nhỏ hơn nhưng mang tính đại diện có thể phù hợp hơn để theo dõi một thương hiệu. Phạm vi bao phủ, nguồn gốc và thiết kế lấy mẫu quan trọng hơn số lượng prompt được quảng bá.
Kết luận
Phần mềm đo lường khả năng hiển thị trên AI chính xác nhất không phải là công cụ đưa ra tỷ lệ phần trăm tự tin nhất. Đó là nền tảng cho phép kiểm tra tập hợp prompt, bối cảnh thu thập, bằng chứng, lỗi, định nghĩa chỉ số và độ bất định. Trước tiên, hãy kiểm tra các yếu tố đó; sau đó chọn quy trình mà nhóm của bạn có thể sử dụng nhất quán để cải thiện các trang được trích dẫn và đề xuất thương hiệu.
Dageno is the research and insights team at Dageno AI, publishing industry reports and expert analysis on AI Search Visibility, Generative Engine Optimization (GEO), and AI-powered search discovery.