Identifique as oportunidades de crescimento que valem a pena priorizar, considerando a demanda do mercado, o cenário competitivo, as propostas de valor da marca e as fontes de citação.
Do GSC/GA4 às Tarefas de Otimização: Como Construir um Sistema de Diagnóstico de Crescimento de Conteúdo
Uma estrutura prática para transformar dados do GSC, GA4, conhecimento de marca, referências de IA e rastreadores em tarefas acionáveis de otimização de conteúdo.
Explore mais de 12,000 nichos de mercado sem necessidade de login.
Atualizado por
10 minutos de leitura•
Atualizado em Jun 29, 2026
Nos últimos anos, uma mudança tornou-se cada vez mais evidente: as operações de conteúdo estão migrando de uma mentalidade focada em tráfego para uma mentalidade focada em crescimento (growth mindset).
À medida que a busca por IA e a distribuição de conteúdo se tornam mais complexas, apenas fazer SEO, publicar conteúdo e rastrear impressões ou cliques já não é suficiente. Espera-se agora que as equipes de conteúdo compreendam toda a jornada do usuário: como os utilizadores chegam, por que permanecem, por que não convertem e o que deve ser otimizado em cada etapa.
Em outras palavras, os cargos de conteúdo estão evoluindo gradualmente de executores de conteúdo para participantes e até designers de sistemas de crescimento.
Isso tornou-se muito claro para mim enquanto trabalhava em projetos de crescimento de conteúdo.
Métricas como impressões, cliques, rankings, status de indexação e volume de artigos ainda importam. Mas o verdadeiro impulsionador dos resultados não é se um site tem mais conteúdo. É se o conteúdo existente conecta com sucesso a demanda de busca com as ações de negócio.
Isso é especialmente verdadeiro para B2B SaaS, sites independentes, e-commerce e sites industriais. Muitas páginas não estão completamente sem tráfego. Em vez disso, o tráfego chega e não avança pelo funil. Os usuários entram via busca, mas a página não atende corretamente à sua intenção. Os usuários leem o artigo, mas não veem uma CTA. Os usuários clicam em uma CTA, mas não completam um evento-chave.
O problema não é a falta de dados. O problema é a ausência de uma cadeia de decisão que conecte:
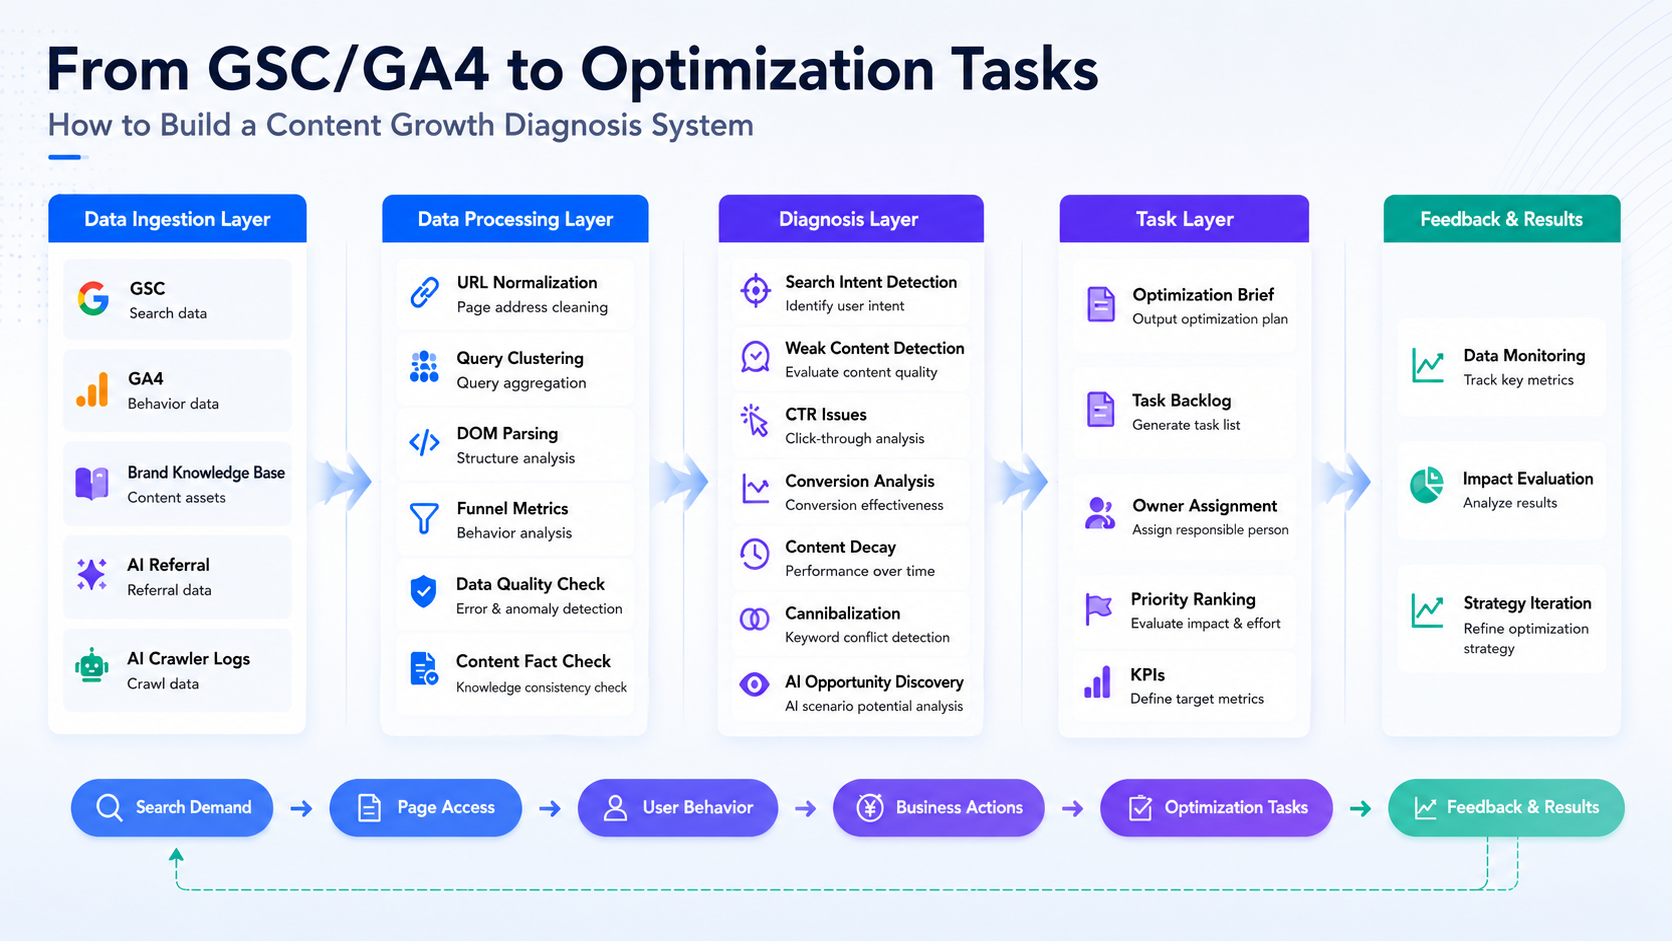
Demanda de busca → Correspondência de intenção da página → Comportamento do usuário → Ação de negócio → Tarefa de otimização → Feedback de performance
Para resolver isso, construímos um sistema interno de diagnóstico de crescimento de conteúdo e validamo-lo em múltiplos sites independentes de e-commerce, manufatura, eletrônicos de consumo e SaaS de IA.
Este sistema não é um relatório de SEO padrão. Também não é uma ferramenta que simplesmente pede à IA para gerar sugestões de otimização genéricas. Em vez disso, ele conecta GSC, GA4, a base de conhecimento da marca, referências de IA e logs de rastreadores de IA em um fluxo de trabalho de diagnóstico em nível de página.
Ele ajuda as equipes a responder às seguintes perguntas:
Quais consultas e intenções trazem os usuários para uma página?
A página corresponde e satisfaz corretamente essa intenção?
Após os usuários chegarem à página, eles leem, veem as CTAs e clicam nelas?
As informações do produto na página estão precisas?
Produtos de IA trazem visitas e os rastreadores de IA conseguem acessar a página?
Como as evidências podem ser convertidas em uma tarefa de otimização acionável?
Quais métricas devem ser rastreadas após a página ser atualizada?
O fluxo geral de dados funciona assim:
Primeiro, os dados são conectados. Em seguida, os dados de diferentes fontes são alinhados à mesma URL. Clusters de consulta são usados para identificar a intenção de busca. A análise do DOM da página é usada para determinar se o conteúdo satisfaz essa intenção. Os dados de funil do GSC e GA4 são combinados para identificar onde os usuários abandonam a página. A base de conhecimento da marca é usada para verificar fatos no conteúdo. Sinais de IA/GEO são usados para avaliar o tráfego de referência de IA e a acessibilidade dos rastreadores. Finalmente, todas as evidências são convertidas em tarefas de otimização, e a performance é rastreada continuamente após as atualizações.
Abaixo está um passo a passo do fluxo de trabalho completo.
1. Ingestão de Dados: Colocando Busca, Comportamento, Fatos e Sinais de IA em uma única cadeia
A primeira camada é a ingestão de dados. Conectamos principalmente cinco tipos de dados:
Google Search Console, ou GSC
Google Analytics 4, ou GA4
Base de conhecimento da marca
Sessões de referência de IA
Logs de rastreadores (crawlers) de IA
1.1 GSC e GA4
O GSC é responsável pela performance do lado da busca. Ele fornece impressões, cliques, CTR, posição média e performance detalhada em nível de consulta.
Por meio do GSC, o sistema pode identificar quais consultas ajudam os usuários a descobrir uma página e quais páginas ainda recebem impressões, mas começam a perder taxa de cliques (CTR).
O GA4 é responsável pelo comportamento no site. Ele fornece sessões de origem orgânica, taxa de engajamento, comportamento de rolagem (scroll), impressões de CTA, cliques em CTA, inscrições e eventos-chave.
Por meio do GA4, o sistema pode determinar se os usuários continuam lendo após chegarem à página, se veem pontos de entrada de produtos, se clicam em CTAs e se iniciam ações críticas para o negócio.
O GSC e o GA4 só se tornam poderosos quando usados juntos.
Se olharmos apenas para o GSC, só vemos o que acontece nos resultados de busca. Se olharmos apenas para o GA4, só vemos o que acontece depois que os usuários entram no site. Quando os dois são conectados, o sistema consegue identificar exatamente onde um artigo está travado.
Por exemplo:
Impressões altas, mas CTR baixo
Priorize o título, meta descrição e relevância do resultado de busca.
Cliques altos, mas engajamento baixo
Priorize a seção de abertura, sumário, estrutura da página e o alinhamento de conteúdo versus intenção.
Bom engajamento, mas cliques baixos nas CTAs
Priorize módulos de produto, copy da CTA e posicionamento da CTA.
Os cliques em CTA existem, mas os eventos-chave permanecem baixos
Continue verificando o caminho de registro, o fluxo de demonstração ou a jornada da página de destino (landing page).
1.2 Base de Conhecimento da Marca (Brand Knowledge Base)
A base de conhecimento da marca é responsável pela verificação de fatos do produto.
As equipes podem sincronizar as funcionalidades mais recentes do produto, planos de preços, versões de capturas de tela, mensagens da marca, padrões de comparação com concorrentes, respostas de FAQ e atualizações importantes do produto para dentro da base de conhecimento.
O sistema então compara o conteúdo da página com a base de conhecimento para determinar se as informações do produto em um artigo tornaram-se obsoletas.
O objetivo deste módulo é fornecer à LLM uma fonte de fatos sobre o produto que seja atualizada, unificada e confiável.
Sem uma base de conhecimento da marca, o sistema só pode inferir se o conteúdo pode estar desatualizado com base na data de publicação, termos relacionados a anos, capturas de tela ou frescor (freshness) nos SERPs. Uma vez conectada a base de conhecimento, o sistema pode gerar tarefas muito mais específicas, tais como:
Substituir capturas de tela obsoletas do produto
Corrigir descrições de planos de preços
Reescrever tabelas de comparação com concorrentes
Sincronizar as respostas mais recentes de FAQ
1.3 Referências de IA e Logs de Crawler de IA
Os dados de IA/GEO são divididos em duas categorias:
Sessões de referência de IA
Logs de crawler de IA
As sessões de referência de IA vêm do GA4. Elas mostram se produtos como ChatGPT ou Perplexity trazem tráfego real para o site e se essas visitas geram engajamento ou eventos-chave.
Os logs de crawler de IA vêm de logs de servidor, Cloudflare, logs de CDN ou logs de borda (edge logs). Eles mostram se crawlers como o GPTBot, PerplexityBot e ClaudeBot acessaram uma página, se o código de status está normal e se o acesso é afetado por regras de robots, WAF, configuração de CDN ou logs ausentes.
Esta distinção é importante:
Crawlers de IA não são fontes de tráfego do GA4.
O GA4 é adequado para medir sessões de referência provenientes de produtos de IA. O acesso de crawlers deve ser verificado por meio de logs.
Uma página pode ter sido rastreada pelo GPTBot, mas não apresentar sessões de referência do ChatGPT. Outra página já pode ter tráfego de referência do Perplexity, mas logs de crawler incompletos. Somente quando ambos os sinais são analisados em conjunto é que a equipe pode determinar se uma página precisa de mais conteúdo citável ou se a acessibilidade técnica deve ser verificada primeiro.
2. Processamento de Dados: Alinhe as URLs primeiro, depois construa evidências em nível de página
Após a conexão dos dados, o sistema não gera sugestões imediatamente. Ele primeiro processa os dados.
O objetivo da camada de processamento é transformar dados dispersos em evidências em nível de página.
2.1 Alinhamento de dados em nível de URL
O primeiro passo é o alinhamento de URL.
O GSC, o GA4 e os logs do servidor frequentemente registram os endereços das páginas de maneiras diferentes.
Por exemplo, o mesmo artigo pode aparecer no GSC como uma URL completa, no GA4 com parâmetros de rastreamento e nos logs do servidor apenas como um caminho de página (page path). Se o sistema não padronizar esses endereços primeiro, o mesmo artigo será dividido em múltiplos registros: cliques de pesquisa em um lugar, sessões no site em outro, cliques em CTA em outro lugar e acesso de crawler em uma localização adicional.
Portanto, o sistema primeiro limpa os endereços das páginas removendo parâmetros UTM, parâmetros de cliques em anúncios, âncoras de página e outros elementos que não alteram o conteúdo da página em si. Em seguida, ele mapeia o mesmo artigo para uma única URL canônica.
Somente após esta etapa as impressões, cliques, sessões, CTAs, eventos-chave e registros de crawler de IA podem ser atribuídos corretamente ao mesmo artigo.
2.2 Agrupamento de consultas (Query Clustering)
Um agrupamento de consultas (query cluster) significa agrupar consultas de pesquisa semelhantes com base na intenção do usuário.
O GSC geralmente contém um grande número de consultas fragmentadas. Se a equipe de conteúdo analisar essas consultas uma a uma, será difícil entender o que os usuários estão realmente tentando alcançar.
O sistema agrupa as consultas pela intenção de pesquisa e as rotula com tipos de intenção, tais como:
Intenção de definição
Intenção de seleção de ferramentas
Intenção de comparação
Intenção comercial
Intenção de preço
Intenção de suporte
Intenção de navegação
No futuro, isso também poderá ser mapeado para a intenção do usuário em cenários de marketing de IA e pesquisa de IA.
Isso muda a visão da equipe de milhares de palavras-chave dispersas para um número menor de necessidades do usuário.
Também é importante esclarecer o limite desta funcionalidade:
Esta não é uma atribuição precisa de consulta para conversão.
O sistema não pretende saber que uma consulta específica causou diretamente uma inscrição (sign-up) específica. Em vez disso, ele resolve o problema da correspondência entre intenção de pesquisa e conteúdo: quais necessidades do usuário trazem as pessoas para a página e se a página possui conteúdo correspondente para atender a essas necessidades.
2.3 Parsing de DOM da página
O terceiro passo é o parsing de DOM da página.
O sistema rastreia e analisa a estrutura da página, incluindo:
Título
H1
H2
H3
Seções de FAQ
Tabelas
CTAs
Links internos
Fragmentos de conteúdo do corpo
Em seguida, o sistema determina se cada grupo de consultas possui uma posição de conteúdo correspondente na página.
Por exemplo, se os usuários pesquisam consultas de comparação de ferramentas, mas a página apenas explica conceitos, sem critérios de seleção de ferramentas, tabelas comparativas ou casos de uso, o sistema pode identificar uma correspondência de intenção fraca.
2.4 Avaliação de Qualidade de Dados
Nem todos os dados são adequados para a geração automática de tarefas.
O sistema também verifica se:
Faltam dados do GSC (Google Search Console)
Faltam dados do GA4
As URLs estão mapeadas corretamente
O tamanho da amostra é suficiente
O rastreamento de eventos está completo
A base de conhecimento da marca está disponível
Os logs do rastreador de IA estão conectados
A qualidade dos dados determina diretamente o que o sistema tem permissão para fazer:
Qualidade dos Dados
Comportamento do Sistema
Alta
Gera rascunhos de tarefas
Média
Gera tarefas apenas após confirmação manual
Baixa
Exibe apenas diagnósticos, sem geração automática de tarefas
Inválida
Não julga nem gera tarefas
Esta etapa é fundamental.
Um sistema de diagnóstico de conteúdo não deve apenas saber como gerar recomendações. Ele também deve saber quando as evidências são insuficientes e a automação não deve ser utilizada.
3. Loop de Diagnóstico: Da Demanda de Pesquisa ao Mapeamento de Página, Comportamento do Usuário e Ação de Negócio
Após a conclusão do processamento de dados, o sistema entra na camada de diagnóstico.
3.1 Lado da Pesquisa: Quais Consultas e Intenções Trazem os Usuários?
O sistema analisa primeiro as consultas do GSC e os clusters de consulta.
Para a mesma página relacionada à visibilidade de IA, a intenção do usuário pode variar significativamente:
“O que é visibilidade de IA?” indica compreensão conceitual.
“Melhores ferramentas de visibilidade de IA para SaaS” indica seleção de ferramentas.
“Comparar plataformas de monitoramento GEO” indica comparação de soluções.
“Rastrear menções à marca no ChatGPT” indica um fluxo de trabalho específico.
Se uma página anteriormente atendia principalmente a consultas baseadas em definições, mas novas impressões agora vêm de consultas de seleção de ferramentas, comparação ou fluxos de trabalho, o sistema identifica que a demanda do usuário mudou.
Esta etapa responde a uma pergunta:
Qual tarefa o usuário está tentando concluir ao entrar na página?
3.2 Lado da Página: A Página Corresponde à Intenção de Pesquisa do Usuário?
Após a identificação dos clusters de consulta, o sistema analisa o DOM da página.
Diferentes intenções exigem diferentes estruturas de conteúdo:
Tipo de Intenção
Conteúdo Necessário
Intenção de definição
Definição clara, explicação e FAQ
Intenção de seleção de ferramentas
Lista de ferramentas, critérios de seleção, casos de uso e CTA
Intenção de comparação
Tabelas, preços, diferenças e casos de uso
Intenção de fluxo de trabalho
Passos, métricas, modelos e erros comuns
Intenção comercial
Módulos de produto, estudos de caso, CTA e caminho para o próximo passo
O sistema verifica se esses elementos aparecem no Título, H1, H2, FAQ, tabelas, CTAs, ou se estão ausentes.
Se um cluster de consulta tem impressões de pesquisa, mas a página cobre essa necessidade de forma superficial, o sistema marca como um gap de conteúdo, uma nova oportunidade de consulta ou uma correspondência fraca de intenção de pesquisa.
Esta etapa responde:
A página recebeu e satisfez adequadamente a necessidade do usuário?
3.3 Lado do Comportamento: Os Usuários Lêm, Veem os CTAs e Clicam?
A correspondência de conteúdo por si só não basta. Dados de comportamento do GA4 são necessários para verificar se os usuários realmente continuam a realizar ações.
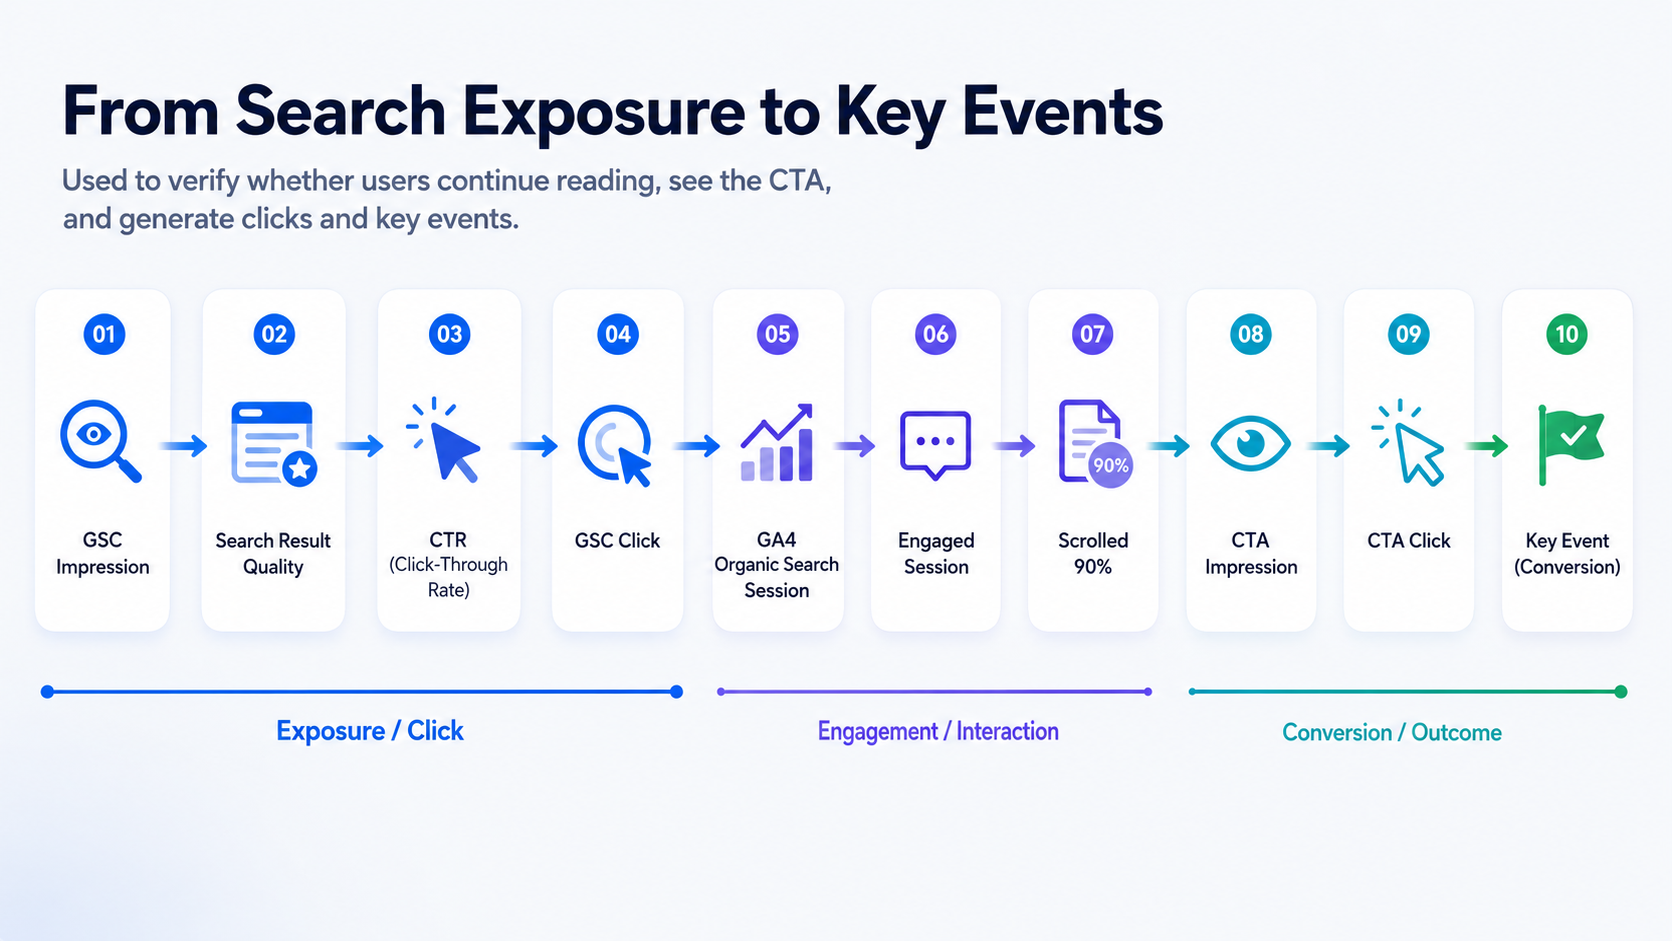
O sistema constrói um funil de página desde a exposição na pesquisa até a ação de negócio.
Esta é uma das perspectivas mais importantes no processo de diagnóstico, pois ajuda a localizar onde os usuários estão estagnados.
Por exemplo:
Se os usuários acessam a página, mas o engajamento é baixo, o problema pode estar na seção de introdução, no índice (sumário), na estrutura de conteúdo ou na experiência de carregamento da página.
Se os usuários leem a página, mas as impressões de CTA são baixas, o CTA pode estar posicionado muito abaixo (profundidade).
Se as impressões de CTA são normais, mas os cliques são baixos, o texto do CTA, o módulo do produto ou a intenção do usuário podem estar desalinhados.
Se existem cliques no CTA, mas os cliques em inscrição, demonstração ou eventos-chave são baixos, o problema pode estar no registro subsequente, na demonstração ou no caminho da landing page.
Esta etapa responde:
Os usuários estão estagnados na leitura, na exposição ao CTA, no clique ao CTA ou na conversão de negócio?
3.4 Lado dos Fatos: O Conteúdo está Desatualizado e as Informações do Produto estão Precisas?
Para conteúdo B2B SaaS, conteúdo desatualizado não é apenas uma questão de data de publicação.
Um artigo publicado no ano passado ainda pode estar preciso. Outro artigo, atualizado no mês passado, já pode conter preços, recursos, capturas de tela ou comparações com concorrentes incorretos.
A base de conhecimento da marca alinha o conteúdo da página com os fatos mais recentes do produto. O sistema verifica se:
Os recursos mencionados na página ainda existem
Os preços ainda estão atualizados
As capturas de tela estão obsoletas
As comparações de concorrentes seguem o padrão atual
As respostas do FAQ são consistentes com as respostas oficiais
Este módulo evita dois problemas comuns:
Artigos antigos continuam fornecendo aos usuários informações incorretas sobre o produto.
O LLM gera recomendações enganosas com base em conteúdo de página desatualizado.
Esta etapa responde:
As recomendações do sistema baseiam-se nos fatos mais recentes sobre o produto?
3.5 Lado da IA/GEO: As fontes de IA conseguem acessar e citar a página?
O módulo de IA/GEO realiza principalmente dois julgamentos.
Primeiro, as sessões de referência de IA mostram se os produtos de IA trazem visitas reais. Por exemplo, o sistema verifica se o ChatGPT, Perplexity e fontes similares trazem sessões, e se essas sessões geram engajamento ou eventos-chave.
Segundo, os logs de rastreadores (crawlers) de IA mostram se os rastreadores de IA conseguem acessar a página. O sistema verifica se GPTBot, PerplexityBot, ClaudeBot e rastreadores similares visitaram a página, se retornaram códigos 200, 304, 403 ou 404, se há algum motivo de bloqueio e se há logs ausentes.
Estes dois sinais determinam, em conjunto, a próxima ação:
Se a página possui referências de IA, mas conversão fraca, priorize a correspondência de conteúdo e a otimização de CTA (Call-to-Action).
Se o status do rastreador estiver anormal, priorize a verificação de regras de robots, WAF, CDN ou integração de logs.
Se o acesso do rastreador estiver normal, mas a página carecer de definições claras, etapas, FAQs e resumos em estilo de resposta, priorize o conteúdo citável.
Se as referências de IA estiverem crescendo, mas os eventos-chave forem fracos, o tráfego de IA existe, mas a correspondência de página no lado do negócio ainda precisa de melhorias.
Esta etapa responde a:
Em cenários de busca por IA e citação por LLM, o problema é tráfego, conteúdo ou visibilidade técnica?
4. Identificação do Tipo de Problema: Transforme Resultados de Diagnóstico em uma Fila de Operações
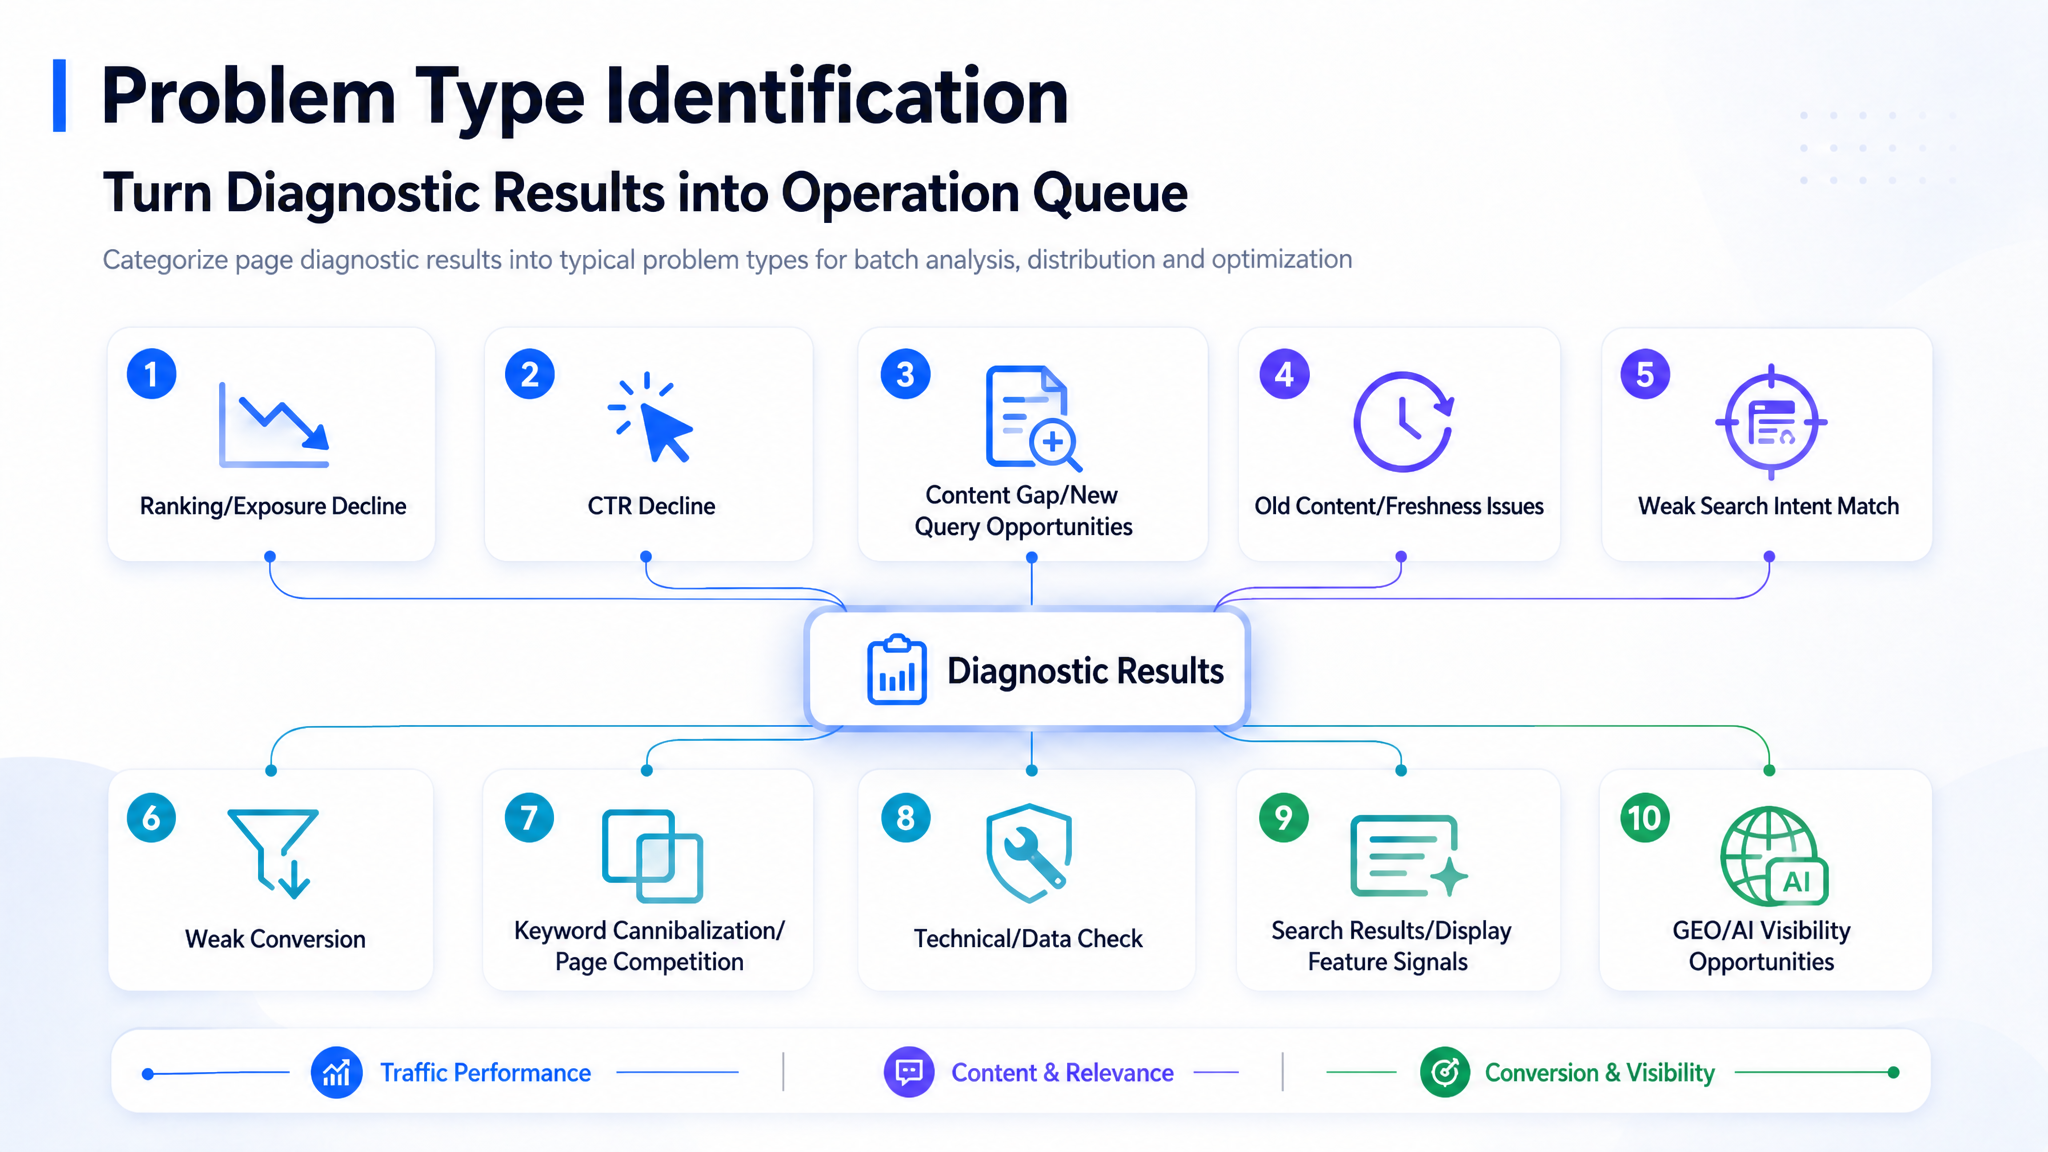
Após concluir as etapas de diagnóstico acima, o sistema atribui a cada página um tipo de problema específico.
O valor do agrupamento de problemas reside no fato de que a otimização de conteúdo torna-se uma operação em lote, em vez de uma edição única de artigo.
Os grupos de problemas comuns incluem:
Queda de tráfego
Queda de CTR
Conteúdo fraco ou baixa correspondência com a intenção de busca
Conteúdo antigo ou desatualizado
Conversão fraca
Páginas duplicadas ou concorrentes internas (cannibalization)
Oportunidades de conteúdo perdidas
Problemas técnicos ou de dados
Problemas de visibilidade GEO ou IA
O grupo de páginas não exibe apenas os nomes dos problemas. Ele também mostra:
Evidências do gatilho
Snapshot do funil da página
Principais clusters de consulta afetados
Posicionamentos de conteúdo
Qualidade dos dados
Resumo das ações recomendadas
Responsável
Status
Isso permite que os proprietários do conteúdo gerenciem o trabalho por grupo de problemas semanalmente.
Por exemplo:
Esta semana: lidar com queda de CTR.
Próxima semana: lidar com conversão fraca.
Na semana seguinte: lidar com conteúdo desatualizado e canibalização de páginas.
A equipe não edita mais aleatoriamente qualquer página que pareça problemática. Em vez disso, eles podem avançar no trabalho de otimização por tipo de problema e prioridade.
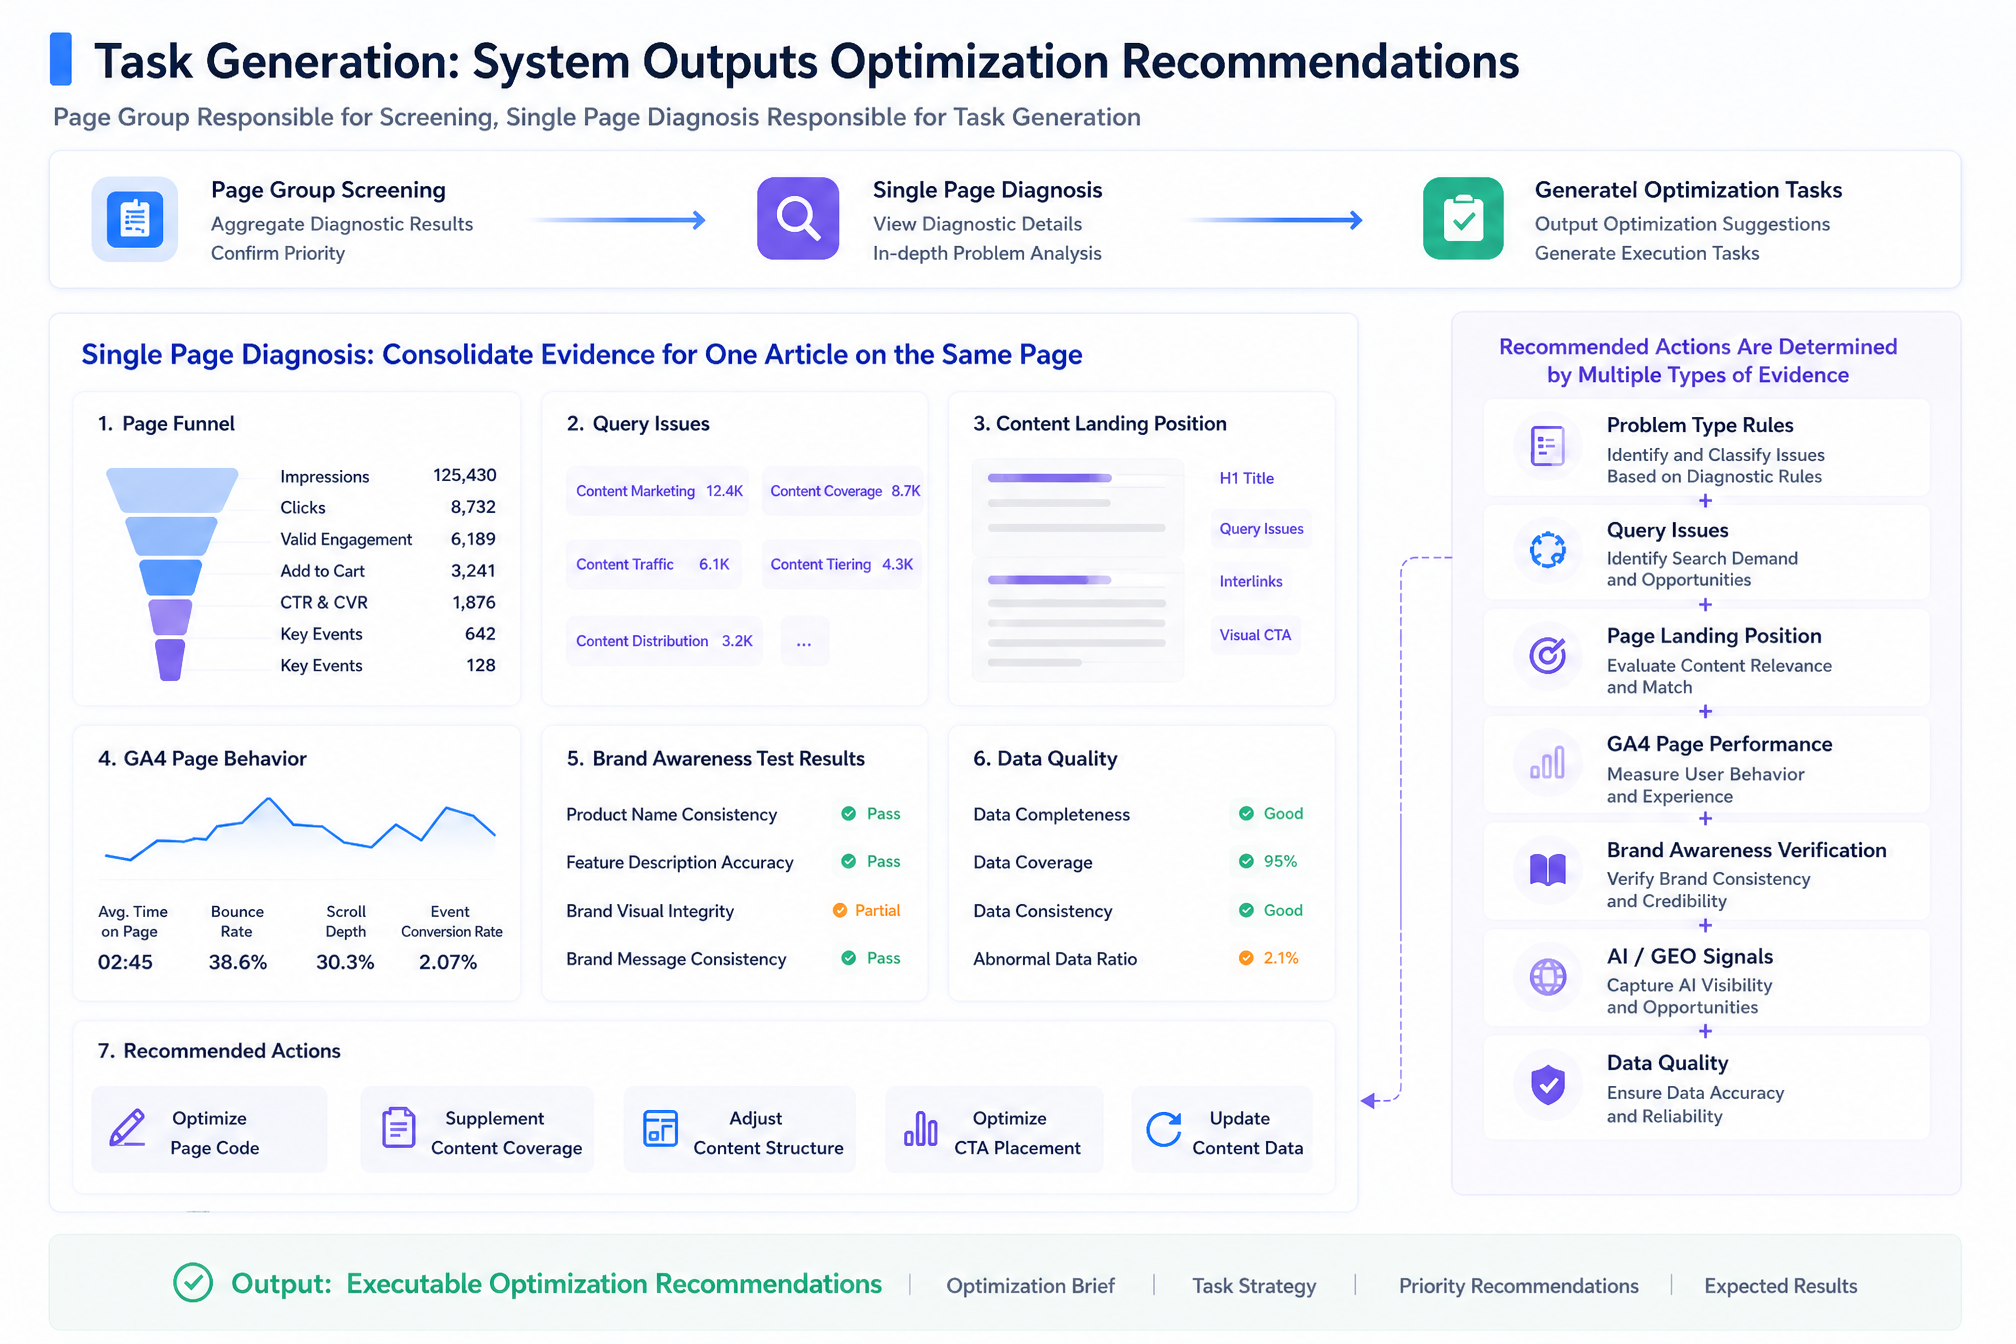
5. Geração de Tarefas: O Sistema Emite Recomendações de Otimização
Os grupos de páginas são usados para filtragem. Os diagnósticos de página única são usados para a geração de tarefas.
Ao entrar em uma visualização de diagnóstico de página única, o sistema coloca todas as evidências de um artigo em uma página:
Funil de página
Clusters de consulta
Posicionamentos de correspondência de conteúdo
Comportamento da página no GA4
Resultados da verificação da base de conhecimento da marca
Qualidade dos dados
Ações recomendadas
As ações recomendadas são determinadas principalmente por uma combinação de tipos de evidência:
textCopy
Regras de tipo de problema
+ Clusters de consulta
+ Posicionamentos de correspondência de conteúdo da página
+ Performance da página no GA4
+ Verificação da base de conhecimento da marca
+ Sinais de IA/GEO
+ Qualidade dos dados
O output não é uma sugestão vaga como “otimize este artigo”. Deve ser uma tarefa que explique claramente:
Por que esta página precisa ser atualizada
Qual parte da página apresenta um problema
O que deve ser alterado
Quem deve se responsabilizar pela tarefa
Quais métricas devem ser verificadas após a atualização
6. Exemplo: Como a Cadeia de Diagnóstico Completa funciona em uma página
O GSC mostra que esta página está começando a receber impressões de consultas relacionadas a “ferramentas de rastreamento de menções de IA”.
Se olharmos apenas para o GSC, podemos ver que há demanda de busca, mas ainda não conseguimos determinar se a página satisfaz essa demanda.
Etapa 2: O agrupamento de consultas identifica a intenção de seleção de ferramentas
O sistema agrupa essas consultas em um cluster de intenção de seleção de ferramentas.
Isso significa que os usuários não estão apenas tentando entender um conceito. Eles estão procurando uma categoria de ferramentas, comparando capacidades de ferramentas e podem até estar prontos para iniciar um teste ou processo de compra.
Etapa 3: A análise de DOM encontra baixa correspondência de intenção
O sistema analisa o DOM da página e descobre que a seção inicial e a estrutura de H2 ainda explicam, principalmente, o conceito.
A página não fornece critérios claros de seleção de ferramentas, dimensões de comparação ou casos de uso.
Em outras palavras, a intenção do lado da busca mudou para a seleção de ferramentas, mas a página ainda se comporta como um artigo de explicação de conceitos.
Passo 4: O GA4 adiciona evidências comportamentais
O GA4 mostra que a página tem um engajamento relativamente alto, mas cliques baixos no CTA.
Isso significa que os usuários estão dispostos a ler, mas a página não os direciona de forma fluida para uma ação relacionada ao produto.
Passo 5: A base de conhecimento da marca verifica fatos sobre o produto
A base de conhecimento da marca identifica que as capturas de tela do produto na página estão desatualizadas e que algumas descrições de recursos não foram atualizadas para a versão mais recente.
Se isso não for corrigido, o LLM poderá continuar usando informações obsoletas do produto ao gerar recomendações de otimização.
Passo 6: Logs de rastreamento de IA verificam a acessibilidade técnica
Os logs de rastreamento (crawler logs) de IA mostram que o GPTBot consegue rastrear a página normalmente.
Isso significa que o problema prioritário não é a rastreabilidade técnica. Os pontos mais urgentes são: se o conteúdo é citável o suficiente, se as informações do produto estão precisas e se o CTA está alinhado com usuários que buscam a seleção de ferramentas.
Rascunho da Tarefa Final
O sistema gera um rascunho de tarefa como este:
markdownCopy
Página: /blog/top-tools-to-track-ai-mentions-in-llms

Tipo de Problema:
- Correspondência de intenção de busca fraca
- Conversão fraca
- Conteúdo desatualizado

Evidências de Gatilho:
- Consultas de seleção de ferramentas possuem impressões de busca
- A introdução e a estrutura H2 ainda focam na explicação de conceitos
- O engajamento é alto, mas os cliques no CTA são baixos
- A base de conhecimento da marca encontrou capturas de tela do produto desatualizadas
- O rastreamento do GPTBot está normal

Ações Recomendadas:
- Adicionar um módulo de critérios de seleção de ferramentas
- Adicionar uma tabela de comparação de ferramentas
- Atualizar as capturas de tela do produto
- Alterar o CTA genérico de inscrição para "Ver Solução de Monitoramento de Menções em IA"
- Adicionar conteúdo de FAQ
- Adicionar conteúdo passo a passo que seja mais fácil de ser citado por LLMs

Métricas a acompanhar após a atualização:
- CTR
- Sessões de busca orgânica
- Cliques no CTA
- Cliques em demonstração
- Principais eventos (Key events)
- Referências de IA
- Status do rastreamento
Dessa forma, um artigo deixa de ter um "desempenho de dados pouco claro" para se tornar uma tarefa concreta.
A equipe sabe:
Por que o artigo precisa ser alterado
Onde está o problema
O que precisa ser atualizado
Quem deve lidar com isso
Quais métricas devem ser revisadas posteriormente
7. Monitoramento e Revisão de Desempenho
Um verdadeiro ciclo de crescimento de conteúdo também precisa retroalimentar o sistema com dados de desempenho após a atualização de um artigo.
A versão atual já consegue executar o fluxo de trabalho principal, desde a ingestão de dados até o diagnóstico da página e a geração do rascunho da tarefa.
O próximo estágio é adicionar o acompanhamento de desempenho pós-execução, conectando cada atualização de conteúdo às alterações subsequentes nas métricas.
O sistema registrará:
Data de geração da tarefa
Módulos atualizados
Data de publicação
Responsável
Status da tarefa
Dados de desempenho de acompanhamento
Isso permite que as equipes avaliem se cada ação de otimização realmente gera resultados.
8. O que ainda precisa ser construído
Neste ponto, o sistema já consegue executar a cadeia de diagnóstico principal. No entanto, várias capacidades ainda precisam ser aprimoradas.
8.1 Agrupamento de intenção de consulta (Query Intent Clustering)
A versão atual depende principalmente da similaridade de texto e de julgamentos baseados em regras. Em setores verticais, isso já cobre a maioria das consultas comuns.
No entanto, consultas de cauda longa (long-tail), termos emergentes e consultas semanticamente semelhantes, mas com intenções diferentes, ainda podem ser agrupadas incorretamente.
No futuro, o sistema combinará correspondência de palavras-chave e julgamento baseado em LLM para classificar grupos de consulta com mais precisão.
Para clusters de intenção com baixa confiança, o sistema os marcará automaticamente como "confirmação manual necessária", evitando que tarefas incorretas sejam geradas quando as evidências forem insuficientes.
8.2 Atualizações automáticas da base de conhecimento da marca
A base de conhecimento atual da marca ainda é mantida principalmente por importação manual. Isso funciona bem para centralizar informações essenciais, como recursos do produto, preços, capturas de tela, respostas de FAQ e padrões de mensagem da concorrência.
Mas, a longo prazo, a base de conhecimento não pode depender apenas da manutenção manual.
O próximo passo é conectar logs de mudanças do produto (changelogs), dados de CMS ou fontes de documentação interna, para que a versão da base de conhecimento seja atualizada automaticamente conforme o produto evolui.
Isso tornará as verificações de conteúdo desatualizado menos dependentes de revisão manual. O sistema também será capaz de identificar mais rapidamente recursos obsoletos, capturas de tela antigas, preços incorretos e descrições de produtos que não condizem mais com a comunicação atual.
8.3 Acompanhamento de desempenho
O sistema já pode determinar qual artigo deve ser atualizado, por que deve ser atualizado, onde deve ser alterado e como gerar uma tarefa de otimização fundamentada em evidências.
O próximo passo é adicionar o acompanhamento de desempenho após a execução da tarefa e conectar cada atualização de conteúdo às mudanças posteriores nas métricas.
Uma vez concluído, as equipes de conteúdo poderão entender:
Se uma otimização realmente gerou crescimento
Quais tipos de atualizações são mais eficazes
Quais páginas ainda precisam de iteração adicional
Conclusão
O objetivo deste sistema de diagnóstico de crescimento de conteúdo não é fornecer apenas mais um relatório de SEO.
O seu objetivo é transformar a otimização de tráfego orgânico num processo que seja:
Executável
Rastreável
Revisável
Conectado aos resultados de negócio
Ele conecta dados de pesquisa, conteúdo da página, comportamento do usuário, fatos sobre a marca, visibilidade em IA/GEO, tarefas de otimização e feedback de performance em um ciclo fechado.
Como resultado, a equipe de conteúdo deixa de receber instruções vagas como "otimize o artigo".
Em vez disso, eles podem entender claramente:
Por que a página precisa ser alterada
Onde está o problema
O que deve ser atualizado
Quem deve executar a tarefa
Quais métricas devem ser verificadas após a atualização
Se você também está criando um site independente para mercados externos, com foco em crescimento de conteúdo ou pesquisa por IA, e gostaria de discutir esta solução ou saber mais sobre os detalhes de implementação do sistema, você pode adicionar o WeChat: dudulhc.
Dageno is the research and insights team at Dageno AI, publishing industry reports and expert analysis on AI Search Visibility, Generative Engine Optimization (GEO), and AI-powered search discovery.