Identifique as oportunidades de crescimento que valem a pena priorizar, considerando a demanda do mercado, o cenário competitivo, as propostas de valor da marca e as fontes de citação.
Como as perguntas de compra feitas à IA variam entre mercados
No teste da FTA Global, em média 2,9 das cinco marcas mais recomendadas pela IA mudaram fora da referência "Nova York + inglês". Este artigo detalha quatro formas como as perguntas de compra feitas à IA variam entre mercados (onde as pessoas perguntam, condições locais, fontes citadas e marcas recomendadas) e apresenta um método em cinco etapas para compará-las.
Neste artigo, "perguntas de compra feitas à IA" são as perguntas de compra, comparação e preço que as pessoas fazem ao ChatGPT, ao Gemini, ao Google AI Mode e a outras ferramentas de IA.
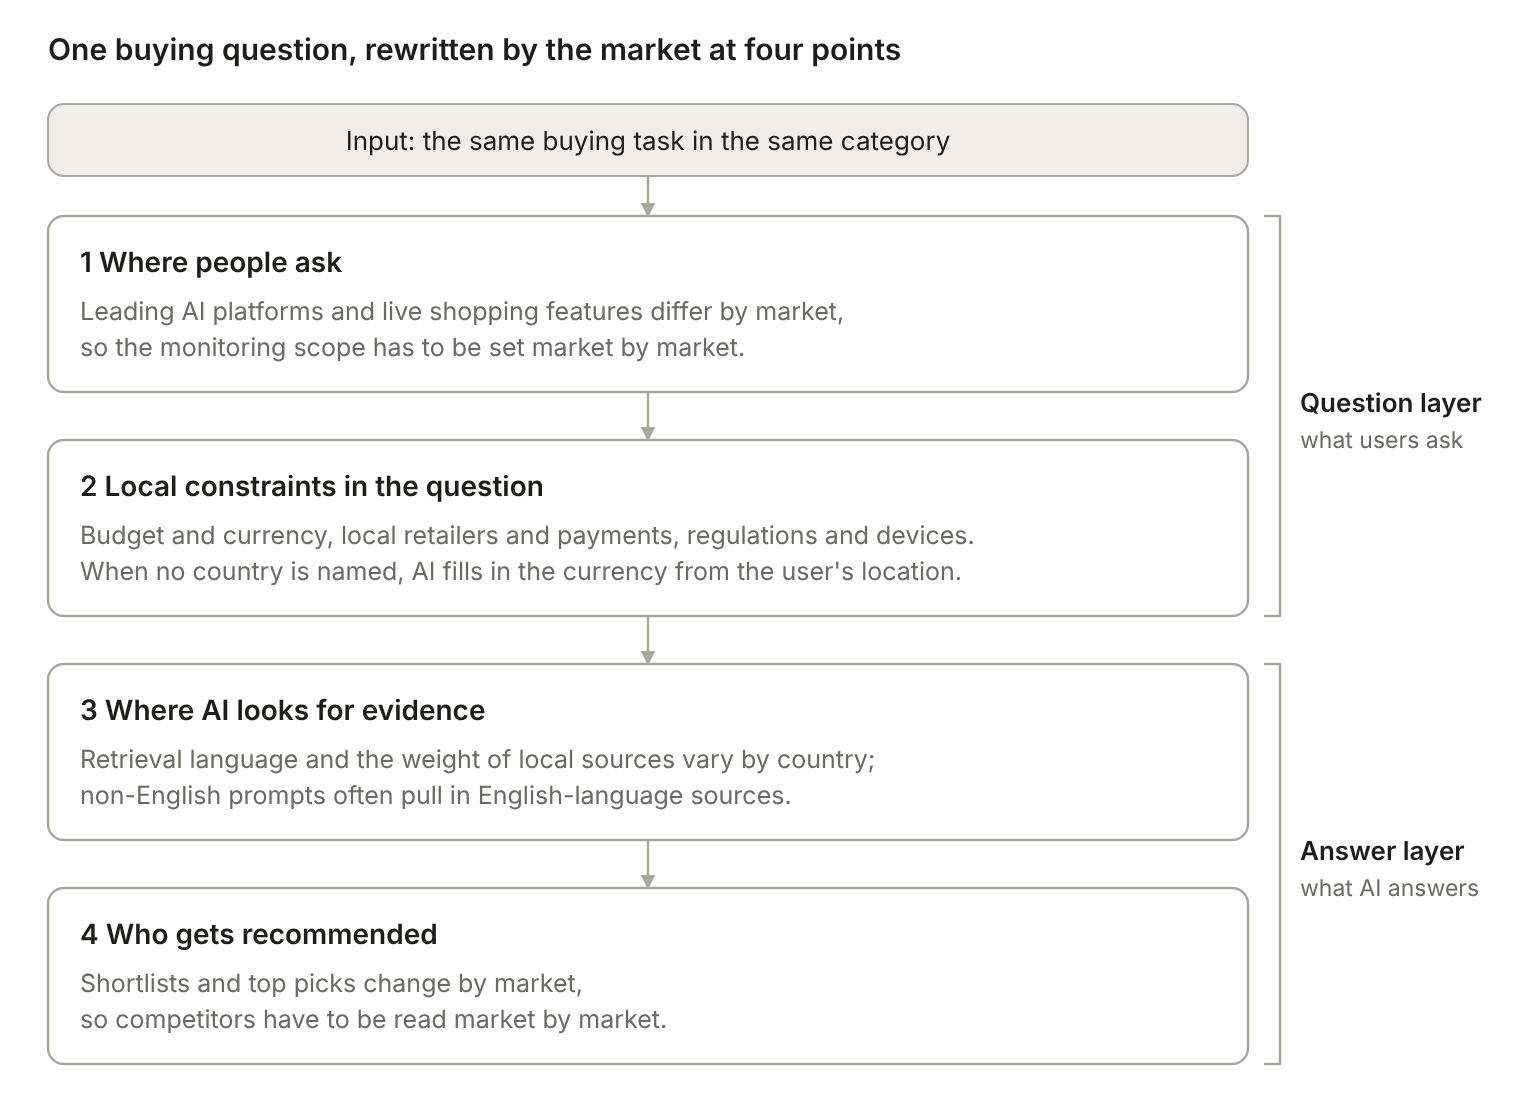
A mesma pergunta de compra, na mesma categoria, muda em pelo menos quatro pontos quando você passa para outro país, região ou mercado de idioma: a qual IA as pessoas perguntam, que condições locais a pergunta traz, onde a IA busca evidências e quais marcas ela acaba recomendando.
Testes públicos mostram que a diferença é grande. A FTA Global testou 10 categorias de software no ChatGPT e no Gemini: fora da referência "Nova York + inglês", em média 2,9 das cinco marcas mais recomendadas mudaram. Em outro teste com cinco idiomas, a easyJet foi a primeira escolha em 72,5% das respostas em russo, mas em só 12,5% das respostas em persa.
Um alerta logo de início (isto é um julgamento nosso): a maior parte das pesquisas públicas mede que respostas a mesma pergunta recebe em mercados diferentes. Pouquíssimas medem como as pessoas de cada mercado realmente perguntam. Para isso, é preciso ter amostras reais de perguntas no idioma local; traduzir prompts em inglês não resolve.
Na prática, trate "país × idioma × plataforma" como uma unidade de comparação. Colete amostras repetidas de cada unidade com um conjunto de perguntas localizado e compare em quatro dimensões. Quando encontrar uma diferença, explique-a primeiro com preços locais, disponibilidade e fontes citadas, e só depois decida se vai mudar o conteúdo.
Por que as perguntas de compra feitas à IA na mesma categoria variam por mercado
Aqui, "mercado" são três variáveis sobrepostas: o país ou a região do usuário, o idioma da pergunta e a plataforma de IA. Se qualquer uma delas mudar, a mesma pergunta de compra pode receber outra resposta. O Reino Unido e os EUA compartilham o idioma, enquanto a Índia mistura inglês, hindi e hinglish, então país e idioma precisam ser registrados separadamente.
Só a localização já pode reescrever uma resposta. Em um teste publicado em outubro de 2026, a Massive enviou ao ChatGPT o mesmo prompt pedindo "o preço típico de uma xícara de café em uma cafeteria" a partir dos Estados Unidos, do Brasil e do Japão ao mesmo tempo. O prompt não citava nenhum país. A resposta dos EUA citou dólares, enquanto as do Brasil e do Japão acrescentaram preços em reais e ienes. Cada país foi testado uma única vez, então o teste mostra que o efeito existe, não com que frequência ele acontece.
Mantenha duas camadas separadas na análise. A camada da pergunta é o que os usuários perguntaram e que condições incluíram. A camada da resposta é quais fontes a IA usou e quais marcas recomendou. Quando uma marca "some" em um mercado, pode ser que os usuários locais estejam simplesmente fazendo outra pergunta, ou que as fontes e preferências da IA tenham mudado. As quatro seções a seguir seguem essa ordem.
Quatro camadas de diferença, tratadas nas quatro seções abaixo.
Diferença 1: a IA a que as pessoas perguntam varia por mercado
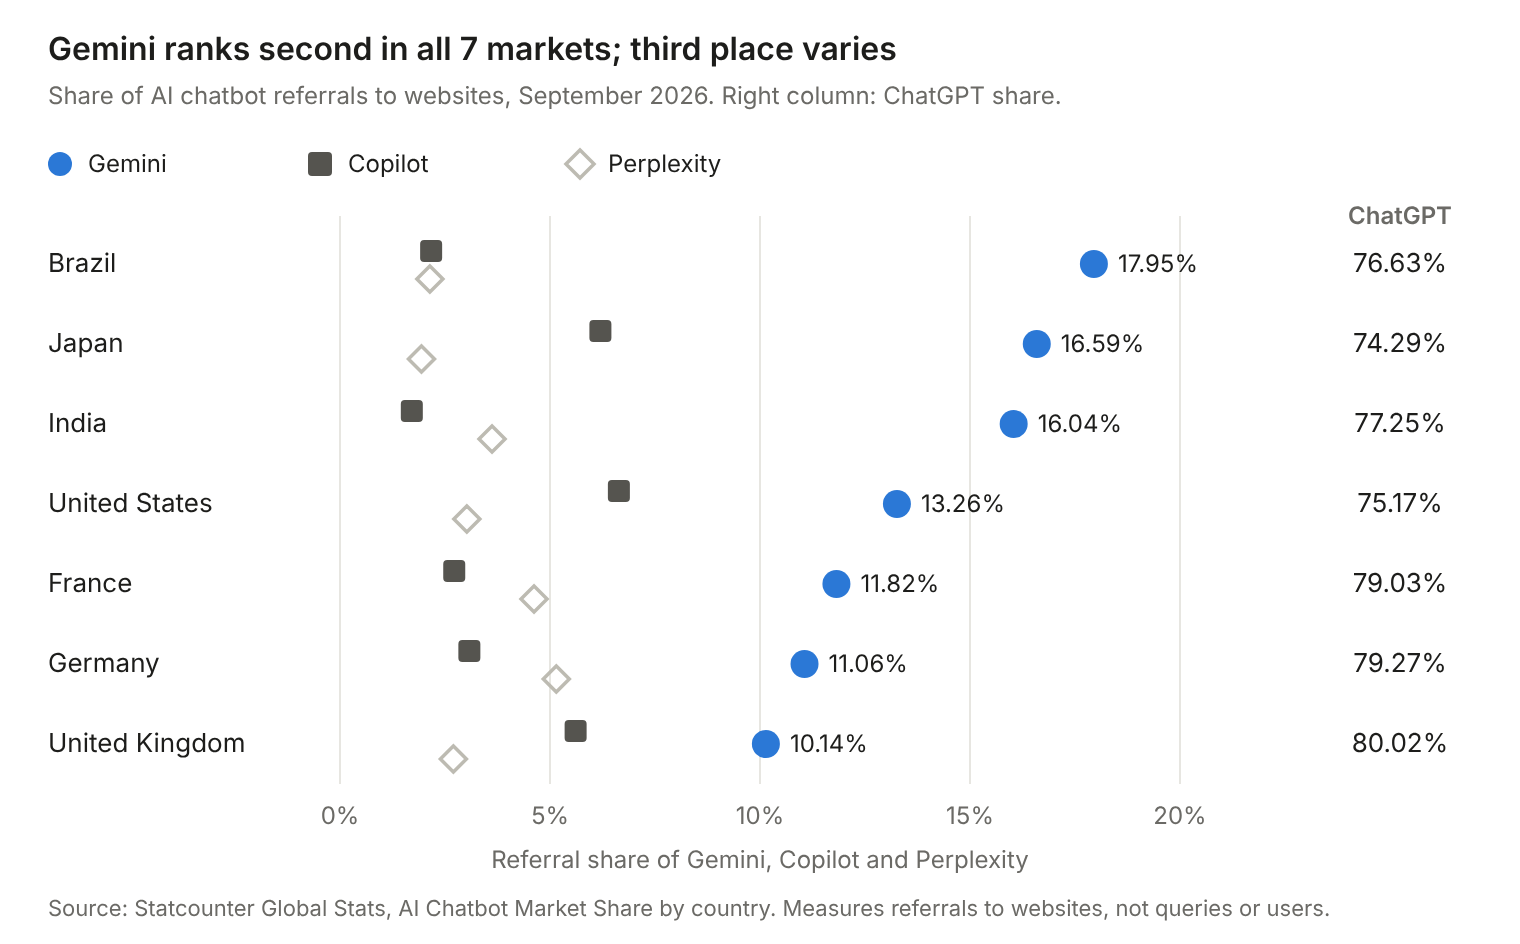
O ChatGPT lidera em todos os principais mercados internacionais, mas a ordem logo atrás muda. Os dados de setembro de 2026 da Statcounter colocam o ChatGPT em cerca de 74%–80% em cada um dos sete mercados abaixo. O Gemini passa de 16% no Brasil, no Japão e na Índia, mas fica em cerca de 10% no Reino Unido. O Copilot passa de 6% nos EUA e no Japão, mas fica abaixo de 2% na Índia. O Perplexity é mais alto na Alemanha e na França do que nos outros mercados mostrados.
Fonte: Statcounter Global Stats, participação nas visitas vindas de chatbots de IA, setembro de 2026, sete mercados.
Atenção à métrica. A Statcounter mede a participação de cada chatbot nas visitas enviadas a sites (com base nas visualizações de página dos sites que acompanha). Não é uma contagem de perguntas nem de usuários, e exclui o Grok, que não repassa dados de origem. Ela mostra quais plataformas levam pessoas a sites em um mercado; não serve para estimar o volume de perguntas de compra.
Dados de pesquisa apontam na mesma direção. Uma pesquisa do World Retail Congress encomendada pela Vercel (maio de 2026, 4.000 consumidores europeus), divulgada pela Pygmalios, mostrou que 49% dos entrevistados do Sul da Europa usam o ChatGPT ao fazer compras, contra 40% nos países nórdicos, 38% na Alemanha e 33% no Reino Unido. Metade dos entrevistados do Reino Unido não usa nenhuma busca por IA ao comprar, contra 32% no Sul da Europa. Os números são autodeclarados, Sul da Europa e países nórdicos são grupos que reúnem vários países, e a própria Pygmalios alerta que "intenções declaradas costumam superestimar o comportamento observado".
A ordem de lançamento dos recursos também cria diferenças. Quando a OpenAI lançou o Instant Checkout dentro do ChatGPT, em 29 de setembro de 2025, ele estava disponível só para usuários dos EUA, e os únicos lojistas eram vendedores americanos do Etsy. Um pedido do tipo "compre para mim" podia ser concluído dentro do chat nos mercados com checkout, mas nos demais só podia mandar o usuário para um site externo. Não verificamos quais mercados o recurso cobre em outubro de 2026; confira isso à parte antes de comparar mercados.
Diferença 2: as perguntas de compra trazem condições locais diferentes
Mesmo quando a pergunta é "qual devo escolher", cada mercado acrescenta condições diferentes. Algumas estão escritas na pergunta; outras são preenchidas a partir da localização do usuário.
Condições escritas na pergunta: orçamento em moeda local, plataformas de varejo locais, formas de pagamento e entrega, regulamentações locais ou exigências fiscais. Pagamentos são um exemplo claro. No teste da FTA Global, a Stripe ficou em primeiro em Nova York, Londres, Madri, Paris e Berlim, mas não entrou no top 5 em Mumbai, Délhi ou Bengaluru. Com um ecossistema de pagamentos local diferente, "qual ferramenta de pagamento uma pequena empresa deve usar" vira, na prática, outra pergunta.
Condições preenchidas pela localização: mesmo quando o usuário não cita país nenhum, a IA deduz moeda e regras pela localização, como mostra o teste do café acima. Ao comparar mercados, registre onde cada resposta foi coletada.
Até onde a pergunta avança na jornada de compra: na pesquisa da Deloitte de maio de 2026 com 13.500 consumidores de 15 países europeus, 42% dos entrevistados na Espanha estavam dispostos a deixar a IA tomar decisões de compra por eles, contra 27% na Finlândia. Em mercados em que mais pessoas delegam a decisão à IA, perguntas como "escolha uma para mim" ou "me dê a melhor opção" podem ser mais comuns. É uma hipótese a testar com amostras de perguntas locais.
Nem toda necessidade varia por mercado. Na pesquisa do World Retail Congress citada acima, comparar preços foi o uso mais comum entre quem compra com IA em todas as regiões (51%–55%). Nosso julgamento: a ação na pergunta é parecida entre mercados, e as diferenças ficam principalmente nas faixas de orçamento, nos canais disponíveis e nas regras locais. Por isso, ao organizar as perguntas, dê colunas próprias a orçamento e moeda, plataformas citadas, pagamento e entrega, regulamentação e condições de dispositivo.
Diferença 3: a IA cita fontes diferentes, e os usuários confiam de forma diferente na IA
Nas perguntas de compra de mercados que não falam inglês, boa parte das evidências ainda vem de páginas em inglês. A Peec AI analisou mais de 10 milhões de prompts do ChatGPT e mais de 20 milhões de buscas em segundo plano (query fan-outs), mantendo só as sessões em que a localização do usuário correspondia ao idioma do prompt. Quase 78% das sessões em outros idiomas acrescentaram pesquisa em inglês, e 43% dos fan-outs de prompts em outros idiomas foram feitos em inglês. Por idioma, as sessões em turco foram as que mais acrescentaram pesquisa em inglês (94%) e as em espanhol, as que menos acrescentaram (66%).
O peso das fontes locais também varia por país. No teste da FTA Global, domínios e publicações locais representaram 42% das fontes citadas na Alemanha, 34% na França e 17% na Índia. Onde as fontes locais pesam menos, marcas locais talvez precisem de cobertura em sites em inglês ou internacionais para entrar nas respostas. Os testes manuais da Peec AI trazem um exemplo: ao perguntar em polonês, a partir de um IP polonês, quais são os melhores sites de leilão, o ChatGPT deixou de fora o Allegro, principal plataforma local da Polônia, ou o colocou bem no fim da lista. É um exemplo isolado, não um resultado estatístico.
A confiança nas respostas da IA também muda. Na mesma pesquisa da Deloitte, 61% dos entrevistados na Espanha disseram confiar nas informações dadas pela IA, contra 36% na Finlândia. Nossa hipótese: em mercados com menos confiança, os usuários tendem a checar mais fontes, avaliações e garantias de pós-venda, então materiais verificáveis localmente pesam mais. Ainda não há dados públicos que testem isso diretamente.
Diferença 4: mudam as marcas recomendadas e os concorrentes
Somando as três primeiras diferenças, os usuários acabam vendo listas curtas diferentes. Usando "Nova York + inglês" como referência, a FTA Global repetiu as mesmas perguntas de compra de pequenas empresas em Londres, Madri, Paris, Berlim e três cidades indianas:
Em média, 2,9 das cinco marcas mais recomendadas mudaram.
As mudanças se concentraram em categorias ligadas a dinheiro e conformidade: folha de pagamento, contabilidade, pagamentos e RH tiveram em média 4,4 marcas trocadas, enquanto gestão de projetos, videoconferência e armazenamento em nuvem tiveram só 1,5.
Das 206 marcas no total, 159 entraram no top 5 em apenas um local.
O idioma também muda a primeira escolha. Um teste de Reza Moaiandin, cofundador da SALT.agency, publicado no Search Engine Journal, fez o mesmo conjunto de perguntas de compra em inglês, árabe, russo, chinês simplificado e persa. O teste principal usou o Claude Sonnet 5 com a busca na web desligada, com coleta em 7 de setembro de 2026 e 40 execuções por par de cenário e idioma. A tabela mostra a porcentagem de respostas em que cada marca foi a primeira escolha:
Cenário
Marca
Maior porcentagem
Menor porcentagem
Voo de ida e volta Londres–Tenerife
easyJet
Russo 72,5%
Persa 12,5%
Fones com cancelamento de ruído abaixo de £400
Sony
Russo e persa 100%
Inglês 50%
CRM para uma pequena empresa do Reino Unido
HubSpot CRM
Inglês 22,5%
Árabe 2,5%
Robô aspirador abaixo de £500
Roborock
Russo 97,5%
Inglês e árabe 87,5%
A linha do robô aspirador mostra que nem toda categoria oscila muito. No mesmo teste, ao ligar a busca na web para duas das categorias, a primeira escolha mudou em 7 de 10 pares de categoria e idioma. Nessas mesmas duas categorias, com a busca desligada, a primeira escolha do ChatGPT coincidiu com a do Claude em só 1 de 10 pares, e com a do Gemini em 5. O autor observa que os dados foram coletados em uma única tarde e que os resultados indicam uma direção.
Pesquisas acadêmicas observam uma tendência parecida. O artigo "Global is Good, Local is Bad?", da EMNLP 2024, mostrou que os LLMs associam com mais frequência atributos positivos a marcas globais e recomendam de forma desproporcional presentes de luxo a pessoas de países de alta renda, embora o efeito do país de origem possa favorecer marcas locais em contextos específicos. Para as marcas, isso significa que os concorrentes variam por mercado: as marcas que você enfrenta diretamente nos EUA podem ser substituídas por outro conjunto de marcas locais na Índia ou na Polônia.
Como comparar perguntas de compra entre mercados de forma sistemática
Trate "país ou região × idioma × plataforma" como a menor unidade de comparação e siga cinco etapas.
Defina as unidades de comparação: registre o país ou a região, o idioma e a plataforma de cada unidade. Separe por idioma os países multilíngues, por exemplo inglês e hindi na Índia, ou inglês e francês no Canadá.
Monte um conjunto de perguntas localizado: colete formulações reais de fontes locais, como sugestões de busca locais, fóruns e registros de atendimento e vendas, e peça revisão a um falante nativo. Mantenha um conjunto de tarefas de compra comum a todos os mercados para comparação e acrescente as perguntas exclusivas de cada mercado.
Fixe as condições e colete amostras repetidas: use a mesma janela de tempo, o mesmo modelo e as mesmas configurações de busca, e repita cada condição várias vezes. A FTA Global executou cada condição 5 vezes; o teste da SALT, 40. Registre o local da coleta e o estado da conta.
Compare em quatro dimensões: veja a tabela abaixo.
Explique as diferenças com fatos locais: verifique primeiro preços locais, disponibilidade, canais e regulamentação, e depois decida se vai criar conteúdo localizado, atualizar uma página compartilhada ou continuar observando.
Dimensão
O que registrar em cada mercado
Erro de leitura comum
Onde as pessoas perguntam
Principais plataformas de IA locais; se há cartões de compra, checkout e recursos parecidos
Testar só o ChatGPT, só em inglês dos EUA
Condições da pergunta
Texto original da pergunta; orçamento e moeda; plataformas, pagamentos, entrega, regulamentação e dispositivos citados
Tratar uma pergunta em inglês traduzida como pergunta local
Fontes de evidência
URLs citadas, idioma da fonte, sites locais ou internacionais
Contar domínios sem ler as fontes
Recomendações
Primeira escolha, lista do top 5, se sua marca aparece e em que contexto
Deixar um único print representar todo o mercado
Comparando perguntas de compra entre mercados internacionais com o Dageno
As quatro dimensões acima correspondem a vários recursos do Dageno:
Cross-Model and Regional Benchmarking: compara a visibilidade, a posição e os principais concorrentes da sua marca entre modelos de IA e regiões, para que uma média não esconda onde sua posição muda.
Regional Comparison: reúne em uma única visão revisável as respostas de IA observáveis, o contexto competitivo e as fontes visíveis de diferentes mercados e idiomas.
AI Search Intents: agrupa os prompts do mercado por intenção; para cada grupo, você pode ver quais marcas as respostas mencionam e quais páginas citam.
Se o objetivo é escolher o próximo mercado, a solução de expansão de mercado encadeia esses módulos em três verificações: comparar mercados, entender cada mercado e escolher o que verificar.
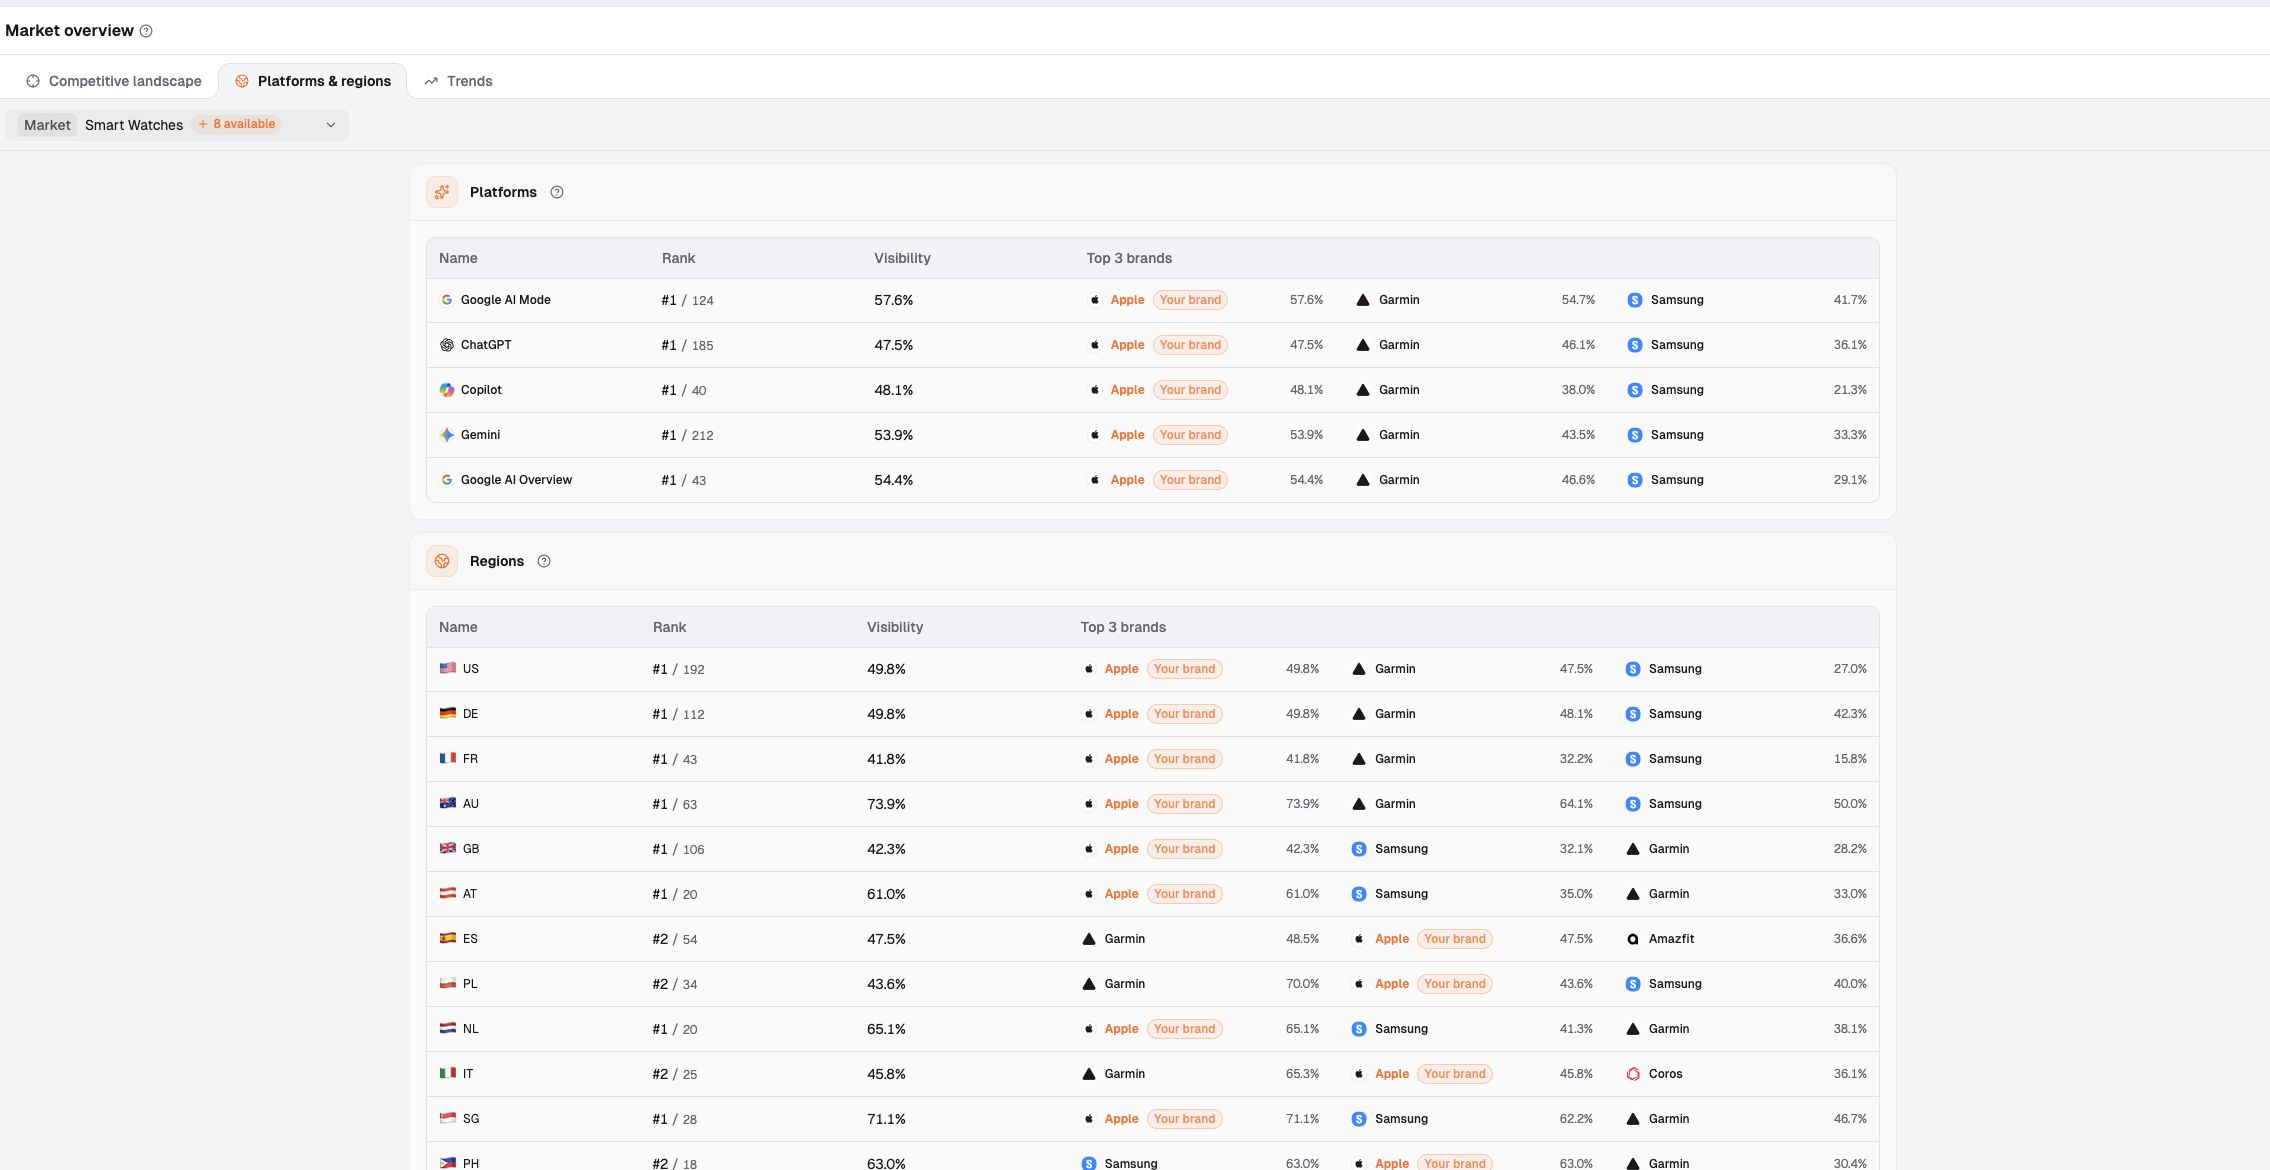
Tome como exemplo o mercado de smartwatches em um workspace de demonstração do Dageno (a Apple é só a marca de exemplo e não é cliente do Dageno). A tabela de regiões em "Market overview → Platforms & regions" mostra a Apple em 1º na maioria dos mercados, mas em 2º na Espanha, na Polônia e na Itália, onde a Garmin lidera.
Figura 1: um mercado de smartwatches, com posição e visibilidade da marca divididas por plataforma de IA e região.
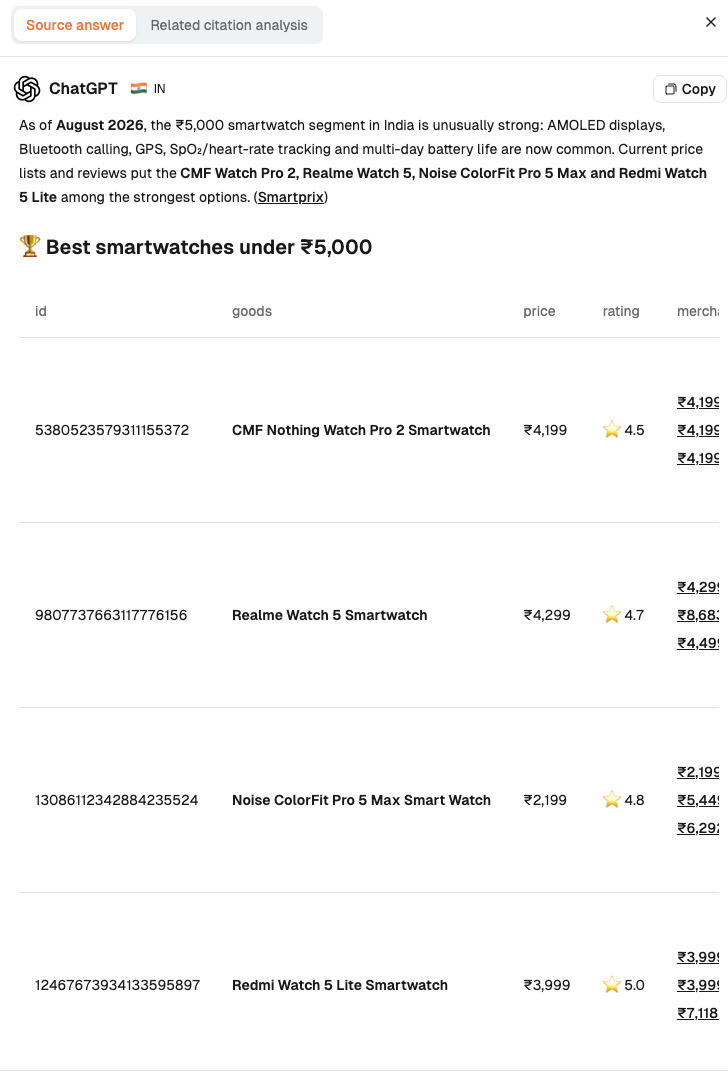
A tabela de regiões só indica onde olhar primeiro; para ver as próprias perguntas, é preciso abrir as respostas. No estudo de caso publicado pelo Dageno, Visibilidade na IA por região: quando localizar páginas, a Apple está em 14º na Índia, com 4,76% de visibilidade. Lendo as respostas, vê-se que as duas respostas da Índia recomendam relógios abaixo de ₹5.000, enquanto o site da Apple na Índia mostrava o Apple Watch SE 3 a partir de ₹29.900 (verificado em 30 de setembro de 2026, segundo o estudo de caso).
Figura 2: resposta do ChatGPT para a Índia (IN), com a pergunta limitada a menos de ₹5.000.
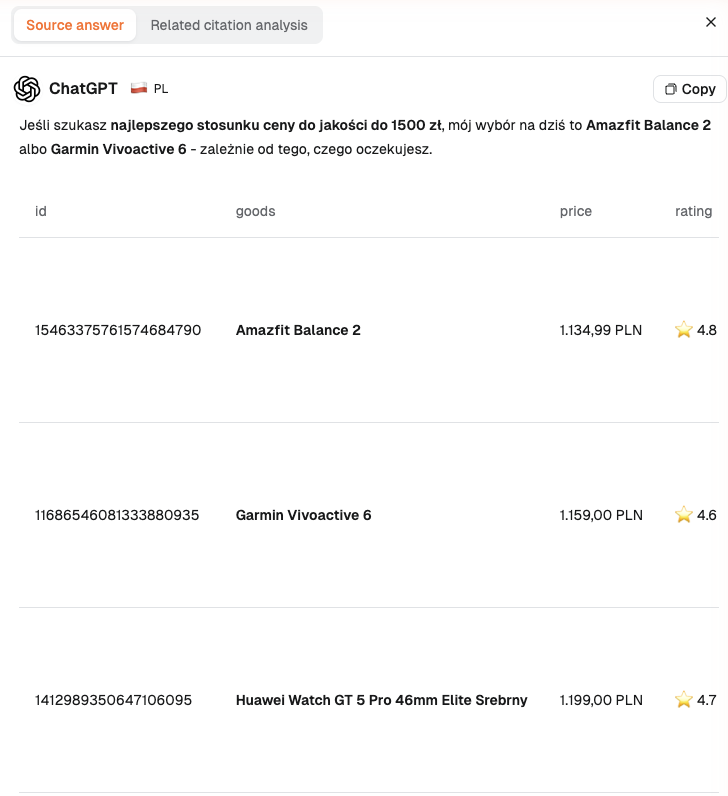
Já a resposta polonesa está em polonês, com orçamento de 1500 zł. Ela recomenda relógios da Amazfit, Garmin, Huawei, Samsung e outras, e suas citações vêm principalmente de sites locais de varejo e comparação de preços, como euro.com.pl, ceneo.pl, mediamarkt.pl e allegro.pl.
Figura 3: resposta do ChatGPT para a Polônia (PL), recomendando relógios em polonês dentro de um orçamento de 1500 zł.
Esses dois mercados correspondem aos dois tipos de diferença descritos acima: na Índia, mudou a condição de orçamento da pergunta; na Polônia, mudaram o idioma e as fontes locais. As amostras são pequenas (duas respostas para a Índia e só uma resposta comparável para a Polônia), então o estudo de caso conclui "marcar como pergunta fora do público-alvo" para a Índia e "continuar observando" para a Polônia.
Essas visões registram respostas de IA salvas. Como diz a página de expansão de mercado do Dageno, a visibilidade na IA entre mercados "não mede demanda total, tamanho de mercado, potencial de vendas, participação de mercado ou preferência do comprador". Escolher um mercado ainda exige pesquisa própria e análise de produto, canais e conformidade. Segundo o blog do Dageno, a consulta gratuita cobre 86 países e regiões e 12.000 segmentos de mercado, então você pode começar vendo onde sua marca está em um mercado-alvo.
Variáveis, vieses e custos que passam despercebidos
Ao comparar mercados, os fatores abaixo são fáceis de confundir com "diferenças de mercado" ou podem elevar o custo da comparação além do esperado.
Localização e idioma são duas variáveis: a FTA Global fez a mesma pergunta sobre pagamentos em Mumbai em inglês, hindi e hinglish. Os três trouxeram principalmente marcas indianas, mas as listas e a ordem mudaram. Mudar só o IP sem mudar o idioma, ou só o idioma sem mudar o local, mede coisas diferentes.
As respostas são instáveis por si só: no teste da FTA Global, as cinco execuções citaram a mesma marca no topo em só 35% das condições. Uma diferença vista em uma única execução pode ser só variação aleatória.
Plataforma, versão e configurações de busca: para a mesma cidade e pergunta, ChatGPT e Gemini tiveram em média só 3,2 marcas em comum no top 5 (FTA Global); no teste da SALT, ligar a busca mudou a primeira escolha em 7 de 10 pares. Não junte resultados de condições diferentes.
As métricas são diferentes: a Statcounter mede visitas enviadas a sites, não uso. Pesquisas com consumidores são autodeclaradas, e algumas trazem países isolados enquanto outras agrupam vários. No relatório da Deloitte, as taxas de uso de IA de alguns países diferem um pouco entre o gráfico e a tabela do apêndice, então confira a tabela original antes de citar.
A posição de quem pesquisa: Peec AI, FTA Global e SALT.agency, todas citadas aqui, vendem serviços de GEO ou de visibilidade na IA, assim como o Dageno. As conclusões apontam na mesma direção, mas amostras e métodos são diferentes; o ideal é testar de novo com suas próprias categorias e mercados.
O custo cresce com o número de combinações: cada combinação extra de "país × idioma × plataforma" acrescenta trabalho de coleta e leitura de respostas, e conjuntos de perguntas locais precisam de revisão por nativos. Aprofundar-se nos 2–3 mercados mais importantes para o negócio é mais viável do que se espalhar por uma dúzia de uma vez.
O tempo muda as conclusões: os recursos das plataformas são lançados mercado a mercado e os modelos continuam sendo atualizados. Coloque data em toda comparação e não compare diretamente resultados antigos com novos.
Compare a visibilidade da sua marca na busca por IA entre mercados
Traduzir perguntas em inglês para o idioma local representa as perguntas dos usuários locais?
Só como "a mesma tarefa perguntada no idioma local". Isso não capta orçamentos, canais nem a forma cotidiana de falar. Perguntas traduzidas servem como conjunto de controle entre mercados; acrescente formulações nativas tiradas de sugestões de busca locais, fóruns e registros de atendimento.
Quantos idiomas devemos testar em um país?
Siga os idiomas que os compradores locais realmente usam. Em mercados multilíngues como Índia, Suíça e Canadá, teste pelo menos os idiomas principais separadamente. Se parte dos seus compradores pergunta em inglês (por exemplo, equipes de compras de multinacionais), registre também as formulações em inglês à parte.
Quantas respostas por mercado são suficientes?
Não há um número universal. Em testes públicos, a FTA Global executou cada condição 5 vezes e a SALT, 40. Nossa recomendação: não tire conclusões sobre o mercado até a primeira escolha ficar estável nas execuções repetidas, e colete mais amostras em categorias instáveis.
Monitorar só o ChatGPT é suficiente?
Não na maioria dos mercados. O ChatGPT tem a maior participação nas visitas, mas o Gemini passa de 16% em alguns mercados, e ChatGPT e Gemini têm em média só 3,2 marcas em comum no top 5 para a mesma pergunta. No mínimo, acrescente a segunda e a terceira maiores plataformas de cada mercado.
Se um mercado mostra recomendações diferentes, devemos criar uma página localizada na hora?
Não. Primeiro verifique se a própria pergunta é diferente, por exemplo, um orçamento abaixo da sua linha de produtos. Depois veja se o produto é vendido localmente e o que dizem as fontes locais. Uma página localizada só vale a pena quando os fatos locais são realmente diferentes e as amostras repetidas continuam mostrando sua marca ausente.
Conclusão
As perguntas de compra feitas à IA em diferentes mercados internacionais variam em quatro camadas: a qual plataforma as pessoas perguntam, que condições a pergunta traz, de onde a IA tira as evidências e quem ela acaba recomendando. Os testes públicos já mostram que olhar só os resultados em inglês dos EUA pode enganar você sobre mais da metade da lista curta (no teste de categorias de software da FTA Global, em média 2,9 das cinco primeiras mudaram). Ainda há poucos dados públicos sobre como os usuários locais realmente perguntam, porém, então cada marca precisa coletar amostras nos próprios mercados e categorias.
Dageno is the research and insights team at Dageno AI, publishing industry reports and expert analysis on AI Search Visibility, Generative Engine Optimization (GEO), and AI-powered search discovery.
 Alexa for Shopping