AI에서 부정적인 브랜드 정서를 해결하는 방법: 7단계 (2026)
12,000 이상의 틈새 시장을 탐색해 보세요.

업데이트한 사람
Nov 12, 2026에 업데이트됨
잠재 고객이 ChatGPT에게 “이 회사의 제품은 살 가치가 있나요?”라고 물었을 때, AI는 귀하의 브랜드를 어떻게 묘사할까요?
제품의 강점을 강조할까요, 아니면 높은 가격, 열악한 고객 지원, 제한적인 기능 등을 반복적으로 언급할까요?
누군가 Google AI 개요(AI Overview)에 귀하의 브랜드와 경쟁사를 비교해달라고 요청했을 때, AI가 다른 제품을 추천하지는 않을까요?
이러한 질문들은 브랜드 평판 관리의 새로운 과제가 되고 있습니다.
과거에는 기업들이 주로 고객 리뷰, 소셜 미디어, 검색 결과 등을 통해 평판을 모니터링했습니다. 이제는 더 많은 사용자가 구매 조언을 얻기 위해 ChatGPT, Google AI 개요, Gemini, Perplexity를 찾습니다. 이러한 환경에서 AI가 생성한 브랜드 설명은 기업에 대한 중요한 정보원이 될 수 있습니다.
만약 AI가 정확하지 않거나 구시대적인, 또는 부정적인 정보로 브랜드를 반복적으로 묘사한다면, 이는 잠재 고객의 제품 평가에 영향을 미칠 수 있습니다. 이것이 바로 기업들이 AI 내의 부정적인 브랜드 정서를 어떻게 해결할지 고민하기 시작한 이유입니다.
하지만 AI 브랜드 정서를 개선하는 것은 단순히 ChatGPT에게 더 긍정적인 답변을 해달라고 요청하는 것만큼 간단하지 않습니다. 기업은 먼저 구체적인 문제를 식별하고, AI가 어떤 정보를 참조했는지 조사하며, 브랜드가 어디에서 부정적으로 묘사되고 있는지 확인하고, 그러한 묘사가 정확한지 검토해야 합니다.
본 기사는 브랜드 팀을 돕기 위한 7가지 실무 단계를 제시합니다.
또한, 실제 Dageno 정서 분석(Sentiment Analytics) 화면을 사용하여 팀이 전반적인 브랜드 점수에서 개별 AI 답변으로 어떻게 이동하며, 증거 기반의 AI 평판 관리 프로세스를 구축할 수 있는지 보여드리겠습니다.
AI에서의 부정적 브랜드 정서는 AI 시스템이 브랜드를 설명, 비교 또는 추천하는 과정에서 비우호적인 평가, 언어 또는 판단을 사용할 때 발생합니다.
예를 들어, 누군가 ChatGPT에게 질문합니다:
브랜드 X는 소규모 비즈니스를 위한 좋은 CRM인가요?
AI는 다음과 같이 답변할 수 있습니다:
브랜드 X는 포괄적인 CRM 기능을 제공하지만, 가격과 구현의 복잡성으로 인해 매우 작은 팀에는 적합하지 않을 수 있습니다.
이 답변은 제품의 기능을 인정하면서도 가격 및 설정과 관련된 한계를 언급하고 있습니다. 이는 완전히 부정적인 평가라기보다는 혼합된 정서나 조건부 추천으로 분류될 수 있습니다.
기업이 가장 먼저 이해해야 할 점은 부정적 정서, 객관적인 비판, 사실 오류, 그리고 제품을 추천하지 않기로 한 결정이 각각 다른 문제라는 것입니다.
| 유형 | AI 답변 예시 | 대응 방법 |
|---|---|---|
| 부정적 정서 | “이 브랜드는 고객 서비스 리뷰가 좋지 않습니다.” | 문제가 실제하는지 확인하고 증거 조사 |
| 객관적 한계 | “이 소프트웨어는 예산이 부족한 소규모 팀에는 적합하지 않습니다.” | 포지셔닝 및 적합한 사용 사례 재검토 |
| 사실 오류 | “이 제품은 API를 지원하지 않습니다.” (실제는 지원함) | 제품 정보 수정 |
| 추천 없음 | “이 용도로는 경쟁사 제품을 추천합니다.” | 경쟁 우위 차이 및 구매자의 니즈 검토 |
| 중립적 묘사 | “이 회사는 CRM 소프트웨어를 제공합니다.” | 대개 수정 불필요 |
| 긍정적 평가 | “이 제품은 자동화된 워크플로가 필요한 팀에 적합합니다.” | 주장의 정확성 및 근거 확인 |
기업은 모든 중립적인 진술이나 정당한 비판을 제거해야 할 부정적 콘텐츠로 간주해서는 안 됩니다. 우선순위는 잘못된 브랜드 사실, 구시대적인 부정적 정보, 반복적이고 중요한 고객 문제, 그리고 구매 결정을 오도할 수 있는 묘사입니다.
AI는 고객처럼 직접 제품을 경험하지 않습니다. AI는 모델이 이미 알고 있는 정보, 사용자가 제공한 맥락, 그리고 필요에 따라 검색된 웹 페이지와 기타 자료를 활용하여 답변을 구성합니다. 따라서 여러 요인이 AI의 브랜드 묘사에 영향을 미칠 수 있습니다.
SaaS 기업은 새로운 기능을 출시하거나, 가격을 변경하거나, 고객 지원을 개선했을 수 있습니다. 만약 AI가 여전히 과거의 제품 설명을 기반으로 한다면, 더 이상 적용되지 않는 단점을 반복할 수 있습니다.
예를 들어, 특정 기능이 현재는 지원됨에도 불구하고 AI가 해당 제품에는 기업용 싱글 사인온(SSO) 기능이 부족하다고 잘못 말할 수 있습니다. 이는 정보의 정확성 문제이지, 반드시 심각한 평판 문제는 아닙니다.
리뷰 사이트, 포럼, 커뮤니티 토론 및 업계 간행물에는 모두 제품 경험에 대한 후기가 포함될 수 있습니다. AI가 이러한 출처를 검색하고 활용할 때, 해당 출처의 비판적인 내용이 최종 AI 답변에 나타날 수 있습니다.
그러나 부정적인 제3자 리뷰가 존재한다고 해서 AI가 반드시 이를 인용하는 것은 아닙니다. 마찬가지로, 특정 소스가 인용되었다고 해서 그것이 특정 부정적 진술의 유일한 원인임을 증명하는 것도 아닙니다.
회사 웹사이트에서 해당 제품의 타겟 고객, 해결 문제, 경쟁사와의 차별점을 명확하게 설명하지 않으면, AI가 적절한 사용 사례를 식별하는 데 어려움을 겪을 수 있습니다.
예를 들어, 중견 및 대기업용 소프트웨어는 가격 때문에 소규모 팀을 위한 저예산 옵션에 관한 답변에서 부적합한 것으로 묘사될 수 있습니다. 이는 브랜드 평판이 나빠서가 아니라, 사용자의 요구 사항과 브랜드 포지셔닝 간의 불일치를 반영하는 것일 수 있습니다.
때때로 반복되는 비판에는 사실적 근거가 있습니다. 고객은 실제로 서비스 중단, 배송 지연 또는 신뢰성 문제를 겪었을 수 있습니다. 이 경우, 기업은 먼저 근본적인 문제를 해결한 다음 무엇이 개선되었는지 정확하게 전달해야 합니다.
문제를 해결하지 않은 채 긍정적인 기사만 더 많이 게시하는 것은 신뢰할 수 있는 평판 전략이 아닙니다.
동일한 브랜드라도 ChatGPT, Google AI Overview 또는 기타 AI 플랫폼에서 각기 다른 평가를 받을 수 있습니다. 검색된 소스, 답변 생성 방식, 모델, 지역 및 사용자의 질문이 모두 결과에 영향을 미칠 수 있습니다.
따라서 단 하나의 ChatGPT 답변만으로 AI 검색 전반에서 브랜드의 평판을 판단할 수는 없습니다.
부정적인 정서를 개선하기 전에, AI가 현재 브랜드를 어떻게 설명하고 있는지 확인해야 합니다. 브랜드 및 고객의 구매 결정과 관련된 질문 세트부터 시작하여 여러 AI 플랫폼에서 이를 모니터링하십시오.
예를 들어, 스포츠웨어 브랜드는 다음과 같은 내용을 추적할 수 있습니다.
| 프롬프트 | 모니터링 목표 |
|---|---|
| HIIT 운동에 가장 좋은 신발은? | 트레이닝화 추천에서 브랜드가 어떻게 평가되는지 확인 |
| 프리미엄 러닝화는 가격 값을 할까? | 가격과 가치에 대한 묘사 연구 |
| 쿠셔닝이 가장 좋은 러닝화 브랜드는? | 제품 성능에 대한 인식 연구 |
| 재생 소재로 만든 신발은 내구성이 좋을까? | 지속 가능한 제품에 대한 평가 관찰 |
| 가장 신뢰할 수 있는 운동화 브랜드는? | 신뢰도 및 브랜드 신뢰성 연구 |
두 가지 유형의 프롬프트를 포함하십시오. 브랜드 프롬프트는 특정 브랜드가 신뢰할 만한지, 구매할 가치가 있는지 직접적으로 묻습니다. 비브랜드 프롬프트는 제품 카테고리나 구매 필요에 대해 질문하며, AI가 스스로 브랜드를 추천하는지, 그리고 어떻게 설명하는지 확인할 수 있게 해줍니다.
이 두 그룹을 별도로 분석하십시오. 사용자가 브랜드에 대해 직접 질문할 때 AI는 장단점에 대한 전체적인 설명을 제공할 수 있습니다. 제품 추천 시에는 특정 판매 포인트 하나만 강조할 수도 있습니다.
Dageno에서 **Analytics(분석) → Prompt Tracking(프롬프트 추적) → Sentiment(정서)**로 이동하십시오.
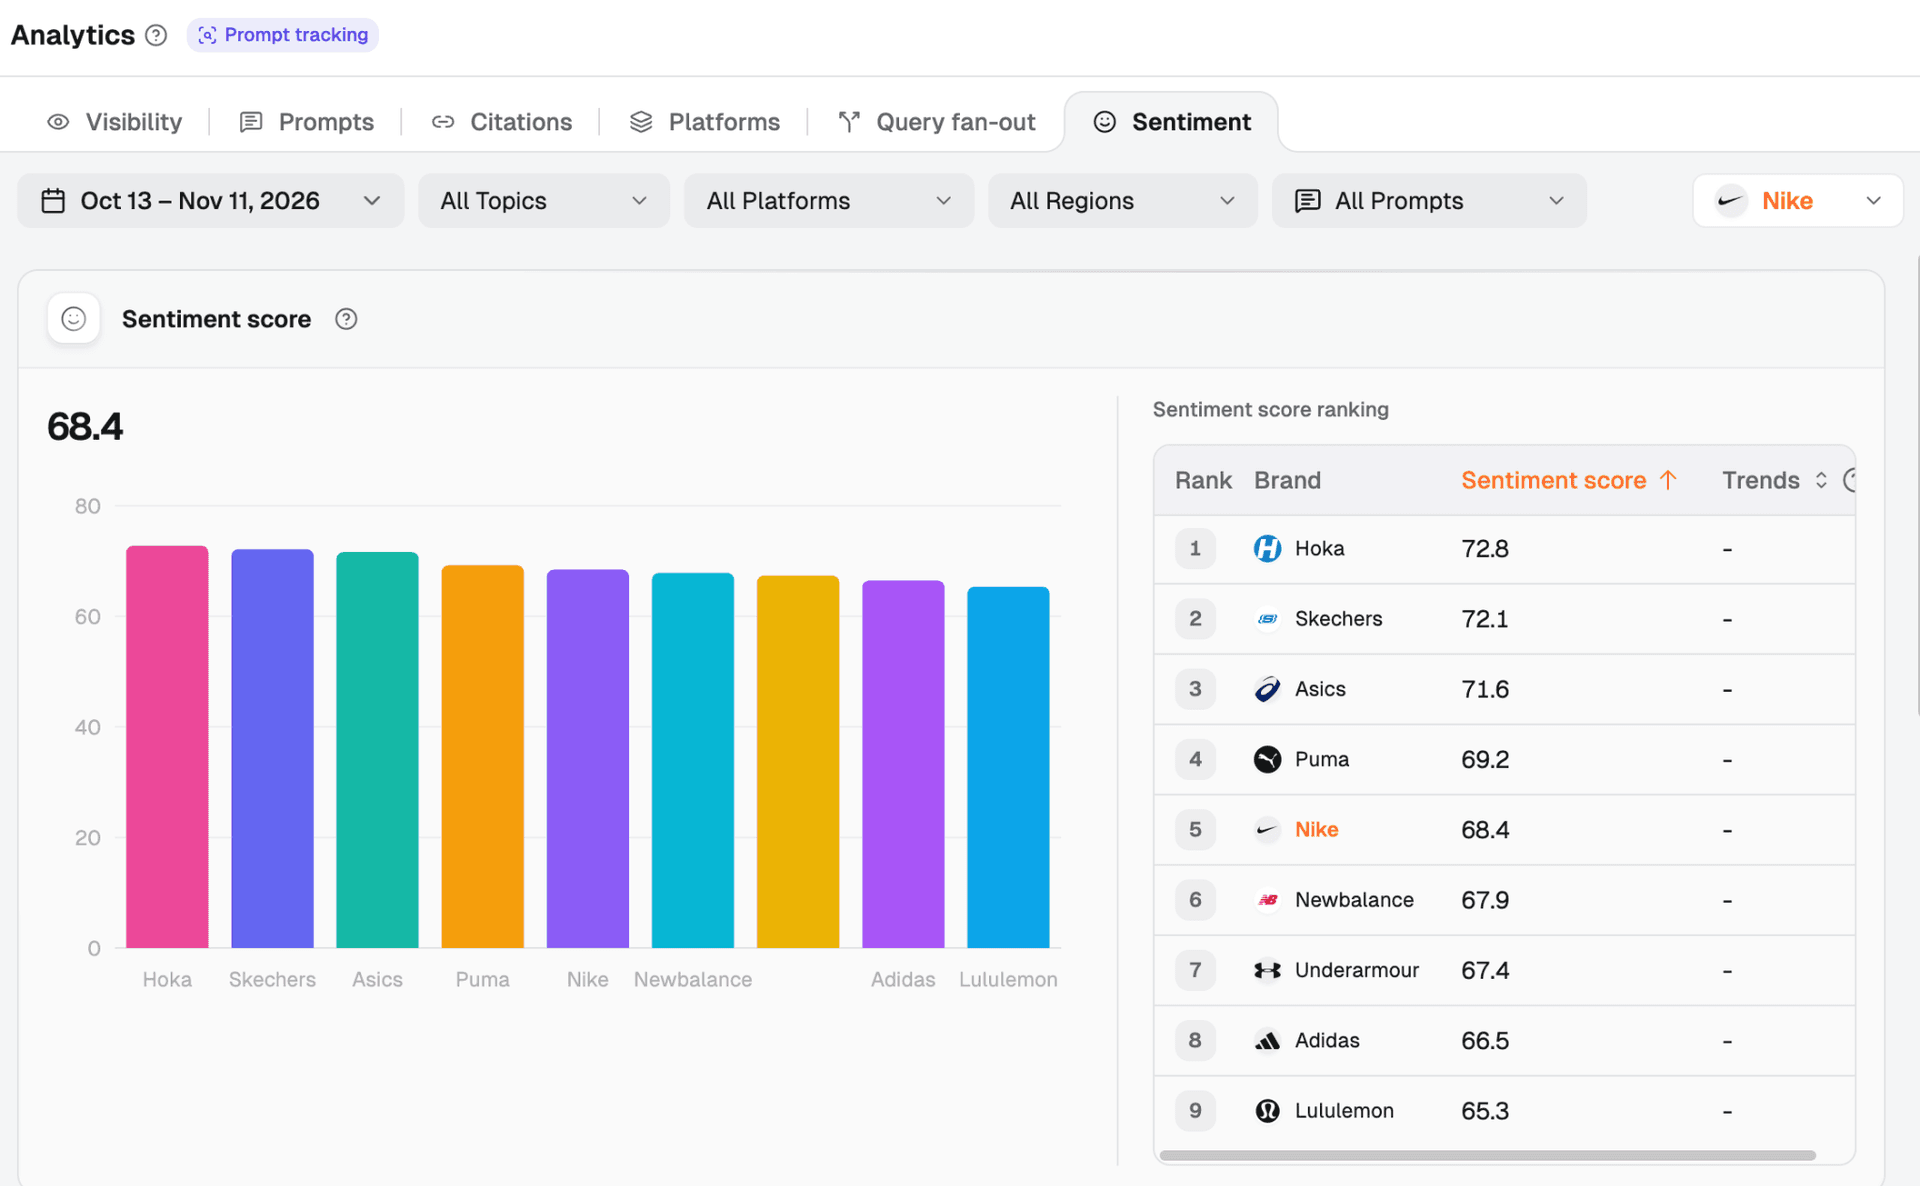
Sentiment(정서) 페이지에서는 날짜, 주제, 플랫폼, 지역 및 프롬프트별로 필터링하고 분석 대상 브랜드를 전환할 수 있습니다. 이를 통해 팀은 단일 수동 테스트에 의존하는 대신 특정 시장과 질문 세트에 대한 브랜드 정서를 연구할 수 있습니다.
Nike 사례에서 선택된 기간의 정서 점수(Sentiment Score)는 68.4입니다. 이는 관찰을 위한 기준점을 제공하지만, 표본 크기, 점수 산정 방식 및 실제 답변과 함께 해석해야 합니다. 이는 소비자의 68.4%가 Nike를 좋아한다는 의미가 아니며, 소비자 만족도 점수도 아닙니다.
자신의 정서 점수를 아는 것만으로는 브랜드 성과를 평가하기에 충분하지 않습니다. 브랜드 점수가 68.4라고 가정할 때, 주요 경쟁사의 점수가 80점대라면 그 격차는 조사가 필요함을 시사합니다. 하지만 비교 대상 브랜드들이 대부분 65점에서 72점 사이에 분포한다면, 동일한 68.4점이라도 경쟁력 측면에서는 다른 의미를 갖습니다.
이것이 Dageno 정서 순위(Sentiment Ranking)를 사용하는 이유 중 하나입니다. Nike의 대시보드는 다음과 같이 보여줍니다.
| 브랜드 | 정서 점수 | 순위 |
|---|---|---|
| Hoka | 72.8 | 1 |
| Skechers | 72.1 | 2 |
| Asics | 71.6 | 3 |
| Puma | 69.2 | 4 |
| Nike | 68.4 | 5 |
| New Balance | 67.9 | 6 |
| Under Armour | 67.4 | 7 |
| Adidas | 66.5 | 8 |
| Lululemon | 65.3 | 9 |
이 모니터링 뷰에서 Nike의 점수는 Hoka보다 4.4점 낮고, Puma보다 0.8점 낮지만, Adidas와 Lululemon보다는 높습니다.
이는 Nike의 전반적인 평판이 Hoka보다 나쁘다는 것을 증명하지는 않습니다. 이는 선택된 모니터링 범위와 채점 시스템 하에서의 차이를 보여줄 뿐입니다.
다음과 같은 후속 질문이 더 유용할 수 있습니다.
경쟁 감성 분석의 목표는 단순히 1위를 차지하려고 노력하는 것이 아니라, 중요한 구매 시나리오에서 조사하고 개선할 가치가 있는 격차를 발견하는 것입니다.
브랜드 전체 점수는 문제를 드러낼 수는 있지만, 기업에게 무엇을 수정해야 할지는 알려주지 않습니다. 다음 단계는 개별 프롬프트와 AI 답변을 검토하는 것입니다.
Dageno의 감성 분석(Sentiment Analytics)은 개별 답변 목록을 제공합니다. 스크린샷은 다음 필드를 보여줍니다.
| 필드 | 목적 |
|---|---|
| 플랫폼 | 답변을 생성한 AI 플랫폼 식별 |
| 프롬프트 | 사용자의 구체적인 질문 확인 |
| 감성 | 긍정, 중립, 부정 분류 확인 |
| 응답 | AI 답변 읽기 |
| 답변 일자 | 답변이 기록된 날짜 확인 |
예를 들어, 2026년 11월 11일 Nike의 답변 목록에는 Google AI Overview의 긍정적인 평가와 ChatGPT의 중립적인 평가가 모두 포함되어 있습니다.
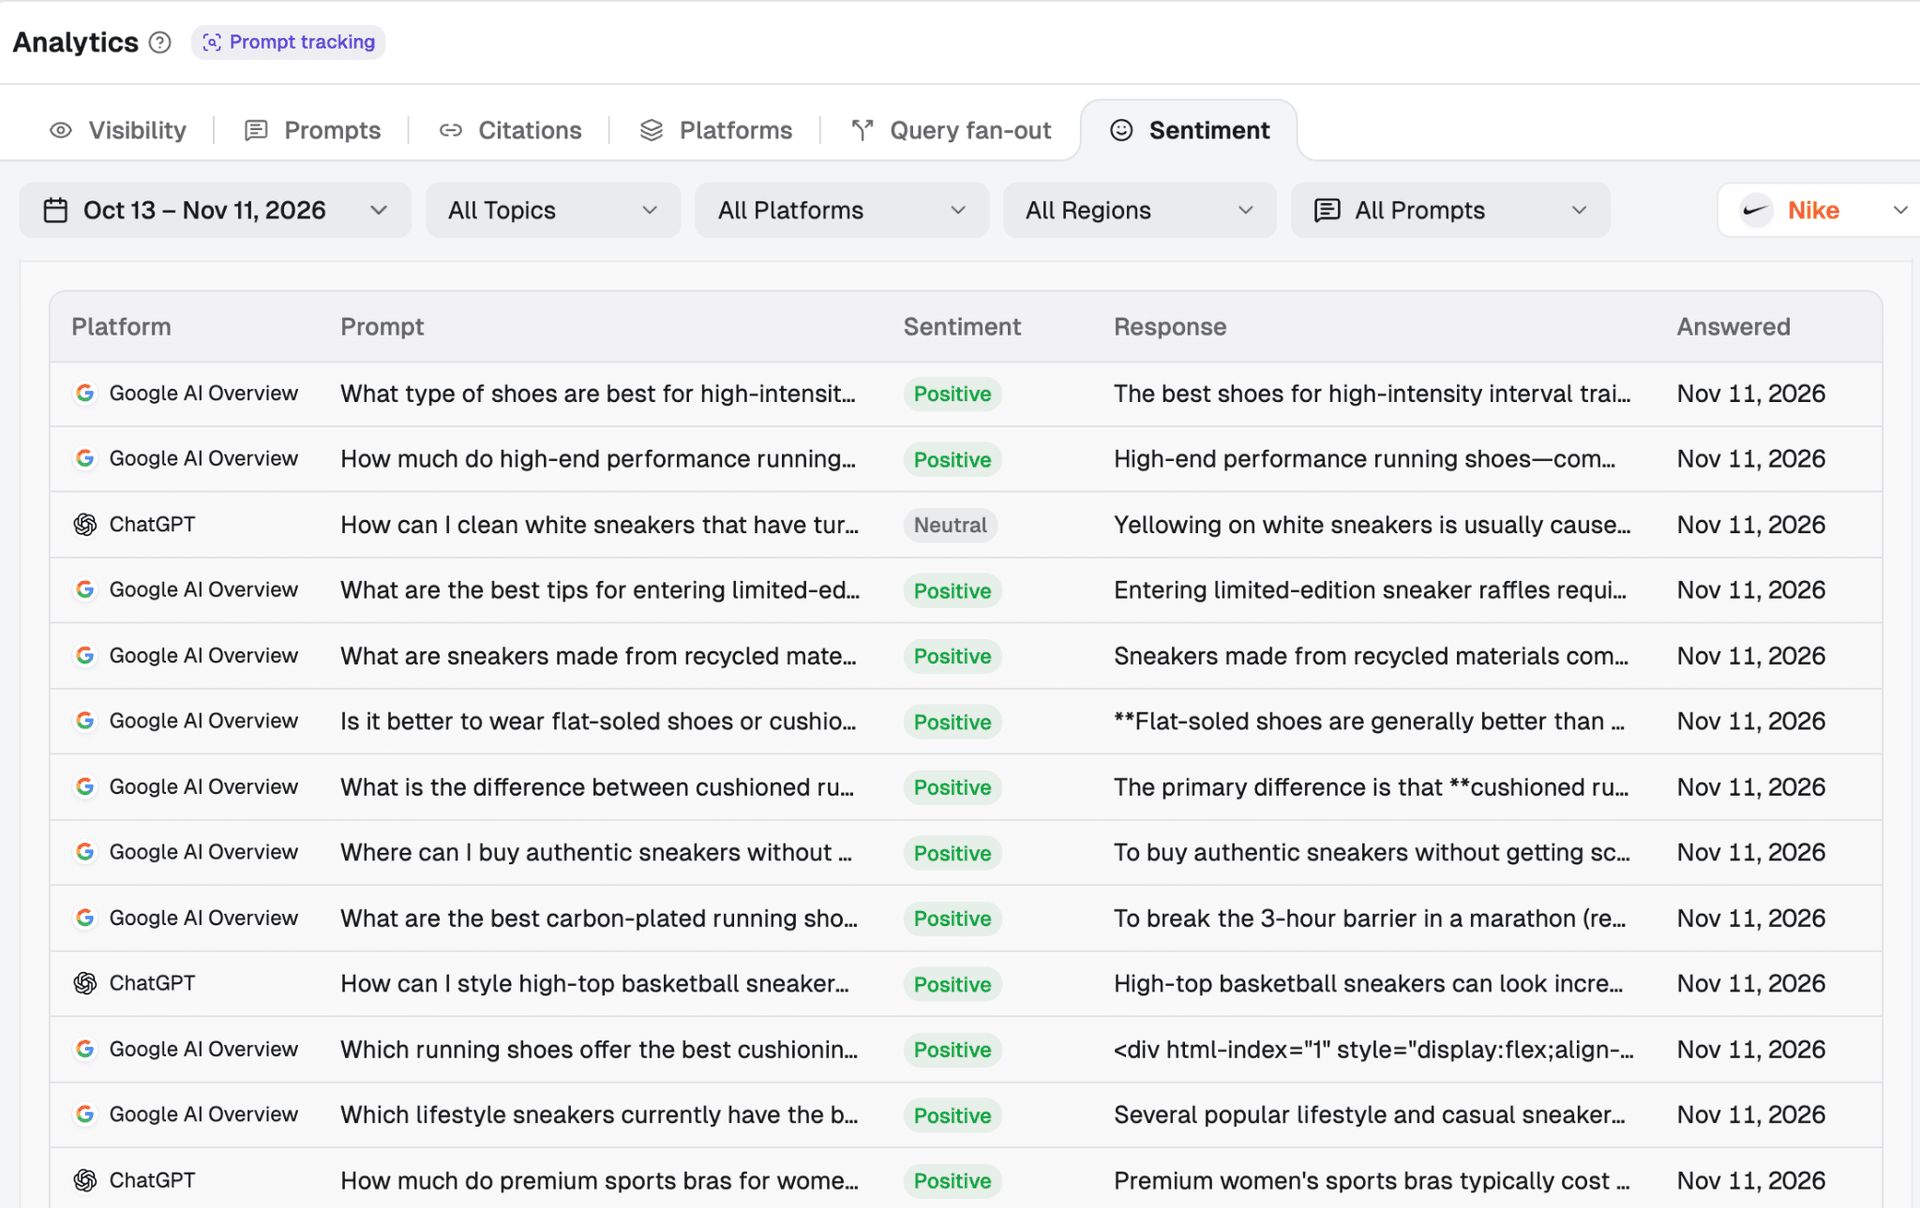
흰색 운동화의 황변 제거에 관한 질문은 '중립'으로 표시된 반면, 트레이닝화 및 운동 장비에 관한 많은 질문은 '긍정'으로 표시되었습니다. 브랜드의 전체 점수가 상대적으로 높더라도 질문에 따라 감성은 달라질 수 있습니다.
부정적 감성을 해결하려면 먼저 부정적 답변을 필터링한 다음, 비즈니스 영향도에 따라 순위를 매기십시오. 제품 안전, 신뢰, 가격 책정, 서비스 안정성 및 구매 권장 사항에 관한 부정적인 언급을 우선적으로 처리하십시오.
감성 라벨에만 의존하지 마십시오. '부정'으로 표시된 답변이 합리적인 제품의 한계를 설명하는 것일 수도 있고, '중립'으로 표시된 답변에 수정이 필요한 사실 오류가 포함되어 있을 수도 있습니다. 전체 답변과 그 맥락을 읽어보십시오.
이는 Dageno 인터페이스의 중요한 기능입니다. 감성 답변 목록에서 상세 기록을 열어 전체 AI 답변, 언급된 브랜드, 그리고 관련 출처를 확인할 수 있습니다.
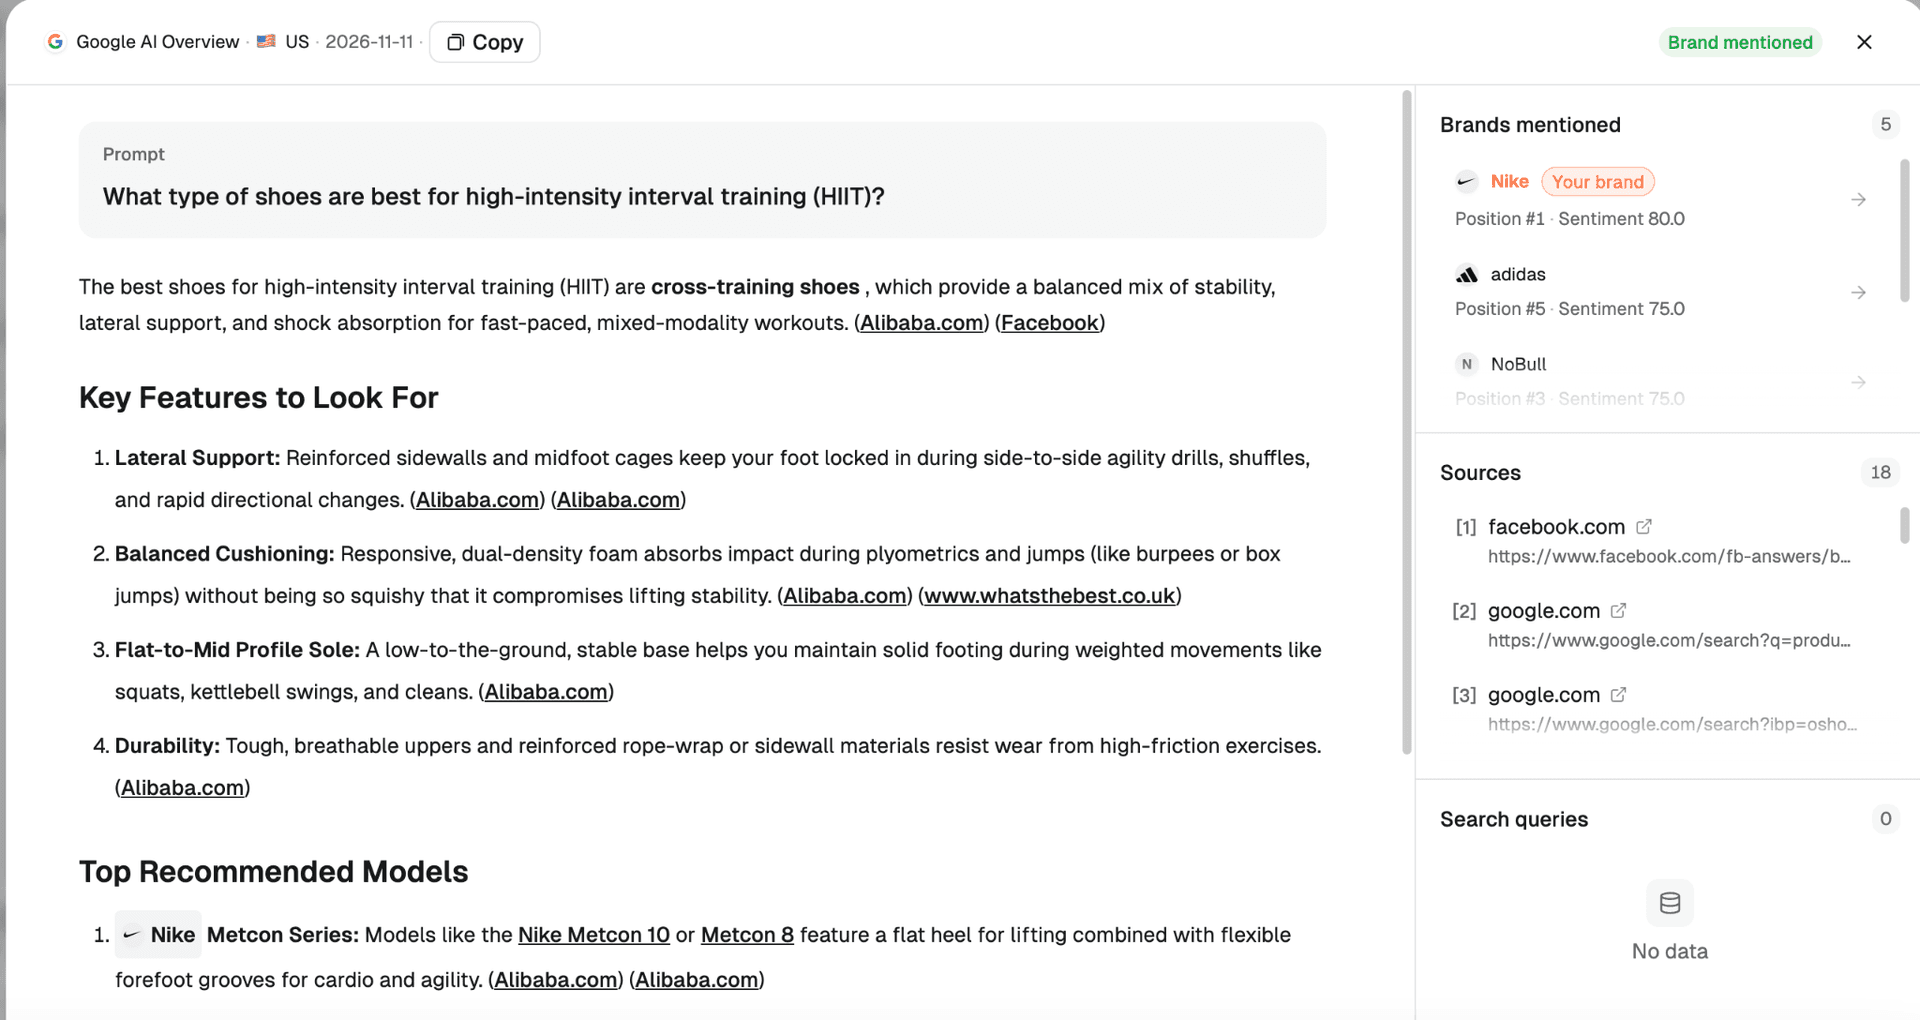
이 답변은 Nike의 Metcon 라인뿐만 아니라 다른 스포츠웨어 브랜드도 언급하고 있습니다. 스크린샷의 숫자 18은 답변 상세 패널의 출처 개수를 나타내며, 18개 출처 모두가 Nike에 대해 긍정적인 견해를 뒷받침한다는 의미는 아닙니다.
이 예시는 세 가지 별도의 정보를 보여줍니다.
또한 이 답변은 측면 지지력, 쿠션감, 밑창 안정성, 내구성 등 HIIT 슈즈에서 중요한 기능을 논의합니다. 이러한 세부 정보들은 팀이 Nike가 왜 이 답변에 나타났는지, 답변이 어떤 자료를 참고했는지 조사하는 데 도움을 줍니다.
중요한 제한 사항이 있습니다. 브랜드 평가와 함께 나타나는 인용 출처가 해당 출처가 평가의 원인임을 증명하지는 않습니다. 부정적인 답변의 경우, 관련 출처를 개별적으로 열어 실제로 비판을 뒷받침하는지 확인하십시오. 증거가 부족하다면 특정 사이트를 부정적 감성의 원인으로 단정하기보다 원인 불명으로 표시하십시오.
특정 문제를 파악했다면, 대량의 긍정적인 콘텐츠를 게시하기 전에 부정적인 설명이 정확한지 확인하십시오. 문제마다 대응 방식이 달라야 합니다.
| 문제 유형 | 예시 | 더 나은 대응 |
|---|---|---|
| 정보 노후화 | AI가 기능이 출시되지 않았다고 판단함 | 제품 문서 및 기능 설명 업데이트 |
| 가격 오해 | AI가 제품에 유연한 요금제가 없다고 판단함 | 정확한 가격 및 요금제 약관 게시 |
| 잘못된 제품 포지셔닝 | 엔터프라이즈 도구가 개인용 도구로 설명됨 | 타겟 고객 및 사용 사례 명확화 |
| 실제 제품 문제 | 고객들이 반복적으로 낮은 신뢰성을 보고함 | 먼저 제품 문제를 해결하십시오 |
| 증거 부족 | AI가 제품의 효과성에 대해 불확실성을 표함 | 신뢰할 수 있는 연구 및 사용 증거를 제공하십시오 |
| 추천 없음 | AI가 경쟁사 제품을 자주 추천함 | 사용자 요구에 맞춰 제품 간 차이를 비교하십시오 |
| 과거의 부정적 사건 | 과거의 문제가 현재의 문제로 제시됨 | 해결 및 업데이트에 관한 연대기적 기록을 게시하십시오 |
AI가 소프트웨어에 통합 기능이 없다고 잘못 언급하는 경우, 먼저 자사의 기능 페이지에 지원되는 내용이 명확하게 명시되어 있는지 확인하십시오. 그런 다음 고객 센터 및 통합 관련 문서를 업데이트하고, 타사 제품 디렉토리에 여전히 구식 정보가 포함되어 있는지 확인하십시오.
실제 고객 서비스 문제의 경우, 무엇이 변경되었는지 공개적으로 설명하기 전에 서비스 자체를 개선하십시오.
GEO/AEO의 목표는 AI가 브랜드를 무조건적으로 칭찬하게 만드는 것이 아닙니다. 브랜드 정보를 더 정확하고, 완전하며, 검증 가능하게 만드는 것입니다.
AI 검색은 자사 사이트뿐만 아니라 타사의 자료도 활용할 수 있습니다. 따라서 기업은 자사 콘텐츠뿐만 아니라 관련 리뷰 플랫폼, 업계 간행물 및 커뮤니티에도 주의를 기울여야 합니다.
특정한 부정적 답변에서 시작하여 어떤 타사 정보에 주의를 기울여야 할지 결정하십시오. AI 답변이 2년 전의 제품 리뷰를 인용하여 이미 해결된 문제를 설명하고 있다고 가정해 봅시다. 기업은 공식 정보를 업데이트하고, 허용되는 경우 해당 리뷰에 수정 사실과 날짜를 포함한 답변을 남길 수 있습니다.
부정적 평가가 여전히 사실이라면, 근거 없는 홍보 기사로 이를 덮으려 하지 마십시오. 더 나은 접근 방식은 고객이 실제 문제를 확인하고, 기업이 이를 어떻게 해결했는지, 그리고 제품이나 서비스의 현재 상태가 어떠한지 알 수 있도록 하는 것입니다.
실제 경험을 반영하지 않는 가짜 리뷰, 조작된 사례 연구, 포럼 토론의 대규모 조작, 구매된 추천 등을 피하십시오. 이러한 전략은 소비자 신뢰를 훼손하며 AI 브랜드 평판을 신뢰할 수 있고 지속적으로 개선하는 데 도움이 되지 않습니다.
콘텐츠와 정보를 업데이트한 후, 원래 모니터링하던 질문으로 돌아가 브랜드 성과가 변화했는지 확인하십시오. 최소한 다음 지표들을 비교하십시오:
기간을 비교할 때는 프롬프트, 플랫폼, 지역 및 측정 정의를 가능한 한 일관되게 유지하십시오. AI 답변은 시간이 지남에 따라 또는 모델 변경에 따라 변동될 수 있으므로, 단 한 번의 높은 점수가 문제가 완전히 해결되었다는 증거는 아닙니다.
이 7단계 프로세스는 대부분의 브랜드에 적용됩니다. 수동적인 ChatGPT 확인만으로 이를 지속적으로 수행하는 것은 어려울 수 있습니다. Dageno는 감성 분석을 AI 가시성 추적(AI Visibility Tracking)에 통합하여 팀이 전반적인 브랜드 평가에서 개별 답변 수준으로 분석을 확장할 수 있도록 합니다.
세 개의 실제 대시보드 스크린샷은 다음과 같은 워크플로우를 지원합니다.
Dageno Analytics에서 '감성(Sentiment)' 페이지를 열고 대상 브랜드, 날짜 범위 및 모니터링 조건을 선택하십시오. 먼저 전반적인 감성 점수와 경쟁사 순위를 검토하십시오.
이 뷰는 브랜드 리더가 현재 모니터링 샘플 내의 감성을 평가하고 더 깊은 조사가 필요한 경쟁적 격차를 파악하는 데 도움을 줍니다.
주제(Topics), 플랫폼(Platforms), 지역(Regions) 및 프롬프트(Prompts)별로 필터링하십시오. 각 모니터링 기록은 플랫폼, 질문, 감성 분류, AI 답변 및 기록된 날짜를 보여줍니다.
특정 가격 비교 질문에서만 브랜드 성과가 저조하다면, 팀은 모든 브랜드 콘텐츠를 한꺼번에 변경하기보다 가격 및 가치 포지셔닝에 관한 정보에 우선순위를 둘 수 있습니다.
조사가 필요한 답변을 열어 전체 내용을 읽어보십시오. Dageno의 상세 뷰는 브랜드 언급, 브랜드 위치, 감성 점수 및 출처(Sources)를 보여주며, 팀이 관련 인용문을 확인할 수 있는 출발점을 제공합니다.
명확한 오류를 발견했다면 자사 사이트, 제품 문서 및 타사 출처를 검토하십시오. 잠재적으로 관련 있는 출처를 찾는 것과 부정적 평가의 원인을 규명하는 것을 구분해야 합니다. 후자의 경우 추가적인 증거가 필요합니다.
Dageno Analytics에는 Visibility(가시성), Prompts(프롬프트), Citations(인용), Platforms(플랫폼), Query Fan-out(쿼리 확산)이 포함되어 있습니다. 이러한 모듈은 감성 분석을 위한 맥락을 제공합니다.
어떤 브랜드는 특정 시장에서 높은 가시성을 확보하고 있지만, 구매 비교 상황에서는 자주 '고가'로 묘사될 수 있습니다. 이는 고객의 니즈와 브랜드 포지셔닝 간의 불일치 문제일 수 있습니다. 반면, 긍정적인 평가를 받으면서도 정작 중요한 구매 관련 질문에는 거의 나타나지 않는 브랜드도 있습니다.
감성(Sentiment)과 가시성(Visibility)을 별도로 측정하고, 이를 종합적으로 해석하십시오. Dageno 웹사이트에서는 경쟁 우위와 최적화 기회를 조사하는 데 도움이 되는 Market Competitive Landscape(시장 경쟁 환경), Search Intents(검색 의도), GEO/AEO Gap Diagnosis(GEO/AEO 격차 진단) 기능도 설명하고 있습니다.
AI 감성 모니터링 도구는 서로 다른 점수 산정 알고리즘을 사용할 수 있습니다. 서로 다른 플랫폼의 점수가 동일한 척도를 나타낸다고 가정해서는 안 됩니다. 도구가 제공하는 점수 외에도 팀이 직접 검토하고 검증할 수 있는 내부 측정 지표를 수립하십시오.
| 지표 | 정의 | 활용 |
|---|---|---|
| 감성 점수 (Sentiment Score) | 도구가 계산한 브랜드 감성 점수 | 전반적인 추세 추적 |
| 부정적 언급률 (Negative Mention Rate) | 유효한 브랜드 언급 중 부정적 언급의 비율 | 부정적 묘사의 빈도 측정 |
| 경쟁사 감성 격차 (Competitor Sentiment Gap) | 자사 브랜드 점수와 경쟁사 점수의 차이 | 경쟁력 평가 |
| 사실 오류율 (Factual Error Rate) | 브랜드에 대해 검증 가능한 사실 오류를 포함한 답변의 비율 | 정보 정확성 측정 |
| 추천율 (Recommendation Rate) | 브랜드가 추천된 관련 구매 질문의 비율 | 의사결정 상황에서의 성과 평가 |
특정 기간 동안 브랜드를 언급하는 200개의 유효한 AI 답변을 모니터링했고, 그중 24개가 부정적으로 분류되었다고 가정해 보겠습니다.
[
\text{부정적 언급률} = \frac{24}{200} \times 100% = 12%
]
이 가상의 샘플에서 부정적 언급률은 12%입니다. 이는 Dageno 스크린샷에 표시된 68.4점의 감성 점수와는 다른 지표이며, 해당 점수로 직접 환산할 수 없습니다.
자동 감성 분류는 오류를 범할 수 있습니다. 영향력이 큰 부정적 답변의 경우, 원문을 수동으로 검토하고 논란의 여지가 있는 분류는 별도로 표시하십시오.
사용자는 정확하고 균형 잡힌 조언을 필요로 합니다. 특정 사용 사례에 제품이 적합하지 않을 때, AI가 그 한계를 지적하는 것은 반드시 잘못된 일이 아닙니다. 기업은 모든 비판을 없애는 것보다 오류를 수정하는 것을 우선시해야 합니다.
평균은 중요한 문제를 숨길 수 있습니다. 전체적인 감성 점수는 양호하더라도, 가치가 높은 구매 질문에서 AI가 반복적으로 잘못된 제품 정보를 사용할 수 있습니다. 이는 여전히 우선적으로 해결해야 할 문제입니다.
부정적(Negative), 중립적(Neutral), 긍정적(Positive)은 분석 도구가 할당한 범주일 뿐입니다. 이는 맥락에 대한 이해를 대신할 수 없습니다. 타당한 제품 한계와 부정확한 부정적 판단을 구분하십시오.
AI 답변은 여러 소스를 종합하거나 모델이 이미 학습한 내용을 바탕으로 생성될 수 있습니다. 인용된 링크 하나가 부정적 평가의 직접적인 원인이라고 단정할 수 없습니다.
반복되는 고객 불만이 타당하다면, 제품이나 서비스를 먼저 개선하십시오. 뒷받침되지 않는 대량의 홍보 콘텐츠는 실제 개선을 대체할 수 없으며, 오히려 브랜드에 대한 신뢰를 약화시킬 수 있습니다.
먼저 관련 답변을 모니터링하여 사실 오류, 실제 제품 문제, 그리고 제품이 적합하지 않은 사용 사례를 구분하십시오. 그다음 관련 출처를 조사하고, 오래된 정보를 수정하며, 제품 문서를 개선하고, 실제 고객 문제를 해결하십시오. 마지막으로 일관된 프롬프트 세트를 사용하여 시간이 지남에 따라 감성과 정확도가 어떻게 변화하는지 모니터링하십시오.
기업은 ChatGPT가 모든 사용자에게 전달하는 내용을 직접 통제할 수 없습니다. 기업이 할 수 있는 일은 웹사이트, 제품 문서 및 관련 제3자 정보의 정확성을 개선하고, 플랫폼 피드백 채널을 활용해 명백한 사실 오류를 신고하는 것입니다. 이러한 조치가 AI 시스템이 활용하는 정보를 개선할 수는 있지만, 특정 답변의 변경을 보장하지는 않습니다.
일반적인 원인으로는 오래된 정보, 실제 고객 불만, 불분명한 제품 포지셔닝, 잘못된 브랜드 사실, 그리고 AI 플랫폼마다 사용하는 정보의 차이 등이 있습니다. 실제 답변과 검증 가능한 증거를 통해 근본 원인을 파악해야 합니다.
브랜드 및 구매 관련 질문을 일관된 세트로 구성하고, 정기적으로 ChatGPT의 답변을 기록하여 브랜드에 대한 묘사 방식을 분류하십시오. 다수의 질문, 플랫폼, 경쟁사를 비교해야 하는 팀은 Dageno와 같은 AI 가시성 추적(AI Visibility Tracking) 도구를 활용할 수 있습니다.
도구와 산업 전반에 걸쳐 통용되는 보편적인 임계값은 없습니다. 알고리즘, 샘플, 평가 척도 및 질문 세트가 모두 다르기 때문입니다. 현재 점수는 동일한 도구 내에서 비교 가능한 조건으로 측정된 과거 결과 및 경쟁사의 점수와 우선적으로 비교하십시오.
반드시 그렇지는 않습니다. 뚜렷한 추천이나 비판이 없는 객관적이고 정확한 설명은 보통 부정적인 평판이 아닌 중립적인 정보에 해당합니다. 중립적인 답변에 사용자의 결정에 영향을 미칠 수 있는 중요한 제품 사실이 누락되어 있는지 확인하십시오.
정해진 일정은 없습니다. 제품 정보와 제3자 콘텐츠가 수정된 후, 실시간 검색을 활용하는 AI 검색 경험은 새로운 정보를 점진적으로 반영할 수 있지만 업데이트 완료 시간을 보장할 수는 없습니다. 모델의 기존 지식에 주로 의존하는 답변은 변경 속도가 더 느릴 수 있습니다.
그럴 수 있습니다. 잠재 고객이 제품 비교를 위해 AI를 사용하는데 부정확하거나 불리한 묘사를 접하게 된다면, 해당 묘사가 구매 결정에 영향을 줄 수 있습니다. AI 감정 점수의 하락이 곧바로 매출 감소를 입증하는 것은 아니므로, 리드(lead), 방문자 수, 전환율 및 기타 비즈니스 데이터와 함께 평가하십시오.
AI 가시성(AI Visibility)은 브랜드가 관련 AI 답변에 노출되는지 여부를 측정합니다. 반면, AI 감정(AI Sentiment)은 브랜드가 노출되었을 때 AI가 이를 어떻게 평가하거나 묘사하는지를 살펴봅니다. 브랜드는 높은 가시성을 확보하고 있더라도 평가가 혼재되거나 부정적일 수 있으며, 반대로 일부 관련 답변에서만 긍정적인 묘사를 얻을 수도 있습니다. 두 지표를 함께 분석하십시오.
AI 브랜드 모니터링 도구로는 Dageno, PromptEye 및 기타 AI 가시성 플랫폼이 있습니다. 브랜드 감정, 경쟁사 순위, 개별 프롬프트, 전체 답변 및 인용 출처를 연결하여 파악하고자 하는 팀이라면 Dageno를 고려해 볼 가치가 있습니다.
더 많은 사람들이 AI 검색을 통해 제품을 조사하고 비교함에 따라, 기업은 자신의 브랜드가 노출되는지 여부뿐만 아니라 AI가 브랜드를 어떻게 묘사하는지 파악해야 합니다.
AI 내 부정적인 브랜드 감정을 수정한다는 것이 모든 답변을 찬사로 바꾸려 노력하는 것을 의미해서는 안 됩니다. 더 효과적인 프로세스는 다음과 같습니다.
문제 발견 → 답변 읽기 → 사실 검증 → 출처 확인 → 정보 개선 → 결과 모니터링
Dageno의 감정 분석(Sentiment Analytics)은 이 프로세스를 위한 관찰 가능한 데이터를 제공합니다. 종합 감정 점수, 경쟁사 순위, 프롬프트별 감정 분류, 전체 AI 답변, 브랜드 위치 및 인용 출처는 팀이 브랜드 성과를 더 상세하게 이해하도록 돕습니다.
경쟁 상황과 GEO/AEO 기회를 조사하는 기업은 이러한 분석 결과를 Dageno의 다른 AI 가시성 및 시장 인텔리전스(Market Intelligence) 기능과 결합할 수 있습니다.
지금 AI가 귀하의 브랜드를 어떻게 묘사하고 있는지 확인하고, 가장 먼저 주의를 기울여야 할 문제를 파악하십시오.
Ye Faye is an SEO and AI growth executive with extensive experience spanning leading SEO service providers and high-growth AI companies, bringing a rare blend of search intelligence and AI product expertise. As a former Marketing Operations Director, he has led cross-functional, data-driven initiatives that improve go-to-market execution, accelerate scalable growth, and elevate marketing effectiveness. He focuses on Generative Engine Optimization (GEO), helping organizations adapt their content and visibility strategies for generative search and AI-driven discovery, and strengthening authoritative presence across platforms such as ChatGPT and Perplexity
Read full bio Alexa for Shopping
