FTA Global의 테스트에서 "뉴욕 + 영어" 기준을 벗어나자 AI가 추천하는 상위 5개 브랜드 중 평균 2.9개가 바뀌었습니다. 이 글은 AI 구매 질문이 시장마다 달라지는 네 가지(어디서 묻는지, 현지 조건, 인용 출처, 추천 브랜드)를 정리하고, 이를 비교하는 다섯 단계 방법을 제시합니다.
12,000 이상의 틈새 시장을 탐색해 보세요.

Nov 05, 2026에 업데이트됨
이 글에서 "AI 구매 질문"은 사람들이 ChatGPT, Gemini, Google AI Mode 등 AI 도구에 묻는 쇼핑, 비교, 가격 관련 질문을 뜻합니다.
여기서 "시장"은 세 가지 변수를 겹친 것입니다. 사용자의 국가나 지역, 질문 언어, 그리고 AI 플랫폼입니다. 이 중 하나만 바뀌어도 같은 구매 질문에 다른 답이 나올 수 있습니다. 영국과 미국은 같은 언어를 쓰지만 인도는 영어, 힌디어, 힝글리시가 섞여 있으므로 국가와 언어를 따로 기록해야 합니다.
위치만으로도 답변이 바뀔 수 있습니다. 2026년 10월에 공개된 테스트에서 Massive는 "카페 커피 한 잔의 일반적인 가격"을 묻는 같은 프롬프트를 미국, 브라질, 일본에서 동시에 ChatGPT에 보냈습니다. 프롬프트에는 국가가 없었습니다. 미국 답변은 달러로 제시했고, 브라질과 일본 답변에는 헤알과 엔 가격이 추가되었습니다. 국가마다 한 번만 실행했으므로 이 테스트는 효과가 존재한다는 것만 보여 줄 뿐, 얼마나 자주 일어나는지는 보여 주지 않습니다.
분석할 때는 두 층을 구분하세요. 질문 층은 사용자가 무엇을 물었고 어떤 조건을 붙였는지입니다. 답변 층은 AI가 어떤 출처를 썼고 어떤 브랜드를 추천했는지입니다. 어떤 시장에서 브랜드가 "사라졌다"면, 현지 사용자가 단지 다른 질문을 하고 있을 수도 있고, AI의 출처나 선호가 바뀌었을 수도 있습니다. 다음 네 섹션은 이 순서를 따릅니다.
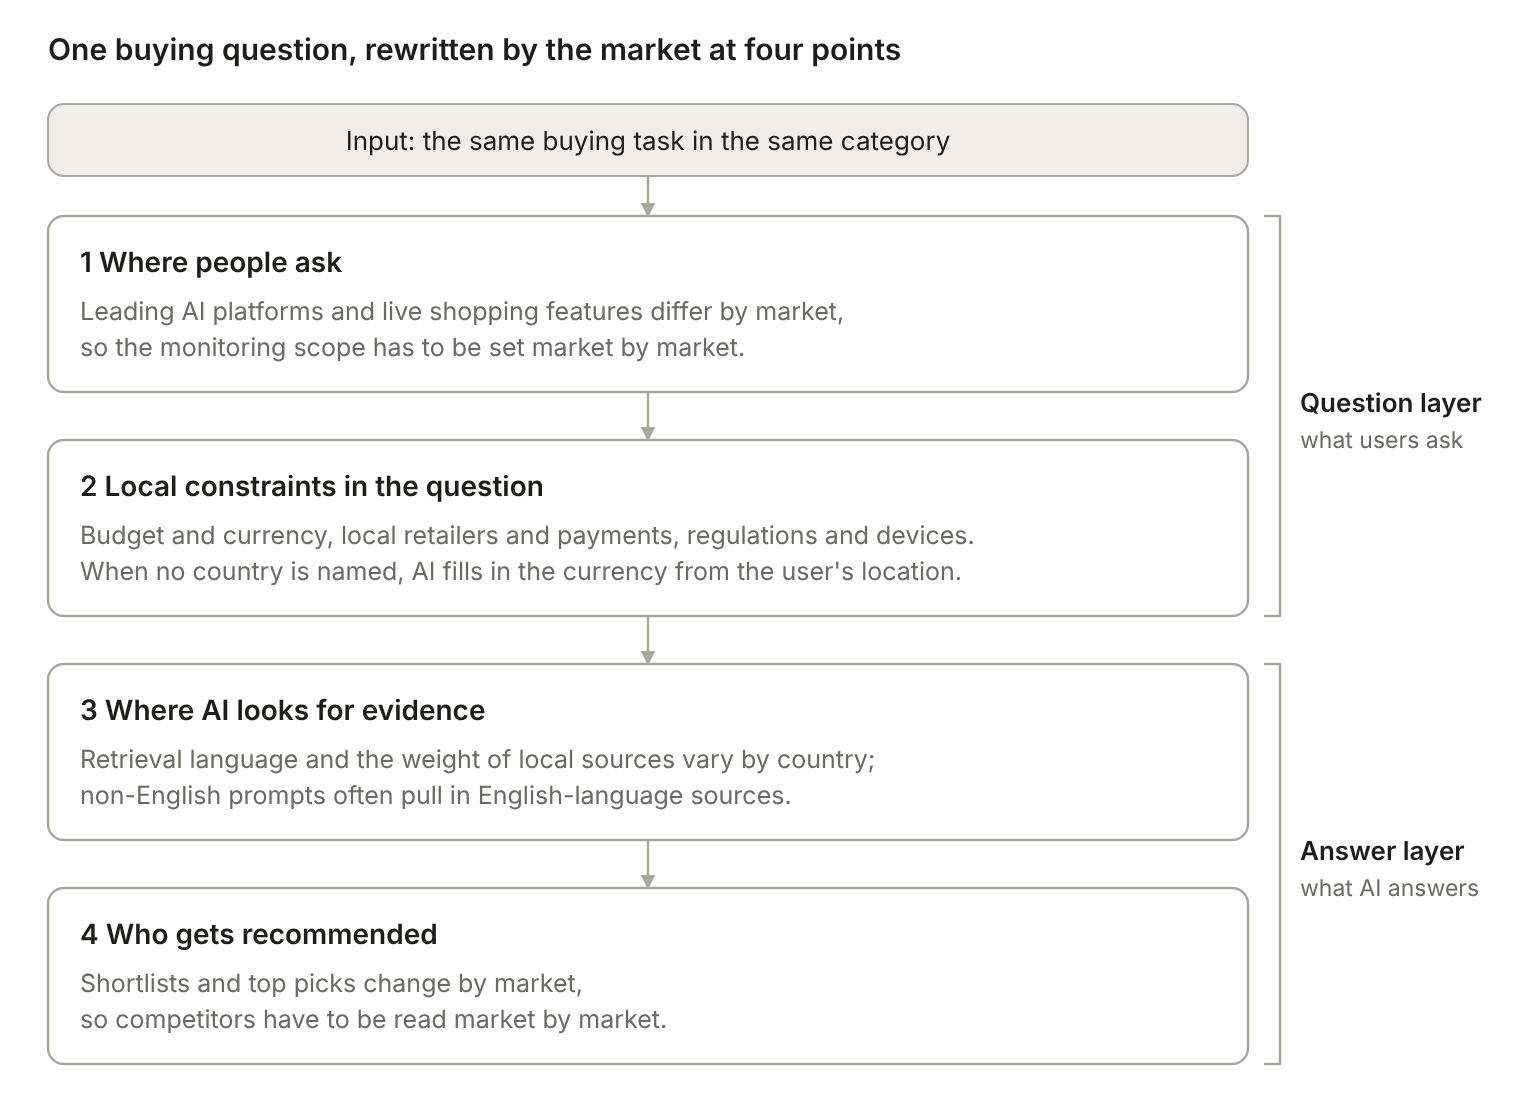
네 층의 차이. 아래 네 섹션에서 다룹니다.
ChatGPT는 주요 해외 시장 모두에서 1위지만 그 뒤의 순서는 다릅니다. Statcounter의 2026년 9월 데이터에서 아래 7개 시장 각각의 ChatGPT 비중은 약 74%~80%입니다. Gemini는 브라질, 일본, 인도에서 16%를 넘지만 영국에서는 약 10%입니다. Copilot은 미국과 일본에서 6%를 넘지만 인도에서는 2% 미만입니다. Perplexity는 독일과 프랑스에서 다른 시장보다 높습니다.
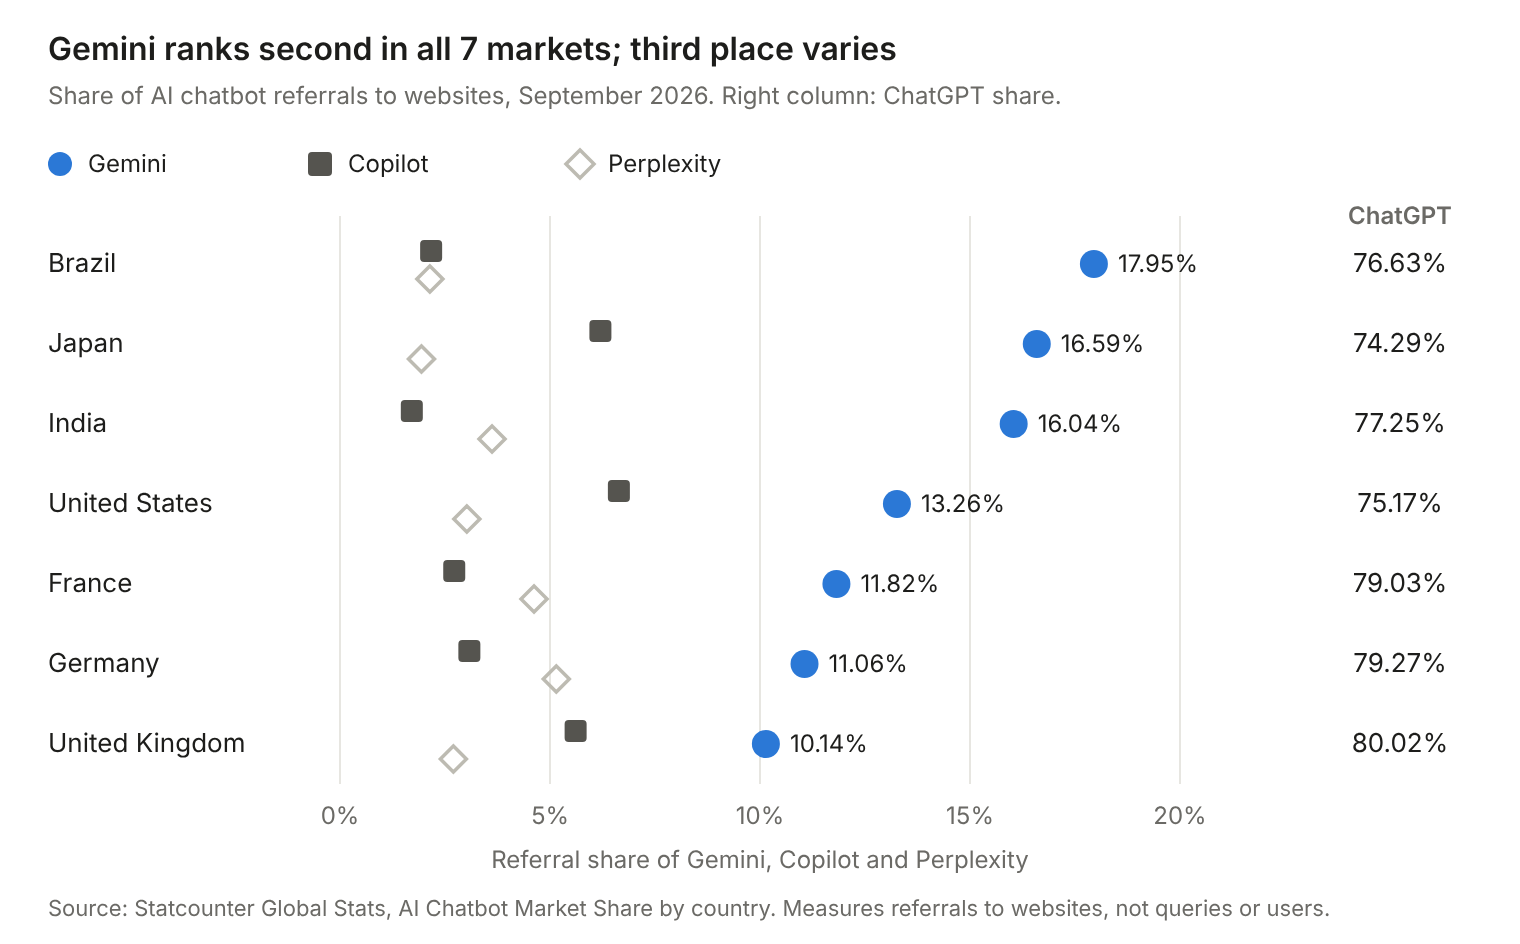
출처: Statcounter Global Stats, AI 챗봇 유입 비중, 2026년 9월, 7개 시장.
지표에 주의하세요. Statcounter가 측정하는 것은 각 챗봇이 웹사이트로 보내는 유입 비중(추적하는 사이트의 페이지뷰 기준)입니다. 질문 수나 사용자 수가 아니며, 유입 데이터를 넘기지 않는 Grok은 빠져 있습니다. 어떤 시장에서 어느 플랫폼이 사람들을 웹사이트로 보내는지는 알 수 있지만, 쇼핑 질문량을 추정하는 데는 쓸 수 없습니다.
설문 데이터도 같은 방향을 가리킵니다. Vercel이 의뢰한 World Retail Congress 설문(2026년 5월, 유럽 쇼핑객 4,000명)을 Pygmalios가 보도한 바에 따르면, 쇼핑할 때 ChatGPT를 쓰는 응답자는 남유럽 49%, 북유럽 40%, 독일 38%, 영국 33%였습니다. 영국 응답자의 절반은 쇼핑할 때 AI 검색을 전혀 쓰지 않았고, 남유럽은 32%였습니다. 이 수치는 자기 보고이며 남유럽과 북유럽은 여러 국가를 묶은 그룹입니다. Pygmalios도 "밝힌 의향은 관찰된 행동을 흔히 과장한다"고 주의를 줍니다.
기능 출시 순서도 차이를 만듭니다. OpenAI가 2025년 9월 29일 ChatGPT 안에서 Instant Checkout을 출시했을 때는 미국 사용자만 쓸 수 있었고, 판매자도 미국 Etsy 판매자뿐이었습니다. "대신 사 줘" 요청은 결제 기능이 있는 시장에서는 채팅 안에서 끝낼 수 있었지만, 다른 곳에서는 외부 사이트로 보내는 것만 가능했습니다. 2026년 10월 기준으로 이 기능이 어느 시장을 지원하는지는 확인하지 않았으니, 시장을 비교하기 전에 따로 확인하세요.
질문이 "무엇을 골라야 하나요"여도 시장마다 붙는 조건이 다릅니다. 질문 안에 적히는 조건도 있고, 사용자의 위치로 채워지는 조건도 있습니다.
모든 필요가 시장마다 다른 것은 아닙니다. 위의 World Retail Congress 설문에서 AI로 쇼핑하는 사람들의 가장 흔한 용도는 모든 지역에서 가격 비교였습니다(51%~55%). 우리의 판단: 질문의 행동은 시장 전반에서 비슷하고, 차이는 주로 예산 범위, 이용 가능한 채널, 현지 규칙에 있습니다. 그러니 질문을 정리할 때는 예산과 통화, 언급된 플랫폼, 결제와 배송, 규제, 기기 조건을 각각 별도의 열로 두세요.
영어가 아닌 시장의 구매 질문에서도 근거의 상당 부분은 여전히 영어 웹페이지에서 나옵니다. Peec AI는 ChatGPT 프롬프트 1,000만 건 이상과 백그라운드 검색(쿼리 팬아웃) 2,000만 건 이상을 분석하면서, 사용자 위치와 프롬프트 언어가 일치하는 세션만 남겼습니다. 영어가 아닌 세션의 약 78%에서 영어 조사가 추가되었고, 영어가 아닌 프롬프트의 팬아웃 중 43%는 영어로 실행되었습니다. 언어별로는 터키어 세션이 영어 조사를 가장 많이(94%), 스페인어 세션이 가장 적게(66%) 추가했습니다.
현지 출처의 비중도 국가마다 다릅니다. FTA Global의 테스트에서 인용 출처 중 현지 도메인과 매체의 비중은 독일 42%, 프랑스 34%, 인도 17%였습니다. 현지 출처의 비중이 낮은 곳에서는 현지 브랜드가 답변에 들어가려면 영어 사이트나 해외 사이트에 노출되어야 할 수 있습니다. Peec AI의 수동 테스트에 예가 하나 있습니다. 폴란드 IP 주소에서 폴란드어로 최고의 경매 사이트를 물었더니, ChatGPT는 폴란드 1위 현지 플랫폼인 Allegro를 빼거나 목록 한참 아래에 두었습니다. 이는 사례 하나일 뿐 통계 결과가 아닙니다.
AI 답변에 대한 신뢰도 다릅니다. 같은 Deloitte 설문에서 AI가 제공하는 정보를 믿는다는 응답은 스페인 61%, 핀란드 36%였습니다. 우리의 가설: 신뢰가 낮은 시장일수록 사용자는 출처, 리뷰, 사후 서비스 보장을 더 확인하려 하므로 현지에서 검증 가능한 자료가 더 중요합니다. 이를 직접 검증한 공개 데이터는 아직 없습니다.
앞의 세 가지 차이가 겹치면 사용자가 보는 후보 목록이 달라집니다. FTA Global은 "뉴욕 + 영어"를 기준으로 같은 소규모 사업자 구매 질문을 런던, 마드리드, 파리, 베를린, 인도 세 도시에서 반복했습니다.
언어도 1순위를 바꿉니다. SALT.agency 공동 창업자 Reza Moaiandin이 Search Engine Journal에 발표한 테스트는 같은 구매 질문 묶음을 영어, 아랍어, 러시아어, 중국어 간체, 페르시아어로 물었습니다. 핵심 테스트는 웹 검색을 끈 Claude Sonnet 5를 썼고, 2026년 9월 7일에 수집했으며, 시나리오와 언어 조합마다 40번 실행했습니다. 표는 각 브랜드가 1순위였던 답변의 비율입니다.
| 시나리오 | 브랜드 | 가장 높은 비율 | 가장 낮은 비율 |
|---|---|---|---|
| 런던–테네리페 왕복 항공권 | easyJet | 러시아어 72.5% | 페르시아어 12.5% |
| 400파운드 이하 노이즈 캔슬링 헤드폰 | Sony | 러시아어와 페르시아어 100% | 영어 50% |
| 영국 소규모 사업자용 CRM | HubSpot CRM | 영어 22.5% | 아랍어 2.5% |
| 500파운드 이하 로봇 청소기 | Roborock | 러시아어 97.5% | 영어와 아랍어 87.5% |
로봇 청소기 행은 모든 카테고리가 크게 흔들리지는 않는다는 것을 보여 줍니다. 같은 테스트에서 두 카테고리에 웹 검색을 켜자 카테고리와 언어 조합 10개 중 7개에서 1순위가 바뀌었습니다. 같은 두 카테고리에서 검색을 끈 상태로 보면, ChatGPT의 1순위가 Claude와 일치한 조합은 10개 중 1개뿐이었고 Gemini와는 5개였습니다. 저자는 데이터를 한나절 동안 수집했으며 결과는 방향성을 보여 주는 정도라고 밝힙니다.
학술 연구에서도 비슷한 경향이 보입니다. EMNLP 2024 논문 "Global is Good, Local is Bad?"는 LLM이 긍정적인 속성을 글로벌 브랜드와 더 자주 연결하고, 고소득 국가 사람들에게 고급 선물을 지나치게 많이 추천한다는 것을 발견했습니다. 다만 특정 상황에서는 원산지 효과 때문에 현지 브랜드가 유리할 수도 있습니다. 브랜드 입장에서는 경쟁사가 시장마다 다르다는 뜻입니다. 미국에서 정면으로 맞붙는 브랜드들이 인도나 폴란드에서는 다른 현지 브랜드들로 바뀔 수 있습니다.
"국가 또는 지역 × 언어 × 플랫폼"을 가장 작은 비교 단위로 삼고 다섯 단계를 따르세요.
| 측면 | 시장마다 기록할 것 | 흔한 오해 |
|---|---|---|
| 어디서 묻는가 | 현지 주요 AI 플랫폼, 쇼핑 카드나 결제 같은 기능 제공 여부 | ChatGPT만, 미국 영어로만 테스트하기 |
| 질문 조건 | 원래 질문 문장, 예산과 통화, 언급된 플랫폼·결제·배송·규제·기기 | 번역한 영어 질문을 현지 질문으로 취급하기 |
| 근거 출처 | 인용된 URL, 출처 언어, 현지 사이트인지 해외 사이트인지 | 출처를 읽지 않고 도메인 수만 세기 |
| 추천 | 1순위, 상위 5개 목록, 자사 브랜드 등장 여부와 맥락 | 스크린샷 한 장으로 시장 전체를 대표하기 |
위의 네 가지 측면은 Dageno의 여러 기능에 대응합니다.
Dageno 데모 워크스페이스의 스마트워치 시장을 예로 들어 보겠습니다(Apple은 예시 브랜드일 뿐 Dageno 고객이 아닙니다). "Market overview → Platforms & regions"의 지역 표에서 Apple은 대부분의 시장에서 1위지만 스페인, 폴란드, 이탈리아에서는 2위이며, 그곳에서는 Garmin이 선두입니다.
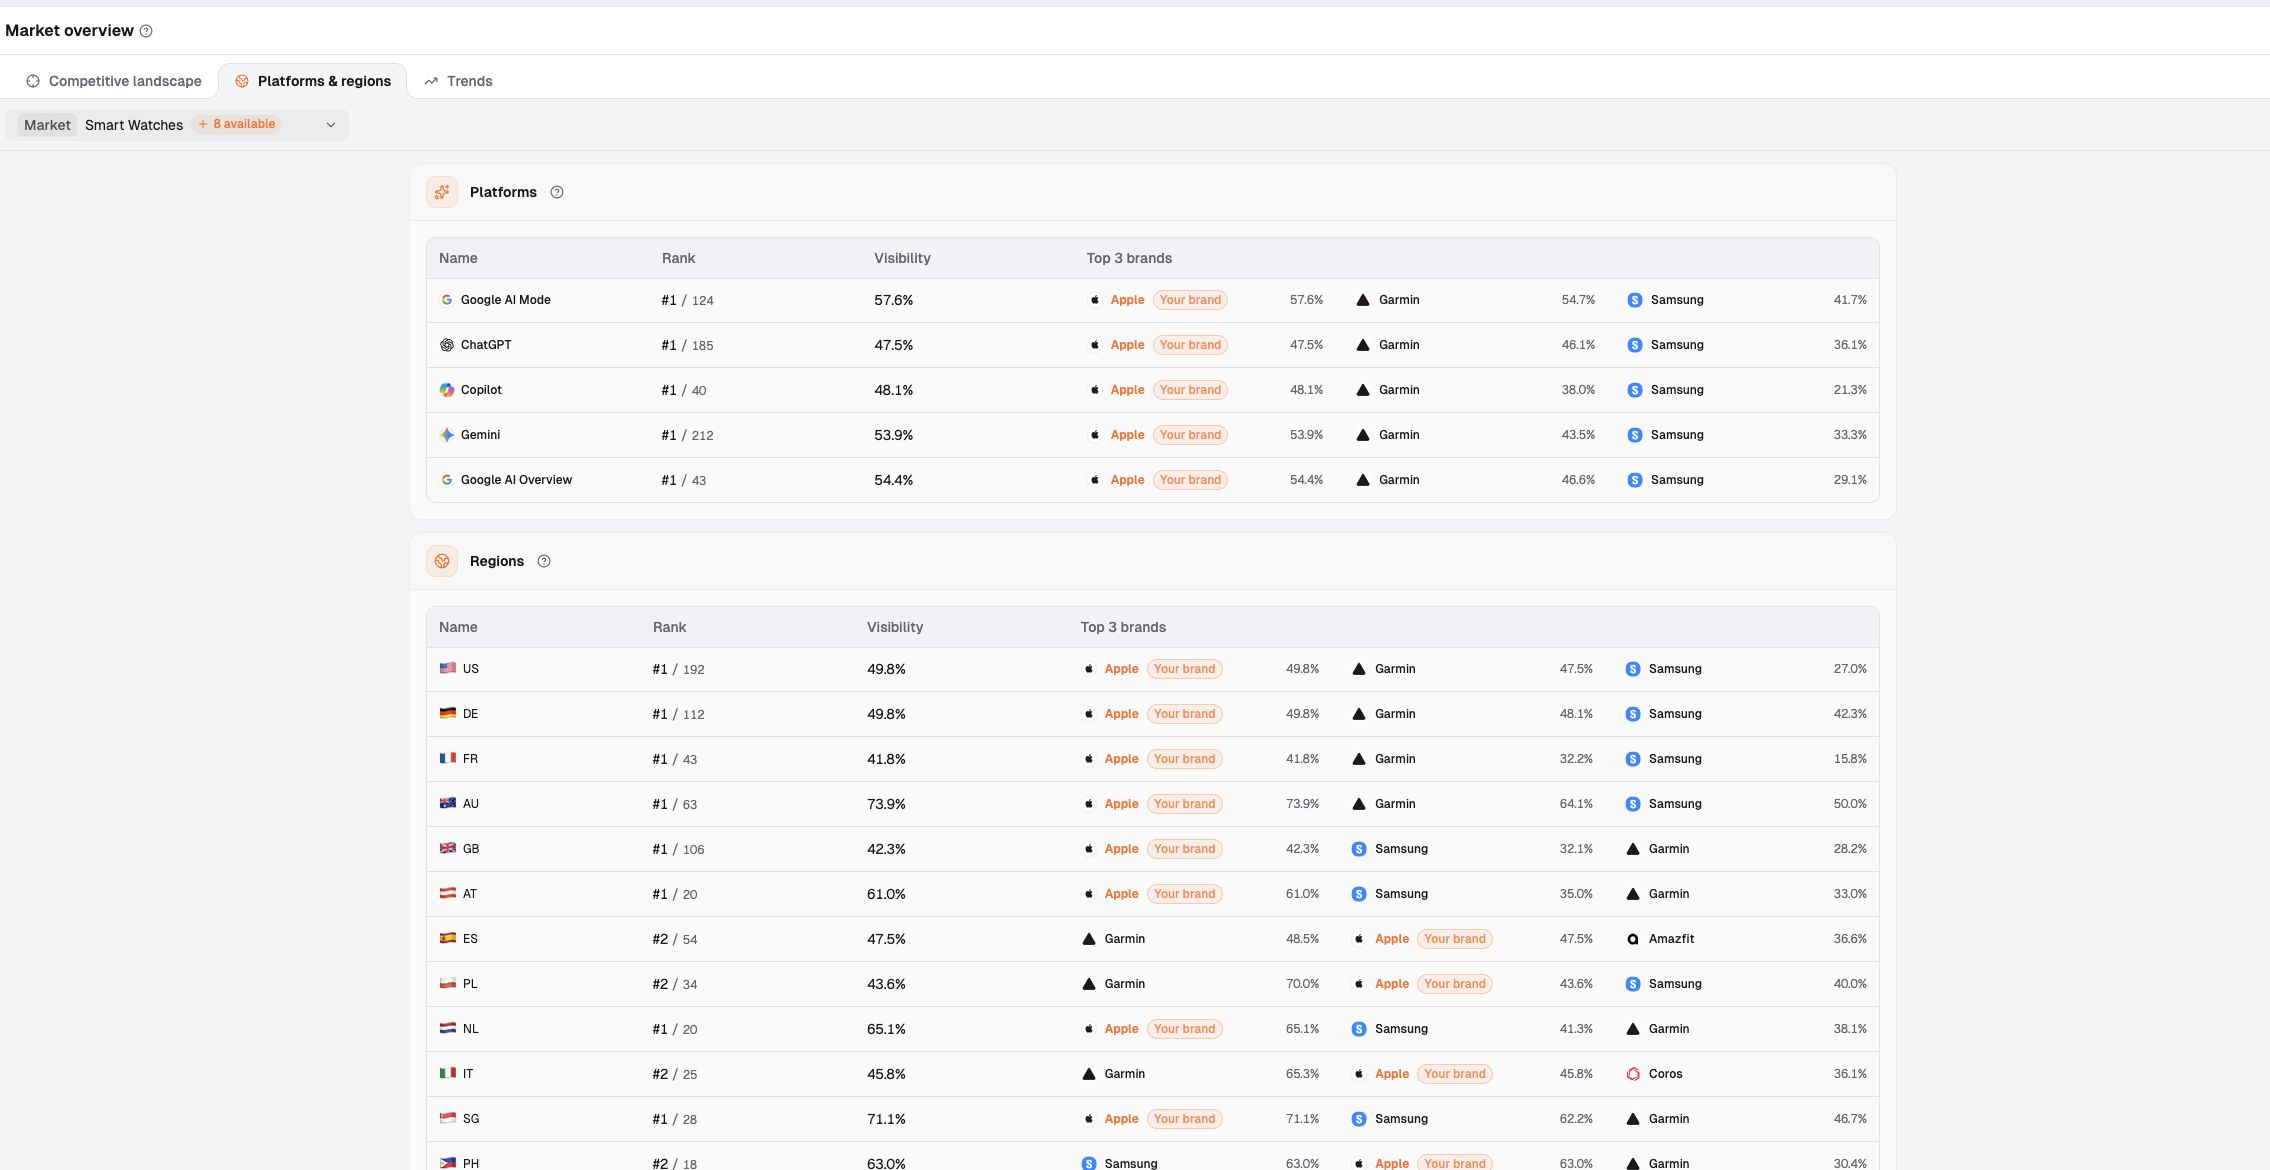
그림 1: 하나의 스마트워치 시장에서 브랜드 순위와 가시성을 AI 플랫폼별, 지역별로 나눈 화면.
지역 표는 어디부터 볼지만 알려 줍니다. 질문 자체를 보려면 답변을 열어야 합니다. Dageno가 공개한 사례 연구 지역별 AI 가시성: 페이지를 현지화해야 할 때에서 Apple은 인도에서 14위, 가시성 4.76%입니다. 답변을 읽어 보면 인도의 두 답변 모두 ₹5,000 이하 시계를 추천하는데, Apple 인도 사이트는 Apple Watch SE 3를 ₹29,900부터 판매하고 있었습니다(사례 연구에 따르면 2026년 9월 30일 확인).
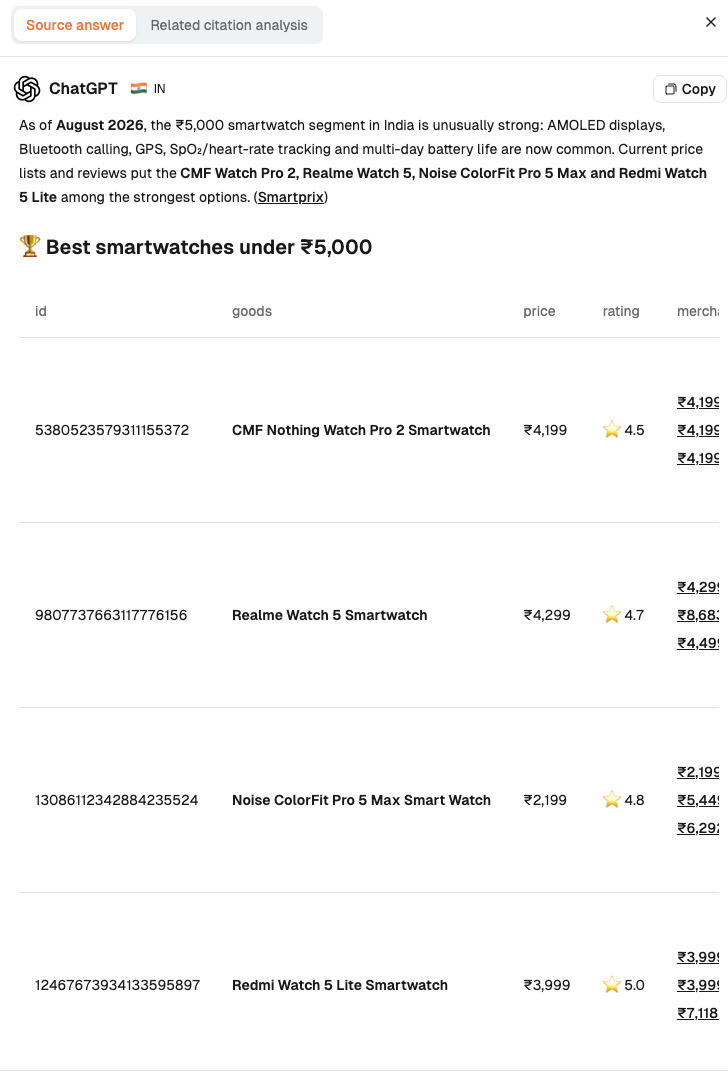
그림 2: 인도(IN) ChatGPT 답변. 질문이 ₹5,000 이하로 한정되어 있습니다.
반면 폴란드 답변은 폴란드어이고 예산은 1500 zł입니다. Amazfit, Garmin, Huawei, Samsung 등의 시계를 추천하며, 인용은 주로 euro.com.pl, ceneo.pl, mediamarkt.pl, allegro.pl 같은 현지 소매·가격 비교 사이트에서 나왔습니다.
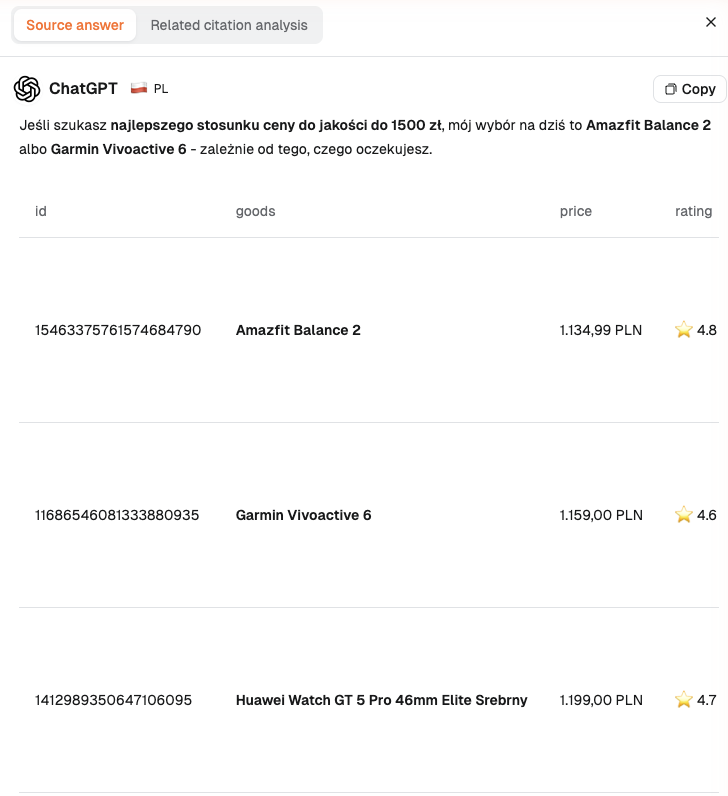
그림 3: 폴란드(PL) ChatGPT 답변. 1500 zł 예산 안의 시계를 폴란드어로 추천합니다.
이 두 시장은 위에서 설명한 두 종류의 차이에 해당합니다. 인도에서는 질문의 예산 조건이 바뀌었고, 폴란드에서는 언어와 현지 출처가 바뀌었습니다. 표본이 작기 때문에(인도는 답변 2개, 폴란드는 비교 가능한 답변 1개뿐) 사례 연구는 인도를 "비대상 질문으로 표시", 폴란드를 "계속 관찰"로 결론 냈습니다.
이 화면들은 저장된 AI 답변을 기록한 것입니다. Dageno 시장 확장 페이지의 표현대로, 시장 간 AI 가시성은 "총수요, 시장 규모, 판매 잠재력, 시장 점유율, 구매자 선호를 측정하지 않습니다". 시장을 고르려면 여전히 자체 조사와 제품, 채널, 규정 준수 검토가 필요합니다. Dageno 블로그에 따르면 무료 조회는 86개 국가와 지역, 12,000개 시장 세그먼트를 다루므로, 먼저 타깃 시장에서 브랜드가 어디에 있는지 확인하는 것부터 시작할 수 있습니다.
시장을 비교할 때 다음 요인은 "시장 차이"로 착각하기 쉽고, 비교 비용을 예상보다 키울 수도 있습니다.
"같은 과제를 현지 언어로 물은 것"으로서만 그렇습니다. 현지 예산, 채널, 일상적인 표현은 담지 못합니다. 번역한 질문은 시장 간 대조용 묶음으로 쓰고, 현지 검색 추천어, 포럼, 고객 서비스 기록에서 모은 현지 표현을 추가하세요.
현지 구매자가 실제로 쓰는 언어를 따르세요. 인도, 스위스, 캐나다 같은 다언어 시장에서는 최소한 주요 언어를 따로 테스트하세요. 구매자 일부가 영어로 묻는다면(예: 다국적 기업 구매팀) 영어 표현도 따로 기록하세요.
정해진 숫자는 없습니다. 공개 테스트에서 FTA Global은 조건마다 5번, SALT는 40번 실행했습니다. 우리의 권장: 반복 실행에서 1순위가 안정될 때까지는 시장에 대한 결론을 내리지 말고, 변동이 큰 카테고리에서는 표본을 더 늘리세요.
대부분의 시장에서는 부족합니다. ChatGPT의 유입 비중이 가장 크지만 일부 시장에서는 Gemini가 16%를 넘고, 같은 질문에서 ChatGPT와 Gemini의 상위 5개 브랜드 중 겹치는 것은 평균 3.2개뿐입니다. 최소한 시장마다 두 번째와 세 번째로 큰 플랫폼을 추가하세요.
아닙니다. 먼저 질문 자체가 다른지 확인하세요. 예를 들어 예산이 자사 제품 라인보다 낮은 경우입니다. 그다음 제품이 현지에서 판매되는지, 현지 출처가 무엇을 말하는지 확인하세요. 현지 사실이 실제로 다르고, 반복 표본에서도 브랜드가 계속 빠질 때만 현지화 페이지를 만들 가치가 있습니다.
해외 시장별 AI 구매 질문은 네 층에서 다릅니다. 사람들이 어떤 플랫폼에 묻는지, 질문에 어떤 조건이 붙는지, AI가 어디서 근거를 얻는지, 그리고 최종적으로 누구를 추천하는지입니다. 공개 테스트는 이미 미국 영어 결과만 보면 후보 목록의 절반 이상에서 판단을 그르칠 수 있음을 보여 줍니다(FTA Global의 소프트웨어 카테고리 테스트에서 상위 5개 중 평균 2.9개가 바뀌었습니다). 다만 현지 사용자가 실제로 어떻게 묻는지에 대한 공개 데이터는 아직 부족하므로, 모든 브랜드가 자사 시장과 카테고리에서 직접 표본을 수집해야 합니다.
더 읽을거리:
Dageno is the research and insights team at Dageno AI, publishing industry reports and expert analysis on AI Search Visibility, Generative Engine Optimization (GEO), and AI-powered search discovery.
Read full bio Alexa for Shopping
