あるAIモデルはブランドに触れ、別のモデルは触れない。スマートウォッチの事例から、異なる質問が見かけ上の矛盾を生む仕組みと、次の一手が比較可能な回答を増やすことである理由を解説します。
12,000以上のニッチ市場を探索

Nov 05, 2026に更新されました
ダッシュボードのスマートウォッチ市場を例にします。今回個別に記録した回答の中には、オーストラリアのこのサブインテントについて、Google AI Mode と Copilot の回答が 1 件もありませんでした。調査担当者は、これらのセルを「Apple はこれらのモデルに出てこない」ではなく「このセットに回答なし」と記録すべきです。この区別はモニタリングに影響します。回答があるモデルだけが、その回答がブランドに触れているかを評価できるからです。その他のモデルは、確認できる記録が出てくるまで観察リストに置いておきます。
Issues & opportunities に進み、Opportunity overview を開いて LLM coverage gap カードを選びます。View analysis をクリックし、続いて View related AI responses をクリックします。ボタンにはサブインテントの回答総数である 203 が表示されますが、開いたリストに含まれるのは 9 件だけで、すべて Apple に触れていない Google AI Overview の回答です。モデルと地域をまたいだ 203 件すべてを見るには、Demand & insights → Search intents → Recommendations → See top recommendations → View AI responses と進みます。オーストラリアを確認するときは、各回答の上部にあるモデルと地域のラベルを読みます。
カードには、Google AI Overview における Apple の Model visibility が 35.71%、Model median が 72.00%、Visibility gap が 36.29% と表示され、優先度は Medium です。これは調査担当者に、どこで根拠を確認すべきかを教えてくれます。しかし、どの質問がこの差を生んだのかも、チームが修正すべきページも示していません。
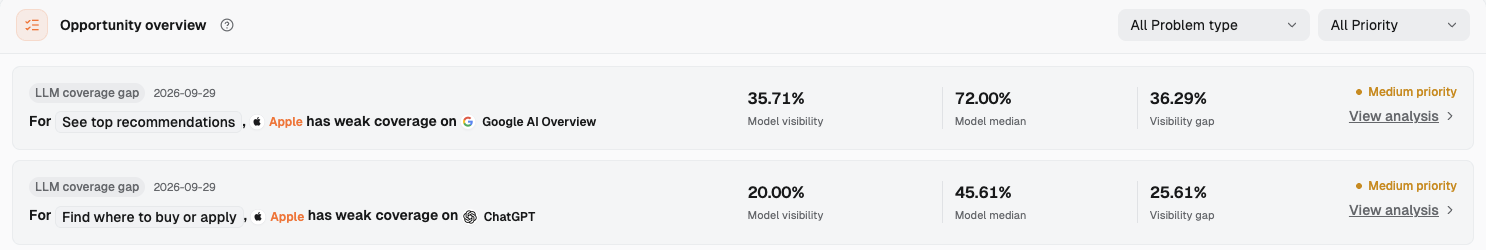
Opportunity overview の LLM coverage gap カード:See top recommendations について、Google AI Overview における Apple の Model visibility は 35.71%、Model median は 72.00%、Visibility gap は 36.29% で、優先度は Medium です。2 枚目のカードは、ChatGPT で同じ種類の差が出ていることを記録しています。
このサブインテントの 203 件の回答を 1 件ずつ記録すると、Google AI Overview の回答は 14 件で、そのうち 5 件が Apple に触れています。カードから開く関連回答リストには、残りの 9 件がちょうど入っており、これらはニーズと地域で分類する必要があります。回答にブランドが出てこないというのは、その 1 件の回答についての記述です。特定の質問の推薦からブランドが抜けていると言うには、その回答が、ブランドが候補になりうる購入の選択を扱っていたかどうかも知る必要があります。ブランドのページが引用されていることは別の観察であり、回答本文での推薦の代わりにはなりません。
Evidence preview で Source answer を読み、続いて Related citation analysis を読みます。上部のモデルと地域、回答内のブランド名、そしてそのブランドが推薦されたのか、ついでに言及されただけか、引用ページにしか出てこなかったのかを記録します。こうすることで、「出てこない」を分析する単位がはっきりします。
オーストラリアの子ども向け見守りウォッチについての Google AI Overview の回答は 4 件で、どれも Apple に触れていません。これは特定のニーズについてのシグナルです。しかし現在の記録では、ほかのモデルには同じ地域で子ども向けウォッチに該当する回答がないため、チームはどちら側にも比較可能なサンプルを持っていません。1 つのモデルの回答が何件あっても、グループ内の質問が異なれば、同じ質問への回答の代わりにはなりません。
調査担当者は、次にどの質問を収集するか、モデルごとに完全な回答を何件残すか、いつ見直すかを事前に決めておけます。チームが行動に移るべき「この件数なら十分」という普遍的な数値は、現在の根拠からは得られません。まず回答が同じ地域の同じ質問に答えているかを確認し、それから新しい回答でもブランドの欠落が続くかを見ます。
市場ビューはサブインテントごとに回答をまとめるため、ある種類の需要での異常を見つけるのに役立ちます。ブランドの推薦を比べるには、地域、言語、そして質問そのものも固定する必要があります。「スマートフォンユーザー向けにスマートウォッチを選ぶ」と「子ども向けに位置情報付きの見守りウォッチを選ぶ」はどちらも Recommendations に入りえますが、購買者の条件は異なります。これらを混ぜると、質問の違いがモデルの違いのように見えてしまいます。
完全な回答ごとに、モデル、地域、回答が扱っていると思われる質問、ブランドに触れているか、ブランドをはっきり推薦しているかを記録します。回答数はモデルごとに分けて報告します。リスト全体の合計は、どちらのモデルの分母でもありません。リストにはモデルのフィルターがないため、回答上部のラベルを人が 1 件ずつ確認して記録する必要があります。同じ回答は、何度開き直しても 1 回だけ数えます。
個々の回答にはばらつきがあります。SparkToro と Gumshoe による AI の推薦の一貫性に関する調査では、同じ質問に繰り返し答えさせたときにブランドのリストが変わることが記録されています。AI プラットフォームをまたいでブランドの推薦を確認するためのガイドでは、繰り返しの回答がなぜ重要かを説明しています。ここではそれより前に、比べようとしている回答がそもそも同じニーズを扱っているかを確認します。
LLM coverage gap カードは、Google AI Overview を優先度 Medium としています。Apple の 35.71% が Model median の 72.00% を下回り、差は 36.29% です。View analysis を開くと、Where the problem occurs の下に What the user is doing、Sub-intents、Observed result が表示されます。続いて関連回答を開きます。カードが示すのは調査の出発点です。その手がかりが行動に値するかどうかは、個々の回答で決まります。
Google AI Overview の 14 件のうち、5 件が Apple に触れています。残りの 9 件を回答内容で分けると、4 つのグループになります。3 件はベルギーまたはオランダでの Garmin のウォッチ、1 件はポーランドでの Garett のウォッチ、1 件はスペイン語の文脈でスポーツ用スマートウォッチとは何かの説明、4 件はオーストラリアでの子ども向けの見守り・位置情報ウォッチについてです。特定ブランドの回答と定義の回答は、Apple が抜け落ちたと言える、比較可能な自由回答型の購入推薦ではありません。詳しく見る価値があるのは、オーストラリアの子ども向けウォッチのグループです。
ある回答は次のように始まります。"The top 5 highly-rated child safety smartwatches with GPS tracking are Spacetalk Adventurer 2, TickTalk 5, Gabb Watch 3e, Xplora X6 Play, and Garmin Bounce."(GPS 追跡付きで評価の高い子ども向け見守りスマートウォッチのトップ 5 は、Spacetalk Adventurer 2、TickTalk 5、Gabb Watch 3e、Xplora X6 Play、Garmin Bounce です。)別の回答は次のように始まります。"Top kids smartwatches feature real-time GPS tracking combined with 4G LTE calling, geofencing "safe zones," and SOS buttons."(人気の子ども向けスマートウォッチは、リアルタイムの GPS 追跡に加え、4G LTE 通話、ジオフェンスによる「安全ゾーン」、SOS ボタンを備えています。)これらの原文は、回答が扱っているニーズを示しています。そこに出てくるブランドは、引用した回答の一部です。
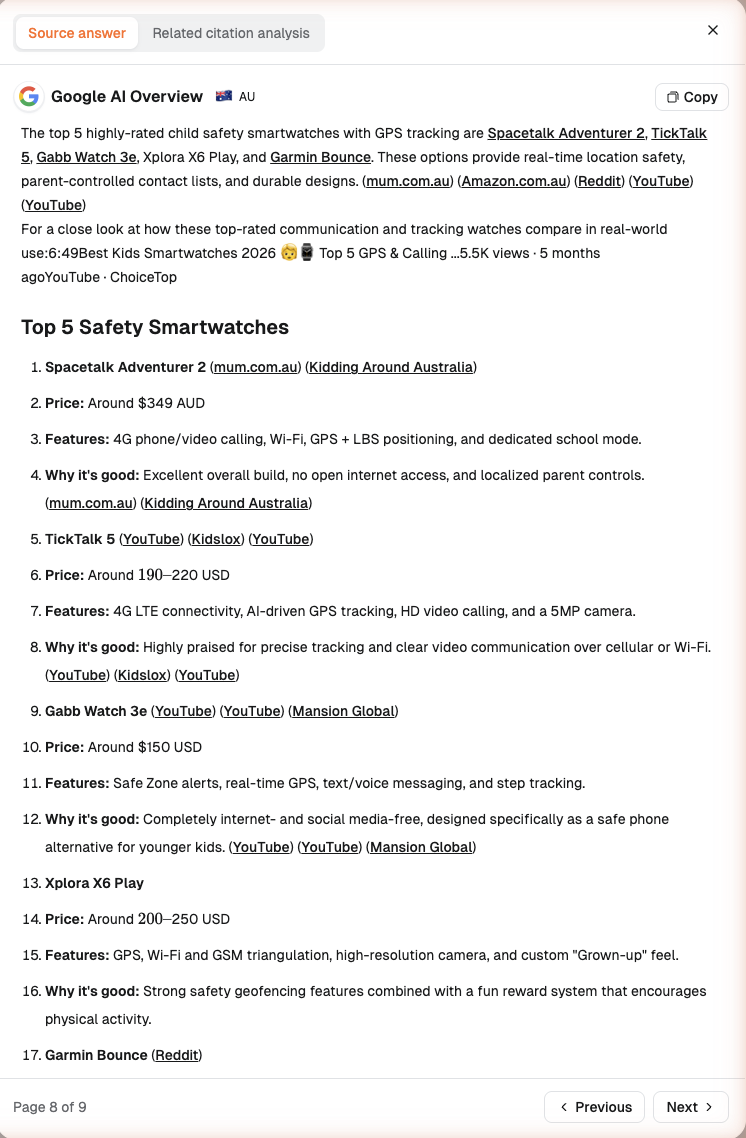
カードからは 9 件の関連回答が開きます。これは 8 件目で、オーストラリア(AU)の Google AI Overview の回答です。子ども向けの見守り・位置情報ウォッチを挙げていますが、Apple には触れていません。
同じサブインテントと地域では、ChatGPT の回答 5 件と Gemini の回答 3 件のすべてが Apple に触れています。内容から判断すると、この 8 件のどれも子ども向け見守りウォッチの質問を扱っていません。詳しく読んだいくつかの回答は、一般的なスマートウォッチやスポーツウォッチについてのものでした。ある ChatGPT の回答はこう述べています。"If you're shopping for a smartwatch right now in 2026, these are the standouts. The biggest factor is your phone: Apple Watches are for iPhone …"(2026 年の今スマートウォッチを買うなら、これらが注目のモデルです。最大の決め手はスマートフォンで、Apple Watch は iPhone 向けです……)この回答が扱っているのはスマートフォンとの互換性であり、子どもの安全や位置情報の追跡ではありません。これらは1 つのサブインテントの中の異なる質問です。現在の記録には、同じ子ども向けウォッチの質問に対して、ほかのモデルが Apple を推薦した回答はありません。
つまりこのカードは、確認する価値のある回答を見つける手段になります。無関係な質問を分け、それからどのサンプルを追加するかを決めます。この事例で不足しているのは、オーストラリアの同じ子ども向け見守りウォッチの質問に対する、異なるモデルの回答です。ページを修正するタスクは、その後の話です。
View related AI responses のリストにも View AI responses のリストにもモデルのフィルターはなく、Evidence preview には元のプロンプトが表示されません。調査担当者は回答内容からおおよそ何を扱っているかを判断できますが、これらの記録から各質問の正確な文言を再現することはできません。See top recommendations は、一般的な買い物、特定ブランド、子ども向け見守りウォッチについての回答を含むサブインテントです。本当にモデル間の差があるかを検証するには、クライアントが追跡したい同じ質問を Monitored prompts に登録し、選んだモデルから回答を集める必要があります。
Monitoring settings の下にある Monitored prompts のリストには、#、Prompt、Platforms、Regions、Answers、Brands、Details、Leading、Status が表示されます。この事例は、クライアントが 1 つの固定した質問でモニタリングした回答ではなく市場データを使っているため、質問の文言を一字一句確認することはできません。次のモニタリングでは、プロンプトの文面を保存し、実際に返ってきた回答を確認します。これらの市場の回答を、同じ文言ですでに実行されたものとして扱わないでください。
各回答の上部には、Google AI Overview と AU のように、モデルと地域が表示されます。これらのラベルで回答をグループ分けし、選んだ地域に各モデルの記録が実際にあるかを確認します。Market overview の Platforms & regions は範囲を絞るのに役立ちますが、判断の根拠はその中の完全な回答です。地域ラベルが同じだけでは不十分で、スマートウォッチの回答をまとめる前に、言語と回答内容を確認します。
オーストラリアの既存の記録から、Google AI Overview、ChatGPT、Gemini を同じ地域の確認リストに入れます。1 つの固定した子ども向けウォッチの質問でモデル間の件数を比べるのは、次の回の回答からになります。Google AI Mode と Copilot は、今回この範囲で記録した回答に出てこなかったので、観察を続けます。購買者がどのモデルを使っているか、オーストラリアが優先市場かどうかは、市場調査担当者がクライアント側の根拠で確認する必要があります。
Evidence preview には収集日時が表示されません。回答リストにも、元のプロンプトや収集日時は表示されません。調査担当者がカードを開いた日は確認日であり、回答が実行された日ではありません。現在の記録からは、これらの過去の回答に共通する収集期間も特定できません。次の再テストは、保存できる新しい回答から始めます。各回について、質問、モデル、地域、言語、そしてチームが確認できる時期の情報を記録します。システムの収集日時が分からない場合は、「表示なし」と記録します。
子ども向け見守りウォッチが、自社製品の対象ユーザーや用途に合っているかも、ブランドが判断する必要があります。ダッシュボードが示すのは回答と出典であり、この質問に取り組むかどうかはブランドが決めることです。製品がその用途に合わないなら、coverage gap があるというだけで最適化の対象にする理由にはなりません。
オーストラリアの子ども向け見守りウォッチについての Google AI Overview の回答 4 件には、それぞれ 23、24、25、19 件の引用元が表示されています。個々の引用リストによく含まれるのは、safewise.com、harveynorman.com.au、reddit.com、youtube.com、forbes.com、kidslox.com、mum.com.au、garmin.com です。この 4 件の回答に表示された引用の中に、apple.com を指すものはありません。これは回答とその出典についての観察であり、あるサイトが出典にないことがブランドの欠落を引き起こしたとは言えません。Google のAI 機能とウェブサイトに関する公式ガイドによると、AI Overview は読者が詳しく調べられるよう関連リンクを表示します。表示されたリンクは、出典を確認する出発点になります。
ここで重要な画面は 2 つあります。Evidence preview の Related citation analysis は、個々の回答の引用を表示します。この事例では、カードのドロワーにある Sources used by the answers は No data と表示されます。出典を比べるときは、実際に開いた回答を使い、各引用 URL を対応する回答本文と一緒に保存します。ドロワーに No data と表示された場合は、その結果をそのまま報告します。
同じモデルは、オランダの子ども向けウォッチについての回答では Apple Watch SE に触れていました。"Voor oudere jeugd (Middelbare school): Een instapmodel zoals de Apple Watch SE of reguliere Samsung Galaxy Watch."(中高生くらいの年長の子どもには、Apple Watch SE のような入門モデルや通常の Samsung Galaxy Watch も選択肢になります。)この記録は、モデルを固定していても、地域や回答が想定する年齢層によって挙げられる選択肢が変わることを示しています。オランダの記録は、1 つのモデルの中での地域間の比較です。オーストラリアでのモデル間の比較には、同じ質問に対する新しい回答が必要です。
次の回で異なるモデルがオーストラリアの同じ子ども向けウォッチの質問に答えたら、各回答で挙げられた製品と引用されたページを比べます。どのページが関連製品を載せているか、どのページが選び方の基準を説明しているか、回答がどの情報を使っているかを確認します。回答と引用ページを比べる方法の全体は別の記事で扱っています。ここでは、このブランド欠落のシグナルに直接関係する出典の記録だけに絞っています。
この事例での判断は、まずサンプルを増やすことです。カードが示した coverage gap は調べる価値があります。しかし現在の記録には、オーストラリアの子ども向け見守りウォッチの回答と同じ質問に対する、ほかのモデルの回答がありません。gap はチームにどこを見るべきかを教え、回答の内容はそれらを比較できるかを教えます。そして、この用途をモニタリングの範囲に含めるかどうかはブランドが決めます。
| 見えていること | 現時点の結論 | 次の対応 | まだ言えない結論 |
|---|---|---|---|
| LLM coverage gap カードに 35.71%、72.00%、36.29% が表示される | 回答を開いて確認する | 関連回答ごとに質問、モデル、地域を確認する | すでに直すべきコンテンツの不足が見つかった |
| Apple に触れていない回答の一部は、特定ブランドや定義を扱っている | 比較可能な自由回答型の購入回答ではない | モデル間の比較から外し、元の記録は残す | 一般的な推薦で Apple が抜けていることを示している |
| オーストラリアの子ども向け見守りウォッチの回答 4 件すべてに Apple が出てこない | 特定のニーズについてのシグナルがある | ブランドが製品の適合を確認し、質問を固定してほかのモデルの回答を集める | 異なるモデルが同じ質問に正反対のブランド推薦をしていることが示された |
| 同じ地域の既存の ChatGPT と Gemini の回答は Apple に触れているが、一般的なスマートウォッチを扱っている | 回答は異なる質問を扱っているので、まず比較可能なサンプルを増やす | ChatGPT と Gemini に、Google AI Overview と同じ子ども向けウォッチの質問をする | ChatGPT や Gemini は子ども向けウォッチで Apple を推薦する |
| 今回確認した記録には、この地域の Google AI Mode と Copilot の回答がない | この 2 つのモデルについてブランドを判断する根拠はまだない | 観察リストに残し、新しい回答が出てきたら分類する | この 2 つのモデルに Apple が出てこない |
選んだモデルがまったく同じ質問に対して十分な数の比較可能な回答を返したら、その後の観測期間でもブランドの欠落が続くかを確認します。購買者がブランドの欠落しているモデルを使っていて、ブランドが製品がその質問に合っていると確認し、回答と引用が特定の情報の違いを示している場合に、ページへの事実の追加や第三者への資料提供を検討できます。ページの修正内容は、ニーズと出典についての検証可能な情報から選びます。今回の記録からは、まだそのような対応の対象は特定できていません。
関連する状況には、それぞれ別の診断方法があります。記録された回答があるすべてのモデルでブランドが出てこない場合は、AI の回答全体でブランドが出てこないときの診断方法を参照してください。ブランドは推薦に出てくるものの競合の後ろに置かれる場合は、AI の推薦で競合の後ろに置かれるブランドの診断方法を参照してください。言及、推薦、引用を区別するには、AI 検索での可視性を測るためのガイドを使います。
グループ分けは、次の判断のためにあります。コアモデルは、ブランド欠落の具体的なシグナルを持つモデルです。比較モデルにはまったく同じ質問に答えてもらい、本当の意味で横並びの比較をします。観察モデルは、現在の記録で使える回答がなかったモデルで、回答が出てきたときに分類します。次のモニタリング範囲は、この事例のために提案する方法です。モデル名と既存の根拠はダッシュボードから取っていますが、購買者の利用状況、観測期間、担当者はクライアントが確認する必要があります。
| グループ | モデル | 既存の根拠 | 固定する範囲と次に記録する結果 |
|---|---|---|---|
| コア | Google AI Overview | オーストラリアの子ども向け見守りウォッチの回答に Apple が出てこない | AU で子ども向けの見守り・位置情報ウォッチの質問を 1 つ固定し、完全な回答、ブランドへの言及、明確な推薦、引用元を保存する |
| 比較 | ChatGPT、Gemini | 同じ地域の一般的なスマートウォッチの回答は Apple に触れているが、子ども向けウォッチに該当する回答はない | コアモデルとまったく同じ質問と地域を使い、各回答が扱う用途を確認したうえで、言及、推薦、出典を記録する |
| 観察 | Google AI Mode、Copilot | 今回確認した記録には、このオーストラリアのサブインテントの回答がない | 同じ範囲の回答が出てきたら 1 件ずつ記録し、そのモデルをコアと比較のどちらに入れるかを判断する |
自社がこのブランドだとしたら、まず製品と市場の担当者に、子ども向けの見守り・位置情報ウォッチが製品の想定ユーザーに合っているか、そして購買者が実際にどのモデルを使っているかを確認します。確認が取れたら、市場調査担当者がプロンプト、地域、言語を 1 つずつ保存し、観測期間、再テストの頻度、担当者、終了条件を決めます。日付と実行回数はクライアントが決めることです。新しい回答が届く前にこれらのルールを決めておけば、結果を見てから比較のルールを変えることを防げます。
各回で、回答全文と引用を保存します。プロンプト、モデル、地域、言語、ブランドへの言及や明確な推薦の有無、そして確認できる時期の情報を記録します。比較グループでは、子ども向けウォッチの質問で比較可能な推薦があるかと、一般的な買い物の回答で既存の推薦が失われていないかの両方を確認します。実際にページを変更した場合は、何をいつ変えたかを記録します。次の再テストには新しく得た回答を使い、古い記録を開き直しても新しい結果にはなりません。AI の推薦が改善したかを検証する方法は、今後の観測期間と記録の計画に役立ちます。
市場調査担当者は、チームに次のようにはっきり伝えられます。システムは確認する価値のある coverage gap を見つけました。回答を分けてみると、オーストラリアでは子ども向け見守りウォッチのニーズについてブランド欠落のシグナルが見つかりましたが、既存のモデル間の記録は異なる質問を扱っていました。今回はまず、そのニーズが自社製品に合っているかをブランドが判断します。そのうえで、コアモデルと比較モデルに同じ質問に答えてもらい、新しい回答と引用を保存します。コンテンツの最適化に投資するかどうかは、購買者のモデル利用状況、繰り返しの観測、出典の根拠を確認してから決めます。
件数を並べて報告することはできますが、まず両方の回答が同じ質問に答えていることを確認してください。モデルごとの回答数を明記し、少ない側のサンプルを先に増やします。異なる質問への回答を合わせても、件数が似ていたとしてもモデルの違いは見えてきません。
言及として記録し、その前後の文章も残します。回答がそのニーズに対する選択肢としてブランドをはっきり挙げている場合にだけ、推薦として数えます。ブランドのページが引用されている場合は別に記録します。3 つを分けておくと、後の変化が回答本文に表れたのか、出典に表れたのかが分かります。
まず、新しい回答が同じ質問、地域、言語を使っているかを確認します。次に、購買者がそのモデルを使っているか、ブランドがその質問に合っているか、新しい回答が何を引用しているかを確認します。これらの条件がはっきりしたら、チームは対応すべき具体的なページの情報や第三者向けの資料を選び、同じ範囲で再テストを続けられます。
新しい地域には独自の起点となる記録を作り、元の地域は合意した質問で観察を続けます。毎回、地域と言語を記録します。こうすれば、地域ごとの時系列の変化を比べつつ、地域間の違いは別に確認できます。
まず、現在の根拠で裏付けられる確認リストから始めます。市場調査担当者に、既存の顧客調査やインタビューで購買者のモデル利用状況を確認してもらいます。そのうえで、どのモデルをコアのモニタリングに残し、どのモデルを比較や観察に回すかを決めます。ダッシュボードの回答数は、購買者の利用状況を測るものではありません。
Dageno is the research and insights team at Dageno AI, publishing industry reports and expert analysis on AI Search Visibility, Generative Engine Optimization (GEO), and AI-powered search discovery.
Read full bio Alexa for Shopping

