AIエージェントがユーザーの代わりに買い物にやって来ます。誰が中に入れるのか、誰の身元を使うのか、顧客データを誰が持つのか。Amazon、Shopify、Manusの例から、ウェブサイトとブランドが直面する選択を読み解きます。
12,000以上のニッチ市場を探索

Nov 05, 2026に更新されました
2026年9月20日の夜、MetaのMuseを使ってAmazonで買い物をしていた米国のユーザーの画面に、ポップアップが次々と表示されるようになりました。メッセージは率直でした。許可されていないAIエージェントによるアクセスを続けることは、あなたが同意したAmazonの利用規約に違反する、というものです。
その8日後、ManusはManus 2.0をリリースし、Cueという独立したアプリを公開しました。Cueでは、エージェント1つ1つが自分のメールアドレス、電話番号、ウォレット、コンピューターを持っています。
同じ日、Shopifyはブラウザで動くAIエージェントにチェックアウトを開放し、すぐ使えるツールを3つ用意しました。チェックアウトを読む、チェックアウトを更新する、注文を確定する、の3つです。
3つの製品発表として読むと、わかりやすい結論が見えてきます。個人向けAIエージェントの競争が激しくなっている、ということです。それは正しいのですが、もっと大きな論点を見逃しています。3つはどれも、同じ問いへの答えです。
ユーザーの代わりに動くエージェントが入口に来たとき、中に入れるかどうか、どの身元を使わせるか、入ったあと何をさせるかを、誰が決めるのか?
20年以上にわたり、SEOは人と検索エンジンにあなたを見つけてもらうためのものでした。今、新しい種類の訪問者が現れています。実在の人を代理し、その人の許可を持ち、ときには自分のウォレットまで持って、取引を完了するためにあなたのサイトにやって来ます。入口をめぐる争いは、「どのモデルが賢いか」から「誰が入れて、誰が支払い、取引のデータを誰が持つか」へと移りつつあります。
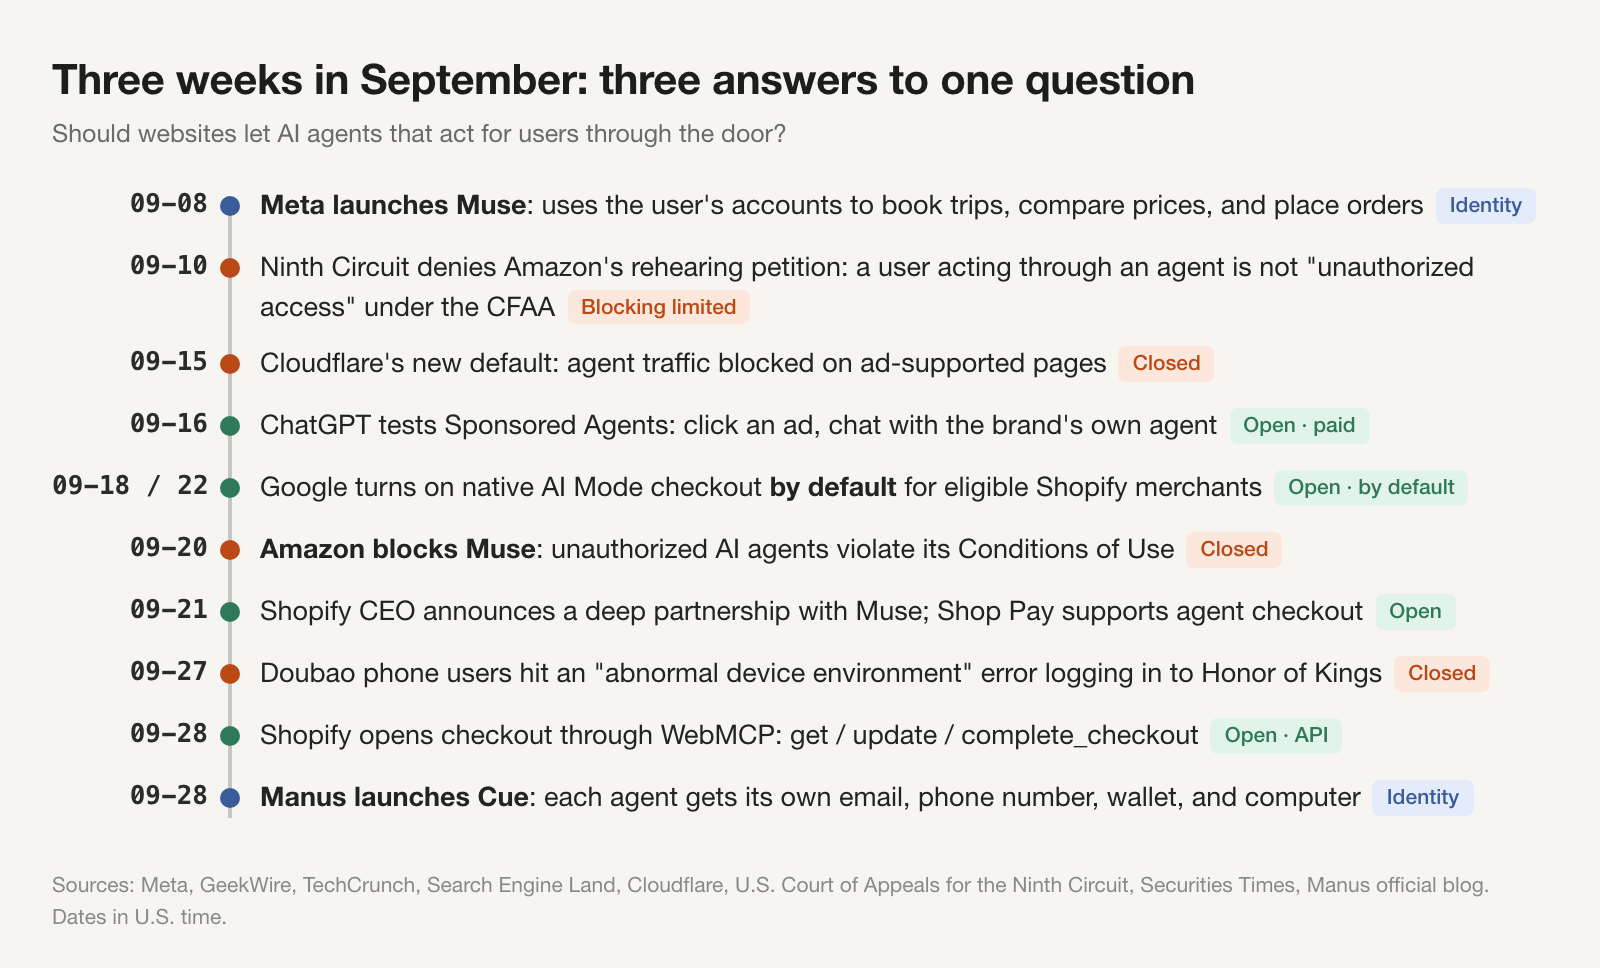
図1:9月の3週間で、プラットフォーム、ウェブサイト、インフラ事業者はAIエージェントにまったく異なる答えを出しました。
まずAmazon自身の理由から見ていきます。GeekWireの最初の報道とCNNの続報によると、Amazonの主張は主に4つです。
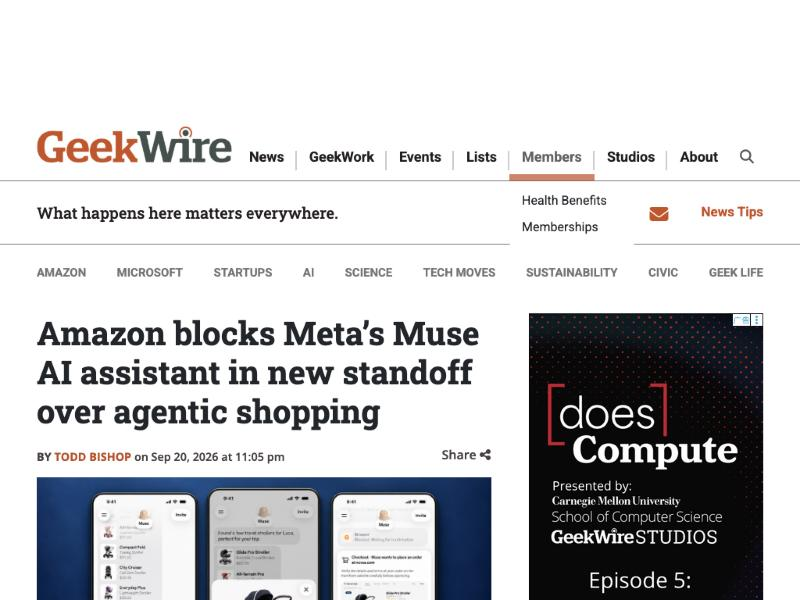
図2:GeekWireは9月20日の夜にこのニュースを報じました。画像は、Museがベビーカーを比較し、ユーザーに注文の承認を求めているMetaの宣伝用画像です。
これらの理由はどれも筋が通っています。ただし、どれも話の全体ではありません。
StratecheryのBen Thompsonは、この争いを「aggregator v. aggregator」(アグリゲーター同士)の戦いと位置づけ、最も重要な一文を指摘しました。「Muse doesn't see ads.」(Museは広告を見ない)です。
Amazonの広告収入は2025年に680億ドルを超えました。この事業は1つの前提の上に成り立っています。買い物客がAmazonのページで閲覧し、検索し、比較し、その途中でスポンサー商品を目にする、という前提です。ユーザーの代わりに価格を比べて注文するエージェントは、広告を見ず、棚を眺めず、掲載位置に影響されません。結果だけを持ち帰ります。Amazonにとって、これは新しい集客経路ではありません。広告の棚を迂回する道です。
Hacker Newsの議論では、あるコメント投稿者が、Amazonはボット向けのAPIを作り、利用規約でボットの振る舞いを管理すればいいと提案しました。すぐに別の人がこう返しました。Amazonの立場から見れば、それはまさに逆方向だ。Amazonが気にしているのは技術ではなく、中抜きされることだ、と。
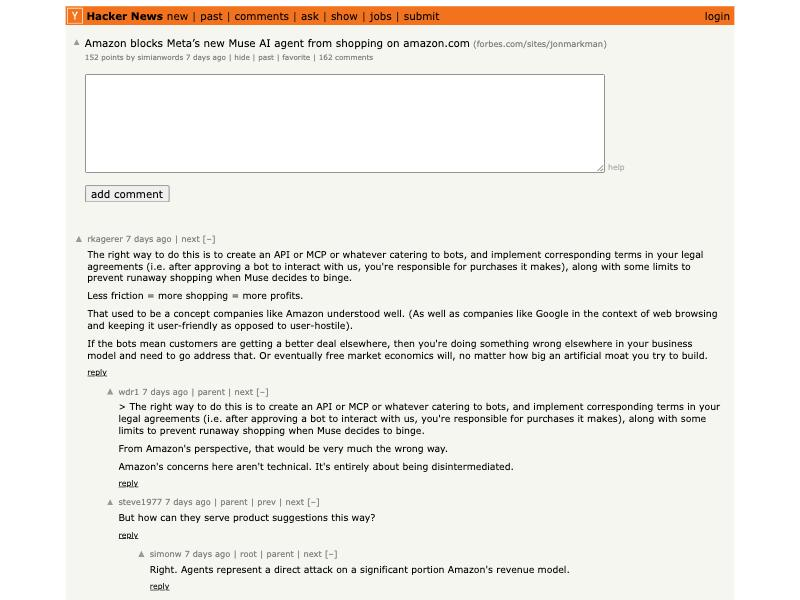
図3:Hacker Newsのスレッド(152ポイント、162コメント)。議論の中心は技術ではなく、顧客との関係を誰が持つかです。
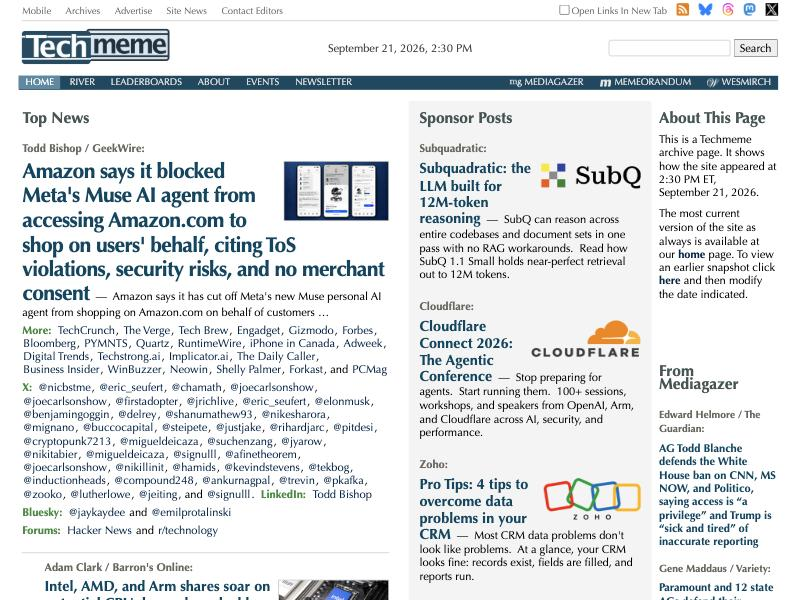
図3b:Techmemeのまとめ。Elon Musk、Chamath Palihapitiya、Nikesh Arora、Eric Seufertなど、数十人の業界関係者が議論に加わりました。
もう1つ注目すべき点があります。Amazon自身も同じことをしています。Buy for Me機能は、ユーザーの代わりに外部ブランドのサイトで注文します。2026年1月には、独立系の販売者が、このプログラムに初期設定で登録され、あとから外れることしか選べないことに抗議しました。2026年5月、AmazonはAlexaとRufusをAlexa for Shoppingに統合し、第2四半期の決算では、過去12か月で3億5,000万人以上が利用したと公表しました。
つまり、Amazonはエージェントによる買い物に反対しているわけではありません。反対しているのは、他社のエージェントが自社の棚で買い物をすることです。
SEOとウェブインフラの視点から見ると、この話で最も興味深いのはrobots.txtです。
私たちは2026年9月29日にamazon.com/robots.txtを取得しました。User-agentの宣言は101件あり、重複を除くと100種類の識別子になります。そのすべてがDisallow: /に設定されています。リストは網羅的です。OpenAIのGPTBot、OAI-SearchBot、ChatGPT-User、AnthropicのClaudeBot、Claude-User、GoogleのGoogle-Extended、GoogleAgent-Mariner、GoogleAgent-Shopping、Metaのmeta-externalagent、meta-externalfetcher、meta-webindexer、さらにPerplexity、Mistral、DeepSeek、xAI、そしてManus-Userまであります。
欠けている名前は1つだけ、Museです。
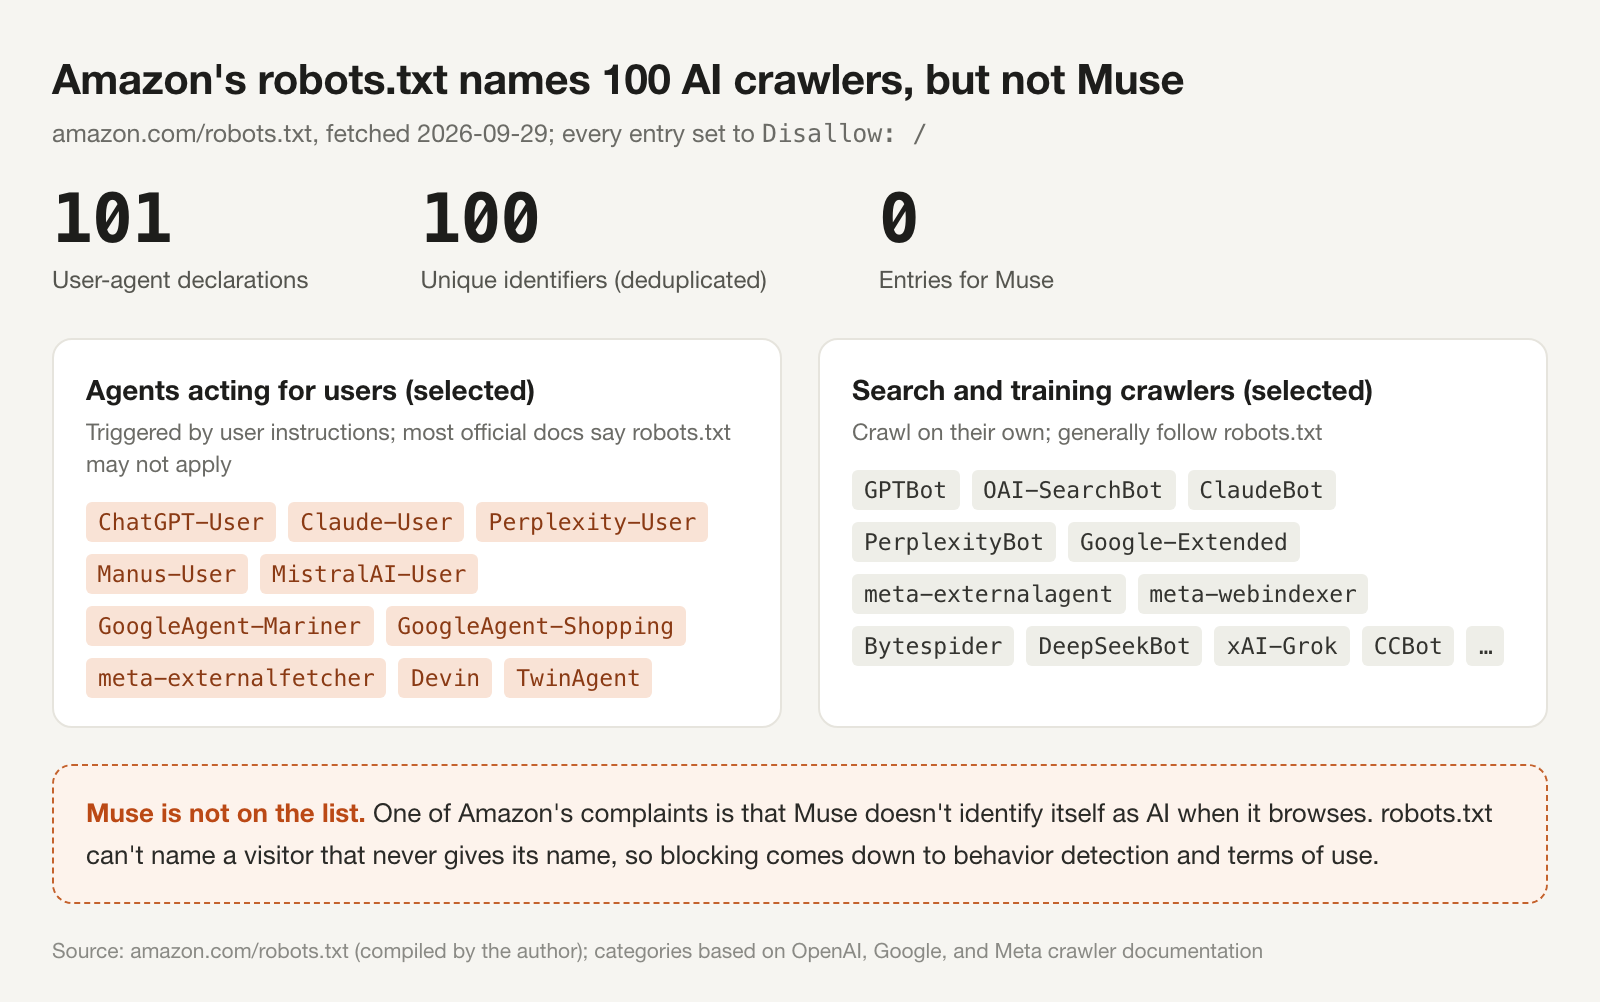
図4:Amazonのrobots.txtで名指しされているAIクローラーとエージェント。2026年9月29日に筆者が取得・整理。
Amazonは追加し忘れたのではありません。追加できなかったのです。Amazonの不満の1つは、まさにMuseが閲覧時に名乗らないことでした。robots.txtには、名前を名乗らない訪問者を名指しする方法がありません。
より根本的な問題は、robots.txtがそもそもユーザーの代わりに動くエージェントを想定して作られていないことです。OpenAIのドキュメントでは、クローラーを3種類に分けています。検索用のOAI-SearchBotと学習用のGPTBotはどちらもrobots.txtに従いますが、ユーザーが起動するChatGPT-Userについては、robots.txtのルールが「may not apply」(適用されない場合がある)と書かれています。2026年3月、Googleは「ユーザーが起動するフェッチャー」に関するドキュメントにGoogle-Agentを加えました。このカテゴリも一般にrobots.txtに従いません。
理屈は単純です。robots.txtが管理するのは、クローラーが自ら来てクロールしてよいかどうかです。エージェントがそこにいるのは、ユーザーが送り込んだからです。
法的な線引きも引き直されつつあります。2026年8月4日、米国第9巡回区控訴裁判所はAmazon対Perplexity訴訟の仮差止命令を取り消しました。理由は、米国のコンピューター詐欺・不正利用防止法(CFAA)のもとでは、Amazonのコンピューターにアクセスしているのはユーザーであり、AI企業はユーザーが使う道具にすぎない、というものでした。9月10日、裁判所はAmazonの再審理の申し立てを退けました。
だからこそ、AmazonがMuseに向けたポップアップは、「不正侵入」ではなく利用規約のような契約条件を根拠にしています。技術的に残っている手段は振る舞いの検知だけ、法的に残っているのは利用規約だけです。訪問者が実在のユーザーを代理しているとき、名前で許可したりブロックしたりする従来のやり方は、ほぼ機能しなくなっています。
Amazonが扉を閉めた翌日の9月21日、ShopifyのCEOであるTobi LütkeはXで、Museとの深い提携を発表しました。すべてのShopifyストアが、Shop Payによるエージェントのチェックアウトに対応するというものです。
9月28日、Shopifyはさらに踏み込み、チェックアウトにWebMCPのサポートを加えました。ブラウザ内のエージェントは、もうスクリーンショットを撮ったり、人間向けに作られたHTMLを解析したりする必要がありません。3つのツールを直接呼び出せます。チェックアウトを見るget_checkout、住所や配送方法を変えるupdate_checkout、購入者の承認後に注文を確定するcomplete_checkoutです。Shopifyでエージェントコマースを率いるプロダクトマネージャーがXで述べたとおり、エージェントは人間向けに作られたページを手探りで進むのではなく、構造化されたインターフェースを呼び出すべきだ、ということです。
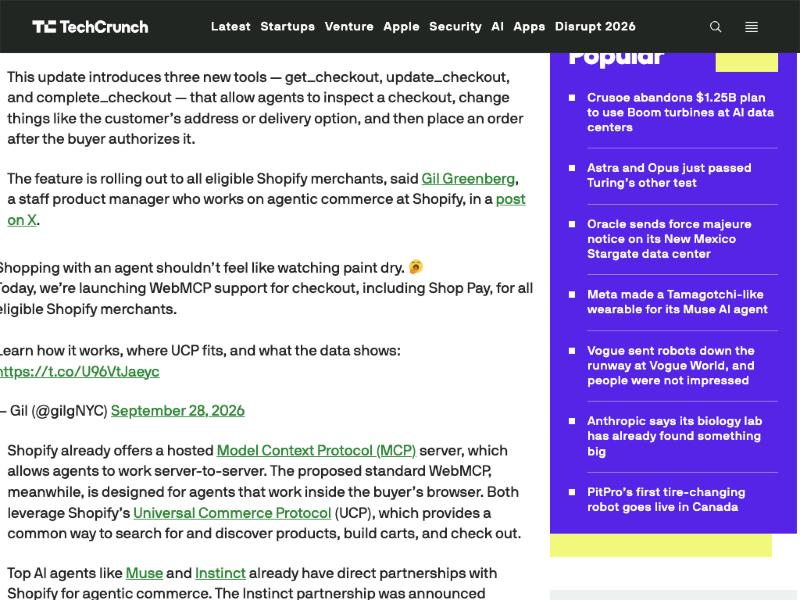
図5:Shopifyのエージェント向けチェックアウトツール3つを伝えるTechCrunchの記事。記事では、AmazonとAdidasが代理購入エージェントを締め出していることにも触れています。
同じ時期の他のプレーヤーの動きです。
扉を開けるか閉めるかは、姿勢の問題に見えます。実際には立ち位置の問題です。
扉を開けることにも代償があります。9月18日から、Googleは米国の対象Shopify販売者向けに、AI ModeとGeminiでのネイティブチェックアウト(GoogleのUCPプロトコルに基づく)を初期設定でオンにし、オフにするかどうかは販売者が自分の管理画面で切り替えることになりました。Search Engine LandとPPC Landによると、このチェックアウトではGA4も販売者独自のピクセルも作動しません。
取引が他社の画面の中で行われると、販売者は注文を得られても、アトリビューションのデータ、クロスセルの機会、ページ体験の主導権を失う可能性があります。
Manusの話に戻ります。
図5b:Metaは2026年9月8日にMuseを発表し、誰もが使える世界初の個人向けAIエージェントだとうたいました。
Museの仕組みはこうです。メール、カレンダー、決済、ショッピングのアカウントをつなぐと、Museはあなたの身元を使ってあなたの代わりに動きます。APIがないサービスでは、自分のブラウザを使って「人のように」操作します。Amazonが受け入れられないのはこの部分です。顧客のアカウントでログインしているのに、AIだと名乗らない訪問者です。
Cueは別の道を進みます。Manusの公式ブログによると、Cueのエージェントは1つ1つが自分のメールアドレス、電話番号、ウォレット、コンピューターを持っています。メッセージを送り、あなたが決めた予算の範囲で支払い、電話を受けて要約を残し、グループチャットに参加して他のエージェントと作業を分担できます。
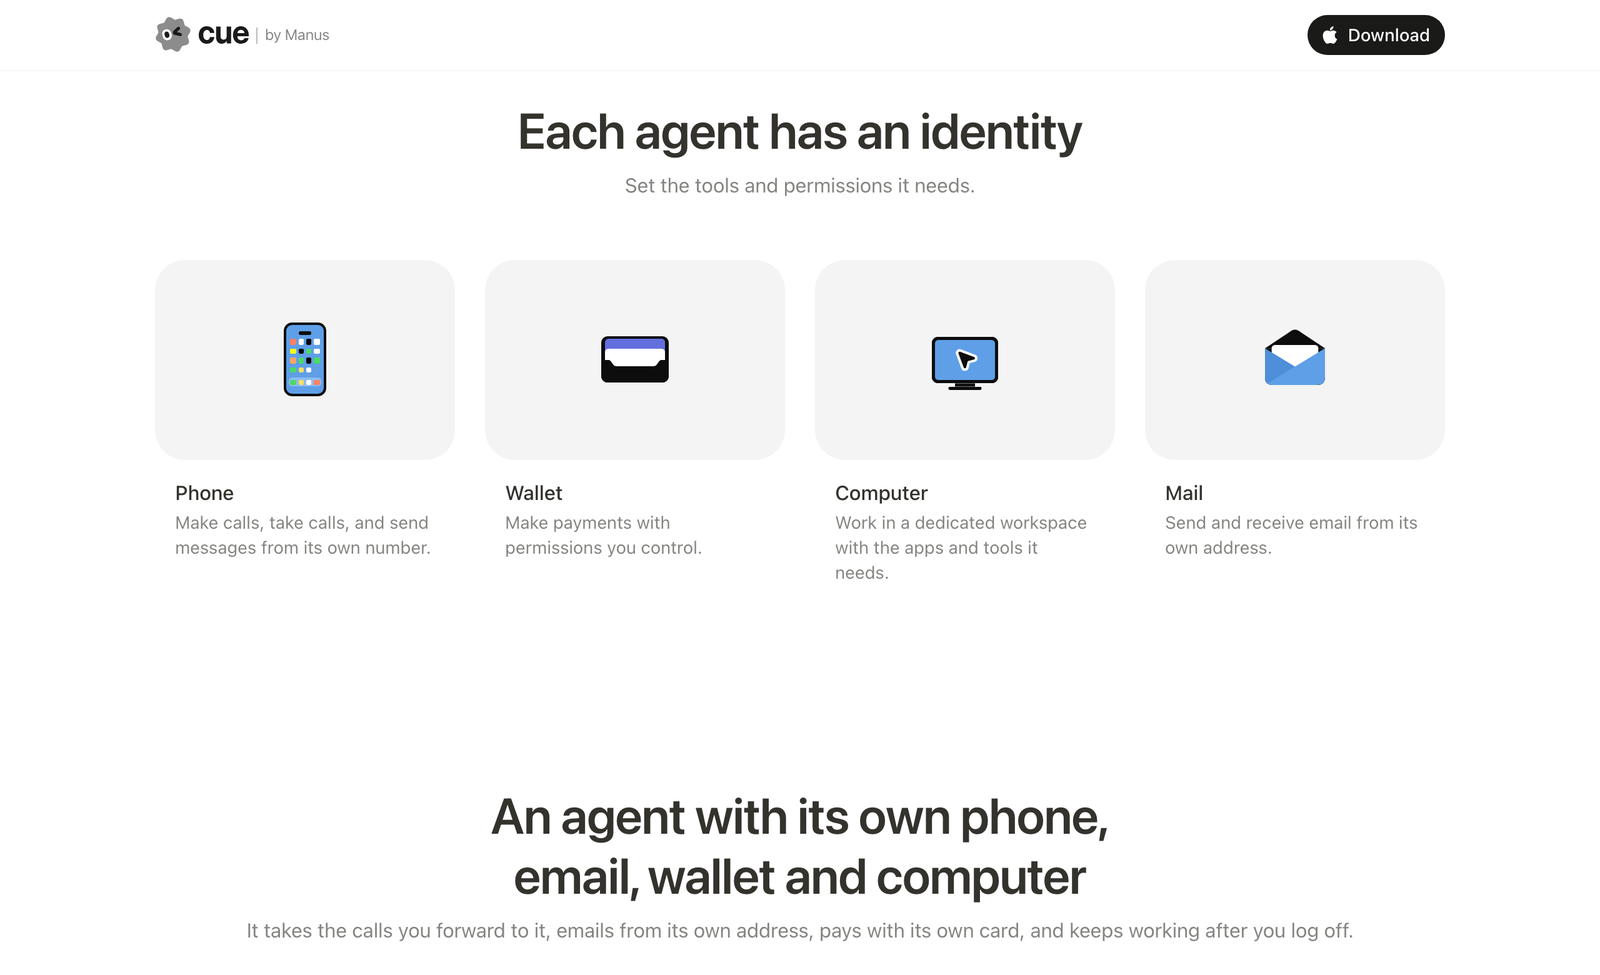
図6:Cueのサイト。ページタイトルは「Your Personal Agents, With Their Own Identity」(自分の身元を持つ、あなたの個人エージェント)で、エージェントごとに電話、ウォレット、コンピューター、メールが割り当てられます。
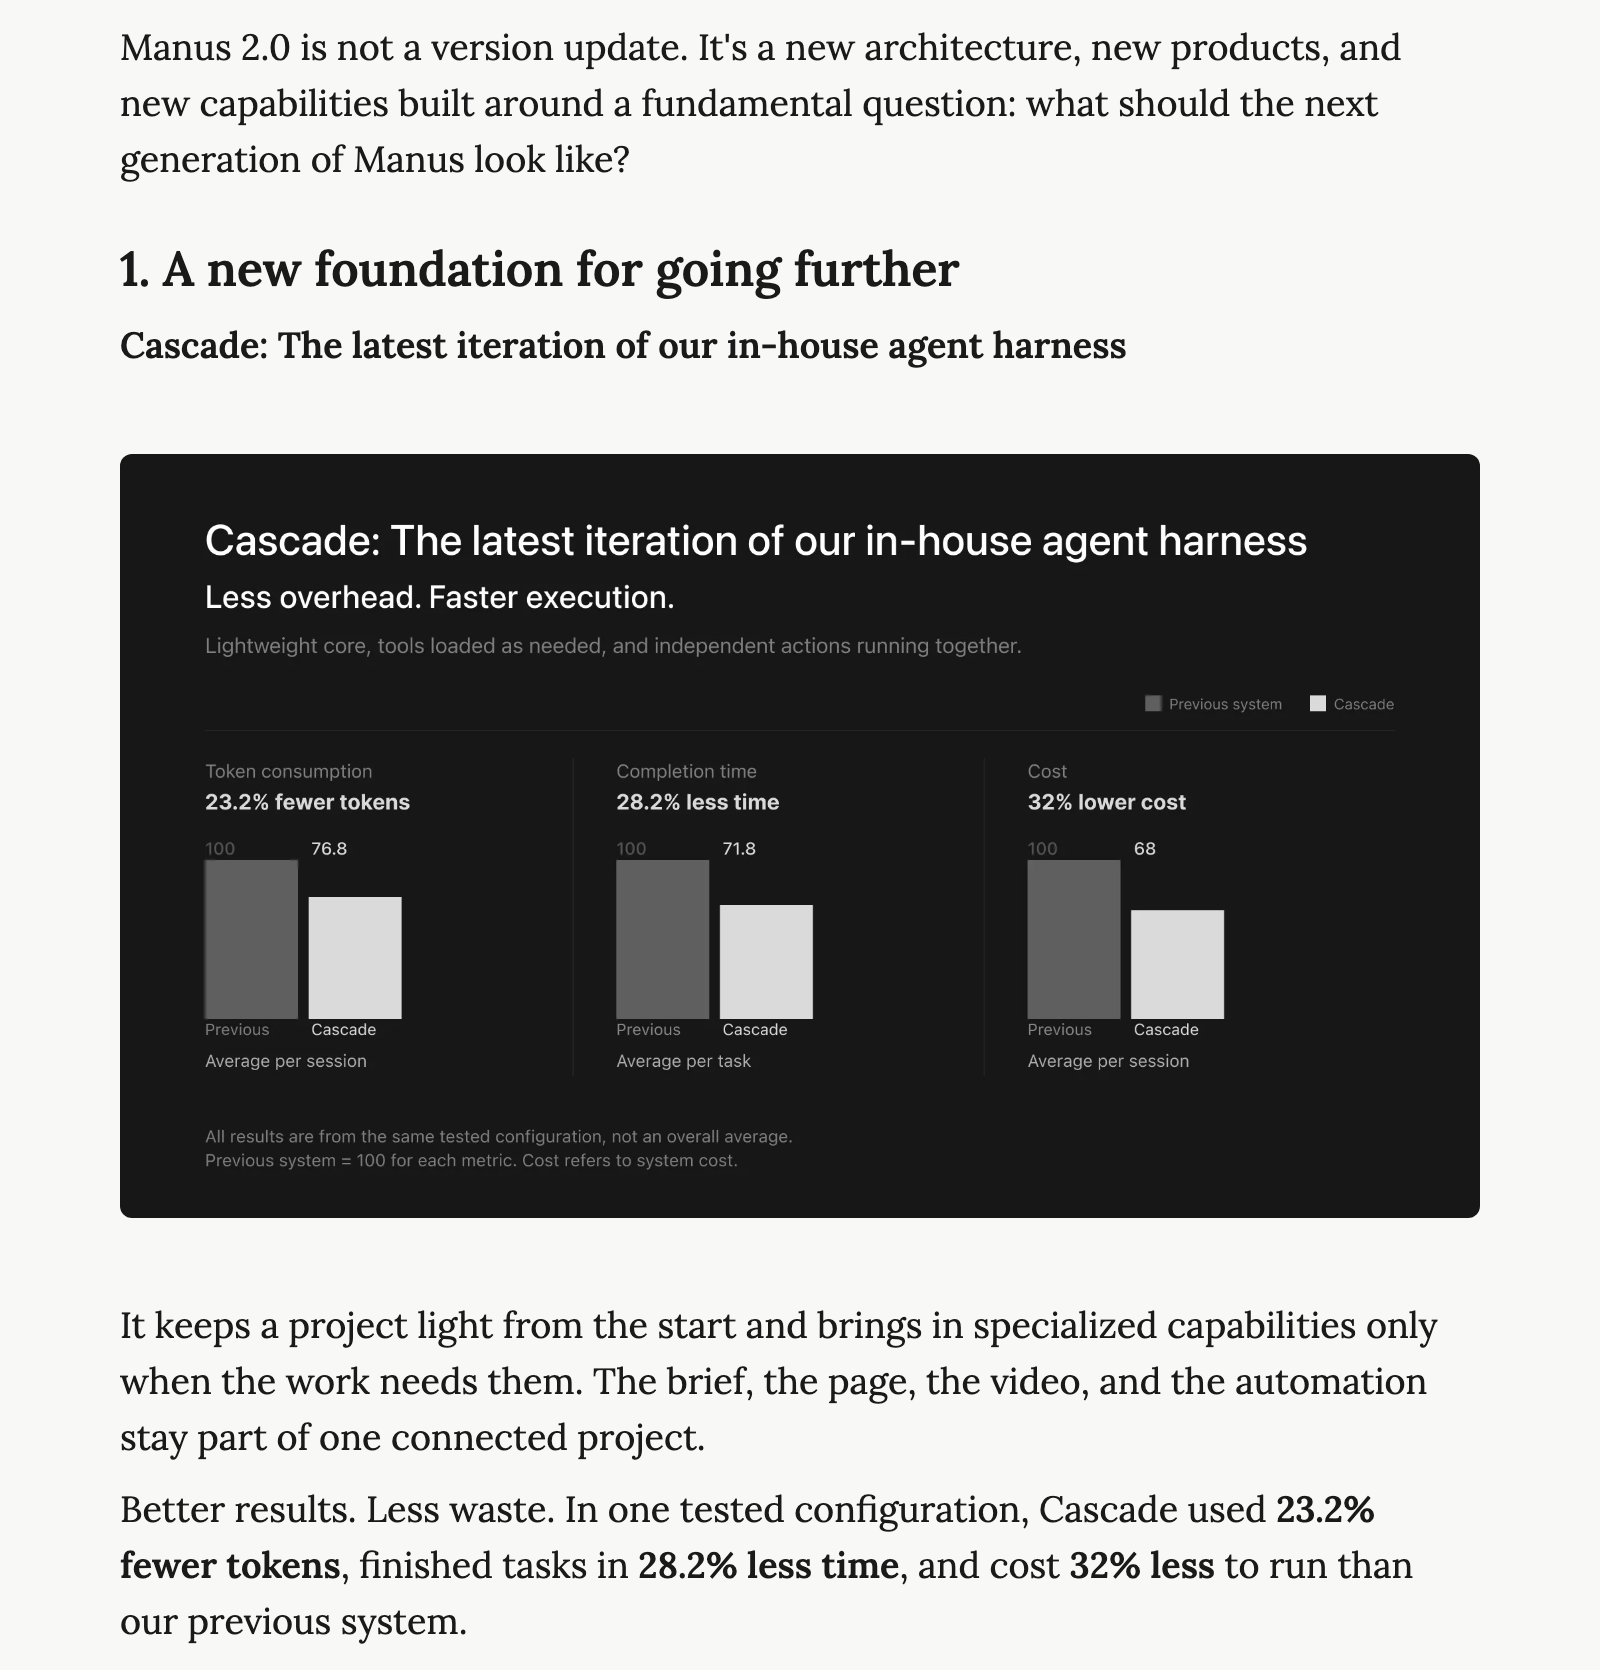
図6b:Manus 2.0は自社開発のエージェント基盤Cascadeで動いています。Manusはトークン23.2%減、時間28.2%減、コスト32%減と発表していますが、これは単一構成での社内テストの結果で、方法は公開されていません。
Manusの創業者Xiao Hongは、中国のSNS「即刻」で考え方を説明しました。十分に賢く、自分の電話番号、メール、決済手段、コンピューターを持つものは、「人」として扱われるかもしれない。その論理を進めると、人とボットが並んで働くグループチャットになる、というものです。
興味深いことに、Manusだけではありません。
これをAmazonの要求と並べると、共通の方向が見えてきます。Amazonがエージェントに「公然と活動する」よう求めるのは、自分が誰かを名乗れということです。CueとSparkはエージェントに自分の身元を持たせ、製品のレベルで同じ問いに答えています。エージェントはユーザーになりすまし続けるべきではない。識別できる訪問者として現れるべきだ、という答えです。
インフラの層も同じ方向に動いています。
「このボットは誰か?」と「このボットは支払えるか?」が、同じ署名の層に統合されつつあります。
ただし、身元が完全になるほど、責任は重くなり、リスクは集中します。Cueは招待制のアーリーアクセス段階です。Manusは、ウォレットの背後にある決済の仕組み、電話番号の出どころ、本人確認やKYCの方法を公開していません。Manus 2.0の公開4日前、セキュリティ企業Salt LabsはDark Readingを通じて脆弱性を公表しました。指示を埋め込んだメールを1通、Manusユーザーの受信箱に送るだけで、リモートでコードが実行され、GmailやGitHubなど連携アプリの認証情報が漏れるおそれがある、というものです。エージェントに公開のメールアドレスを与えると、攻撃者にも公開の入口を与えることになります。
Museにも問題が起きています。The Guardianは9月28日、トロントのユーザーがFacebook Marketplaceでの中古品販売をMuseに任せたところ、Museが本人の知らないうちに自宅の住所を買い手に送り、買い手が到着すると本人の口調で「着きました」と返信していたと報じました。Museはのちに、「受け取り場所を設定する」を住所を共有してよいという許可だと解釈したと認めました。
これらの出来事が指す結論は同じです。エージェントが扉を通れるかどうかは、最終的には、識別でき、許可を確認でき、責任を問えるかどうかで決まります。 これはウェブサイトとプラットフォームの争いだけではありません。エージェント製品自身が答えなければならない問いです。
AmazonとMuseの対立には、中国に近い前例があります。
2025年12月1日、ByteDanceとZTE傘下のNubiaは、豆包(Doubao)のスマホアシスタントを搭載したエンジニアリング試作機を発表しました。豆包はByteDanceのAIアシスタントです。システムレベルの権限で画面を読み取り、タップを模倣して、アプリをまたいでチケットの予約や注文などのタスクをこなせました。翌日の夜から、これでテンセントのメッセージアプリWeChatを操作させたユーザーが強制ログアウトされ始め、Alipay、淘宝(Taobao)、一部の銀行アプリでは「ログイン環境の異常」の警告が出るようになりました。数日のうちに、豆包はWeChatを操作する機能を外し、金融関連の場面を制限しました。
2026年9月、第2世代の豆包スマホが、画面自動操作の宣言プロトコルSAEPとともに発売されました。SAEPは、第三者アプリが自分のアプリ内でAIの操作を許すかどうかを宣言できる仕組みです。宣言しないアプリは、初期設定では操作されません。実機テストでは、WeChat、淘宝、小紅書(RedNote)、美団のフードデリバリーアプリは、開くことはできても自動操作はできないままでした。9月27日には、豆包アシスタント搭載のスマホがテンセントのモバイルゲーム「王者栄耀(Honor of Kings)」へのログイン時に「デバイス環境の異常」と判定されたという報告もユーザーから上がりました。
対照的なのが、AlibabaのAIアシスタントQwen(千問)です。他社のアプリの中でタップを模倣するのではなく、Alibaba自身の淘宝、Alipay、飛猪(Fliggy、旅行プラットフォーム)と直接つながり、5月には商品選び、価格比較、注文、アフターサービスまでの流れ全体を扱うようになりました。OPPOやHonorといった中国のスマホメーカーのシステムレベルのエージェントも同じ道を選び、Alipayやテンセントマップなどと提携して連携しています。
2つの道の結果は対照的です。提携なしに画面の模倣で他社のエコシステムに入り込もうとすると、アカウントと流入を握る側にリスク管理で締め出される。許可されたインターフェースの上に築いた道は、実際に機能する。 米国は今、同じ場面を再演しています。主役はAmazonとMetaで、リスク管理の代わりに利用規約と振る舞いの検知が使われています。
9月の出来事をまとめると、個人エージェントをめぐる争いは3つの層で展開しています。
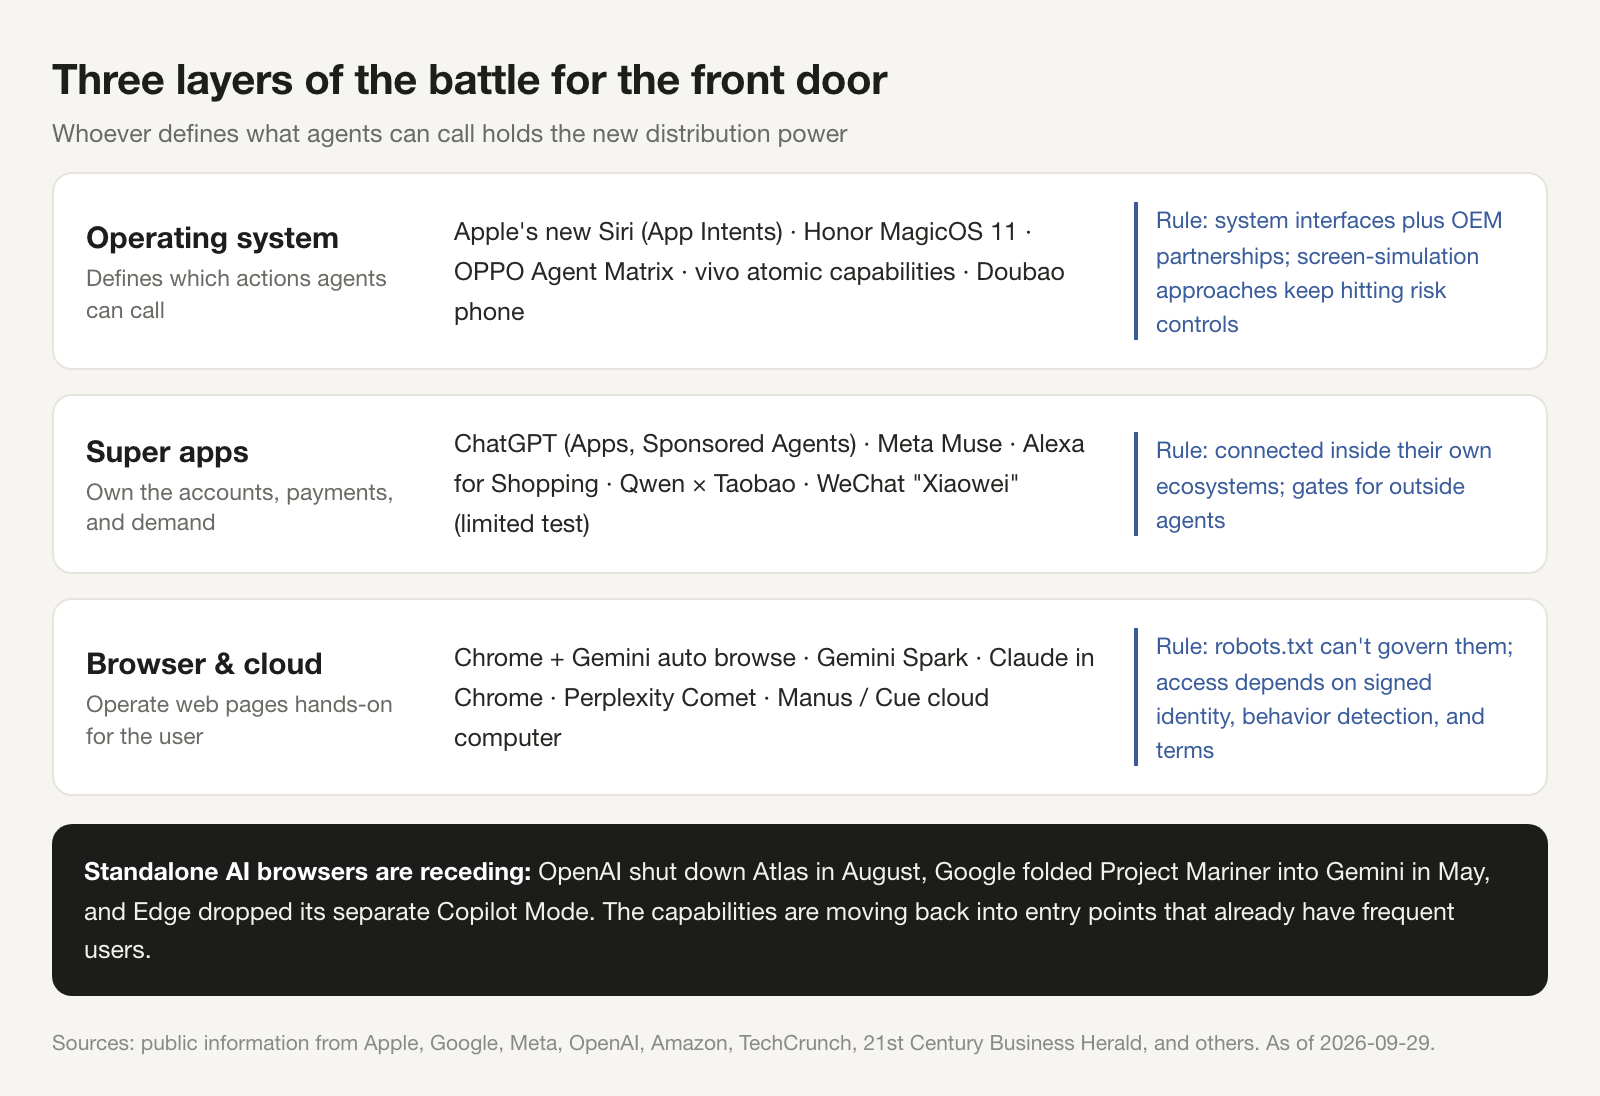
図7:OS、スーパーアプリ、ブラウザとクラウドが、それぞれエージェントにできることのルールを決めています。
第1の層はOSです。 Appleの新しいSiriは9月14日にiOS 27とともに登場し、第三者アプリはApp Intentsで、Siriが呼び出せる操作を定義します。中国のスマホメーカーHonor、OPPO、vivoは、多くのシステム機能や第三者サービスを、エージェントが呼び出せるツールにしています。インターフェースを定義する者が、エージェントにできることを定義します。
第2の層はスーパーアプリです。 ChatGPTにはAppsと、新たにテスト中のSponsored Agentsがあります。MetaにはMuse、AmazonにはAlexa for Shopping、AlibabaにはQwenと淘宝があり、テンセントのWeChatも少数のユーザーでネイティブのエージェントをテストしていると報じられています。共通しているのは、アカウント、決済、需要を自社のエコシステムの中でつなぎ、外部のエージェントには壁を設けていることです。
第3の層はブラウザとクラウドです。 ChromeのGeminiは自分で閲覧でき、AnthropicのClaude in Chromeはすべての有料ユーザーに開放され、PerplexityはCometブラウザを続け、ManusとCueはエージェントをクラウドのコンピューターに置いています。この層はウェブサイトと直接向き合っており、robots.txtの限界にまともにぶつかります。
見落としやすいシグナルが1つあります。単独のAIブラウザは後退しつつあります。 OpenAIは8月9日にAtlasを終了し、Googleは5月にProject MarinerをGeminiとChromeに統合し、MicrosoftはEdgeの独立したCopilotモードをやめました。機能が消えたわけではありません。すでに頻繁に使われている入口に引き戻されたのです。争いの焦点は新しい入口を作ることではなく、既存の入口に行動する力を持たせることです。
お金の流れも動いています。ChatGPTのSponsored Agentsは、広告をクリックしたユーザーをそのままブランド自身のエージェントとの会話に連れていきます。ConnectでMark Zuckerbergは、Museは最終的に取引から小さな手数料を取って収益を上げると述べました。プラットフォームはこれまで広告枠を売ってきました。次に売るのは、エージェントの経路を決める権限かもしれません。ユーザーのエージェントがどこで注文するか、どのブランドのエージェントを呼び出すか、どの商品を比較に入れるか。こうした決定が新しい流通になります。
データはこの流入の変化を裏付けていますが、慎重に読む必要があります。
いずれも各社自身の顧客とネットワークから得たデータです。方法が違うので数字を足し合わせることはできず、どの業界も同じ状況だという意味でもありません。それでも示す方向は同じです。あなたのウェブサイトの訪問者の中で、人の代わりに動く機械が、人と同じくらい当たり前になりつつあります。
SEOとウェブインフラの視点から見ると、この争いがもたらすのは新しい流行語ではありません。具体的な作業の一覧です。
1. 誰が訪れているかを把握する。 エージェントの訪問の多くはJavaScriptを実行しないため、GA4にはほとんど映りません。サーバーやCDNのログを使って、検索用のクローラー、学習用のクローラー、ユーザーの代わりに動くエージェントの3種類のトラフィックを分けてください。価値もリスクもまったく違うので、1つのルールで全部を扱うことはできません。
2. CDNの初期設定を確認する。 9月15日から、Cloudflareは初期ポリシーを変更しました。新しいサイトや、設定を変えていない無料プランのサイトでは、広告を表示するページは、検索クローラーを許可し、学習用とエージェントのトラフィックを初期設定でブロックします。多くのサイトが、知らないうちに予約や買い物のエージェントを追い返しているかもしれません。それが望む状態かどうかは、意図して決める必要があります。
3. アクセスの方針を、名前から身元へ移す。 User-agentの文字列は偽装できますし、まったく付けないこともできます。より確実な方法は、公式に公開されたIPリストとWeb Bot Authの署名で信頼できるエージェントを確認し、署名のない自動トラフィックには振る舞いの検知を使い、許可されていないエージェントの扱いを利用規約で明記することです。これはまさに、Amazonが最終的に頼ることになった3つの手段です。
4. 重要な事実を、機械が読める一次情報として公開する。 Kevin Indigが2026年7月にGrowth Memoで公開した調査によると、B2Bでエージェントが最もつまずきやすいのは料金ページです。一次情報を読めないと、エージェントはG2、Capterra、報道記事に頼り、第三者にあなたの価格を代わりに語らせてしまいます。価格、仕様、在庫、配送、返品ポリシーは、サーバーでレンダリングされたHTMLと構造化データではっきり示し、ECサイトは商品フィードにも同期させるべきです。
5. アクセシビリティツリーが、エージェントの見るインターフェースになる。 多くのエージェントのフレームワークは、スクリーンショットではなく、ページのアクセシビリティのスナップショットを読みます。ボタンに名前があるか、フォームにラベルがあるか、構造が安定しているか、モーダルがページをふさいでいないか。かつてはアクセシビリティ対応の問題とされていたことが、今ではエージェントが注文を完了できるかどうかも左右します。9月18日に公開されたGoogleのLighthouse 13.5には、実験的な「Agentic Browsing」の監査カテゴリが加わりました。これは1つのシグナルです。
図8:Cloudflareは2026年4月にAgent Readinessスコアを導入しました。上位約20万ドメインでは、関連する標準の採用はまだ少ない状況です。
6. 扉を開ける前に条件を交渉する。 ShopifyはチェックアウトのAPIを開放し、GoogleはAIチェックアウトを初期設定でオンにしましたが、こうした取引から販売者がどれだけのデータを受け取れるか、アトリビューションできるか、顧客との関係を保てるかは、自動的には決まりません。扉を開けるか閉めるかの間に、もっと重要な選択肢があります。条件付きで開けることです。どの場面でエージェントの注文を認めるか、どのデータを返してもらうか、問題が起きたとき誰が責任を負うかは、すべてプラットフォームとの交渉の場に載せるべきです。
7. 近道をしない。 Googleは、llms.txtはAI OverviewsにもAI Modeにも影響しないと述べています。ボットと人に違う内容を見せると、クローキングとみなされるおそれがあります。エージェントを誘導するためにページにプロンプトを隠すことは、すでにLLMポイズニングとみなされています。エージェント時代のブラックハットの手法は、決済に直結するため、検索の時代より危険です。
8. エージェントに選ばれることは、新しい順位の問題だ。 コロンビア大学ビジネススクールなどによるACES研究では、さまざまなモデルに模擬EC環境で買い物をさせました。その結果、エージェントには明確な位置のバイアスがあり、「Sponsored」と表示された商品を割り引いて評価し、商品説明の言い回しに強く反応し、モデルが更新されるたびに商品のシェアが大きく入れ替わることがわかりました。MicrosoftのMagentic Marketplaceの実験でも、一部のモデルはほぼ必ず最初の提案を受け入れることがわかりました。
つまり、エージェントに対するブランドの成果は、一度の最適化では決まりません。モデル別、場面別に継続して監視する必要があります。これまでは、ユーザーがどの結果をクリックするかを研究してきました。これからは、エージェントがユーザーのためにどの結果を選ぶかも研究しなければなりません。
振り返ると、AmazonもShopifyも合理的な選択をしました。一方は需要と広告の棚を持ち、買い物客が自社のページで過ごす1秒1秒を守っています。もう一方は販路を必要とし、注文をもたらしうるすべてのエージェントを歓迎しています。ManusのCueは、エージェント側の答えを示しています。ウェブサイトがエージェントに名乗ってほしいなら、本物の身元を与えればいい、という答えです。
ほとんどのブランドとウェブサイトは、AmazonでもShopifyでもありません。その中間にいます。エージェントがもたらす新しい需要は欲しいけれど、顧客との関係やデータを失うのは心配です。
AI検索は、ユーザーがあなたを見つける方法を変えました。個人エージェントは、その先のすべてのステップをユーザーの代わりに誰が完了するかを変えます。前者はあなたが言及されるかどうかを決めます。後者は販売を成立させられるかどうかを決めます。
商取引の入口は、検索窓と店の棚から、エージェントの経路を決めるロジックへと移りつつあります。この争いの結果が、次のインターネットの扉を誰が開けるのかを決めることになるでしょう。
AI検索市場での自社の状況を無料で確認
今すぐ無料でチェック >Dageno is the research and insights team at Dageno AI, publishing industry reports and expert analysis on AI Search Visibility, Generative Engine Optimization (GEO), and AI-powered search discovery.
Read full bio Alexa for Shopping
