Analisis Cakupan Prompt untuk GEO: Metrik & Kerangka Kerja
Pelajari cara menyusun kumpulan prompt GEO yang representatif, menghitung cakupan, mengendalikan variasi jawaban, mendiagnosis kesenjangan, dan mengubah temuan menjadi daftar pekerjaan yang terukur.
Analisis cakupan prompt mengukur seberapa menyeluruh sebuah brand muncul di berbagai pertanyaan nyata yang diajukan pembeli kepada asisten AI—bukan seberapa banyak prompt yang kebetulan dilacak oleh sebuah tim. Analisis yang bermanfaat menghubungkan setiap prompt dengan intent, audiens, pasar, jawaban, sumber sitasi, kompetitor, dan tindakan bisnis.
Analisis Cakupan Prompt: Definisi Praktis
Cakupan prompt adalah persentase dari kumpulan prompt yang telah ditentukan saat sebuah brand memperoleh jenis kehadiran yang dibutuhkan bisnis. Kehadiran tersebut dapat berupa penyebutan, rekomendasi, sitasi ke URL milik sendiri, atau penyertaan dalam perbandingan. Ini adalah hasil yang berbeda dan tidak seharusnya digabungkan menjadi satu skor tanpa penjelasan.
Sebagai contoh, sebuah platform penggajian mungkin muncul dalam 60 dari 100 jawaban yang dilacak, tetapi hanya direkomendasikan dalam 18 jawaban dan mendapat sitasi ke situs milik sendiri dalam 9 jawaban. Melaporkan “visibilitas 60%” menyamarkan kesenjangan yang penting secara komersial. Laporan yang lebih kuat menunjukkan:
Cakupan penyebutan: jawaban yang menyebut brand ÷ prompt yang memenuhi syarat.
Cakupan rekomendasi: jawaban yang memasukkan brand ke dalam daftar pilihan secara positif ÷ prompt komersial yang memenuhi syarat.
Cakupan sitasi milik sendiri: jawaban yang menyitasi domain brand ÷ prompt yang menampilkan sitasi.
Cakupan kompetitif: prompt tempat brand muncul dibandingkan dengan kompetitor yang disebutkan.
Cakupan jawaban akurat: jawaban yang memuat fakta penting tentang brand secara benar.
Karena itu, cakupan prompt adalah metrik portofolio. Metrik ini hanya berguna jika denominator-nya—kumpulan prompt—dirancang dan didokumentasikan dengan sengaja.
Bangun Kumpulan Prompt yang Mewakili Permintaan
Jangan mulai dengan daftar acak yang dibuat oleh LLM. Mulailah dengan bukti dari bahasa pelanggan: kueri Google Search Console, penelusuran situs, panggilan penjualan, tiket dukungan, ulasan, diskusi komunitas, halaman kompetitor, dan dokumentasi produk. Variasi yang dihasilkan AI dapat memperluas kumpulan setelah permintaan nyata dipetakan.
Kelompokkan berdasarkan tahap pengambilan keputusan
Setiap prompt harus memiliki satu intent utama:
Tahap
Contoh prompt
Hasil yang diinginkan
Penemuan masalah
“Mengapa brand kami tidak muncul di jawaban ChatGPT?”
Asosiasi kategori yang akurat
Penemuan solusi
“Tools untuk melacak sitasi AI”
Penyebutan brand dan sitasi ke situs milik sendiri
Evaluasi
“Platform visibilitas AI terbaik untuk agensi”
Masuk dalam daftar pilihan
Perbandingan
“Dageno vs [kompetitor] untuk GEO multibahasa”
Diferensiasi yang akurat
Validasi
“Apakah Dageno akurat?”
Bukti tepercaya dan sentimen yang seimbang
Implementasi
“Bagaimana cara melacak sitasi AI berdasarkan URL?”
Sitasi dokumentasi dan kunjungan yang memenuhi kriteria
Tambahkan dimensi yang mengubah jawaban
Kebutuhan yang sama dapat menghasilkan jawaban berbeda berdasarkan persona, industri, lokasi, bahasa, ukuran perusahaan, anggaran, platform, dan batasan. Simpan informasi ini sebagai field, bukan sebagai daftar tidak terstruktur yang berisi banyak prompt serupa. Catatan prompt praktis mencakup:
prompt_id, pertanyaan kanonis, klaster, tahap funnel, persona, pasar, bahasa, platform, prioritas, fakta brand yang diharapkan, URL target, dan penanggung jawab.
Pisahkan prompt evergreen dari prompt volatil yang membahas harga saat ini, ketersediaan produk, atau peristiwa terbaru. Prompt volatil perlu ditinjau lebih sering dan tidak seharusnya dicampur ke dalam benchmark yang jarang berubah tanpa label.
Cara Menghitung Cakupan Tanpa Menyesatkan Tim
Gunakan periode pengukuran tetap dan kumpulan prompt yang stabil. Jika prompt ditambahkan atau dihapus, pertahankan kohort sebelumnya agar perbandingan tren tetap valid.
Rumus cakupan sederhana
Untuk kumpulan 200 prompt yang memenuhi syarat, misalkan brand disebutkan dalam 74 prompt:
Cakupan penyebutan = 74 ÷ 200 = 37%
Jika hanya 120 prompt yang memiliki intent rekomendasi komersial dan brand direkomendasikan dalam 24 prompt:
Cakupan rekomendasi = 24 ÷ 120 = 20%
Jangan membagi jumlah rekomendasi dengan seluruh 200 prompt; banyak prompt informasional yang secara logis tidak memerlukan rekomendasi vendor.
Beri bobot pada prompt secara transparan
Tingkat tanpa bobot memperlakukan prompt definisi bernilai rendah dan perbandingan tahap pembelian dengan bobot yang sama. Jika bisnis menggunakan pembobotan, publikasikan aturannya. Sebagai contoh:
Prioritas 3: prompt evaluasi dan perbandingan yang terkait dengan pendapatan.
Prioritas 2: prompt penemuan solusi dan implementasi.
Selalu tampilkan tingkat tanpa bobot di samping tingkat berbobot. Jika tidak, perubahan bobot dapat terlihat seperti perubahan performa.
Perhitungkan Variabilitas Jawaban
Jawaban AI dapat bervariasi dari satu proses ke proses lain karena perubahan model, pengambilan informasi dari web, personalisasi, geografi, dan konteks prompt. Satu tangkapan layar manual adalah bukti dari sebuah jawaban, bukan bukti posisi pasar yang stabil.
Gunakan kontrol berikut:
Jalankan prompt kanonis yang sama di platform dan pasar yang sama.
Kendalikan personalisasi dan riwayat percakapan jika memungkinkan.
Jalankan ulang prompt penting beberapa kali atau pada tanggal berbeda.
Simpan teks jawaban, timestamp, URL yang disitasi, dan label model/platform.
Laporkan ukuran sampel bersama setiap persentase.
Pisahkan observasi dari satu kali proses dengan ambang kehadiran berulang.
Aturan stabilitas praktisnya adalah menandai sebuah brand sebagai “hadir secara konsisten” hanya jika brand muncul dalam proporsi tertentu dari observasi berulang yang telah ditentukan. Ambang batasnya merupakan keputusan bisnis; yang penting adalah mencatatnya sebelum meninjau hasil.
Diagnosis Kesenjangan di Balik Setiap Prompt yang Tidak Terpenuhi
Tidak adanya penyebutan tidak otomatis berarti “tulis artikel blog lain.” Klasifikasikan masalah sebelum menentukan pekerjaan:
Jenis kesenjangan
Bukti
Tindakan yang sesuai
Kesenjangan cakupan
Tidak ada halaman milik sendiri yang menjawab prompt
Buat atau perluas halaman yang tepat
Kesenjangan retrieval
Halaman yang relevan tersedia, tetapi diblokir, tidak memiliki tautan masuk, terduplikasi, atau sulit dirender
Perbaiki crawlability, canonicalization, HTML, dan tautan internal
Kesenjangan bukti
Halaman menyampaikan klaim tanpa bukti
Tambahkan metodologi, data, contoh, dokumentasi, atau tinjauan ahli
Kesenjangan konsensus
AI mengandalkan sumber pihak ketiga yang tidak menyebut brand
Bangun ulasan, kemitraan, PR, dan edukasi komunitas yang autentik
Kesenjangan entitas
Nama produk, kategori, atau atribut tidak konsisten
Selaraskan fakta produk, structured data, profil, dan dokumentasi
Kesenjangan positioning
Brand muncul, tetapi dikaitkan dengan use case yang keliru
Perbaiki halaman produk dan bukti perbandingan
Kesenjangan freshness
Fakta yang disitasi sudah usang
Perbarui bagian faktual dan timestamp sumber
Klasifikasi ini mencegah tim menanggapi setiap penurunan visibilitas dengan menambah volume konten.
Ubah Cakupan Prompt Menjadi Backlog yang Diprioritaskan
Beri skor untuk setiap kesenjangan berdasarkan nilai bisnis, kelemahan saat ini, kekuatan bukti, dan upaya yang diperlukan. Model prioritas yang berguna:
Prioritas = nilai bisnis × kesenjangan cakupan × tingkat keyakinan ÷ upaya
Tingkat keyakinan penting. Ketidakhadiran berulang di beberapa observasi dengan kompetitor yang sama dikutip merupakan bukti yang lebih kuat daripada satu jawaban yang volatil. Backlog harus mencantumkan klaster prompt yang terdampak, URL target, sumber yang diamati, perubahan spesifik, penanggung jawab, dan tanggal pengujian ulang.
Contoh
Sebuah perusahaan SaaS B2B disebutkan untuk prompt “apa itu [kategori]?” tetapi tidak muncul untuk “platform [kategori] terbaik untuk tim global.” Kompetitor disitasi dari halaman fitur multibahasa dan perbandingan pihak ketiga. Backlog yang tepat bukanlah artikel kategori umum. Backlog tersebut adalah:
Perluas halaman enterprise yang sudah ada dengan detail cakupan bahasa, tata kelola, dan pelaporan.
Publikasikan perbandingan transparan yang menjelaskan kesesuaian dan keterbatasan.
Perkuat dokumentasi yang relevan dan bukti pelanggan.
Tambahkan tautan internal dari panduan kategori yang memiliki otoritas tinggi.
Uji ulang kohort prompt komersial tetap setelah perayapan ulang.
Dageno AI untuk Analisis Tingkat Prompt
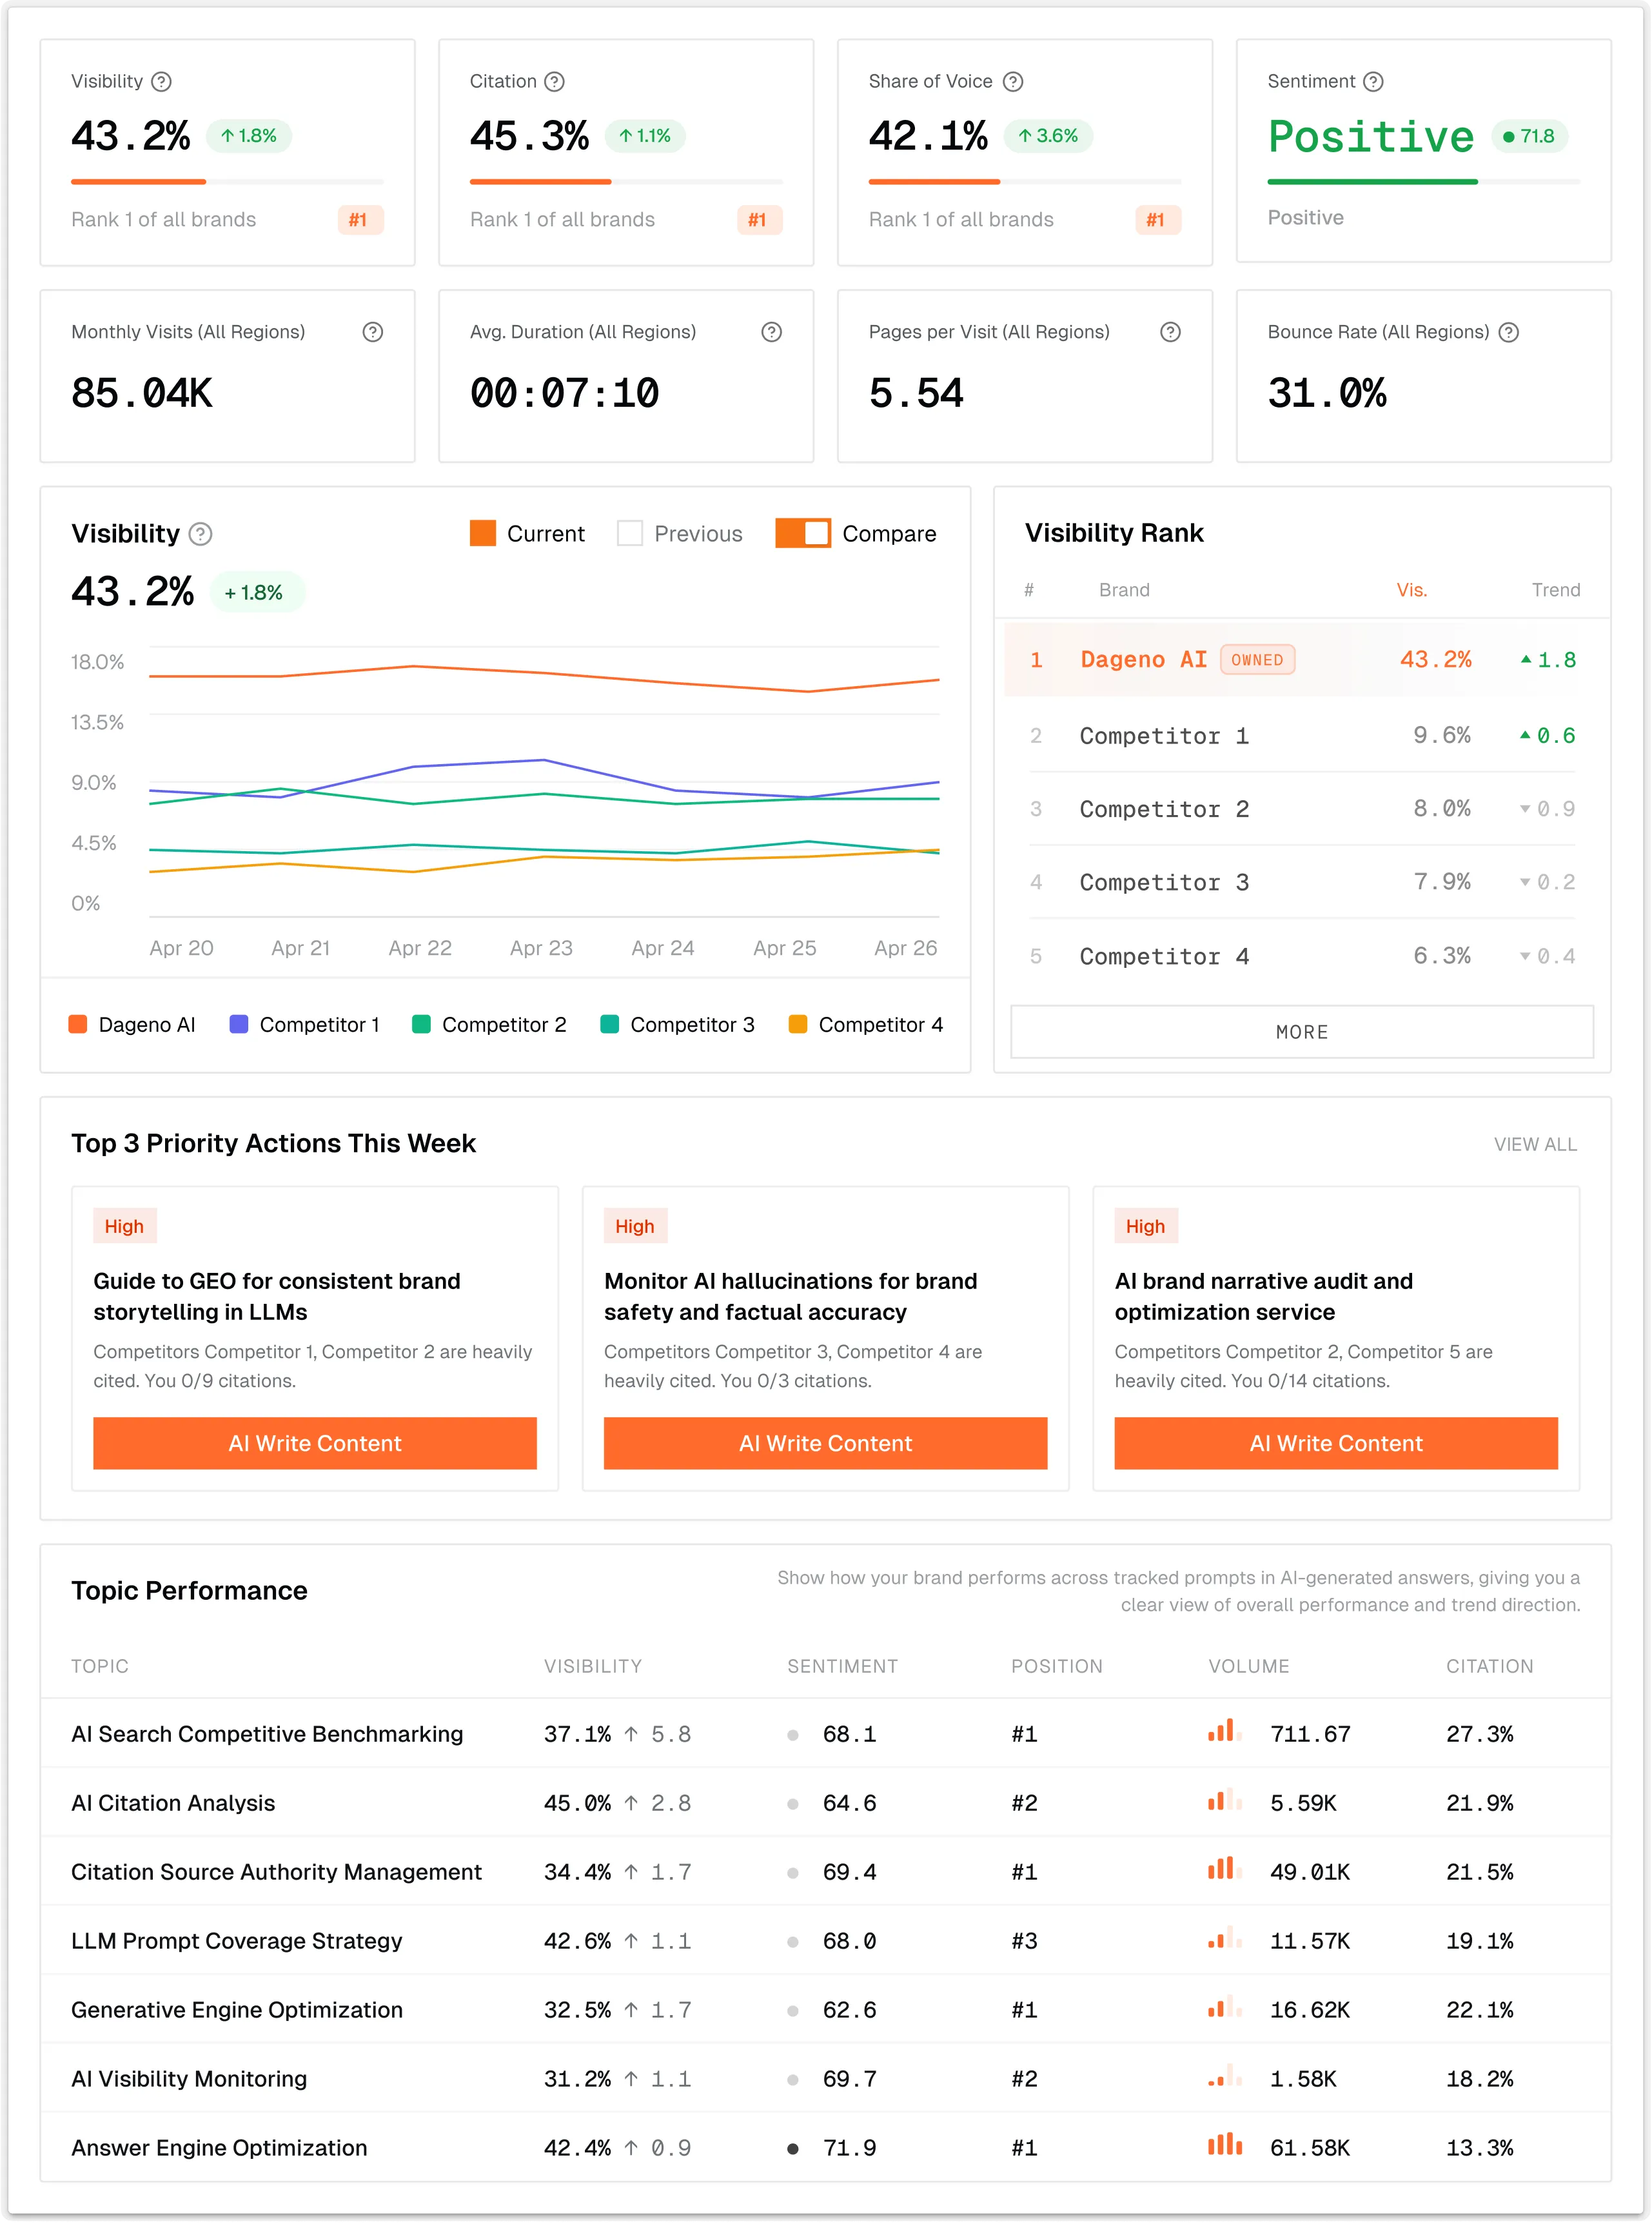
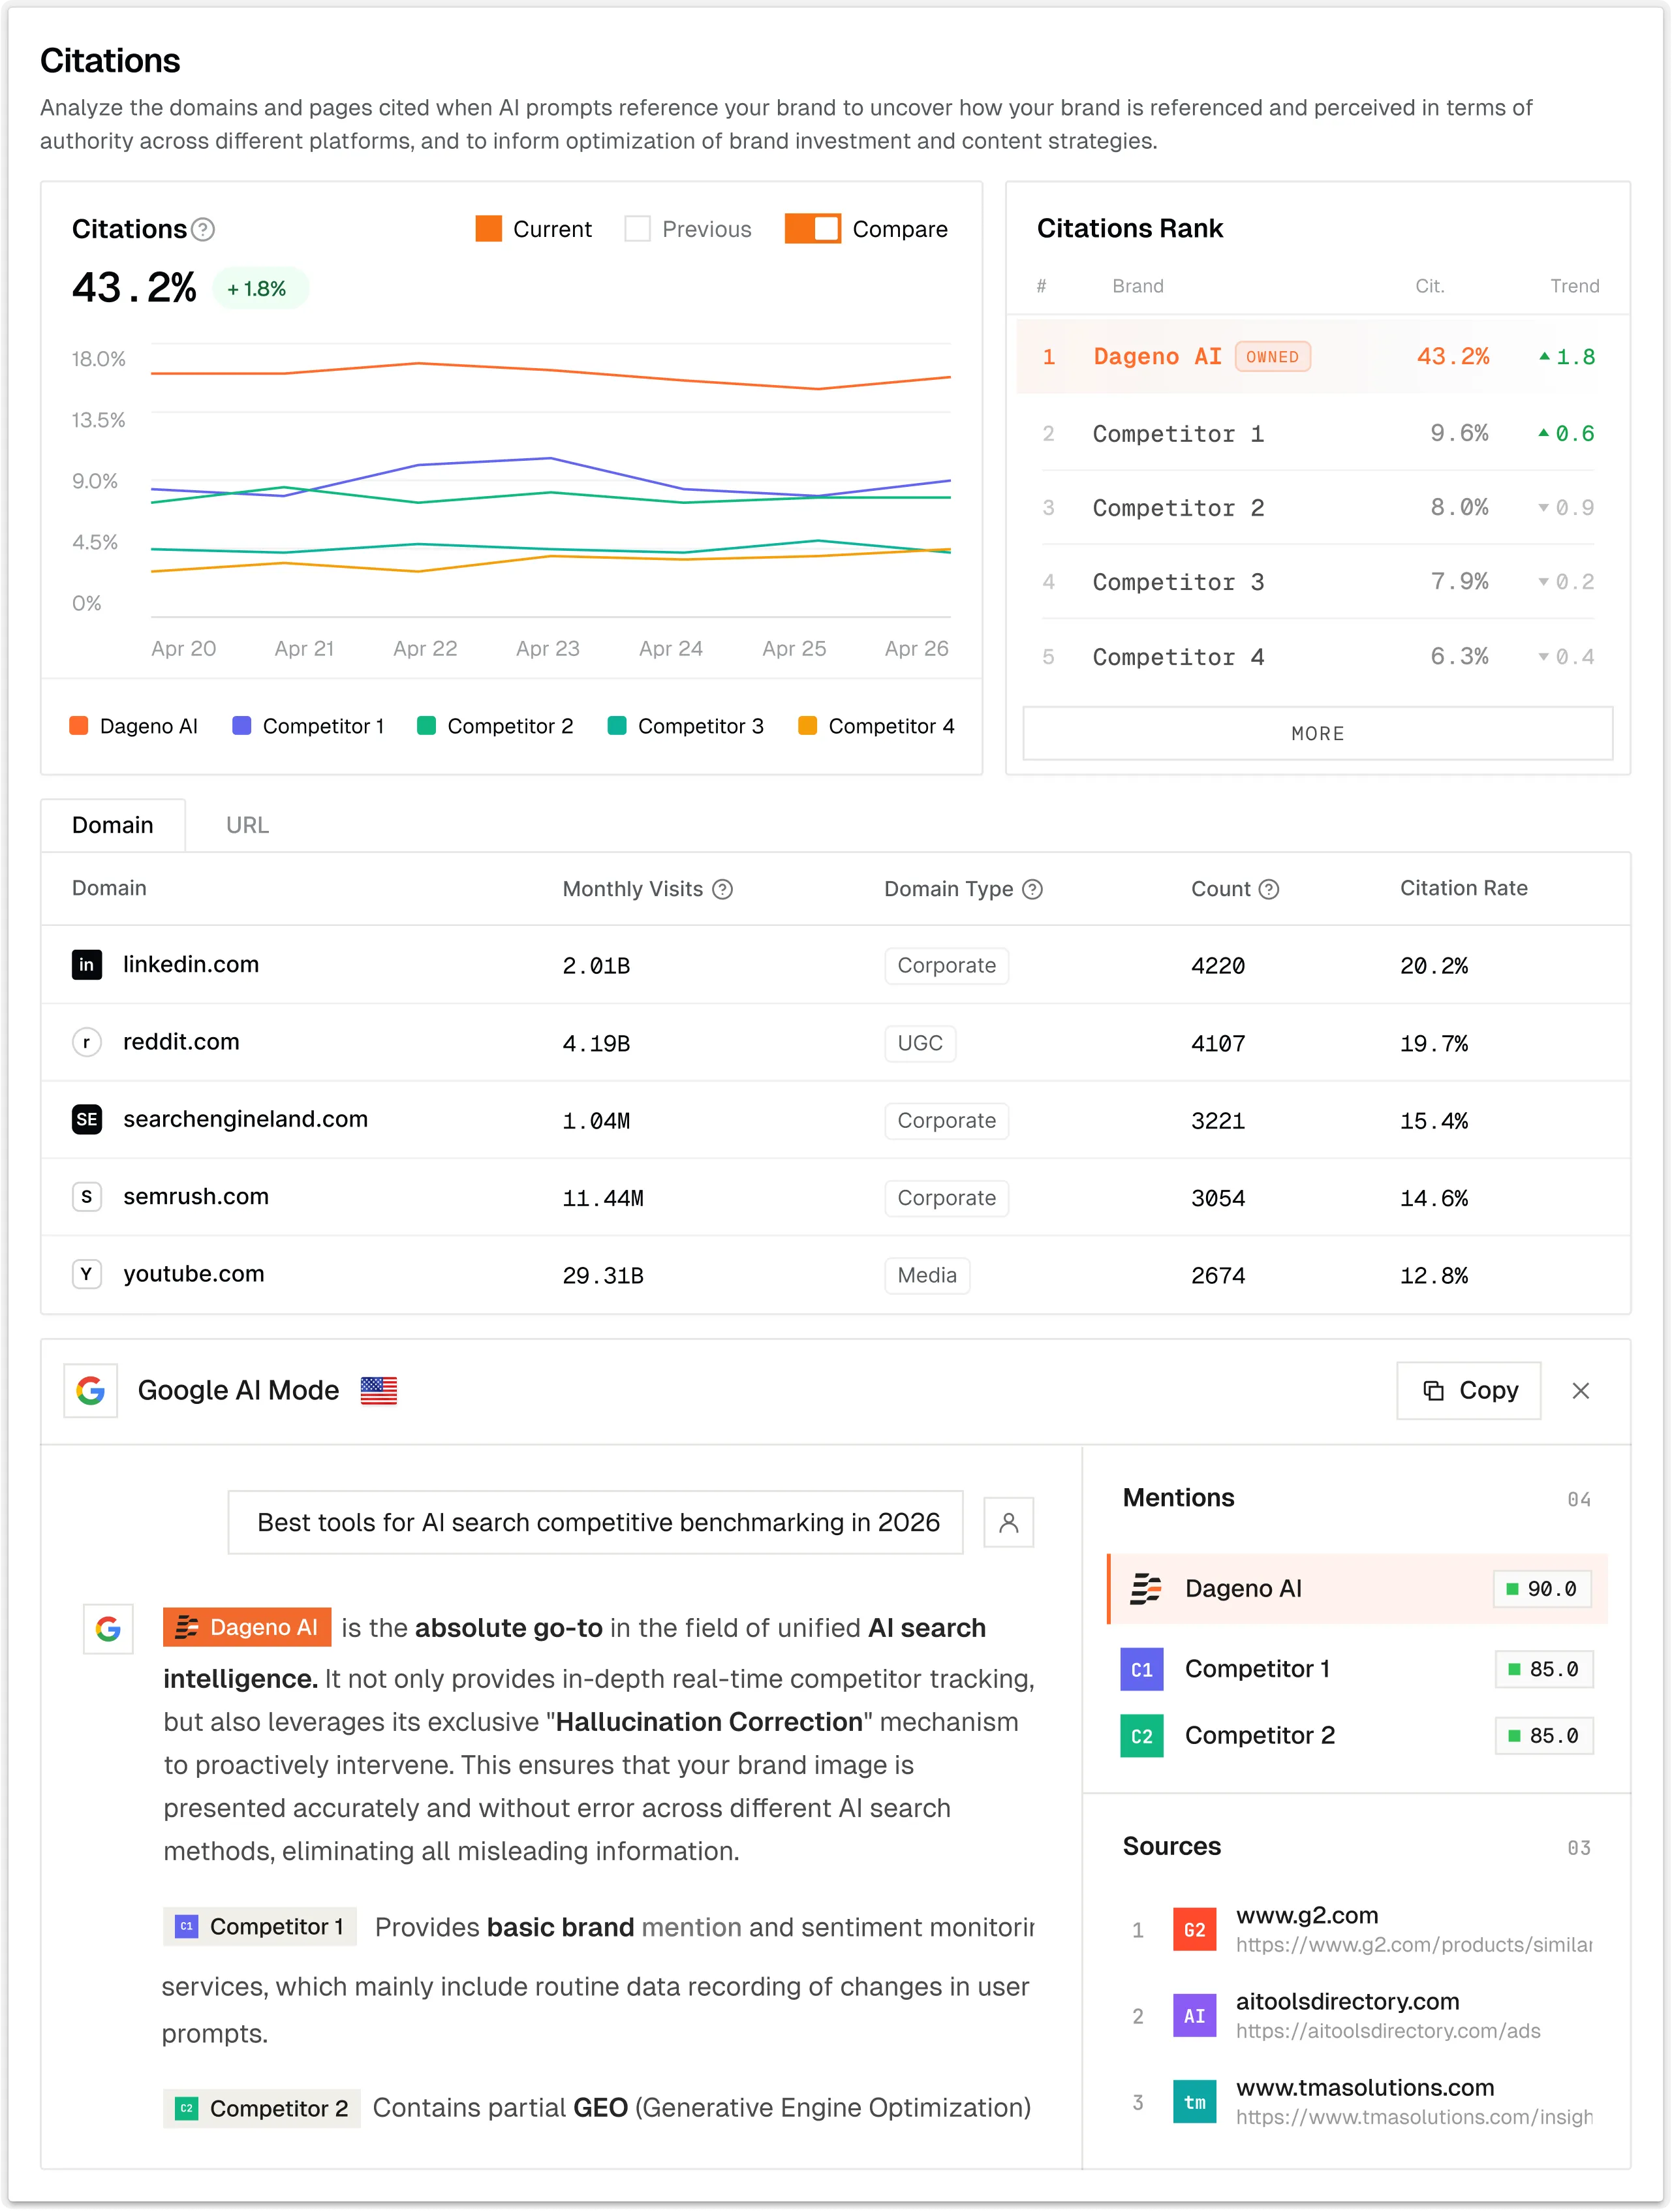
Dageno membantu tim memantau jawaban, sitasi, sentimen, kompetitor, dan klaster prompt di berbagai platform penelusuran AI. Alur kerja yang bermanfaat bukan sekadar memeriksa skor visibilitas: tetapi menemukan klaster prompt komersial yang lemah, memeriksa sumber yang mendukung jawaban kompetitor, menetapkan tindakan konten atau otoritas yang tepat, lalu mengukur kembali kohort yang sama.
Prompt Volumes Explorer dapat membantu memperluas pertanyaan awal, sementara Answer Engine Insights membantu mengatur jawaban yang diamati dan jalur sitasinya. Tim tetap perlu mendokumentasikan aturan sampling dan bobot bisnis agar dasbor tetap mudah ditafsirkan.
Konfirmasikan tujuan bisnis, susun taksonomi prompt, tetapkan kohort awal, jalankan baseline, dan verifikasi aturan brand/entitas. Catat kasus yang ambigu alih-alih memaksakannya ke kategori “hadir” atau “tidak hadir”.
Minggu 2: Diagnosis
Periksa klaster prioritas tinggi yang lemah. Bandingkan halaman yang disitasi, jenis sumber, cakupan fakta, jalur tautan internal, dan konsensus pihak ketiga. Pilih sejumlah kecil perubahan dengan hipotesis yang jelas.
Minggu 3: Eksekusi
Perbarui halaman yang sudah ada sebelum membuat halaman yang tumpang tindih. Tambahkan bukti orisinal, tingkatkan bagian yang menjawab pertanyaan, selesaikan masalah teknis, dan upayakan validasi eksternal yang autentik jika kesenjangannya berasal dari luar situs.
Minggu 4: Uji ulang dan pelajari
Jalankan ulang kohort tetap. Bandingkan prompt yang stabil, bukan hanya rata-rata portofolio. Catat apakah perubahan meningkatkan penyebutan, rekomendasi, sitasi ke situs milik sendiri, akurasi, atau traffic yang memenuhi kriteria. Jika memungkinkan, pertahankan klaster kontrol.
Template Pelaporan untuk Pimpinan
Laporan eksekutif yang berguna cukup disajikan dalam satu halaman:
Kumpulan prompt dan ukuran sampel.
Cakupan berdasarkan intent dan pasar.
Cakupan rekomendasi dan sitasi ke situs milik sendiri.
Kompetitor yang mengalami kenaikan atau penurunan pangsa.
Lima kesenjangan komersial teratas beserta buktinya.
Tindakan yang telah dilakukan dan halaman yang terdampak.
Hasil pengujian ulang dan tingkat keyakinan.
Sinyal GSC, GA4, lead, atau CRM jika tersedia.
Hindari mengklaim bahwa suatu optimasi “menyebabkan” perubahan jika satu-satunya bukti berasal dari satu kali proses jawaban. Gunakan frasa seperti “berkaitan dengan”, “teramati setelah”, atau “memerlukan lebih banyak observasi”, kecuali rancangan pengukurannya mendukung klaim sebab-akibat.
Kesalahan Umum dalam Cakupan Prompt
Hanya melacak prompt yang menyebut brand.
Membiarkan daftar prompt berubah tanpa dicatat di antara laporan.
Mencampur penyebutan informasional dengan rekomendasi komersial.
Melaporkan skor proprietary tanpa denominator atau bobotnya.
Menganggap setiap ketidakhadiran sebagai kesenjangan konten.
Mengabaikan perbedaan negara dan bahasa.
Menghitung variasi prompt duplikat sebagai permintaan yang independen.
Merayakan penyebutan meskipun fakta produk keliru.
Mengoptimalkan untuk satu platform saja sementara pembeli menggunakan beberapa platform.
Mengukur visibilitas tanpa langkah lanjutan di tingkat halaman atau pendapatan.
FAQ
Berapa banyak prompt yang sebaiknya dilacak oleh tim GEO?
Tidak ada jumlah universal. Gunakan prompt secukupnya untuk mewakili intent, persona, produk, pasar, dan bahasa prioritas tanpa memenuhi kumpulan dengan duplikat. Laporkan ukuran sampel dan perluas hanya jika klaster baru mengubah keputusan.
Apakah cakupan prompt sama dengan share of voice?
Tidak. Cakupan prompt mengukur seberapa banyak dari kumpulan pertanyaan yang telah ditentukan menghasilkan hasil brand yang diinginkan. Share of voice membandingkan kehadiran brand yang diamati dengan kompetitor. Keduanya berguna, tetapi menjawab pertanyaan yang berbeda.
Haruskah volume prompt digunakan sebagai bobot?
Volume prompt dapat menjadi salah satu input, tetapi volume prompt percakapan merupakan estimasi, bukan sensus lengkap. Gabungkan dengan intent bisnis, bukti penjualan, dan kepentingan strategis; tampilkan metode pembobotannya.
Seberapa sering prompt harus dijalankan ulang?
Klaster bernilai tinggi dan volatil mungkin perlu dipantau setiap minggu; klaster edukasi yang lebih lambat berubah dapat ditinjau lebih jarang. Konsistensi platform, pasar, dan metode lebih penting daripada memeriksa semuanya setiap hari.
Apa tindakan pertama yang paling berguna setelah audit?
Perbaiki kesenjangan bernilai tertinggi dengan bukti terkuat. Tindakan tersebut bisa berupa memperbarui landing page yang sudah ada, mengoreksi fakta produk, meningkatkan crawlability, menambahkan bukti, atau memperkuat sumber pihak ketiga—bukan otomatis membuat artikel baru.
Dageno is the research and insights team at Dageno AI, publishing industry reports and expert analysis on AI Search Visibility, Generative Engine Optimization (GEO), and AI-powered search discovery.
 Alexa for Shopping