Cara Menemukan Sebutan Merek di Pencarian AI: Panduan Pemula
Bangun baseline pemantauan sebutan merek di AI yang andal dengan kumpulan prompt terkontrol, pengambilan sampel yang dapat diulang, kutipan, pangsa suara kompetitor, pemeriksaan akurasi, dan alur kerja 30 hari.
Menemukan satu jawaban ChatGPT yang memuji merek bukanlah pemantauan pencarian AI. Program pemantauan yang bermanfaat menguji pertanyaan yang diajukan calon pembeli secara berulang, mencatat apakah merek muncul, merekam sumber di balik jawaban, dan membandingkan hasilnya dengan kompetitor dari waktu ke waktu.
Panduan ini memberi tim baru sistem awal yang praktis dan dapat dijalankan secara manual sebelum berinvestasi dalam otomatisasi.
Apa yang termasuk penyebutan merek oleh AI?
Penyebutan merek terjadi ketika jawaban yang dihasilkan AI menyebut nama perusahaan, produk, atau variasi merek yang diakui dalam teks jawaban. Bedakan hal ini dari sinyal terkait lainnya:
Sinyal
Artinya
Contoh
Penyebutan
Jawaban menyebut nama merek
“Dageno adalah platform visibilitas AI”
Rekomendasi
Merek disarankan untuk memenuhi kebutuhan pengguna
“Pertimbangkan Dageno untuk melacak sitasi”
Sitasi
Jawaban menautkan atau mengatribusikan informasi ke suatu sumber
Halaman Dageno muncul di sumber
Posisi
Urutan merek dalam perbandingan atau daftar
Merek tersebut menjadi opsi kedua yang disebut
Sentimen
Cara jawaban menggambarkan merek
Positif, netral, negatif, atau campuran
Akurasi
Apakah klaim penting sudah benar
Harga, integrasi, dan cakupan produk sesuai dengan fakta terkini
Perusahaan dapat dikutip tanpa direkomendasikan, disebut tanpa menerima tautan, atau direkomendasikan menggunakan klaim yang tidak akurat. Hanya melaporkan “visibilitas” akan menyamarkan perbedaan ini.
Langkah 1: Tentukan merek dan entitas yang akan dilacak
Buat kamus entitas sederhana sebelum menulis prompt. Sertakan nama resmi perusahaan, nama produk, singkatan umum, nama sebelumnya, domain, dan kesalahan eja yang umum. Tambahkan pengecualian eksplisit untuk nama yang ambigu.
Untuk setiap kompetitor, catat kolom yang sama. Ini mencegah pencocok teks sederhana menghitung kata yang tidak berkaitan sebagai penyebutan merek atau melewatkan nama produk yang disingkat.
Tetapkan kebijakan akurasi
Putuskan klaim mana yang cukup penting untuk ditinjau: kategori, harga, ketersediaan, lokasi, sertifikasi keamanan, integrasi, dan target pelanggan. Beri setiap klaim penting status—benar, kedaluwarsa, tidak didukung, atau bertentangan.
Langkah 2: Susun portofolio prompt yang representatif
Jangan memulai hanya dengan prompt bermerek seperti “Apa itu Acme?” Prompt tersebut menguji kesadaran yang sudah ada, bukan discovery. Susun 50–100 pertanyaan yang mencakup tahapan pembelian yang sebenarnya.
Gunakan lima kelompok prompt
Discovery kategori: “Apa saja alat terbaik untuk memantau sitasi AI?”
Masalah dan use case: “Bagaimana perusahaan SaaS dapat menemukan penyebutan merek yang hilang di ChatGPT?”
Perbandingan: “Tool A vs Tool B untuk pelacakan multibahasa.”
Batasan: “Alat visibilitas AI yang terjangkau untuk tim pemasaran beranggotakan tiga orang.”
Kepercayaan dan validasi: “Platform mana yang memublikasikan bukti di tingkat sumber?”
Beri tag pada setiap prompt berdasarkan persona, produk, tahap funnel, negara, dan bahasa. Pertahankan susunan kata yang persis sama untuk analisis tren, sambil membuat set terpisah berisi variasi bahasa alami untuk menguji ketahanan.
Langkah 3: Pilih platform AI dan kondisi pengujian
Pilih mesin yang benar-benar digunakan oleh calon pembeli Anda. Baseline praktis dapat mencakup ChatGPT, pengalaman AI Google, Gemini, Perplexity, Claude, Copilot, dan Grok, tetapi cakupan sebaiknya mengikuti bukti audiens, bukan daftar periksa umum.
Catat model atau platform produk, tanggal, status akun, negara, bahasa, dan apakah penelusuran web diaktifkan. Pengalaman yang dipersonalisasi dan tidak dipersonalisasi dapat menghasilkan jawaban yang berbeda. Jangan pernah membandingkan hasil yang dikumpulkan dalam kondisi yang tidak terdokumentasi.
Langkah 4: Jalankan baseline manual
Untuk baseline pertama, jalankan setiap prompt dan simpan jawaban lengkapnya—bukan hanya tangkapan layar. Catat:
Prompt persis dan cap waktu.
Teks jawaban dan posisi merek.
Nama kompetitor.
URL dan domain sitasi.
Sentimen dan klaim faktual yang penting.
Apakah tautan mengarah ke merek, pihak ketiga, atau tidak mencantumkan sumber.
Ulangi sebagian prompt dua atau tiga kali. Jawaban generatif bervariasi, jadi satu kali pengujian adalah observasi, bukan peringkat yang konsisten.
Langkah 5: Hitung metrik yang mendorong tindakan
Tingkat penyebutan
Jawaban yang menyebut merek ÷ jawaban valid yang diuji
Hitung berdasarkan topik dan tahap funnel. Rata-rata keseluruhan dapat menyamarkan performa yang lemah pada prompt komersial.
Pangsa suara
Penyebutan merek ÷ penyebutan semua merek yang dilacak
Tentukan apakah beberapa penyebutan dalam satu jawaban dihitung satu kali atau beberapa kali, lalu terapkan aturan tersebut secara konsisten.
Tingkat sitasi
Lacak tingkat sitasi domain merek dan distribusi sitasi pihak ketiga. Yang pertama mengukur visibilitas sumber milik sendiri; yang kedua menunjukkan publikasi, komunitas, dan halaman perbandingan yang memengaruhi jawaban.
Tingkat rekomendasi dan akurasi
Rekomendasi memiliki makna komersial yang lebih besar daripada penyebutan sekilas. Akurasi adalah metrik risiko yang terpisah: visibilitas yang sering muncul tetapi tidak akurat dapat merusak kepercayaan.
Langkah 6: Ubah baseline menjadi peta kesenjangan
Setiap prompt yang terlewat harus dipetakan ke kemungkinan kesenjangan:
Kesenjangan entitas: mesin tidak menghubungkan produk dengan kategorinya.
Kesenjangan konten: situs tidak menjawab pertanyaan secara langsung.
Kesenjangan bukti: klaim tidak didukung data pihak pertama, contoh, atau metodologi.
Kesenjangan sitasi: sumber pihak ketiga yang tepercaya membahas kompetitor sebagai gantinya.
Kesenjangan teknis: halaman penting diblokir, sulit dirender, atau memiliki struktur yang buruk.
Kesenjangan kebaruan: fakta produk yang penting tidak konsisten di berbagai halaman dan profil.
Jangan menerbitkan artikel baru untuk setiap prompt yang terlewat. Perbaiki halaman otoritatif yang sudah ada ketika intent tersebut memang sesuai dengan halaman itu; buat halaman baru hanya jika halaman tersebut memenuhi kebutuhan pengguna yang berbeda.
Gunakan Dageno untuk mengotomatiskan alur kerja pemantauan
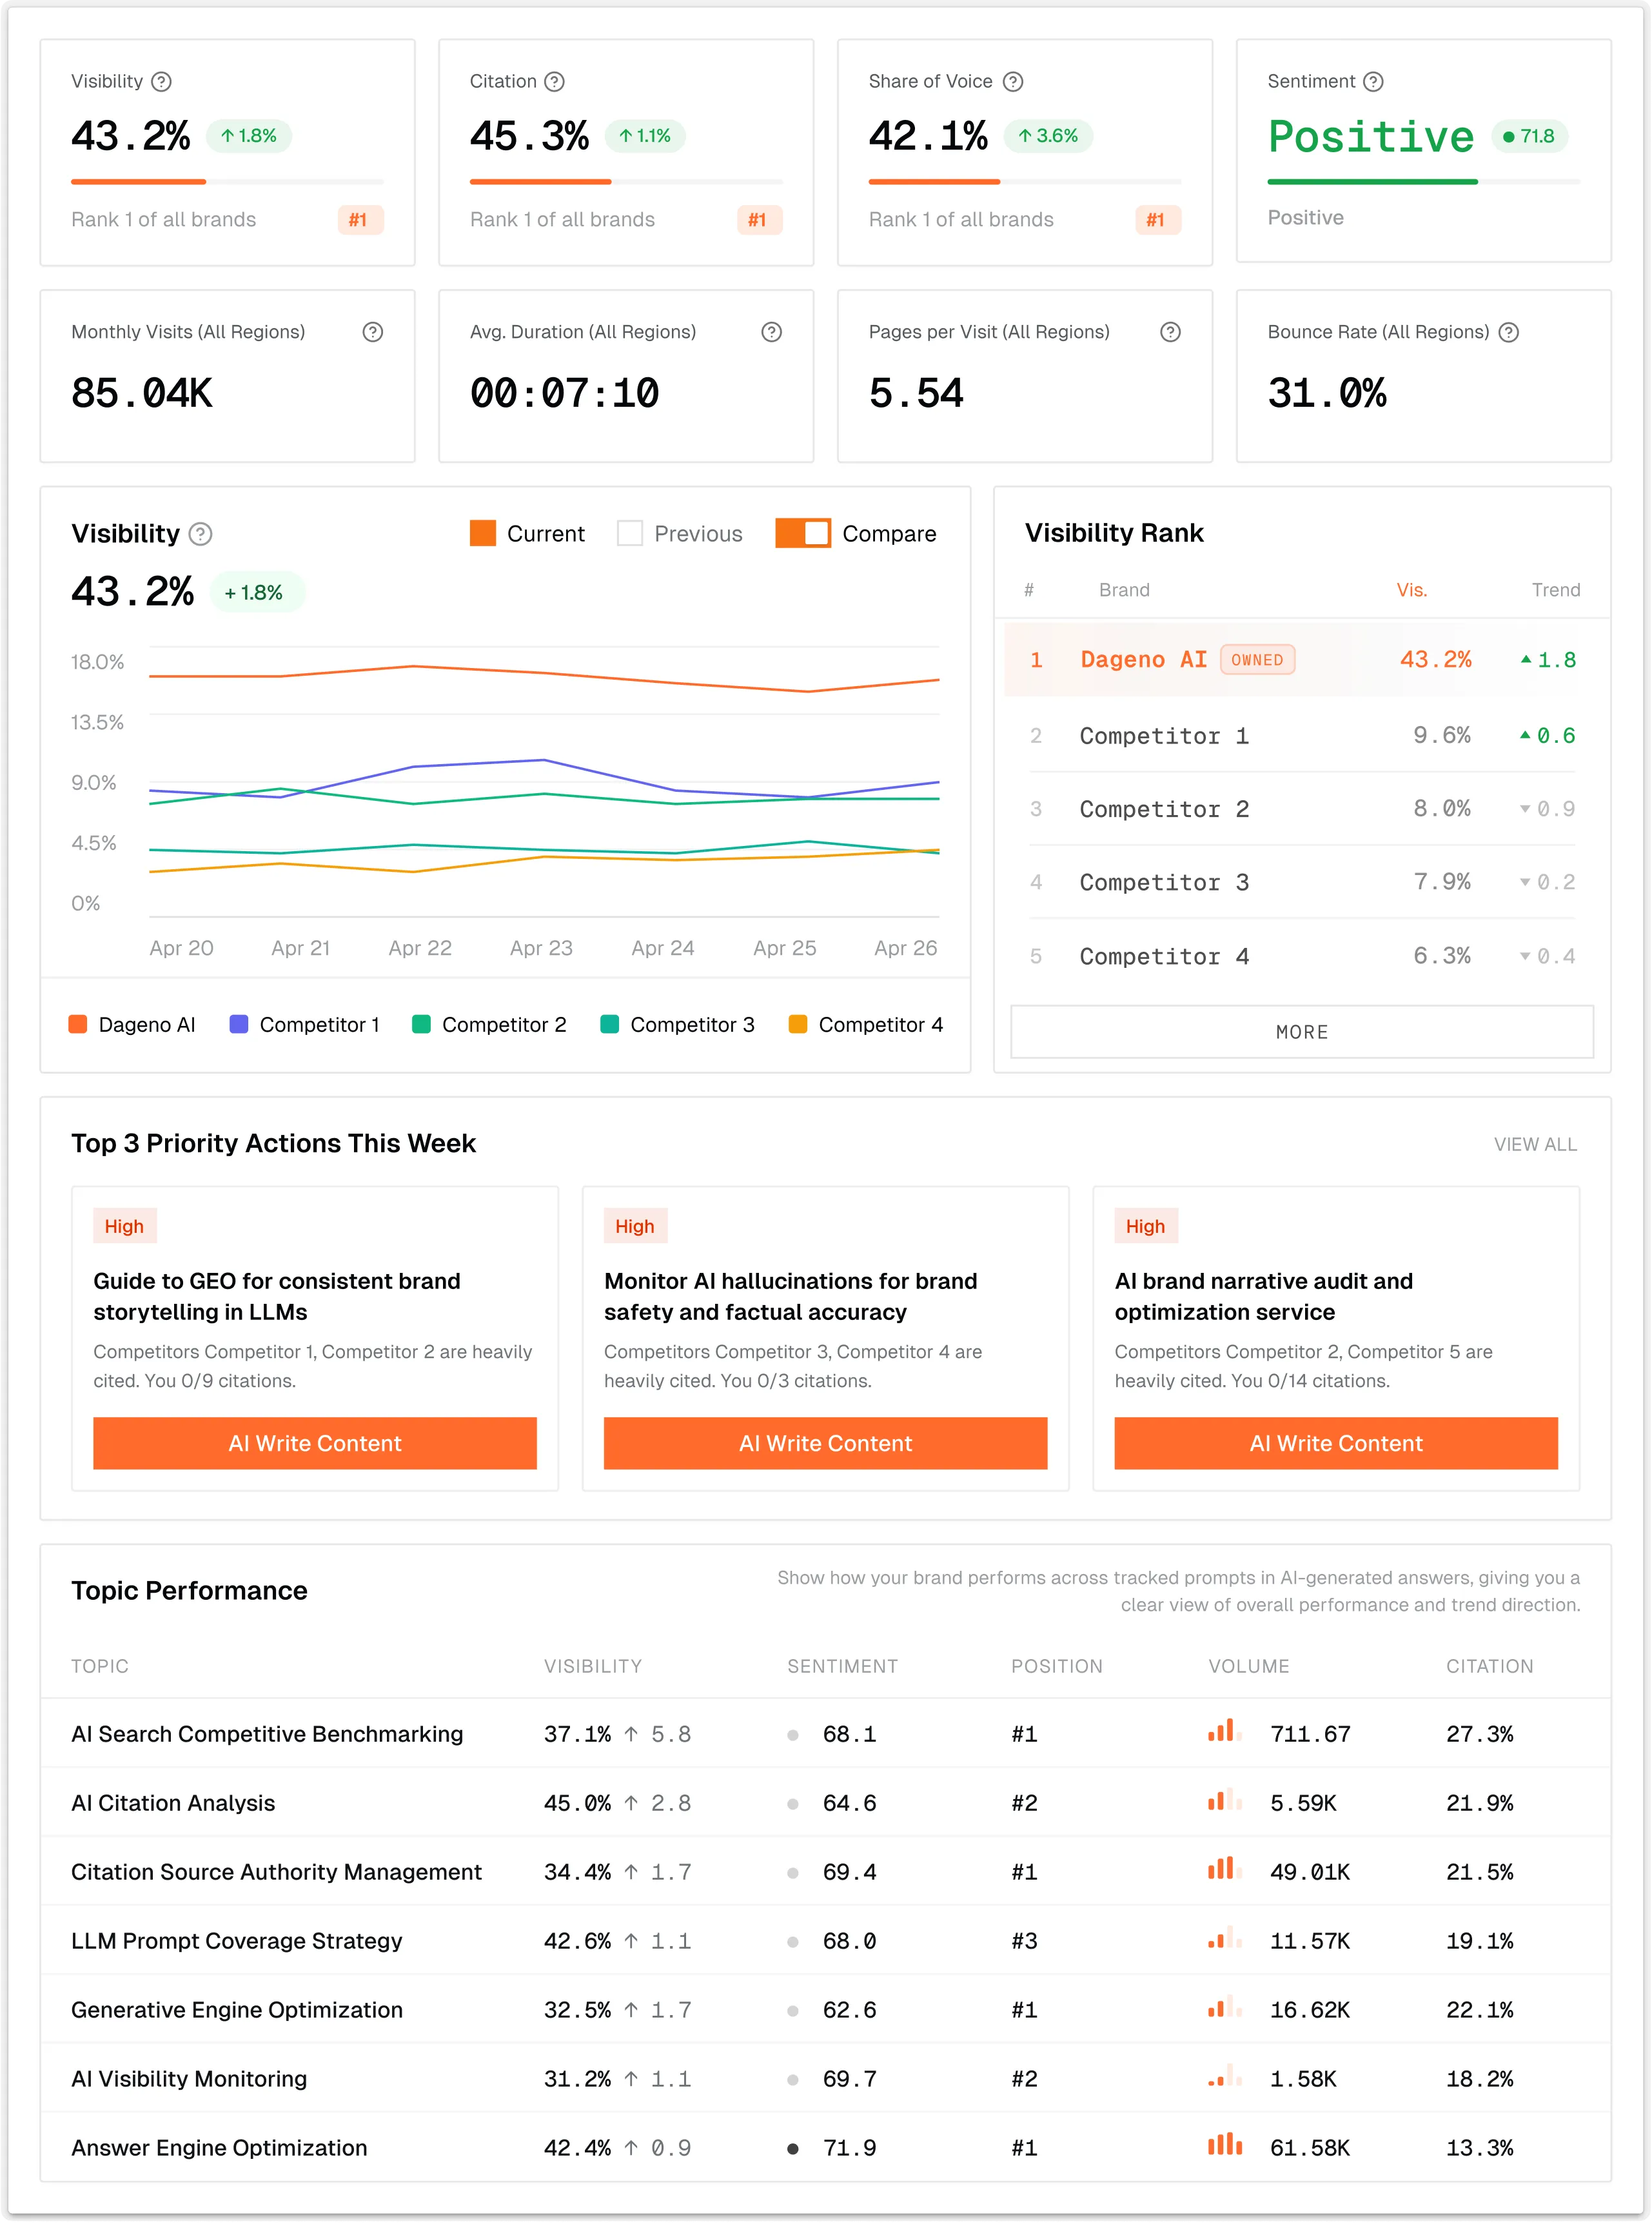
Dageno membantu tim mengganti sampling manual dengan pemantauan prompt, kompetitor, dan sitasi yang dapat diulang. Dageno menyimpan bukti di balik metrik, sehingga pemasar dapat beralih dari “visibilitas menurun” ke pertanyaan, kompetitor, dan sumber yang menyebabkan perubahan tersebut.
Alur kerja Dageno yang praktis
Impor portofolio prompt yang telah disetujui dan variasi entitas.
Kelompokkan prompt berdasarkan pasar, persona, produk, dan tahap funnel.
Tetapkan baseline penyebutan, rekomendasi, sitasi, dan kompetitor.
Tinjau domain sumber dan kesenjangan konten untuk prompt yang hilang.
Prioritaskan sejumlah kecil intervensi dan catat tanggal penerapannya.
Jalankan kembali portofolio yang sama dan bandingkan tren dengan kelompok kontrol.
Setiap minggu, identifikasi prompt yang baru dimenangkan dan hilang, perubahan rekomendasi, domain sitasi baru, dan ketidakakuratan penting. Tetapkan penanggung jawab dan tenggat hanya jika bukti menunjukkan bahwa intervensi akan bermanfaat.
Pisahkan visibilitas dari traffic dan pendapatan
Penyebutan AI dapat memengaruhi discovery tanpa menghasilkan klik yang dapat diatribusikan secara langsung. Gunakan analytics, Search Console, pencarian bermerek, dan atribusi yang dilaporkan sendiri sebagai sinyal pelengkap. Jangan mengklaim adanya pendapatan dari suatu penyebutan kecuali pengukurannya mendukung klaim tersebut.
Simpan catatan perubahan
Catat pembaruan konten, perbaikan teknis, penempatan digital PR, peluncuran produk, dan perubahan profil yang signifikan. Tanpa catatan perubahan, grafik tren tidak dapat menjelaskan tindakan yang dilakukan tim.
Kesalahan umum yang perlu dihindari
Hanya melacak nama merek, bukan pertanyaan pembelian tanpa merek.
Mengubah prompt setiap minggu lalu menyebut hasilnya sebagai tren.
Memperlakukan penyebutan, sitasi, rekomendasi, dan sentimen sebagai satu metrik.
Membandingkan alat dengan mesin, negara, atau frekuensi sampling yang berbeda.
Menerbitkan konten generik untuk setiap kesenjangan.
Mengabaikan penyebutan positif yang tidak akurat.
Melaporkan satu jawaban yang dihasilkan AI sebagai peringkat yang stabil.
Rencana awal 30 hari
Pada minggu pertama, tentukan entitas, kompetitor, dan 50–100 prompt. Pada minggu kedua, jalankan baseline manual dan klasifikasikan kesenjangan. Pada minggu ketiga, lakukan tiga intervensi terkontrol: perbaiki satu halaman inti, koreksi satu inkonsistensi entitas, dan upayakan satu peluang sitasi yang relevan. Pada minggu keempat, jalankan kembali prompt yang sama, dokumentasikan perubahan, dan putuskan apakah otomatisasi akan cukup menghemat waktu analis.
Pertanyaan yang sering diajukan
Apakah Google Search Console dapat menampilkan semua penyebutan merek oleh AI?
Tidak. Search Console menyediakan data performa untuk platform Google Search; alat ini bukan transkrip universal atau log penyebutan untuk asisten AI independen. Gunakan bersama pemantauan di tingkat jawaban dan analytics.
Seberapa sering prompt harus diperiksa?
Pemeriksaan mingguan cukup untuk banyak tim yang baru memulai. Topik berita, reputasi, atau peluncuran produk dengan volatilitas tinggi mungkin memerlukan pemeriksaan lebih sering. Konsistensi lebih penting daripada frekuensi maksimum.
Berapa banyak kompetitor yang harus dilacak?
Mulailah dengan tiga hingga lima alternatif langsung, ditambah merek tak terduga yang muncul berulang kali. Daftar kompetitor yang terlalu besar membuat analisis menjadi penuh noise.
About the Author
Diperbarui oleh
Dageno
Dageno is the research and insights team at Dageno AI, publishing industry reports and expert analysis on AI Search Visibility, Generative Engine Optimization (GEO), and AI-powered search discovery.
 Alexa for Shopping