Bagaimana Pertanyaan Pembelian di AI Berbeda di Setiap Pasar
Dalam uji FTA Global, rata-rata 2,9 dari lima merek teratas yang direkomendasikan AI berubah di luar acuan "New York + bahasa Inggris". Artikel ini menguraikan empat cara pertanyaan pembelian di AI berbeda antarpasar (tempat orang bertanya, syarat lokal, sumber yang dikutip, dan merek yang direkomendasikan) serta memberikan metode lima langkah untuk membandingkannya.
Dalam artikel ini, "pertanyaan pembelian di AI" berarti pertanyaan tentang belanja, perbandingan, dan harga yang diajukan orang kepada ChatGPT, Gemini, Google AI Mode, dan alat AI lainnya.
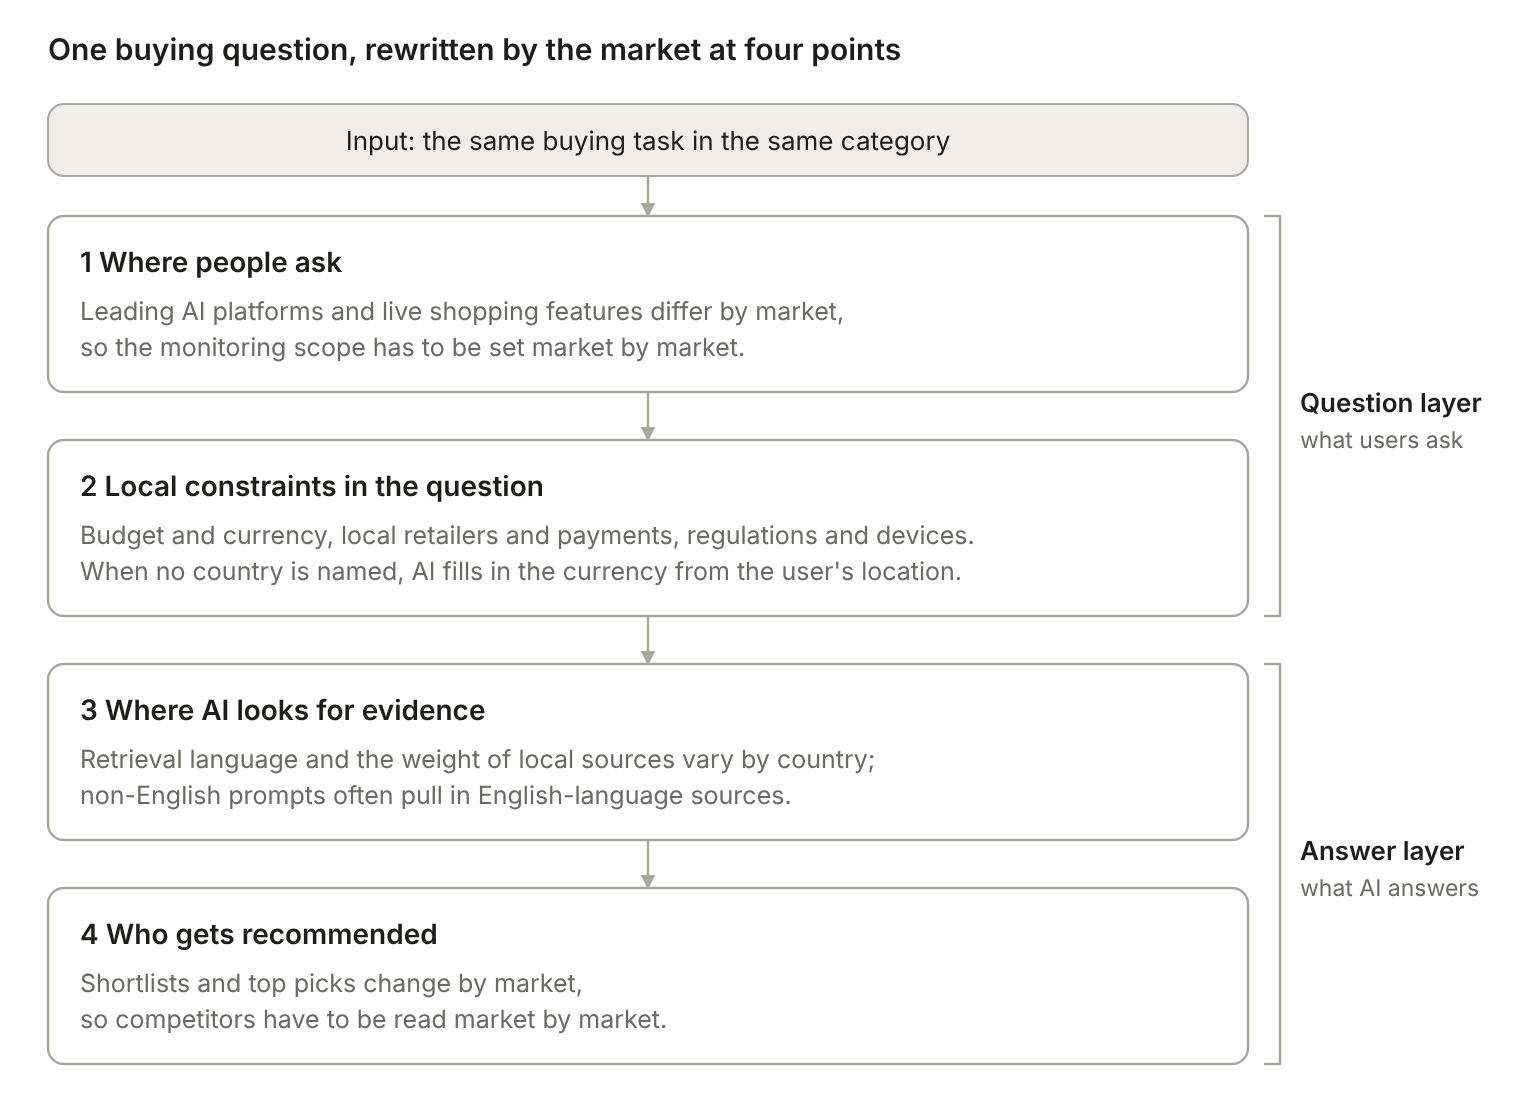
Pertanyaan pembelian yang sama dalam kategori yang sama berubah setidaknya di empat hal saat Anda pindah ke negara, wilayah, atau pasar bahasa lain: AI mana yang ditanya orang, syarat lokal apa yang dibawa pertanyaan itu, di mana AI mencari bukti, dan merek mana yang akhirnya direkomendasikan.
Uji publik menunjukkan perbedaannya besar. FTA Global menguji 10 kategori software di ChatGPT dan Gemini: di luar acuan "New York + bahasa Inggris", rata-rata 2,9 dari lima merek teratas yang direkomendasikan berubah. Dalam uji lima bahasa yang terpisah, easyJet menjadi pilihan utama di 72,5% jawaban berbahasa Rusia, tetapi hanya di 12,5% jawaban berbahasa Persia.
Satu catatan di awal (ini penilaian kami): sebagian besar riset publik mengukur jawaban apa yang didapat pertanyaan yang sama di berbagai pasar. Sangat sedikit yang mengukur bagaimana orang di tiap pasar benar-benar bertanya. Untuk itu dibutuhkan sampel pertanyaan nyata dalam bahasa lokal; menerjemahkan prompt bahasa Inggris tidak akan memberikannya.
Dalam praktik, perlakukan "negara × bahasa × platform" sebagai satu unit perbandingan. Ambil sampel setiap unit berulang kali dengan kumpulan pertanyaan yang sudah dilokalkan, lalu bandingkan dalam empat dimensi. Saat menemukan perbedaan, jelaskan dulu dengan harga lokal, ketersediaan, dan sumber yang dikutip, baru putuskan apakah konten perlu diubah.
Mengapa pertanyaan pembelian di AI dalam kategori yang sama berbeda di setiap pasar
"Pasar" di sini adalah tiga variabel yang bertumpuk: negara atau wilayah pengguna, bahasa pertanyaan, dan platform AI. Jika salah satunya berubah, pertanyaan pembelian yang sama bisa mendapat jawaban berbeda. Inggris dan AS memakai bahasa yang sama, sedangkan India mencampur bahasa Inggris, Hindi, dan Hinglish, jadi negara dan bahasa perlu dicatat terpisah.
Lokasi saja bisa mengubah jawaban. Dalam uji yang diterbitkan pada Oktober 2026, Massive mengirim prompt yang sama ke ChatGPT, menanyakan "harga umum secangkir kopi di kafe", dari Amerika Serikat, Brasil, dan Jepang secara bersamaan. Prompt itu tidak menyebut negara. Jawaban dari AS menyebut dolar, sedangkan jawaban dari Brasil dan Jepang menambahkan harga dalam real dan yen. Setiap negara hanya dijalankan sekali, jadi uji ini menunjukkan bahwa efeknya ada, bukan seberapa sering terjadi.
Pisahkan dua lapisan dalam analisis Anda. Lapisan pertanyaan adalah apa yang ditanyakan pengguna dan syarat apa yang mereka sertakan. Lapisan jawaban adalah sumber apa yang dipakai AI dan merek apa yang direkomendasikannya. Saat sebuah merek "hilang" di suatu pasar, bisa jadi pengguna lokal memang mengajukan pertanyaan berbeda, atau sumber dan preferensi AI-nya berubah. Empat bagian berikutnya mengikuti urutan itu.
Empat lapis perbedaan, dibahas di empat bagian berikut.
Perbedaan 1: AI yang ditanya orang berbeda di setiap pasar
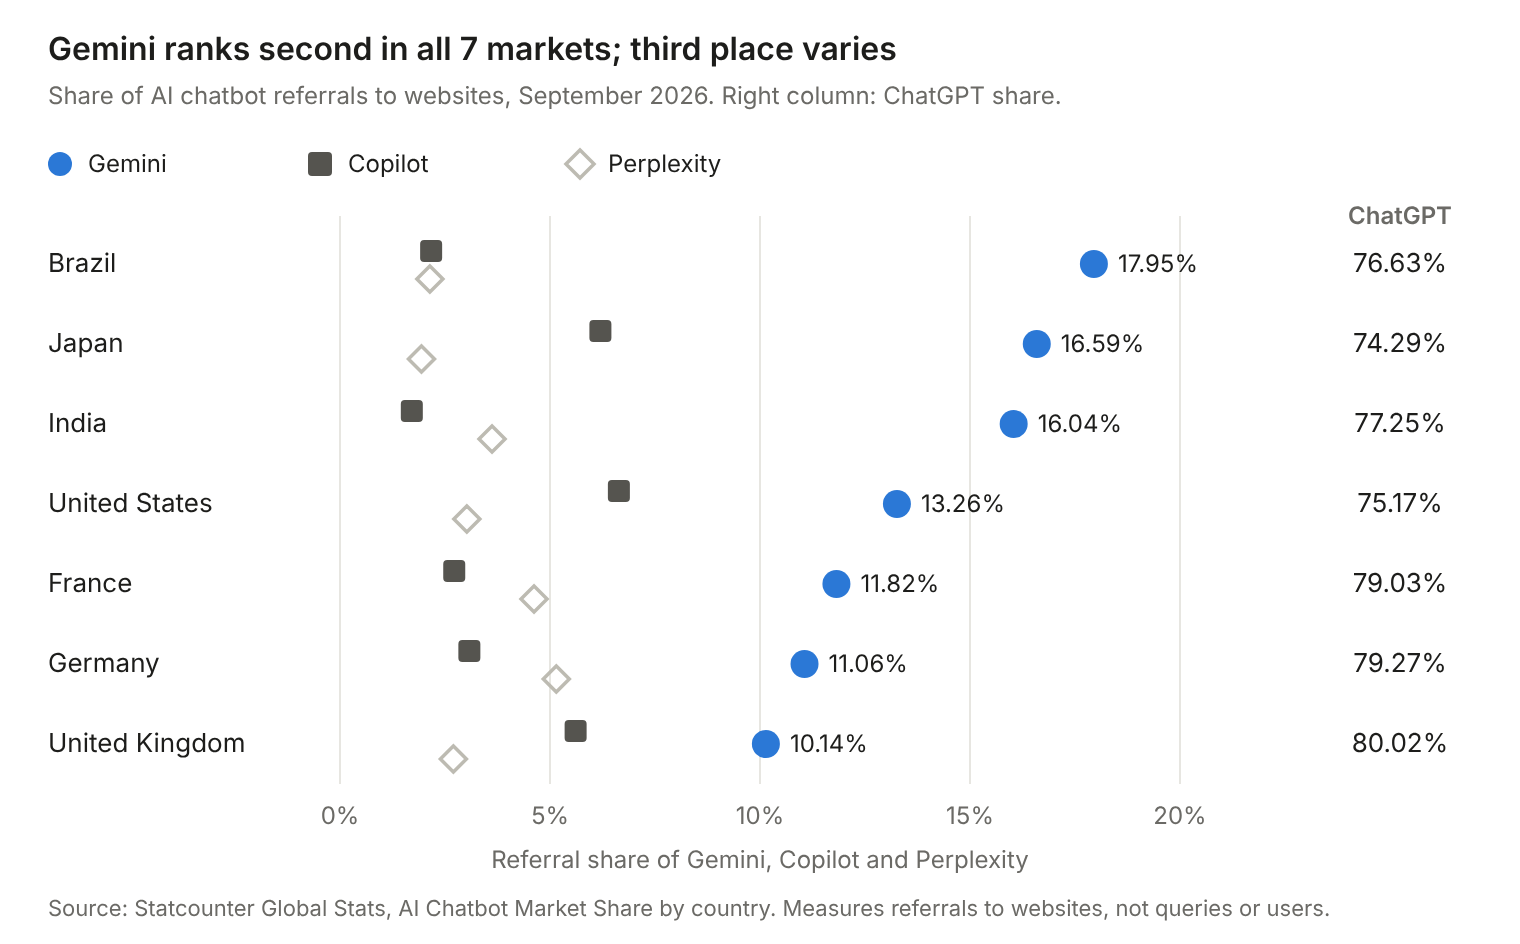
ChatGPT memimpin di semua pasar luar negeri utama, tetapi urutan di belakangnya berbeda. Data Statcounter September 2026 menempatkan ChatGPT di kisaran 74%–80% di masing-masing dari tujuh pasar di bawah. Gemini di atas 16% di Brasil, Jepang, dan India, tetapi sekitar 10% di Inggris. Copilot di atas 6% di AS dan Jepang, tetapi di bawah 2% di India. Perplexity lebih tinggi di Jerman dan Prancis dibanding pasar lain yang ditampilkan.
Sumber: Statcounter Global Stats, pangsa rujukan chatbot AI, September 2026, tujuh pasar.
Perhatikan metriknya. Statcounter mengukur pangsa setiap chatbot dalam rujukan ke situs web (berdasarkan tampilan halaman di situs yang dilacaknya). Ini bukan jumlah pertanyaan atau pengguna, dan Grok tidak termasuk karena tidak meneruskan data rujukan. Data ini menunjukkan platform mana yang mengirim orang ke situs web di suatu pasar; data ini tidak bisa dipakai untuk memperkirakan volume pertanyaan belanja.
Data survei menunjukkan arah yang sama. Survei World Retail Congress yang ditugaskan Vercel (Mei 2026, 4.000 pembeli Eropa), seperti dilaporkan Pygmalios, menemukan bahwa 49% responden di Eropa Selatan memakai ChatGPT saat berbelanja, dibanding 40% di negara Nordik, 38% di Jerman, dan 33% di Inggris. Separuh responden di Inggris sama sekali tidak memakai pencarian AI saat berbelanja, dibanding 32% di Eropa Selatan. Angka-angka ini berasal dari laporan mandiri, Eropa Selatan dan negara Nordik adalah kelompok gabungan beberapa negara, dan Pygmalios sendiri mengingatkan bahwa "niat yang dinyatakan biasanya melebih-lebihkan perilaku yang teramati".
Urutan peluncuran fitur juga menciptakan perbedaan. Saat OpenAI meluncurkan Instant Checkout di dalam ChatGPT pada 29 September 2025, fitur ini hanya terbuka bagi pengguna di AS, dan pedagangnya hanya penjual Etsy di AS. Permintaan seperti "belikan untuk saya" bisa diselesaikan di dalam chat di pasar yang punya fitur checkout, tetapi di tempat lain hanya bisa mengarahkan pengguna ke situs eksternal. Kami belum memverifikasi pasar mana yang dicakup fitur ini per Oktober 2026; periksa hal ini secara terpisah sebelum membandingkan pasar.
Perbedaan 2: Pertanyaan pembelian membawa syarat lokal yang berbeda
Bahkan saat pertanyaannya "mana yang sebaiknya saya pilih", setiap pasar menambahkan syarat yang berbeda. Sebagian ditulis di dalam pertanyaan; sebagian lagi diisi dari lokasi pengguna.
Syarat yang ditulis dalam pertanyaan: anggaran dalam mata uang lokal, platform ritel lokal, opsi pembayaran dan pengiriman, regulasi lokal, atau ketentuan pajak. Pembayaran adalah contoh yang jelas. Dalam uji FTA Global, Stripe menempati peringkat pertama di New York, London, Madrid, Paris, dan Berlin, tetapi tidak masuk lima besar di Mumbai, Delhi, atau Bengaluru. Dengan ekosistem pembayaran lokal yang berbeda, "alat pembayaran apa yang sebaiknya dipakai usaha kecil" pada praktiknya menjadi pertanyaan lain.
Syarat yang diisi dari lokasi: meskipun pengguna tidak menyebut negara, AI menyimpulkan mata uang dan aturan dari lokasi, seperti yang ditunjukkan uji kopi di atas. Saat membandingkan pasar, catat di mana setiap jawaban dikumpulkan.
Seberapa jauh pertanyaan itu masuk ke perjalanan pembelian: dalam survei Deloitte Mei 2026 terhadap 13.500 konsumen di 15 negara Eropa, 42% responden di Spanyol bersedia membiarkan AI membuat keputusan pembelian untuk mereka, dibanding 27% di Finlandia. Di pasar tempat lebih banyak orang menyerahkan keputusan kepada AI, pertanyaan seperti "pilihkan saja satu untuk saya" atau "beri saya pilihan terbaik" mungkin lebih umum. Ini hipotesis yang perlu diuji dengan sampel pertanyaan lokal.
Tidak semua kebutuhan berbeda di setiap pasar. Dalam survei World Retail Congress di atas, perbandingan harga adalah penggunaan paling umum di kalangan pembeli yang memakai AI di semua wilayah (51%–55%). Penilaian kami: tindakan dalam pertanyaan cenderung mirip di berbagai pasar, dan perbedaannya terutama ada pada rentang anggaran, saluran yang tersedia, dan aturan lokal. Jadi saat menyusun pertanyaan, beri kolom tersendiri untuk anggaran dan mata uang, platform yang disebut, pembayaran dan pengiriman, regulasi, serta kondisi perangkat.
Perbedaan 3: AI mengutip sumber yang berbeda, dan tingkat kepercayaan pengguna terhadap AI juga berbeda
Untuk pertanyaan pembelian di pasar non-Inggris, sebagian besar bukti masih berasal dari halaman web berbahasa Inggris. Peec AI menganalisis lebih dari 10 juta prompt ChatGPT dan lebih dari 20 juta pencarian latar belakang (query fan-out), dan hanya menyimpan sesi yang lokasi penggunanya cocok dengan bahasa prompt. Hampir 78% sesi non-Inggris menambahkan riset berbahasa Inggris, dan 43% fan-out untuk prompt non-Inggris dijalankan dalam bahasa Inggris. Menurut bahasa, sesi berbahasa Turki paling sering menambahkan riset bahasa Inggris (94%) dan sesi berbahasa Spanyol paling jarang (66%).
Bobot sumber lokal juga berbeda menurut negara. Dalam uji FTA Global, domain dan publikasi lokal mencakup 42% sumber yang dikutip di Jerman, 34% di Prancis, dan 17% di India. Di tempat yang sumber lokalnya kurang berbobot, merek lokal mungkin perlu tampil di situs berbahasa Inggris atau situs internasional agar masuk ke jawaban. Uji manual Peec AI memuat satu contoh: saat ditanya dalam bahasa Polandia dari alamat IP Polandia tentang situs lelang terbaik, ChatGPT tidak menyebut Allegro, platform lokal terbesar di Polandia, atau menempatkannya jauh di bawah daftar. Ini satu contoh, bukan hasil statistik.
Kepercayaan terhadap jawaban AI juga berbeda. Dalam survei Deloitte yang sama, 61% responden di Spanyol mengatakan percaya pada informasi dari AI, dibanding 36% di Finlandia. Hipotesis kami: di pasar dengan tingkat kepercayaan lebih rendah, pengguna lebih cenderung menelusuri sumber, ulasan, dan jaminan purnajual, sehingga materi yang bisa diverifikasi secara lokal lebih penting. Belum ada data publik yang menguji hal ini secara langsung.
Perbedaan 4: Merek yang direkomendasikan dan pesaing berubah
Jika tiga perbedaan pertama digabungkan, pengguna akhirnya melihat daftar pendek yang berbeda. Dengan "New York + bahasa Inggris" sebagai acuan, FTA Global mengulang pertanyaan pembelian usaha kecil yang sama di London, Madrid, Paris, Berlin, dan tiga kota di India:
Rata-rata, 2,9 dari lima merek teratas yang direkomendasikan berubah.
Perubahan terpusat di kategori yang berkaitan dengan uang dan kepatuhan: penggajian, akuntansi, pembayaran, dan SDM rata-rata berganti 4,4 merek, sedangkan manajemen proyek, konferensi video, dan penyimpanan cloud rata-rata hanya 1,5.
Dari total 206 merek, 159 hanya masuk lima besar di satu lokasi.
Bahasa juga mengubah pilihan utama. Uji oleh Reza Moaiandin, salah satu pendiri SALT.agency, yang diterbitkan di Search Engine Journal, mengajukan kumpulan pertanyaan pembelian yang sama dalam bahasa Inggris, Arab, Rusia, Mandarin sederhana, dan Persia. Uji intinya memakai Claude Sonnet 5 dengan pencarian web dimatikan, dikumpulkan pada 7 September 2026, dengan 40 kali jalan per pasangan skenario dan bahasa. Tabel menunjukkan porsi jawaban yang menempatkan setiap merek sebagai pilihan utama:
Skenario
Merek
Porsi tertinggi
Porsi terendah
Penerbangan pulang-pergi London–Tenerife
easyJet
Rusia 72,5%
Persia 12,5%
Headphone peredam bising di bawah £400
Sony
Rusia dan Persia 100%
Inggris 50%
CRM untuk usaha kecil di Inggris
HubSpot CRM
Inggris 22,5%
Arab 2,5%
Robot vakum di bawah £500
Roborock
Rusia 97,5%
Inggris dan Arab 87,5%
Baris robot vakum menunjukkan bahwa tidak semua kategori berayun lebar. Dalam uji yang sama, menyalakan pencarian web untuk dua kategori mengubah pilihan utama di 7 dari 10 pasangan kategori dan bahasa. Untuk dua kategori yang sama dengan pencarian dimatikan, pilihan utama ChatGPT sama dengan Claude hanya di 1 dari 10 pasangan, dan sama dengan Gemini di 5. Penulisnya mencatat bahwa data dikumpulkan dalam satu sore saja dan hasilnya bersifat indikatif.
Riset akademis juga melihat kecenderungan serupa. Makalah EMNLP 2024 "Global is Good, Local is Bad?" menemukan bahwa LLM lebih sering mengaitkan atribut positif dengan merek global dan secara tidak proporsional merekomendasikan hadiah mewah kepada orang di negara berpenghasilan tinggi, meski efek negara asal bisa menguntungkan merek lokal dalam konteks tertentu. Bagi merek, ini berarti pesaing bersifat spesifik per pasar: merek yang Anda hadapi langsung di AS bisa digantikan kelompok merek lokal lain di India atau Polandia.
Cara membandingkan pertanyaan pembelian antarpasar secara sistematis
Perlakukan "negara atau wilayah × bahasa × platform" sebagai unit perbandingan terkecil dan ikuti lima langkah.
Tentukan unit perbandingan: catat negara atau wilayah, bahasa, dan platform untuk setiap unit. Pisahkan negara multibahasa berdasarkan bahasa, misalnya bahasa Inggris dan Hindi di India, atau bahasa Inggris dan Prancis di Kanada.
Susun kumpulan pertanyaan yang dilokalkan: kumpulkan rumusan nyata dari sumber lokal seperti saran pencarian lokal, forum, serta catatan layanan pelanggan dan penjualan, lalu minta penutur asli meninjaunya. Simpan satu set tugas pembelian yang sama untuk semua pasar sebagai pembanding, lalu tambahkan pertanyaan khas setiap pasar.
Kunci kondisi dan ambil sampel berulang kali: gunakan rentang waktu, model, dan pengaturan pencarian yang sama, dan ulangi setiap kondisi beberapa kali. FTA Global menjalankan setiap kondisi 5 kali; uji SALT 40 kali. Catat lokasi pengumpulan dan status akun.
Bandingkan dalam empat dimensi: lihat tabel di bawah.
Jelaskan perbedaan dengan fakta lokal: periksa dulu harga lokal, ketersediaan, saluran, dan regulasi, lalu putuskan apakah perlu membuat konten lokal, memperbarui halaman bersama, atau terus mengamati.
Dimensi
Yang dicatat untuk setiap pasar
Salah baca yang umum
Tempat orang bertanya
Platform AI utama di pasar lokal; apakah kartu belanja, checkout, dan fitur serupa tersedia
Hanya menguji ChatGPT, hanya dalam bahasa Inggris AS
Syarat dalam pertanyaan
Teks asli pertanyaan; anggaran dan mata uang; platform, pembayaran, pengiriman, regulasi, dan perangkat yang disebut
Menganggap pertanyaan bahasa Inggris yang diterjemahkan sebagai pertanyaan lokal
Sumber bukti
URL yang dikutip, bahasa sumber, situs lokal atau internasional
Menghitung domain tanpa membaca sumbernya
Rekomendasi
Pilihan utama, daftar lima besar, apakah merek Anda muncul dan dalam konteks apa
Membiarkan satu tangkapan layar mewakili seluruh pasar
Membandingkan pertanyaan pembelian antarpasar luar negeri dengan Dageno
Empat dimensi di atas terhubung dengan beberapa fitur Dageno:
Cross-Model and Regional Benchmarking: membandingkan visibilitas, peringkat, dan pesaing terdepan merek Anda di berbagai model AI dan wilayah, agar angka rata-rata tidak menyembunyikan tempat posisi Anda berubah.
Regional Comparison: mengumpulkan jawaban AI yang bisa diamati, konteks persaingan, dan sumber yang terlihat dari berbagai pasar dan bahasa ke dalam satu tampilan yang bisa ditinjau.
AI Search Intents: mengelompokkan prompt pasar berdasarkan niat; untuk setiap kelompok, Anda bisa memeriksa merek mana yang disebut jawaban dan halaman mana yang dikutip.
Jika tujuannya memilih pasar berikutnya, solusi ekspansi pasar merangkai modul-modul ini menjadi tiga pemeriksaan: bandingkan pasar, pahami setiap pasar, dan pilih yang perlu diperiksa.
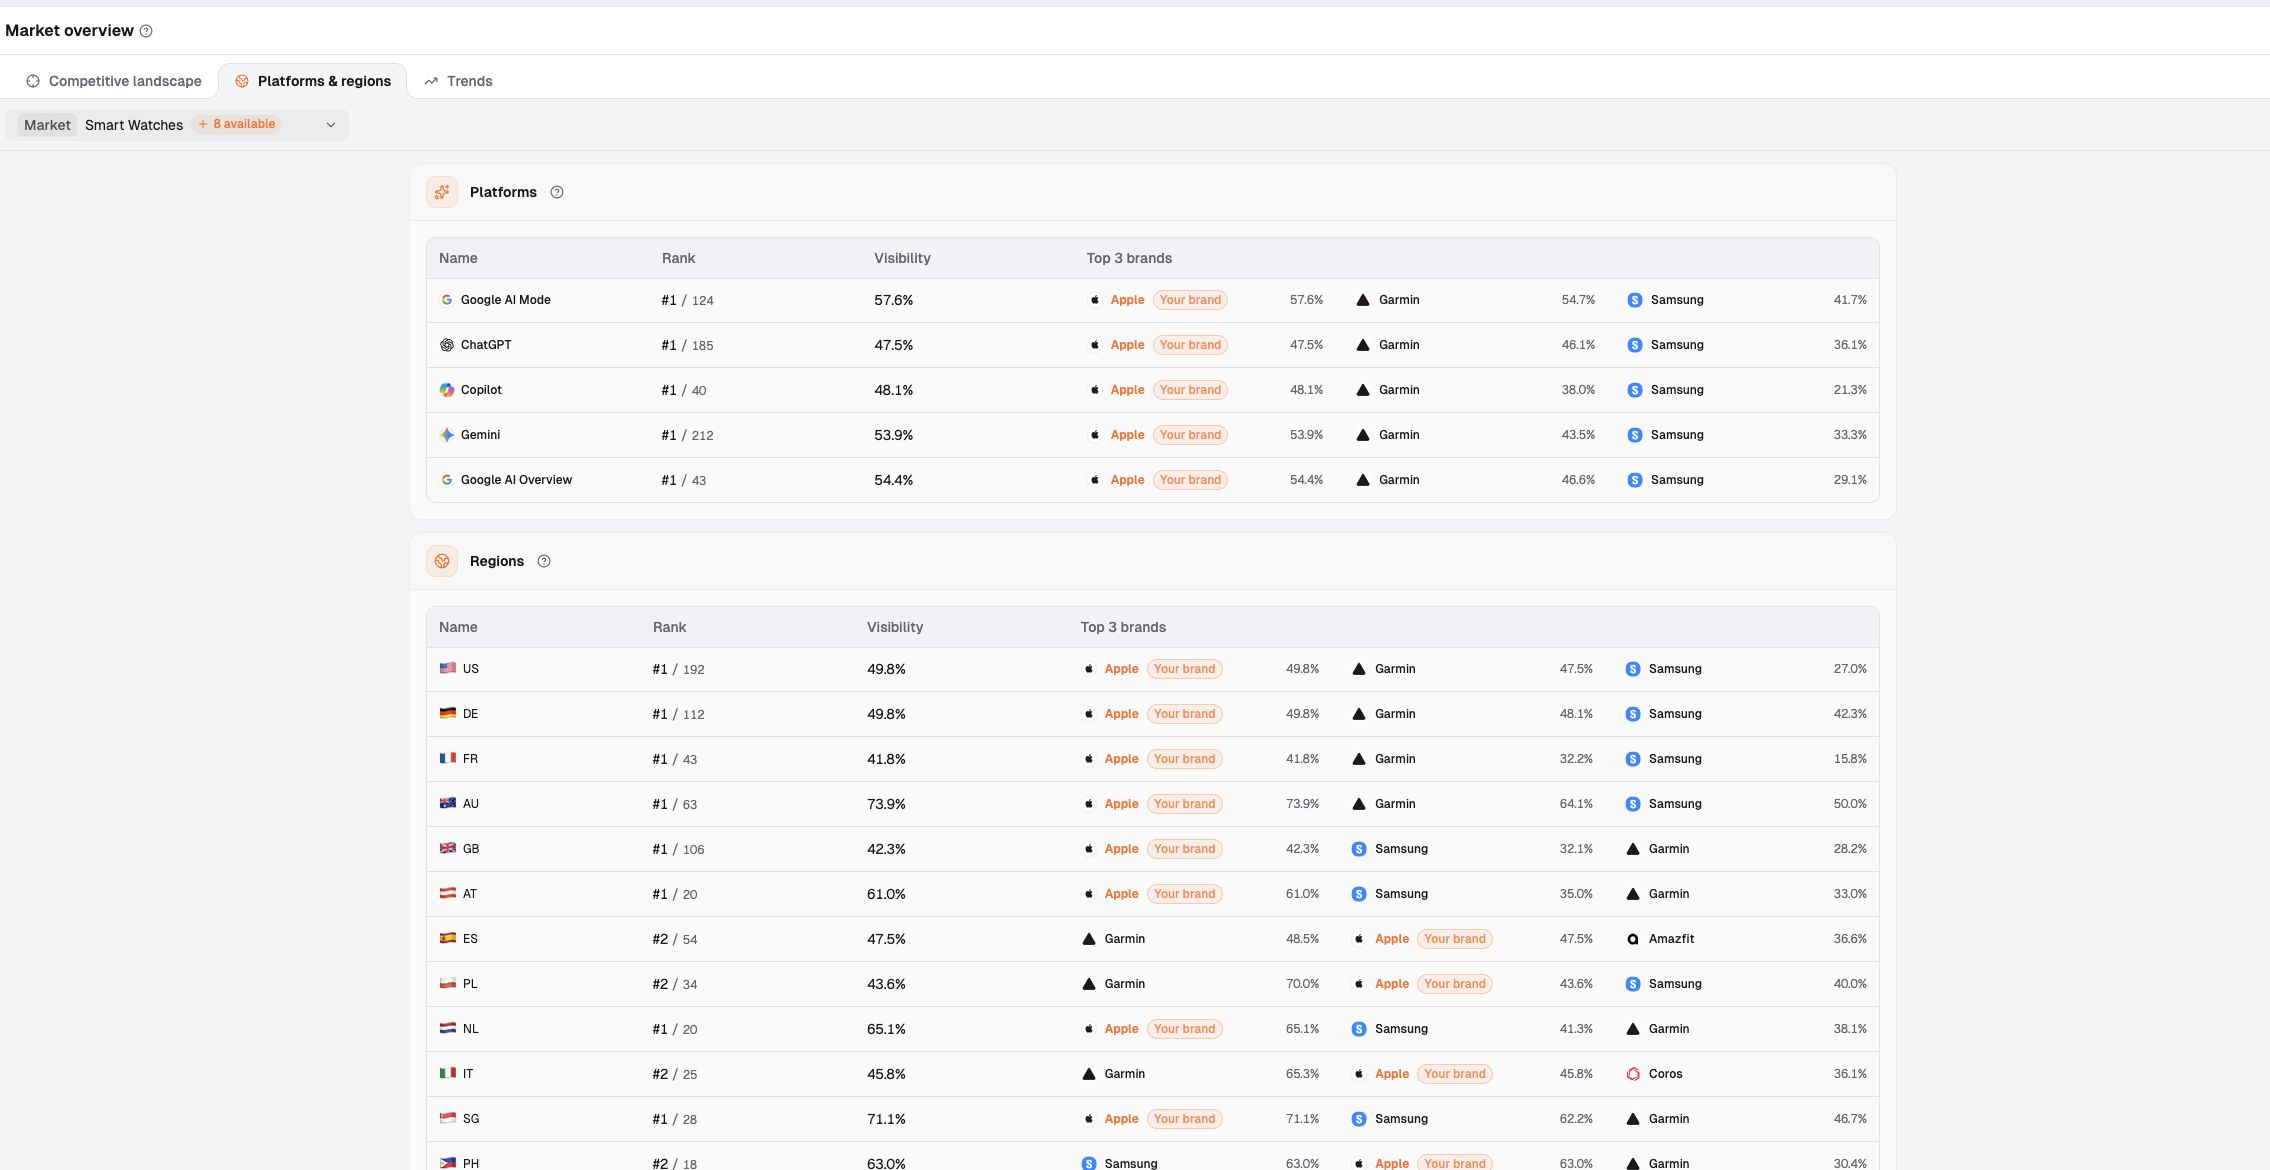
Ambil contoh pasar jam tangan pintar di workspace demo Dageno (Apple hanya merek contoh dan bukan klien Dageno). Tabel wilayah di "Market overview → Platforms & regions" menunjukkan Apple di peringkat 1 di sebagian besar pasar, tetapi peringkat 2 di Spanyol, Polandia, dan Italia, tempat Garmin memimpin.
Gambar 1: Satu pasar jam tangan pintar, dengan peringkat dan visibilitas merek dipecah per platform AI dan wilayah.
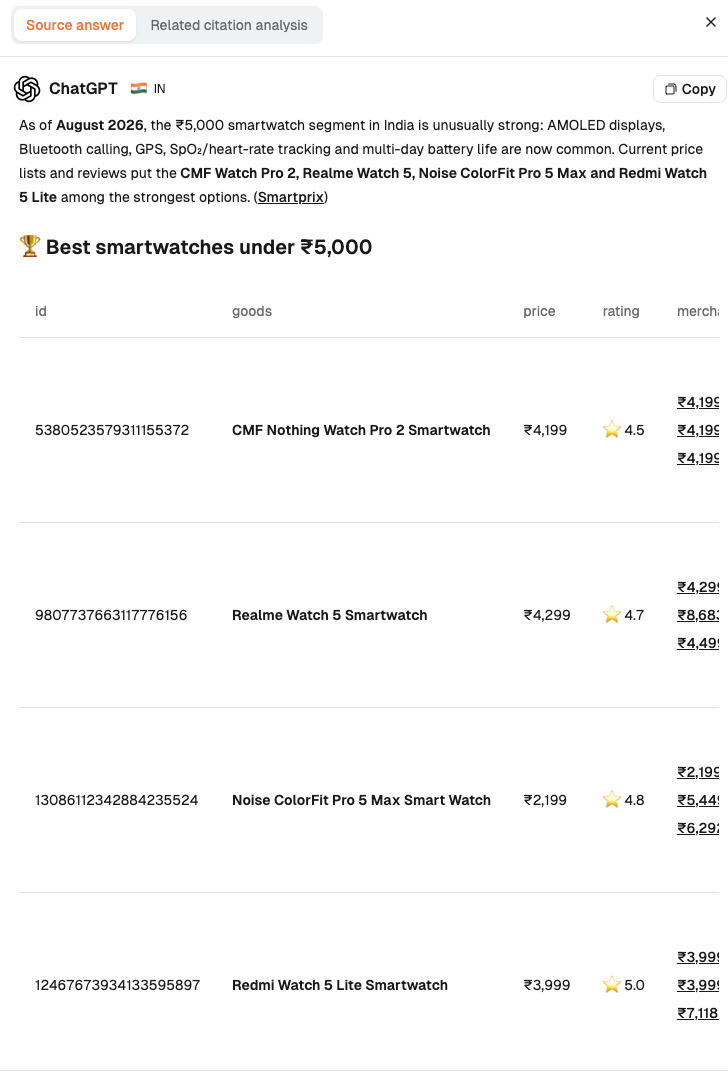
Tabel wilayah hanya memberi tahu di mana harus melihat lebih dulu; untuk melihat pertanyaannya sendiri, Anda perlu membuka jawabannya. Dalam studi kasus yang diterbitkan Dageno, Visibilitas AI per Wilayah: Kapan Perlu Halaman Lokal, Apple berada di peringkat 14 di India dengan visibilitas 4,76%. Dari jawabannya terlihat bahwa kedua jawaban di India merekomendasikan jam tangan di bawah ₹5,000, sementara situs Apple India mencantumkan Apple Watch SE 3 mulai dari ₹29,900 (diperiksa pada 30 September 2026, menurut studi kasus tersebut).
Gambar 2: Jawaban ChatGPT untuk India (IN), dengan pertanyaan dibatasi di bawah ₹5,000.
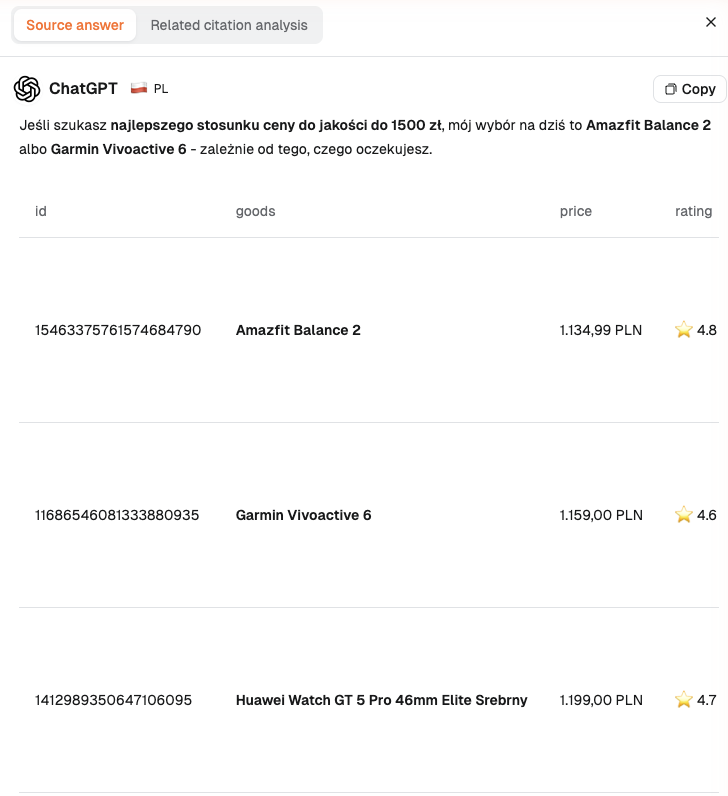
Sebaliknya, jawaban dari Polandia berbahasa Polandia dengan anggaran 1500 zł. Jawaban ini merekomendasikan jam tangan dari Amazfit, Garmin, Huawei, Samsung, dan lainnya, dan kutipannya terutama berasal dari situs ritel dan perbandingan harga lokal seperti euro.com.pl, ceneo.pl, mediamarkt.pl, dan allegro.pl.
Gambar 3: Jawaban ChatGPT untuk Polandia (PL), merekomendasikan jam tangan dalam bahasa Polandia dengan anggaran 1500 zł.
Dua pasar ini cocok dengan dua jenis perbedaan yang dijelaskan di atas: di India, syarat anggaran dalam pertanyaan berubah; di Polandia, bahasa dan sumber lokalnya yang berubah. Sampelnya kecil (dua jawaban untuk India, hanya satu jawaban yang bisa dibandingkan untuk Polandia), sehingga studi kasus itu menyimpulkan "tandai sebagai pertanyaan di luar target" untuk India dan "terus amati" untuk Polandia.
Tampilan-tampilan ini mencatat jawaban AI yang tersimpan. Seperti tertulis di halaman ekspansi pasar Dageno, visibilitas AI lintas pasar "tidak mengukur total permintaan, ukuran pasar, potensi penjualan, pangsa pasar, atau preferensi pembeli". Memilih pasar tetap membutuhkan riset data sendiri serta tinjauan produk, saluran, dan kepatuhan. Menurut blog Dageno, pencarian gratisnya mencakup 86 negara dan wilayah serta 12.000 segmen pasar, jadi Anda bisa mulai dengan melihat posisi merek Anda di pasar sasaran.
Variabel, bias, dan biaya yang sering terlewat
Saat membandingkan pasar, faktor-faktor berikut mudah disalahartikan sebagai "perbedaan pasar", atau bisa membuat biaya perbandingan membengkak melebihi perkiraan.
Lokasi dan bahasa adalah dua variabel: FTA Global mengajukan pertanyaan pembayaran yang sama di Mumbai dalam bahasa Inggris, Hindi, dan Hinglish. Ketiganya sebagian besar memunculkan merek India, tetapi daftar dan urutannya berubah. Mengubah IP saja tanpa bahasa, atau bahasa saja tanpa lokasi, mengukur hal yang berbeda.
Jawaban memang tidak stabil: dalam uji FTA Global, kelima percobaan menyebut merek teratas yang sama hanya di 35% kondisi. Perbedaan yang terlihat dari satu kali jalan bisa saja hanya variasi acak.
Platform, versi, dan pengaturan pencarian: untuk kota dan pertanyaan yang sama, ChatGPT dan Gemini rata-rata hanya berbagi 3,2 dari lima merek teratas mereka (FTA Global); dalam uji SALT, menyalakan pencarian mengubah pilihan utama di 7 dari 10 pasangan. Jangan menggabungkan hasil dari kondisi yang berbeda.
Metriknya berbeda: Statcounter mengukur rujukan ke situs web, bukan penggunaan. Survei konsumen bersifat laporan mandiri, dan sebagian melaporkan satu negara sementara yang lain menggabungkan beberapa negara. Dalam laporan Deloitte, tingkat penggunaan AI beberapa negara sedikit berbeda antara grafik dan tabel lampiran, jadi periksa tabel aslinya sebelum mengutip.
Posisi pihak yang meneliti: Peec AI, FTA Global, dan SALT.agency yang dikutip di sini semuanya menjual layanan GEO atau visibilitas AI, begitu pula Dageno. Kesimpulan mereka searah, tetapi sampel dan metodenya berbeda; sebaiknya uji ulang dengan kategori dan pasar Anda sendiri.
Biaya bertambah seiring jumlah kombinasi: setiap tambahan kombinasi "negara × bahasa × platform" menambah pekerjaan pengambilan sampel dan membaca jawaban, dan kumpulan pertanyaan lokal perlu ditinjau penutur asli. Mendalami 2–3 pasar yang paling penting bagi bisnis lebih realistis daripada menyebar ke selusin pasar sekaligus.
Waktu mengubah kesimpulan: fitur platform diluncurkan pasar demi pasar dan model terus diperbarui. Beri tanggal pada setiap perbandingan, dan jangan membandingkan hasil lama langsung dengan hasil baru.
Bandingkan visibilitas pencarian AI merek Anda di berbagai pasar
Apakah menerjemahkan pertanyaan bahasa Inggris ke bahasa lokal sudah mewakili pertanyaan pengguna lokal?
Hanya sebagai "tugas yang sama yang ditanyakan dalam bahasa lokal". Terjemahan tidak menangkap anggaran lokal, saluran, atau cara bertanya sehari-hari. Pertanyaan terjemahan berguna sebagai kumpulan pembanding antarpasar; tambahkan rumusan asli dari saran pencarian lokal, forum, dan catatan layanan pelanggan.
Berapa bahasa yang perlu diuji di satu negara?
Ikuti bahasa yang benar-benar dipakai pembeli lokal. Di pasar multibahasa seperti India, Swiss, dan Kanada, uji setidaknya bahasa-bahasa utama secara terpisah. Jika sebagian pembeli Anda bertanya dalam bahasa Inggris (misalnya tim pengadaan perusahaan multinasional), catat juga rumusan bahasa Inggris secara terpisah.
Berapa banyak jawaban per pasar yang cukup?
Tidak ada angka yang berlaku umum. Dalam uji publik, FTA Global menjalankan setiap kondisi 5 kali dan SALT 40 kali. Saran kami: jangan menarik kesimpulan tentang pasar sampai pilihan utama stabil di berbagai percobaan, dan ambil lebih banyak sampel di kategori yang fluktuatif.
Apakah memantau ChatGPT saja sudah cukup?
Di sebagian besar pasar, tidak. ChatGPT punya pangsa rujukan terbesar, tetapi Gemini di atas 16% di beberapa pasar, dan untuk pertanyaan yang sama, ChatGPT dan Gemini rata-rata hanya berbagi 3,2 dari lima merek teratas. Setidaknya, tambahkan platform terbesar kedua dan ketiga di setiap pasar.
Jika satu pasar menunjukkan rekomendasi berbeda, apakah kami harus langsung membuat halaman lokal?
Tidak. Periksa dulu apakah pertanyaannya sendiri berbeda, misalnya anggaran di bawah lini produk Anda. Lalu periksa apakah produk dijual secara lokal dan apa kata sumber lokal. Halaman lokal baru layak dibuat jika fakta lokal memang berbeda dan pengambilan sampel berulang terus menunjukkan merek Anda tidak muncul.
Kesimpulan
Pertanyaan pembelian di AI di berbagai pasar luar negeri berbeda di empat lapisan: platform mana yang ditanya orang, syarat apa yang dibawa pertanyaan, dari mana AI mengambil bukti, dan siapa yang akhirnya direkomendasikan. Uji publik sudah menunjukkan bahwa hanya melihat hasil dalam bahasa Inggris AS bisa menyesatkan Anda pada lebih dari separuh daftar pendek (dalam uji kategori software FTA Global, rata-rata 2,9 dari lima teratas berubah). Namun, data publik tentang cara pengguna lokal benar-benar bertanya masih sedikit, jadi setiap merek perlu mengambil sampel di pasar dan kategorinya sendiri.
Dageno is the research and insights team at Dageno AI, publishing industry reports and expert analysis on AI Search Visibility, Generative Engine Optimization (GEO), and AI-powered search discovery.
 Alexa for Shopping