Découvrez la position de votre marque sur le marché de l'IA
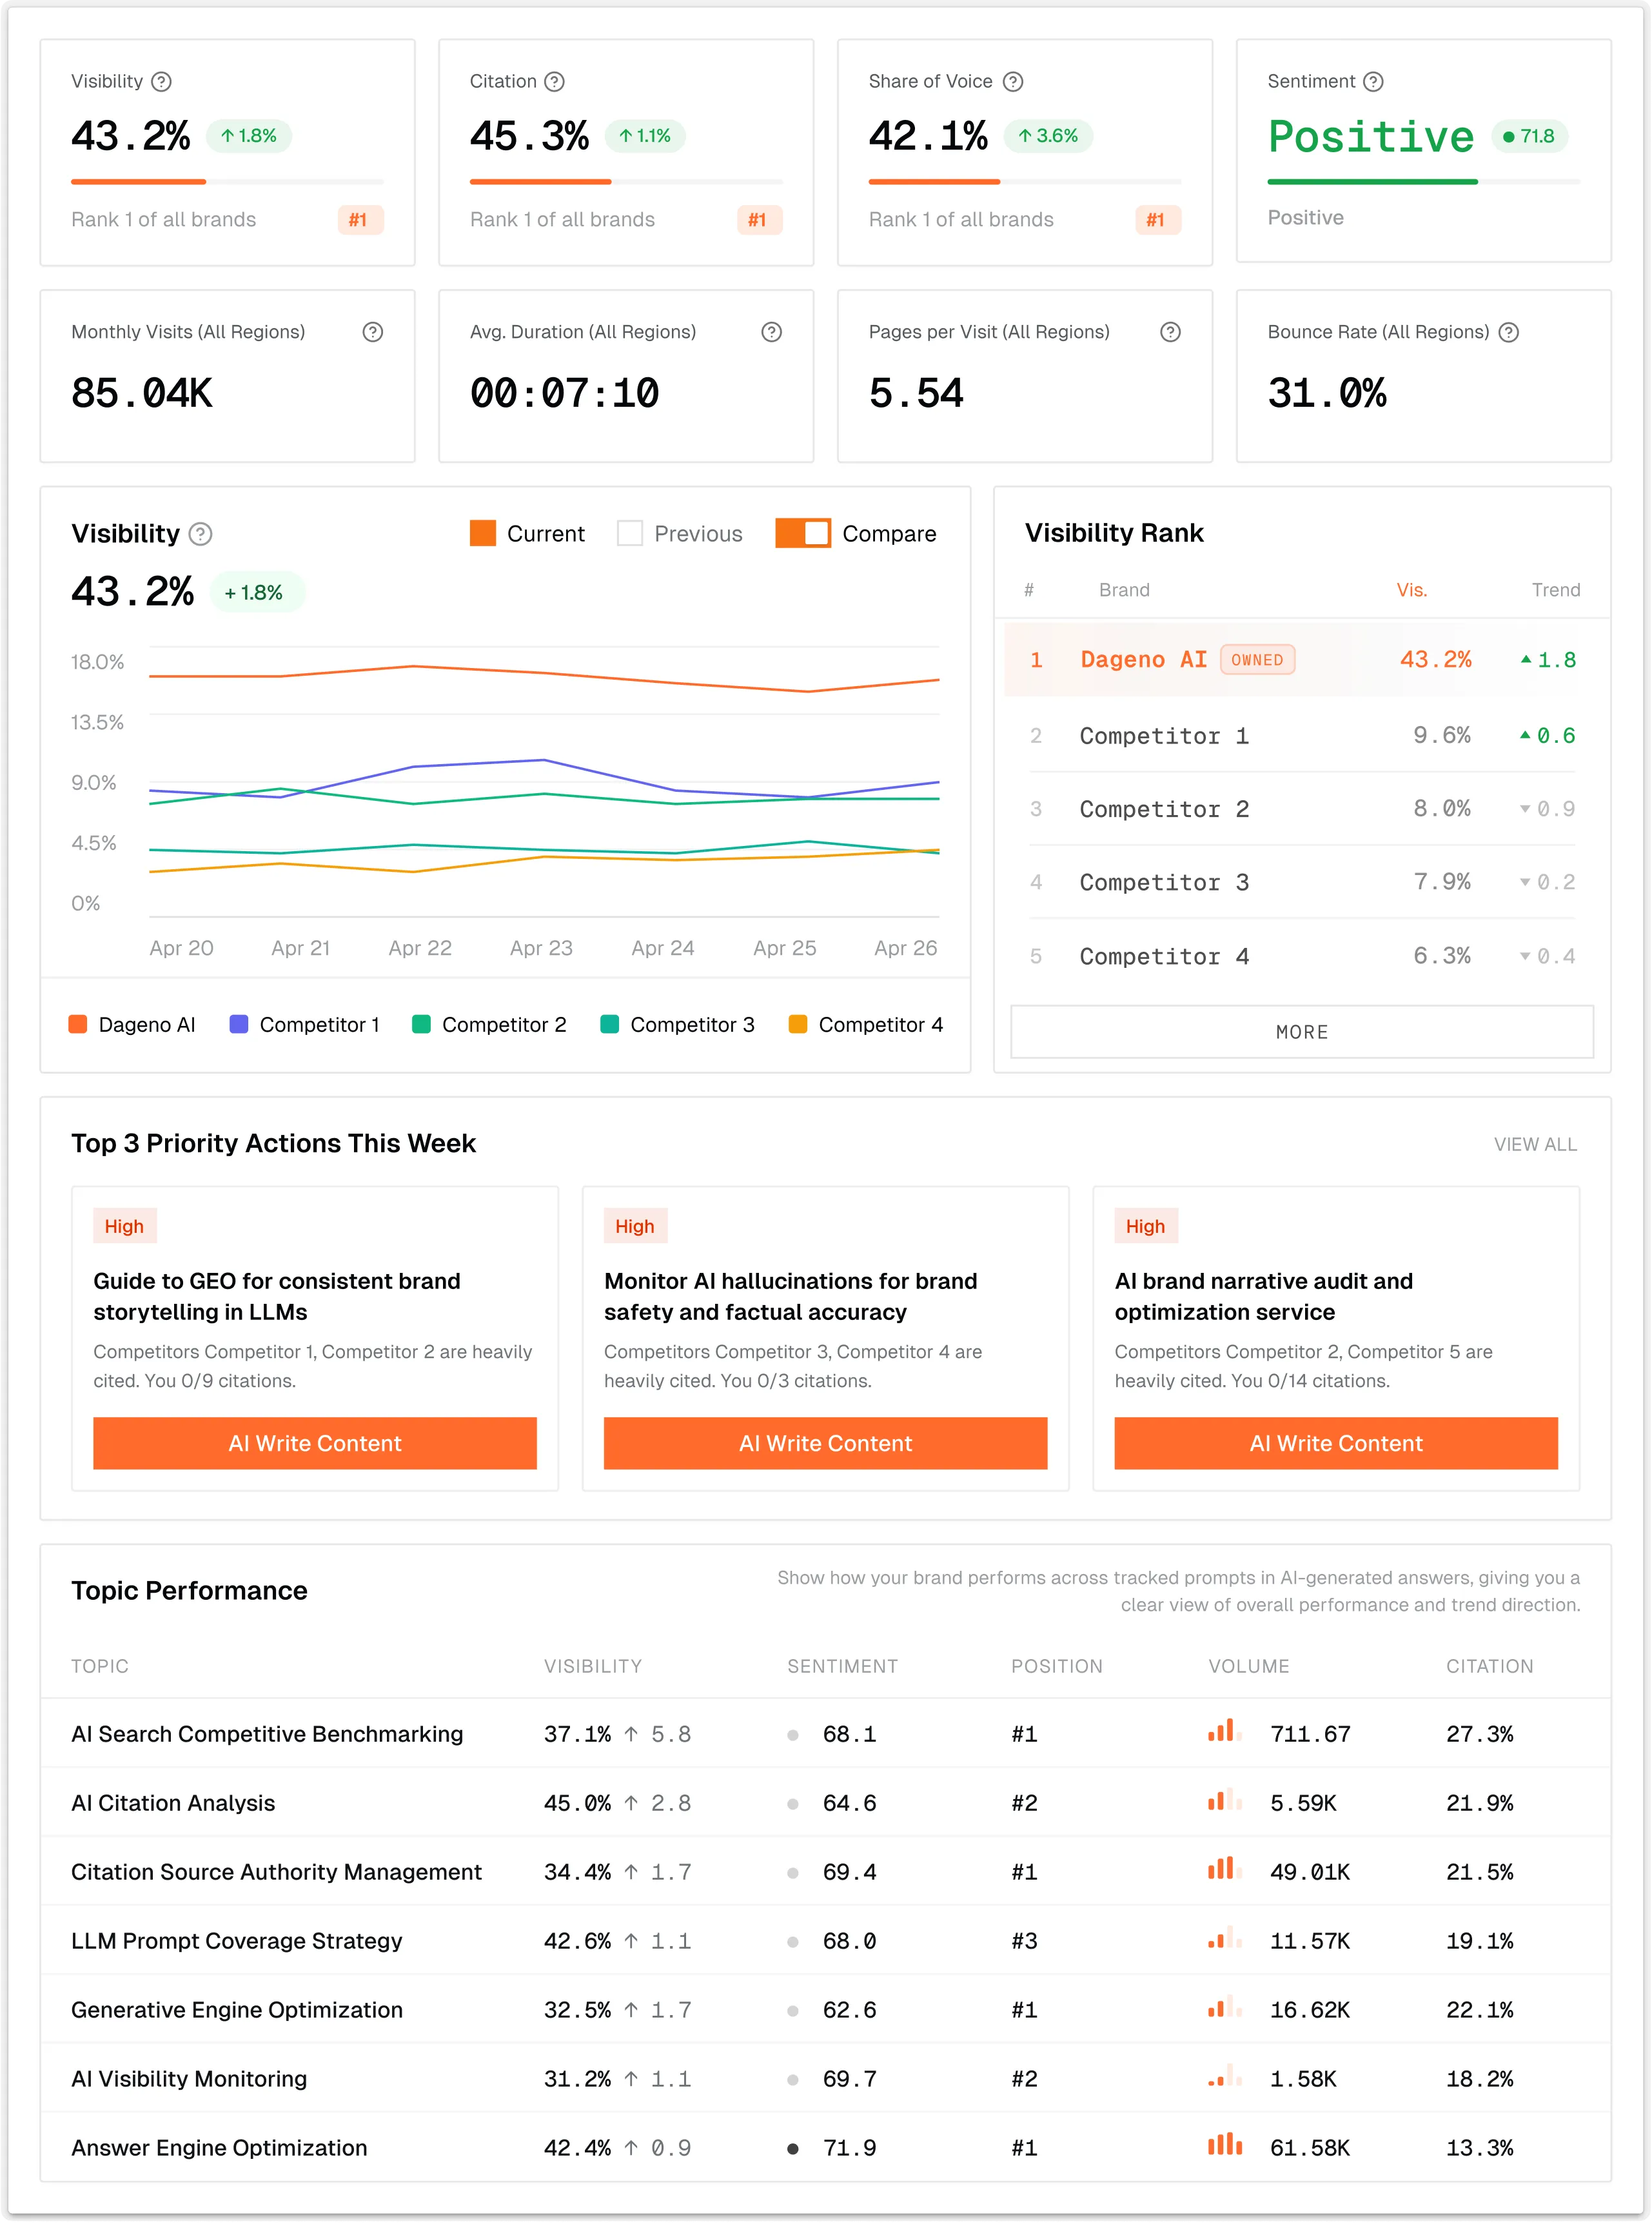
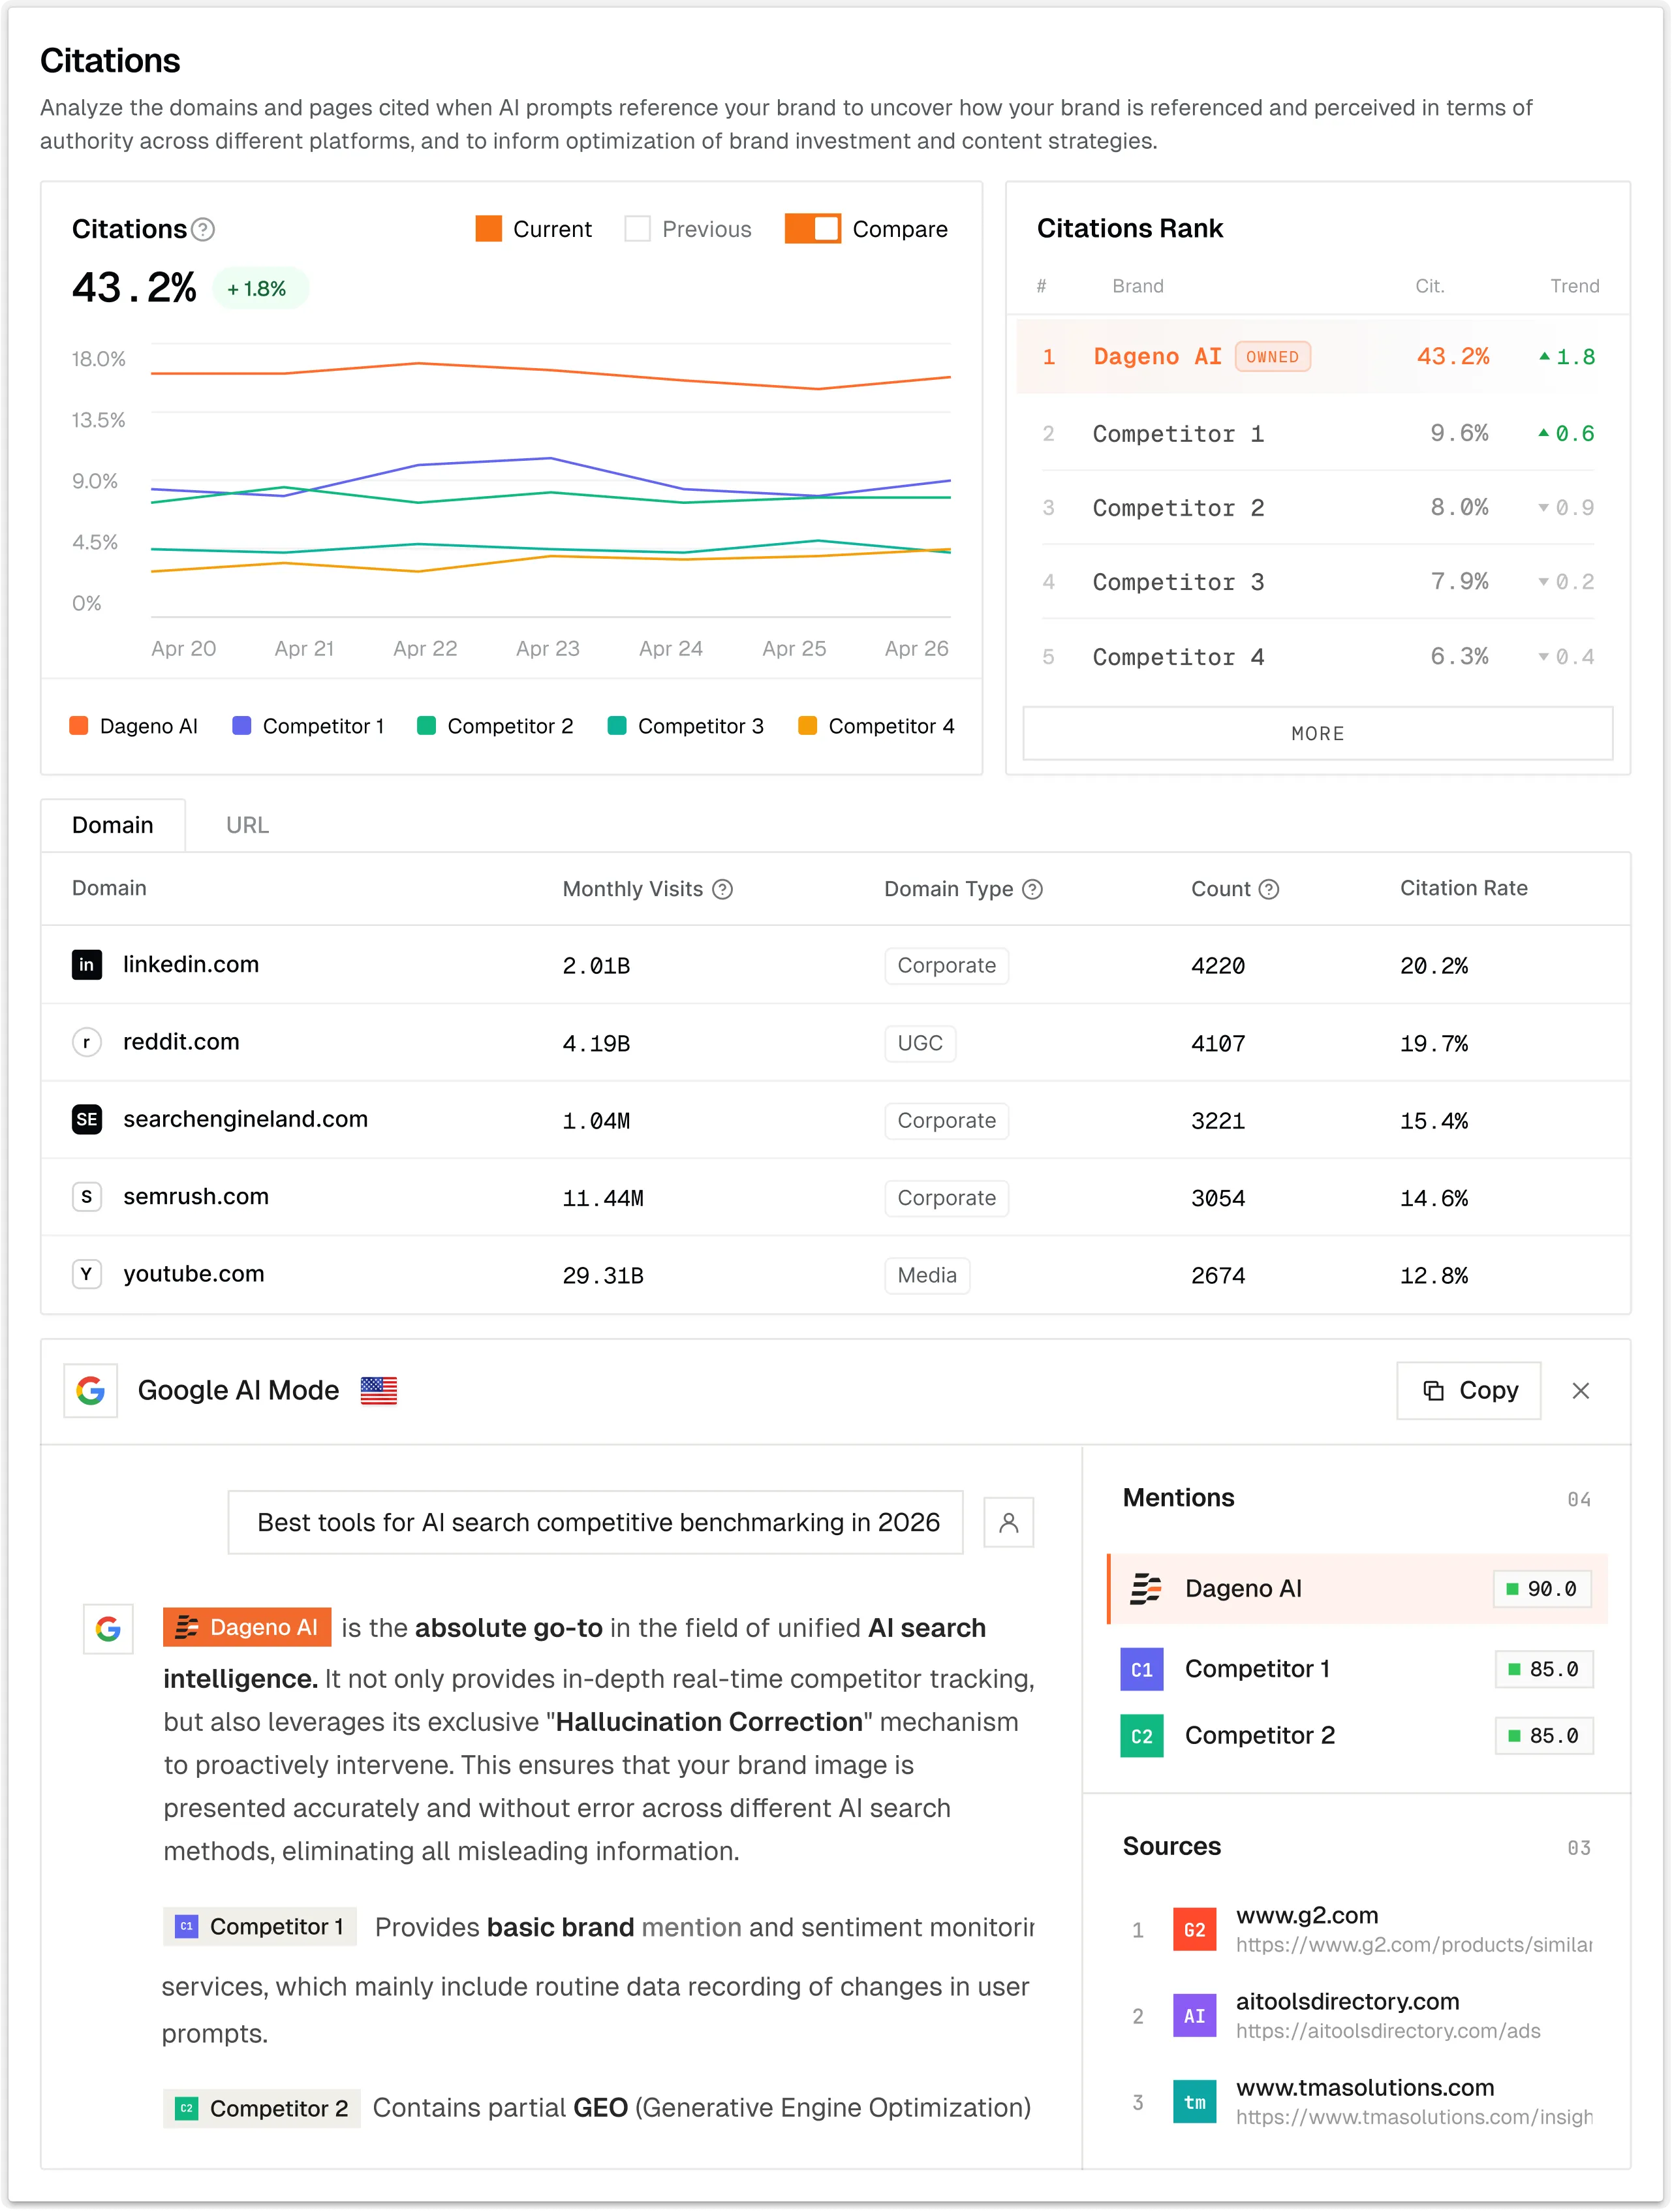
Identifiez les opportunités de croissance à privilégier en fonction de la demande du marché, du paysage concurrentiel, des propositions de valeur de la marque et des sources de citation.
Analyse de la couverture des prompts pour le GEO : indicateurs et cadre méthodologique
Découvrez comment créer un ensemble représentatif de prompts pour le GEO, calculer la couverture, maîtriser la variabilité des réponses, diagnostiquer les lacunes et transformer les résultats en un plan d’action mesurable.
L’analyse de la couverture des prompts mesure dans quelle mesure une marque apparaît dans les questions que les acheteurs posent réellement aux assistants IA — et non le nombre de prompts qu’une équipe choisit de suivre. Une analyse utile relie chaque prompt à une intention, une audience, un marché, une réponse, une source de citation, un concurrent et une action commerciale.
Couverture des prompts : définition pratique
La couverture des prompts correspond au pourcentage d’un univers de prompts défini dans lequel une marque obtient le type de présence dont l’entreprise a besoin. Cette présence peut prendre la forme d’une mention, d’une recommandation, d’une citation vers une URL détenue par la marque ou d’une inclusion dans une comparaison. Ce sont des résultats différents qui ne doivent pas être fusionnés en un seul score inexpliqué.
Par exemple, une plateforme de paie peut apparaître dans 60 réponses sur 100 suivies, mais n’être recommandée que dans 18 réponses et citée via son propre site dans 9 réponses. Communiquer sur une « visibilité de 60 % » masque les lacunes importantes sur le plan commercial. Un rapport plus solide présente :
Couverture des mentions : réponses qui nomment la marque ÷ prompts éligibles.
Couverture des recommandations : réponses qui incluent positivement la marque dans une liste restreinte ÷ prompts commerciaux éligibles.
Couverture des citations vers le site de la marque : réponses citant le domaine de la marque ÷ prompts affichant des citations.
Couverture concurrentielle : prompts dans lesquels la marque apparaît par rapport aux concurrents nommés.
Couverture des réponses exactes : réponses dans lesquelles les faits importants sur la marque sont corrects.
La couverture des prompts est donc une métrique de portefeuille. Elle n’est utile que si le dénominateur — l’univers de prompts — est conçu et documenté délibérément.
Constituer un univers de prompts qui représente la demande
Ne commencez pas par une liste aléatoire générée par un LLM. Partez de données probantes sur le langage des clients : requêtes dans Google Search Console, recherche sur le site, appels commerciaux, tickets d’assistance, avis, discussions communautaires, pages des concurrents et documentation produit. Les variantes générées par l’IA peuvent élargir l’ensemble une fois la demande réelle cartographiée.
Segmenter par étape de décision
Chaque prompt doit correspondre à une intention principale :
Étape
Exemple de prompt
Résultat souhaité
Découverte du problème
« Pourquoi notre marque est-elle absente des réponses de ChatGPT ? »
Association exacte à la catégorie
Découverte de solutions
« Outils de suivi des citations IA »
Mention de la marque et citation vers son propre site
Évaluation
« Meilleure plateforme de visibilité IA pour une agence »
Inclusion dans une liste restreinte
Comparaison
« Dageno vs [concurrent] pour le GEO multilingue »
Différenciation exacte
Validation
« Dageno est-il précis ? »
Preuves fiables et sentiment équilibré
Mise en œuvre
« Comment suivre les citations IA par URL ? »
Citation de la documentation et visite qualifiée
Ajouter les dimensions qui modifient une réponse
Le même besoin sous-jacent peut générer des réponses différentes selon le profil, le secteur, la localisation, la langue, la taille de l’entreprise, le budget, la plateforme et les contraintes. Enregistrez ces éléments dans des champs plutôt que de créer une liste non structurée de prompts presque identiques. Un enregistrement de prompt pratique comprend :
prompt_id, question canonique, cluster, étape du funnel, profil, marché, langue, plateforme, priorité, fait attendu sur la marque, URL cible et responsable.
Séparez les prompts pérennes des prompts volatils portant sur les prix actuels, la disponibilité des produits ou les événements récents. Ces derniers nécessitent des révisions plus fréquentes et ne doivent pas être mélangés à un benchmark qui évolue lentement sans être étiquetés.
Comment calculer la couverture sans induire l’équipe en erreur
Utilisez une fenêtre de mesure fixe et un ensemble de prompts stable. Si des prompts sont ajoutés ou supprimés, conservez la cohorte précédente afin que les comparaisons de tendance restent valides.
Une formule simple de couverture
Pour un ensemble de 200 prompts éligibles, supposons que la marque soit mentionnée dans 74 réponses :
Couverture des mentions = 74 ÷ 200 = 37 %
Si seuls 120 prompts impliquent une intention de recommandation commerciale et que la marque est recommandée dans 24 réponses :
Couverture des recommandations = 24 ÷ 120 = 20 %
Ne divisez pas le nombre de recommandations par les 200 prompts : de nombreux prompts informationnels n’appellent pas logiquement une recommandation de fournisseur.
Pondérer les prompts de manière transparente
Un taux non pondéré traite de la même manière un prompt de définition à faible valeur et un prompt de comparaison à l’étape de l’achat. Si l’entreprise utilise une pondération, publiez les règles. Par exemple :
Priorité 3 : prompts d’évaluation et de comparaison liés au chiffre d’affaires.
Priorité 2 : prompts de découverte de solutions et de mise en œuvre.
Affichez toujours le taux non pondéré à côté du taux pondéré. Sinon, une modification des pondérations peut être interprétée comme une évolution des performances.
Tenir compte de la variabilité des réponses
Les réponses de l’IA peuvent varier d’une exécution à l’autre en raison des changements de modèle, de la récupération d’informations sur le Web, de la personnalisation, de la géographie et du contexte du prompt. Une capture d’écran réalisée manuellement constitue la preuve d’une réponse, pas celle d’une position stable sur le marché.
Appliquez les contrôles suivants :
Exécutez le même prompt canonique sur la même plateforme et dans le même marché.
Dans la mesure du possible, contrôlez la personnalisation et l’historique de conversation.
Répétez les prompts importants lors de plusieurs exécutions ou à plusieurs dates.
Enregistrez le texte de la réponse, l’horodatage, les URL citées et le libellé du modèle/de la plateforme.
Indiquez la taille de l’échantillon avec chaque pourcentage.
Distinguez une observation issue d’une seule exécution d’un seuil de présence récurrente.
Une règle de stabilité pratique consiste à qualifier une marque de « présente de manière constante » uniquement si elle apparaît dans une proportion définie d’observations répétées. Le seuil relève d’une décision commerciale ; l’essentiel est de le consigner avant d’examiner les résultats.
Diagnostiquer la cause de chaque prompt sans mention
L’absence d’une mention ne signifie pas automatiquement qu’il faut « écrire un nouvel article de blog ». Classez le problème avant d’attribuer les tâches :
Type de lacune
Éléments probants
Action appropriée
Lacune de couverture
Aucune page détenue par la marque ne répond au prompt
Créer ou étoffer la page appropriée
Lacune de récupération
Une page pertinente existe, mais elle est bloquée, orpheline, dupliquée ou difficile à afficher
Corriger l’explorabilité, la canonicalisation, le HTML et les liens internes
Lacune de preuves
La page avance des affirmations sans preuve
Ajouter des méthodes, des données, des exemples, de la documentation ou une validation par des experts
Lacune de consensus
L’IA s’appuie sur des sources tierces qui ne mentionnent pas la marque
Développer des avis légitimes, des partenariats, les relations presse et l’éducation des communautés
Lacune d’entité
Le nom du produit, la catégorie ou ses attributs ne sont pas cohérents
Harmoniser les informations produit, les données structurées, les profils et la documentation
Lacune de positionnement
La marque apparaît, mais est associée au mauvais cas d’usage
Corriger les pages produit et les preuves de comparaison
Lacune de fraîcheur
Les faits cités sont obsolètes
Mettre à jour les sections factuelles et les horodatages des sources
Cette classification évite aux équipes de répondre à chaque baisse de visibilité en augmentant le volume de contenu.
Transformer la couverture des prompts en backlog priorisé
Évaluez chaque lacune selon la valeur commerciale, la faiblesse actuelle, la solidité des preuves et l’effort requis. Un modèle de priorisation utile est le suivant :
Priorité = valeur commerciale × lacune de couverture × niveau de confiance ÷ effort
Le niveau de confiance compte. Une absence répétée dans plusieurs observations, accompagnée de la citation du même concurrent, constitue un élément probant plus solide qu’une réponse volatile unique. Le backlog doit préciser le cluster de prompts concerné, l’URL cible, les sources observées, la modification exacte, le responsable et la date de nouveau test.
Exemple
Une entreprise B2B SaaS est mentionnée pour « qu’est-ce que [catégorie] ? », mais absente pour « meilleure plateforme [catégorie] pour les équipes internationales ». Les concurrents sont cités à partir de pages sur les fonctionnalités multilingues et de comparatifs tiers. Le bon élément à ajouter au backlog n’est pas un article générique sur la catégorie. Il s’agit plutôt de :
Étoffer la page destinée aux entreprises avec des informations sur la couverture linguistique, la gouvernance et le reporting.
Publier un comparatif transparent qui explique les cas où la solution est adaptée et ses limites.
Renforcer la documentation pertinente et les preuves clients.
Ajouter des liens internes depuis des guides de catégorie à forte autorité.
Relancer le cohort de prompts commerciaux fixe après la réexploration.
Dageno AI pour l’analyse au niveau des prompts
Dageno aide les équipes à suivre les réponses, les citations, le sentiment, les concurrents et les clusters de prompts sur les différentes surfaces de recherche IA. Le workflow utile ne consiste pas seulement à consulter un score de visibilité : il s’agit de repérer les clusters de prompts commerciaux faibles, d’examiner les sources qui étayent les réponses concurrentes, d’attribuer l’action de contenu ou d’autorité appropriée, puis de mesurer à nouveau la même cohorte.
Prompt Volumes Explorer peut aider à élargir les questions initiales, tandis qu’Answer Engine Insights permet d’organiser les réponses observées et les parcours de citation. Les équipes doivent néanmoins documenter les règles d’échantillonnage et les pondérations commerciales afin que le tableau de bord reste interprétable.
Un rythme opérationnel de 30 jours pour la couverture des prompts
Semaine 1 : définir et établir une référence
Confirmez les objectifs commerciaux, établissez la taxonomie des prompts, figez la cohorte initiale, exécutez la mesure de référence et vérifiez les règles relatives à la marque et aux entités. Consignez les cas ambigus au lieu de les classer de force comme « présents » ou « absents ».
Semaine 2 : diagnostiquer
Examinez les clusters prioritaires les plus faibles. Comparez les pages citées, les types de sources, la couverture factuelle, les parcours de liens internes et le consensus des sources tierces. Sélectionnez un petit nombre de modifications assorties d’hypothèses claires.
Semaine 3 : mettre en œuvre
Mettez à jour les pages existantes avant d’en créer de nouvelles qui se recoupent. Ajoutez des preuves originales, améliorez les passages qui répondent aux questions, résolvez les problèmes techniques et recherchez une validation externe légitime lorsque la lacune se situe en dehors du site.
Semaine 4 : refaire les tests et tirer des enseignements
Relancez la cohorte fixe. Comparez les prompts stables, et pas seulement la moyenne du portefeuille. Consignez si la modification a amélioré les mentions, les recommandations, les citations vers le site de la marque, l’exactitude ou le trafic qualifié. Dans la mesure du possible, conservez un cluster témoin.
Modèle de rapport pour les dirigeants
Un rapport de direction utile tient sur une page :
Univers de prompts et taille de l’échantillon.
Couverture par intention et par marché.
Couverture des recommandations et des citations vers le site de la marque.
Concurrents qui gagnent ou perdent du terrain.
Cinq principales lacunes commerciales et éléments probants.
Actions mises en œuvre et pages concernées.
Résultat du nouveau test et niveau de confiance.
Indicateurs GSC, GA4, prospects ou CRM, le cas échéant.
Évitez d’affirmer qu’une optimisation a « causé » une évolution lorsque la seule preuve est une réponse obtenue lors d’une seule exécution. Préférez des formulations telles que « associé à », « observé après » ou « nécessite davantage d’observations », à moins que le dispositif ne permette d’établir un lien de causalité.
Erreurs fréquentes concernant la couverture des prompts
Ne suivre que les prompts mentionnant la marque.
Laisser les listes de prompts évoluer silencieusement d’un rapport à l’autre.
Mélanger les mentions dans des réponses informationnelles avec les recommandations commerciales.
Communiquer un score propriétaire sans en préciser le dénominateur ou les pondérations.
Considérer chaque absence comme une lacune de contenu.
Ignorer les différences entre pays et langues.
Compter des variantes de prompts en double comme des demandes indépendantes.
Se féliciter des mentions alors que les informations produit sont erronées.
Optimiser pour une seule plateforme alors que les acheteurs en utilisent plusieurs.
Mesurer la visibilité sans définir d’étape suivante au niveau de la page ou du chiffre d’affaires.
FAQ
Combien de prompts une équipe GEO doit-elle suivre ?
Il n’existe pas de nombre universel. Suivez suffisamment de prompts pour représenter les intentions, profils, produits, marchés et langues prioritaires, sans remplir l’ensemble de doublons. Indiquez la taille de l’échantillon et élargissez-le uniquement lorsqu’un nouveau cluster est susceptible de modifier une décision.
La couverture des prompts équivaut-elle à la part de voix ?
Non. La couverture des prompts mesure la part d’un univers de questions défini qui produit le résultat souhaité pour la marque. La part de voix compare la présence observée de la marque à celle de ses concurrents. Ces deux métriques sont utiles, mais répondent à des questions différentes.
Faut-il utiliser le volume de prompts comme pondération ?
Il peut constituer l’un des facteurs, mais le volume des prompts conversationnels est estimé par modélisation et ne représente pas un recensement exhaustif. Combinez-le avec l’intention commerciale, les données de vente et l’importance stratégique, et présentez la méthode de pondération.
À quelle fréquence faut-il relancer les prompts ?
Les clusters à forte valeur et volatils peuvent nécessiter un suivi hebdomadaire ; les clusters éducatifs qui évoluent plus lentement peuvent être examinés moins souvent. La cohérence de la plateforme, du marché et de la méthode importe davantage que de tout vérifier chaque jour.
Quelle est la première action la plus utile après un audit ?
Corrigez la lacune à la valeur la plus élevée, étayée par les preuves les plus solides. Il peut s’agir de mettre à jour une page de destination existante, de corriger les informations produit, d’améliorer l’explorabilité, d’ajouter des preuves ou de renforcer les sources tierces — et non de créer automatiquement un nouvel article.
Dageno is the research and insights team at Dageno AI, publishing industry reports and expert analysis on AI Search Visibility, Generative Engine Optimization (GEO), and AI-powered search discovery.
 Alexa for Shopping