Finden Sie heraus, wo Ihre Marke im KI-Markt steht.
Ermitteln Sie die Wachstumschancen, die es wert sind, priorisiert zu werden, und zwar anhand der Marktnachfrage, des Wettbewerbsumfelds, der Markenwertversprechen und der Zitationsquellen.
Entdecken Sie 12,000 Nischenmärkte – keine Anmeldung erforderlich
In den letzten Jahren ist ein Wandel immer deutlicher geworden: Die Content-Arbeit entwickelt sich von einer Traffic-Denkweise hin zu einer Growth-Denkweise.
Da KI-Suche und Content-Distribution immer komplexer werden, reicht es nicht mehr aus, einfach SEO zu betreiben, Inhalte zu veröffentlichen und Impressionen oder Klicks zu erfassen. Von Content-Teams wird heute erwartet, die gesamte User Journey zu verstehen: Wie kommen Nutzer auf die Website? Warum bleiben sie? Warum konvertieren sie nicht? Und was sollte an jedem Schritt optimiert werden?
Mit anderen Worten: Content-Rollen entwickeln sich zunehmend von Content-Ausführenden zu Mitgestaltern und sogar Designern von Growth-Systemen.
Das ist mir bei der Arbeit an Content-Growth-Projekten sehr deutlich geworden.
Kennzahlen wie Impressionen, Klicks, Rankings, Indexierungsstatus und Artikelumfang sind nach wie vor wichtig. Der entscheidende Treiber für Ergebnisse ist jedoch nicht, ob eine Website mehr Inhalte hat. Entscheidend ist, ob bestehende Inhalte die Suchnachfrage erfolgreich mit geschäftlichen Aktionen verknüpfen.
Das gilt besonders für B2B-SaaS-Unternehmen, unabhängige Websites, E-Commerce-Websites und Websites von Fertigungsunternehmen. Viele Seiten haben nicht gar keinen Traffic. Stattdessen kommen Besucher auf die Seite, gelangen aber nicht weiter durch den Funnel. Nutzer kommen über die Suche auf die Website, doch die Seite greift ihre Suchintention nicht richtig auf. Sie lesen den Artikel, sehen aber keinen CTA. Sie klicken auf einen CTA, erreichen jedoch kein wichtiges Ereignis.
Das Problem ist nicht ein Mangel an Daten. Es fehlt eine Entscheidungskette, die Folgendes miteinander verbindet:
Suchnachfrage → Abgleich mit der Seitenintention → Nutzerverhalten → Geschäftsaktion → Optimierungsaufgabe → Performance-Feedback
Um dieses Problem zu lösen, haben wir ein internes Content-Growth-Diagnosesystem entwickelt und auf mehreren unabhängigen Websites aus den Bereichen E-Commerce, Fertigung, Unterhaltungselektronik und KI-SaaS validiert.
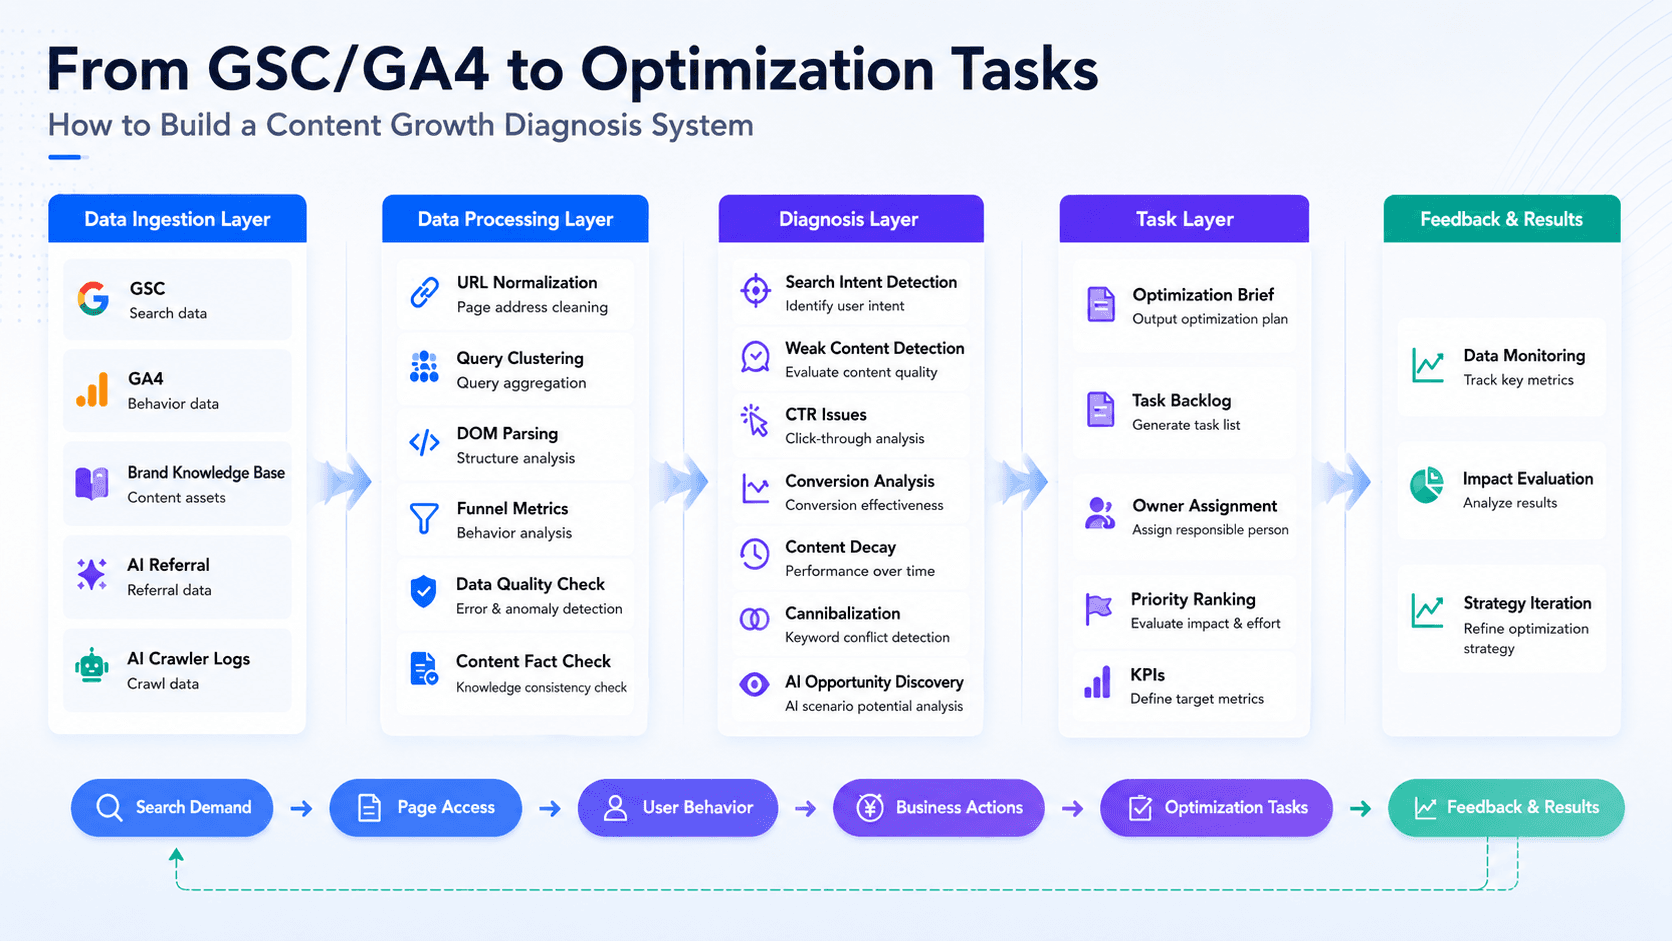
Dieses System ist kein standardmäßiger SEO-Bericht. Es ist auch kein Tool, das einfach eine KI um allgemeine Optimierungsvorschläge bittet. Stattdessen verbindet es GSC, GA4, die Marken-Wissensdatenbank, KI-Verweiszugriffe und KI-Crawler-Logs zu einem Diagnose-Workflow auf Seitenebene.
Das System hilft Teams dabei, folgende Fragen zu beantworten:
Welche Suchanfragen und Suchintentionen führen Nutzer auf eine Seite?
Greift die Seite diese Suchintention richtig auf und erfüllt sie?
Lesen Nutzer nach dem Aufruf der Seite weiter, sehen sie CTAs und klicken sie darauf?
Sind die Produktinformationen auf der Seite korrekt?
Bringen KI-Produkte Besuche auf die Website, und können KI-Crawler auf die Seite zugreifen?
Wie lassen sich die Belege in eine umsetzbare Optimierungsaufgabe überführen?
Welche Kennzahlen sollten nach der Aktualisierung der Seite beobachtet werden?
Der gesamte Datenfluss funktioniert folgendermaßen:
Zunächst werden die Datenquellen angebunden. Anschließend werden Daten aus verschiedenen Quellen derselben URL zugeordnet. Suchanfragen-Cluster dienen dazu, die Suchintention zu ermitteln. Mithilfe einer DOM-Analyse der Seite wird festgestellt, ob der Inhalt diese Suchintention erfüllt. GSC- und GA4-Funnel-Daten werden kombiniert, um zu ermitteln, an welcher Stelle Nutzer abspringen. Die Marken-Wissensdatenbank dient zur Überprüfung von Fakten im Content. KI-/GEO-Signale werden verwendet, um KI-Verweiszugriffe und die Zugänglichkeit für Crawler zu bewerten. Schließlich werden alle Belege in Optimierungsaufgaben überführt. Nach der Veröffentlichung der Änderungen wird die Performance kontinuierlich beobachtet.
Im Folgenden gehen wir den gesamten Workflow durch.
1. Datenerfassung: Suche, Verhalten, Fakten und KI-Signale in einer gemeinsamen Kette zusammenführen
Die erste Ebene ist die Datenerfassung. Wir binden hauptsächlich fünf Arten von Daten an:
Google Search Console, kurz GSC
Google Analytics 4, kurz GA4
Marken-Wissensdatenbank
KI-Verweiszugriffe
KI-Crawler-Logs
1.1 GSC und GA4
GSC erfasst die Performance auf der Suchseite. Dazu gehören Impressionen, Klicks, CTR, durchschnittliche Position und detaillierte Performance-Daten auf Suchanfragenebene.
Anhand der GSC-Daten kann das System feststellen, über welche Suchanfragen Nutzer eine Seite finden und welche Seiten weiterhin Impressionen erzielen, deren Klickrate jedoch zu sinken beginnt.
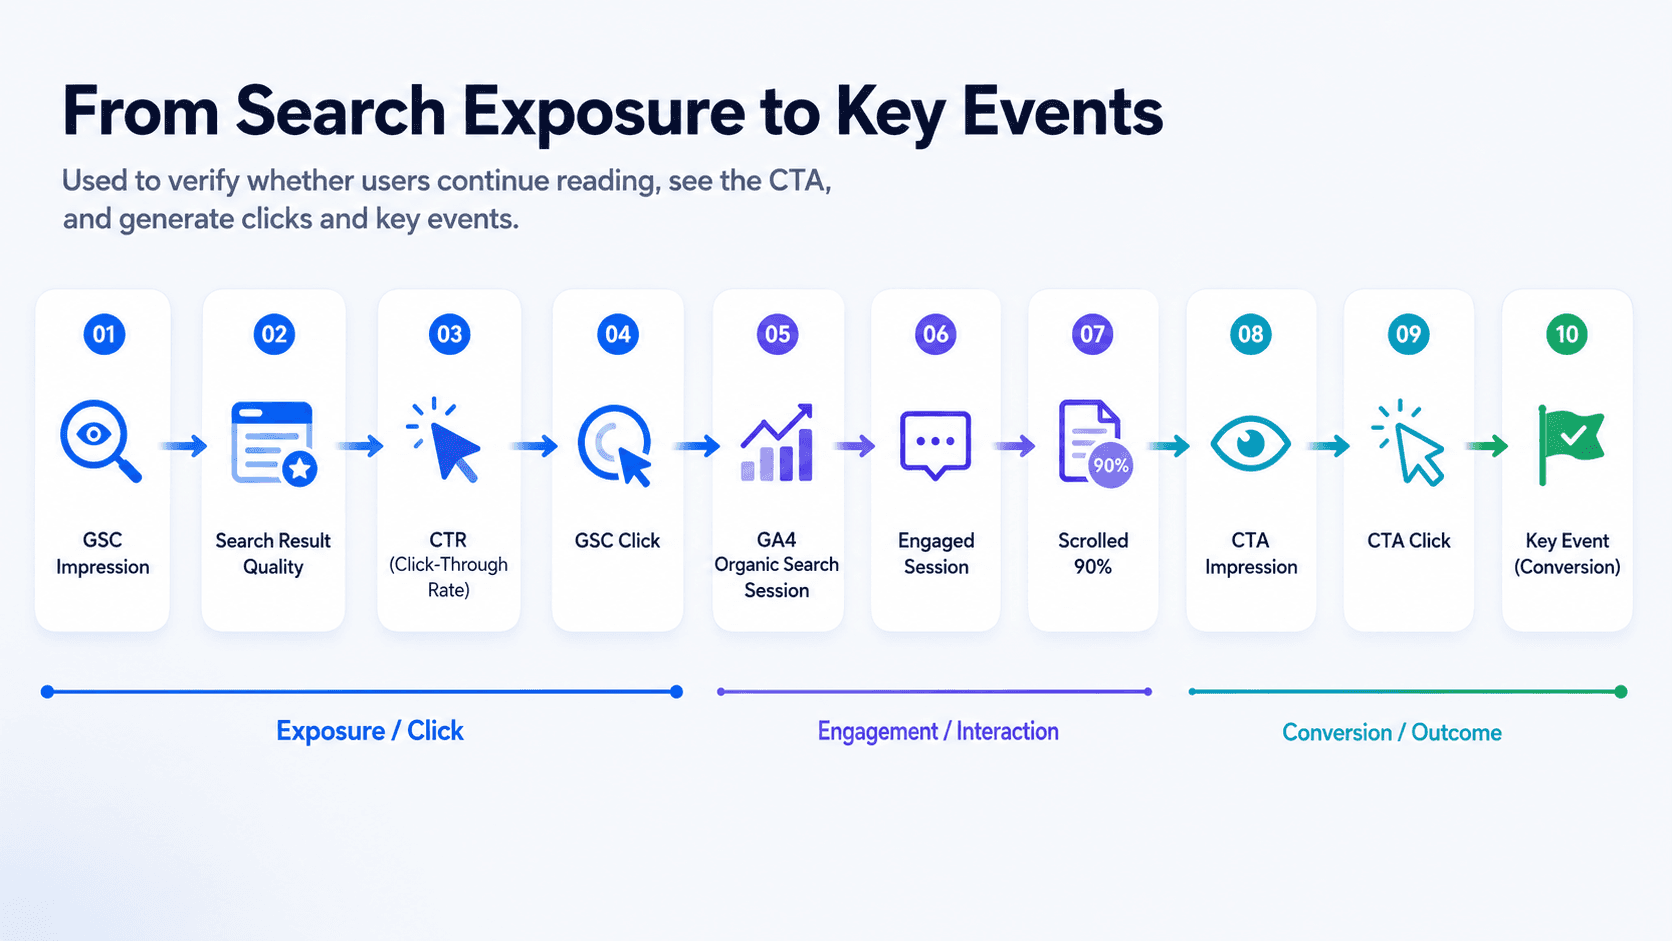
GA4 erfasst das Verhalten auf der Website. Dazu gehören organische Landing-Sessions aus der Suche, Engagement-Rate, Scroll-Verhalten, CTA-Impressionen, CTA-Klicks, Registrierungen und wichtige Ereignisse.
Anhand der GA4-Daten kann das System ermitteln, ob Nutzer nach dem Aufruf der Seite weiterlesen, ob sie Produktausstiege sehen, ob sie auf CTAs klicken und ob sie wichtige geschäftliche Aktionen ausführen.
GSC und GA4 entfalten ihre volle Wirkung erst, wenn sie gemeinsam eingesetzt werden.
Betrachten wir nur GSC, sehen wir lediglich, was in den Suchergebnissen passiert. Betrachten wir nur GA4, sehen wir lediglich, was passiert, nachdem Nutzer auf die Website gelangt sind. Werden beide miteinander verknüpft, kann das System genau feststellen, an welcher Stelle ein Artikel ins Stocken gerät.
Zum Beispiel:
Viele Impressionen, aber eine niedrige CTR
Titel, Meta-Beschreibung und Relevanz für die Suchanfrage priorisieren.
Viele Klicks, aber niedriges Engagement
Einstiegsbereich, Inhaltsverzeichnis, Seitenstruktur und Übereinstimmung mit der Suchintention priorisieren.
Gutes Engagement, aber wenige CTA-Klicks
Produktmodule, CTA-Texte und CTA-Platzierung priorisieren.
CTA-Klicks sind vorhanden, aber wichtige Ereignisse bleiben aus
Registrierungsprozess, Demo-Prozess oder Landingpage-Flow weiter überprüfen.
1.2 Marken-Wissensdatenbank
Die Marken-Wissensdatenbank dient der Überprüfung von Produktfakten.
Teams können die neuesten Produktfunktionen, Preispläne, Screenshot-Versionen, Markenbotschaften, Standards für Wettbewerbsvergleiche, FAQ-Antworten und wichtige Produktaktualisierungen mit der Wissensdatenbank synchronisieren.
Anschließend vergleicht das System die Seiteninhalte mit der Wissensdatenbank, um festzustellen, ob Produktinformationen in einem Artikel veraltet sind.
Ziel dieses Moduls ist es, dem LLM eine aktuelle, einheitliche und vertrauenswürdige Quelle für Produktfakten bereitzustellen.
Ohne eine Marken-Wissensdatenbank kann das System nur anhand des Veröffentlichungsdatums, jahresbezogener Formulierungen, Screenshots oder der Aktualität der SERP vermuten, ob Inhalte veraltet sein könnten. Nach der Anbindung der Wissensdatenbank kann das System deutlich konkretere Aufgaben erstellen, zum Beispiel:
Veraltete Produktscreenshots ersetzen
Beschreibungen der Preispläne korrigieren
Vergleichstabellen zu Wettbewerbern überarbeiten
Die neuesten FAQ-Antworten übernehmen
1.3 KI-Verweiszugriffe und KI-Crawler-Logs
KI-/GEO-Daten werden in zwei Kategorien unterteilt:
KI-Verweis-Sessions
KI-Crawler-Logs
KI-Verweis-Sessions stammen aus GA4. Sie zeigen, ob Produkte wie ChatGPT oder Perplexity echte Besuche auf die Website bringen und ob diese Besuche zu Engagement oder wichtigen Ereignissen führen.
KI-Crawler-Logs stammen aus Server-Logs, Cloudflare, CDN-Logs oder Edge-Logs. Sie zeigen, ob Crawler wie GPTBot, PerplexityBot und ClaudeBot auf eine Seite zugegriffen haben, ob der Statuscode normal ist und ob der Zugriff durch Robots-Regeln, WAF, CDN-Konfiguration oder fehlende Logs beeinträchtigt wird.
Diese Unterscheidung ist wichtig:
KI-Crawler sind keine Traffic-Quellen in GA4.
GA4 eignet sich dazu, Verweis-Sessions von KI-Produkten zu messen. Der Zugriff durch Crawler muss anhand von Logs überprüft werden.
Eine Seite kann von GPTBot gecrawlt worden sein, ohne KI-Verweis-Sessions von ChatGPT zu haben. Eine andere Seite kann bereits Verweiszugriffe von Perplexity erhalten, aber unvollständige Crawler-Logs aufweisen. Erst wenn beide Signale gemeinsam betrachtet werden, kann das Team entscheiden, ob eine Seite mehr zitierfähige Inhalte benötigt oder zuerst ihre technische Zugänglichkeit überprüft werden sollte.
2. Datenverarbeitung: Zuerst URLs zuordnen, dann Belege auf Seitenebene erstellen
Nachdem die Datenquellen angebunden wurden, erstellt das System nicht sofort Vorschläge. Zunächst verarbeitet es die Daten.
Ziel der Verarbeitungsebene ist es, verstreute Daten in Belege auf Seitenebene zu überführen.
2.1 Zuordnung von Daten auf URL-Ebene
Der erste Schritt ist die URL-Zuordnung.
GSC, GA4 und Server-Logs erfassen Seitenadressen häufig unterschiedlich.
Ein und derselbe Artikel kann in GSC beispielsweise als vollständige URL erscheinen, in GA4 Tracking-Parameter enthalten und in Server-Logs nur als Seitenpfad auftauchen. Wenn das System diese Adressen nicht zuerst vereinheitlicht, wird derselbe Artikel auf mehrere Datensätze verteilt: Suchklicks an einem Ort, Website-Sessions an einem anderen, CTA-Klicks an einem dritten und Crawler-Zugriffe an einem weiteren.
Deshalb bereinigt das System zunächst die Seitenadressen, indem es UTM-Parameter, Anzeigenklick-Parameter, Seitenanker und andere Elemente entfernt, die den Seiteninhalt selbst nicht verändern. Anschließend ordnet es denselben Artikel einer kanonischen Seiten-URL zu.
Erst nach diesem Schritt können Impressionen, Klicks, Sessions, CTAs, wichtige Ereignisse und KI-Crawler-Datensätze korrekt demselben Artikel zugeordnet werden.
2.2 Clustering von Suchanfragen
Ein Suchanfragen-Cluster bündelt ähnliche Suchanfragen anhand der Suchintention der Nutzer.
GSC enthält oft eine große Zahl fragmentierter Suchanfragen. Wenn sich das Content-Team jede einzelne Suchanfrage ansieht, lässt sich nur schwer erkennen, was Nutzer tatsächlich erreichen möchten.
Das System gruppiert Suchanfragen nach Suchintention und ordnet ihnen entsprechende Intentionstypen zu, etwa:
Definitionsintention
Intention zur Toolauswahl
Vergleichsintention
Kommerzielle Intention
Preisintention
Support-Intention
Navigationsintention
Künftig können diese auch den Nutzerintentionen in KI-Marketing- und KI-Suchszenarien zugeordnet werden.
Dadurch kann das Team statt Tausender verstreuter Keywords eine überschaubare Anzahl von Nutzerbedürfnissen betrachten.
Wichtig ist auch, die Grenzen dieser Funktion klarzustellen:
Dies ist keine präzise Zuordnung einzelner Suchanfragen zu Conversions.
Das System gibt nicht vor zu wissen, dass eine bestimmte Suchanfrage direkt zu einer bestimmten Registrierung geführt hat. Stattdessen löst es das Problem des Abgleichs zwischen Suchintention und Content: Welche Nutzerbedürfnisse führen Besucher auf die Seite, und gibt es dort passende Inhalte, die diese Bedürfnisse erfüllen?
2.3 DOM-Analyse der Seite
Der dritte Schritt ist die DOM-Analyse der Seite.
Das System crawlt die Seite und analysiert ihre Struktur, darunter:
Titel
H1
H2
H3
FAQ-Bereiche
Tabellen
CTAs
Interne Links
Textauszüge aus dem Hauptinhalt
Anschließend ermittelt es, ob jeder Suchanfragen-Cluster einer entsprechenden Position im Seiteninhalt zugeordnet werden kann.
Wenn Nutzer beispielsweise nach Tools suchen, aber die Seite nur Konzepte erklärt und keine Auswahlkriterien, Vergleichstabelle oder Anwendungsfälle für Tools enthält, kann das System eine schwache Übereinstimmung mit der Suchintention erkennen.
2.4 Bewertung der Datenqualität
Nicht alle Daten eignen sich für die automatische Erstellung von Aufgaben.
Das System prüft außerdem, ob:
GSC-Daten fehlen
GA4-Daten fehlen
URLs korrekt zugeordnet sind
Die Stichprobengröße ausreicht
Das Event-Tracking vollständig ist
Die Marken-Wissensdatenbank verfügbar ist
KI-Crawler-Logs angebunden sind
Die Datenqualität bestimmt unmittelbar, was das System tun darf:
Datenqualität
Verhalten des Systems
Hoch
Aufgabenentwürfe erstellen
Mittel
Aufgaben erst nach manueller Bestätigung erstellen
Niedrig
Nur Diagnosen anzeigen, keine Aufgaben automatisch erstellen
Ungültig
Keine Beurteilung vornehmen und keine Aufgaben erstellen
Dieser Schritt ist entscheidend.
Ein Content-Diagnosesystem sollte nicht nur wissen, wie es Empfehlungen erstellt. Es sollte auch erkennen, wenn die Belege nicht ausreichen und keine Automatisierung eingesetzt werden sollte.
3. Diagnoseschleife: Von der Suchnachfrage über den Abgleich mit der Seite und das Nutzerverhalten bis zur Geschäftsaktion
Nach Abschluss der Datenverarbeitung wechselt das System auf die Diagnoseebene.
3.1 Suchseite: Welche Suchanfragen und Suchintentionen führen Nutzer auf die Seite?
Das System überprüft zunächst die GSC-Suchanfragen und die Suchanfragen-Cluster.
Bei ein und derselben Seite zum Thema KI-Sichtbarkeit kann die Suchintention der Nutzer erheblich variieren:
„Was ist KI-Sichtbarkeit?“ deutet auf den Wunsch hin, ein Konzept zu verstehen.
„Die besten KI-Sichtbarkeitstools für SaaS“ deutet auf die Auswahl eines Tools hin.
„GEO-Monitoring-Plattformen vergleichen“ deutet auf einen Lösungsvergleich hin.
„Markenerwähnungen in ChatGPT tracken“ deutet auf einen konkreten Workflow hin.
Wenn eine Seite zuvor hauptsächlich Suchanfragen mit Definitionsintention bedient hat, neue Impressionen nun aber von Suchanfragen zur Toolauswahl, zum Vergleich oder zu Workflows stammen, erkennt das System, dass sich die Nutzerbedürfnisse verändert haben.
Dieser Schritt beantwortet eine Frage:
Welche Aufgabe versucht der Nutzer zu erledigen, wenn er auf die Seite gelangt?
3.2 Seiteninhalt: Entspricht die Seite der Suchintention des Nutzers?
Nachdem die Suchanfragen-Cluster ermittelt wurden, analysiert das System das DOM der Seite.
Verschiedene Suchintentionen erfordern unterschiedliche Inhaltsstrukturen:
Intentionstyp
Erforderlicher Inhalt
Definitionsintention
Klare Definition, Erklärung und FAQ
Intention zur Toolauswahl
Toolliste, Auswahlkriterien, Anwendungsfälle und CTA
Vergleichsintention
Tabellen, Preise, Unterschiede und Anwendungsfälle
Workflow-Intention
Schritte, Kennzahlen, Vorlagen und häufige Fehler
Kommerzielle Intention
Produktmodule, Fallstudien, CTA und nächster Schritt
Das System prüft, ob diese Elemente im Titel, in H1, H2, FAQ, Tabellen und CTAs vorkommen oder vollständig fehlen.
Wenn ein Suchanfragen-Cluster Impressionen erzielt, die Seite das entsprechende Bedürfnis aber nur oberflächlich abdeckt, kennzeichnet das System dies als Content-Lücke, neue Suchanfragen-Chance oder schwache Übereinstimmung mit der Suchintention.
Dieser Schritt beantwortet die Frage:
Greift die Seite das Bedürfnis des Nutzers richtig auf und erfüllt sie es?
3.3 Verhalten: Lesen Nutzer, sehen sie CTAs und klicken sie darauf?
Der Abgleich des Contents mit der Suchintention allein reicht nicht aus. GA4-Verhaltensdaten werden benötigt, um zu überprüfen, ob Nutzer tatsächlich weitere Aktionen ausführen.
Das System erstellt einen Seiten-Funnel von der Sichtbarkeit in der Suche bis zur Geschäftsaktion.
Dies ist eine der wichtigsten Perspektiven im Diagnoseprozess, denn sie hilft dabei, die Stelle zu ermitteln, an der Nutzer nicht weiterkommen.
Zum Beispiel:
Wenn Nutzer auf der Seite landen, das Engagement aber niedrig ist, liegt das Problem möglicherweise am Einstiegsbereich, am Inhaltsverzeichnis, an der Inhaltsstruktur oder am Ladeerlebnis der Seite.
Wenn Nutzer den Inhalt lesen, aber nur wenige CTA-Impressionen erfasst werden, ist der CTA möglicherweise zu weit unten platziert.
Wenn die CTA-Impressionen normal sind, die Klicks aber niedrig ausfallen, passen der CTA-Text, das Produktmodul oder die Nutzerintention möglicherweise nicht zusammen.
Wenn CTA-Klicks vorhanden sind, aber wenige Registrierungen, Demo-Klicks oder wichtige Ereignisse folgen, liegt das Problem möglicherweise im anschließenden Registrierungs-, Demo- oder Landingpage-Prozess.
Dieser Schritt beantwortet die Frage:
Bleiben Nutzer beim Lesen, bei der CTA-Einblendung, beim CTA-Klick oder bei der geschäftlichen Conversion hängen?
3.4 Fakten: Sind die Inhalte veraltet und sind die Produktinformationen korrekt?
Bei B2B-SaaS-Inhalten sind veraltete Inhalte nicht nur eine Frage des Veröffentlichungsdatums.
Ein im letzten Jahr veröffentlichter Artikel kann weiterhin korrekt sein. Ein anderer Artikel, der erst im letzten Monat aktualisiert wurde, kann bereits falsche Preisangaben, Funktionen, Screenshots oder Wettbewerbsvergleiche enthalten.
Die Marken-Wissensdatenbank gleicht Seiteninhalte mit den neuesten Produktfakten ab. Das System prüft, ob:
Die auf der Seite genannten Funktionen weiterhin verfügbar sind
Die Preise noch aktuell sind
Screenshots veraltet sind
Wettbewerbsvergleiche dem aktuellen Standard entsprechen
FAQ-Antworten mit den offiziellen Antworten übereinstimmen
Dieses Modul verhindert zwei häufige Probleme:
Alte Artikel geben Nutzern weiterhin falsche Produktinformationen.
Das LLM erstellt irreführende Empfehlungen auf Grundlage veralteter Seiteninhalte.
Dieser Schritt beantwortet die Frage:
Basieren die Empfehlungen des Systems auf den neuesten Produktfakten?
3.5 KI/GEO: Können KI-Quellen auf die Seite zugreifen und sie zitieren?
Das KI-/GEO-Modul trifft hauptsächlich zwei Beurteilungen.
Erstens zeigen KI-Verweis-Sessions, ob KI-Produkte echte Besuche bringen. Das System prüft zum Beispiel, ob ChatGPT, Perplexity und ähnliche Quellen Sessions generieren und ob diese zu Engagement oder wichtigen Ereignissen führen.
Zweitens zeigen KI-Crawler-Logs, ob KI-Crawler auf die Seite zugreifen können. Das System prüft, ob GPTBot, PerplexityBot, ClaudeBot und ähnliche Crawler die Seite besucht haben, ob sie den Statuscode 200, 304, 403 oder 404 zurückgegeben haben, ob es einen Grund für eine Blockierung gibt und ob Logs fehlen.
Zusammen bestimmen diese beiden Signale die nächsten Schritte:
Wenn die Seite KI-Verweiszugriffe erhält, die Conversion aber schwach ist, sollten der Abgleich mit der Suchintention und die CTA-Optimierung priorisiert werden.
Wenn der Crawler-Status auffällig ist, sollten zuerst Robots-Regeln, WAF, CDN oder die Log-Integration überprüft werden.
Wenn der Crawler-Zugriff normal ist, der Seite aber klare Definitionen, Schritte, FAQs und antwortorientierte Zusammenfassungen fehlen, sollten zitierfähige Inhalte priorisiert werden.
Wenn die KI-Verweiszugriffe zunehmen, wichtige Ereignisse aber ausbleiben, ist KI-Traffic vorhanden, doch der Abgleich der Seite mit den geschäftlichen Zielen muss noch verbessert werden.
Dieser Schritt beantwortet die Frage:
Liegt das Problem in KI-Such- und LLM-Zitierszenarien am Traffic, am Content oder an der technischen Sichtbarkeit?
4. Ermittlung des Problemtyps: Diagnoseergebnisse in eine Operations-Warteschlange überführen
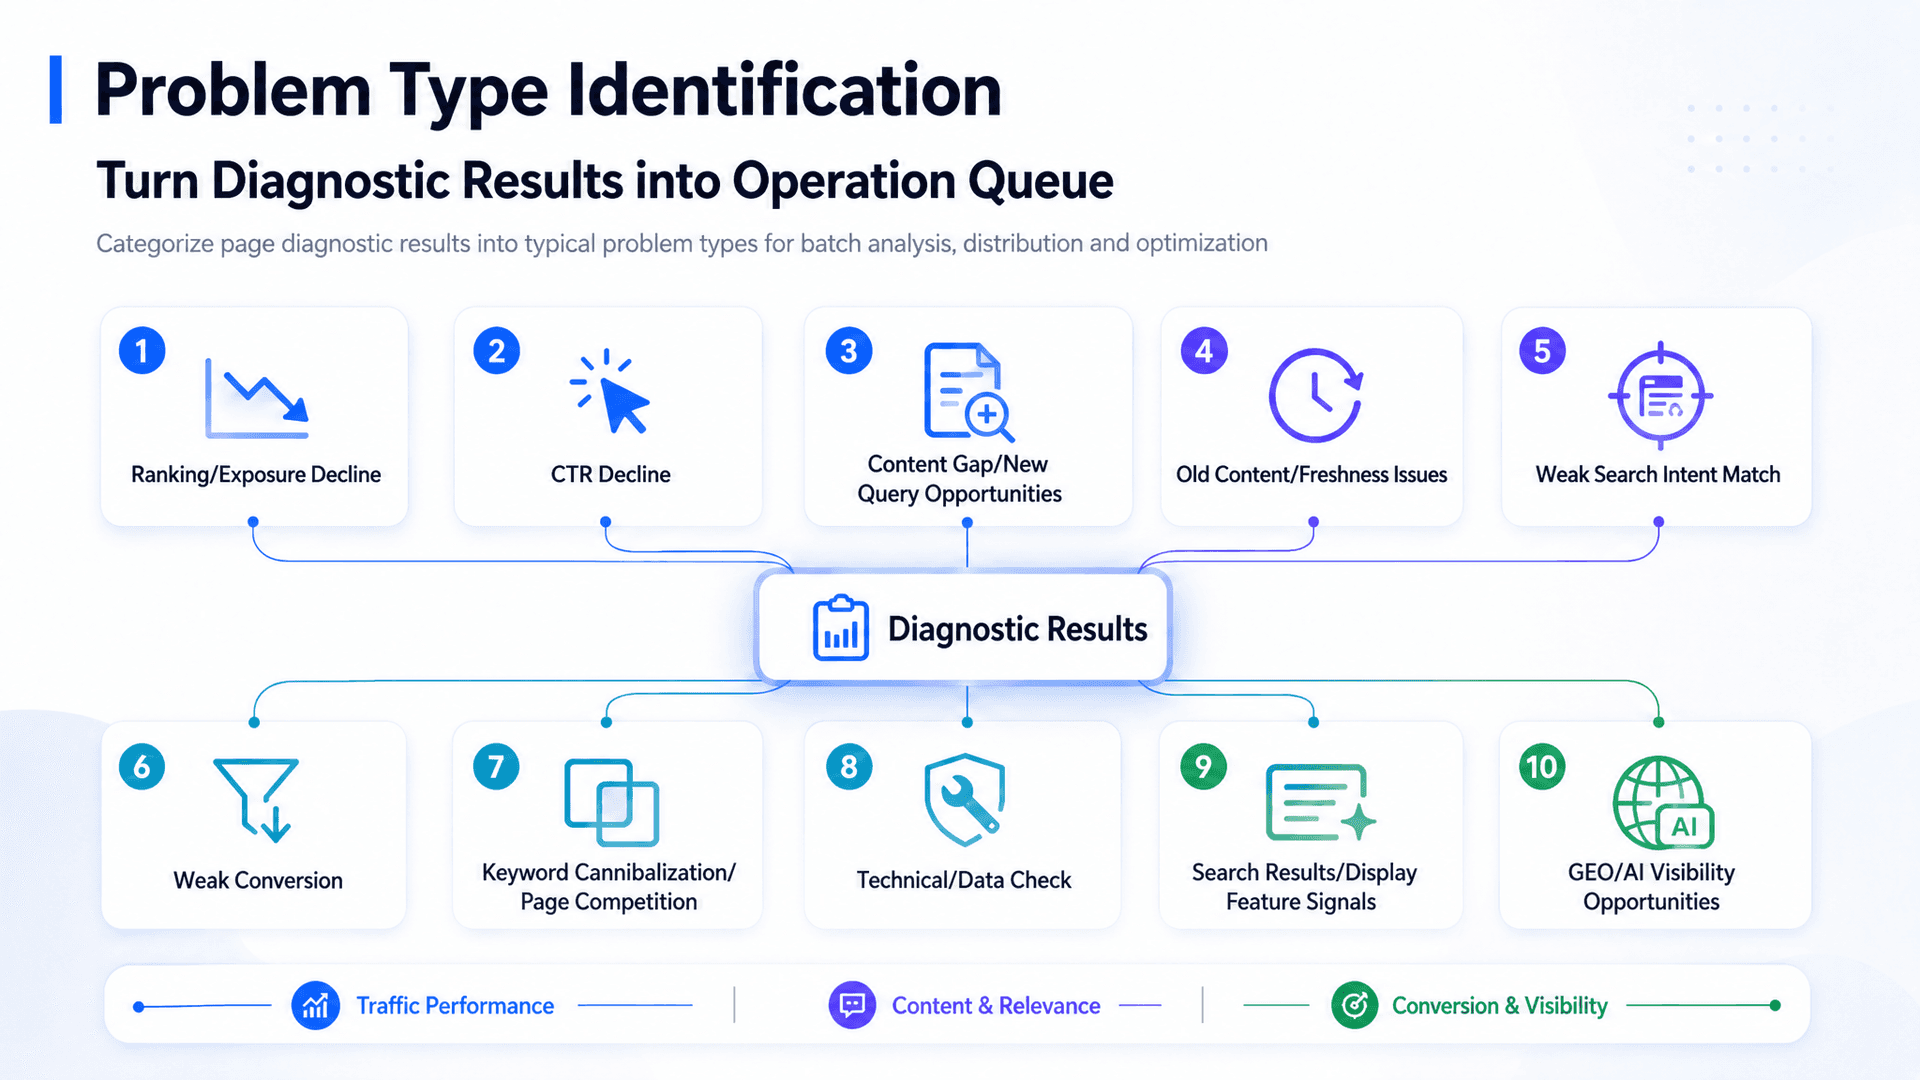
Nach Abschluss der oben beschriebenen Diagnoseschritte ordnet das System jede Seite einem bestimmten Problemtyp zu.
Der Vorteil der Gruppierung nach Problemen besteht darin, dass Content-Optimierung zu einer gebündelten Operations-Aufgabe wird statt zur vereinzelten Bearbeitung einzelner Artikel.
Zu den häufigen Problemgruppen gehören:
Rückgang des Traffics
Rückgang der CTR
Schwacher Content oder schwache Übereinstimmung mit der Suchintention
Veralteter Content
Schwache Conversion
Doppelte oder miteinander konkurrierende Seiten
Nicht genutzte Content-Chancen
Technische Probleme oder Datenprobleme
GEO- oder KI-Sichtbarkeitsprobleme
Die Seitengruppe zeigt nicht nur die Problembezeichnungen an. Sie enthält auch:
Auslösende Belege
Momentaufnahme des Seiten-Funnels
Wichtigste betroffene Suchanfragen-Cluster
Content-Positionen
Datenqualität
Zusammenfassung der empfohlenen Maßnahmen
Verantwortliche Person
Status
So können die für Content Verantwortlichen ihre Arbeit jede Woche nach Problemgruppen organisieren.
Zum Beispiel:
Diese Woche: Rückgang der CTR beheben.
Nächste Woche: schwache Conversion angehen.
In der darauffolgenden Woche: veraltete Inhalte und Kannibalisierung zwischen Seiten bearbeiten.
Das Team bearbeitet nicht länger zufällig Seiten, die problematisch aussehen. Stattdessen kann es die Optimierungsarbeit nach Problemtyp und Priorität angehen.
5. Aufgabenerstellung: Das System gibt Optimierungsempfehlungen aus
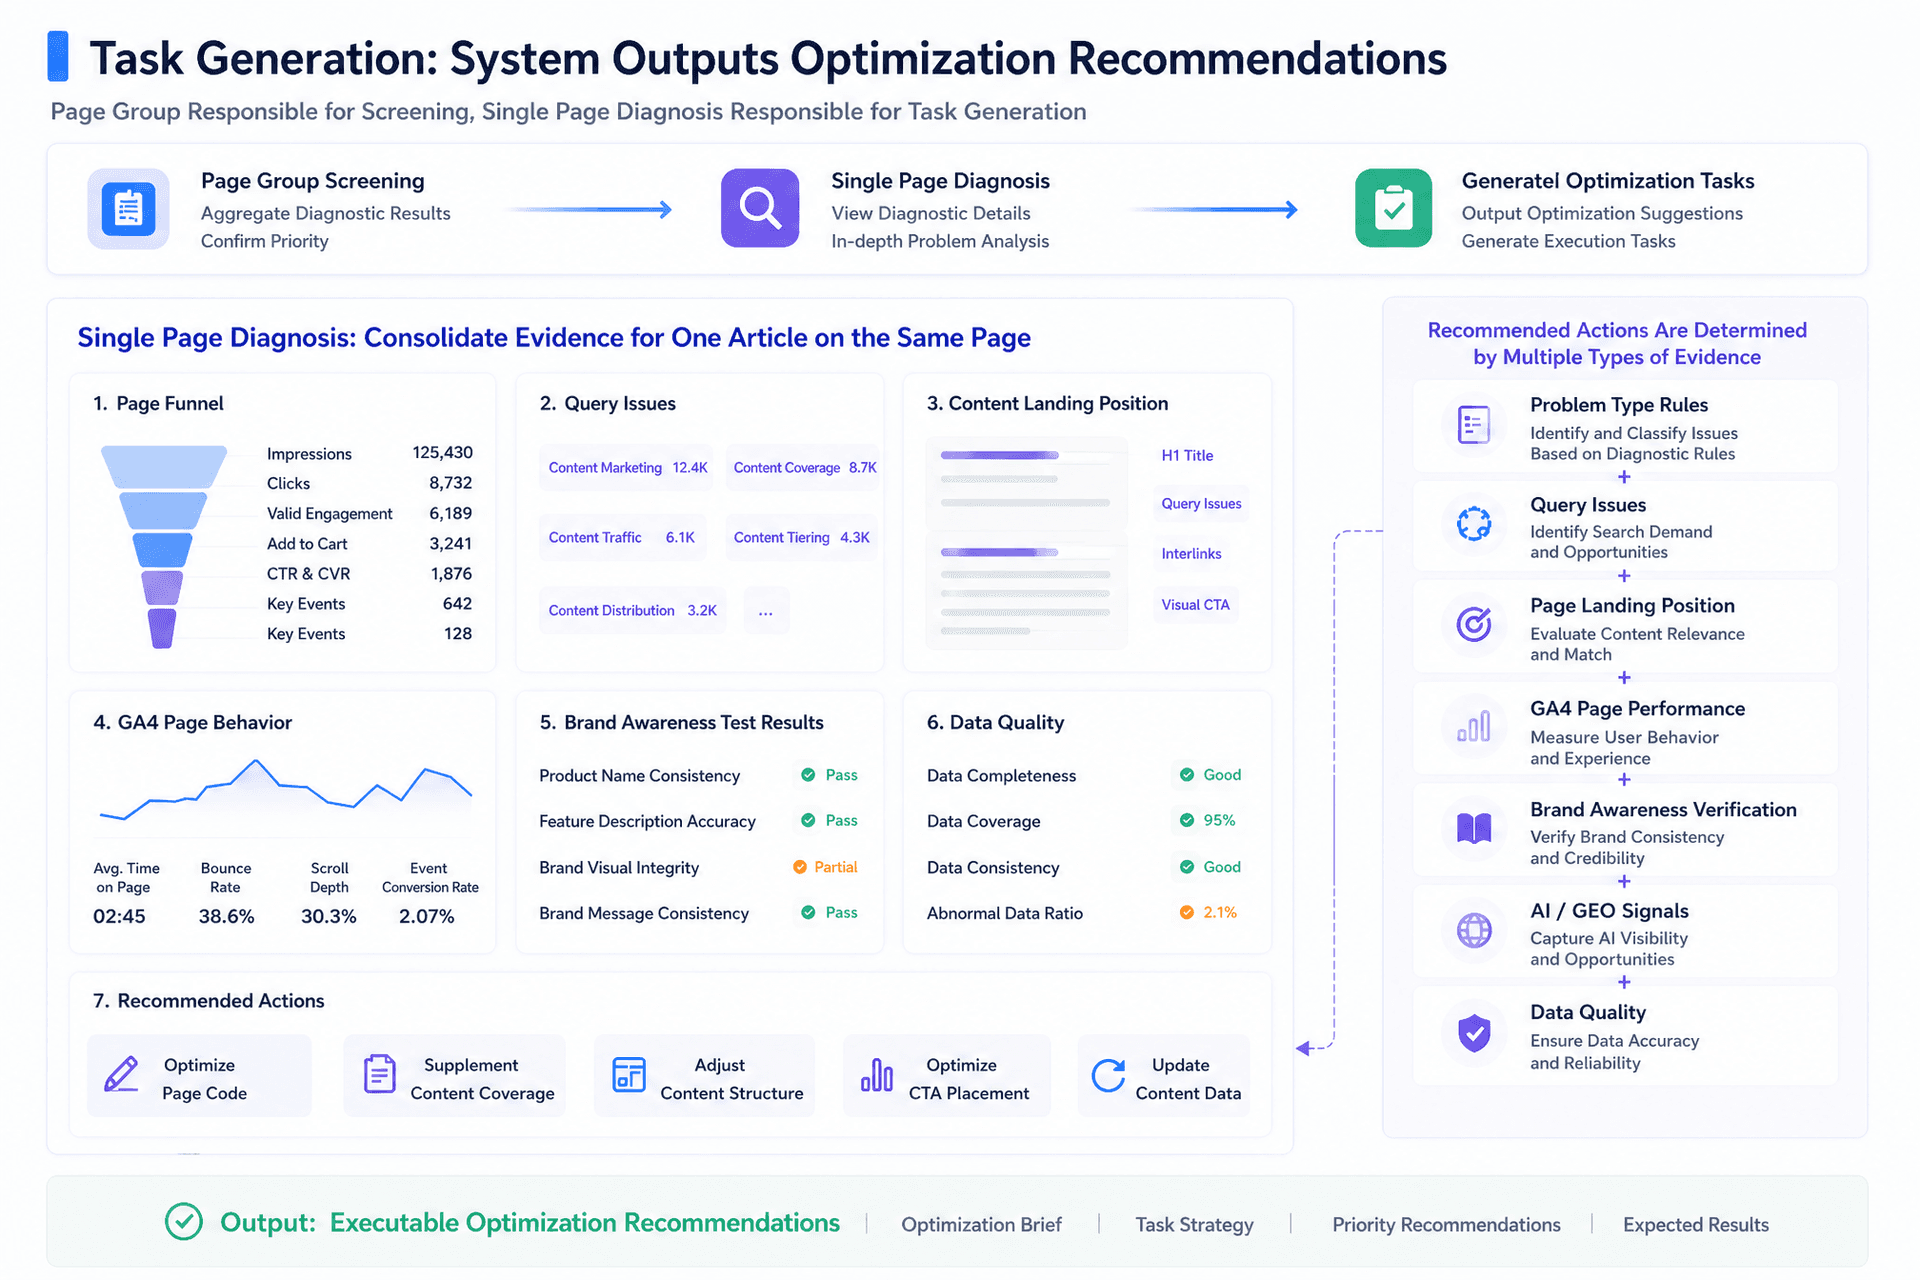
Seitengruppen dienen der Filterung. Die Diagnose einzelner Seiten dient der Aufgabenerstellung.
Bei der Aufrufung der Diagnoseansicht einer einzelnen Seite stellt das System alle Belege zu einem Artikel auf einer Seite zusammen:
Seiten-Funnel
Suchanfragen-Cluster
Positionen zum Content-Abgleich
Seitenverhalten in GA4
Ergebnisse der Überprüfung anhand der Marken-Wissensdatenbank
Datenqualität
Empfohlene Maßnahmen
Die empfohlenen Maßnahmen werden hauptsächlich anhand einer Kombination verschiedener Belegarten ermittelt:
textCopy
Regeln für Problemtypen
+ Suchanfragen-Cluster
+ Positionen zum Abgleich mit dem Seiteninhalt
+ Seiten-Performance in GA4
+ Überprüfung anhand der Marken-Wissensdatenbank
+ KI-/GEO-Signale
+ Datenqualität
Die Ausgabe ist kein vager Vorschlag wie „Diesen Artikel optimieren“. Stattdessen sollte daraus eine Aufgabe werden, die klar erklärt:
Warum diese Seite aktualisiert werden muss
Welcher Teil der Seite ein Problem aufweist
Was geändert werden sollte
Wer für die Aufgabe verantwortlich ist
Welche Kennzahlen nach der Aktualisierung überprüft werden sollten
6. Beispiel: So funktioniert die vollständige Diagnosekette für eine Seite
GSC zeigt, dass diese Seite zunehmend Impressionen für Suchanfragen rund um „Tools zum Tracken von KI-Erwähnungen“ erhält.
Wenn wir nur GSC betrachten, sehen wir zwar, dass Suchnachfrage besteht, können aber noch nicht feststellen, ob die Seite diese Nachfrage erfüllt.
Schritt 2: Das Clustering der Suchanfragen ermittelt die Intention zur Toolauswahl
Das System ordnet diese Suchanfragen einem Cluster mit der Intention zur Toolauswahl zu.
Das bedeutet, dass Nutzer nicht nur ein Konzept verstehen möchten. Sie suchen nach einer Kategorie von Tools, vergleichen die Funktionen verschiedener Tools und sind möglicherweise sogar bereit, eine Testphase oder einen Kaufprozess zu starten.
Schritt 3: Die DOM-Analyse zeigt eine schwache Übereinstimmung mit der Suchintention
Das System analysiert das DOM der Seite und stellt fest, dass der Einstiegsbereich und die H2-Struktur nach wie vor hauptsächlich das Konzept erklären.
Die Seite bietet keine klaren Kriterien für die Toolauswahl, Vergleichsdimensionen oder Anwendungsfälle.
Mit anderen Worten: Die Suchintention hat sich in Richtung Toolauswahl verschoben, die Seite funktioniert aber weiterhin wie ein Artikel zur Erklärung eines Konzepts.
Schritt 4: GA4 ergänzt Verhaltensbelege
GA4 zeigt, dass die Seite ein relativ hohes Engagement, aber wenige CTA-Klicks erzielt.
Das bedeutet, dass Nutzer bereit sind, weiterzulesen, die Seite sie aber nicht reibungslos zu einer Produktaktion führt.
Schritt 5: Die Marken-Wissensdatenbank überprüft Produktinformationen
Die Marken-Wissensdatenbank stellt fest, dass die Produktscreenshots auf der Seite veraltet sind und einige Funktionsbeschreibungen nicht auf den neuesten Stand gebracht wurden.
Wird dies nicht korrigiert, verwendet das LLM möglicherweise weiterhin veraltete Produktinformationen, wenn es Optimierungsempfehlungen generiert.
Schritt 6: KI-Crawler-Logs überprüfen die technische Zugänglichkeit
Die KI-Crawler-Logs zeigen, dass GPTBot die Seite normal crawlen kann.
Das bedeutet, dass das vorrangige Problem nicht das technische Crawling ist. Dringender ist die Frage, ob die Inhalte zitierfähig genug sind, ob die Produktinformationen korrekt sind und ob der CTA zu Nutzern passt, die ein Tool auswählen möchten.
Entwurf der abschließenden Aufgabe
Das System erstellt einen Aufgabenentwurf wie diesen:
markdownCopy
Seite: /blog/top-tools-to-track-ai-mentions-in-llms

Problemtyp:
- Schwache Übereinstimmung mit der Suchintention
- Schwache Conversion
- Veraltete Inhalte

Auslösende Hinweise:
- Suchanfragen zur Toolauswahl erzielen Impressionen in der Suche
- Einleitungsabschnitt und H2-Struktur konzentrieren sich weiterhin auf die Erklärung von Konzepten
- Das Engagement ist hoch, aber die CTA-Klicks sind niedrig
- Die Marken-Wissensdatenbank stellt veraltete Produktscreenshots fest
- Das Crawling durch GPTBot funktioniert normal

Empfohlene Maßnahmen:
- Ein Modul mit Auswahlkriterien für Tools hinzufügen
- Eine Vergleichstabelle für Tools hinzufügen
- Produktscreenshots aktualisieren
- Den allgemeinen Anmelde-CTA durch „KI-Erwähnungen überwachen – Lösung ansehen“ ersetzen
- FAQ-Inhalte hinzufügen
- Schrittweise aufbereitete Inhalte hinzufügen, die sich leichter von LLMs zitieren lassen

Nach der Aktualisierung zu verfolgende Kennzahlen:
- CTR
- Sitzungen aus der organischen Suche
- CTA-Klicks
- Demo-Klicks
- Wichtige Ereignisse
- KI-Verweise
- Crawler-Status
So wird aus einem Artikel mit „unklarer Datenperformance“ eine konkrete Aufgabe.
Das Team weiß:
Warum der Artikel geändert werden muss
Wo das Problem liegt
Was aktualisiert werden muss
Wer dafür zuständig ist
Welche Kennzahlen anschließend überprüft werden sollten
7. Performance-Monitoring und Überprüfung
Ein echter Content-Growth-Loop muss nach der Aktualisierung eines Artikels auch Performance-Daten zurück in das System einspeisen.
Die aktuelle Version kann bereits den zentralen Workflow von der Datenerfassung über die Seitendiagnose bis zur Erstellung eines Aufgabenentwurfs ausführen.
In der nächsten Phase soll das Performance-Tracking nach der Umsetzung ergänzt werden, sodass jede Content-Aktualisierung mit den anschließenden Veränderungen der Kennzahlen verknüpft wird.
Das System erfasst:
Zeitpunkt der Aufgabenerstellung
Aktualisierte Module
Veröffentlichungszeitpunkt
Zuständige Person
Aufgabenstatus
Nachfolgende Performance-Daten
So können Teams beurteilen, ob jede Optimierungsmaßnahme tatsächlich Ergebnisse erzielt.
8. Was noch entwickelt werden muss
Das System kann mittlerweile die zentrale Diagnosestrecke ausführen. Einige Funktionen müssen jedoch noch verbessert werden.
8.1 Clustering nach Suchintention
Die aktuelle Version stützt sich hauptsächlich auf Textähnlichkeit und regelbasierte Bewertungen. In vertikalen Branchen deckt dies bereits die meisten gängigen Suchanfragen ab.
Long-Tail-Suchanfragen, neu aufkommende Begriffe sowie Suchanfragen, die semantisch ähnlich sind, sich aber in ihrer Intention unterscheiden, können jedoch weiterhin falsch gruppiert werden.
Künftig kombiniert das System Keyword-Matching mit LLM-basierter Bewertung, um Suchanfrage-Cluster präziser zu klassifizieren.
Suchintentions-Cluster mit geringer Konfidenz markiert das System automatisch als „manuelle Bestätigung erforderlich“. So wird verhindert, dass bei unzureichender Beweislage falsche Aufgaben erstellt werden.
8.2 Automatische Aktualisierung der Marken-Wissensdatenbank
Die Marken-Wissensdatenbank wird derzeit noch hauptsächlich durch manuelle Importe gepflegt. Das funktioniert gut, um zentrale Informationen wie Produktfunktionen, Preise, Screenshots, FAQ-Antworten und Standards für die Kommunikation über Wettbewerber zunächst an einem Ort zusammenzuführen.
Langfristig kann die Wissensdatenbank jedoch nicht ausschließlich auf manueller Pflege beruhen.
Im nächsten Schritt sollen Produkt-Changelogs, CMS-Daten oder interne Dokumentationsquellen angebunden werden, damit die Version der Wissensdatenbank automatisch aktualisiert werden kann, wenn sich das Produkt weiterentwickelt.
Dadurch hängen Prüfungen auf veraltete Inhalte weniger von manueller Kontrolle ab. Außerdem kann das System veraltete Funktionen, alte Screenshots, falsche Preise und Produktbeschreibungen, die nicht mehr zur aktuellen Kommunikation passen, schneller erkennen.
8.3 Performance-Tracking
Das System kann bereits bestimmen, welcher Artikel aktualisiert werden sollte, warum eine Aktualisierung erforderlich ist, wo Änderungen vorgenommen werden sollten und wie sich eine evidenzbasierte Optimierungsaufgabe erstellen lässt.
Im nächsten Schritt soll das Performance-Tracking nach der Aufgabenumsetzung ergänzt und jede Content-Aktualisierung mit späteren Veränderungen der Kennzahlen verknüpft werden.
Sobald dies umgesetzt ist, können Content-Teams nachvollziehen:
Ob eine Optimierung tatsächlich Wachstum bewirkt hat
Welche Arten von Aktualisierungen wirksamer sind
Bei welchen Seiten weitere Iterationen erforderlich sind
Fazit
Das Ziel dieses Diagnosesystems für Content-Wachstum ist nicht, einen weiteren SEO-Bericht bereitzustellen.
Vielmehr soll die Optimierung des organischen Traffics zu einem Prozess werden, der:
Umsetzbar ist
Nachverfolgt werden kann
Überprüft werden kann
Mit Geschäftsergebnissen verknüpft ist
Das System verbindet Suchdaten, Seiteninhalte, Nutzerverhalten, Markeninformationen, KI-/GEO-Sichtbarkeit, Optimierungsaufgaben und Performance-Feedback zu einem geschlossenen Kreislauf.
Dadurch erhält das Content-Team nicht länger vage Anweisungen wie „den Artikel optimieren“.
Stattdessen kann es klar nachvollziehen:
Warum die Seite geändert werden muss
Wo das Problem liegt
Was aktualisiert werden sollte
Wer die Aufgabe umsetzen sollte
Welche Kennzahlen nach der Aktualisierung überprüft werden sollten
Wenn du ebenfalls eine unabhängige Website für Auslandsmärkte aufbaust, dich auf Content-Wachstum oder KI-Suche konzentrierst und diese Lösung besprechen oder mehr über die Implementierungsdetails des Systems erfahren möchtest, kannst du WeChat: dudulhc hinzufügen.
Dageno is the research and insights team at Dageno AI, publishing industry reports and expert analysis on AI Search Visibility, Generative Engine Optimization (GEO), and AI-powered search discovery.