Finden Sie heraus, wo Ihre Marke im KI-Markt steht.
Ermitteln Sie die Wachstumschancen, die es wert sind, priorisiert zu werden, und zwar anhand der Marktnachfrage, des Wettbewerbsumfelds, der Markenwertversprechen und der Zitationsquellen.
Wenn KI-Modelle auf dieselbe Frage gegensätzliche Markenempfehlungen geben: Wie sollte Ihr Team sie deuten und handeln?
Ein KI-Modell erwähnt eine Marke, ein anderes lässt sie aus. Ein Smartwatch-Fall zeigt, wie unterschiedliche Fragen einen scheinbaren Widerspruch erzeugen können und warum der nächste Schritt darin besteht, vergleichbare Antworten zu erweitern.
Wenn KI-Modelle auf dieselbe Frage scheinbar gegensätzliche Markenempfehlungen geben, prüfen Sie zuerst, ob sie tatsächlich dieselbe Frage beantwortet haben. Entscheiden Sie erst danach, ob Sie handeln. Keine Antwort in den Daten, eine Antwort ohne die Marke und zu wenige Antworten sind unterschiedliche Situationen. Untersuchen Sie Quellen und erwägen Sie eine Optimierung nur dann, wenn die Marke in vergleichbaren Antworten auf dieselbe Frage in derselben Region und demselben Beobachtungsrahmen wiederholt fehlt und Käufer dieses Modell nutzen.
Ein Smartwatch-Fall in Dageno zeigt, warum ein LLM coverage gap eine Prüfung verdient, aber noch keinen Widerspruch zwischen Modellen belegt. Die Antworten von Google AI Overview zu Kinder-Sicherheitsuhren in Australien erwähnten Apple nicht. Die Antworten von ChatGPT und Gemini, die Apple in derselben Region erwähnten, behandelten ihrem Inhalt nach Smartwatches allgemein. Die Entscheidung lautet: zuerst die Frage festlegen und die vergleichbare Stichprobe erweitern.
Für das Monitoring wird das Modell mit dem Fehlsignal zum Kernmodell, Modelle mit vorhandenen Antworten in derselben Region werden zu Vergleichsmodellen. Modelle, die in den erfassten Antworten nicht vorkamen, bleiben unter Beobachtung. Die Marke muss außerdem entscheiden, ob Kinder-Sicherheitsuhren zu ihrer Zielnachfrage gehören.
1. Unterscheiden Sie drei Arten von Fehlen: keine erfasste Antwort, keine Markenerwähnung und zu wenige Antworten
Keine erfasste Antwort: Prüfen Sie, ob es für dieses Segment einen Datensatz gibt
Nehmen Sie den Smartwatch-Markt im Dashboard als Beispiel. Unter den diesmal einzeln erfassten Antworten gab es für diese Sub-Intention in Australien keine Antwort von Google AI Mode oder Copilot. Die Research-Verantwortlichen sollten diese Zellen als „keine Antwort in diesem Datensatz“ markieren und nicht als „Apple fehlt bei diesen Modellen“. Diese Unterscheidung beeinflusst das Monitoring: Nur bei einem Modell mit Antwort lässt sich beurteilen, ob die Antwort die Marke erwähnt. Halten Sie die übrigen Modelle auf einer Beobachtungsliste, bis es Datensätze zu prüfen gibt.
Gehen Sie zu Issues & opportunities, öffnen Sie Opportunity overview und wählen Sie die Karte LLM coverage gap. Klicken Sie auf View analysis und dann auf View related AI responses. Die Schaltfläche zeigt 203, die Gesamtzahl der Antworten für die Sub-Intention; die geöffnete Liste enthält jedoch nur 9 Antworten, alles Google-AI-Overview-Antworten ohne Apple. Um alle 203 Antworten über Modelle und Regionen hinweg zu sehen, gehen Sie über Demand & insights → Search intents → Recommendations → See top recommendations → View AI responses. Lesen Sie bei der Prüfung Australiens die Modell- und Regionslabels oben in jeder Antwort.
Es gibt eine Antwort: Erwähnungen und Empfehlungen getrennt erfassen
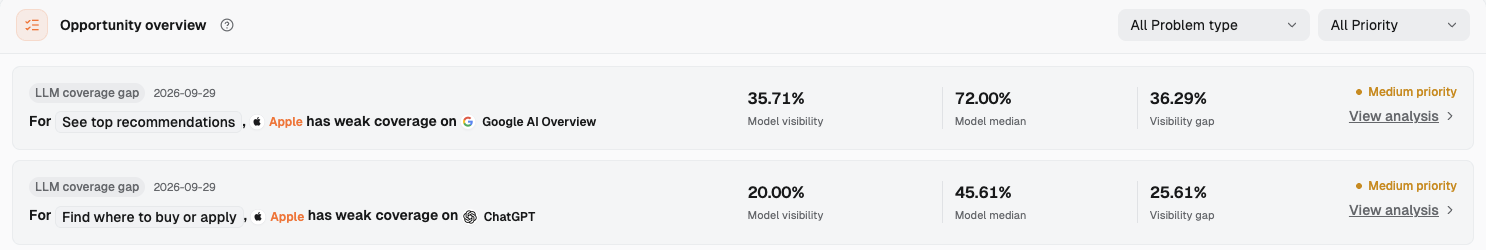
Die Karte zeigt Apples Model visibility bei Google AI Overview mit 35,71 %, einen Model median von 72,00 % und eine Visibility gap von 36,29 %, mit der Priorität Medium. Das sagt den Research-Verantwortlichen, wo sie die Belege prüfen sollten. Es sagt nicht, welche Fragen die Lücke erzeugt haben, und benennt keine Seite, die das Team ändern sollte.
LLM-coverage-gap-Karten im Opportunity overview: Für See top recommendations liegt Apples Model visibility bei Google AI Overview bei 35,71 %, der Model median bei 72,00 % und die Visibility gap bei 36,29 %, Priorität Medium. Die zweite Karte erfasst dieselbe Art von Lücke bei ChatGPT.
Nach der Einzelerfassung der 203 Antworten dieser Sub-Intention entfallen 14 auf Google AI Overview; 5 davon erwähnen Apple. Die über die Karte geöffnete Liste verwandter Antworten enthält genau die anderen 9, die nach Bedarf und Region sortiert werden müssen. Die Marke fehlt in einer Antwort beschreibt diese eine Antwort. Um zu sagen, dass die Marke bei Empfehlungen zu einer bestimmten Frage fehlt, müssen Sie außerdem wissen, ob die Antwort eine Kaufentscheidung behandelte, an der die Marke plausibel hätte teilnehmen können. Ein Zitat einer Markenseite ist eine separate Beobachtung und kann eine Empfehlung im Antworttext nicht ersetzen.
Lesen Sie in Evidence preview zuerst die Source answer und dann Related citation analysis. Erfassen Sie Modell und Region oben, den Markennamen in der Antwort und ob die Marke empfohlen, beiläufig erwähnt oder nur auf einer zitierten Seite genannt wurde. So bekommt das „Fehlen“ eine klare Analyseeinheit.
Zu wenige Antworten: Signal behalten und vergleichbare Antworten sammeln
Google AI Overview hat 4 Antworten zu Kinder-Sicherheitsuhren in Australien, und keine erwähnt Apple. Das ist ein Signal für einen bestimmten Bedarf. Die anderen Modelle haben in den aktuellen Daten jedoch keine passenden Antworten zu Kinderuhren in derselben Region, sodass dem Team auf beiden Seiten eine vergleichbare Stichprobe fehlt. Selbst mehrere Antworten eines Modells ersetzen keine Antworten auf dieselbe Frage, wenn die Fragen in der Gruppe unterschiedlich sind.
Die Research-Verantwortlichen können vorab festlegen, welche Fragen als Nächstes gesammelt werden, wie viele vollständige Antworten pro Modell aufbewahrt werden und wann sie geprüft werden. Die aktuellen Belege liefern keine allgemeingültige Zahl, ab der ein Team handeln sollte. Prüfen Sie zuerst, ob die Antworten dieselbe Frage in derselben Region behandeln, und dann, ob das Fehlen in neuen Antworten anhält.
2. Prüfen Sie, ob sich der Widerspruch wiederholt: Wie viele Antworten hat jedes Modell für denselben Bedarf und dieselbe Region?
Legen Sie die Vergleichseinheit fest, bevor Sie Antworten pro Modell zählen
Die Marktansicht gruppiert Antworten nach Sub-Intention, was hilft, Auffälligkeiten bei einer Bedarfsart zu erkennen. Um Markenempfehlungen zu vergleichen, halten Sie zusätzlich Region, Sprache und die Frage selbst konstant. „Eine Smartwatch für Nutzer eines bestimmten Smartphones auswählen“ und „eine Sicherheitsuhr mit Ortung für ein Kind auswählen“ können beide unter Recommendations stehen, doch die Anforderungen der Käufer unterscheiden sich. Würde man sie zusammenlegen, könnte ein Unterschied zwischen Fragen wie ein Unterschied zwischen Modellen aussehen.
Erfassen Sie für jede vollständige Antwort Modell, Region, die Frage, die sie zu beantworten scheint, ob sie die Marke erwähnt und ob sie die Marke klar empfiehlt. Geben Sie die Antwortzahl jedes Modells getrennt an. Die Gesamtzahl der Liste ist für kein Modell der Nenner. Die Liste hat keinen Modellfilter, daher muss eine Person die Labels oben in den Antworten einzeln prüfen und erfassen. Zählen Sie jede Antwort nur einmal, auch wenn sie erneut geöffnet wird.
Fallbeispiel: Was in der markierten Modelllücke steckt
Die Karte LLM coverage gap markiert Google AI Overview mit der Priorität Medium. Sie zeigt Apples 35,71 % unter dem Model median von 72,00 %, eine Lücke von 36,29 %. Öffnen Sie View analysis. Unter Where the problem occurs zeigt das Panel What the user is doing, Sub-intents und Observed result; öffnen Sie dann die verwandten Antworten. Die Karte zeigt, wo eine Untersuchung beginnen sollte. Ob dieser Hinweis eine Maßnahme erfordert, entscheiden die einzelnen Antworten.
Von den 14 Antworten von Google AI Overview erwähnen 5 Apple. Sortiert man die übrigen 9 nach Inhalt, ergeben sich vier Gruppen: 3 behandeln Garmin-Uhren in Belgien oder den Niederlanden, 1 behandelt Garett-Uhren in Polen, 1 erklärt in einem spanischsprachigen Kontext, was eine Sport-Smartwatch ist, und 4 behandeln Sicherheits- und Ortungsuhren für Kinder in Australien. Die markenspezifischen Antworten und die Definitionsantwort sind keine vergleichbaren offenen Kaufempfehlungen, bei denen Apple ausgelassen wurde. Die australische Gruppe zu Kinderuhren verdient einen genaueren Blick.
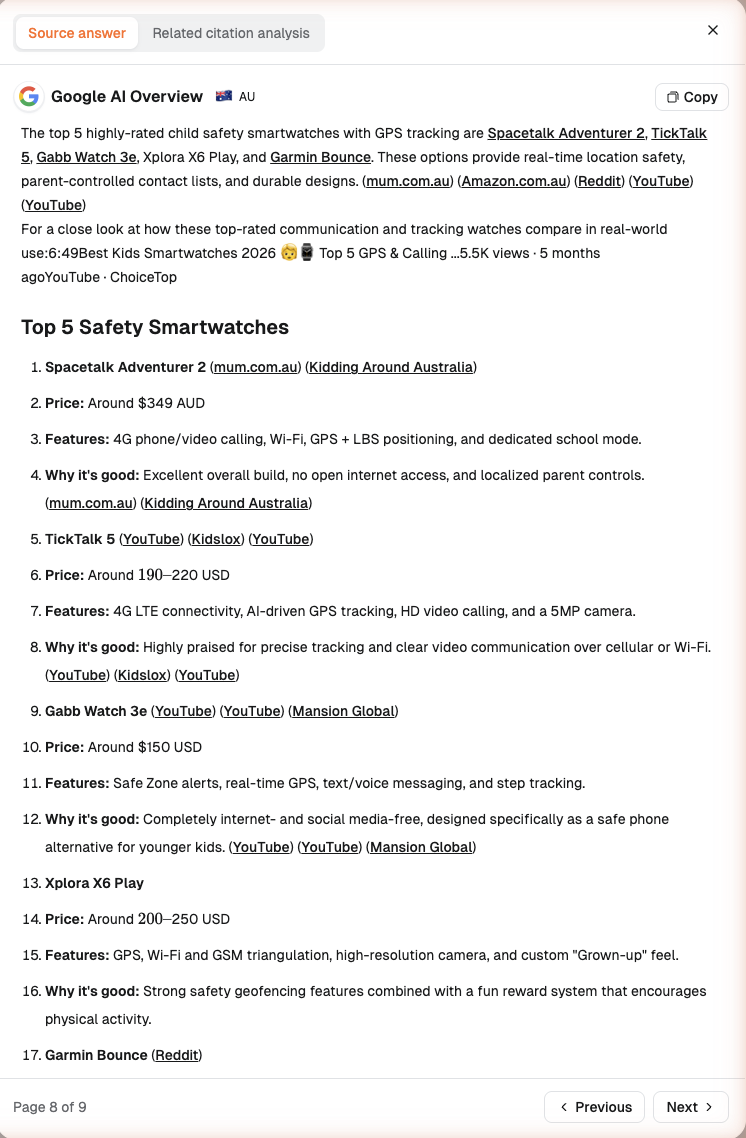
Eine Antwort beginnt so: "The top 5 highly-rated child safety smartwatches with GPS tracking are Spacetalk Adventurer 2, TickTalk 5, Gabb Watch 3e, Xplora X6 Play, and Garmin Bounce." (Die fünf am besten bewerteten Kinder-Sicherheits-Smartwatches mit GPS-Ortung sind Spacetalk Adventurer 2, TickTalk 5, Gabb Watch 3e, Xplora X6 Play und Garmin Bounce.) Eine andere beginnt so: "Top kids smartwatches feature real-time GPS tracking combined with 4G LTE calling, geofencing "safe zones," and SOS buttons." (Die besten Kinder-Smartwatches bieten GPS-Ortung in Echtzeit, kombiniert mit 4G-LTE-Telefonie, „Sicherheitszonen“ per Geofencing und SOS-Tasten.) Diese Originalzeilen zeigen den Bedarf, den die Antworten behandeln. Die darin genannten Marken sind Teil der zitierten Antworten.
Die Karte öffnet 9 verwandte Antworten. Dies ist die achte: eine Google-AI-Overview-Antwort aus Australien (AU), die Sicherheits- und Ortungsuhren für Kinder auflistet, ohne Apple zu erwähnen.
In derselben Sub-Intention und Region erwähnen alle 5 ChatGPT-Antworten und alle 3 Gemini-Antworten Apple. Ihrem Inhalt nach behandelt keine dieser 8 Antworten die Frage nach Kinder-Sicherheitsuhren. Die wenigen genau gelesenen Antworten behandeln Smartwatches allgemein oder Sportuhren. Eine ChatGPT-Antwort sagt: "If you're shopping for a smartwatch right now in 2026, these are the standouts. The biggest factor is your phone: Apple Watches are for iPhone …" (Wenn Sie jetzt im Jahr 2026 eine Smartwatch kaufen, sind das die herausragenden Modelle. Der wichtigste Faktor ist Ihr Smartphone: Apple Watches sind für das iPhone …) Sie behandelt die Kompatibilität mit dem Smartphone, nicht Kindersicherheit oder Ortung. Es handelt sich um unterschiedliche Fragen innerhalb einer Sub-Intention. Die aktuellen Daten enthalten keine Antwort eines anderen Modells auf dieselbe Kinderuhr-Frage, die Apple empfiehlt.
Die Karte bietet also einen Weg, Antworten zu finden, die eine Prüfung wert sind. Trennen Sie die nicht zusammengehörenden Fragen und entscheiden Sie dann, welche Stichprobe ergänzt werden soll. Hier fehlen Antworten verschiedener Modelle auf dieselbe Frage nach Kinder-Sicherheitsuhren in Australien. Eine Aufgabe zur Seitenänderung käme erst später.
3. Prompt, Modell, Region und Ausführungszeit festlegen: Was das Dashboard zeigt und was der Kunde liefern muss
Prompt: Eine Sub-Intention bezeichnet eine Art von Frage
Weder die Liste View related AI responses noch die Liste View AI responses hat einen Modellfilter, und Evidence preview zeigt den ursprünglichen Prompt nicht. Die Research-Verantwortlichen können anhand des Inhalts grob einschätzen, worum es in einer Antwort geht, den genauen Wortlaut jeder Frage aber nicht aus diesen Daten rekonstruieren. See top recommendations ist eine Sub-Intention, die Antworten zu allgemeinem Einkauf, zu bestimmten Marken und zu Kinder-Sicherheitsuhren enthält. Um einen echten Unterschied zwischen Modellen zu prüfen, sollte der Kunde genau die Frage, die er verfolgen will, in Monitored prompts anlegen und Antworten der ausgewählten Modelle sammeln.
Unter Monitoring settings zeigt die Liste Monitored prompts #, Prompt, Platforms, Regions, Answers, Brands, Details, Leading und Status. Dieser Fall nutzt Marktdaten statt Antworten, die der Kunde mit einer festen Frage überwacht hat, daher lässt sich der Wortlaut der Frage nicht Wort für Wort prüfen. Speichern Sie in der nächsten Monitoring-Runde den Prompt-Text und prüfen Sie die tatsächlich zurückgegebenen Antworten. Behandeln Sie diese Marktantworten nicht so, als wären sie bereits mit identischem Wortlaut ausgeführt worden.
Modell und Region: Prüfen Sie die Labels jeder Antwort
Jede Antwort zeigt oben ein Modell und eine Region, etwa Google AI Overview und AU. Gruppieren Sie die Antworten anhand dieser Labels und prüfen Sie dann, ob jedes Modell in der gewählten Region tatsächlich Datensätze hat. Platforms & regions unter Market overview hilft, den Rahmen einzugrenzen; die vollständigen Antworten darin bleiben die Grundlage der Beurteilung. Gleiche Regionslabels reichen nicht: Prüfen Sie Sprache und Antwortinhalt, bevor Sie Smartwatch-Antworten zusammenfassen.
Die vorhandenen australischen Daten setzen Google AI Overview, ChatGPT und Gemini auf dieselbe regionale Prüfliste. Eine modellübergreifende Zählung für eine feste Kinderuhr-Frage muss mit der nächsten Antwortrunde beginnen. Google AI Mode und Copilot kamen in den diesmal für diesen Rahmen erfassten Antworten nicht vor, beobachten Sie sie daher weiter. Die Marktforschungsverantwortlichen müssen anhand von Kundenbelegen bestätigen, welche Modelle Käufer nutzen und ob Australien ein Prioritätsmarkt ist.
Ausführungszeit: Neue Datensätze anlegen, ohne das Prüfdatum als Erfassungsdatum zu behandeln
Evidence preview zeigt keine Erfassungszeit. Die Antwortlisten zeigen weder den ursprünglichen Prompt noch die Erfassungszeit. Der Tag, an dem jemand eine Karte öffnet, ist das Prüfdatum, nicht das Datum, an dem die Antwort erzeugt wurde. Die aktuellen Daten belegen auch kein gemeinsames Erfassungsfenster für diese älteren Antworten. Beginnen Sie den nächsten Test mit neuen Antworten, die gespeichert werden können. Erfassen Sie in jeder Runde Frage, Modell, Region, Sprache und alle Zeitangaben, die das Team überprüfen kann. Ist die Erfassungszeit des Systems nicht verfügbar, notieren Sie „nicht angezeigt“.
Die Marke muss außerdem entscheiden, ob Kinder-Sicherheitsuhren zu den Menschen und Einsatzzwecken passen, die ihr Produkt bedient. Das Dashboard zeigt Antworten und Quellen; die Entscheidung, um diese Frage zu konkurrieren, liegt bei der Marke. Passt das Produkt nicht zu diesem Einsatzzweck, ist die coverage gap allein kein Grund, daraus ein Optimierungsziel zu machen.
4. Welche Quellen nutzte das Modell, das die Marke ausließ? Betrachten Sie nur Belege, die den Unterschied erklären können
Beginnen Sie mit den in den tatsächlichen Antworten zitierten Quellen
Die 4 australischen Google-AI-Overview-Antworten zu Kinder-Sicherheitsuhren zeigen 23, 24, 25 bzw. 19 zitierte Quellen. Ihre Zitatlisten enthalten häufig safewise.com, harveynorman.com.au, reddit.com, youtube.com, forbes.com, kidslox.com, mum.com.au und garmin.com. Keines der sichtbaren Zitate in diesen 4 Antworten verweist auf apple.com. Das sind Beobachtungen zu den Antworten und ihren Quellen; sie belegen nicht, dass das Fehlen einer Website dazu führte, dass die Marke ausgelassen wurde. Googles offizieller Leitfaden zu KI-Funktionen und Ihrer Website sagt, dass AI Overview relevante Links anzeigt, die Leser weiter erkunden können. Diese sichtbaren Links sind ein Ausgangspunkt für die Quellenprüfung.
Zwei Bereiche der Oberfläche sind hier wichtig. Related citation analysis in Evidence preview zeigt die Zitate einer einzelnen Antwort. In diesem Fall zeigt Sources used by the answers im Kartenpanel No data. Nutzen Sie beim Quellenvergleich die tatsächlich geöffneten Antworten und speichern Sie jede zitierte URL zusammen mit dem zugehörigen Antworttext. Zeigt das Panel No data, berichten Sie dieses Ergebnis so, wie es angezeigt wird.
Dasselbe Modell gab auch eine Antwort zu Kinderuhren in den Niederlanden, die die Apple Watch SE erwähnte: "Voor oudere jeugd (Middelbare school): Een instapmodel zoals de Apple Watch SE of reguliere Samsung Galaxy Watch." (Für ältere Kinder in der weiterführenden Schule kann ein Einstiegsmodell wie die Apple Watch SE oder eine normale Samsung Galaxy Watch infrage kommen.) Dieser Datensatz zeigt, dass selbst bei gleichem Modell die Region und die in der Antwort angesprochene Altersgruppe die genannten Optionen verändern können. Der niederländische Datensatz ist ein Vergleich zwischen Regionen innerhalb eines Modells. Der modellübergreifende Vergleich für Australien erfordert neue Antworten auf dieselbe Frage.
Wenn in der nächsten Runde verschiedene Modelle dieselbe australische Kinderuhr-Frage beantworten, vergleichen Sie die in jeder Antwort genannten Produkte und zitierten Seiten. Prüfen Sie, welche Seiten relevante Produkte auflisten, welche Auswahlkriterien beschreiben und welche Informationen die Antworten verwenden. Die vollständige Methode zum Vergleich von Antworten mit zitierten Seiten wird gesondert behandelt; hier beschränken sich die Quellendaten auf das, was dieses Fehlsignal direkt betrifft.
5. Entscheiden Sie, ob es ein Optimierungssignal ist oder ob zuerst die Stichprobe erweitert werden muss
Die Entscheidung in diesem Fall lautet: zuerst die Stichprobe erweitern. Die coverage gap der Karte verdient eine Untersuchung. Für die australischen Antworten zu Kinder-Sicherheitsuhren gibt es in den aktuellen Daten jedoch keine passenden Antworten anderer Modelle auf dieselbe Frage. Die Lücke zeigt dem Team, wo es suchen soll; der Antwortinhalt zeigt, ob die Antworten vergleichbar sind; und die Marke entscheidet, ob dieser Einsatzzweck in ihren Monitoring-Rahmen gehört.
Was Sie sehen
Aktuelle Schlussfolgerung
Nächste Maßnahme
Schlussfolgerung, die Sie noch nicht ziehen können
Die Karte LLM coverage gap zeigt 35,71 %, 72,00 % und 36,29 %
Die Antworten zur Prüfung öffnen
Frage, Modell und Region jeder verwandten Antwort prüfen
Es wurde eine Content-Lücke gefunden, die schon behoben werden sollte
Einige Antworten ohne Apple behandeln bestimmte Marken oder Definitionen
Es sind keine vergleichbaren offenen Kaufantworten
Aus dem Modellvergleich ausschließen; Originaldaten aufbewahren
Sie zeigen, dass Apple bei allgemeinen Empfehlungen fehlt
Alle 4 australischen Antworten zu Kinder-Sicherheitsuhren lassen Apple aus
Es gibt ein Signal für einen bestimmten Bedarf
Die Marke bestätigt die Produktpassung; dann die Frage festlegen und Antworten anderer Modelle sammeln
Es ist belegt, dass verschiedene Modelle auf dieselbe Frage gegensätzliche Markenempfehlungen geben
Vorhandene ChatGPT- und Gemini-Antworten in derselben Region erwähnen Apple, behandeln aber Smartwatches allgemein
Die Antworten behandeln unterschiedliche Fragen; zuerst die vergleichbare Stichprobe erweitern
ChatGPT und Gemini dieselbe Kinderuhr-Frage stellen wie Google AI Overview
ChatGPT oder Gemini werden Apple für Kinderuhren empfehlen
In den diesmal geprüften Daten gab es für diese Region keine Antwort von Google AI Mode oder Copilot
Für diese beiden Modelle gibt es noch keine Grundlage für ein Markenurteil
Auf der Beobachtungsliste halten; bei neuen Antworten einordnen
Apple fehlt bei diesen beiden Modellen
Sobald die ausgewählten Modelle genügend vergleichbare Antworten auf exakt dieselbe Frage geliefert haben, prüfen Sie, ob das Fehlen über spätere Beobachtungsfenster anhält. Wenn Käufer das Modell nutzen, in dem die Marke fehlt, die Marke bestätigt, dass ihr Produkt zur Frage passt, und Antworten sowie Zitate auf einen konkreten Informationsunterschied hinweisen, kann das Team erwägen, Fakten auf einer Seite zu ergänzen oder Dritten Material bereitzustellen. Wählen Sie jede Seitenänderung auf Grundlage überprüfbarer Informationen zu Bedarf und Quellen. Diese Daten haben ein solches Handlungsziel noch nicht ergeben.
6. Wählen Sie die zu überwachenden Modelle und den Umfang des erneuten Tests
Geben Sie Kern-, Vergleichs- und Beobachtungsmodellen unterschiedliche Aufgaben
Die Gruppen dienen der nächsten Entscheidung. Das Kernmodell trägt das konkrete Fehlsignal. Vergleichsmodelle beantworten exakt dieselbe Frage, damit das Team einen echten direkten Vergleich ziehen kann. Beobachtungsmodelle kamen in den aktuellen Daten nicht mit verwertbaren Antworten vor; ordnen Sie sie ein, sobald Antworten vorliegen. Der folgende Monitoring-Rahmen ist eine für diesen Fall vorgeschlagene Methode. Modellnamen und vorhandene Belege stammen aus dem Dashboard; Käufergewohnheiten, Beobachtungszeitraum und Verantwortliche muss der Kunde noch bestätigen.
Gruppe
Modell
Vorhandene Belege
Fester Rahmen und als Nächstes zu erfassendes Ergebnis
Kern
Google AI Overview
Die australischen Antworten zu Kinder-Sicherheitsuhren lassen Apple aus
Eine Frage zu Sicherheits- und Ortungsuhren für Kinder in AU festlegen; vollständige Antworten, Markenerwähnungen, klare Empfehlungen und zitierte Quellen speichern
Vergleich
ChatGPT, Gemini
Ihre Antworten zu Smartwatches allgemein in derselben Region erwähnen Apple; passende Antworten zu Kinderuhren gibt es nicht
Exakt dieselbe Frage und Region wie beim Kernmodell nutzen; den in jeder Antwort behandelten Einsatzzweck prüfen und dann Erwähnungen, Empfehlungen und Quellen erfassen
Beobachtung
Google AI Mode, Copilot
In den diesmal geprüften Daten gab es keine Antworten für diese australische Sub-Intention
Sobald Antworten für denselben Rahmen vorliegen, jede einzeln erfassen und entscheiden, ob das Modell zur Kern- oder Vergleichsgruppe gehört
Wäre das Ihre Marke, fragen Sie zuerst die Produkt- und Marktverantwortlichen, ob Sicherheits- und Ortungsuhren für Kinder zu den vorgesehenen Nutzern des Produkts passen und welche Modelle Käufer tatsächlich nutzen. Nach der Bestätigung sollten die Marktforschungsverantwortlichen einen Prompt, eine Region und eine Sprache speichern und Beobachtungszeitraum, Testhäufigkeit, Verantwortliche und Abbruchbedingungen festlegen. Termine und Anzahl der Durchläufe bestimmt der Kunde. Legen Sie diese Regeln fest, bevor die neuen Antworten eintreffen, damit sich die Vergleichsregeln nicht nach Sichtung der Ergebnisse ändern.
Speichern Sie in jeder Runde die vollständigen Antworten und ihre Zitate. Erfassen Sie Prompt, Modell, Region, Sprache, ob die Marke erwähnt oder klar empfohlen wurde, und alle überprüfbaren Zeitangaben. Die Vergleichsgruppe prüft sowohl, ob es bei der Kinderuhr-Frage eine vergleichbare Empfehlung gibt, als auch, ob bestehende Empfehlungen in allgemeinen Kaufantworten verloren gehen. Wird eine Seite tatsächlich geändert, erfassen Sie, was sich wann geändert hat. Nutzen Sie für den nächsten Test neu gewonnene Antworten; das erneute Öffnen eines alten Datensatzes ist kein neues Ergebnis. Die Methode zur Überprüfung, ob sich KI-Empfehlungen verbessert haben, hilft bei der Planung späterer Zeitfenster und Datensätze.
7. Fazit
Die Marktforschungsverantwortlichen können dem Team jetzt eine klare Antwort geben: Das System hat eine coverage gap gefunden, die eine Prüfung wert ist. Nach der Trennung der Antworten ergab sich in Australien ein Fehlsignal für den Bedarf an Kinder-Sicherheitsuhren, während die vorhandenen modellübergreifenden Daten unterschiedliche Fragen behandelten. In dieser Runde sollte die Marke zuerst entscheiden, ob der Bedarf zu ihrem Produkt passt. Lassen Sie dann Kern- und Vergleichsmodelle dieselbe Frage beantworten und speichern Sie die neuen Antworten und Zitate. Entscheiden Sie über Investitionen in Content-Optimierung erst, nachdem Sie die Modellnutzung der Käufer, wiederholte Beobachtungen und die Quellenbelege bestätigt haben.
Verstehen Sie, wie Ihre Marke in der KI-Suche abschneidet
Lassen sich Modelle vergleichen, wenn sie unterschiedlich viele Antworten haben?
Sie können die Zahlen nebeneinander berichten, sollten aber zuerst sicherstellen, dass beide Antwortgruppen dieselbe Frage beantworten. Geben Sie die Antwortzahl jedes Modells an und erweitern Sie zuerst die Stichprobe auf der kleineren Seite. Werden Antworten auf unterschiedliche Fragen zusammengelegt, zeigt sich kein Modellunterschied, selbst wenn die Zahlen ähnlich aussehen.
Wie erfasst man eine Markenerwähnung, die keine Empfehlung ist?
Erfassen Sie sie als Erwähnung und bewahren Sie den umgebenden Text auf. Zählen Sie sie nur dann als Empfehlung, wenn die Antwort die Marke klar als Option für diesen Bedarf anbietet. Erfassen Sie ein Zitat einer Markenseite separat. Wenn Sie die drei auseinanderhalten, sehen Sie, ob eine spätere Veränderung im Antworttext oder in den Quellen auftritt.
Sollte man eine Seite sofort ändern, wenn die Marke auch in der nächsten Runde fehlt?
Prüfen Sie zuerst, ob die neuen Antworten dieselbe Frage, Region und Sprache verwendet haben. Bestätigen Sie dann, ob Käufer das Modell nutzen, ob die Marke zur Frage passt und was die neuen Antworten zitieren. Sind diese Bedingungen geklärt, kann das Team die genaue Seiteninformation oder das Material für Dritte auswählen und im selben Rahmen weiter testen.
Wie behält man den ursprünglichen Vergleich bei, wenn eine neue Region hinzukommt?
Geben Sie der neuen Region einen eigenen Ausgangsdatensatz und beobachten Sie die ursprüngliche Region weiter mit der vereinbarten Frage. Erfassen Sie in jeder Runde Region und Sprache. So kann das Team die Entwicklung innerhalb einer Region über die Zeit vergleichen und Unterschiede zwischen Regionen getrennt prüfen.
Wie wählt man die zu überwachenden Modelle aus, wenn man nicht weiß, welche Käufer nutzen?
Beginnen Sie mit der Prüfliste, die durch die aktuellen Belege gestützt wird. Lassen Sie die Marktforschungsverantwortlichen die Modellnutzung der Käufer über vorhandene Kundenforschung oder Interviews bestätigen. Entscheiden Sie dann, welche Modelle im Kern-Monitoring bleiben und welche als Vergleich oder zur Beobachtung dienen. Die Antwortzahlen im Dashboard messen nicht die Nutzung durch Käufer.
Dageno is the research and insights team at Dageno AI, publishing industry reports and expert analysis on AI Search Visibility, Generative Engine Optimization (GEO), and AI-powered search discovery.
 Alexa for Shopping