Identifique as oportunidades de crescimento que valem a pena priorizar, considerando a demanda do mercado, o cenário competitivo, as propostas de valor da marca e as fontes de citação.
Quando modelos de IA dão recomendações de marca opostas para a mesma pergunta, como a sua equipe deve interpretar e agir?
Um modelo de IA menciona uma marca e outro a deixa de fora. Um caso de smartwatches mostra como perguntas diferentes podem criar um conflito aparente e por que o próximo passo é ampliar as respostas comparáveis.
Quando modelos de IA parecem dar recomendações de marca opostas para a mesma pergunta, verifique primeiro se eles realmente responderam à mesma pergunta. Só depois decida se vai agir. Não haver resposta nos registros, haver uma resposta que omite a marca e haver poucas respostas são situações diferentes. Investigue as fontes e considere otimizar apenas quando a marca estiver repetidamente ausente de respostas comparáveis à mesma pergunta, na mesma região e no mesmo escopo de observação, e os compradores usarem esse modelo.
Um caso de smartwatches na Dageno mostra por que um LLM coverage gap merece análise, mas ainda não comprova um conflito entre modelos. As respostas do Google AI Overview sobre relógios de segurança infantil na Austrália não mencionaram a Apple. Pelo conteúdo, as respostas do ChatGPT e do Gemini que mencionaram a Apple na mesma região tratavam de smartwatches em geral. A decisão é fixar a pergunta e ampliar primeiro a amostra comparável.
No monitoramento, defina como modelo principal aquele que apresenta o sinal de ausência e como modelos de comparação os que já têm respostas na mesma região. Mantenha em observação os modelos que não apareceram nas respostas registradas. A marca também precisa decidir se relógios de segurança infantil fazem parte da demanda que ela quer atender.
1. Diferencie três tipos de ausência: nenhuma resposta registrada, nenhuma menção à marca e respostas de menos
Nenhuma resposta registrada: verifique se há registro neste segmento
Tome como exemplo o mercado de smartwatches no painel. Entre as respostas registradas individualmente desta vez, não apareceu nenhuma resposta do Google AI Mode nem do Copilot para esta subintenção na Austrália. O responsável pela pesquisa deve marcar essas células como "sem resposta neste conjunto", e não como "a Apple está ausente desses modelos". Essa distinção afeta o monitoramento: só é possível avaliar se a resposta menciona a marca em um modelo que tem resposta. Mantenha os demais em uma lista de observação até que haja registros para analisar.
Acesse Issues & opportunities, abra Opportunity overview e selecione o card LLM coverage gap. Clique em View analysis e depois em View related AI responses. O botão mostra 203, o total de respostas da subintenção; a lista que ele abre contém apenas 9 respostas, todas do Google AI Overview e sem menção à Apple. Para ver as 203 respostas de todos os modelos e regiões, siga Demand & insights → Search intents → Recommendations → See top recommendations → View AI responses. Ao verificar a Austrália, leia os rótulos de modelo e região no topo de cada resposta.
Existe resposta: registre menções e recomendações separadamente
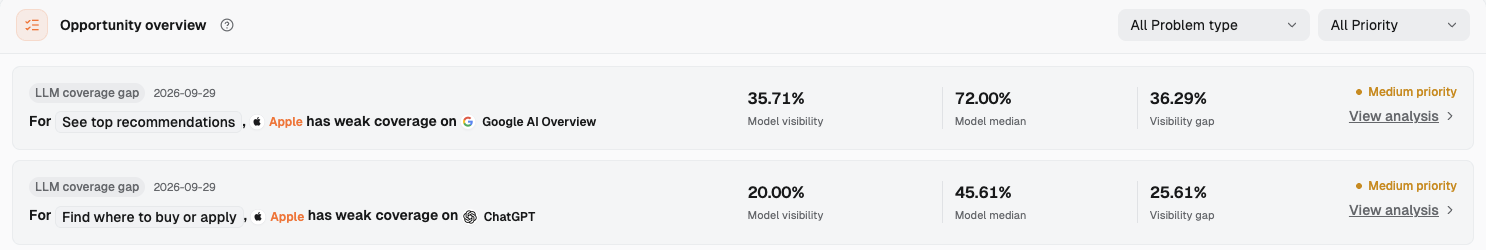
O card mostra a Model visibility da Apple no Google AI Overview em 35,71%, uma Model median de 72,00% e um Visibility gap de 36,29%, com prioridade Medium. Isso indica ao responsável pela pesquisa onde examinar as evidências. Não diz quais perguntas geraram a diferença nem aponta uma página para a equipe alterar.
Cards LLM coverage gap no Opportunity overview: em See top recommendations, a Model visibility da Apple no Google AI Overview é de 35,71%, a Model median é de 72,00% e o Visibility gap é de 36,29%, com prioridade Medium. O segundo card registra o mesmo tipo de diferença no ChatGPT.
Depois de registrar uma a uma as 203 respostas desta subintenção, o Google AI Overview responde por 14; 5 mencionam a Apple. A lista de respostas relacionadas aberta pelo card contém exatamente as outras 9, que precisam ser separadas por necessidade e região. A marca não aparece em uma resposta descreve aquela resposta. Para dizer que a marca está ausente das recomendações para determinada pergunta, você também precisa saber se a resposta tratou de uma escolha de compra da qual a marca poderia razoavelmente participar. Uma citação a uma página da marca é uma observação separada e não substitui uma recomendação no texto da resposta.
No Evidence preview, leia o Source answer e depois o Related citation analysis. Registre o modelo e a região no topo, o nome da marca na resposta e se ela foi recomendada, citada de passagem ou apareceu apenas em uma página citada. Isso dá à "ausência" uma unidade de análise clara.
Respostas de menos: mantenha o sinal e reúna respostas comparáveis
O Google AI Overview tem 4 respostas sobre relógios de segurança infantil na Austrália, e nenhuma menciona a Apple. Isso é um sinal para uma necessidade específica. Os outros modelos, porém, não têm respostas correspondentes sobre relógios infantis na mesma região nos registros atuais, então a equipe não tem uma amostra comparável de nenhum dos lados. Mesmo várias respostas de um modelo não substituem respostas à mesma pergunta se as perguntas do grupo forem diferentes.
O responsável pela pesquisa pode combinar com antecedência quais perguntas coletar a seguir, quantas respostas completas manter por modelo e quando revisá-las. As evidências atuais não oferecem um número universal a partir do qual a equipe deva agir. Primeiro, verifique se as respostas tratam da mesma pergunta na mesma região; depois, veja se a ausência continua em novas respostas.
2. Verifique se o conflito se repete: quantas respostas cada modelo tem para a mesma necessidade e região?
Defina a unidade de comparação antes de contar respostas por modelo
A visão de mercado agrupa as respostas por subintenção, o que ajuda a revelar anomalias em um tipo de demanda. Para comparar recomendações de marca, mantenha fixos também a região, o idioma e a própria pergunta. "Escolher um smartwatch para quem usa determinado celular" e "escolher um relógio de segurança com localização para uma criança" podem estar ambos em Recommendations, mas os requisitos do comprador são diferentes. Juntá-los pode fazer uma diferença entre perguntas parecer uma diferença entre modelos.
Para cada resposta completa, registre o modelo, a região, a pergunta que ela parece responder, se menciona a marca e se a recomenda claramente. Informe a contagem de respostas de cada modelo separadamente. O total da lista não é o denominador de nenhum dos modelos. A lista não tem filtro por modelo, então uma pessoa precisa verificar e registrar os rótulos no topo das respostas uma a uma. Conte cada resposta apenas uma vez, mesmo que ela seja aberta de novo.
Estudo de caso: o que há dentro da diferença sinalizada entre modelos
O card LLM coverage gap marca o Google AI Overview com prioridade Medium. Ele mostra os 35,71% da Apple abaixo da Model median de 72,00%, uma diferença de 36,29%. Abra View analysis. Em Where the problem occurs, a gaveta mostra What the user is doing, Sub-intents e Observed result; depois, abra as respostas relacionadas. O card indica onde a investigação deve começar. São as respostas individuais que determinam se essa pista exige ação.
Das 14 respostas do Google AI Overview, 5 mencionam a Apple. Separando as outras 9 pelo conteúdo, surgem quatro grupos: 3 falam de relógios Garmin na Bélgica ou na Holanda, 1 fala de relógios Garett na Polônia, 1 explica o que é um smartwatch esportivo em um contexto em espanhol e 4 tratam de relógios de segurança e localização para crianças na Austrália. As respostas sobre marcas específicas e as de definição não são recomendações de compra abertas e comparáveis em que a Apple tenha sido omitida. O grupo australiano de relógios infantis merece uma análise mais atenta.
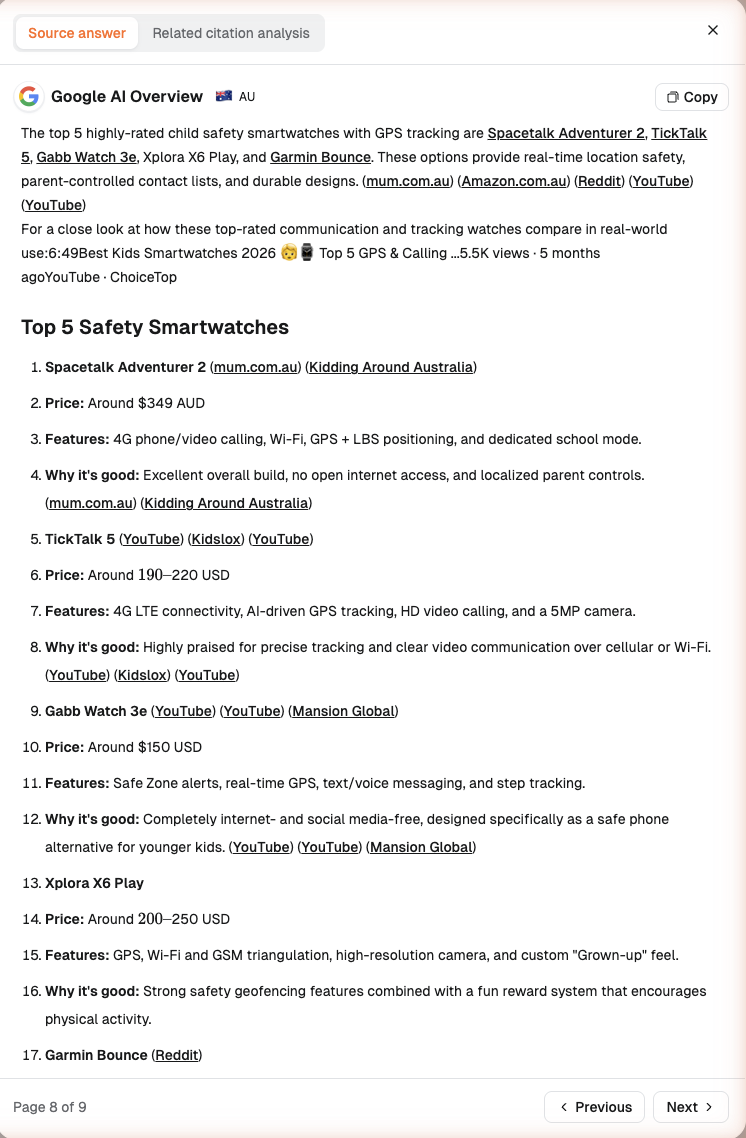
Uma resposta começa assim: "The top 5 highly-rated child safety smartwatches with GPS tracking are Spacetalk Adventurer 2, TickTalk 5, Gabb Watch 3e, Xplora X6 Play, and Garmin Bounce." (Os 5 smartwatches de segurança infantil com rastreamento por GPS mais bem avaliados são Spacetalk Adventurer 2, TickTalk 5, Gabb Watch 3e, Xplora X6 Play e Garmin Bounce.) Outra começa assim: "Top kids smartwatches feature real-time GPS tracking combined with 4G LTE calling, geofencing "safe zones," and SOS buttons." (Os principais smartwatches infantis oferecem rastreamento por GPS em tempo real com chamadas 4G LTE, "zonas seguras" por geofencing e botões de SOS.) Esses trechos originais mostram a necessidade que as respostas atendem. As marcas citadas neles fazem parte das respostas citadas.
O card abre 9 respostas relacionadas. Esta é a oitava: uma resposta do Google AI Overview da Austrália (AU) que lista relógios de segurança e localização para crianças sem mencionar a Apple.
Na mesma subintenção e região, todas as 5 respostas do ChatGPT e todas as 3 do Gemini mencionam a Apple. Pelo conteúdo, nenhuma dessas 8 respostas trata da pergunta sobre relógios de segurança infantil. As poucas lidas em detalhe falam de smartwatches em geral ou de relógios esportivos. Uma resposta do ChatGPT diz: "If you're shopping for a smartwatch right now in 2026, these are the standouts. The biggest factor is your phone: Apple Watches are for iPhone …" (Se você está comprando um smartwatch agora, em 2026, estes são os destaques. O fator mais importante é o seu celular: o Apple Watch é para iPhone…) Ela trata de compatibilidade com o celular, não de segurança infantil ou localização. São perguntas diferentes dentro de uma mesma subintenção. Os registros atuais não trazem uma resposta de outro modelo à mesma pergunta sobre relógios infantis que recomende a Apple.
O card, portanto, oferece um caminho para encontrar respostas que valem a pena verificar. Separe as perguntas que não têm relação e depois decida qual amostra acrescentar. Aqui, a amostra que falta são respostas de modelos diferentes à mesma pergunta sobre relógios de segurança infantil na Austrália. Uma tarefa de alteração de página viria depois.
3. Fixe prompt, modelo, região e momento de execução: o que o painel mostra e o que o cliente precisa fornecer
Prompt: uma subintenção identifica um tipo de pergunta
Nem a lista View related AI responses nem a lista View AI responses têm filtro por modelo, e o Evidence preview não mostra o prompt original. O responsável pela pesquisa consegue julgar, pelo conteúdo, mais ou menos do que a resposta trata, mas não consegue reconstruir a redação exata de cada pergunta a partir desses registros. See top recommendations é uma subintenção que reúne respostas sobre compras em geral, marcas específicas e relógios de segurança infantil. Para testar uma diferença real entre modelos, o cliente deve colocar no Monitored prompts a mesma pergunta que quer acompanhar e coletar respostas dos modelos escolhidos.
Em Monitoring settings, a lista Monitored prompts mostra #, Prompt, Platforms, Regions, Answers, Brands, Details, Leading e Status. Este caso usa dados de mercado, e não respostas monitoradas pelo cliente com uma pergunta fixa, então não é possível conferir a redação da pergunta palavra por palavra. Na próxima rodada de monitoramento, salve o texto do prompt e verifique as respostas realmente retornadas. Não trate essas respostas de mercado como se já tivessem sido executadas com a mesma redação.
Modelo e região: confira os rótulos de cada resposta
Cada resposta mostra no topo um modelo e uma região, como Google AI Overview e AU. Use esses rótulos para agrupar as respostas e depois verifique se cada modelo realmente tem registros na região escolhida. Platforms & regions, em Market overview, ajuda a localizar o escopo; as respostas completas dentro dele continuam sendo a base do julgamento. Rótulos de região iguais não bastam: confira o idioma e o conteúdo das respostas antes de agrupar respostas sobre smartwatches.
Os registros australianos existentes colocam o Google AI Overview, o ChatGPT e o Gemini na mesma lista de revisão regional. Uma contagem entre modelos para uma pergunta fixa sobre relógios infantis precisa começar na próxima rodada de respostas. O Google AI Mode e o Copilot não apareceram nas respostas registradas para este escopo desta vez, então mantenha-os em observação. O responsável pela pesquisa de mercado precisa confirmar, com evidências do cliente, quais modelos os compradores usam e se a Austrália é um mercado prioritário.
Momento de execução: crie novos registros sem tratar a data da revisão como data da coleta
O Evidence preview não mostra o horário da coleta. As listas de respostas não mostram nem o prompt original nem o horário da coleta. O dia em que o pesquisador abre um card é a data da revisão, não a data em que a resposta foi gerada. Os registros atuais também não estabelecem uma janela de coleta comum para essas respostas antigas. Comece o próximo reteste com respostas novas que possam ser salvas. Em cada rodada, registre a pergunta, o modelo, a região, o idioma e qualquer informação de tempo que a equipe consiga verificar. Se o horário de coleta do sistema não estiver disponível, registre "não exibido".
A marca também precisa decidir se relógios de segurança infantil se encaixam nas pessoas e nos usos que seu produto atende. O painel mostra respostas e fontes; a decisão de disputar essa pergunta é da marca. Se o produto não se encaixa nesse uso, o coverage gap sozinho não é motivo para torná-lo um alvo de otimização.
4. Que fontes usou o modelo que omitiu a marca? Olhe apenas para evidências que possam explicar a diferença
Comece pelas fontes citadas nas respostas reais
As 4 respostas australianas do Google AI Overview sobre relógios de segurança infantil mostram 23, 24, 25 e 19 fontes citadas, respectivamente. As listas de citações costumam incluir safewise.com, harveynorman.com.au, reddit.com, youtube.com, forbes.com, kidslox.com, mum.com.au e garmin.com. Nenhuma das citações visíveis nessas 4 respostas aponta para apple.com. Essas são observações sobre as respostas e suas fontes; elas não comprovam que a ausência de um site fez a marca ser omitida. O guia oficial do Google sobre recursos de IA e o seu site diz que o AI Overview exibe links relevantes para os leitores explorarem. Esses links visíveis são um ponto de partida para verificar as fontes.
Duas partes da interface importam aqui. O Related citation analysis, no Evidence preview, mostra as citações de uma resposta individual. Neste caso, Sources used by the answers, na gaveta do card, mostra No data. Ao comparar fontes, use as respostas que foram de fato abertas e salve cada URL citada junto com o texto da resposta correspondente. Se a gaveta mostrar No data, informe esse resultado como exibido.
O mesmo modelo também deu uma resposta sobre relógios infantis na Holanda que mencionava o Apple Watch SE: "Voor oudere jeugd (Middelbare school): Een instapmodel zoals de Apple Watch SE of reguliere Samsung Galaxy Watch." (Para crianças maiores, no ensino médio, um modelo de entrada como o Apple Watch SE ou um Samsung Galaxy Watch comum pode ser uma opção.) Esse registro mostra que, mesmo com o modelo fixo, a região e a faixa etária tratadas na resposta podem mudar as opções citadas. O registro holandês é uma comparação entre regiões dentro de um modelo. A comparação australiana entre modelos vai exigir novas respostas à mesma pergunta.
Se modelos diferentes responderem à mesma pergunta australiana sobre relógios infantis na próxima rodada, compare os produtos citados e as páginas referenciadas em cada resposta. Verifique quais páginas listam produtos relevantes, quais descrevem critérios de escolha e quais informações as respostas usam. O método completo para comparar respostas com páginas citadas é tratado separadamente; aqui, os registros de fontes se limitam ao que tem relação direta com este sinal de ausência.
5. Decida se vai tratar como sinal de otimização ou ampliar a amostra primeiro
A decisão neste caso é ampliar a amostra primeiro. O coverage gap do card merece investigação. As respostas australianas sobre relógios de segurança infantil, porém, não têm respostas correspondentes à mesma pergunta de outros modelos nos registros atuais. A diferença mostra à equipe onde olhar; o conteúdo das respostas mostra se elas podem ser comparadas; e a marca decide se esse uso entra no escopo do monitoramento.
O que você vê
Conclusão atual
Próxima ação
Conclusão que ainda não dá para tirar
O card LLM coverage gap mostra 35,71%, 72,00% e 36,29%
Abrir as respostas para análise
Verificar a pergunta, o modelo e a região de cada resposta relacionada
Foi encontrada uma lacuna de conteúdo que já deveria ser corrigida
Algumas respostas que omitem a Apple tratam de marcas específicas ou de definições
Não são respostas de compra abertas e comparáveis
Excluí-las da comparação entre modelos; manter os registros originais
Elas mostram que a Apple está ausente das recomendações gerais
As 4 respostas australianas sobre relógios de segurança infantil omitem a Apple
Há um sinal para uma necessidade específica
A marca confirma a adequação do produto; depois, fixar a pergunta e coletar respostas de outros modelos
Ficou demonstrado que modelos diferentes dão recomendações de marca opostas para a mesma pergunta
As respostas existentes do ChatGPT e do Gemini na mesma região mencionam a Apple, mas tratam de smartwatches em geral
As respostas tratam de perguntas diferentes; ampliar primeiro a amostra comparável
Fazer ao ChatGPT e ao Gemini a mesma pergunta sobre relógios infantis feita ao Google AI Overview
O ChatGPT ou o Gemini vão recomendar a Apple para relógios infantis
Nenhuma resposta do Google AI Mode ou do Copilot apareceu para esta região nos registros verificados desta vez
Ainda não há base para um julgamento sobre a marca nesses dois modelos
Mantê-los na lista de observação; classificá-los se surgirem novas respostas
A Apple está ausente desses dois modelos
Quando os modelos escolhidos tiverem produzido respostas comparáveis suficientes à mesma pergunta exata, verifique se a ausência persiste nas janelas de observação seguintes. Se os compradores usam o modelo em que a marca está ausente, se a marca confirma que o produto se encaixa na pergunta e se as respostas e citações apontam para uma diferença de informação específica, a equipe pode então considerar acrescentar fatos a uma página ou fornecer materiais a terceiros. Escolha qualquer mudança de página com base em informações verificáveis sobre a necessidade e as fontes. Esses registros ainda não identificaram esse tipo de alvo.
6. Escolha os modelos a monitorar e o escopo do reteste
Dê aos modelos principais, de comparação e de observação papéis diferentes
Os grupos servem à próxima decisão. O modelo principal carrega o sinal específico de ausência. Os modelos de comparação respondem exatamente à mesma pergunta para que a equipe possa fazer uma comparação real lado a lado. Os modelos de observação não apareceram com respostas utilizáveis nos registros atuais; classifique-os quando surgirem respostas. O escopo de monitoramento a seguir é um método proposto para este caso. Os nomes dos modelos e as evidências existentes vêm do painel; o cliente ainda precisa confirmar os hábitos dos compradores, o período de observação e o responsável.
Grupo
Modelo
Evidência existente
Escopo fixo e resultado a registrar em seguida
Principal
Google AI Overview
As respostas australianas sobre relógios de segurança infantil omitem a Apple
Fixar uma pergunta sobre relógios infantis de segurança e localização na AU; salvar as respostas completas, as menções à marca, as recomendações claras e as fontes citadas
Comparação
ChatGPT, Gemini
As respostas sobre smartwatches em geral na mesma região mencionam a Apple; não há respostas correspondentes sobre relógios infantis
Usar exatamente a mesma pergunta e região do modelo principal; verificar o uso tratado em cada resposta e depois registrar menções, recomendações e fontes
Observação
Google AI Mode, Copilot
Não apareceram respostas para esta subintenção australiana nos registros verificados desta vez
Quando surgirem respostas para o mesmo escopo, registrar cada uma e decidir se o modelo entra no grupo principal ou no de comparação
Se esta fosse a sua marca, pergunte primeiro aos responsáveis por produto e mercado se relógios infantis de segurança e localização se encaixam nos usuários pretendidos do produto e quais modelos os compradores realmente usam. Depois da confirmação, o responsável pela pesquisa de mercado deve salvar um prompt, uma região e um idioma e combinar o período de observação, a frequência dos retestes, o responsável e as condições de encerramento. As datas e o número de execuções cabem ao cliente. Defina essas regras antes de as novas respostas chegarem, para que as regras de comparação não mudem depois de ver os resultados.
Em cada rodada, salve as respostas completas e suas citações. Registre o prompt, o modelo, a região, o idioma, se a marca foi mencionada ou claramente recomendada e qualquer informação de tempo que possa ser verificada. O grupo de comparação verifica tanto se há uma recomendação comparável na pergunta sobre relógios infantis quanto se houve perda de recomendações existentes nas respostas de compra em geral. Se uma página for de fato alterada, registre o que mudou e quando. Use respostas recém-obtidas no próximo reteste; reabrir um registro antigo não é um resultado novo. O método para verificar se as recomendações de IA melhoraram pode ajudar a planejar as próximas janelas e registros.
7. Conclusão
Agora o responsável pela pesquisa de mercado pode dar à equipe uma resposta clara: o sistema encontrou um coverage gap que vale a pena verificar. Depois de separar as respostas, a Austrália revelou um sinal de ausência para uma necessidade de relógios de segurança infantil, enquanto os registros existentes entre modelos tratavam de perguntas diferentes. Nesta rodada, a marca deve decidir primeiro se essa necessidade se encaixa no seu produto. Depois, faça os modelos principal e de comparação responderem à mesma pergunta e salve as novas respostas e citações. Decida se vai investir em otimização de conteúdo depois de confirmar o uso dos modelos pelos compradores, as observações repetidas e as evidências das fontes.
Comece a entender o desempenho da sua marca na busca com IA
Dá para comparar os modelos quando eles têm números diferentes de respostas?
Você pode apresentar as contagens lado a lado, mas antes verifique se os dois conjuntos respondem à mesma pergunta. Informe a contagem de respostas de cada modelo e amplie primeiro a amostra do lado menor. Juntar respostas a perguntas diferentes não revela diferença entre modelos, mesmo que as contagens pareçam parecidas.
Como registrar uma menção à marca que não é uma recomendação?
Registre como menção e guarde o texto ao redor. Conte como recomendação apenas quando a resposta oferecer claramente a marca como opção para aquela necessidade. Registre separadamente uma citação a uma página da marca. Manter os três separados mostra se uma mudança posterior aparece no texto da resposta ou nas fontes.
Devemos alterar uma página imediatamente se a próxima rodada ainda omitir a marca?
Primeiro, confirme se as novas respostas usaram a mesma pergunta, região e idioma. Depois, confirme se os compradores usam o modelo, se a marca se encaixa na pergunta e o que as novas respostas citam. Com essas condições claras, a equipe pode escolher a informação exata da página ou o material de terceiros a trabalhar e continuar retestando no mesmo escopo.
Como manter a comparação original ao adicionar uma nova região?
Dê à nova região um registro inicial próprio e continue observando a região original com a pergunta combinada. Registre a região e o idioma em todas as rodadas. Assim, a equipe pode comparar a mudança ao longo do tempo dentro de uma região e analisar as diferenças entre regiões separadamente.
Como escolher os modelos a monitorar quando não se sabe quais os compradores usam?
Comece pela lista de revisão sustentada pelas evidências atuais. Peça ao responsável pela pesquisa de mercado que confirme o uso dos modelos pelos compradores com pesquisas ou entrevistas com clientes já existentes. Depois, decida quais modelos ficam no monitoramento principal e quais servem para comparação ou observação. As contagens de respostas do painel não medem o uso pelos compradores.
Dageno is the research and insights team at Dageno AI, publishing industry reports and expert analysis on AI Search Visibility, Generative Engine Optimization (GEO), and AI-powered search discovery.
 Alexa for Shopping