LLM에서 브랜드 감성을 추적하는 가장 좋은 방법은 의사결정 관련 프롬프트, 인용된 출처, 경쟁사 비교, 감성을 바꿀 수 있는 콘텐츠 공백 전반에서 AI 시스템이 브랜드를 어떻게 설명하는지 모니터링하는 것입니다.
12,000 이상의 틈새 시장을 탐색해 보세요.
업데이트한 사람
Nov 03, 2026에 업데이트됨
LLM 브랜드 감성 추적은 AI 시스템이 생성한 답변에서 브랜드의 평판, 신뢰성, 가격, 지원, 사용성 및 경쟁 우위를 어떻게 설명하는지 모니터링하는 과정입니다.
LLM 감성 추적은 기존 소셜 리스닝과 같지 않습니다. 기존 감성 분석 도구는 일반적으로 소셜 게시물, 리뷰, 언론 보도 및 설문 응답을 분석합니다. LLM 감성 추적은 사용자가 ChatGPT, Gemini, Perplexity, Copilot, Grok 또는 Google AI 기반 검색 환경에서 브랜드에 관해 질문했을 때 보게 되는 종합된 답변을 분석합니다.
효과적인 LLM 감성 추적 워크플로는 다음 다섯 가지 질문에 답해야 합니다.
LLM 감성은 단순한 평판 지표가 아니기 때문에 Dageno AI가 관련성을 갖습니다. Dageno AI GEO 플랫폼은 브랜드가 AI 검색 가시성을 모니터링하고, 콘텐츠 및 출처의 공백을 파악하며, GEO에 적합한 콘텐츠를 만들고, 개선 사항을 측정 가능한 결과와 연결하도록 지원합니다.
AI가 생성한 답변은 사용자가 웹사이트를 방문하거나, 공급업체를 비교하거나, 영업 담당자와 상담하기 전에 브랜드를 평가하는 데 점점 더 큰 영향을 미치기 때문에 LLM의 브랜드 감성이 중요합니다.
Google Search Central은 AI Overviews 및 AI Mode와 같은 AI 기능이 사용자의 질문 탐색과 웹 출처 연결을 지원할 수 있다고 설명합니다. 이는 브랜드 평판이 검색 환경 안에서 바로 요약될 수 있음을 의미합니다. Google Search Central – AI features and your website
OpenAI는 ChatGPT Search에서 인라인 인용 및 출처 패널을 표시할 수 있다고 설명합니다. 따라서 인용된 출처는 사용자가 신뢰를 형성하는 과정의 일부가 됩니다. OpenAI Help Center – ChatGPT Search
비즈니스에 미치는 영향은 브랜드 모니터링을 넘어섭니다. McKinsey는 생성형 AI가 분석 대상 사용 사례 전반에 걸쳐 연간 2조 6,000억~4조 4,000억 달러의 가치를 창출할 수 있다고 추산했으며, Stanford HAI의 AI Index는 비즈니스, 정책 및 사회 전반에서 생성형 AI가 빠르게 주류로 자리 잡는 현상을 추적합니다. McKinsey – The economic potential of generative AI Stanford HAI – AI Index Report
Dageno AI는 브랜드에 대시보드만으로는 부족하기 때문에 LLM 감성 추적을 GEO 실행과 연결합니다. 브랜드는 어떤 AI 프롬프트가 위험을 유발하는지, 어떤 출처가 브랜드 내러티브를 형성하는지, 어떤 페이지를 업데이트해야 하는지, 그리고 수정 사항이 가시성, 감성, 트래픽, 리드 또는 매출을 개선하는지 파악해야 합니다.
독창적인 인사이트:
가치가 가장 높은 LLM 감성 프롬프트는 검색량은 적더라도 영업에 미치는 영향은 큰 검색어인 경우가 많습니다. “Is [Brand] hard to implement?”와 같은 문구는 기존 키워드 수요가 제한적일 수 있지만, 부정적인 AI 답변 하나가 구매 여정 후반부의 구매자 반론을 강화할 수 있습니다.
LLM 브랜드 감성 추적은 AI 시스템이 사용자에게 제시하는 종합된 의견을 측정하는 반면, 기존 평판 모니터링은 그 의견에 영향을 미칠 수 있는 대중의 직접적인 반응을 측정합니다.
평판 관리팀은 이미 리뷰, 소셜 미디어 언급, Reddit 토론, 뉴스 보도, 고객 지원 불만 및 애널리스트 보고서를 모니터링하고 있을 수 있습니다. LLM 감성 추적은 AI 시스템이 여러 출처를 하나의 답변으로 압축한다는 점에서 새로운 계층을 더합니다. 이 답변은 근거가 되는 출처가 불완전하거나, 오래되었거나, 편향되어 있더라도 권위 있는 정보처럼 들릴 수 있습니다.
| 차원 | 기존 평판 모니터링 | LLM 브랜드 감성 추적 |
|---|---|---|
| 주요 데이터 출처 | 리뷰, 소셜 게시물, 뉴스, 포럼, 설문조사 | AI 생성 답변 및 인용된 출처 |
| 주요 질문 | “사람들은 무엇을 이야기하고 있는가?” | “AI는 사용자에게 브랜드에 관해 무엇을 알려주는가?” |
| 쿼리 유형 | 키워드, 언급, 해시태그 | 브랜드 평가 프롬프트 및 비교 프롬프트 |
| 결과 | 언급, 감성 레이블, 볼륨 추이 | AI 감성, 반복적으로 나타나는 주장, 인용, 경쟁사 프레이밍 |
| 위험 | 대중의 대화가 부정적인 인식을 확산 | AI가 의사 결정 순간에 부정적인 인식을 반복 |
| 최선의 조치 | PR 대응, 고객 지원 대응, 리뷰 관리 | GEO 콘텐츠 업데이트, 인용 출처 개선, 프롬프트 모니터링, 기여도 측정 |
| Dageno AI의 역할 | 브랜드 모니터링 보완 | AI 감성 신호를 전략, 콘텐츠 및 기여도 측정으로 연결 |
마케팅, SEO, PR, 제품 및 고객 성공 팀이 공동 워크플로를 필요로 할 때 Dageno AI의 가치가 가장 두드러집니다. GEO 콘텐츠 전략은 부정적인 감성 주제를 콘텐츠 브리프, 출처 업데이트, 제품 근거 자료 및 측정 가능한 후속 추적으로 전환할 수 있습니다.
효과적인 LLM 브랜드 감성 측정 프레임워크는 프롬프트 주제, 플랫폼, 지역, 출처, 경쟁사 및 비즈니스 영향을 기준으로 감성을 추적합니다.
전반적인 감성 점수 하나만으로는 충분하지 않습니다. LLM 감성은 사용 사례에 따라 달라질 수 있기 때문입니다. 한 브랜드가 엔터프라이즈 기능에서는 긍정적인 감성을 받고, 가격에서는 중립적인 감성을 받으며, 고객 지원에서는 부정적인 감성을 받을 수 있습니다. 실용적인 프레임워크는 개선 방법을 결정하기 전에 이러한 주제를 구분합니다.
다음 여섯 부분으로 구성된 프레임워크를 사용하세요.
감성 주제
가격, 사용 편의성, 지원, 신뢰성, 보안, 통합, 구현, 고용주 브랜드, 가성비 등 구매자가 평가하는 속성을 기준으로 프롬프트를 그룹화합니다.
프롬프트 유형
브랜드 프롬프트와 비브랜드 프롬프트를 구분합니다. 브랜드 프롬프트는 AI 시스템이 해당 브랜드를 설명하게 하고, 비브랜드 프롬프트는 추천 결과에 해당 브랜드가 등장하는지 확인합니다.
LLM 플랫폼
ChatGPT, Gemini, Perplexity, Copilot, Grok 및 Google AI 검색 기능을 비교합니다. 시스템마다 활용하는 출처와 검색 패턴이 다를 수 있기 때문입니다.
인용 출처
감성에 영향을 미치는 웹사이트, 리뷰 플랫폼, 기사, 문서 페이지, Reddit 스레드 및 비교 페이지를 파악합니다.
반복되는 주장
“비싸다”, “배우기 어렵다”, “고객 지원이 우수하다”, “통합 기능이 제한적이다”, “엔터프라이즈 팀이 신뢰한다”와 같이 반복해서 나타나는 문구를 기록합니다.
비즈니스 기여도
감성 개선을 AI 가시성, 인용된 페이지, 자연 검색 트래픽, 데모 요청, 영업 과정에서 제기되는 반론 및 고객 확보 신호의 변화와 연결합니다.
Dageno AI는 AI 플랫폼 전반의 가시성, 인용률, 점유율, 평균 순위 및 감성을 모니터링하여 이 프레임워크를 지원합니다. Dageno AI의 워크플로는 데이터 모니터링에서 전략, 콘텐츠 생성, 결과 기여도 측정으로 이어지도록 설계되었습니다.
실용적인 예시:
B2B SaaS 팀은 “가격”, “온보딩”, “보안”, “지원”을 별도의 감성 주제로 만들 수 있습니다. LLM이 지원이 느리다고 반복해서 설명하는 반면 고객 성공 데이터에서는 최근 지원 개선이 확인된다면, Dageno AI는 업데이트된 근거가 필요한 프롬프트와 인용 출처를 파악하도록 지원할 수 있습니다.
LLM 추적용 감성 프롬프트를 만드는 가장 좋은 방법은 구매자의 반론, 지원 문제, 리뷰 주제 및 제품 차별점을 직접적인 브랜드 관련 질문으로 바꾸는 것입니다.
감성 프롬프트는 구매자가 결정을 내리기 전에 실제로 물어볼 법한 질문처럼 들려야 합니다. 브랜드 감성 프롬프트는 광범위한 가시성 프롬프트와 다릅니다. 목표는 AI가 브랜드를 발견하는지 확인하는 것이 아니라, AI 시스템이 브랜드에 대해 어떻게 인식하는지 설명하게 하는 것입니다.
다음 프롬프트 구조를 사용하세요.
| 감성 주제 | LLM 감성 프롬프트 예시 | 프롬프트가 중요한 이유 |
|---|---|---|
| 신뢰 | “Can I trust [Brand]?” “Is [Brand] legitimate?” | 신뢰도 및 안전성에 대한 인식을 측정합니다 |
| 가격 | “Is [Brand] worth the price?” “Is [Brand] expensive?” | 가치와 경제성에 대한 프레이밍을 드러냅니다 |
| 지원 | “Does [Brand] have good customer support?” | 서비스 관련 반론을 파악합니다 |
| 사용 편의성 | “Is [Brand] easy to use?” “Is [Brand] hard to set up?” | 온보딩 및 사용성에 대한 인식을 보여줍니다 |
| 보안 | “Is [Brand] secure?” “Is [Brand] safe for enterprise use?” | 위험, 규정 준수 및 기술적 신뢰도를 확인합니다 |
| 비교 | “Is [Brand] better than [Competitor]?” | 경쟁 포지셔닝을 드러냅니다 |
| 적합한 사용자 | “Who should use [Brand]?” “Who is [Brand] best for?” | AI가 ICP를 이해하는지 보여줍니다 |
| 약점 | “What are the disadvantages of [Brand]?” | 반복적으로 나타나는 부정적인 주장을 드러냅니다 |
Dageno AI의 Free Prompt Miner는 브랜드 도메인, 타깃 지역, 언어 및 핵심 비즈니스 라인을 기준으로 가치가 높은 AI 검색 질문을 찾도록 지원할 수 있습니다. 프롬프트 탐색이 중요한 이유는 내부 마케팅 용어가 아니라 실제 구매자 의도를 반영할 때 LLM 감성 추적이 가장 효과적으로 작동하기 때문입니다.
독창적인 인사이트:
유용한 프롬프트 목록에는 “대중의 인식” 프롬프트와 “영업 반론” 프롬프트가 모두 포함되어야 합니다. 대중의 인식 프롬프트는 전반적인 평판을 드러내고, 영업 반론 프롬프트는 전환을 가로막는 구체적인 의문을 드러냅니다.
LLM 감성을 가장 신뢰도 높게 설명하려면 AI 시스템이 인용하거나 요약하거나 반복되는 주장의 근거로 삼는 것으로 보이는 출처를 살펴봐야 합니다.
LLM 감성은 우연히 형성되는 경우가 드뭅니다. 부정적이거나 긍정적인 표현은 대개 리뷰 플랫폼, 헬프 센터 페이지, 비교 기사, Reddit 스레드, 오래된 블로그 게시물, 타사 순위 페이지, 제품 문서, 언론 보도 또는 커뮤니티 토론 등 여러 출처의 패턴에서 비롯됩니다.
출처 분석 워크플로에서는 영향력 있는 출처를 다음과 같이 분류해야 합니다.
| 출처 유형 | 확인할 사항 | 권장 조치 |
|---|---|---|
| 자사 제품 페이지 | 현재 기능, 근거 자료 및 사용 사례를 명확히 설명하는가? | 미흡하거나 오래된 콘텐츠를 업데이트합니다 |
| 헬프 센터 페이지 | 지원 콘텐츠가 방어적이거나 불완전하게 들리는가? | 더 명확한 답변과 최근 개선 사항을 추가합니다 |
| 리뷰 플랫폼 | 리뷰가 진정성 있고, 최신이며, 대표성을 갖는가? | 실제 문제에 대응하고 스팸 패턴을 신고합니다 |
| 타사 기사 | 주장이 정확하고 최신 정보인가? | 근거를 제시해 수정을 요청합니다 |
| Reddit 및 포럼 | 반복되는 불만이 사실에 근거하거나, 오래되었거나, 오해에서 비롯된 것인가? | 주의 깊게 모니터링하고 진정성 있는 방식으로만 참여합니다 |
| 경쟁사 페이지 | 경쟁사가 브랜드보다 해당 카테고리를 더 잘 설명하고 있는가? | 더 효과적인 비교 및 포지셔닝 콘텐츠를 만듭니다 |
| 애널리스트 또는 조사 출처 | 권위 있는 출처에서 브랜드가 빠져 있는가? | 신뢰할 수 있는 제3자 검증 자료를 확보합니다 |
Ahrefs는 AI Overview 인용과 기존 자연 검색 순위가 겹칠 수 있다고 보고했습니다. 하지만 AI가 생성하는 검색 환경은 기존 파란색 링크 순위에서 사용자가 보는 것과 항상 같은 페이지를 인용하지 않기 때문에 AI 인용은 별도로 추적해야 합니다. Ahrefs – AI Overview citations and top 10 rankings
Dageno AI는 팀이 인용 출처, 경쟁사와의 출처 격차 및 프롬프트 수준의 가시성을 살펴보도록 지원하기 때문에 유용합니다. 무료 GEO 보고서를 통해 AI 검색에서 도메인이 어떻게 나타나는지, 콘텐츠 범위가 부족할 수 있는 부분은 어디인지 초기 현황을 파악할 수 있습니다.
실용적인 예시:
핀테크 브랜드는 회사가 새로운 규정 준수 인증을 획득한 뒤에도 LLM이 보안에 의문을 제기하는 오래된 기사를 인용한다는 사실을 발견할 수 있습니다. 해결책은 일반적인 사고 리더십 게시물을 발행하는 것이 아닙니다. 자사 보안 페이지를 업데이트하고, 출처 수정을 요청하며, 제3자 검증 자료를 추가하고, 보안 관련 프롬프트에서 AI 감성이 개선되는지 모니터링해야 합니다.
부정적이거나 부정확한 LLM 감성을 개선하는 가장 좋은 방법은 주장의 출처를 수정하고, 자사 근거 자료를 강화하며, 구조화된 반대 근거 콘텐츠를 발행하고, 시간이 지나면서 AI 답변이 바뀌는지 모니터링하는 것입니다.
LLM 감성 개선을 조작으로 여겨서는 안 됩니다. 지속 가능한 GEO 전략은 AI 시스템이 브랜드를 더 정확히 이해할 수 있도록 정보 생태계의 기반을 개선합니다.
다음 5단계 개선 프로세스를 활용하세요.
감성이 가장 약한 주제의 우선순위를 정합니다
가격, 지원, 보안 또는 신뢰성처럼 부정적 감성이 매출에 영향을 미치는 주제 하나를 선택합니다. 모든 주제를 한 번에 개선하려고 하지 마세요.
반복되는 부정적 주장을 파악합니다
LLM 답변에서 반복되는 표현을 추출합니다. 예를 들어 “통합 기능이 제한적이다”, “지원이 부실하다”, “소규모 팀에겐 비싸다”, “온보딩이 명확하지 않다” 등이 있습니다.
출처 경로를 찾습니다
주장을 뒷받침하는 것으로 보이는 인용, 링크된 페이지, 리뷰 사이트, 커뮤니티 스레드 및 자사 페이지를 검토합니다.
적절한 해결 방법을 선택합니다
오래된 타사 주장은 출처 수정으로, 미흡한 자사 페이지는 콘텐츠 업데이트로, 정당한 불만은 리뷰 대응으로, 실제 운영 문제는 제품 개선으로 해결합니다.
결과를 모니터링하고 기여도를 측정합니다
수정 후 감성, 가시성, 인용, 트래픽, 데모 요청 또는 영업 반론에 변화가 있는지 추적합니다.
Dageno AI는 감성 감지를 AI 검색 브랜드 위기 관리, 콘텐츠 전략, 출처 격차 분석 및 결과 기여도 측정과 연결해 이 프로세스를 지원합니다.
독창적인 인사이트:
LLM 감성을 개선하는 가장 신뢰도 높은 방법은 실제 제품과 콘텐츠 근거를 일치시키는 것입니다. 고객 지원이 실제로 개선되었다면 지원 응답 지표, 헬프 센터 업데이트, 고객 인용문 및 사례 연구를 공개하여 AI 시스템이 오래된 불만을 반복하는 대신 최신 근거를 찾을 수 있게 하세요.
Dageno AI는 AI 답변 모니터링을 감성 분석, 인용 분석, GEO 콘텐츠 전략 및 측정 가능한 기여도와 연결하여 브랜드가 LLM 감성을 추적하고 개선하도록 지원합니다.
Dageno AI는 데이터 모니터링 → 전략 → 콘텐츠 생성 → 결과 기여도 측정으로 이어지는 워크플로를 제공합니다. LLM 감성 추적은 부정적인 각 주제를 AI 답변 형성에 영향을 미친 프롬프트, 출처, 경쟁사 및 콘텐츠 조치와 연결할 때 비로소 유용해집니다.
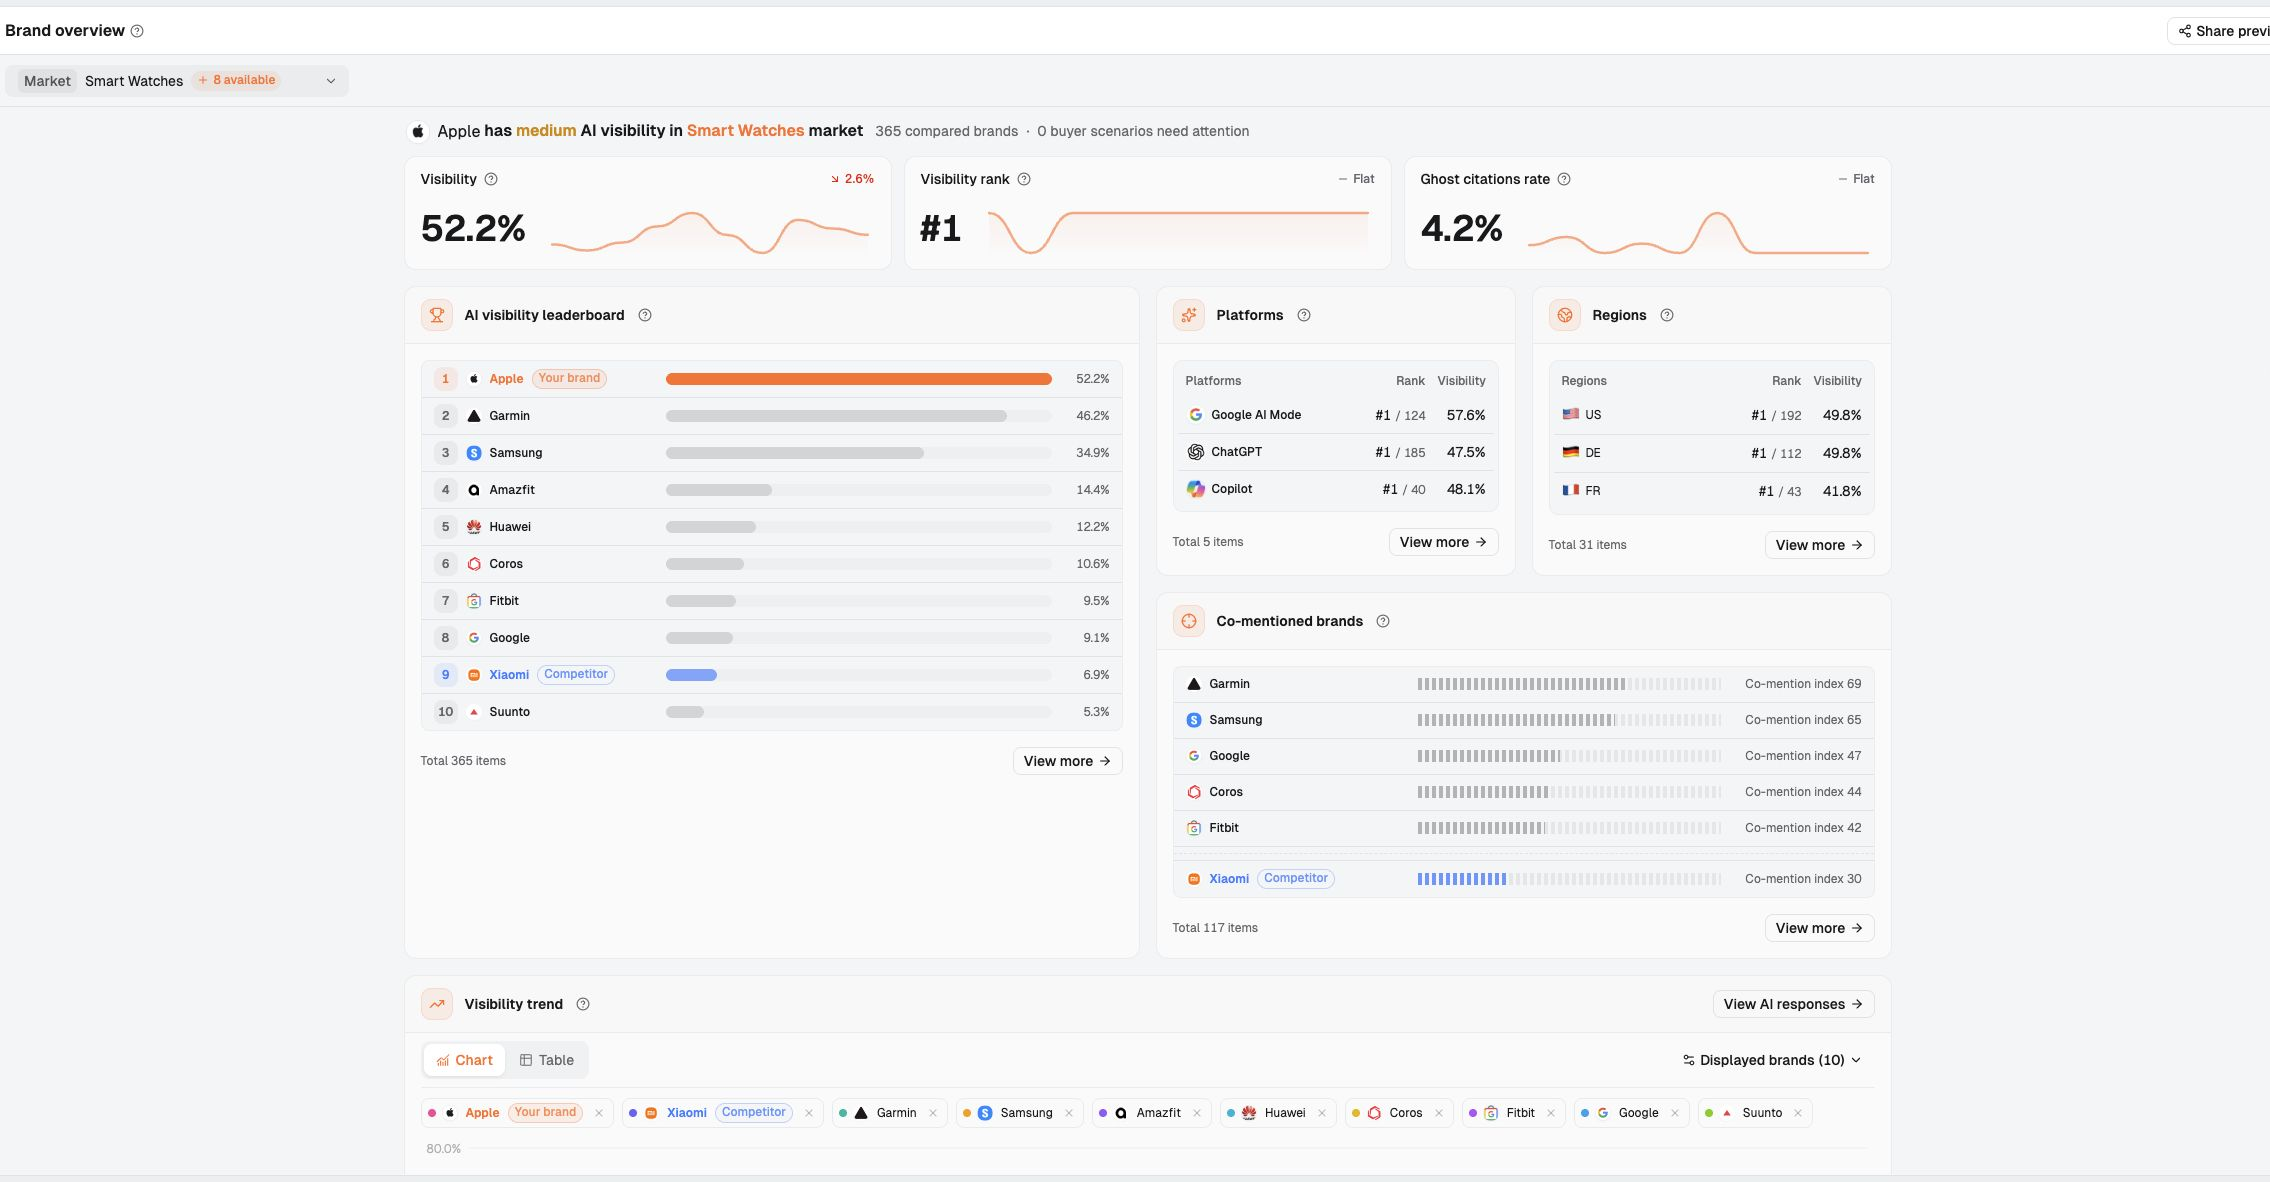
Dageno AI의 Overview 모듈은 가시성, 인용, 점유율 및 감성이라는 네 가지 핵심 AI 검색 평판 지표를 모니터링하도록 지원합니다. 이 화면에서 브랜드는 LLM이 브랜드를 언급하는지뿐만 아니라 AI 시스템이 브랜드를 긍정적, 중립적 또는 부정적으로 설명하는지도 파악할 수 있습니다.
Dageno AI의 Sentiment 모듈은 AI 언급 전반에서 감성 분포와 추세 변화를 보여주기 때문에 LLM 브랜드 감성 추적에 특히 유용합니다. 마케팅 또는 평판 관리팀은 이 화면을 활용해 AI 시스템이 브랜드 강점을 강화하는지, 아니면 지원, 가격, 안전성, 규정 준수 또는 제품 신뢰성에 관한 부정적인 신호를 확대하는지 파악할 수 있습니다.
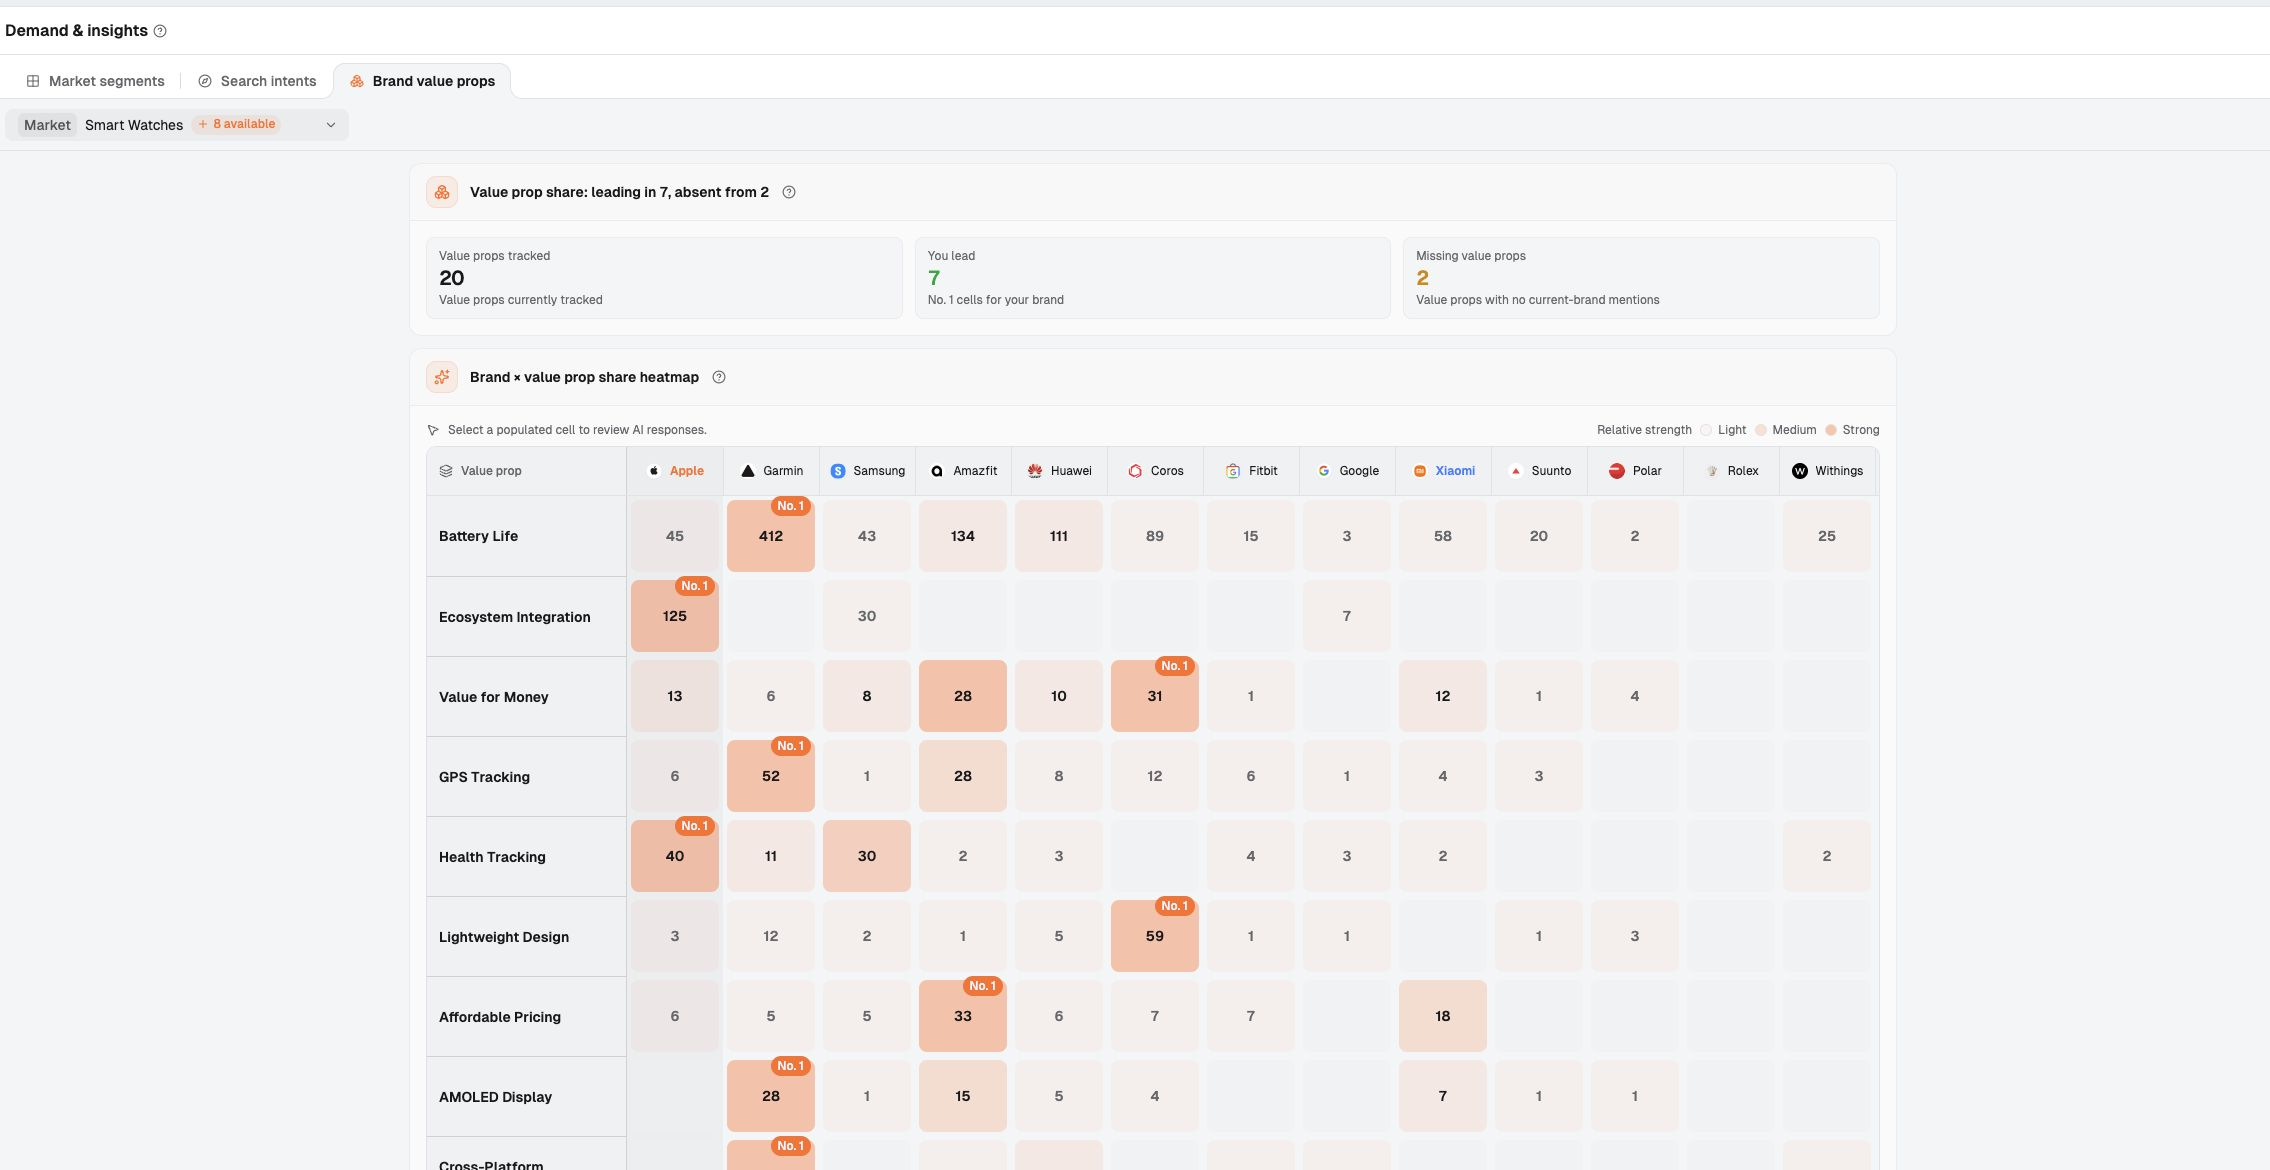
Dageno AI의 Citations 모듈은 팀이 LLM이 특정 브랜드 인식을 형성하는 이유를 이해하도록 지원합니다. AI 시스템이 오래된 리뷰, 경쟁사 비교 페이지 또는 신뢰도가 낮은 타사 출처를 반복적으로 인용한다면, 브랜드는 자사 콘텐츠 업데이트, 출처 수정, PR 지원 및 GEO에 적합한 근거 자료를 우선적으로 진행할 수 있습니다.
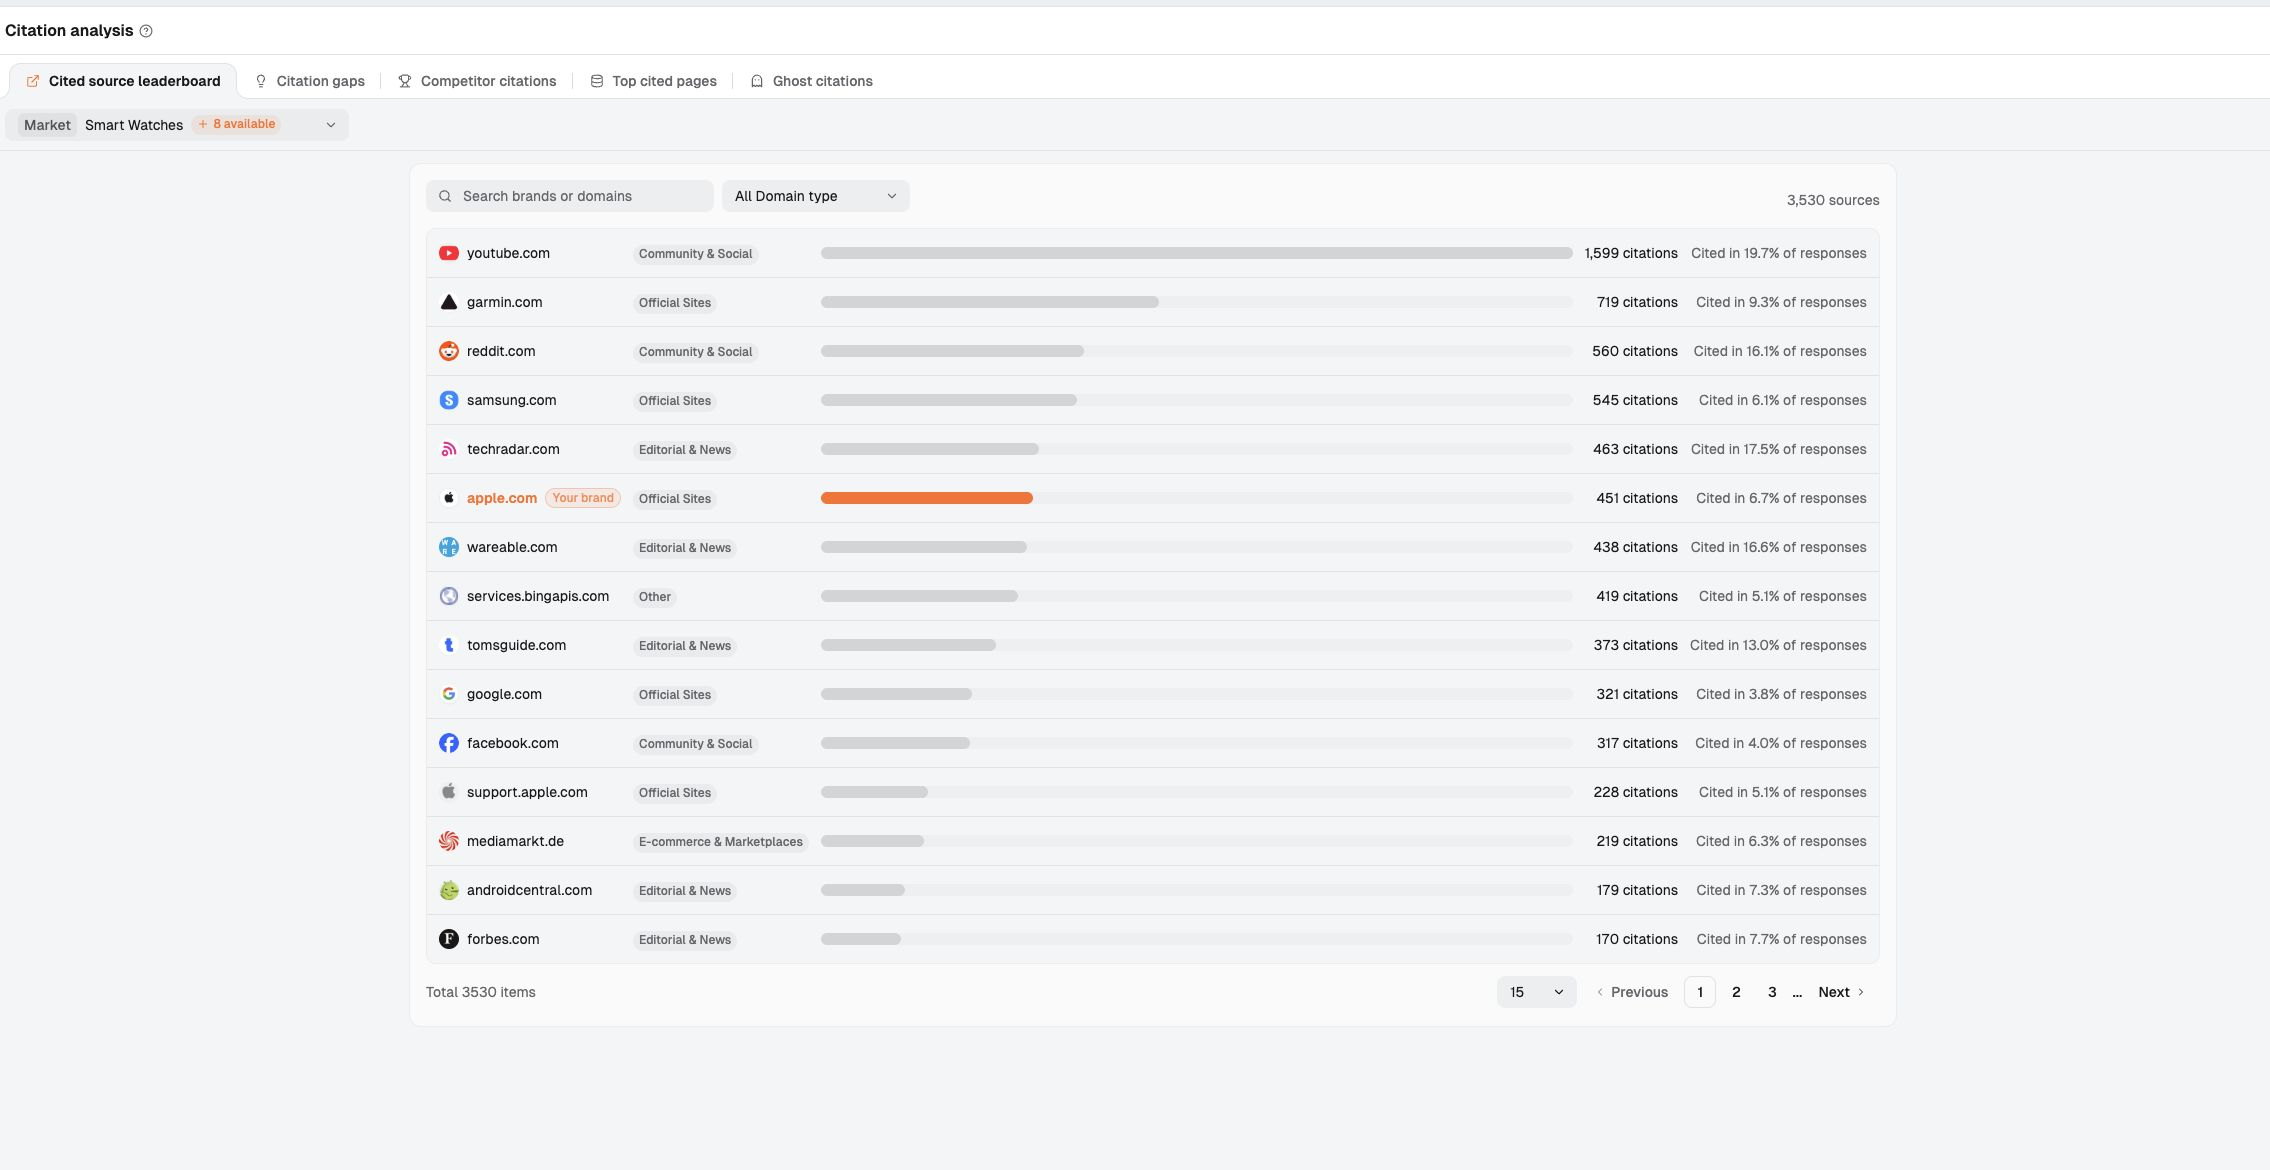
데이터 모니터링:
Dageno AI는 AI 검색 플랫폼 전반의 AI 가시성, 감성, 인용률, 점유율, 프롬프트 수준 성과 및 경쟁사 존재 여부를 모니터링합니다. 모니터링을 통해 AI 시스템이 브랜드를 언급하는지, 그리고 브랜드를 어떻게 설명하는지 확인할 수 있습니다.
전략:
Dageno AI는 AI가 생성하는 브랜드 인식에 영향을 미치는 감성이 약한 주제, 출처 격차, 프롬프트 기회 및 경쟁사 내러티브를 파악합니다. 이를 통해 브랜드가 나타나지 않거나, 부정적으로 묘사되거나, 경쟁사가 우위를 점해 비즈니스 위험이 발생하는 프롬프트를 우선적으로 다룰 수 있습니다.
콘텐츠 생성:
Dageno AI는 AI 검색 인사이트를 FAQ 섹션, 비교 페이지, 사용 사례 페이지, 보안 페이지, 가격 설명 콘텐츠, 지원 업데이트 및 근거 기반 콘텐츠 클러스터와 같은 GEO에 적합한 콘텐츠로 전환하도록 지원합니다. Single Page Audit을 통해 팀은 페이지가 명확하고 구조화되어 있으며 AI가 이해하기 쉬운지 검토할 수 있습니다.
결과 기여도 측정:
Dageno AI는 팀이 감성과 가시성 개선을 인용 변화, 프롬프트 성과, 콘텐츠 커버리지, 트래픽, 리드, 영업 대화와 같은 후속 지표와 연결하도록 지원합니다. LLMs.txt Generator는 중요한 페이지에 대한 AI가 읽을 수 있는 사이트 가이드를 제공하는 데도 도움이 됩니다.
웹사이트의 GEO 보고서를 받아보세요!
지금 시작하고 무료로 받아보세요!>가장 중요한 LLM 감성 추적 지표는 감성 점수, 인용 영향력, 반복적으로 등장하는 주장, 플랫폼별 차이, 경쟁사 프레이밍, 비즈니스 성과 기여도입니다.
유용한 대시보드는 감성이 긍정적인지 부정적인지만 알려줘서는 안 됩니다. 감성이 왜 변했는지, 다음에 어떤 조치를 취해야 하는지 설명해야 합니다.
| 지표 | 지표의 의미 | 지표가 중요한 이유 | Dageno AI 워크플로와의 연계 |
|---|---|---|---|
| 감성 점수 | 프롬프트 전반에 걸친 긍정적, 중립적 또는 부정적 어조 | AI가 브랜드를 어떻게 설명하는지 보여줌 | 프롬프트 주제별로 평판을 추적 |
| 인용 영향력 | AI 시스템이 반복적으로 사용하거나 인용하는 출처 | AI가 왜 그렇게 말하는지 설명 | 자사 및 타사 출처의 격차를 파악 |
| 반복적으로 등장하는 주장 | 브랜드에 대해 반복되는 표현 | 사용자가 접하는 서사를 파악 | 반복되는 주장을 콘텐츠 과제로 전환 |
| 플랫폼별 차이 | ChatGPT, Gemini, Perplexity 및 기타 시스템 간 감성 차이 | 주의를 기울여야 할 AI 플랫폼을 보여줌 | 플랫폼별 GEO 작업의 우선순위를 정함 |
| 경쟁사 프레이밍 | AI가 브랜드를 대안과 어떻게 비교하는지 | 포지셔닝 격차를 파악 | 비교 콘텐츠 및 서사 전략 지원 |
| 주제 또는 프롬프트 격차 | 가치가 높은 프롬프트에서 감성이 좋지 않거나 브랜드가 언급되지 않는 경우 | 감성이 수요에 영향을 미치는 지점을 보여줌 | 프롬프트 기반 콘텐츠 기획에 반영 |
| 성과 기여도 | 가시성, 트래픽, 리드 및 매출 신호의 변화 | GEO 작업을 비즈니스 가치와 연결 | 최적화가 성과를 바꿨는지 측정 |
Dageno AI는 감성 추적을 일상적인 운영 리듬으로 정착시키려는 팀을 위해 설계되었습니다. 이 플랫폼은 마케팅, SEO, PR, 제품 및 고객 성공 팀이 일화적인 브랜드 인식에 대해 논쟁하는 대신 동일한 프롬프트 수준의 근거를 바탕으로 협업하도록 지원합니다.
LLM 감성 인사이트를 GEO 콘텐츠 전략으로 전환하는 가장 좋은 방법은 감성이 약한 주제를 답변 우선 페이지, 근거 자료, 비교 콘텐츠 및 출처 구축 작업으로 전환하는 것입니다.
LLM 감성은 대개 근거 생태계가 바뀔 때 달라집니다. AI 시스템이 브랜드를 정확히 요약할 수 있도록 브랜드는 명확하고 최신이며 일관된 정보를 충분히 제공해야 합니다.
다음 콘텐츠 매핑 모델을 활용하세요.
| 감성이 약한 주제 | 제작하거나 업데이트할 콘텐츠 자산 | 포함할 근거 |
|---|---|---|
| 가격 관련 우려 | 가격 설명 페이지, ROI 페이지, 요금제 비교 | 비용 내역, 가치 사례, 구매자 시나리오 |
| 지원 관련 우려 | 지원 정책 페이지, 고객 성공 사례 연구 | 지원 채널, 지원 시간, 고객 인용문 |
| 보안 관련 우려 | 보안 페이지, 규정 준수 FAQ, 신뢰 센터 | 인증, 감사, 암호화 관행 |
| 사용 편의성 관련 우려 | 온보딩 가이드, 구현 일정, 제품 안내 | 설정 단계, 템플릿, 교육 리소스 |
| 안정성 관련 우려 | 상태 페이지, 가동 시간 설명, 사고 대응 정책 | 과거 안정성 신호 및 프로세스 투명성 |
| 경쟁사 비교 | 대안 페이지, 비교 페이지, 카테고리 가이드 | 기능 차이, 이상적인 고객 프로필, 한계 |
Google의 생성형 AI 기능 관련 가이드는 유용하고 신뢰할 수 있으며 사람을 우선하는 콘텐츠와 탄탄한 기술 기반을 강조합니다. Google Search Central – 생성형 AI 기능 최적화
Dageno AI의 AI 검색 최적화 워크플로가 중요한 이유는 LLM 감성을 개선하려면 제품 페이지, 블로그 게시물, 사례 연구, FAQ, 리뷰 및 타사 출처 전반에 일관된 서사가 필요하기 때문입니다.
실용적인 예:
“설정하기 어렵다”는 부정적 감성이 있는 소프트웨어 회사는 설정 가이드, 온보딩 체크리스트, 가치 실현 시간 페이지, 고객 구현 사례, 그리고 “[Brand]를 구현하는 데 얼마나 걸리나요?”라는 질문에 답하는 FAQ 섹션을 게시할 수 있습니다. 이후 Dageno AI는 LLM이 기존의 불편함에 대한 서사를 새로운 구현 관련 서사로 대체하기 시작하는지 모니터링할 수 있습니다.
LLM 감성 개선 과제의 우선순위를 정하는 가장 좋은 방법은 각 부정적 감성 주제를 프롬프트 의도, 전환 위험, 인용 취약성, 경쟁사 우위 및 수정 용이성을 기준으로 순위를 매기는 것입니다.
모든 부정적인 AI 답변에 똑같이 대응할 필요는 없습니다. 의도가 낮은 프롬프트에서 모호하게 부정적으로 언급되는 것보다 “기업 팀에 [Brand]가 [Competitor]보다 나은가요?”와 같이 구매 의도가 높은 비교 프롬프트에서 중립적이거나 부정적인 답변이 나오는 것이 더 중요할 수 있습니다.
다음 우선순위 평가표를 활용하세요.
| 우선순위 신호 | 우선순위가 높은 예시 | 신호가 중요한 이유 |
|---|---|---|
| 구매 의도 | “[Brand]는 그만한 가치가 있나요?” | 구매 확신에 영향을 줌 |
| 매출 관련성 | “기업 보안에 [Brand]가 적합한가요?” | 가치가 높은 거래에 영향을 줌 |
| 경쟁사 대체 가능성 | “[Competitor]의 최선의 대안”에서 브랜드가 제외됨 | 발견 기회를 놓쳤음을 보여줌 |
| 인용 취약성 | LLM이 경쟁사 페이지는 인용하지만 자사 페이지는 인용하지 않음 | 출처 권위의 격차를 나타냄 |
| 주장 정확성 | LLM이 오래된 제품 한계를 반복해서 언급함 | 최신 근거로 바로잡을 수 있음 |
| 콘텐츠 격차 | 프롬프트에 직접 답하는 자사 페이지가 없음 | 명확한 GEO 콘텐츠 과제가 생김 |
| 측정 가능성 | 프롬프트를 반복적으로 모니터링할 수 있음 | 성과 기여도 측정이 가능해짐 |
Dageno AI의 기회 분석 및 프롬프트 수준 분석 워크플로는 팀이 막연한 평판 우려에서 우선순위가 정해진 실행 목록으로 나아가도록 지원합니다. 사용자가 이미 질문하고 있고, AI가 이미 답변을 제공하며, 경쟁사가 이미 가시성을 차지하고 있는 상황에서 브랜드가 누락되거나 약하게 묘사되는 프롬프트에 집중할 수 있습니다.
핵심 인사이트:
가장 빠르게 감성을 개선할 수 있는 경우는 흔히 “오래된 사실” 문제에서 비롯됩니다. LLM이 몇 달 전에 추가된 기능이 브랜드에 없다고 말한다면, 광범위한 평판 캠페인보다 더 명확한 제품 페이지, 릴리스 노트, 비교 정보 업데이트, 타사 출처 정정이 필요할 수 있습니다.
실용적인 LLM 감성 추적 프로그램은 직접적인 답변, 구조화된 프롬프트, 출처 분석, 콘텐츠 업데이트 및 성과 추적으로 시작해야 합니다.
다음 체크리스트를 활용해 LLM 감성 추적 워크플로를 시작하거나 개선하세요.
Dageno AI는 AI 검색 가시성 추적, 감성 분석, 프롬프트 발굴, 인용 분석, GEO 콘텐츠 생성 및 성과 기여도를 연결하므로 전체 체크리스트를 지원합니다.
LLM에서 브랜드 감성 추적이란 AI 시스템이 생성한 답변에서 브랜드의 평판, 신뢰성, 가치 및 약점을 어떻게 설명하는지 측정하는 과정입니다.
LLM 감성 추적은 ChatGPT, Gemini, Perplexity, Copilot, Grok 및 Google AI 검색 기능과 같은 시스템에서 사용자가 받는 답변에 중점을 둡니다. 목표는 AI가 생성한 브랜드 서사가 발견, 신뢰 및 전환에 도움이 되는지 아니면 부정적인 영향을 미치는지 파악하는 것입니다.
LLM 브랜드 감성 추적에 가장 적합한 프롬프트는 구매자가 결정을 내리기 전에 묻는 브랜드 평가 질문입니다.
유용한 예로는 “[Brand]는 믿을 만한가요?”, “[Brand]는 그만한 가치가 있나요?”, “[Brand]는 고객 지원을 잘하나요?”, “[Brand]는 안전한가요?”, “[Brand]의 단점은 무엇인가요?” 등이 있습니다. 이러한 프롬프트를 통해 사용자가 브랜드를 이미 알고 있으며 확신을 얻으려는 상황에서 AI 시스템이 어떤 말을 하는지 파악할 수 있습니다.
LLM 감성은 AI가 브랜드에 대해 무슨 말을 하는지 측정하고, AI 가시성은 브랜드가 AI 답변에 나타나는지를 측정합니다.
AI 시스템이 브랜드를 언급하면서 가격, 지원, 사용성 또는 안정성을 부정적으로 설명한다면 브랜드의 가시성은 높지만 감성은 약할 수 있습니다. Dageno AI는 팀이 가시성과 감성을 모두 모니터링하여 AI 시스템이 브랜드를 언급하는지, 그리고 그 언급이 유익한지 확인하도록 지원합니다.
LLM에서 부정적인 브랜드 감성은 대개 오래된 출처, 해결되지 않은 고객 불만, 불명확한 자사 콘텐츠, 부족한 근거, 리뷰 플랫폼의 특이 사례 또는 경쟁사가 주도하는 서사로 인해 발생합니다.
가장 효과적인 대응은 부정적인 주장의 출처를 파악하고 근본적인 정보 격차를 해소하는 것입니다. Dageno AI는 팀이 부정적 감성 탐지에서 콘텐츠 전략, 출처 업데이트 및 성과 기여도 분석으로 나아가도록 지원합니다.
브랜드는 중요한 프롬프트의 LLM 감성을 지속적으로 추적하고, 전략적 패턴은 최소 월 1회 검토해야 합니다.
가격, 보안, 지원, 규정 준수 및 경쟁사 비교와 관련된 고위험 프롬프트는 구매 의도가 높은 사용자에게 부정적인 AI 서사가 영향을 미칠 수 있으므로 더 자주 모니터링해야 합니다. 월간 검토는 반복되는 주제를 파악하고 GEO 콘텐츠 작업의 우선순위를 정하는 데 유용합니다.
네. Dageno AI는 모니터링 데이터를 전략, 콘텐츠 생성, 출처 분석 및 성과 기여도로 전환하여 LLM 감성을 개선하도록 지원할 수 있습니다.
Dageno AI는 데이터 모니터링 → 전략 → 콘텐츠 생성 → 성과 기여도로 이어지는 워크플로를 제공합니다. 따라서 감성 점수를 관찰하는 데 그치지 않고 LLM이 브랜드를 설명하는 방식을 개선하려는 팀에 유용합니다.
Google Search Central – AI 기능과 웹사이트
Google Search Central – 생성형 AI 기능 최적화
OpenAI Help Center – ChatGPT Search
Pew Research Center – 청소년, 소셜 미디어 및 AI 챗봇

업데이트한 사람
Dageno
Dageno is the research and insights team at Dageno AI, publishing industry reports and expert analysis on AI Search Visibility, Generative Engine Optimization (GEO), and AI-powered search discovery.
 Alexa for Shopping
