한 AI 모델은 브랜드를 언급하고 다른 모델은 빠뜨립니다. 스마트워치 사례로 서로 다른 질문이 겉보기 충돌을 만드는 이유와, 다음 단계가 비교 가능한 답변을 늘리는 것인 이유를 설명합니다.
12,000 이상의 틈새 시장을 탐색해 보세요.

Nov 05, 2026에 업데이트됨
대시보드의 스마트워치 시장을 예로 들어 보겠습니다. 이번에 개별적으로 기록한 답변 중에는 호주의 이 하위 의도에 대한 Google AI Mode나 Copilot 답변이 하나도 없었습니다. 연구 담당자는 이 칸을 "Apple이 이 모델들에서 빠져 있다"가 아니라 "이 세트에 답변 없음"으로 표시해야 합니다. 이 구분은 모니터링에 영향을 줍니다. 답변이 있는 모델만 그 답변이 브랜드를 언급하는지 평가할 수 있기 때문입니다. 나머지 모델은 확인할 기록이 생길 때까지 관찰 목록에 두세요.
Issues & opportunities로 이동해 Opportunity overview를 열고 LLM coverage gap 카드를 선택하세요. View analysis를 클릭한 다음 View related AI responses를 클릭합니다. 버튼에는 하위 의도의 전체 답변 수인 203이 표시되지만, 열리는 목록에는 9개 답변만 있으며 모두 Apple을 언급하지 않은 Google AI Overview 답변입니다. 모델과 지역을 아우르는 203개 답변을 모두 보려면 Demand & insights → Search intents → Recommendations → See top recommendations → View AI responses로 이동하세요. 호주를 확인할 때는 각 답변 상단의 모델과 지역 라벨을 읽으세요.
카드에는 Google AI Overview에서 Apple의 Model visibility가 35.71%, Model median이 72.00%, Visibility gap이 36.29%로 표시되고 우선순위는 Medium입니다. 이는 연구 담당자에게 어디서 근거를 확인해야 하는지 알려 줍니다. 하지만 어떤 질문이 이 격차를 만들었는지, 팀이 어떤 페이지를 바꿔야 하는지는 알려 주지 않습니다.
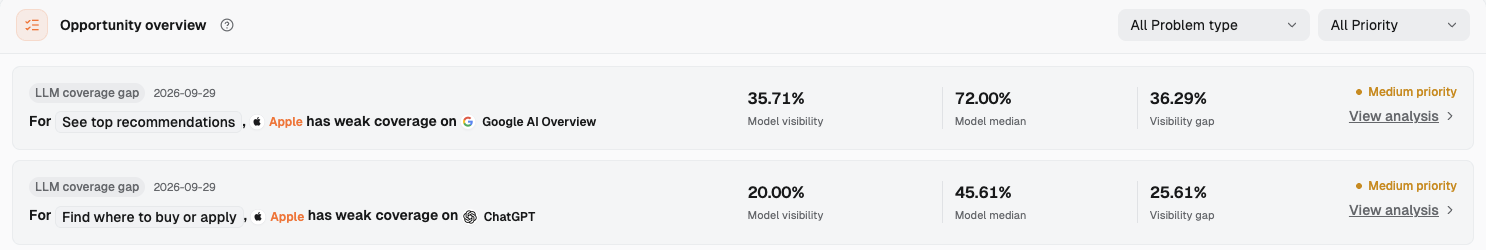
Opportunity overview의 LLM coverage gap 카드: See top recommendations에서 Google AI Overview의 Apple Model visibility는 35.71%, Model median은 72.00%, Visibility gap은 36.29%이며 우선순위는 Medium입니다. 두 번째 카드는 ChatGPT에서 같은 종류의 격차를 기록하고 있습니다.
이 하위 의도의 203개 답변을 하나씩 기록해 보면 Google AI Overview 답변은 14개이고, 그중 5개가 Apple을 언급합니다. 카드에서 여는 관련 답변 목록에는 나머지 9개가 정확히 들어 있으며, 이를 요구와 지역별로 분류해야 합니다. 답변에서 브랜드가 빠졌다는 것은 그 한 답변에 대한 설명입니다. 특정 질문의 추천에서 브랜드가 빠졌다고 말하려면, 그 답변이 브랜드가 후보가 될 수 있는 구매 선택을 다뤘는지도 알아야 합니다. 브랜드 페이지가 인용된 것은 별개의 관찰이며, 답변 본문의 추천을 대신할 수 없습니다.
Evidence preview에서 Source answer를 읽은 다음 Related citation analysis를 읽으세요. 상단의 모델과 지역, 답변 속 브랜드 이름, 그리고 그 브랜드가 추천되었는지, 지나가듯 언급되었는지, 인용 페이지에만 나왔는지를 기록하세요. 그러면 '누락'을 분석하는 단위가 분명해집니다.
호주의 어린이 안전 워치에 관한 Google AI Overview 답변은 4개이며, 어느 답변도 Apple을 언급하지 않습니다. 이는 특정 요구에 대한 신호입니다. 하지만 현재 기록에서 다른 모델에는 같은 지역의 어린이 워치 답변이 없으므로, 팀은 양쪽 모두에 비교 가능한 표본이 없습니다. 한 모델의 답변이 여러 개 있어도 그룹 안의 질문이 서로 다르면 같은 질문에 대한 답변을 대신할 수 없습니다.
연구 담당자는 다음에 어떤 질문을 수집할지, 모델별로 완전한 답변을 몇 개 남길지, 언제 검토할지를 미리 정할 수 있습니다. 현재 근거로는 팀이 행동해야 하는 보편적인 기준 수치를 제시할 수 없습니다. 먼저 답변들이 같은 지역의 같은 질문을 다루는지 확인하고, 그다음 새 답변에서도 누락이 계속되는지 보세요.
시장 화면은 하위 의도별로 답변을 묶기 때문에 특정 수요 유형의 이상을 찾는 데 도움이 됩니다. 브랜드 추천을 비교하려면 지역, 언어, 그리고 질문 자체도 고정해야 합니다. "스마트폰 사용자를 위한 스마트워치 고르기"와 "아이를 위한 위치 추적 안전 워치 고르기"는 모두 Recommendations에 들어갈 수 있지만 구매자의 요구 조건은 다릅니다. 이를 합치면 질문의 차이가 모델의 차이처럼 보일 수 있습니다.
완전한 답변마다 모델, 지역, 답변이 다루는 것으로 보이는 질문, 브랜드 언급 여부, 브랜드를 분명히 추천했는지를 기록하세요. 답변 수는 모델별로 따로 보고하세요. 목록 전체 합계는 어느 모델의 분모도 아닙니다. 목록에는 모델 필터가 없으므로 사람이 답변 상단의 라벨을 하나씩 확인하고 기록해야 합니다. 같은 답변은 여러 번 다시 열어도 한 번만 세세요.
개별 답변은 달라질 수 있습니다. SparkToro와 Gumshoe의 AI 추천 일관성 연구는 같은 질문에 대한 반복 답변에서 브랜드 목록이 달라지는 현상을 기록했습니다. AI 플랫폼 전반에서 브랜드 추천을 확인하는 가이드는 반복 답변이 왜 중요한지 설명합니다. 여기서는 그보다 앞서, 비교하려는 답변들이 애초에 같은 요구를 다루는지 확인합니다.
LLM coverage gap 카드는 Google AI Overview를 Medium 우선순위로 표시합니다. Apple의 35.71%가 Model median 72.00%보다 낮아 격차는 36.29%입니다. View analysis를 열면 Where the problem occurs 아래에 What the user is doing, Sub-intents, Observed result가 표시되고, 이어서 관련 답변을 열 수 있습니다. 카드는 조사를 시작할 위치를 가리킵니다. 그 단서가 조치로 이어져야 하는지는 개별 답변이 결정합니다.
Google AI Overview 답변 14개 중 5개가 Apple을 언급합니다. 나머지 9개를 답변 내용으로 분류하면 네 그룹이 나옵니다. 3개는 벨기에나 네덜란드의 Garmin 워치, 1개는 폴란드의 Garett 워치, 1개는 스페인어 맥락에서 스포츠 스마트워치가 무엇인지 설명, 4개는 호주의 어린이 안전·위치 추적 워치를 다룹니다. 특정 브랜드나 정의를 다룬 답변은 Apple이 빠졌다고 말할 수 있는, 비교 가능한 개방형 구매 추천이 아닙니다. 자세히 볼 가치가 있는 것은 호주의 어린이 워치 그룹입니다.
한 답변은 이렇게 시작합니다. "The top 5 highly-rated child safety smartwatches with GPS tracking are Spacetalk Adventurer 2, TickTalk 5, Gabb Watch 3e, Xplora X6 Play, and Garmin Bounce."(GPS 추적 기능이 있는 평점 높은 어린이 안전 스마트워치 상위 5개는 Spacetalk Adventurer 2, TickTalk 5, Gabb Watch 3e, Xplora X6 Play, Garmin Bounce입니다.) 다른 답변은 이렇게 시작합니다. "Top kids smartwatches feature real-time GPS tracking combined with 4G LTE calling, geofencing "safe zones," and SOS buttons."(인기 어린이 스마트워치는 실시간 GPS 추적과 함께 4G LTE 통화, 지오펜싱 "안전 구역", SOS 버튼을 갖추고 있습니다.) 이 원문은 답변이 다루는 요구를 보여 줍니다. 여기 나오는 브랜드는 인용한 답변의 일부입니다.
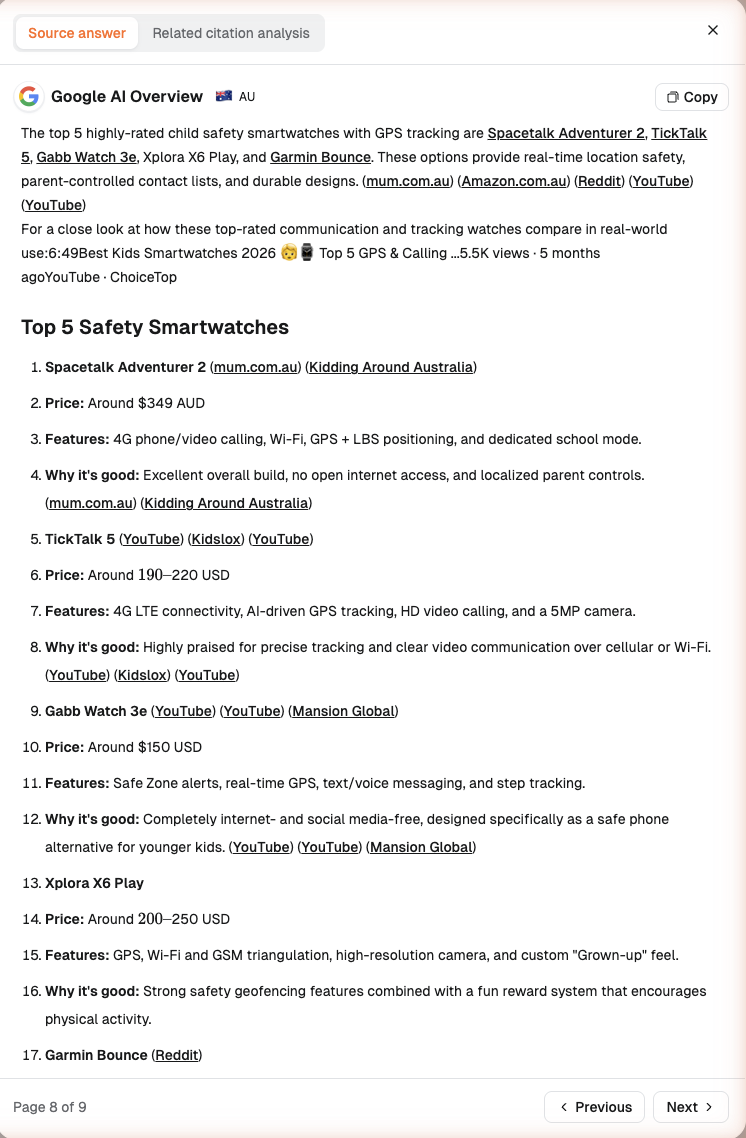
카드에서는 관련 답변 9개가 열립니다. 이것은 여덟 번째 답변으로, 호주(AU)의 Google AI Overview 답변입니다. 어린이 안전·위치 추적 워치를 나열하지만 Apple은 언급하지 않습니다.
같은 하위 의도와 지역에서 ChatGPT 답변 5개와 Gemini 답변 3개는 모두 Apple을 언급합니다. 내용으로 볼 때 이 8개 답변 중 어린이 안전 워치 질문을 다룬 것은 없습니다. 자세히 읽은 몇몇 답변은 일반 스마트워치나 스포츠 워치를 다뤘습니다. 한 ChatGPT 답변은 이렇게 말합니다. "If you're shopping for a smartwatch right now in 2026, these are the standouts. The biggest factor is your phone: Apple Watches are for iPhone …"(2026년인 지금 스마트워치를 산다면 이 제품들이 눈에 띕니다. 가장 큰 요인은 스마트폰입니다. Apple Watch는 iPhone용이며……) 이 답변은 어린이 안전이나 위치 추적이 아니라 스마트폰 호환성을 다룹니다. 이것들은 하나의 하위 의도 안의 서로 다른 질문입니다. 현재 기록에는 같은 어린이 워치 질문에 대해 다른 모델이 Apple을 추천한 답변이 없습니다.
따라서 이 카드는 확인할 가치가 있는 답변을 찾는 방법이 됩니다. 관련 없는 질문을 분리한 다음 어떤 표본을 추가할지 정하세요. 이 사례에서 부족한 표본은 호주의 같은 어린이 안전 워치 질문에 대한 여러 모델의 답변입니다. 페이지 수정 작업은 그다음 일입니다.
View related AI responses 목록과 View AI responses 목록 모두 모델 필터가 없고, Evidence preview는 원래 프롬프트를 보여 주지 않습니다. 연구 담당자는 답변 내용으로 대략 무엇을 다루는지 판단할 수 있지만, 이 기록으로 각 질문의 정확한 문구를 재구성할 수는 없습니다. See top recommendations는 일반 쇼핑, 특정 브랜드, 어린이 안전 워치에 관한 답변을 모두 포함하는 하위 의도입니다. 실제 모델 간 차이를 검증하려면 고객이 추적하려는 같은 질문을 Monitored prompts에 등록하고 선택한 모델에서 답변을 수집해야 합니다.
Monitoring settings 아래 Monitored prompts 목록에는 #, Prompt, Platforms, Regions, Answers, Brands, Details, Leading, Status가 표시됩니다. 이 사례는 고객이 하나의 고정된 질문으로 모니터링한 답변이 아니라 시장 데이터를 사용하므로, 질문 문구를 글자 그대로 확인할 수 없습니다. 다음 모니터링에서는 프롬프트 문구를 저장하고 실제로 돌아온 답변을 확인하세요. 이 시장 답변들을 같은 문구로 이미 실행된 것처럼 다루지 마세요.
각 답변 상단에는 Google AI Overview, AU처럼 모델과 지역이 표시됩니다. 이 라벨로 답변을 묶은 다음, 선택한 지역에 각 모델의 기록이 실제로 있는지 확인하세요. Market overview의 Platforms & regions는 범위를 찾는 데 도움이 되지만, 판단의 근거는 그 안의 완전한 답변입니다. 같은 지역 라벨만으로는 충분하지 않으니, 스마트워치 답변을 묶기 전에 언어와 답변 내용을 확인하세요.
호주의 기존 기록을 보면 Google AI Overview, ChatGPT, Gemini를 같은 지역 검토 목록에 둘 수 있습니다. 하나의 고정된 어린이 워치 질문으로 모델 간 수를 비교하는 것은 다음 회차 답변부터 시작해야 합니다. Google AI Mode와 Copilot은 이번에 이 범위에서 기록한 답변에 나타나지 않았으므로 관찰을 계속하세요. 구매자가 어떤 모델을 쓰는지, 호주가 우선 시장인지는 시장 연구 담당자가 고객 측 근거로 확인해야 합니다.
Evidence preview는 수집 시간을 보여 주지 않습니다. 답변 목록에도 원래 프롬프트나 수집 시간이 표시되지 않습니다. 연구자가 카드를 연 날은 검토 날짜이지, 답변이 실행된 날짜가 아닙니다. 현재 기록으로는 이 과거 답변들의 공통 수집 기간도 확인할 수 없습니다. 다음 재테스트는 저장할 수 있는 새 답변으로 시작하세요. 회차마다 질문, 모델, 지역, 언어, 그리고 팀이 확인할 수 있는 시간 정보를 기록하세요. 시스템의 수집 시간을 알 수 없다면 "표시되지 않음"으로 기록하세요.
어린이 안전 워치가 제품이 대상으로 하는 사람과 용도에 맞는지도 브랜드가 판단해야 합니다. 대시보드는 답변과 출처를 보여 줄 뿐이고, 이 질문을 공략할지는 브랜드가 결정합니다. 제품이 그 용도에 맞지 않는다면 coverage gap만으로 최적화 대상으로 삼을 이유가 되지 않습니다.
호주의 어린이 안전 워치에 관한 Google AI Overview 답변 4개에는 각각 23, 24, 25, 19개의 인용 출처가 표시됩니다. 개별 인용 목록에는 safewise.com, harveynorman.com.au, reddit.com, youtube.com, forbes.com, kidslox.com, mum.com.au, garmin.com이 자주 포함됩니다. 이 4개 답변에 보이는 인용 중 apple.com을 가리키는 것은 없습니다. 이것은 답변과 그 출처에 대한 관찰이며, 특정 사이트가 없다는 사실이 브랜드 누락을 일으켰다고 증명하지는 않습니다. Google의 AI 기능과 웹사이트에 관한 공식 가이드에 따르면 AI Overview는 독자가 더 살펴볼 수 있도록 관련 링크를 표시합니다. 이렇게 보이는 링크가 출처 확인의 출발점입니다.
여기서 중요한 화면은 두 가지입니다. Evidence preview의 Related citation analysis는 개별 답변의 인용을 보여 줍니다. 이 사례에서 카드 서랍의 Sources used by the answers는 No data로 표시됩니다. 출처를 비교할 때는 실제로 열어 본 답변을 사용하고, 각 인용 URL을 해당 답변 본문과 함께 저장하세요. 서랍에 No data가 표시되면 그 결과를 표시된 그대로 보고하세요.
같은 모델은 네덜란드의 어린이 워치에 관한 답변에서 Apple Watch SE를 언급했습니다. "Voor oudere jeugd (Middelbare school): Een instapmodel zoals de Apple Watch SE of reguliere Samsung Galaxy Watch."(중고등학생 정도의 나이가 있는 아이에게는 Apple Watch SE 같은 입문 모델이나 일반 Samsung Galaxy Watch도 선택지가 될 수 있습니다.) 이 기록은 모델을 고정해도 지역과 답변이 대상으로 하는 연령대에 따라 제시되는 선택지가 달라질 수 있음을 보여 줍니다. 네덜란드 기록은 한 모델 안의 지역 간 비교입니다. 호주의 모델 간 비교에는 같은 질문에 대한 새 답변이 필요합니다.
다음 회차에서 여러 모델이 호주의 같은 어린이 워치 질문에 답하면, 각 답변에서 제시된 제품과 인용된 페이지를 비교하세요. 어떤 페이지가 관련 제품을 나열하는지, 어떤 페이지가 선택 기준을 설명하는지, 답변이 어떤 정보를 사용하는지 확인하세요. 답변과 인용 페이지를 비교하는 전체 방법은 별도로 다룹니다. 여기서는 이 누락 신호와 직접 관련된 출처 기록만 다룹니다.
이 사례의 결정은 먼저 표본을 늘리는 것입니다. 카드가 보여 준 coverage gap은 조사할 가치가 있습니다. 하지만 현재 기록에는 호주의 어린이 안전 워치 답변과 같은 질문에 대한 다른 모델의 답변이 없습니다. 격차는 팀에 어디를 볼지 알려 주고, 답변 내용은 그 답변들을 비교할 수 있는지 알려 주며, 이 용도를 모니터링 범위에 넣을지는 브랜드가 결정합니다.
| 보이는 것 | 현재 결론 | 다음 조치 | 아직 내릴 수 없는 결론 |
|---|---|---|---|
| LLM coverage gap 카드에 35.71%, 72.00%, 36.29%가 표시됨 | 답변을 열어 검토한다 | 관련 답변마다 질문, 모델, 지역을 확인한다 | 이미 고쳐야 할 콘텐츠 격차를 찾았다 |
| Apple을 언급하지 않은 답변 일부는 특정 브랜드나 정의를 다룸 | 비교 가능한 개방형 구매 답변이 아니다 | 모델 간 비교에서 제외하고 원래 기록은 보관한다 | 일반 추천에서 Apple이 빠져 있음을 보여 준다 |
| 호주의 어린이 안전 워치 답변 4개 모두 Apple을 언급하지 않음 | 특정 요구에 대한 신호가 있다 | 브랜드가 제품 적합성을 확인한 뒤 질문을 고정하고 다른 모델의 답변을 수집한다 | 여러 모델이 같은 질문에 정반대의 브랜드 추천을 한다는 것이 입증되었다 |
| 같은 지역의 기존 ChatGPT와 Gemini 답변은 Apple을 언급하지만 일반 스마트워치를 다룸 | 답변들이 서로 다른 질문을 다루므로 먼저 비교 가능한 표본을 늘린다 | ChatGPT와 Gemini에 Google AI Overview와 같은 어린이 워치 질문을 한다 | ChatGPT나 Gemini는 어린이 워치에 Apple을 추천할 것이다 |
| 이번에 확인한 기록에 이 지역의 Google AI Mode나 Copilot 답변이 없음 | 이 두 모델에 대해 브랜드를 판단할 근거가 아직 없다 | 관찰 목록에 두고, 새 답변이 나오면 분류한다 | 이 두 모델에서 Apple이 빠져 있다 |
선택한 모델들이 정확히 같은 질문에 대해 충분한 비교 가능 답변을 내놓으면, 이후 관찰 기간에도 누락이 계속되는지 확인하세요. 구매자가 브랜드가 빠진 모델을 사용하고, 브랜드가 제품이 그 질문에 맞는다고 확인하며, 답변과 인용이 특정 정보의 차이를 가리킨다면, 그때 팀은 페이지에 사실을 추가하거나 제3자에게 자료를 제공하는 것을 검토할 수 있습니다. 페이지 수정 내용은 요구와 출처에 대한 검증 가능한 정보로 정하세요. 이번 기록으로는 아직 그런 조치 대상을 특정하지 못했습니다.
관련 상황에는 각각 별도의 진단 경로가 있습니다. 기록된 답변이 있는 모든 모델에서 브랜드가 빠진다면 AI 답변 전반에서 브랜드가 보이지 않을 때의 진단 방법을 참고하세요. 브랜드가 추천에는 나오지만 경쟁사 뒤에 놓인다면 AI 추천에서 경쟁사 뒤에 놓인 브랜드의 진단 방법을 참고하세요. 언급, 추천, 인용을 구분하려면 AI 검색 가시성 측정 가이드를 활용하세요.
그룹은 다음 결정을 위해 존재합니다. 핵심 모델은 구체적인 누락 신호를 가진 모델입니다. 비교 모델은 정확히 같은 질문에 답하게 해 진정한 나란한 비교를 할 수 있게 합니다. 관찰 모델은 현재 기록에서 쓸 수 있는 답변이 나타나지 않은 모델이며, 답변이 나오면 분류합니다. 아래 모니터링 범위는 이 사례를 위해 제안하는 방법입니다. 모델 이름과 기존 근거는 대시보드에서 가져왔지만, 구매자 습관, 관찰 기간, 담당자는 고객이 확인해야 합니다.
| 그룹 | 모델 | 기존 근거 | 고정할 범위와 다음에 기록할 결과 |
|---|---|---|---|
| 핵심 | Google AI Overview | 호주의 어린이 안전 워치 답변에서 Apple이 빠짐 | AU에서 어린이 안전·위치 추적 워치 질문 하나를 고정하고, 완전한 답변, 브랜드 언급, 분명한 추천, 인용 출처를 저장한다 |
| 비교 | ChatGPT, Gemini | 같은 지역의 일반 스마트워치 답변은 Apple을 언급하지만, 어린이 워치에 해당하는 답변은 없음 | 핵심 모델과 정확히 같은 질문과 지역을 사용하고, 각 답변이 다루는 용도를 확인한 뒤 언급, 추천, 출처를 기록한다 |
| 관찰 | Google AI Mode, Copilot | 이번에 확인한 기록에 이 호주 하위 의도의 답변이 없음 | 같은 범위의 답변이 나오면 하나씩 기록하고, 그 모델을 핵심과 비교 중 어디에 둘지 결정한다 |
이것이 우리 브랜드라면 먼저 제품 및 시장 담당자에게 어린이 안전·위치 추적 워치가 제품의 대상 사용자에게 맞는지, 그리고 구매자가 실제로 어떤 모델을 쓰는지 확인하세요. 확인이 끝나면 시장 연구 담당자가 프롬프트, 지역, 언어를 하나씩 저장하고 관찰 기간, 재테스트 빈도, 담당자, 종료 조건을 정해야 합니다. 날짜와 실행 횟수는 고객이 정합니다. 새 답변이 도착하기 전에 이런 규칙을 정해 두면 결과를 본 뒤 비교 규칙이 바뀌는 일을 막을 수 있습니다.
회차마다 답변 전문과 인용을 저장하세요. 프롬프트, 모델, 지역, 언어, 브랜드 언급이나 분명한 추천 여부, 그리고 확인할 수 있는 시간 정보를 기록하세요. 비교 그룹에서는 어린이 워치 질문에서 비교 가능한 추천이 있는지와, 일반 쇼핑 답변에서 기존 추천이 사라지지 않았는지를 모두 확인합니다. 실제로 페이지를 바꿨다면 무엇을 언제 바꿨는지 기록하세요. 다음 재테스트에는 새로 얻은 답변을 사용하세요. 오래된 기록을 다시 여는 것은 새로운 결과가 아닙니다. AI 추천이 개선되었는지 검증하는 방법은 이후 관찰 기간과 기록을 계획하는 데 도움이 됩니다.
시장 연구 담당자는 이제 팀에 분명하게 말할 수 있습니다. 시스템은 확인할 가치가 있는 coverage gap을 찾았습니다. 답변을 분리해 보니 호주에서는 어린이 안전 워치 요구에 대한 누락 신호가 나왔지만, 기존의 모델 간 기록은 서로 다른 질문을 다루고 있었습니다. 이번 회차에서는 먼저 브랜드가 그 요구가 제품에 맞는지 판단해야 합니다. 그다음 핵심 모델과 비교 모델이 같은 질문에 답하게 하고 새 답변과 인용을 저장하세요. 콘텐츠 최적화에 투자할지는 구매자의 모델 사용, 반복 관찰, 출처 근거를 확인한 뒤 결정하세요.
수를 나란히 보고할 수는 있지만, 먼저 두 답변 세트가 같은 질문에 답하는지 확인하세요. 모델별 답변 수를 명시하고 적은 쪽의 표본을 먼저 늘리세요. 서로 다른 질문의 답변을 합치면 수가 비슷해 보여도 모델의 차이는 드러나지 않습니다.
언급으로 기록하고 앞뒤 문장을 함께 남기세요. 답변이 그 요구에 대한 선택지로 브랜드를 분명히 제시할 때만 추천으로 세세요. 브랜드 페이지가 인용된 경우는 따로 기록하세요. 세 가지를 구분해 두면 이후 변화가 답변 본문에서 나타났는지, 출처에서 나타났는지 알 수 있습니다.
먼저 새 답변이 같은 질문, 지역, 언어를 사용했는지 확인하세요. 그다음 구매자가 그 모델을 쓰는지, 브랜드가 그 질문에 맞는지, 새 답변이 무엇을 인용하는지 확인하세요. 이런 조건이 분명해지면 팀은 다룰 정확한 페이지 정보나 제3자 자료를 정하고 같은 범위에서 재테스트를 이어 갈 수 있습니다.
새 지역에는 별도의 시작 기록을 만들고, 원래 지역은 합의한 질문으로 계속 관찰하세요. 매 회차 지역과 언어를 기록하세요. 그러면 지역 안의 시간에 따른 변화를 비교하면서, 지역 간 차이는 따로 살펴볼 수 있습니다.
현재 근거로 뒷받침되는 검토 목록에서 시작하세요. 시장 연구 담당자가 기존 고객 조사나 인터뷰로 구매자의 모델 사용을 확인하게 하세요. 그다음 어떤 모델을 핵심 모니터링에 두고 어떤 모델을 비교나 관찰에 둘지 정하세요. 대시보드의 답변 수는 구매자 사용을 측정하는 지표가 아닙니다.
Dageno is the research and insights team at Dageno AI, publishing industry reports and expert analysis on AI Search Visibility, Generative Engine Optimization (GEO), and AI-powered search discovery.
Read full bio Alexa for Shopping

