Bandingkan lima alat metrik visibilitas AI berdasarkan pengambilan sampel, transparansi sumber, kontrol prompt, cakupan model, akses ke jawaban mentah, dan keterulangan.
Visibilitas AI bukanlah peringkat tetap. Prompt yang sama dapat menghasilkan redaksi, sumber, dan rekomendasi merek yang berbeda dalam setiap proses, lokasi, akun, model, dan mode pencarian. Karena itu, “akurasi” adalah persoalan desain pengukuran, bukan persentase yang diklaim vendor.
Panduan ini membandingkan lima platform visibilitas AI berdasarkan kontrol yang membuat metriknya lebih tepercaya: asal-usul prompt, metode pengumpulan, konteks model dan pasar, pengambilan sampel berulang, akses ke jawaban mentah, bukti pada tingkat sitasi, dan kemampuan ekspor.
Untuk perbandingan operasional yang lebih luas dan berfokus pada penyebutan serta rekomendasi, lihat alat pelacakan penyebutan merek berikut.
Perbandingan singkat: alat metrik visibilitas AI
Platform
Paling sesuai untuk
Sinyal pengukuran terkuat
Pertanyaan uji tuntas
Profound
Program enterprise dan multi-pasar
Pengumpulan melalui antarmuka konsumen, proses harian, ekspor data mentah
Berapa banyak pengulangan yang disertakan?
Semrush
Tim SEO yang membutuhkan penemuan sekaligus pelacakan
Dataset dan sumber prompt yang terdokumentasi
Dataset mana yang mendasari setiap metrik?
HubSpot AEO
Pelanggan HubSpot
Prompt terlacak harian yang terhubung dengan alur kerja pemasaran
Apa batas jumlah prompt dan jawaban?
Dageno
Tim yang beralih dari pengukuran ke optimasi
Sitasi, kompetitor, kesenjangan, dan alur kerja konten
Metode pengumpulan apa yang berlaku untuk setiap mesin?
Ahrefs Brand Radar
Analis SEO dan penemuan pasar
Indeks penemuan besar serta prompt kustom
Bagaimana data penemuan dan pelacakan kustom dipisahkan?
Tidak ada platform yang dapat menetapkan skor universal “94% akurat” tanpa mendefinisikan ground truth, populasi prompt, mesin, rentang waktu, proses pengambilan sampel, dan perhitungan kesalahan. Perlakukan persentase akurasi yang tidak didukung sebagai klaim pemasaran, bukan bukti yang dapat dibandingkan.
Apa arti “visibilitas AI yang akurat”
1. Kumpulan prompt yang representatif
Representativitas dasbor bergantung pada prompt yang mendasarinya. Kumpulan yang berguna mencakup pertanyaan tentang merek, kategori, masalah, perbandingan, alternatif, kasus penggunaan, dan intensi pembelian. Kumpulan itu juga sebaiknya mencatat apakah prompt berasal dari riset pelanggan, permintaan penelusuran, penemuan platform, atau tolok ukur Anda sendiri.
2. Pengamatan berulang
Jawaban generatif bersifat stokastik. Satu kali proses dapat menghasilkan jawaban nyata, tetapi belum tentu representatif. Riset tentang pengukuran penelusuran generatif menunjukkan alasan visibilitas sebaiknya diperlakukan sebagai estimasi dengan ketidakpastian, bukan peringkat permanen. Pengumpulan berulang memungkinkan Anda membedakan perubahan yang bertahan lama dari variasi jawaban normal.
3. Konteks mesin dan pasar yang eksplisit
“Visibilitas ChatGPT” merupakan metadata yang tidak lengkap. Hasil dapat bergantung pada model, mode pencarian, tanggal, negara, bahasa, personalisasi, dan antarmuka. Platform yang kredibel sebaiknya mengungkapkan atau memungkinkan Anda mengontrol dimensi-dimensi yang secara material memengaruhi jawaban.
4. Bukti yang dapat diperiksa
Pangsa suara agregat berguna untuk pemantauan awal, tetapi tim juga membutuhkan jawaban asli, konteks merek, domain yang disitasi, URL yang disitasi, timestamp, dan prompt. Bukti mentah memungkinkan analis mengaudit kesalahan klasifikasi dan menjelaskan perubahan.
5. Definisi metrik yang transparan
Visibilitas, tingkat penyebutan, pangsa sitasi, posisi, sentimen, dan kekuatan rekomendasi mengukur hal yang berbeda. Alat sebaiknya mendokumentasikan pembilang, penyebut, pembobotan, perlakuan terhadap kegagalan, dan rentang agregasinya. Jika tidak, dua grafik dengan label yang sama mungkin tidak dapat dibandingkan.
6. Pelaporan kegagalan dan penolakan
Permintaan yang diblokir, timeout, jawaban kosong, penolakan, dan mode pencarian yang tidak tersedia tidak seharusnya hilang tanpa penjelasan. Mengecualikan pengamatan yang gagal dapat meningkatkan hasil secara artifisial dan membuat sampel kecil tampak lebih stabil daripada kenyataannya.
1. Profound: detail publik paling kuat tentang pengumpulan jawaban
Profound Answer Engine Insights menyediakan detail publik yang sangat berguna tentang alur kerja pengukurannya. Perusahaan menyatakan bahwa mereka mengumpulkan jawaban melalui pengalaman yang ditujukan kepada konsumen, menjalankan pelacakan setiap hari, mendukung prompt kustom dan prompt yang diamati, menyimpan sitasi, membandingkan platform, serta menyediakan ekspor CSV mentah.
Mengapa metriknya lebih mudah diaudit
Pengamatan harian mendukung analisis tren, bukan hanya pemeriksaan satu kali.
Data pada tingkat jawaban dan sitasi dapat diperiksa di bawah metrik agregat.
Kontrol wilayah dan bahasa mendukung perbandingan multi-pasar.
Ekspor mentah memungkinkan tim analitik mereproduksi atau mempertanyakan kesimpulan dasbor.
Hal yang perlu diverifikasi
Tanyakan berapa kali setiap prompt dijalankan, bagaimana pengamatan yang gagal dihitung, mode mesin persis apa yang digunakan, dan apakah perubahan metodologi historis diberi anotasi. Transparansi publik bernilai, tetapi Anda tetap perlu menguji kumpulan prompt Anda sendiri.
2. Semrush: pemisahan dataset AI yang terdokumentasi dengan baik
Semrush AI Visibility menjelaskan bahwa fitur AI-nya menggunakan dataset yang berbeda untuk penemuan pasar dan pelacakan kustom. Basis pengetahuannya menguraikan sumber prompt, jadwal pengumpulan, cakupan model, serta perbedaan antara basis data prompt yang besar dan pemantauan yang ditentukan pengguna.
Mengapa perbedaan itu penting
Dataset penemuan memperkirakan apa yang terlihat di seluruh pasar; pelacak kustom mengukur kumpulan prompt terkontrol yang penting bagi satu merek. Menggabungkan keduanya tanpa label dapat menghasilkan tren yang menyesatkan. Pemisahan yang terdokumentasi di Semrush membantu analis memilih dataset yang tepat untuk mengambil keputusan.
Hal yang perlu diverifikasi
Pastikan dataset, negara, perangkat atau mode, jadwal pembaruan, dan sumber prompt yang mendasari setiap metrik yang diekspor. Jangan membandingkan skor penemuan yang luas secara langsung dengan tolok ukur kustom yang kecil seolah-olah keduanya berasal dari populasi yang sama.
3. HubSpot AEO: terbaik untuk alur kerja harian yang terdefinisi di HubSpot
HubSpot AEO mendokumentasikan pelacakan prompt harian di ChatGPT, Gemini, dan Perplexity, dengan tampilan visibilitas merek, kompetitor, sitasi, dan rekomendasi. Daya tariknya bukan terutama jumlah mesin yang maksimal, melainkan kemampuannya menghubungkan pengamatan dengan alur kerja konten dan pemasaran yang sudah ada.
Mengapa metriknya dapat diandalkan secara operasional
Daftar prompt yang stabil dapat dipantau setiap hari.
Batas akun yang dinyatakan secara eksplisit membuat ukuran sampel terlihat.
Tampilan sitasi dan kompetitor memberikan konteks pada skor visibilitas utama.
Tim dapat menghubungkan temuan dengan konten yang sudah mereka kelola di HubSpot.
Hal yang perlu diverifikasi
Periksa batas yang berlaku untuk langganan Anda, jumlah jawaban persis untuk setiap prompt, kontrol pasar, retensi jawaban mentah, dan opsi ekspor. Jadwal harian hanya berguna jika kumpulan prompt yang mendasarinya tetap dikelola dengan baik.
4. Dageno: terbaik untuk mengubah bukti menjadi pekerjaan optimasi
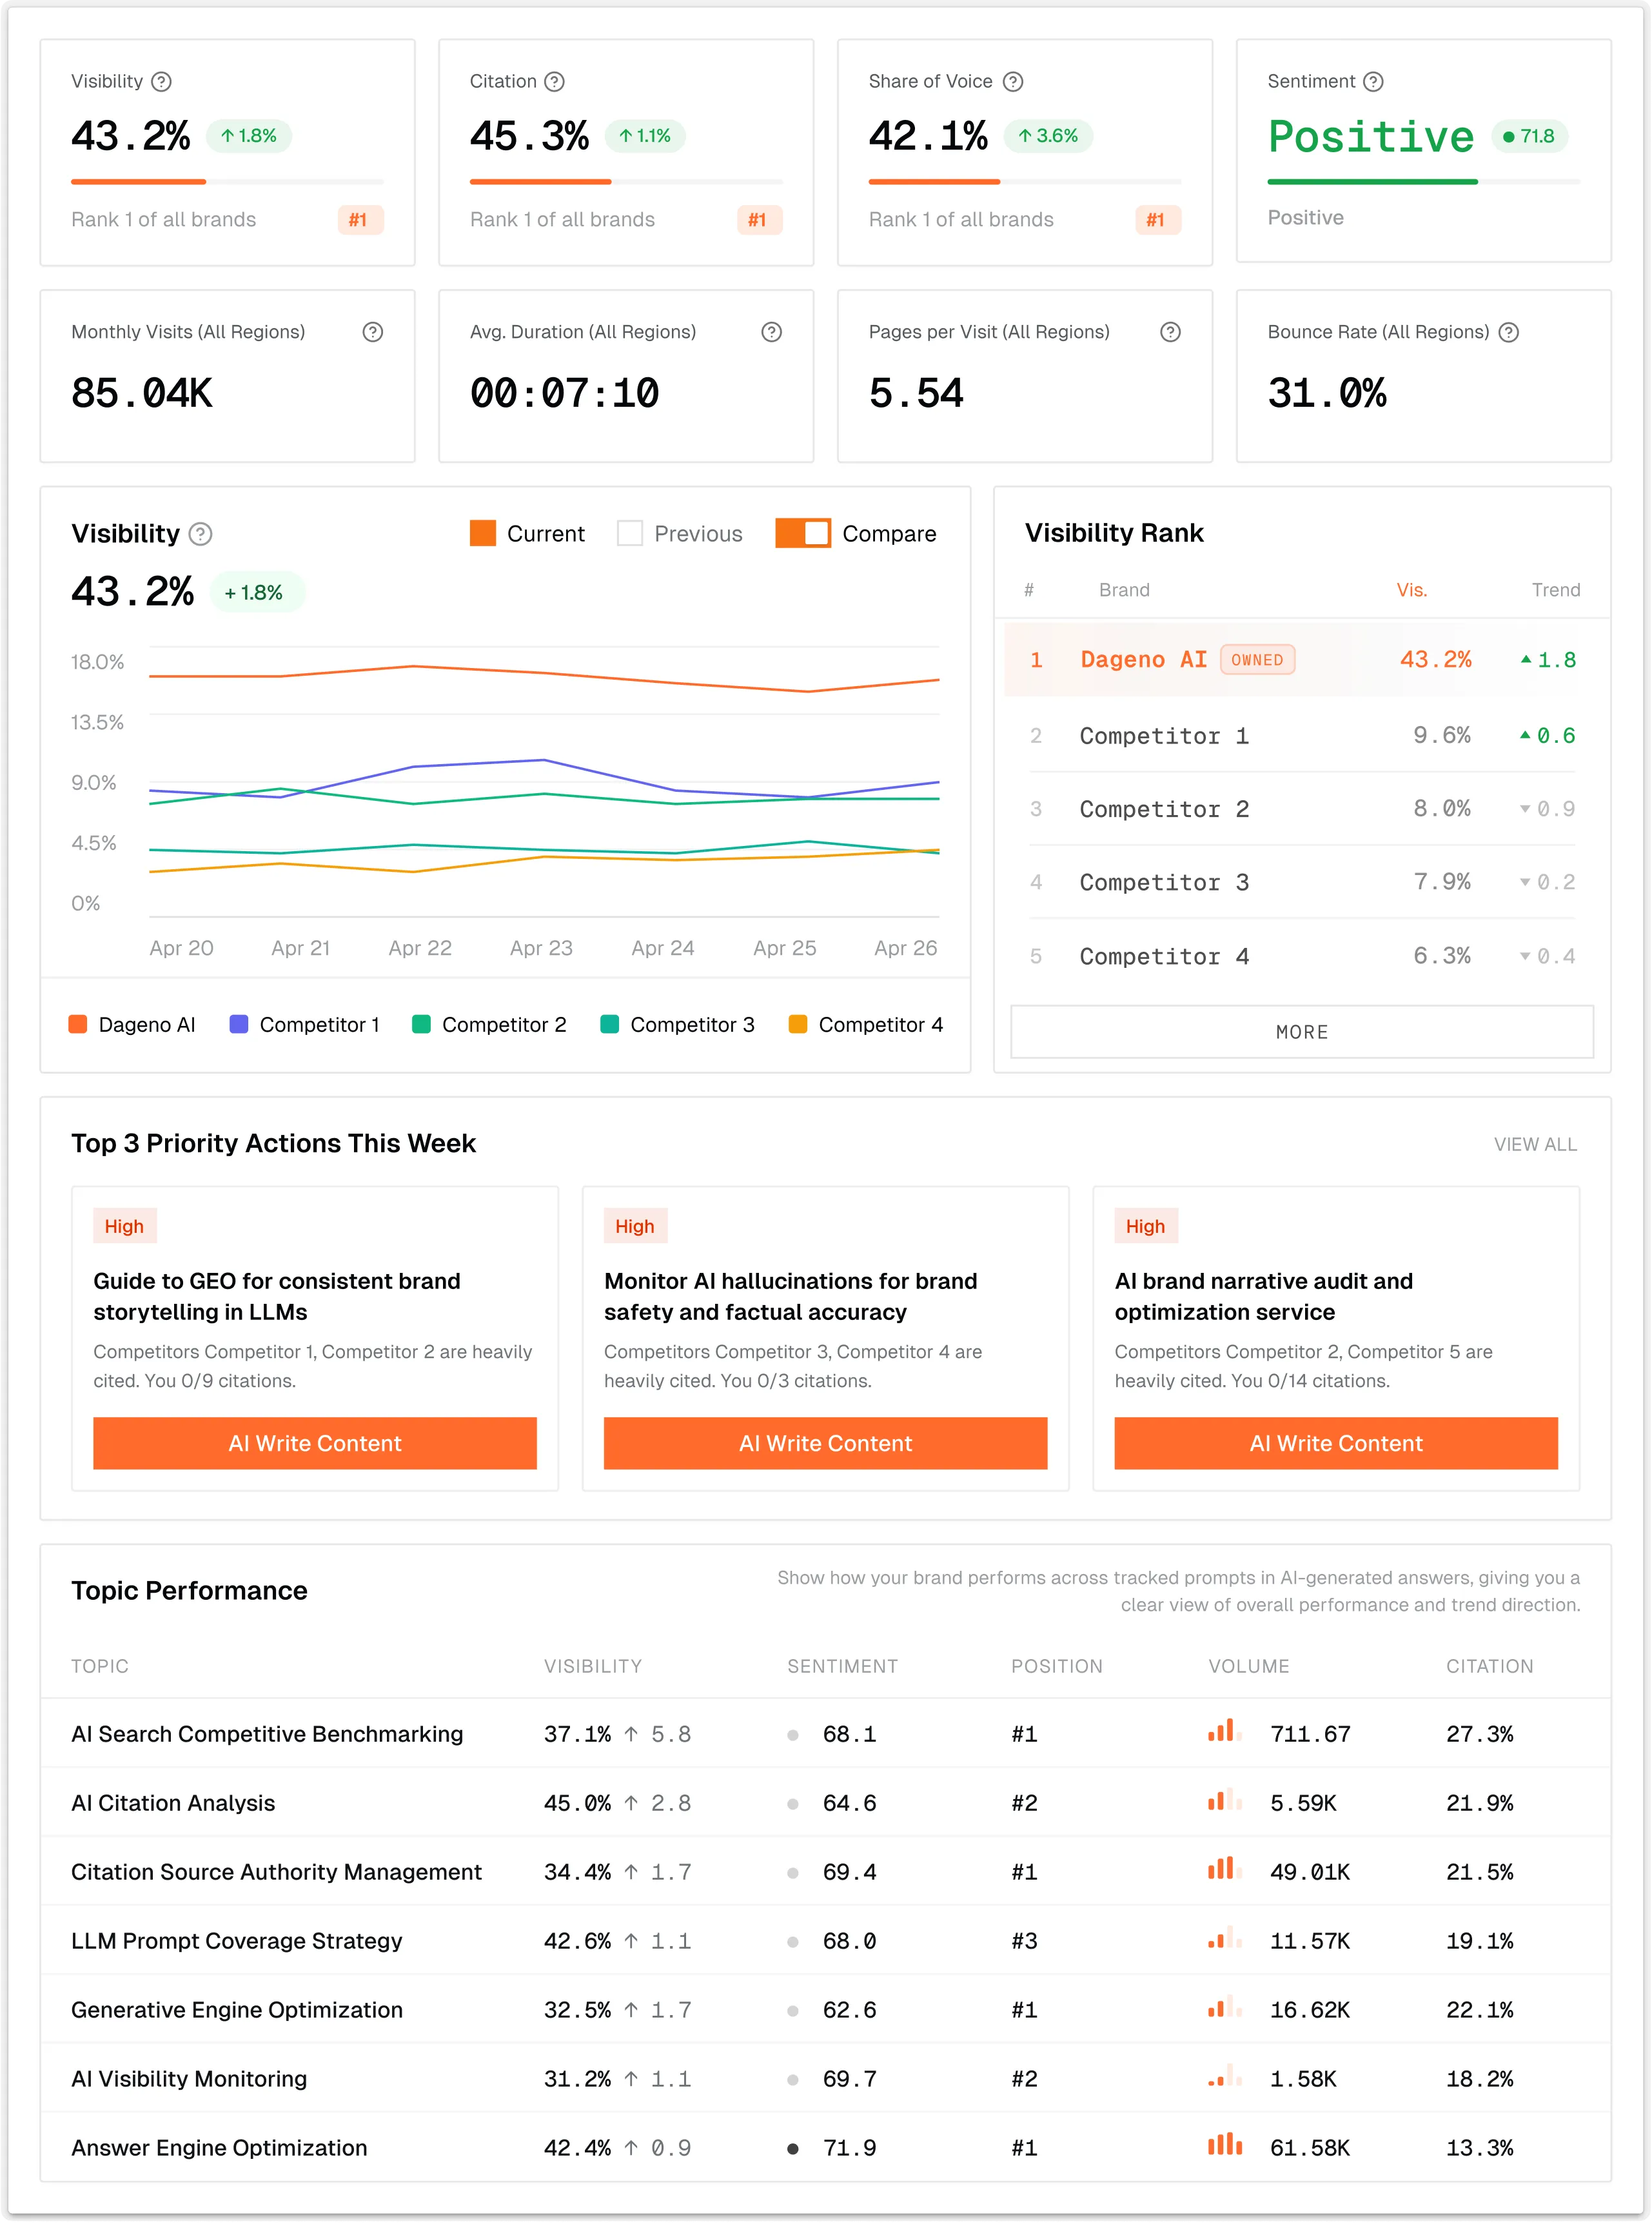
Dageno menggabungkan pelacakan visibilitas AI dengan analisis sitasi, perbandingan kompetitor, kesenjangan topik, dan optimasi konten. Alur end-to-end ini penting karena metrik yang dirancang secara statistik dengan cermat memiliki nilai bisnis terbatas jika tim tidak dapat menelusurinya ke halaman yang disitasi atau perubahan konten yang konkret.
Kekuatan pengukuran
Visibilitas pada tingkat prompt dan perbandingan kompetitor.
Bukti sitasi dan URL untuk mendiagnosis perubahan.
Analisis kesenjangan yang menghubungkan visibilitas yang belum tercapai dengan topik dan sumber.
Alur kerja konten untuk menindaklanjuti temuan.
Hal yang perlu diverifikasi
Untuk setiap mesin, pastikan antarmuka pengumpulan, kontrol pasar dan bahasa, frekuensi proses, kebijakan pengulangan, penanganan kegagalan, dan akses ke jawaban mentah. Dageno sebaiknya dievaluasi berdasarkan bukti dan kesesuaian alur kerjanya, bukan berdasarkan persentase akurasi universal yang tidak didukung.
5. Ahrefs Brand Radar: terbaik untuk penemuan sekaligus prompt kustom
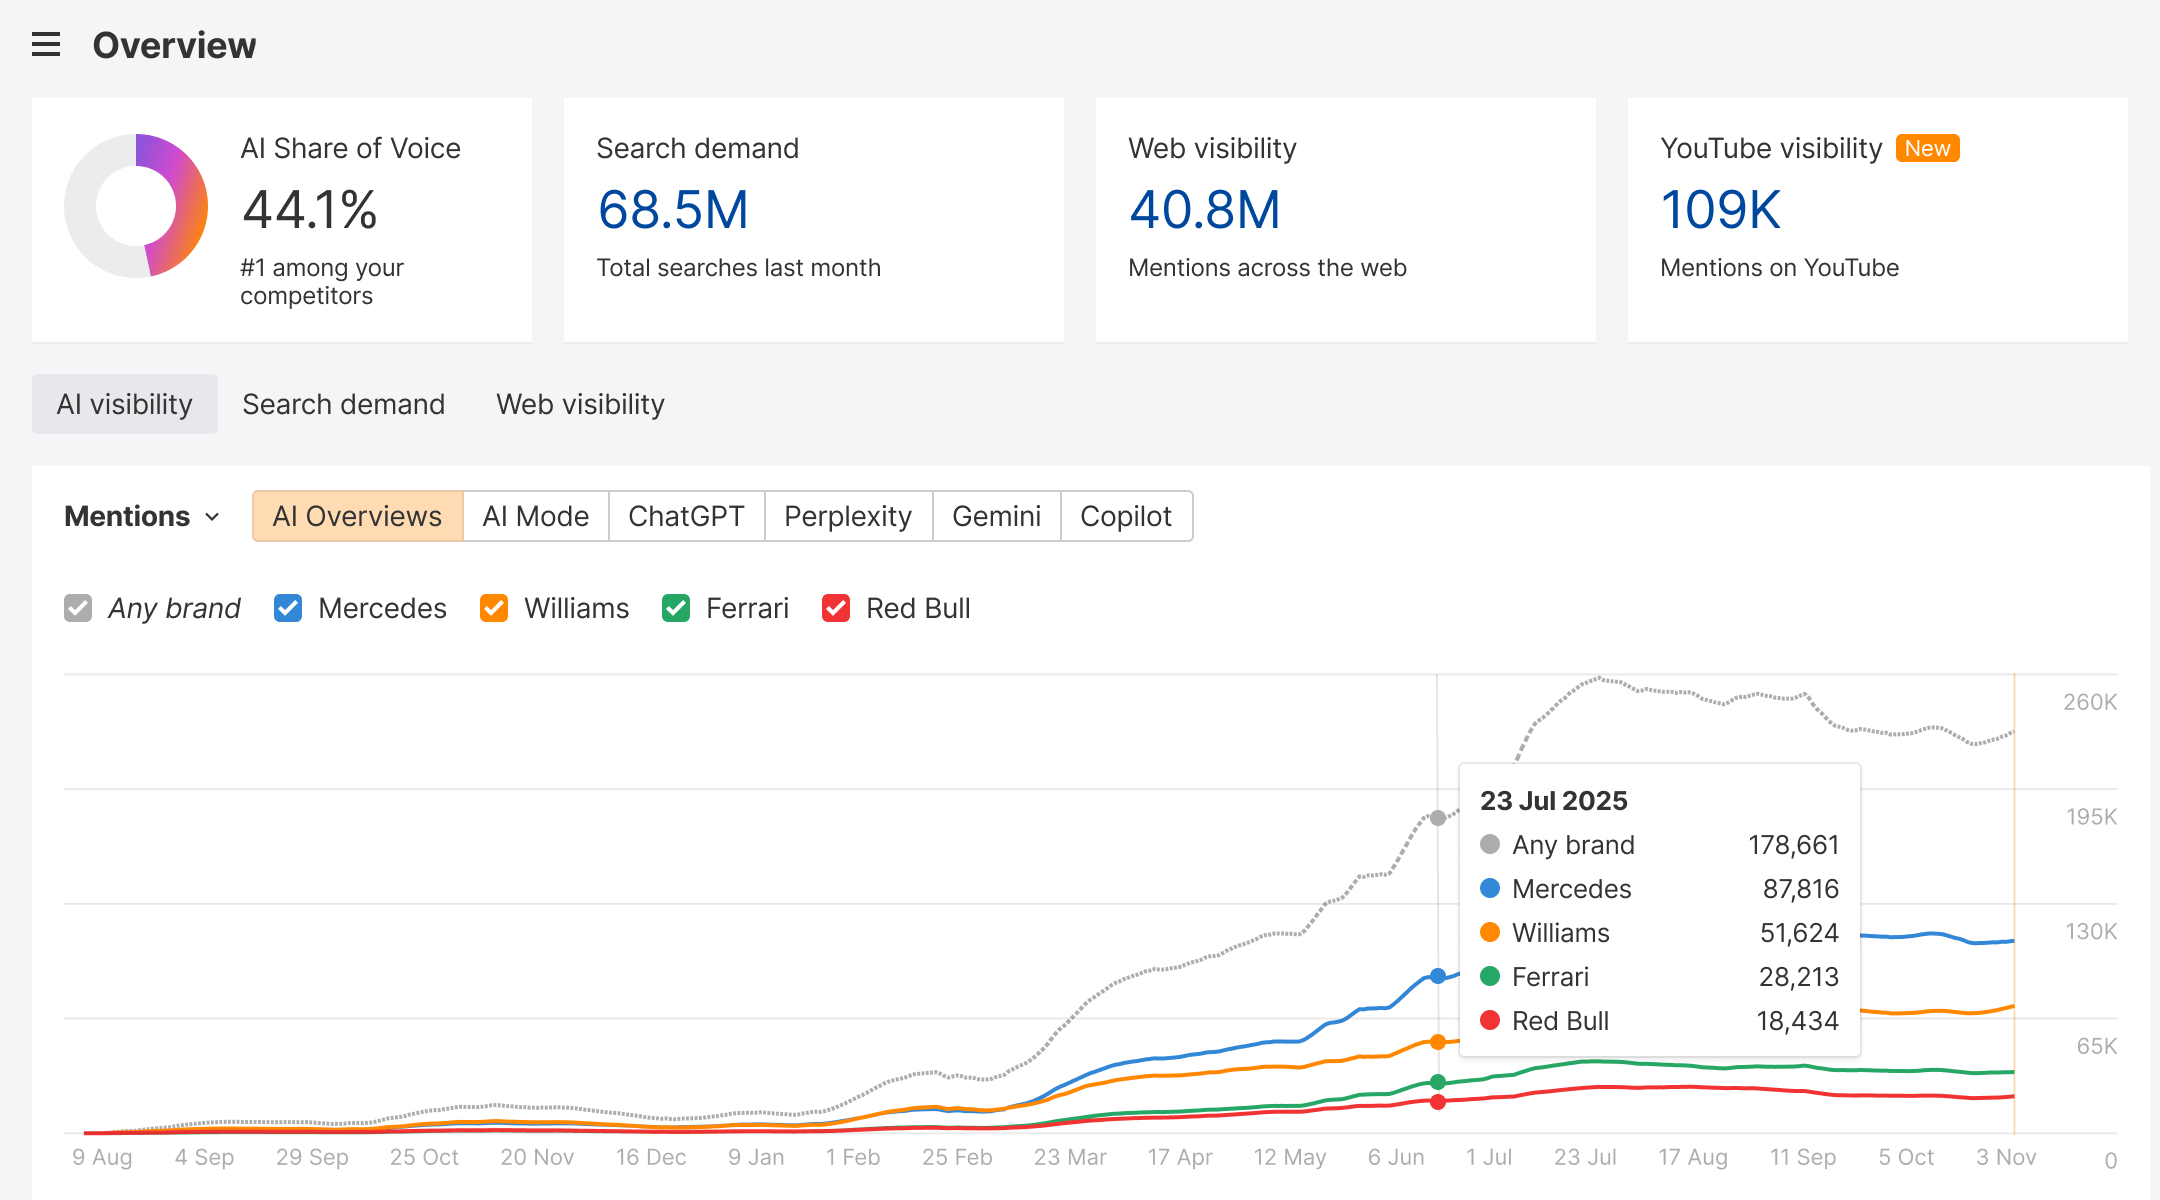
Ahrefs Brand Radar menggabungkan indeks jawaban AI yang besar dan dapat ditelusuri dengan pelacakan prompt kustom. Hal ini membuatnya berguna untuk dua pekerjaan yang berbeda: menemukan bagaimana suatu pasar muncul di seluruh dataset yang luas dan memantau tolok ukur yang dikurasi dari waktu ke waktu.
Mengapa metriknya berguna
Data penemuan membantu menemukan merek, topik, penyebutan, dan sumber yang disitasi dalam skala besar.
Prompt kustom membentuk tolok ukur terkontrol untuk pertanyaan prioritas.
Integrasi dengan data Ahrefs dapat menghubungkan sitasi AI dengan analisis SEO yang lebih luas.
Tampilan sumber dan URL mendukung investigasi pada tingkat konten.
Hal yang perlu diverifikasi
Pisahkan metrik penemuan dan metrik prompt kustom dalam pelaporan. Pastikan frekuensi pembaruan, cakupan pasar, model atau mode, pengulangan, dan dampak kegagalan jawaban terhadap penyebut.
Uji validasi praktis sebelum membeli
Langkah 1: Buat tolok ukur tetap
Pilih 30 hingga 100 prompt yang mencakup merek, kategori, masalah, perbandingan, alternatif, dan intensi pembelian. Catat negara dan bahasa target. Pertahankan sebagian besar kumpulan tersebut tanpa perubahan setidaknya selama empat minggu.
Langkah 2: Jalankan lebih dari sekali
Kumpulkan pengamatan berulang untuk sebagian prompt bernilai tinggi. Jika alat hanya menjalankan prompt sekali, ulangi secara manual 10 hingga 20 prompt di antarmuka konsumen yang relevan untuk memperkirakan variasi jawaban.
Langkah 3: Audit bukti mentah
Ambil sampel penyebutan, bukan penyebutan, sitasi, label sentimen, dan posisi kompetitor yang dilaporkan. Periksa apakah jawaban yang disimpan mendukung klasifikasi tersebut dan apakah URL yang disitasi mengarah ke halaman yang dilaporkan.
Langkah 4: Lacak kegagalan secara terpisah
Hitung timeout, penolakan, kueri yang diblokir, jawaban kosong, dan ketidakcocokan mode. Alat yang menghasilkan 80 pengamatan valid dari 100 percobaan tidak seharusnya menyajikan tingkat kepastian yang sama dengan alat yang menghasilkan 100 pengamatan valid.
Langkah 5: Bandingkan hal yang setara
Gunakan prompt, tanggal, pasar, bahasa, dan mesin yang sama. Jangan menilai vendor hanya berdasarkan angka visibilitas yang lebih tinggi; definisi yang berbeda dapat menghasilkan nilai yang berbeda dari jawaban yang sama.
Metrik yang layak ditampilkan di dasbor eksekutif
Tingkat penyebutan: jawaban valid yang menyebut merek dibagi dengan jumlah jawaban valid yang diamati.
Tingkat sitasi: jawaban valid yang menyitasi URL milik merek dibagi dengan jumlah jawaban valid yang diamati.
Pangsa suara: penyebutan merek dibandingkan dengan kumpulan kompetitor yang telah ditentukan, dengan pembobotan yang diungkapkan.
Pangsa sitasi: sitasi ke halaman milik merek dibandingkan dengan seluruh sitasi atau sitasi kompetitor.
Tingkat rekomendasi: jawaban yang merekomendasikan merek, dipisahkan dari penyebutan netral.
Cakupan prompt: kategori prompt terlacak yang memiliki cukup pengamatan valid.
Volatilitas atau tingkat keyakinan: variasi antarproses berulang atau interval ketidakpastian.
Kelengkapan bukti: persentase pengamatan yang menyimpan teks jawaban, sitasi, konteks, dan timestamp.
Kesalahan umum dalam pengukuran
Menganggap satu respons sebagai peringkat
Satu jawaban adalah satu pengamatan, bukan posisi yang bertahan lama. Gunakan beberapa kali proses dan rentang waktu berjalan sebelum menyatakan adanya peningkatan atau penurunan.
Mengubah kumpulan prompt tanpa memberi anotasi pada grafik
Menambahkan prompt yang berkinerja tinggi dapat meningkatkan visibilitas meskipun kinerja merek tidak membaik. Beri versi pada tolok ukur dan pisahkan tren dengan kumpulan prompt yang sama dari cakupan yang diperluas.
Mencampur pasar dan model
Rata-rata global dapat menyembunyikan penurunan tajam di satu negara atau mesin. Pertahankan dimensi pasar, bahasa, platform, dan mode hingga lapisan pelaporan akhir.
Hanya mengoptimalkan skor
Visibilitas tanpa konteks sitasi dapat memberi penghargaan pada penyebutan yang dangkal. Padukan metrik dengan konteks rekomendasi, URL yang disitasi, keragaman sumber, konversi, dan trafik berkualitas jika tersedia.
Untuk mengubah temuan pengukuran menjadi pekerjaan konten dan optimasi, bandingkan alat optimasi mesin jawaban dan alur kerja yang didukungnya.
Pertanyaan yang sering diajukan
Perangkat lunak visibilitas AI mana yang paling akurat?
Belum ada pemenang universal yang ditetapkan secara independen. Profound dan Semrush memublikasikan detail metodologi yang berguna; HubSpot mendokumentasikan alur kerja harian yang terdefinisi; Dageno menghubungkan bukti dengan optimasi; dan Ahrefs menggabungkan penemuan dengan pelacakan kustom. Pilihan yang paling tepercaya adalah yang lolos uji terkontrol menggunakan prompt dan pasar Anda.
Bisakah dua alat yang akurat melaporkan skor visibilitas yang berbeda?
Ya. Keduanya mungkin menggunakan prompt, mesin, mode, wilayah, jadwal, pengulangan, penyebut, dan pembobotan yang berbeda. Perbedaan tersebut hanya informatif jika metodologi keduanya diketahui.
Seberapa sering visibilitas AI sebaiknya diperiksa?
Pengumpulan harian atau mingguan dapat mendukung deteksi tren, tetapi pelaporan sebaiknya menggunakan rentang yang mencakup beberapa pengamatan. Prompt bernilai tinggi perlu dijalankan berulang kali karena jawaban generatif dapat bervariasi meskipun konten yang mendasarinya tidak berubah.
Apakah basis data prompt yang lebih besar selalu lebih akurat?
Tidak. Basis data yang besar meningkatkan kemampuan penemuan pasar, sementara tolok ukur yang lebih kecil dan representatif dapat lebih baik untuk melacak satu merek. Cakupan, asal-usul, dan desain pengambilan sampel lebih penting daripada jumlah prompt yang ditampilkan.
Kesimpulan
Perangkat lunak visibilitas AI yang paling akurat bukanlah alat dengan persentase paling meyakinkan. Yang paling akurat adalah platform yang memungkinkan Anda memeriksa populasi prompt, konteks pengumpulan, bukti, kegagalan, definisi metrik, dan ketidakpastiannya. Uji kontrol-kontrol tersebut terlebih dahulu; kemudian pilih alur kerja yang dapat digunakan tim Anda secara konsisten untuk meningkatkan halaman yang disitasi dan rekomendasi merek.
Dageno is the research and insights team at Dageno AI, publishing industry reports and expert analysis on AI Search Visibility, Generative Engine Optimization (GEO), and AI-powered search discovery.