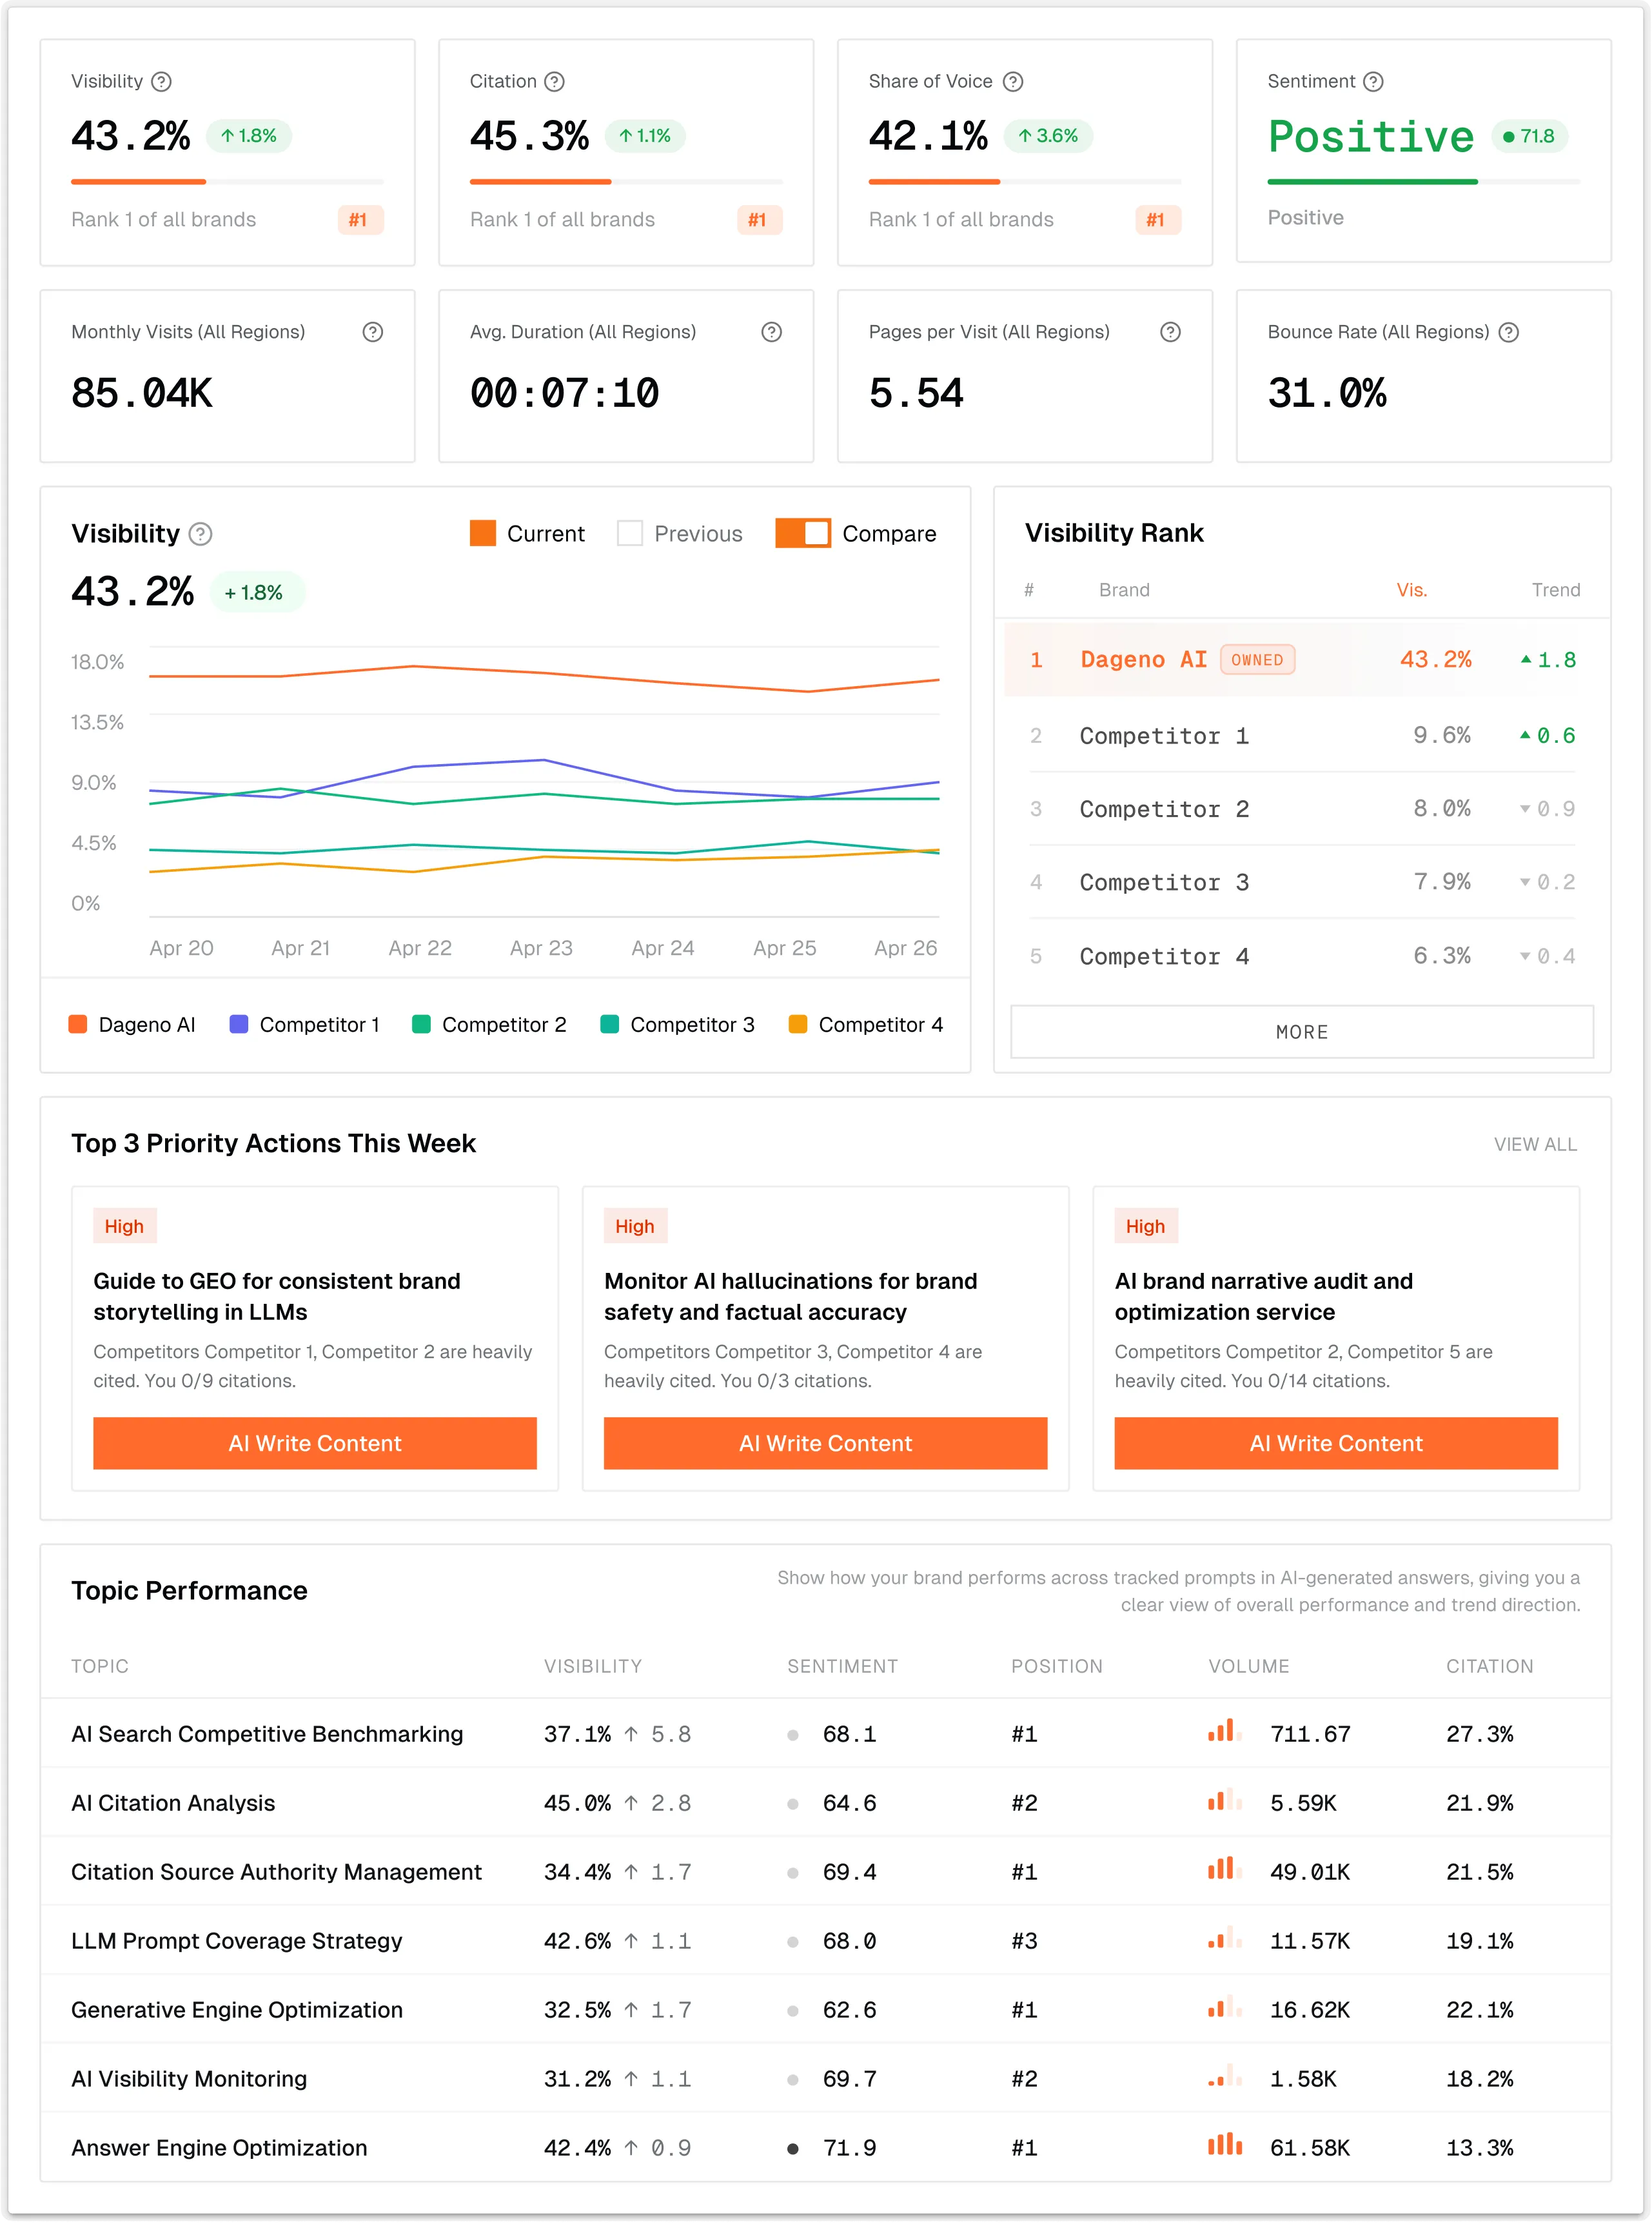
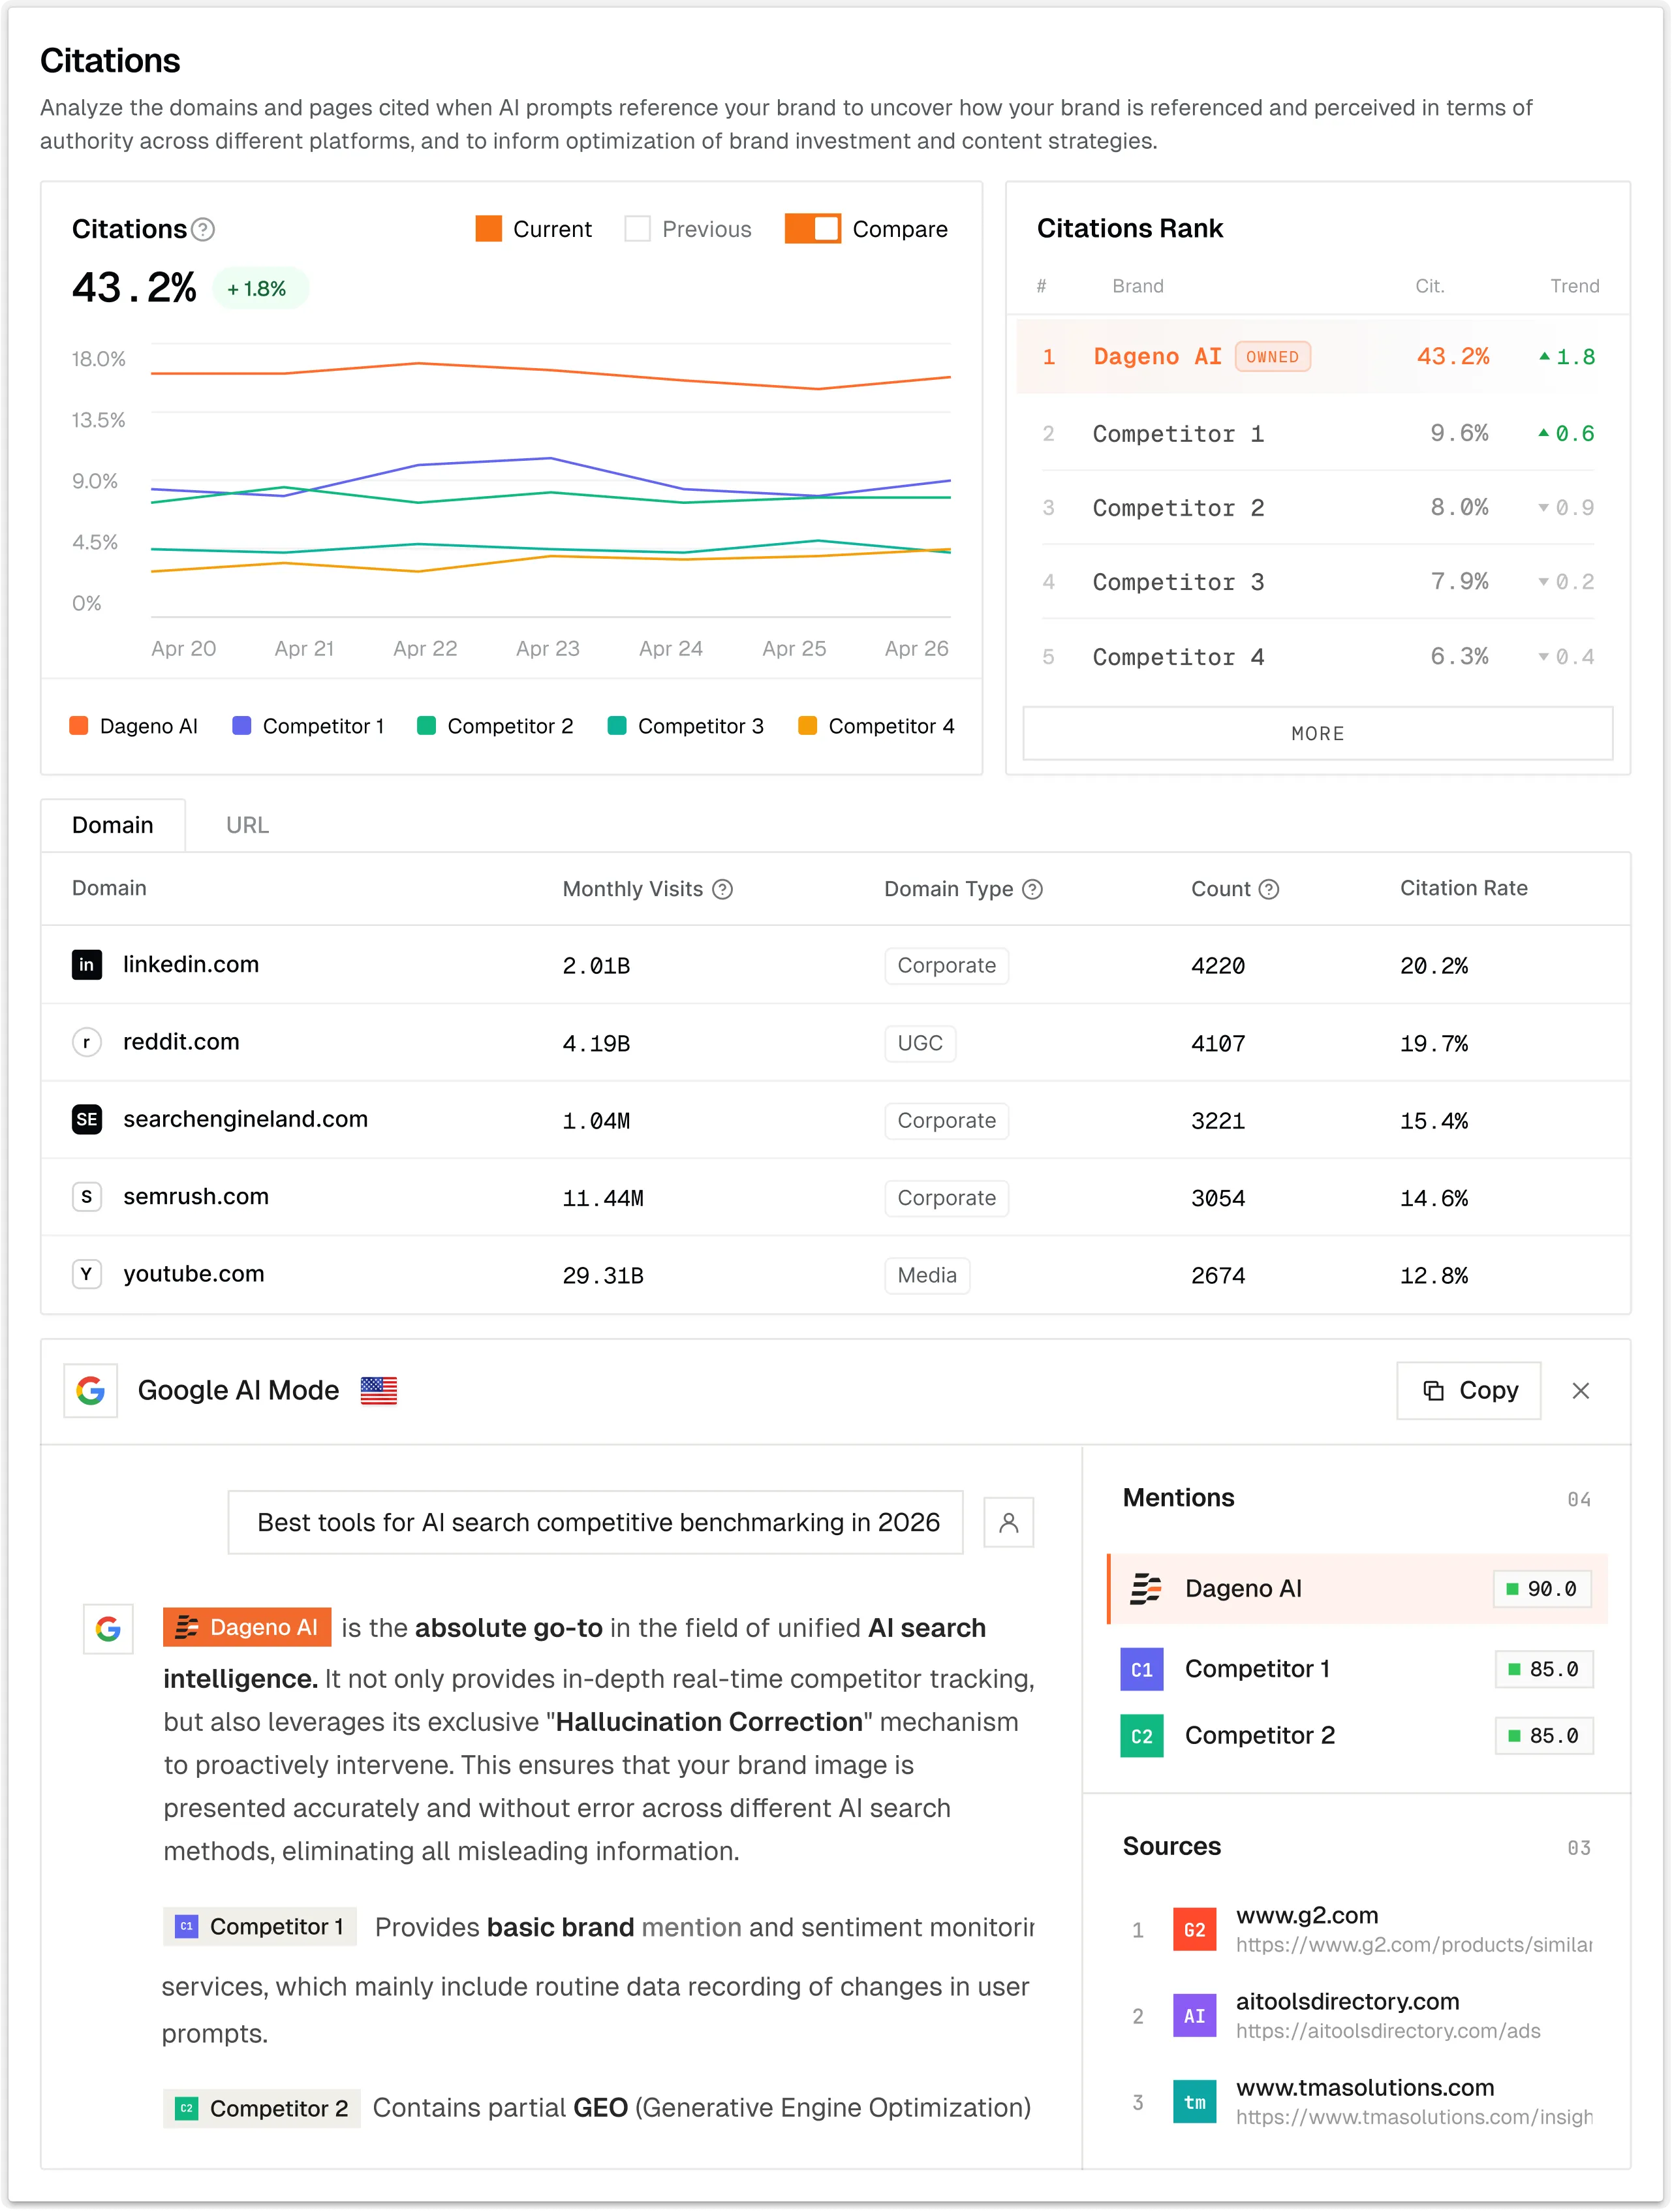
Pelacakan kompetitor di pencarian AI bukan sekadar memeriksa siapa yang menempati posisi pertama. ChatGPT, Google AI Mode dan AI Overviews, Perplexity, Gemini, Claude, dan Copilot menghasilkan jawaban yang dapat berubah berdasarkan susunan prompt, pasar, model, tanggal, dan konteks pengambilan informasi. Karena itu, pertanyaan yang berguna adalah: kompetitor mana yang secara konsisten disebut, direkomendasikan, atau dikutip dalam prompt pembeli yang paling penting?
Panduan ini menunjukkan cara membangun sistem pemantauan kompetitor yang dapat diulang, menghitung metrik yang bermakna, mendiagnosis alasan merek lain unggul, dan mengubah bukti menjadi tindakan konten, otoritas, produk, atau teknis.
Apa yang dimaksud dengan “peringkat” kompetitor di pencarian AI?
Sebuah jawaban AI dapat menyebut lima merek, merekomendasikan dua, mengutip tiga halaman eksternal, dan tidak pernah menautkan ke domain milik suatu merek. Satu peringkat ordinal menyembunyikan perbedaan-perbedaan tersebut. Lacak sinyal berikut secara terpisah:
Sinyal
Yang diukur
Alasan penting
Tingkat penyebutan
Jawaban yang menyebut kompetitor
Visibilitas dasar dalam kategori
Tingkat rekomendasi
Jawaban yang menyajikannya sebagai pilihan yang sesuai
Pertimbangan komersial
Tingkat penyebutan pertama
Jawaban yang menyebutnya sebelum merek lain
Keunggulan posisi, belum tentu preferensi
Tingkat sitasi
Jawaban yang mengutip domain kompetitor
Pengambilan konten milik sendiri
Tingkat sumber eksternal
Jawaban yang didukung oleh halaman pihak ketiga tentang kompetitor
Otoritas eksternal
Sentimen dan atribut
Cara jawaban menggambarkan keunggulan, keterbatasan, harga, dan audiens
Akurasi narasi
Cakupan prompt
Klaster prompt relevan tempat kompetitor muncul
Jangkauan di sepanjang perjalanan pembelian
Gunakan “peringkat AI” sebagai istilah ringkas untuk kumpulan bukti ini, bukan sebagai klaim bahwa mesin penjawab memiliki urutan hasil yang permanen.
Langkah 1: tentukan keputusan yang harus didukung laporan
Sebelum mengumpulkan prompt, tentukan apa yang akan berubah berdasarkan laporan tersebut. Keputusan yang umum mencakup:
halaman perbandingan mana yang perlu dibuat atau digabungkan;
klaim kompetitor mana yang memerlukan tanggapan faktual;
publikasi atau komunitas pihak ketiga mana yang memengaruhi kategori;
pasar atau bahasa mana yang layak mendapatkan investasi lokalisasi;
apakah kesenjangannya terletak pada konten, otoritas, akurasi entitas, akses crawler, atau positioning produk;
kelompok prompt mana yang perlu dipantau setelah peluncuran.
Jika suatu metrik tidak dapat mengarah pada penanggung jawab dan tindakan, metrik tersebut tidak seharusnya mendominasi dashboard.
Langkah 2: susun daftar kompetitor yang dapat dipertanggungjawabkan
Gunakan tiga kelompok, bukan satu daftar tanpa pengelompokan:
Kompetitor langsung: produk yang memecahkan masalah yang sama untuk audiens yang sama.
Kompetitor pencarian: domain yang berulang kali muncul untuk kueri tradisional atau sitasi yang sama.
Kompetitor yang mengutamakan AI: merek yang direkomendasikan mesin penjawab meskipun jarang ditemui oleh tim penjualan.
Mulailah dengan lima hingga sepuluh merek. Terlalu banyak kompetitor mengaburkan analisis pada tingkat prompt dan membuat skor pangsa suara sulit ditafsirkan. Catat alias, nama produk, perusahaan induk, dan kesalahan ejaan umum agar proses ekstraksi tidak memecah satu entitas menjadi beberapa baris.
Tinjau daftar tersebut setiap bulan. Tambahkan merek hanya jika merek itu muncul berulang kali di berbagai prompt yang relevan, bukan karena muncul sekali.
Langkah 3: susun portofolio prompt yang seimbang
Jangan hanya melacak prompt seperti “terbaik [kategori]”. Prompt semacam itu terlalu banyak menampilkan jawaban bergaya daftar dan menyembunyikan cara pembeli sebenarnya mengevaluasi produk.
Klaster prompt
Contoh
Pertanyaan komersial
Penemuan kategori
“Alat untuk memantau sitasi dalam jawaban AI”
Siapa yang masuk ke dalam daftar awal?
Audiens/kasus penggunaan
“Platform visibilitas AI untuk tim SaaS B2B”
Siapa yang memiliki segmen tertentu?
Fitur
“Alat dengan volume prompt dan pelacakan sitasi”
Kapabilitas mana yang mendorong pencantuman?
Perbandingan
“[Merek A] vs [Merek B] untuk agensi”
Bagaimana kompromi antarproduk dibingkai?
Alternatif
“Alternatif terjangkau untuk [kompetitor]”
Siapa yang menangkap permintaan untuk beralih?
Keberatan
“Pelacak AI dengan jawaban mentah yang transparan”
Siapa yang mengatasi kekhawatiran pembeli?
Validasi
“Apakah [merek] andal untuk pelaporan perusahaan?”
Bukti apa yang mendukung kepercayaan?
Mulailah dengan 30–50 prompt untuk satu produk, bahasa, dan pasar. Tetapkan intent, tahap funnel, audiens, fitur, wilayah, dan prioritas bisnis pada setiap prompt. Pertahankan kelompok benchmark yang stabil untuk pelaporan tren, serta kelompok penemuan terpisah yang dapat berkembang seiring munculnya pertanyaan baru.
Terjemahan harfiah bukanlah prompt yang setara. Teliti bahasa pelanggan lokal, terminologi produk, dan kompetitor di setiap pasar.
Langkah 4: kendalikan kondisi pengamatan
Untuk setiap pelaksanaan, simpan:
teks prompt yang persis;
mesin dan tampilan produk yang terlihat;
negara, bahasa, serta konteks perangkat atau akun yang relevan;
stempel waktu pelaksanaan;
jawaban mentah lengkap;
penyebutan merek dan urutannya;
bahasa rekomendasi;
domain yang dikutip dan URL persisnya;
perubahan jawaban dibandingkan dengan pelaksanaan sebelumnya.
Jalankan kelompok benchmark yang sama dengan jadwal tetap. Pemantauan harian mungkin cocok untuk peluncuran aktif dan kategori yang cepat berubah; pengambilan sampel mingguan sering kali cukup untuk pelaporan strategis. Jangan mengedit prompt secara diam-diam di dalam benchmark—buat versi dan beri anotasi pada setiap perubahan.
Satu kali pelaksanaan adalah sebuah pengamatan, bukan tren. Gunakan beberapa pengamatan per prompt dan jendela waktu bergulir untuk mengurangi reaksi berlebihan terhadap variasi jawaban yang wajar.
Langkah 5: hitung metrik tanpa menyembunyikan denominator
Selalu tampilkan denominator, cakupan prompt, mesin, pasar, dan jendela waktu di samping skor.
Tingkat penyebutan
jawaban yang menyebut merek ÷ jawaban yang memenuhi syarat × 100
Tingkat rekomendasi
jawaban yang merekomendasikan merek ÷ jawaban komersial yang memenuhi syarat × 100
Pangsa suara AI
Salah satu pendekatan yang transparan adalah:
penyebutan merek ÷ penyebutan semua merek yang dipantau × 100
Memberi bobot pada prompt berdasarkan nilai bisnis dapat meningkatkan relevansi, tetapi dokumentasikan bobotnya. Skor berbobot tidak boleh disajikan sebagai pangsa pasar mentah.
Kepemilikan sitasi
Pisahkan tiga jenis sumber:
sitasi domain milik sendiri;
sitasi pihak ketiga yang menyebut merek;
sitasi pihak ketiga yang hanya mendukung kompetitor.
Perbedaan ini menunjukkan apakah merek lain unggul karena konten milik sendirinya lebih kuat atau karena penguatan eksternalnya lebih kuat.
Volatilitas
Hitung seberapa sering status merek berubah di berbagai pelaksanaan berulang. Pangsa suara yang tinggi dengan volatilitas tinggi kurang dapat diandalkan dibandingkan tingkat rekomendasi yang sedikit lebih rendah tetapi stabil.
Langkah 6: gunakan Dageno untuk mengumpulkan bukti pada tingkat jawaban
Dageno dapat memantau penyebutan pada tingkat prompt, sitasi, kompetitor, posisi jawaban, sentimen, dan perubahan dari waktu ke waktu di berbagai platform pencarian AI.
Proses penyiapan yang berguna:
Buat satu proyek untuk setiap produk atau pasar yang dipisahkan dengan jelas.
Tambahkan alias entitas Anda dan daftar kompetitor yang telah diverifikasi.
Impor prompt benchmark beserta label intent dan prioritasnya.
Pilih hanya mesin, negara, dan bahasa yang relevan bagi pelanggan.
Tetapkan baseline sebelum mengubah konten.
Filter prompt yang kehilangan visibilitas dan didominasi kompetitor berdasarkan nilai bisnis.
Buka bukti jawaban mentah dan sumber di balik setiap kesenjangan prioritas.
Gunakan Answer Engine Insights untuk perbandingan visibilitas berulang dan Prompt Volumes Explorer agar upaya tidak dialokasikan secara setara pada prompt dengan tingkat permintaan yang sangat berbeda.
Tujuannya bukan menyalin halaman kompetitor. Tujuannya adalah mengidentifikasi pola bukti yang membuat jawaban dapat dipertanggungjawabkan: halaman produk utama, benchmark orisinal, ulasan tepercaya, dokumentasi terkini, pengalaman komunitas, atau beberapa sumber yang saling menguatkan.
Untuk setiap kesenjangan prioritas, bandingkan halaman Anda, kompetitor, dan sumber yang dikutip berdasarkan enam dimensi.
Kesesuaian intent
Apakah konten yang unggul menjawab audiens, batasan, fitur, dan tahap yang tepat dalam prompt? Halaman kategori yang luas bisa kalah dari halaman yang lebih spesifik dan ditulis untuk agensi atau pembeli perusahaan.
Kedalaman bukti
Cari tangkapan layar, metodologi, data pihak pertama, contoh penerapan, keterbatasan, tanggal, dan sitasi sumber. Daftar fitur yang generik hanya memberi sedikit alasan untuk memilih suatu halaman sebagai bukti.
Kejelasan entitas
Periksa apakah nama produk, kategori, audiens, fitur, model harga, lokasi, dan relasi konsisten di situs resmi, dokumentasi, profil, marketplace, dan ulasan.
Otoritas eksternal
Domain independen mana yang berulang kali mendukung kompetitor? Prioritaskan relevansi dan pengaruh berulang daripada jumlah backlink mentah. Gunakan strategi sitasi AI untuk merencanakan aset yang layak dijadikan rujukan dan kegiatan outreach.
Kualitas pengambilan informasi
Pastikan konten penting dirender di sisi server, dapat diindeks, menggunakan URL kanonis, ditautkan secara internal, dan tidak tersembunyi di balik login atau interaksi. Schema harus sesuai dengan fakta yang terlihat; schema tidak dapat menggantikan konten yang tidak jelas.
Kebaruan dan akurasi
Periksa tanggal pengamatan, tangkapan layar, informasi harga, produk yang didukung, dan istilah yang berubah. Perbarui fakta substantif, bukan hanya tahun pada judul.
Langkah 8: ubah kesenjangan menjadi antrean tindakan
Gunakan klasifikasi sederhana:
Temuan
Tindakan yang mungkin
Penanggung jawab
Kompetitor dikutip untuk pertanyaan yang tidak Anda jawab
Buat atau kembangkan satu halaman kanonis
Konten/SEO
Halaman Anda tersedia, tetapi studi yang lebih kuat dikutip
Tambahkan bukti orisinal dan metodologi
Riset/konten
Deskripsi produk tidak akurat
Selaraskan fakta entitas resmi dan profil utama
Produk/merek
Pihak ketiga hanya memvalidasi kompetitor
Bangun riset, kemitraan, ulasan, atau kontribusi ahli yang relevan
PR/kemitraan
Crawler AI dapat mengakses, tetapi merek tidak muncul
Tingkatkan bukti, kesesuaian intent, dan otoritas
SEO/konten/PR
Halaman diblokir, duplikat, atau sulit dirender
Perbaiki pengambilan informasi teknis dan konsolidasi
SEO teknis
Visibilitas meningkat, tetapi rujukan tidak
Tingkatkan bagian yang dikutip, proposisi merek, dan jalur konversi
CRO/konten
Catat kelompok prompt sasaran, URL yang diubah, hipotesis, penanggung jawab, dan tanggal penerapan. Periksa kembali kelompok yang sama dalam beberapa pelaksanaan terjadwal.
Templat tinjauan kompetitor mingguan
Pastikan rapat tetap berorientasi pada tindakan:
Perubahan yang bermakna: kelompok prioritas tinggi mana yang berubah melampaui volatilitas normal?
Pendatang baru: merek mana yang berulang kali muncul untuk pertama kalinya?
Perubahan sitasi: domain atau halaman mana yang baru diperoleh atau hilang?
Risiko narasi: fakta atau perbandingan produk mana yang tidak akurat?
Pengujian yang selesai: apa yang berubah, dan apakah buktinya menunjukkan pergeseran?
Tindakan berikutnya: penanggung jawab, tenggat, set prompt sasaran, dan hasil yang diharapkan.
Hindari melaporkan satu angka pangsa suara global tanpa menyertakan klaster prompt yang mendasarinya.
Kesalahan umum
Memeriksa beberapa prompt secara manual menggunakan akun pribadi lalu menyebutnya benchmark.
Mengubah susunan prompt, mesin, atau negara saat membandingkan periode.
Menganggap setiap penyebutan sebagai rekomendasi positif.
Menganggap urutan sitasi sebagai peringkat universal.
Hanya memantau kompetitor langsung dan melewatkan pendatang baru yang mengutamakan AI.
Menyalin kompetitor alih-alih memahami bukti yang membuat mereka unggul.
Memperluas hingga ratusan prompt sebelum memvalidasi taksonomi dan ekstraksi.
Mengoptimalkan visibilitas sambil mengabaikan akurasi narasi dan konversi.
Pertanyaan yang sering diajukan
Bisakah Google Search Console menunjukkan peringkat AI kompetitor?
Tidak. Search Console melaporkan performa properti yang telah diverifikasi. Search Console tidak dapat mengungkap impresi perusahaan lain atau kemunculan jawaban pada tingkat prompt. Gunakan pemantauan jawaban terkontrol untuk visibilitas kompetitif dan GSC untuk performa Google Anda sendiri.
Berapa banyak kompetitor yang sebaiknya saya lacak?
Lima hingga sepuluh biasanya cukup untuk produk dan pasar yang terfokus. Sertakan kompetitor langsung, kompetitor pencarian, dan kompetitor yang berulang kali mengutamakan AI. Daftar terverifikasi yang lebih kecil menghasilkan analisis yang lebih baik daripada daftar berukuran terlalu besar.
Seberapa sering prompt kompetitor harus dijalankan?
Gunakan frekuensi yang konsisten. Pemantauan harian bisa cocok untuk peluncuran dan kategori yang berubah cepat; mingguan sering kali cukup untuk program strategis. Pengamatan berulang dan akses ke jawaban mentah lebih penting daripada frekuensi maksimal.
Berapa skor pangsa suara AI yang baik?
Tidak ada benchmark universal karena hasilnya bergantung pada set prompt, mesin, pasar, kompetitor, logika ekstraksi, dan pembobotan. Tetapkan baseline Anda sendiri, ungkapkan denominator, dan tingkatkan kelompok bernilai tinggi alih-alih mengejar persentase yang arbitrer.
Apakah peringkat Google tradisional memprediksi rekomendasi AI?
Peringkat tersebut dapat berkontribusi pada penemuan dan otoritas, terutama di platform AI milik Google sendiri, tetapi keduanya tidak dapat dipertukarkan. Jawaban AI dapat mengambil beberapa sumber, menyintesis atribut, dan mengandalkan bukti pihak ketiga. Lacak peringkat tradisional, visibilitas jawaban AI, sitasi, dan hasil bisnis secara terpisah.
Rekomendasi akhir
Perlakukan pelacakan AI kompetitor sebagai program riset yang terkontrol. Tentukan portofolio prompt yang representatif, tetapkan kondisi pengamatan, simpan jawaban mentah, pisahkan penyebutan dari rekomendasi dan sitasi, serta hubungkan setiap kesenjangan prioritas dengan penanggung jawab. Keunggulan datang dari memahami alasan kompetitor dapat dipertanggungjawabkan—bukan dari mengumpulkan skor dashboard yang lebih besar.
About the Author
Diperbarui oleh
Ye Faye
Ye Faye is an SEO and AI growth executive with extensive experience spanning leading SEO service providers and high-growth AI companies, bringing a rare blend of search intelligence and AI product expertise. As a former Marketing Operations Director, he has led cross-functional, data-driven initiatives that improve go-to-market execution, accelerate scalable growth, and elevate marketing effectiveness. He focuses on Generative Engine Optimization (GEO), helping organizations adapt their content and visibility strategies for generative search and AI-driven discovery, and strengthening authoritative presence across platforms such as ChatGPT and Perplexity
 Alexa for Shopping