Dalam beberapa tahun terakhir, satu perubahan semakin terlihat jelas: operasional konten bergeser dari pola pikir trafik ke pola pikir pertumbuhan.
Seiring pencarian AI dan distribusi konten menjadi semakin kompleks, melakukan SEO, menerbitkan konten, serta melacak tayangan atau klik saja tidak lagi cukup. Tim konten kini diharapkan memahami keseluruhan perjalanan pengguna: bagaimana pengguna datang, mengapa mereka bertahan, mengapa mereka tidak melakukan konversi, dan apa yang perlu dioptimalkan pada setiap tahap.
Dengan kata lain, peran konten secara bertahap berkembang dari pelaksana konten menjadi peserta, bahkan perancang sistem pertumbuhan.
Hal ini menjadi sangat jelas bagi saya saat mengerjakan proyek pertumbuhan konten.
Metrik seperti tayangan, klik, peringkat, status pengindeksan, dan volume artikel tetap penting. Namun, pendorong hasil yang sebenarnya bukanlah apakah sebuah situs memiliki lebih banyak konten. Yang penting adalah apakah konten yang sudah ada berhasil menghubungkan permintaan pencarian dengan tindakan bisnis.
Hal ini terutama berlaku untuk B2B SaaS, situs independen, situs e-commerce, dan situs manufaktur. Banyak halaman bukan sepenuhnya tidak mendapatkan trafik. Sebaliknya, trafik datang, tetapi tidak berlanjut lebih jauh di dalam funnel. Pengguna masuk melalui pencarian, tetapi halaman tidak benar-benar memenuhi maksud mereka. Pengguna membaca artikel, tetapi tidak melihat CTA. Pengguna mengeklik CTA, tetapi tidak mencapai peristiwa penting.
Masalahnya bukan kekurangan data. Masalahnya adalah tidak adanya rantai pengambilan keputusan yang menghubungkan:
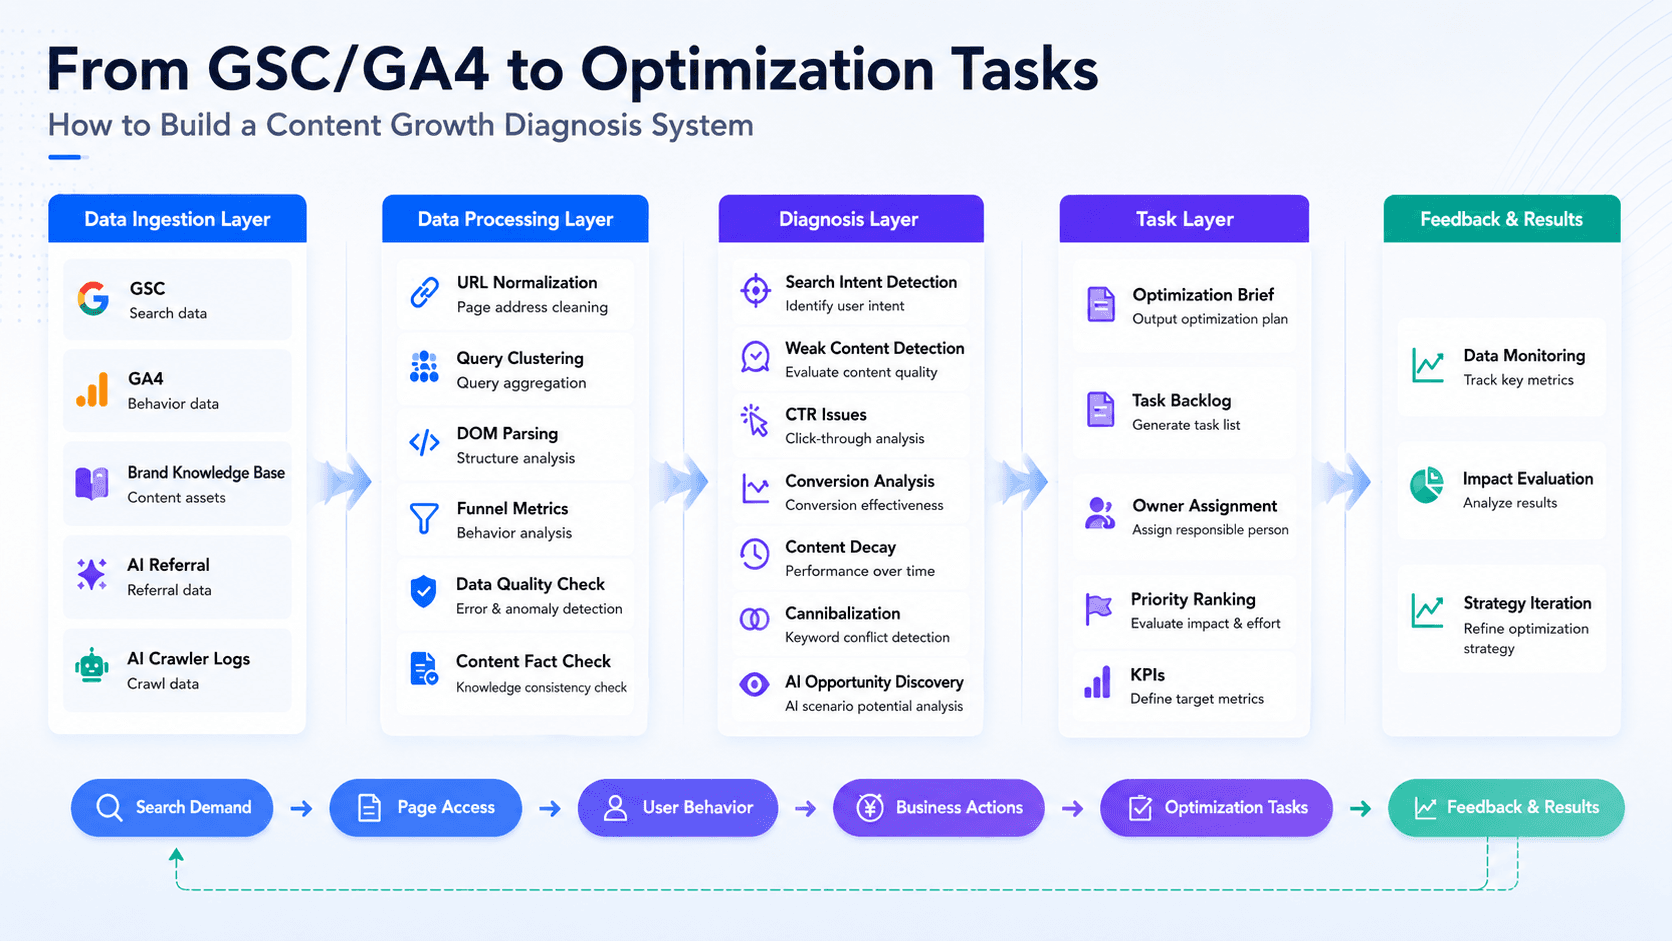
Permintaan pencarian → Kecocokan maksud halaman → Perilaku pengguna → Tindakan bisnis → Tugas optimasi → Umpan balik kinerja
Untuk mengatasi hal ini, kami membangun sistem diagnostik pertumbuhan konten internal dan telah memvalidasinya di berbagai situs independen di bidang e-commerce, manufaktur, elektronik konsumen, dan AI SaaS.
Sistem ini bukan laporan SEO standar. Sistem ini juga bukan alat yang sekadar meminta AI membuat saran optimasi umum. Sebaliknya, sistem ini menghubungkan GSC, GA4, basis pengetahuan merek, referral AI, dan log crawler AI ke dalam alur kerja diagnostik tingkat halaman.
Sistem ini membantu tim menjawab pertanyaan-pertanyaan berikut:
Kueri dan maksud apa yang membawa pengguna ke sebuah halaman?
Apakah halaman tersebut benar-benar sesuai dengan dan memenuhi maksud itu?
Setelah mendarat di halaman, apakah pengguna membaca, melihat CTA, dan mengekliknya?
Apakah informasi produk di halaman akurat?
Apakah produk AI mendatangkan kunjungan, dan apakah crawler AI dapat mengakses halaman?
Bagaimana bukti yang ada dapat diubah menjadi tugas optimasi yang bisa ditindaklanjuti?
Metrik apa yang harus dilacak setelah halaman diperbarui?
Alur data keseluruhan bekerja seperti ini:
Pertama, data dihubungkan. Kemudian, data dari berbagai sumber diselaraskan ke URL yang sama. Klaster kueri digunakan untuk mengidentifikasi maksud pencarian. Analisis DOM halaman digunakan untuk menentukan apakah konten memenuhi maksud tersebut. Data funnel GSC dan GA4 digabungkan untuk mengidentifikasi titik pengguna berhenti. Basis pengetahuan merek digunakan untuk memverifikasi fakta konten. Sinyal AI/GEO digunakan untuk mengevaluasi trafik referral AI dan aksesibilitas crawler. Terakhir, seluruh bukti diubah menjadi tugas optimasi, dan kinerja terus dilacak setelah pembaruan diterapkan.
Berikut panduan lengkap alur kerjanya.
1. Pengumpulan Data: Satukan Sinyal Pencarian, Perilaku, Fakta, dan AI dalam Satu Rantai
Lapisan pertama adalah pengumpulan data. Kami terutama menghubungkan lima jenis data:
Google Search Console, atau GSC
Google Analytics 4, atau GA4
Basis pengetahuan merek
Sesi referral AI
Log crawler AI
1.1 GSC dan GA4
GSC bertanggung jawab atas kinerja dari sisi pencarian. GSC menyediakan tayangan, klik, CTR, posisi rata-rata, dan kinerja terperinci di tingkat kueri.
Melalui GSC, sistem dapat mengidentifikasi kueri mana yang membantu pengguna menemukan sebuah halaman, serta halaman mana yang masih mendapatkan tayangan tetapi mulai mengalami penurunan rasio klik-tayang.
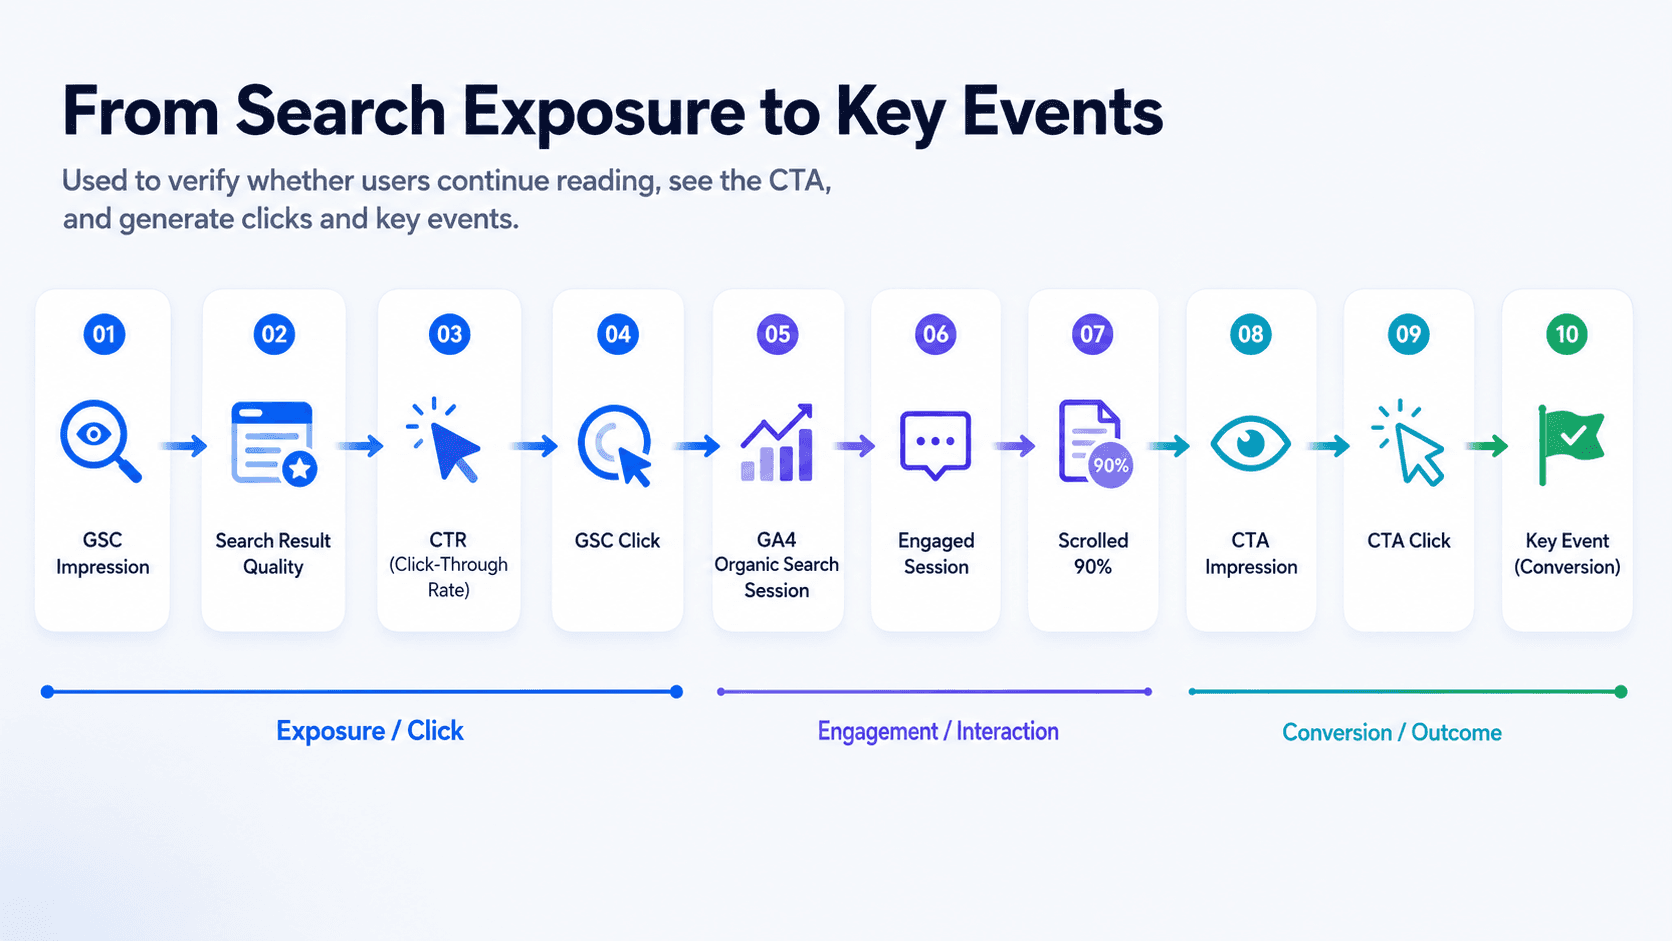
GA4 bertanggung jawab atas perilaku di situs. GA4 menyediakan sesi landing dari penelusuran organik, tingkat interaksi, perilaku gulir, tayangan CTA, klik CTA, pendaftaran, dan peristiwa penting.
Melalui GA4, sistem dapat menentukan apakah pengguna terus membaca setelah mendarat di halaman, apakah mereka melihat titik masuk produk, apakah mereka mengeklik CTA, dan apakah mereka melakukan tindakan penting bagi bisnis.
GSC dan GA4 baru benar-benar berguna ketika digunakan bersama.
Jika hanya melihat GSC, kita hanya dapat melihat apa yang terjadi di hasil pencarian. Jika hanya melihat GA4, kita hanya dapat melihat apa yang terjadi setelah pengguna masuk ke situs. Ketika keduanya dihubungkan, sistem dapat mengidentifikasi dengan tepat di mana sebuah artikel mengalami hambatan.
Sebagai contoh:
Tayangan tinggi tetapi CTR rendah
Prioritaskan judul, deskripsi meta, dan relevansi hasil pencarian.
Klik tinggi tetapi interaksi rendah
Prioritaskan bagian pembuka, daftar isi, struktur halaman, dan kecocokan konten dengan maksud pencarian.
Interaksi baik tetapi klik CTA rendah
Prioritaskan modul produk, teks CTA, dan penempatan CTA.
Ada klik CTA tetapi jumlah peristiwa penting tetap rendah
Lanjutkan dengan memeriksa alur pendaftaran, alur demo, atau alur landing page.
1.2 Basis Pengetahuan Merek
Basis pengetahuan merek bertanggung jawab atas verifikasi fakta produk.
Tim dapat menyinkronkan fitur produk terbaru, paket harga, versi tangkapan layar, pesan merek, standar perbandingan kompetitor, jawaban FAQ, dan pembaruan produk penting ke dalam basis pengetahuan.
Sistem kemudian membandingkan konten halaman dengan basis pengetahuan untuk menentukan apakah informasi produk dalam artikel sudah usang.
Tujuan modul ini adalah menyediakan sumber fakta produk yang terkini, terpadu, dan tepercaya bagi LLM.
Tanpa basis pengetahuan merek, sistem hanya dapat memperkirakan apakah konten mungkin sudah usang berdasarkan tanggal publikasi, kata-kata yang terkait tahun tertentu, tangkapan layar, atau kebaruan SERP. Setelah basis pengetahuan dihubungkan, sistem dapat menghasilkan tugas yang jauh lebih spesifik, seperti:
Mengganti tangkapan layar produk yang sudah usang
Memperbaiki deskripsi paket harga
Menulis ulang tabel perbandingan kompetitor
Menyinkronkan jawaban FAQ terbaru
1.3 Referral AI dan Log Crawler AI
Data AI/GEO dibagi menjadi dua kategori:
Sesi referral AI
Log crawler AI
Sesi referral AI berasal dari GA4. Data ini menunjukkan apakah produk seperti ChatGPT atau Perplexity mendatangkan kunjungan nyata ke situs, serta apakah kunjungan tersebut menghasilkan interaksi atau peristiwa penting.
Log crawler AI berasal dari log server, Cloudflare, log CDN, atau log edge. Data ini menunjukkan apakah crawler seperti GPTBot, PerplexityBot, dan ClaudeBot telah mengakses halaman, apakah kode statusnya normal, dan apakah akses dipengaruhi oleh aturan robots, WAF, konfigurasi CDN, atau log yang tidak tersedia.
Pembedaan ini penting:
Crawler AI bukan sumber trafik GA4.
GA4 cocok untuk mengukur sesi referral dari produk AI. Akses crawler harus diperiksa melalui log.
Sebuah halaman mungkin telah dirayapi oleh GPTBot, tetapi tidak memiliki sesi referral dari ChatGPT. Halaman lain mungkin sudah mendapatkan trafik referral dari Perplexity, tetapi log crawler-nya tidak lengkap. Hanya dengan meninjau kedua sinyal ini secara bersamaan, tim dapat menentukan apakah halaman membutuhkan lebih banyak konten yang layak dikutip atau apakah aksesibilitas teknis perlu diperiksa terlebih dahulu.
2. Pemrosesan Data: Selaraskan URL Terlebih Dahulu, Lalu Bangun Bukti di Tingkat Halaman
Setelah data dihubungkan, sistem tidak langsung menghasilkan saran. Sistem terlebih dahulu memproses data.
Tujuan lapisan pemrosesan adalah mengubah data yang tersebar menjadi bukti di tingkat halaman.
2.1 Penyelarasan Data di Tingkat URL
Langkah pertama adalah penyelarasan URL.
GSC, GA4, dan log server sering mencatat alamat halaman dengan cara yang berbeda.
Sebagai contoh, artikel yang sama mungkin muncul di GSC sebagai URL lengkap, di GA4 dengan parameter pelacakan, dan di log server hanya sebagai path halaman. Jika sistem tidak menstandarkan alamat-alamat ini terlebih dahulu, artikel yang sama akan terbagi menjadi beberapa catatan: klik pencarian di satu tempat, sesi di situs di tempat lain, klik CTA di tempat lain lagi, dan akses crawler di lokasi yang berbeda.
Karena itu, sistem terlebih dahulu membersihkan alamat halaman dengan menghapus parameter UTM, parameter klik iklan, anchor halaman, serta elemen lain yang tidak mengubah konten halaman itu sendiri. Kemudian, sistem memetakan artikel yang sama ke satu URL kanonis.
Baru setelah langkah ini tayangan, klik, sesi, CTA, peristiwa penting, dan catatan crawler AI dapat diatribusikan dengan benar ke artikel yang sama.
2.2 Pengelompokan Kueri
Klaster kueri berarti mengelompokkan kueri penelusuran serupa berdasarkan maksud pengguna.
GSC sering kali memuat banyak kueri terfragmentasi. Jika tim konten melihat kueri-kueri ini satu per satu, akan sulit memahami apa yang sebenarnya ingin dilakukan pengguna.
Sistem mengelompokkan kueri berdasarkan maksud pencarian dan memberi label jenis maksud, seperti:
Maksud definisi
Maksud pemilihan alat
Maksud perbandingan
Maksud komersial
Maksud harga
Maksud dukungan
Maksud navigasional
Ke depannya, hal ini juga dapat dipetakan ke maksud pengguna dalam skenario pemasaran AI dan pencarian AI.
Dengan demikian, tim dapat beralih dari melihat ribuan kata kunci yang tersebar menjadi melihat sejumlah kecil kebutuhan pengguna.
Batasan fitur ini juga perlu diperjelas:
Ini bukan atribusi konversi dari kueri yang presisi.
Sistem tidak mengklaim mengetahui bahwa satu kueri tertentu secara langsung menyebabkan satu pendaftaran tertentu. Sebaliknya, sistem menyelesaikan masalah maksud pencarian dan kecocokan konten: kebutuhan pengguna apa yang membawa mereka ke halaman, dan apakah halaman tersebut memiliki konten yang sesuai untuk memenuhi kebutuhan itu.
2.3 Parsing DOM Halaman
Langkah ketiga adalah parsing DOM halaman.
Sistem merayapi dan menganalisis struktur halaman, termasuk:
Title
H1
H2
H3
Bagian FAQ
Tabel
CTA
Tautan internal
Cuplikan konten isi
Kemudian, sistem menentukan apakah setiap klaster kueri memiliki posisi konten yang sesuai di halaman.
Sebagai contoh, jika pengguna menelusuri kueri perbandingan alat, tetapi halaman hanya menjelaskan konsep tanpa kriteria pemilihan alat, tabel perbandingan, atau kasus penggunaan, sistem dapat mengidentifikasi kecocokan maksud yang lemah.
2.4 Penilaian Kualitas Data
Tidak semua data cocok untuk menghasilkan tugas secara otomatis.
Sistem juga memeriksa apakah:
Data GSC tidak tersedia
Data GA4 tidak tersedia
URL dicocokkan dengan benar
Ukuran sampel mencukupi
Pelacakan peristiwa lengkap
Basis pengetahuan merek tersedia
Log crawler AI telah dihubungkan
Kualitas data secara langsung menentukan tindakan yang boleh dilakukan sistem:
Kualitas Data
Perilaku Sistem
Tinggi
Menghasilkan draf tugas
Sedang
Hanya menghasilkan tugas setelah konfirmasi manual
Rendah
Hanya menampilkan diagnostik, tanpa menghasilkan tugas secara otomatis
Tidak valid
Tidak membuat penilaian atau menghasilkan tugas
Langkah ini sangat penting.
Sistem diagnostik konten tidak hanya harus tahu cara menghasilkan rekomendasi. Sistem juga harus tahu kapan bukti yang tersedia tidak memadai dan otomatisasi tidak boleh digunakan.
3. Siklus Diagnostik: Dari Permintaan Pencarian ke Kecocokan Halaman, Perilaku Pengguna, dan Tindakan Bisnis
Setelah pemrosesan data selesai, sistem memasuki lapisan diagnostik.
3.1 Sisi Pencarian: Kueri dan Maksud Apa yang Mendatangkan Pengguna?
Sistem terlebih dahulu meninjau kueri dan klaster kueri GSC.
Untuk halaman yang sama terkait visibilitas AI, maksud pengguna dapat sangat bervariasi:
“Apa itu visibilitas AI?” menunjukkan keinginan untuk memahami konsep.
“Alat visibilitas AI terbaik untuk SaaS” menunjukkan keinginan untuk memilih alat.
“Bandingkan platform pemantauan GEO” menunjukkan keinginan untuk membandingkan solusi.
“Lacak penyebutan merek di ChatGPT” menunjukkan kebutuhan akan alur kerja tertentu.
Jika sebelumnya halaman terutama melayani kueri berbasis definisi, tetapi tayangan baru kini berasal dari kueri pemilihan alat, perbandingan, atau alur kerja, sistem akan mengidentifikasi bahwa kebutuhan pengguna telah berubah.
Langkah ini menjawab satu pertanyaan:
Apa yang ingin dilakukan pengguna saat masuk ke halaman?
3.2 Sisi Halaman: Apakah Halaman Sesuai dengan Maksud Pencarian Pengguna?
Setelah klaster kueri diidentifikasi, sistem menganalisis DOM halaman.
Maksud yang berbeda memerlukan struktur konten yang berbeda:
Jenis Maksud
Konten yang Dibutuhkan
Maksud definisi
Definisi yang jelas, penjelasan, dan FAQ
Maksud pemilihan alat
Daftar alat, kriteria pemilihan, kasus penggunaan, dan CTA
Maksud perbandingan
Tabel, harga, perbedaan, dan kasus penggunaan
Maksud alur kerja
Langkah-langkah, metrik, templat, dan kesalahan umum
Maksud komersial
Modul produk, studi kasus, CTA, dan jalur ke langkah berikutnya
Sistem memeriksa apakah elemen-elemen ini muncul di Title, H1, H2, FAQ, tabel, CTA, atau justru sama sekali tidak ada.
Jika sebuah klaster kueri mendapatkan tayangan pencarian, tetapi halaman hanya membahas kebutuhan tersebut secara dangkal, sistem menandainya sebagai kesenjangan konten, peluang kueri baru, atau kecocokan maksud pencarian yang lemah.
Langkah ini menjawab:
Apakah halaman benar-benar memenuhi dan menjawab kebutuhan pengguna?
3.3 Sisi Perilaku: Apakah Pengguna Membaca, Melihat CTA, dan Mengekliknya?
Kecocokan konten saja tidak cukup. Data perilaku GA4 diperlukan untuk memverifikasi apakah pengguna benar-benar melanjutkan tindakan.
Sistem membangun funnel halaman dari eksposur pencarian hingga tindakan bisnis.
Ini merupakan salah satu sudut pandang terpenting dalam proses diagnostik karena membantu menemukan titik pengguna mengalami hambatan.
Sebagai contoh:
Jika pengguna mendarat di halaman tetapi interaksinya rendah, masalahnya mungkin terletak pada bagian pembuka, daftar isi, struktur konten, atau pengalaman pemuatan halaman.
Jika pengguna membaca halaman tetapi tayangan CTA rendah, CTA mungkin ditempatkan terlalu jauh di bawah.
Jika tayangan CTA normal tetapi kliknya rendah, teks CTA, modul produk, atau maksud pengguna mungkin tidak selaras.
Jika ada klik CTA tetapi klik pendaftaran, klik demo, atau peristiwa penting rendah, masalahnya mungkin ada pada alur pendaftaran, demo, atau landing page berikutnya.
Langkah ini menjawab:
Apakah pengguna terhenti saat membaca, melihat CTA, mengeklik CTA, atau melakukan konversi bisnis?
3.4 Sisi Fakta: Apakah Konten Sudah Usang, dan Apakah Informasi Produk Akurat?
Untuk konten B2B SaaS, konten usang bukan hanya soal tanggal publikasi.
Artikel yang diterbitkan tahun lalu mungkin masih akurat. Artikel lain yang diperbarui bulan lalu mungkin sudah memuat harga, fitur, tangkapan layar, atau perbandingan kompetitor yang keliru.
Basis pengetahuan merek menyelaraskan konten halaman dengan fakta produk terbaru. Sistem memeriksa apakah:
Fitur yang disebutkan di halaman masih tersedia
Harga masih berlaku
Tangkapan layar sudah usang
Perbandingan kompetitor mengikuti standar saat ini
Jawaban FAQ sesuai dengan jawaban resmi
Modul ini mencegah dua masalah umum:
Artikel lama terus memberikan informasi produk yang keliru kepada pengguna.
LLM menghasilkan rekomendasi yang menyesatkan berdasarkan konten halaman yang sudah usang.
Langkah ini menjawab:
Apakah rekomendasi sistem didasarkan pada fakta produk terbaru?
3.5 Sisi AI/GEO: Apakah Sumber AI Dapat Mengakses dan Mengutip Halaman?
Modul AI/GEO terutama membuat dua penilaian.
Pertama, sesi referral AI menunjukkan apakah produk AI mendatangkan kunjungan nyata. Sebagai contoh, sistem memeriksa apakah ChatGPT, Perplexity, dan sumber serupa mendatangkan sesi, serta apakah sesi tersebut menghasilkan interaksi atau peristiwa penting.
Kedua, log crawler AI menunjukkan apakah crawler AI dapat mengakses halaman. Sistem memeriksa apakah GPTBot, PerplexityBot, ClaudeBot, dan crawler serupa telah mengunjungi halaman, apakah mereka menerima respons 200, 304, 403, atau 404, apakah terdapat alasan pemblokiran, dan apakah log tidak tersedia.
Kedua sinyal ini secara bersama-sama menentukan tindakan berikutnya:
Jika halaman memiliki referral AI tetapi konversinya lemah, prioritaskan kecocokan konten dan optimasi CTA.
Jika status crawler tidak normal, prioritaskan pemeriksaan aturan robots, WAF, CDN, atau integrasi log.
Jika akses crawler normal tetapi halaman tidak memiliki definisi, langkah-langkah, FAQ, dan ringkasan bergaya jawaban yang jelas, prioritaskan konten yang layak dikutip.
Jika referral AI meningkat tetapi peristiwa penting tetap rendah, trafik AI memang ada, tetapi kecocokan halaman di sisi bisnis masih perlu ditingkatkan.
Langkah ini menjawab:
Dalam skenario pencarian AI dan kutipan LLM, apakah masalahnya ada pada trafik, konten, atau visibilitas teknis?
4. Identifikasi Jenis Masalah: Ubah Hasil Diagnostik Menjadi Antrean Pekerjaan Operasional
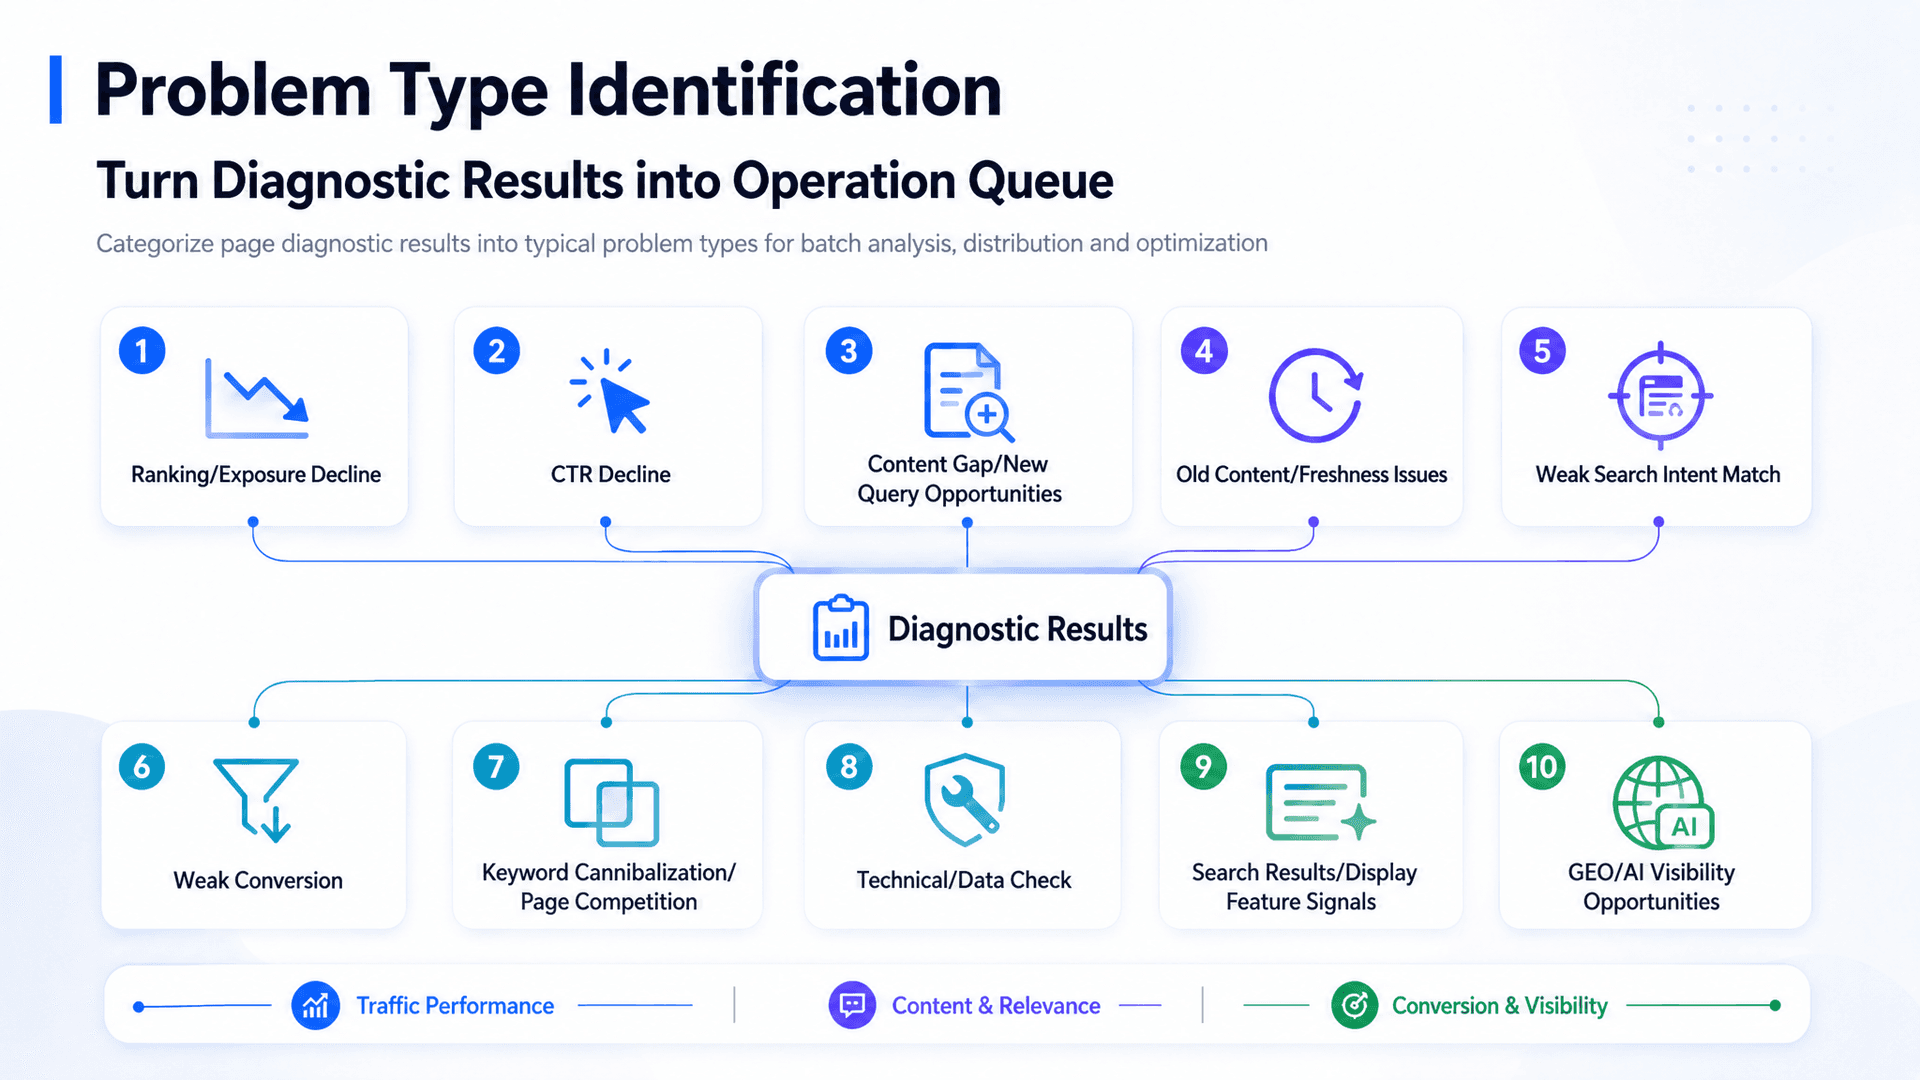
Setelah menyelesaikan langkah-langkah diagnostik di atas, sistem menetapkan setiap halaman ke jenis masalah tertentu.
Manfaat pengelompokan masalah adalah optimasi konten dapat dilakukan secara berkelompok, alih-alih mengedit artikel satu per satu.
Kelompok masalah yang umum meliputi:
Penurunan trafik
Penurunan CTR
Konten lemah atau kecocokan maksud pencarian yang lemah
Konten lama atau usang
Konversi lemah
Halaman duplikat atau saling bersaing
Peluang konten yang belum dimanfaatkan
Masalah teknis atau data
Masalah GEO atau visibilitas AI
Kelompok halaman tidak hanya menampilkan nama masalah. Kelompok ini juga menunjukkan:
Bukti pemicu
Cuplikan funnel halaman
Klaster kueri utama yang terdampak
Posisi konten
Kualitas data
Ringkasan tindakan yang direkomendasikan
Penanggung jawab
Status
Dengan demikian, pemilik konten dapat mengelola pekerjaan berdasarkan kelompok masalah setiap minggu.
Sebagai contoh:
Minggu ini: menangani penurunan CTR.
Minggu depan: menangani konversi yang lemah.
Minggu berikutnya: menangani konten usang dan kanibalisasi halaman.
Tim tidak lagi mengedit halaman secara acak hanya karena terlihat bermasalah. Sebaliknya, mereka dapat menjalankan pekerjaan optimasi berdasarkan jenis masalah dan prioritas.
5. Pembuatan Tugas: Sistem Menghasilkan Rekomendasi Optimasi
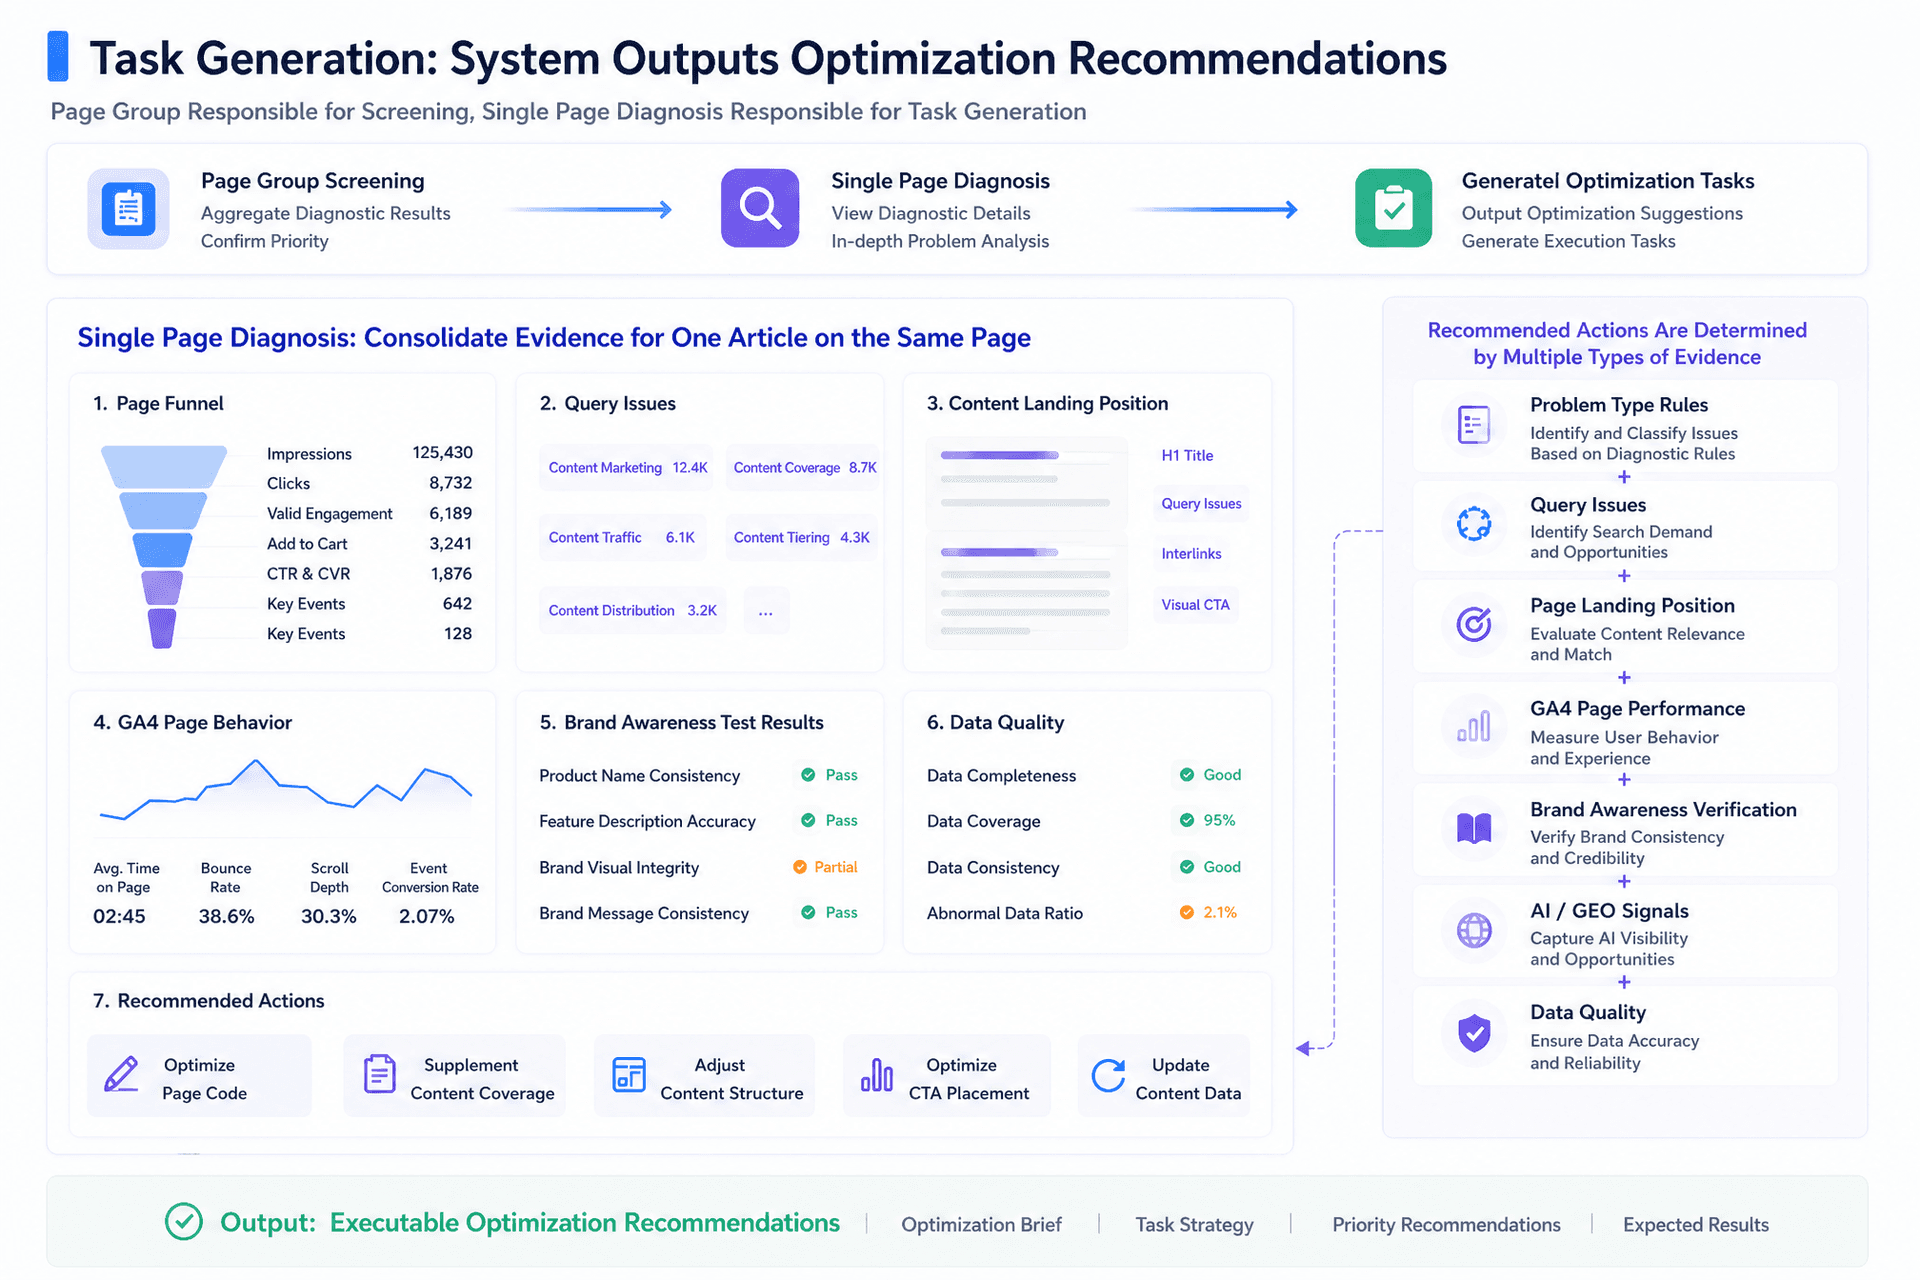
Kelompok halaman digunakan untuk penyaringan. Diagnostik halaman tunggal digunakan untuk pembuatan tugas.
Saat membuka tampilan diagnostik halaman tunggal, sistem menampilkan seluruh bukti untuk sebuah artikel dalam satu halaman:
Funnel halaman
Klaster kueri
Posisi kecocokan konten
Perilaku halaman di GA4
Hasil verifikasi basis pengetahuan merek
Kualitas data
Tindakan yang direkomendasikan
Tindakan yang direkomendasikan terutama ditentukan oleh kombinasi berbagai jenis bukti:
textCopy
Aturan jenis masalah
+ Klaster kueri
+ Posisi kecocokan konten halaman
+ Kinerja halaman GA4
+ Verifikasi basis pengetahuan merek
+ Sinyal AI/GEO
+ Kualitas data
Hasilnya bukan saran samar seperti “optimalkan artikel ini.” Hasilnya harus menjadi tugas yang menjelaskan dengan jelas:
Mengapa halaman ini perlu diperbarui
Bagian halaman mana yang bermasalah
Apa yang harus diubah
Siapa yang bertanggung jawab atas tugas tersebut
Metrik apa yang harus diperiksa setelah pembaruan
6. Contoh: Cara Kerja Rantai Diagnostik Lengkap pada Satu Halaman
GSC menunjukkan bahwa halaman ini mulai mendapatkan tayangan dari kueri yang berkaitan dengan “alat untuk melacak penyebutan AI”.
Jika hanya melihat GSC, kita dapat mengetahui bahwa ada permintaan pencarian, tetapi belum dapat menentukan apakah halaman memenuhi permintaan tersebut.
Langkah 2: Pengelompokan Kueri Mengidentifikasi Maksud Pemilihan Alat
Sistem mengelompokkan kueri-kueri ini ke dalam klaster maksud pemilihan alat.
Artinya, pengguna tidak hanya ingin memahami suatu konsep. Mereka sedang mencari kategori alat, membandingkan kemampuan alat, dan mungkin bahkan siap memulai uji coba atau proses pembelian.
Langkah 3: Analisis DOM Menemukan Kecocokan Maksud yang Lemah
Sistem mem-parsing DOM halaman dan menemukan bahwa bagian pembuka dan struktur H2 masih berfokus terutama pada penjelasan konsep.
Halaman tidak memberikan kriteria pemilihan alat, dimensi perbandingan, atau kasus penggunaan yang jelas.
Dengan kata lain, maksud di sisi pencarian telah bergeser ke pemilihan alat, tetapi halaman masih berfungsi seperti artikel penjelasan konsep.
Langkah 4: GA4 Menambahkan Bukti Perilaku
GA4 menunjukkan bahwa halaman memiliki interaksi yang relatif tinggi, tetapi klik CTA rendah.
Ini berarti pengguna bersedia membaca, tetapi halaman tersebut belum mengarahkan mereka dengan lancar untuk melakukan tindakan terkait produk.
Langkah 5: Basis Pengetahuan Merek Memverifikasi Fakta Produk
Basis pengetahuan merek menemukan bahwa tangkapan layar produk di halaman tersebut sudah usang, dan beberapa deskripsi fitur belum diperbarui ke versi terbaru.
Jika hal ini tidak diperbaiki, LLM mungkin akan terus menggunakan informasi produk yang sudah usang saat menghasilkan rekomendasi optimasi.
Langkah 6: Log Crawler AI Memeriksa Aksesibilitas Teknis
Log crawler AI menunjukkan bahwa GPTBot dapat melakukan crawling pada halaman tersebut secara normal.
Ini berarti masalah prioritasnya bukan crawling teknis. Masalah yang lebih mendesak adalah apakah kontennya cukup layak dikutip, apakah informasi produk akurat, dan apakah CTA sesuai dengan pengguna yang sedang memilih alat.
Draf Tugas Akhir
Sistem menghasilkan draf tugas seperti ini:
markdownCopy
Halaman: /blog/top-tools-to-track-ai-mentions-in-llms

Jenis Masalah:
- Kecocokan dengan search intent lemah
- Konversi lemah
- Konten usang

Bukti Pemicu:
- Kueri pemilihan alat mendapatkan impresi penelusuran
- Bagian pembuka dan struktur H2 masih berfokus pada penjelasan konsep
- Engagement tinggi, tetapi klik CTA rendah
- Basis pengetahuan merek menemukan tangkapan layar produk yang sudah usang
- Crawling GPTBot berjalan normal

Tindakan yang Direkomendasikan:
- Tambahkan modul kriteria pemilihan alat
- Tambahkan tabel perbandingan alat
- Perbarui tangkapan layar produk
- Ganti CTA pendaftaran umum dengan "Lihat Solusi Pemantauan Sebutan AI"
- Tambahkan konten FAQ
- Tambahkan konten langkah demi langkah yang lebih mudah dikutip oleh LLM

Metrik yang Dilacak Setelah Pembaruan:
- CTR
- Sesi penelusuran organik
- Klik CTA
- Klik demo
- Peristiwa utama
- Referral AI
- Status crawler
Dengan cara ini, sebuah artikel beralih dari “performa data yang tidak jelas” menjadi tugas konkret.
Tim mengetahui:
Mengapa artikel perlu diubah
Di mana letak masalahnya
Apa yang perlu diperbarui
Siapa yang harus menanganinya
Metrik apa yang perlu ditinjau setelahnya
7. Pemantauan dan Evaluasi Performa
Siklus pertumbuhan konten yang sesungguhnya juga perlu memasukkan kembali data performa ke dalam sistem setelah artikel diperbarui.
Versi saat ini sudah dapat menjalankan alur kerja utama, mulai dari pemasukan data hingga diagnosis halaman dan pembuatan draf tugas.
Tahap berikutnya adalah menambahkan pelacakan performa setelah eksekusi, dengan menghubungkan setiap pembaruan konten ke perubahan metrik setelahnya.
Sistem akan mencatat:
Waktu pembuatan tugas
Modul yang diperbarui
Waktu peluncuran
Penanggung jawab
Status tugas
Data performa tindak lanjut
Dengan demikian, tim dapat mengevaluasi apakah setiap tindakan optimasi benar-benar menghasilkan dampak.
8. Hal yang Masih Perlu Dikembangkan
Pada tahap ini, sistem sudah dapat menjalankan rangkaian diagnosis utama. Namun, beberapa kemampuan masih perlu ditingkatkan.
8.1 Pengelompokan Intent Kueri
Versi saat ini terutama mengandalkan kemiripan teks dan penilaian berbasis aturan. Untuk industri vertikal, pendekatan ini sudah mencakup sebagian besar kueri umum.
Namun, kueri long-tail, istilah yang baru muncul, dan kueri yang mirip secara semantik tetapi berbeda dari sisi intent mungkin masih dikelompokkan secara keliru.
Ke depannya, sistem akan menggabungkan pencocokan kata kunci dan penilaian berbasis LLM untuk mengklasifikasikan klaster kueri dengan lebih akurat.
Untuk klaster intent dengan tingkat keyakinan rendah, sistem akan secara otomatis menandainya sebagai “perlu konfirmasi manual” agar tugas yang keliru tidak dibuat ketika bukti yang tersedia belum memadai.
8.2 Pembaruan Otomatis Basis Pengetahuan Merek
Saat ini, basis pengetahuan merek masih terutama dikelola melalui impor manual. Cara ini efektif untuk mengonsolidasikan informasi inti seperti fitur produk, harga, tangkapan layar, jawaban FAQ, dan standar pesan kompetitor.
Namun, dalam jangka panjang, basis pengetahuan tidak dapat hanya mengandalkan pemeliharaan manual.
Langkah berikutnya adalah menghubungkan changelog produk, data CMS, atau sumber dokumentasi internal agar versi basis pengetahuan dapat diperbarui secara otomatis seiring perkembangan produk.
Hal ini akan mengurangi ketergantungan pemeriksaan konten usang pada peninjauan manual. Sistem juga akan dapat lebih cepat mengidentifikasi fitur yang sudah usang, tangkapan layar lama, harga yang keliru, dan deskripsi produk yang tidak lagi sesuai dengan pesan saat ini.
8.3 Pelacakan Performa
Sistem sudah dapat menentukan artikel mana yang harus diperbarui, mengapa artikel tersebut perlu diperbarui, bagian mana yang perlu diubah, dan cara membuat tugas optimasi yang didukung bukti.
Langkah berikutnya adalah menambahkan pelacakan performa setelah tugas dijalankan dan menghubungkan setiap pembaruan konten dengan perubahan metrik setelahnya.
Setelah tahap ini selesai, tim konten akan dapat memahami:
Apakah optimasi benar-benar menghasilkan pertumbuhan
Jenis pembaruan mana yang lebih efektif
Halaman mana yang masih perlu diiterasi lebih lanjut
Kesimpulan
Tujuan sistem diagnosis pertumbuhan konten ini bukan untuk menyediakan laporan SEO lainnya.
Tujuannya adalah mengubah optimasi traffic organik menjadi proses yang:
Dapat dijalankan
Dapat dilacak
Dapat dievaluasi
Terhubung dengan hasil bisnis
Sistem ini menghubungkan data penelusuran, konten halaman, perilaku pengguna, fakta merek, visibilitas AI/GEO, tugas optimasi, dan umpan balik performa dalam satu siklus tertutup.
Dengan demikian, tim konten tidak lagi menerima instruksi samar seperti “optimalkan artikel.”
Jika Anda juga sedang membangun situs web independen untuk pasar luar negeri, berfokus pada pertumbuhan konten atau pencarian AI, dan ingin mendiskusikan solusi ini atau mempelajari lebih lanjut detail implementasi sistemnya, Anda dapat menambahkan WeChat: dudulhc.
Dageno is the research and insights team at Dageno AI, publishing industry reports and expert analysis on AI Search Visibility, Generative Engine Optimization (GEO), and AI-powered search discovery.