Découvrez la position de votre marque sur le marché de l'IA
Identifiez les opportunités de croissance à privilégier en fonction de la demande du marché, du paysage concurrentiel, des propositions de valeur de la marque et des sources de citation.
5 outils les plus précis pour mesurer la visibilité dans l’IA (2026)
Comparez cinq outils de mesure de la visibilité dans l’IA selon leur échantillonnage, la transparence de leurs sources, le contrôle des prompts, la couverture des modèles, l’accès aux réponses brutes et la reproductibilité.
Explorez plus 12,000 marchés de niche sans avoir à vous connecter.
La visibilité dans l’IA n’est pas un classement fixe. Un même prompt peut produire des formulations, des sources et des recommandations de marque différentes selon les exécutions, les lieux, les comptes, les modèles et les modes de recherche. L’« exactitude » relève donc de la conception de la mesure, et non d’un pourcentage annoncé par un fournisseur.
Ce guide compare cinq plateformes de visibilité dans l’IA selon les contrôles qui rendent leurs indicateurs plus fiables : provenance des prompts, méthode de collecte, contexte du modèle et du marché, échantillonnages répétés, accès aux réponses brutes, données probantes au niveau des citations et possibilité d’exportation.
Comparaison rapide : outils de mesure de la visibilité dans l’IA
Plateforme
Idéale pour
Signal de mesure le plus fort
Question de vérification préalable
Profound
Programmes d’entreprise et multi-marchés
Collecte via des interfaces destinées aux consommateurs, exécutions quotidiennes, exports bruts
Combien de répétitions sont incluses ?
Semrush
Équipes SEO ayant besoin de découverte et de suivi
Jeux de données et sources de prompts documentés
Quel jeu de données alimente chaque indicateur ?
HubSpot AEO
Clients HubSpot
Suivi quotidien des prompts associé aux workflows marketing
Quelles sont les limites relatives aux prompts et aux réponses ?
Dageno
Équipes passant de la mesure à l’optimisation
Citations, concurrents, lacunes et workflow de contenu
Quelle méthode de collecte est utilisée pour chaque moteur ?
Ahrefs Brand Radar
Analystes SEO et exploration du marché
Grand index de découverte et prompts personnalisés
Comment la découverte et le suivi personnalisé sont-ils dissociés ?
Aucune plateforme ne peut établir un score universel d’« exactitude de 94 % » sans définir une vérité terrain, une population de prompts, un moteur, une période, un processus d’échantillonnage et un calcul de l’erreur. Considérez les pourcentages d’exactitude non étayés comme des arguments marketing, et non comme des données probantes comparables.
Ce que devrait signifier une « visibilité exacte dans l’IA »
1. Un ensemble de prompts représentatif
La représentativité d’un tableau de bord dépend uniquement des prompts sur lesquels il repose. Un ensemble utile comprend des questions sur la marque, la catégorie, le problème, la comparaison, les alternatives, les cas d’usage et l’intention d’achat. Il devrait également indiquer si les prompts proviennent d’études clients, de la demande de recherche, de la découverte par la plateforme ou de votre propre benchmark.
2. Des observations répétées
Les réponses génératives sont stochastiques. Une seule exécution peut être réelle sans être représentative. Les recherches sur la mesure de la recherche générative montrent pourquoi la visibilité doit être considérée comme une estimation assortie d’incertitude plutôt que comme un classement permanent. Des collectes répétées permettent de distinguer un changement persistant des variations normales des réponses.
3. Un contexte explicite du moteur et du marché
La « visibilité dans ChatGPT » est une métadonnée incomplète. Le résultat peut dépendre du modèle, du mode de recherche, de la date, du pays, de la langue, de la personnalisation et de l’interface. Une plateforme crédible devrait divulguer ou permettre de contrôler les dimensions qui influent sensiblement sur la réponse.
4. Des données probantes consultables
La part de voix agrégée est utile pour obtenir une vue d’ensemble, mais les équipes ont également besoin de la réponse d’origine, du contexte de la marque, du domaine cité, de l’URL citée, de l’horodatage et du prompt. Les données probantes brutes permettent aux analystes d’auditer les erreurs de classification et d’expliquer les changements.
5. Des définitions d’indicateurs transparentes
La visibilité, le taux de mention, la part de citations, la position, le sentiment et la force de recommandation mesurent des éléments différents. Un outil devrait documenter son numérateur, son dénominateur, sa pondération, le traitement des échecs et sa fenêtre d’agrégation. Sans cela, deux graphiques portant la même étiquette ne sont pas nécessairement comparables.
6. Le signalement des échecs et des refus
Les requêtes bloquées, les délais d’attente dépassés, les réponses vides, les refus et les modes de recherche indisponibles ne devraient pas disparaître sans explication. Exclure les observations échouées peut gonfler les résultats et donner à un petit échantillon une apparence de stabilité supérieure à la réalité.
1. Profound : les informations publiques les plus détaillées sur la collecte des réponses
Profound Answer Engine Insights fournit des informations publiques particulièrement utiles sur son processus de mesure. L’entreprise indique qu’elle collecte des réponses via des interfaces destinées aux consommateurs, effectue le suivi quotidiennement, prend en charge les prompts personnalisés et observés, conserve les citations, compare les plateformes et propose des exports CSV bruts.
Pourquoi ses indicateurs sont plus faciles à auditer
Les observations quotidiennes permettent d’analyser les tendances plutôt que de procéder à des vérifications ponctuelles.
Les données au niveau des réponses et des citations peuvent être examinées en détail, sous les indicateurs agrégés.
Les contrôles par région et par langue facilitent les comparaisons multi-marchés.
Les exports bruts permettent aux équipes analytiques de reproduire ou de remettre en question les conclusions du tableau de bord.
Points à vérifier
Demandez combien de fois chaque prompt est exécuté, comment les observations échouées sont comptabilisées, quels modes de moteur sont utilisés exactement et si les changements historiques de méthodologie sont annotés. La transparence publique est précieuse, mais elle ne dispense pas de tester votre propre ensemble de prompts.
2. Semrush : la meilleure distinction documentée entre les jeux de données d’IA
Semrush AI Visibility précise que ses fonctionnalités d’IA utilisent différents jeux de données pour la découverte de marché et le suivi personnalisé. Sa base de connaissances explique les sources des prompts, les calendriers de collecte, la couverture des modèles et les différences entre une vaste base de données de prompts et le suivi défini par l’utilisateur.
Pourquoi cette distinction est importante
Une base de données de découverte estime la visibilité à l’échelle d’un marché ; un outil de suivi personnalisé mesure un ensemble contrôlé de prompts importants pour une marque donnée. Les combiner sans les étiqueter peut créer des tendances trompeuses. La distinction documentée par Semrush aide les analystes à choisir le bon jeu de données pour leur décision.
Points à vérifier
Confirmez quel jeu de données, pays, appareil ou mode, calendrier d’actualisation et source de prompts alimentent chaque indicateur exporté. Ne comparez pas directement un score général de découverte à un petit benchmark personnalisé comme s’ils portaient sur la même population.
3. HubSpot AEO : la meilleure solution pour un workflow quotidien défini dans HubSpot
HubSpot AEO documente le suivi quotidien des prompts dans ChatGPT, Gemini et Perplexity, avec des vues sur la visibilité de la marque, les concurrents, les citations et les recommandations. Son intérêt tient moins au nombre maximal de moteurs qu’à la possibilité d’intégrer les observations à un workflow de contenu et de marketing existant.
Pourquoi ses indicateurs peuvent être fiables sur le plan opérationnel
Une liste de prompts stable peut être suivie chaque jour.
Des limites de compte explicites rendent la taille de l’échantillon visible.
Les vues sur les citations et les concurrents apportent du contexte au score de visibilité global.
Les équipes peuvent relier les résultats au contenu qu’elles gèrent déjà dans HubSpot.
Points à vérifier
Vérifiez les limites applicables à votre abonnement, le nombre exact de réponses par prompt, les contrôles du marché, la conservation des réponses brutes et les options d’exportation. Un calendrier quotidien n’est utile que si l’ensemble de prompts sous-jacent reste bien encadré.
4. Dageno : la meilleure solution pour transformer les données probantes en actions d’optimisation
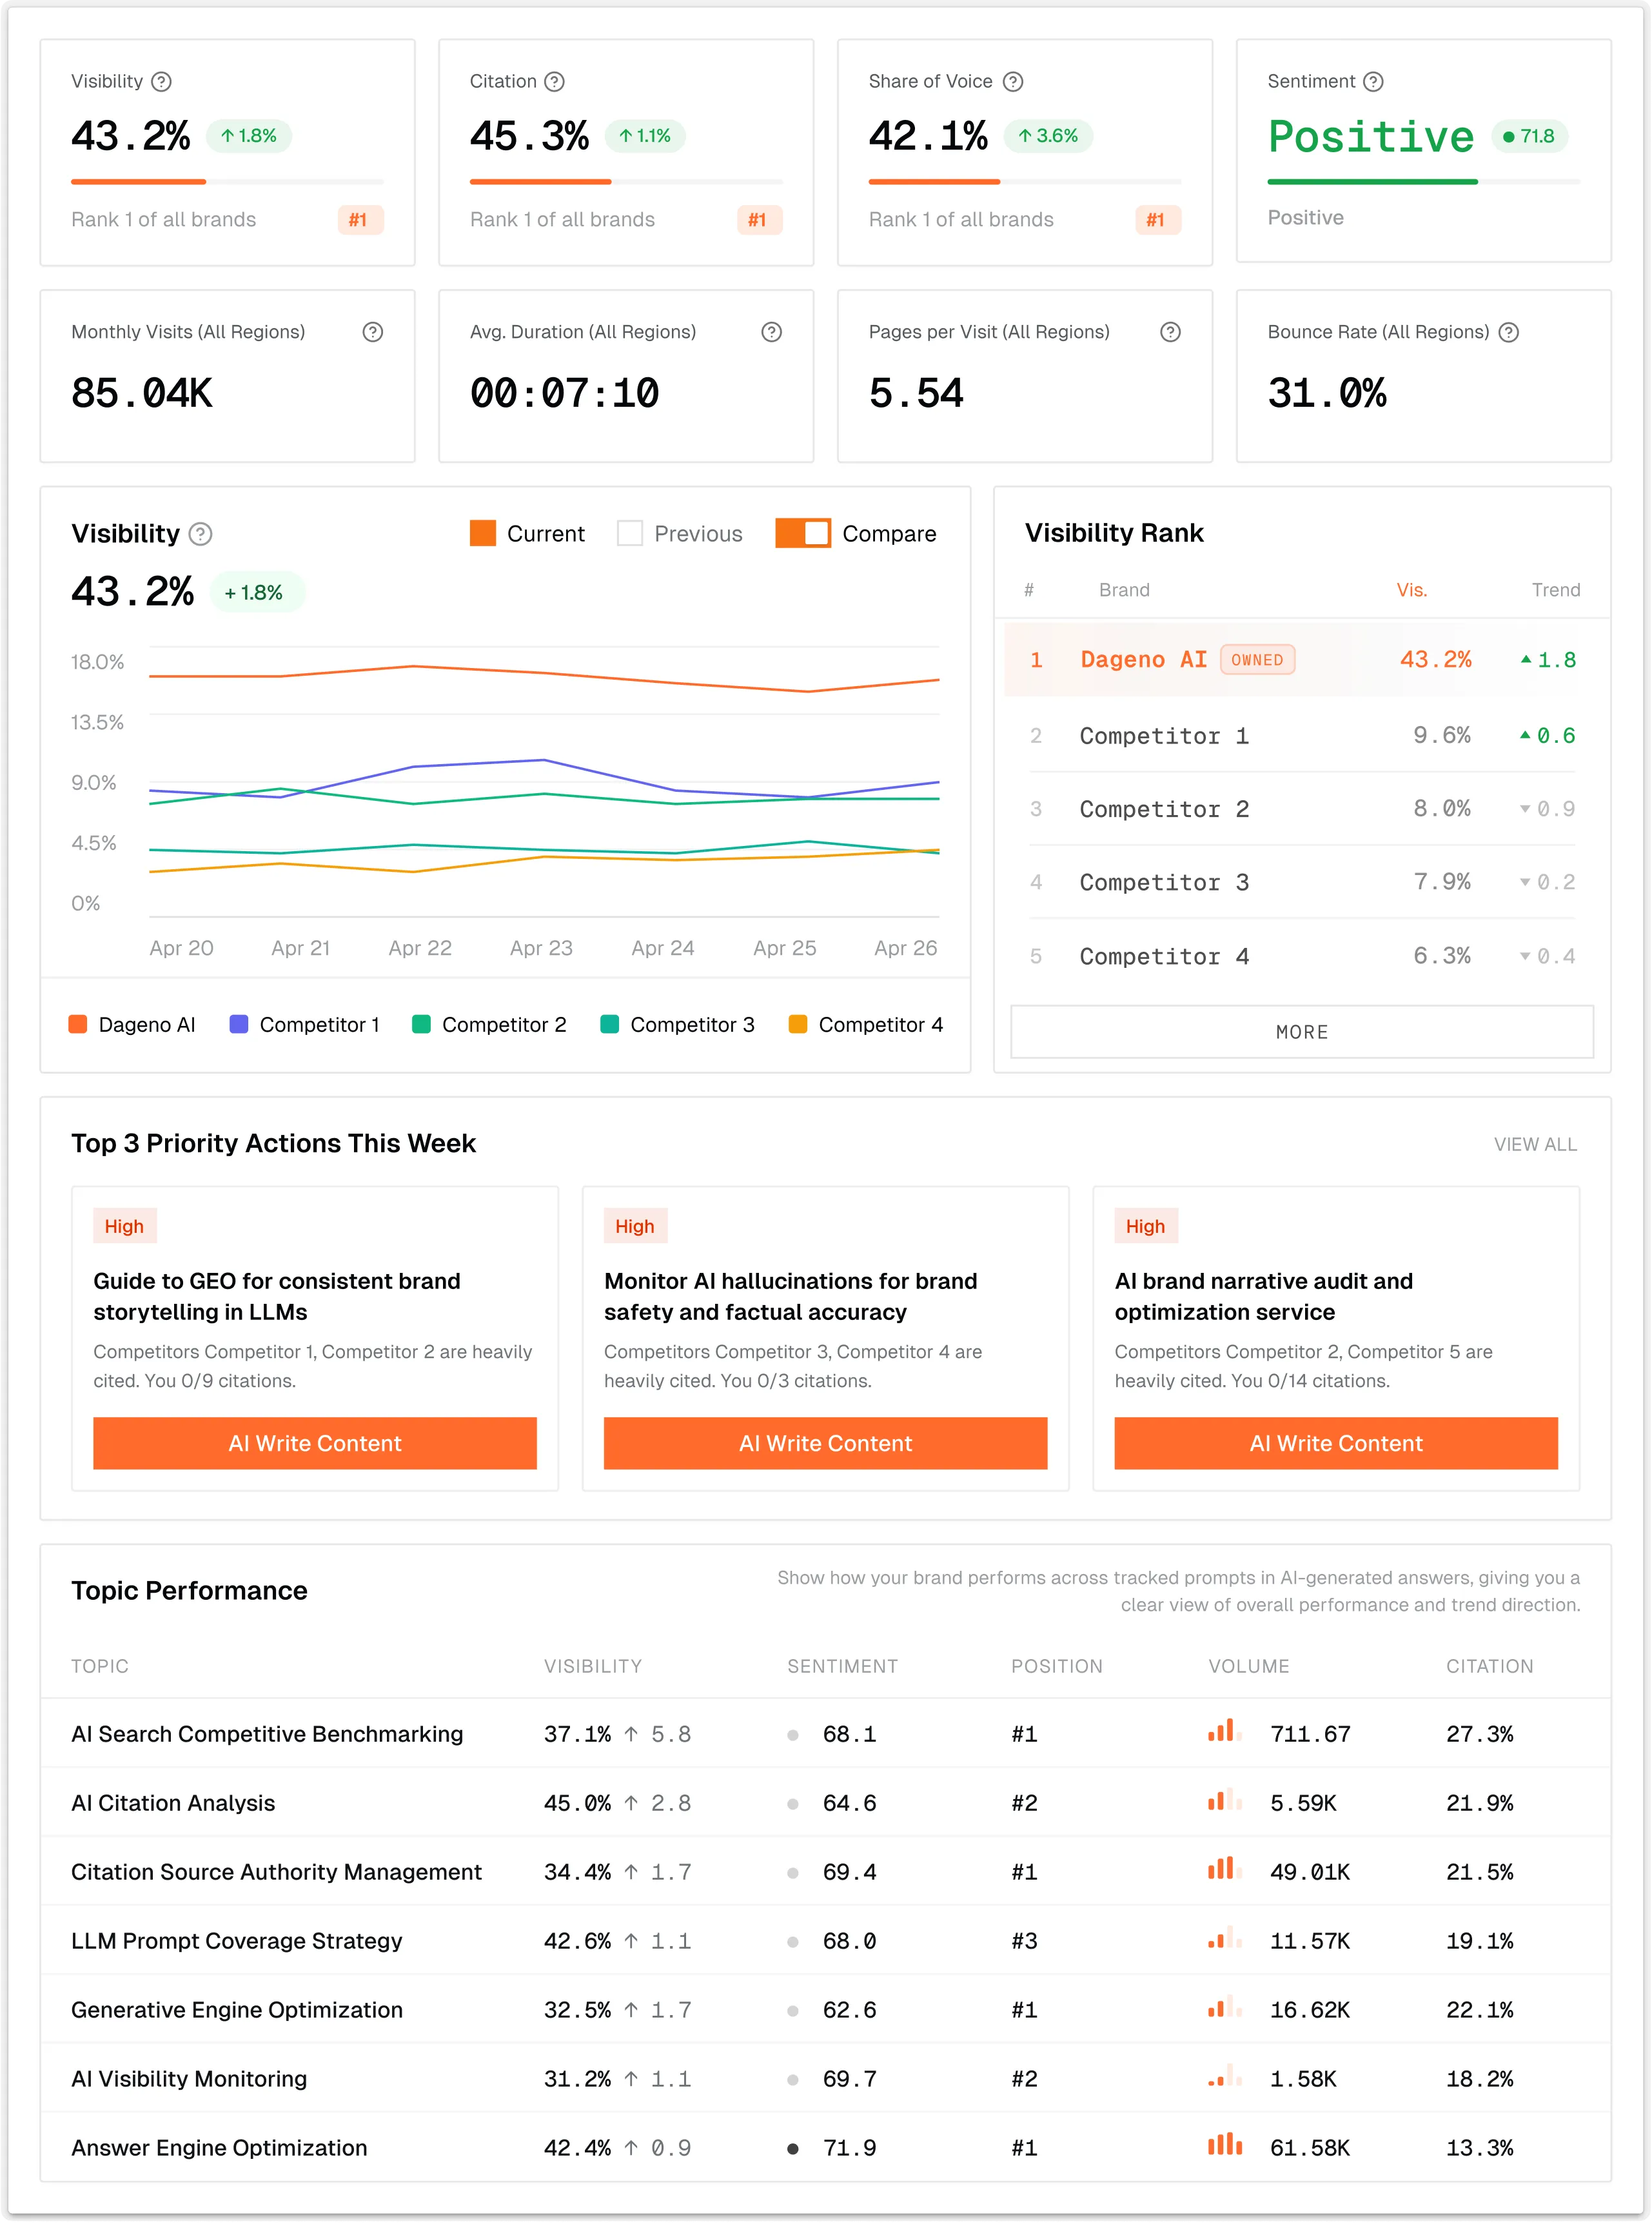
Dageno combine le suivi de la visibilité dans l’IA avec l’analyse des citations, la comparaison des concurrents, l’analyse des lacunes thématiques et l’optimisation du contenu. Ce workflow de bout en bout est important, car un indicateur statistiquement rigoureux a une valeur commerciale limitée si l’équipe ne peut pas le relier à une page citée ou à une modification concrète du contenu.
Points forts en matière de mesure
Visibilité au niveau des prompts et comparaison des concurrents.
Données probantes sur les citations et les URL pour diagnostiquer les changements.
Analyse des lacunes reliant le manque de visibilité aux thèmes et aux sources.
Workflows de contenu pour agir sur les résultats.
Points à vérifier
Pour chaque moteur, confirmez l’interface de collecte, les contrôles du marché et de la langue, la fréquence d’exécution, la politique de répétition, le traitement des échecs et l’accès aux réponses brutes. Dageno doit être évalué au regard de ces données probantes et de l’adéquation de ses workflows, et non selon un pourcentage universel d’exactitude non étayé.
5. Ahrefs Brand Radar : la meilleure solution pour la découverte et les prompts personnalisés
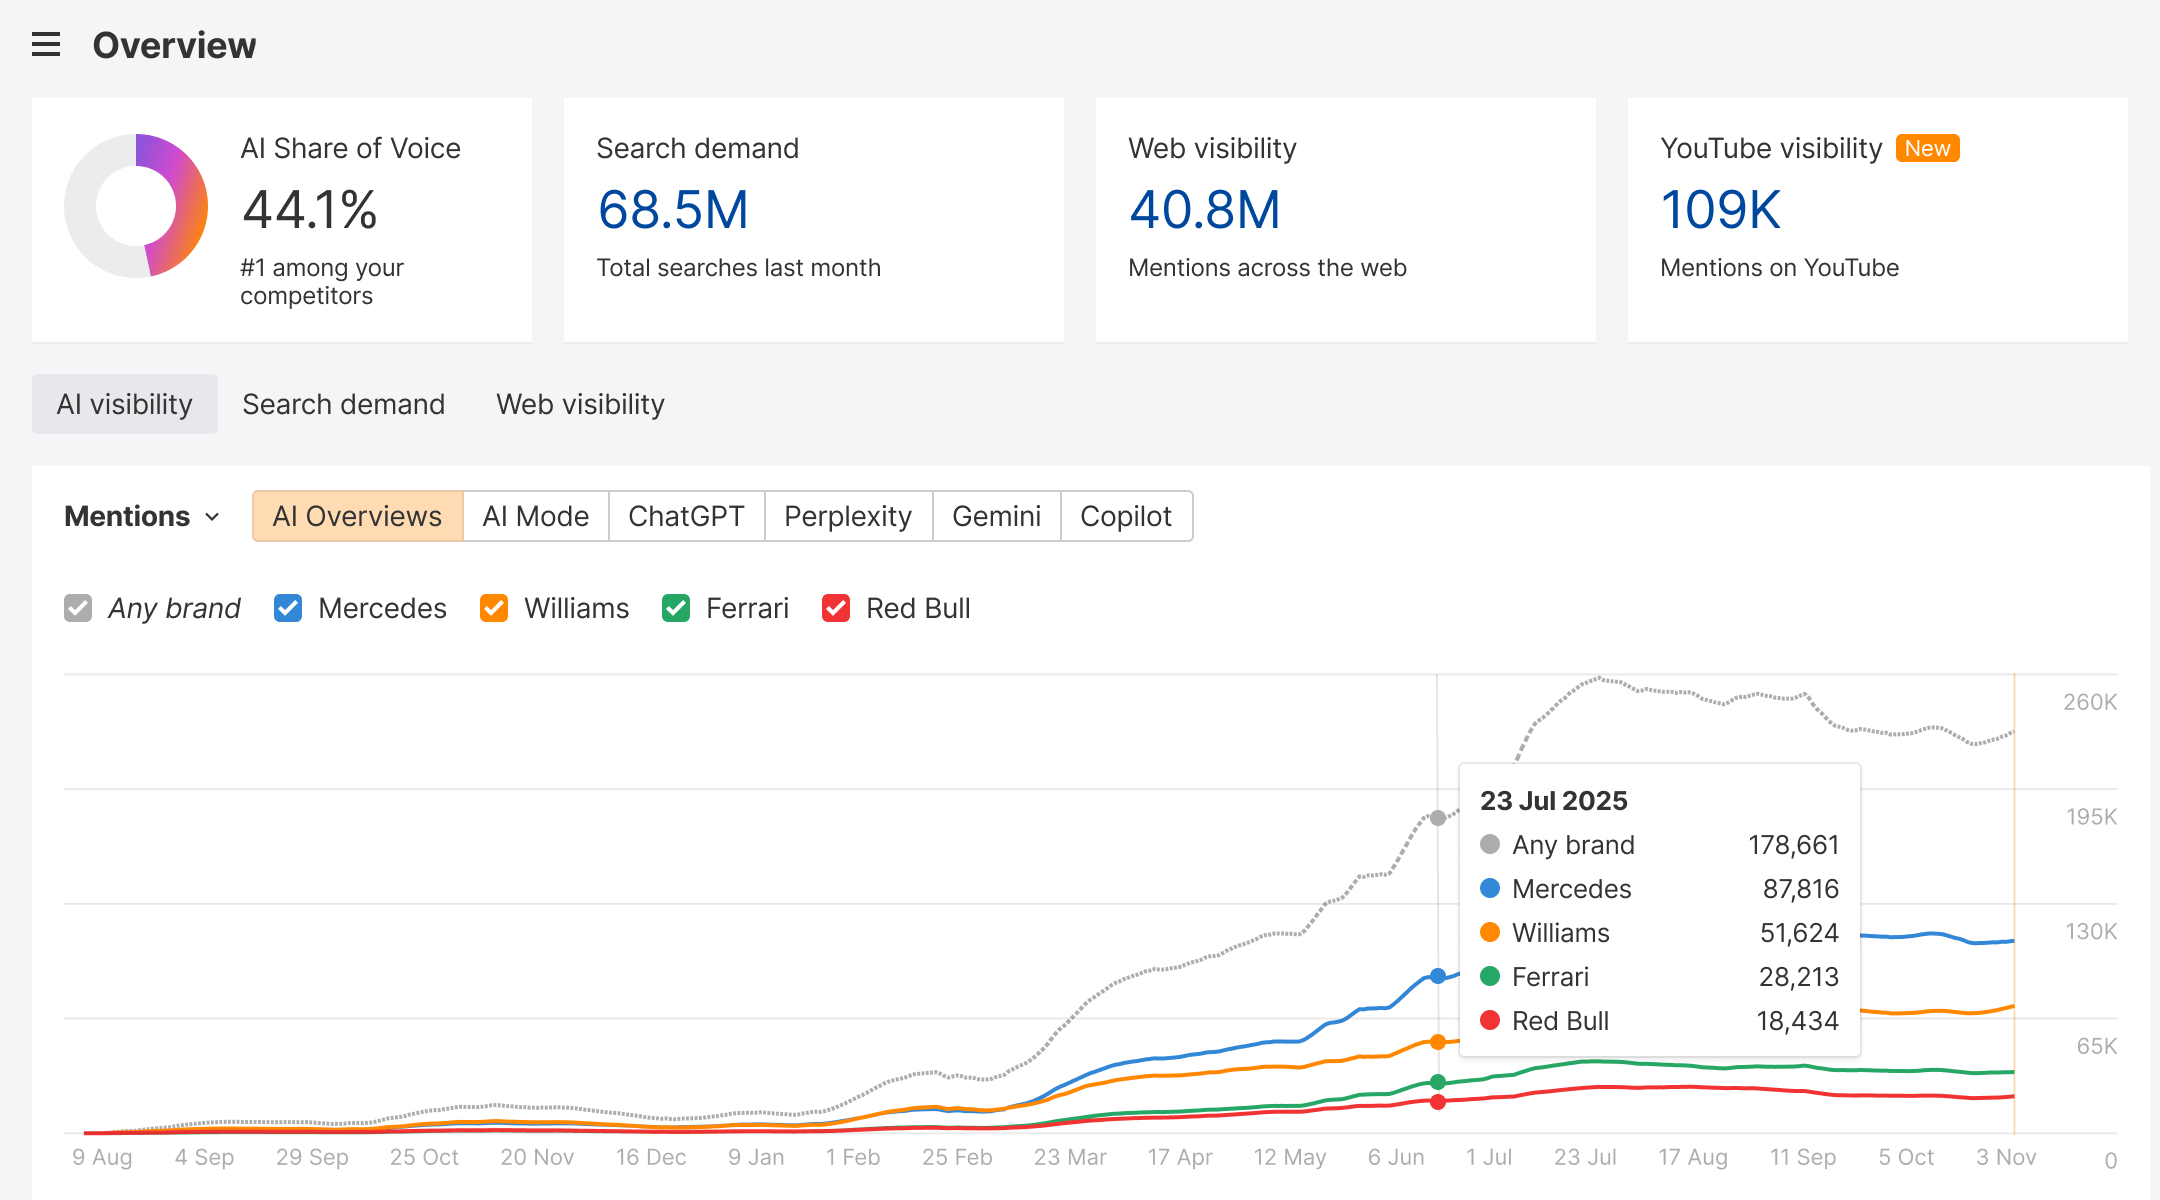
Ahrefs Brand Radar combine un vaste index consultable de réponses générées par l’IA avec le suivi des prompts personnalisés. L’outil est donc utile pour deux tâches distinctes : découvrir la présence d’un marché dans un vaste jeu de données et suivre un benchmark sélectionné dans le temps.
Pourquoi ses indicateurs sont utiles
Les données de découverte permettent de trouver des marques, des sujets, des mentions et des sources citées à grande échelle.
Les prompts personnalisés créent un benchmark contrôlé pour les questions prioritaires.
L’intégration aux données Ahrefs peut relier les citations de l’IA à une analyse SEO plus large.
Les vues des sources et des URL facilitent l’analyse au niveau du contenu.
Points à vérifier
Dans vos rapports, séparez les indicateurs de découverte de ceux issus des prompts personnalisés. Confirmez la fréquence d’actualisation, la couverture des marchés, le modèle ou le mode, les répétitions et la façon dont les échecs de réponse influent sur le dénominateur.
Test de validation pratique avant l’achat
Étape 1 : Créez un benchmark fixe
Choisissez entre 30 et 100 prompts couvrant la marque, la catégorie, le problème, la comparaison, les alternatives et l’intention d’achat. Indiquez le pays et la langue cibles. Conservez la majeure partie de l’ensemble inchangée pendant au moins quatre semaines.
Étape 2 : Effectuez plusieurs exécutions
Collectez des observations répétées pour un sous-ensemble de prompts à forte valeur. Si un outil n’effectue qu’une seule exécution, répétez manuellement 10 à 20 prompts dans l’interface grand public correspondante afin d’estimer la variabilité des réponses.
Étape 3 : Auditez les données probantes brutes
Échantillonnez les mentions, les non-mentions, les citations, les étiquettes de sentiment et les positions concurrentielles rapportées. Vérifiez que la réponse conservée étaye la classification et que les URL citées renvoient bien aux pages indiquées.
Étape 4 : Suivez les échecs séparément
Comptabilisez les délais d’attente dépassés, les refus, les requêtes bloquées, les réponses vides et les incompatibilités de mode. Un outil qui renvoie 80 observations valides sur 100 tentatives ne devrait pas afficher le même niveau de certitude qu’un outil qui en renvoie 100.
Étape 5 : Comparez des éléments comparables
Utilisez les mêmes prompts, dates, marchés, langues et moteurs. Ne jugez pas les fournisseurs uniquement en fonction du niveau de visibilité affiché ; des définitions différentes peuvent produire des valeurs différentes à partir des mêmes réponses.
Indicateurs à intégrer à un tableau de bord de direction
Taux de mention : nombre de réponses valides qui mentionnent la marque, divisé par le nombre de réponses valides observées.
Taux de citation : nombre de réponses valides qui citent une URL appartenant à la marque, divisé par le nombre de réponses valides observées.
Part de voix : mentions de la marque par rapport à un ensemble défini de concurrents, avec une pondération explicitée.
Part de citations : citations de pages appartenant à la marque par rapport à l’ensemble des citations ou aux citations des concurrents.
Taux de recommandation : réponses qui recommandent la marque, distinguées des mentions neutres.
Couverture des prompts : catégories de prompts suivies avec un nombre suffisant d’observations valides.
Volatilité ou niveau de confiance : variation entre les exécutions répétées ou intervalle d’incertitude.
Exhaustivité des données probantes : pourcentage d’observations pour lesquelles le texte de la réponse, les citations, le contexte et l’horodatage sont conservés.
Erreurs courantes de mesure
Considérer une réponse comme un classement
Une réponse est une observation, pas une position durable. Effectuez plusieurs exécutions et utilisez une fenêtre glissante avant de déclarer une progression ou un recul.
Modifier l’ensemble de prompts sans annoter le graphique
L’ajout de prompts performants peut accroître la visibilité même si la marque n’a pas progressé. Versionnez le benchmark et distinguez les tendances mesurées sur le même ensemble de la couverture élargie.
Mélanger les marchés et les modèles
Une moyenne mondiale peut masquer une forte baisse dans un pays ou un moteur. Conservez les dimensions du marché, de la langue, de la plateforme et du mode jusqu’à la dernière étape du reporting.
Optimiser uniquement le score
Une visibilité sans contexte de citation peut valoriser les mentions superficielles. Associez l’indicateur au contexte des recommandations, aux URL citées, à la diversité des sources, aux conversions et au trafic qualifié, lorsque ces données sont disponibles.
Quel logiciel de visibilité dans l’IA est le plus précis ?
Il n’existe aucun vainqueur universel établi de manière indépendante. Profound et Semrush publient des informations utiles sur leur méthodologie ; HubSpot documente un workflow quotidien défini ; Dageno relie les données probantes à l’optimisation ; et Ahrefs associe la découverte au suivi personnalisé. Le choix le plus fiable est celui qui réussit un test contrôlé avec vos prompts et vos marchés.
Deux outils précis peuvent-ils afficher des scores de visibilité différents ?
Oui. Ils peuvent utiliser des prompts, des moteurs, des modes, des régions, des calendriers, des répétitions, des dénominateurs et des pondérations différents. Ces divergences ne sont instructives que si les deux méthodologies sont connues.
À quelle fréquence faut-il vérifier la visibilité dans l’IA ?
Une collecte quotidienne ou hebdomadaire peut aider à détecter les tendances, mais les rapports devraient s’appuyer sur une fenêtre couvrant plusieurs observations. Les prompts à forte valeur méritent des exécutions répétées, car les réponses génératives peuvent varier même si le contenu sous-jacent n’a pas changé.
Une base de données de prompts plus importante est-elle toujours plus précise ?
Non. Une vaste base de données améliore la découverte de marché, tandis qu’un benchmark représentatif plus restreint peut être plus adapté au suivi d’une marque donnée. La couverture, la provenance et la conception de l’échantillonnage comptent davantage que le nombre de prompts mis en avant.
Conclusion
Le logiciel de visibilité dans l’IA le plus précis n’est pas celui qui affiche le pourcentage le plus assuré. C’est la plateforme qui permet d’examiner sa population de prompts, son contexte de collecte, ses données probantes, ses échecs, ses définitions d’indicateurs et son incertitude. Testez d’abord ces contrôles, puis choisissez le workflow que votre équipe peut utiliser de façon constante pour améliorer les pages citées et les recommandations de marque.
Dageno is the research and insights team at Dageno AI, publishing industry reports and expert analysis on AI Search Visibility, Generative Engine Optimization (GEO), and AI-powered search discovery.