Découvrez la position de votre marque sur le marché de l'IA
Identifiez les opportunités de croissance à privilégier en fonction de la demande du marché, du paysage concurrentiel, des propositions de valeur de la marque et des sources de citation.
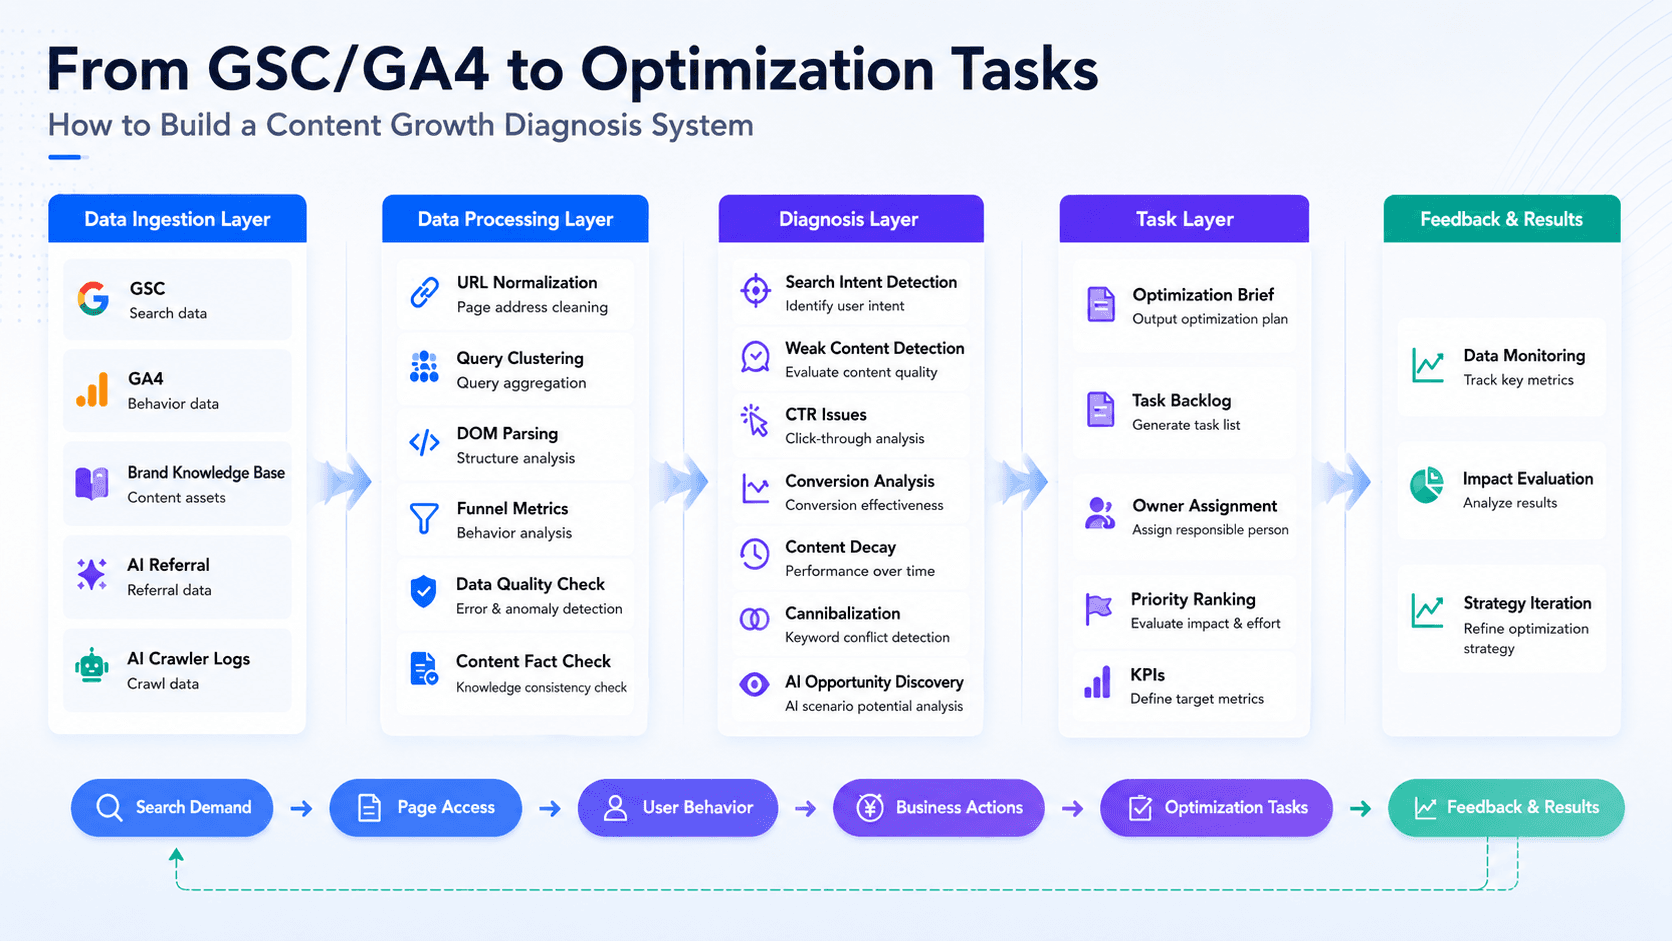
De GSC/GA4 aux tâches d’optimisation : comment créer un système de diagnostic de la croissance de contenu
Un cadre pratique pour transformer les données de GSC, GA4, les connaissances sur la marque, le trafic de référence issu de l’IA et les journaux d’exploration en tâches d’optimisation de contenu concrètes.
Explorez plus 12,000 marchés de niche sans avoir à vous connecter.
Ces dernières années, une évolution est devenue de plus en plus évidente : les opérations de contenu passent d’une logique de trafic à une logique de croissance.
À mesure que la recherche par IA et la distribution de contenu se complexifient, se contenter de faire du SEO, de publier du contenu et de suivre les impressions ou les clics ne suffit plus. On attend désormais des équipes de contenu qu’elles comprennent l’ensemble du parcours utilisateur : comment les utilisateurs arrivent, pourquoi ils restent, pourquoi ils ne convertissent pas et ce qu’il faut optimiser à chaque étape.
Autrement dit, les rôles liés au contenu évoluent progressivement : les exécutants du contenu deviennent des participants, voire des concepteurs de systèmes de croissance.
Cette évolution m’est apparue très clairement au fil de mes projets de croissance par le contenu.
Les indicateurs tels que les impressions, les clics, les classements, l’état d’indexation et le volume d’articles restent importants. Mais le véritable moteur des résultats n’est pas le fait qu’un site ait davantage de contenu. C’est la capacité du contenu existant à relier efficacement la demande de recherche à une action commerciale.
C’est particulièrement vrai pour les entreprises B2B SaaS, les sites indépendants, les sites e-commerce et les sites de fabricants. De nombreuses pages ne sont pas totalement dépourvues de trafic. Le trafic arrive, mais ne progresse pas dans l’entonnoir. Les utilisateurs arrivent via la recherche, mais la page ne répond pas correctement à leur intention. Ils lisent l’article, mais ne voient pas de CTA. Ils cliquent sur un CTA, mais n’atteignent pas un événement clé.
Le problème n’est pas le manque de données. C’est l’absence d’une chaîne de décision reliant :
Demande de recherche → Adéquation entre l’intention et la page → Comportement de l’utilisateur → Action commerciale → Tâche d’optimisation → Retour sur les performances
Pour résoudre ce problème, nous avons créé un système interne de diagnostic de la croissance du contenu et l’avons validé sur plusieurs sites indépendants dans les secteurs du e-commerce, de la fabrication, de l’électronique grand public et du SaaS IA.
Ce système n’est pas un rapport SEO standard. Ce n’est pas non plus un outil qui se contente de demander à l’IA de générer des suggestions d’optimisation génériques. Il relie plutôt GSC, GA4, la base de connaissances de la marque, les référents IA et les journaux des robots d’exploration IA au sein d’un processus de diagnostic à l’échelle de la page.
Il aide les équipes à répondre aux questions suivantes :
Quelles requêtes et intentions amènent les utilisateurs sur une page ?
La page correspond-elle correctement à cette intention et y répond-elle ?
Après leur arrivée sur la page, les utilisateurs lisent-ils, voient-ils les CTA et cliquent-ils dessus ?
Les informations sur les produits présentes sur la page sont-elles exactes ?
Les produits d’IA génèrent-ils des visites et les robots d’exploration IA peuvent-ils accéder à la page ?
Comment transformer les éléments observés en une tâche d’optimisation exploitable ?
Quels indicateurs faut-il suivre après la mise à jour de la page ?
Le flux global de données fonctionne ainsi :
Tout d’abord, les données sont connectées. Ensuite, les données provenant de différentes sources sont associées à la même URL. Les groupes de requêtes servent à identifier l’intention de recherche. L’analyse du DOM de la page permet de déterminer si le contenu répond à cette intention. Les données d’entonnoir de GSC et de GA4 sont combinées afin d’identifier les étapes où les utilisateurs abandonnent. La base de connaissances de la marque sert à vérifier les faits présentés dans le contenu. Les signaux IA/GEO permettent d’évaluer le trafic de référence provenant de l’IA et l’accessibilité aux robots d’exploration. Enfin, tous les éléments observés sont convertis en tâches d’optimisation, et les performances sont suivies en continu après la mise en ligne des modifications.
Voici une présentation détaillée de l’ensemble du processus.
1. Ingestion des données : relier la recherche, le comportement, les faits et les signaux IA
La première couche est celle de l’ingestion des données. Nous connectons principalement cinq types de données :
Google Search Console, ou GSC
Google Analytics 4, ou GA4
Base de connaissances de la marque
Sessions provenant de référents IA
Journaux des robots d’exploration IA
1.1 GSC et GA4
GSC mesure les performances liées à la recherche. Il fournit les impressions, les clics, le CTR, la position moyenne et des données détaillées sur les performances au niveau des requêtes.
Grâce à GSC, le système peut identifier les requêtes qui permettent aux utilisateurs de découvrir une page, ainsi que les pages qui continuent de recevoir des impressions, mais dont le taux de clics commence à baisser.
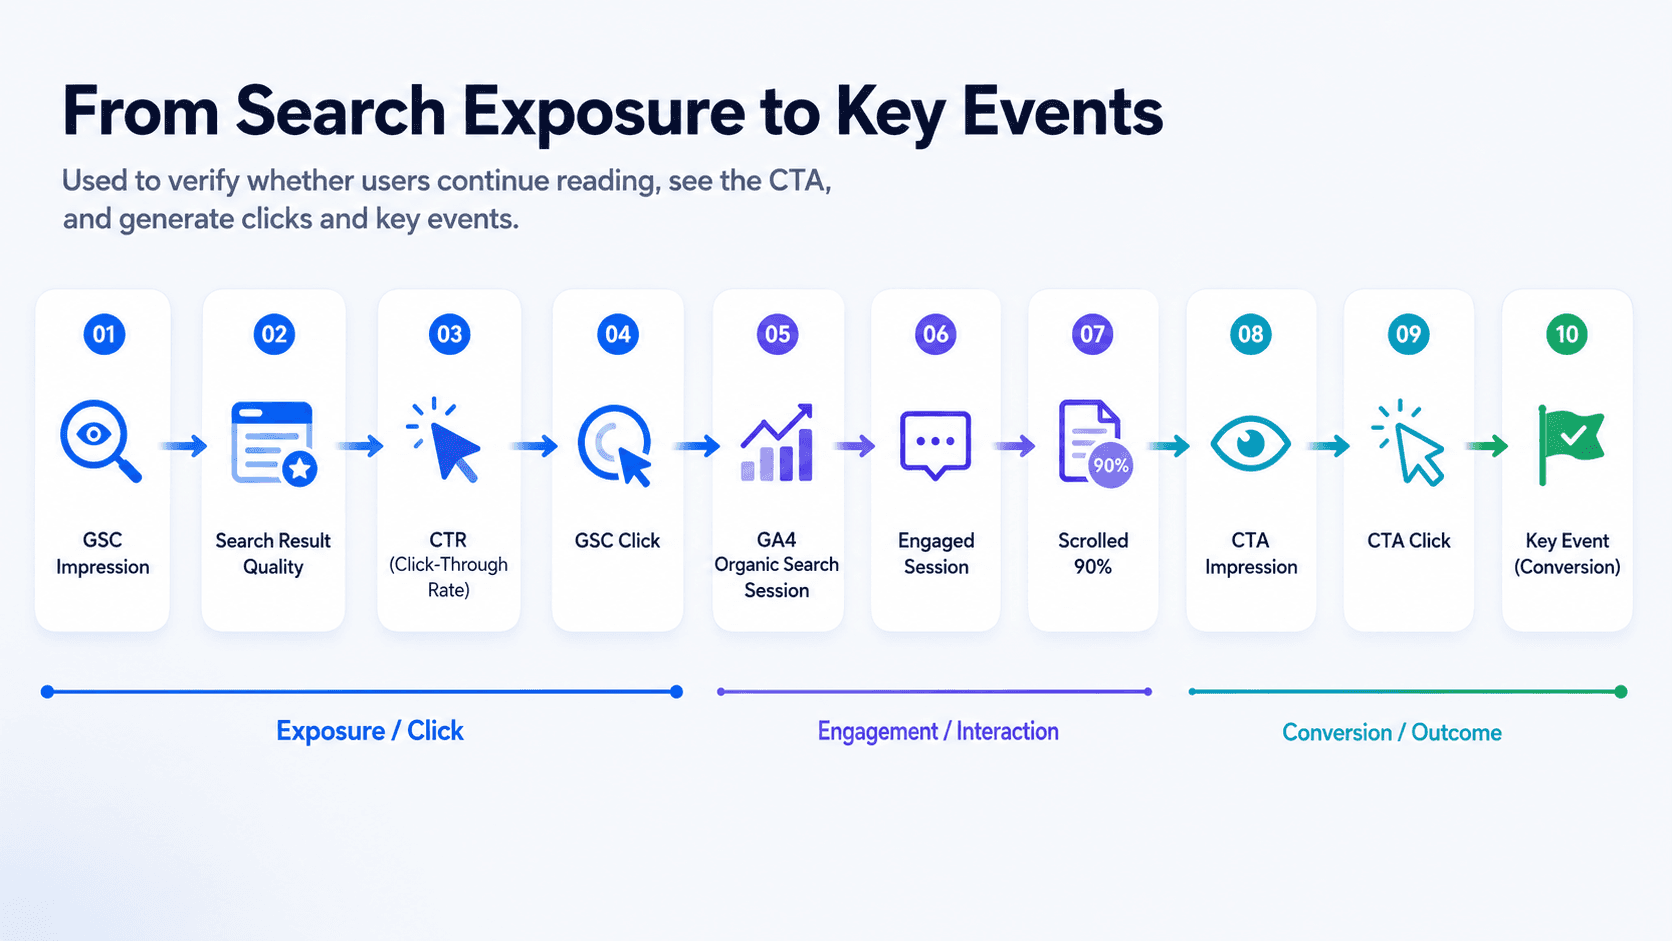
GA4 mesure le comportement sur le site. Il fournit les sessions issues de pages de destination provenant de la recherche organique, le taux d’engagement, le comportement de défilement, les impressions des CTA, les clics sur les CTA, les inscriptions et les événements clés.
Grâce à GA4, le système peut déterminer si les utilisateurs poursuivent leur lecture après avoir accédé à la page, s’ils voient les points d’accès au produit, s’ils cliquent sur les CTA et s’ils passent à des actions essentielles pour l’activité.
GSC et GA4 ne deviennent vraiment puissants que lorsqu’ils sont utilisés ensemble.
Si nous ne consultons que GSC, nous ne pouvons voir que ce qui se passe dans les résultats de recherche. Si nous ne consultons que GA4, nous ne pouvons voir que ce qui se passe après l’arrivée des utilisateurs sur le site. En reliant les deux, le système peut identifier précisément où un article bloque le parcours.
Par exemple :
Beaucoup d’impressions, mais un faible CTR
Donner la priorité au titre, à la méta-description et à la pertinence dans les résultats de recherche.
Beaucoup de clics, mais un faible engagement
Donner la priorité à l’introduction, à la table des matières, à la structure de la page et à l’adéquation entre le contenu et l’intention.
Bon engagement, mais peu de clics sur les CTA
Donner la priorité aux modules produit, au texte des CTA et à leur emplacement.
Des clics sur les CTA, mais peu d’événements clés
Examiner ensuite le parcours d’inscription, le parcours de demande de démo ou le parcours sur la page de destination.
1.2 Base de connaissances de la marque
La base de connaissances de la marque sert à vérifier les faits concernant les produits.
Les équipes peuvent y synchroniser les dernières fonctionnalités des produits, les formules tarifaires, les versions des captures d’écran, les messages de marque, les critères de comparaison avec les concurrents, les réponses aux FAQ et les mises à jour importantes des produits.
Le système compare ensuite le contenu des pages à la base de connaissances pour déterminer si les informations sur les produits présentes dans un article sont devenues obsolètes.
L’objectif de ce module est de fournir au LLM une source d’informations sur les produits à jour, unifiée et fiable.
Sans base de connaissances de la marque, le système ne peut qu’inférer que le contenu est peut-être obsolète en fonction de sa date de publication, des mentions d’années, des captures d’écran ou de la fraîcheur des SERP. Une fois la base de connaissances connectée, le système peut générer des tâches beaucoup plus précises, telles que :
Remplacer les captures d’écran obsolètes du produit
Corriger les descriptions des formules tarifaires
Réécrire les tableaux de comparaison avec les concurrents
Synchroniser les dernières réponses aux FAQ
1.3 Référents IA et journaux des robots d’exploration IA
Les données IA/GEO sont réparties en deux catégories :
Sessions provenant de référents IA
Journaux des robots d’exploration IA
Les sessions provenant de référents IA viennent de GA4. Elles indiquent si des produits tels que ChatGPT ou Perplexity génèrent de vraies visites sur le site et si ces visites entraînent de l’engagement ou des événements clés.
Les journaux des robots d’exploration IA proviennent des journaux serveur, de Cloudflare, des journaux CDN ou des journaux de périphérie. Ils indiquent si des robots tels que GPTBot, PerplexityBot et ClaudeBot ont accédé à une page, si le code de statut est normal et si l’accès est affecté par les règles robots, le WAF, la configuration CDN ou l’absence de journaux.
Cette distinction est importante :
Les robots d’exploration IA ne sont pas des sources de trafic dans GA4.
GA4 convient pour mesurer les sessions de référence provenant des produits d’IA. L’accès des robots d’exploration doit être vérifié dans les journaux.
Une page peut avoir été explorée par GPTBot sans générer de sessions de référence depuis ChatGPT. Une autre page peut déjà recevoir du trafic de référence depuis Perplexity, mais avoir des journaux d’exploration incomplets. Ce n’est qu’en examinant les deux signaux ensemble que l’équipe peut déterminer si une page a besoin d’un contenu plus facile à citer ou s’il faut d’abord vérifier son accessibilité technique.
2. Traitement des données : commencer par aligner les URL, puis constituer des éléments de preuve au niveau de la page
Une fois les données connectées, le système ne génère pas immédiatement des suggestions. Il commence par les traiter.
L’objectif de cette couche de traitement est de transformer des données dispersées en éléments de preuve à l’échelle de la page.
2.1 Alignement des données au niveau des URL
La première étape consiste à aligner les URL.
GSC, GA4 et les journaux serveur enregistrent souvent les adresses des pages de différentes manières.
Par exemple, un même article peut apparaître dans GSC sous la forme d’une URL complète, dans GA4 avec des paramètres de suivi et dans les journaux serveur uniquement sous la forme d’un chemin de page. Si le système ne standardise pas d’abord ces adresses, le même article sera réparti entre plusieurs enregistrements : les clics issus de la recherche à un endroit, les sessions sur le site à un autre, les clics sur les CTA ailleurs et l’accès des robots d’exploration à un autre endroit encore.
Le système nettoie donc d’abord les adresses des pages en supprimant les paramètres UTM, les paramètres de clic publicitaire, les ancres de page et les autres éléments qui ne modifient pas le contenu de la page elle-même. Il associe ensuite le même article à une URL canonique unique.
Ce n’est qu’après cette étape que les impressions, les clics, les sessions, les CTA, les événements clés et les enregistrements des robots d’exploration IA peuvent être correctement attribués au même article.
2.2 Regroupement des requêtes
Un groupe de requêtes rassemble des requêtes de recherche similaires en fonction de l’intention de l’utilisateur.
GSC contient souvent un grand nombre de requêtes fragmentées. Si l’équipe de contenu les examine une par une, il est difficile de comprendre ce que les utilisateurs cherchent réellement à accomplir.
Le système regroupe les requêtes selon leur intention de recherche et les étiquette par type d’intention, par exemple :
Intention de définition
Intention de sélection d’outil
Intention de comparaison
Intention commerciale
Intention tarifaire
Intention d’assistance
Intention de navigation
À l’avenir, cela pourra également être associé à l’intention des utilisateurs dans les scénarios de marketing IA et de recherche par IA.
L’équipe passe ainsi d’une vision constituée de milliers de mots-clés dispersés à un nombre plus restreint de besoins utilisateurs.
Il est également important de préciser les limites de cette fonctionnalité :
Il ne s’agit pas d’une attribution précise des requêtes aux conversions.
Le système ne prétend pas savoir qu’une requête particulière a directement entraîné une inscription précise. Il résout plutôt le problème de l’adéquation entre l’intention de recherche et le contenu : quels besoins d’utilisateurs amènent des personnes sur la page et si la page contient des éléments correspondants pour répondre à ces besoins.
2.3 Analyse du DOM de la page
La troisième étape consiste à analyser le DOM de la page.
Le système explore et analyse la structure de la page, notamment :
Le titre
Les H1
Les H2
Les H3
Les sections FAQ
Les tableaux
Les CTA
Les liens internes
Les extraits du corps du texte
Il détermine ensuite si chaque groupe de requêtes correspond à une section de contenu sur la page.
Par exemple, si les utilisateurs recherchent des comparatifs d’outils, mais que la page se contente d’expliquer des concepts sans proposer de critères de sélection d’outils, de tableau comparatif ni de cas d’usage, le système peut détecter une faible adéquation avec l’intention.
2.4 Évaluation de la qualité des données
Toutes les données ne peuvent pas être utilisées pour générer automatiquement des tâches.
Le système vérifie également si :
Les données GSC sont manquantes
Les données GA4 sont manquantes
Les URL sont correctement associées
La taille de l’échantillon est suffisante
Le suivi des événements est complet
La base de connaissances de la marque est disponible
Les journaux des robots d’exploration IA sont connectés
La qualité des données détermine directement ce que le système est autorisé à faire :
Qualité des données
Comportement du système
Élevée
Générer des ébauches de tâches
Moyenne
Générer des tâches uniquement après confirmation manuelle
Faible
Afficher uniquement les diagnostics, sans génération automatique de tâches
Invalide
Ne pas évaluer ni générer de tâches
Cette étape est essentielle.
Un système de diagnostic du contenu ne doit pas seulement savoir générer des recommandations. Il doit également savoir quand les éléments de preuve sont insuffisants et qu’il ne faut pas recourir à l’automatisation.
3. Boucle de diagnostic : de la demande de recherche à l’adéquation de la page, au comportement utilisateur et à l’action commerciale
Une fois le traitement des données terminé, le système passe à la couche de diagnostic.
3.1 Côté recherche : quelles requêtes et intentions amènent les utilisateurs ?
Le système examine d’abord les requêtes GSC et les groupes de requêtes.
Pour une même page liée à la visibilité IA, les intentions des utilisateurs peuvent varier considérablement :
« Qu’est-ce que la visibilité IA ? » indique une volonté de comprendre un concept.
« Meilleurs outils de visibilité IA pour SaaS » indique une intention de sélection d’outil.
« Comparer les plateformes de suivi GEO » indique une intention de comparaison de solutions.
« Suivre les mentions de marque dans ChatGPT » indique un processus de travail précis.
Si une page répondait auparavant principalement à des requêtes de définition, mais que ses nouvelles impressions proviennent désormais de requêtes de sélection d’outils, de comparaison ou de processus de travail, le système identifie une évolution de la demande des utilisateurs.
Cette étape répond à une question :
Quelle tâche l’utilisateur cherche-t-il à accomplir en arrivant sur la page ?
3.2 Côté page : la page correspond-elle à l’intention de recherche de l’utilisateur ?
Une fois les groupes de requêtes identifiés, le système analyse le DOM de la page.
Chaque type d’intention nécessite une structure de contenu différente :
Type d’intention
Contenu nécessaire
Intention de définition
Définition claire, explication et FAQ
Intention de sélection d’outil
Liste d’outils, critères de sélection, cas d’usage et CTA
Intention de comparaison
Tableaux, tarifs, différences et cas d’usage
Intention liée à un processus de travail
Étapes, indicateurs, modèles et erreurs fréquentes
Intention commerciale
Modules produit, études de cas, CTA et parcours vers l’étape suivante
Le système vérifie si ces éléments apparaissent dans le titre, le H1, les H2, les FAQ, les tableaux et les CTA, ou s’ils sont entièrement absents.
Si un groupe de requêtes génère des impressions dans les résultats de recherche, mais que la page répond seulement de manière superficielle au besoin correspondant, le système signale une lacune de contenu, une nouvelle opportunité de requête ou une faible adéquation avec l’intention de recherche.
Cette étape répond à la question suivante :
La page a-t-elle correctement accueilli et satisfait le besoin de l’utilisateur ?
3.3 Côté comportement : les utilisateurs lisent-ils, voient-ils les CTA et cliquent-ils dessus ?
L’adéquation du contenu ne suffit pas à elle seule. Les données comportementales de GA4 sont nécessaires pour vérifier si les utilisateurs poursuivent réellement leur parcours.
Le système construit un entonnoir de conversion de la visibilité dans les résultats de recherche jusqu’à l’action commerciale.
C’est l’un des points de vue les plus importants du processus de diagnostic, car il aide à localiser les blocages du parcours utilisateur.
Par exemple :
Si les utilisateurs arrivent sur la page, mais que leur engagement est faible, le problème peut venir de l’introduction, de la table des matières, de la structure du contenu ou de l’expérience de chargement de la page.
Si les utilisateurs lisent la page, mais que les impressions des CTA sont faibles, le CTA est peut-être placé trop bas.
Si les impressions des CTA sont normales, mais que les clics sont peu nombreux, le texte du CTA, le module produit ou l’intention de l’utilisateur ne correspondent peut-être pas.
Si des clics sur les CTA existent, mais que les clics sur les boutons d’inscription, les demandes de démo ou les événements clés sont peu nombreux, le problème peut venir du parcours d’inscription, de demande de démo ou de la page de destination qui suit.
Cette étape répond à la question suivante :
Les utilisateurs bloquent-ils au stade de la lecture, de l’exposition au CTA, du clic sur le CTA ou de la conversion commerciale ?
3.4 Côté faits : le contenu est-il obsolète et les informations sur le produit sont-elles exactes ?
Pour le contenu B2B SaaS, l’ancienneté d’un contenu ne se résume pas à sa date de publication.
Un article publié l’année dernière peut toujours être exact. Un autre, mis à jour le mois dernier, peut déjà contenir des informations incorrectes sur les tarifs, les fonctionnalités, les captures d’écran ou les comparatifs avec les concurrents.
La base de connaissances de la marque permet de comparer le contenu des pages aux dernières informations sur les produits. Le système vérifie si :
Les fonctionnalités mentionnées sur la page existent toujours
Les tarifs sont toujours à jour
Les captures d’écran sont obsolètes
Les comparatifs avec les concurrents respectent les critères actuels
Les réponses aux FAQ sont cohérentes avec les réponses officielles
Ce module évite deux problèmes fréquents :
Les anciens articles continuent de fournir aux utilisateurs des informations incorrectes sur les produits.
Le LLM génère des recommandations trompeuses à partir de contenu de page obsolète.
Cette étape répond à la question suivante :
Les recommandations du système s’appuient-elles sur les informations les plus récentes concernant les produits ?
3.5 Côté IA/GEO : les sources IA peuvent-elles accéder à la page et la citer ?
Le module IA/GEO formule principalement deux évaluations.
Premièrement, les sessions provenant de référents IA indiquent si les produits d’IA génèrent de véritables visites. Par exemple, le système vérifie si ChatGPT, Perplexity et des sources similaires génèrent des sessions, et si ces sessions entraînent de l’engagement ou des événements clés.
Deuxièmement, les journaux des robots d’exploration IA indiquent si ces derniers peuvent accéder à la page. Le système vérifie si GPTBot, PerplexityBot, ClaudeBot et des robots similaires ont visité la page, s’ils ont reçu un code 200, 304, 403 ou 404, s’il y a une raison de blocage et si des journaux sont manquants.
Ces deux signaux permettent ensemble de déterminer la prochaine action :
Si la page reçoit des visites de référence provenant de l’IA, mais génère peu de conversions, donner la priorité à l’adéquation du contenu et à l’optimisation des CTA.
Si le statut du robot d’exploration est anormal, donner la priorité à la vérification des règles robots, du WAF, du CDN ou de l’intégration des journaux.
Si l’accès des robots d’exploration est normal, mais que la page manque de définitions claires, d’étapes, de FAQ et de résumés formulés comme des réponses, donner la priorité à la création de contenu facile à citer.
Si les visites de référence provenant de l’IA augmentent, mais que les événements clés restent faibles, le trafic IA existe, mais l’adéquation de la page aux besoins commerciaux doit encore être améliorée.
Cette étape répond à la question suivante :
Dans les scénarios de recherche par IA et de citation par les LLM, le problème concerne-t-il le trafic, le contenu ou la visibilité technique ?
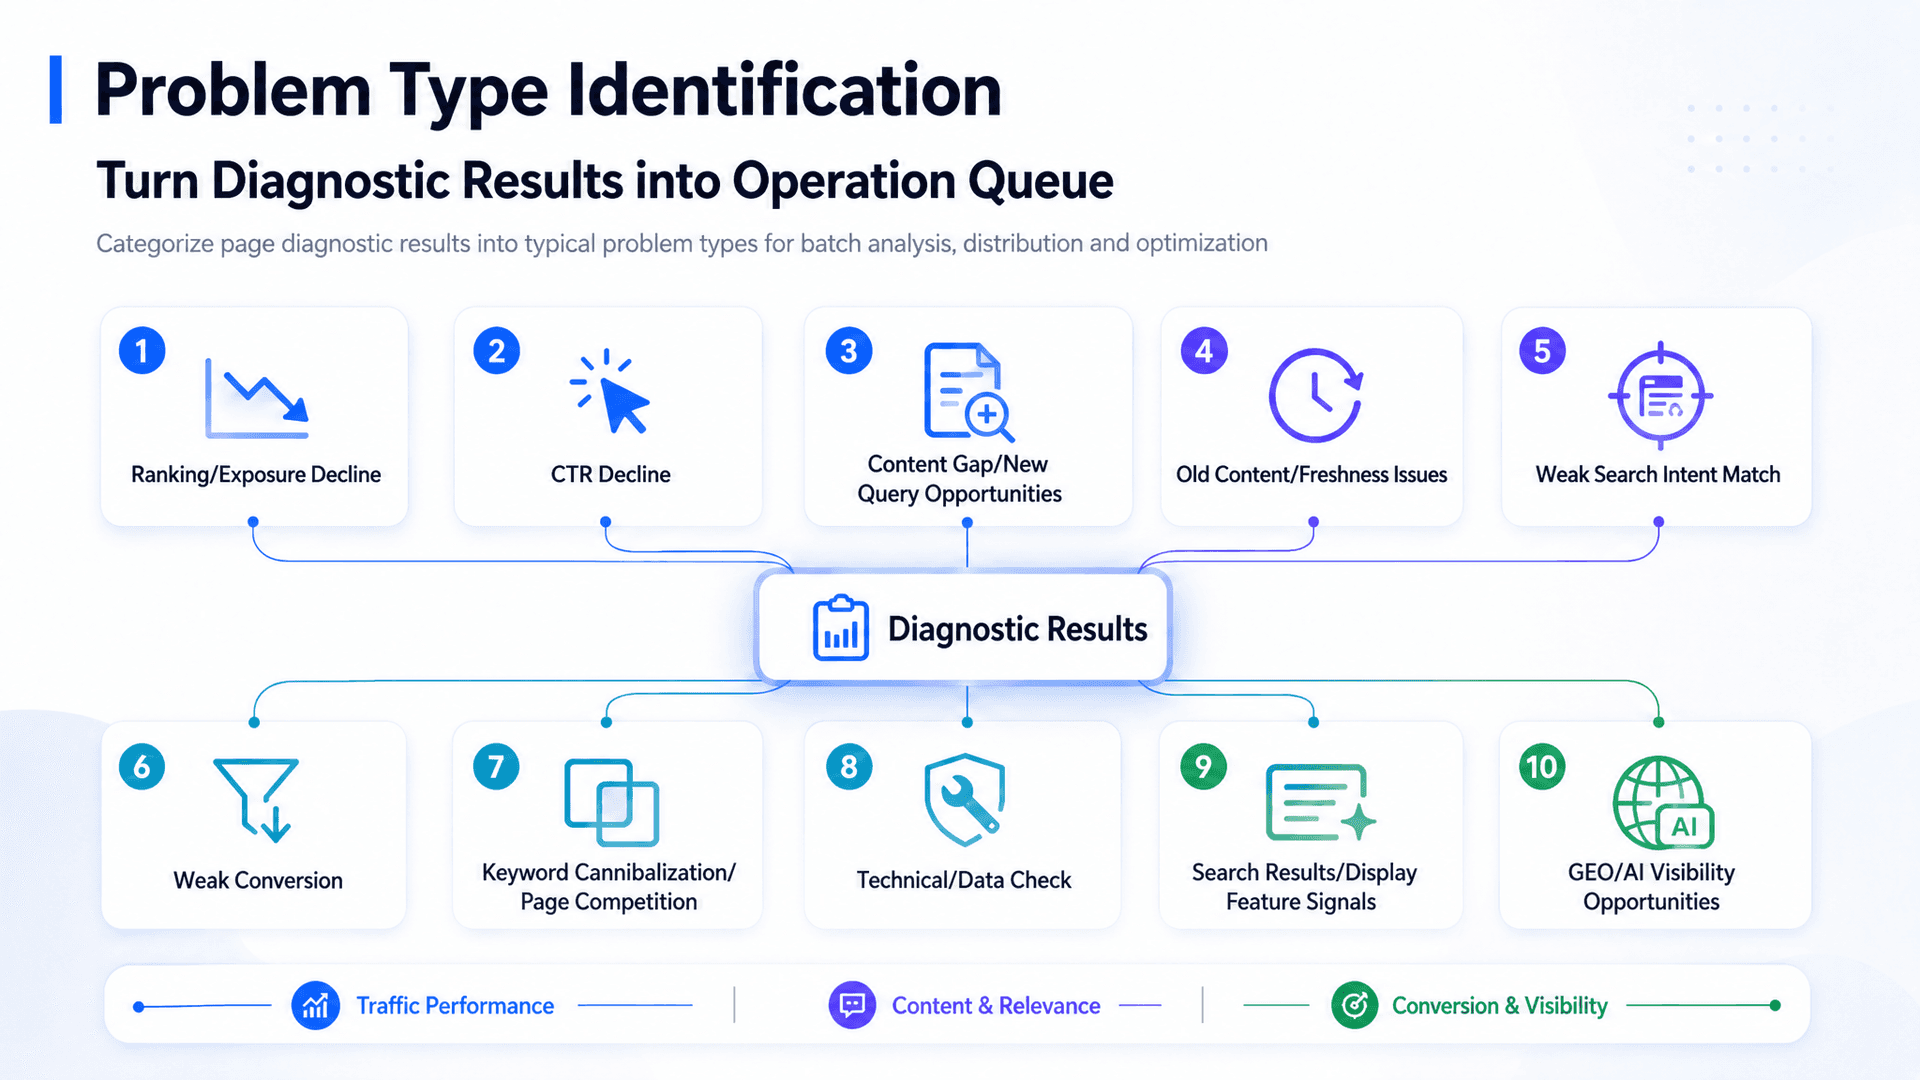
4. Identification du type de problème : transformer les résultats du diagnostic en file de tâches opérationnelles
Après avoir effectué les étapes de diagnostic ci-dessus, le système attribue à chaque page un type de problème précis.
L’intérêt de regrouper les problèmes est de transformer l’optimisation du contenu en opérations par lots plutôt qu’en modifications ponctuelles d’articles.
Les groupes de problèmes courants comprennent :
Baisse du trafic
Baisse du CTR
Faiblesse du contenu ou mauvaise adéquation avec l’intention de recherche
Contenu ancien ou obsolète
Faiblesse des conversions
Pages en doublon ou concurrentes
Opportunités de contenu manquantes
Problèmes techniques ou liés aux données
Problèmes de GEO ou de visibilité IA
Le groupe de pages n’affiche pas uniquement les noms des problèmes. Il présente également :
Les éléments de preuve déclencheurs
Un instantané de l’entonnoir de conversion de la page
Les principaux groupes de requêtes concernés
Les sections de contenu concernées
La qualité des données
Un résumé des actions recommandées
Le responsable
Le statut
Les responsables du contenu peuvent ainsi gérer les tâches chaque semaine par groupe de problèmes.
Par exemple :
Cette semaine : traiter la baisse du CTR.
La semaine prochaine : traiter la faiblesse des conversions.
La semaine suivante : traiter le contenu obsolète et la cannibalisation entre pages.
L’équipe ne modifie plus au hasard les pages qui semblent poser problème. Elle peut plutôt organiser les travaux d’optimisation par type de problème et par priorité.
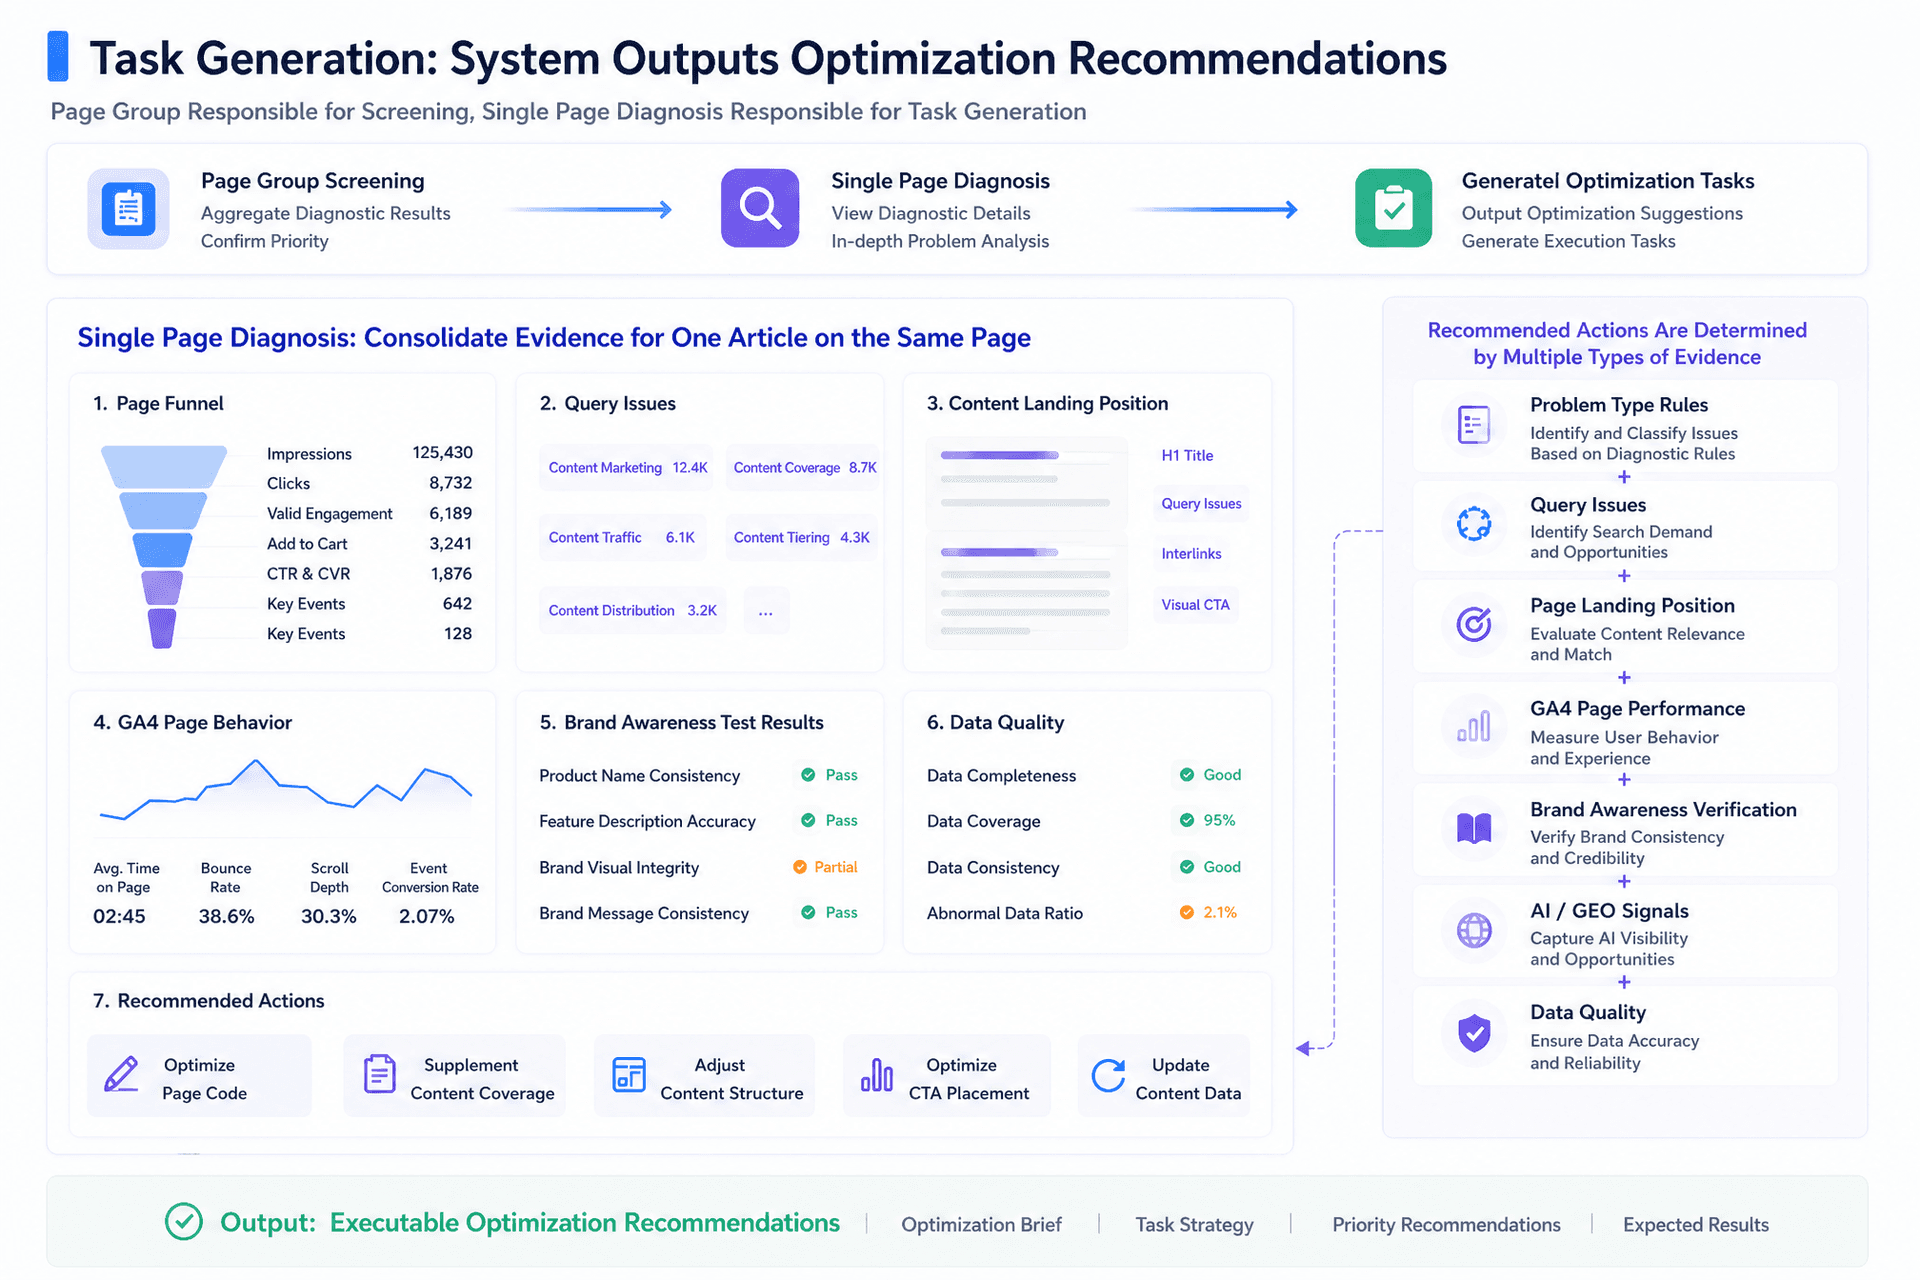
5. Génération de tâches : le système produit des recommandations d’optimisation
Les groupes de pages servent au filtrage. Les diagnostics d’une page individuelle servent à générer des tâches.
Lorsqu’on accède à la vue de diagnostic d’une page individuelle, le système rassemble tous les éléments de preuve associés à un article sur une seule page :
Entonnoir de conversion de la page
Groupes de requêtes
Sections de correspondance du contenu
Comportement sur la page dans GA4
Résultats de vérification de la base de connaissances de la marque
Qualité des données
Actions recommandées
Les actions recommandées sont principalement déterminées par la combinaison de plusieurs types d’éléments de preuve :
textCopy
Règles relatives aux types de problèmes
+ Groupes de requêtes
+ Sections de correspondance du contenu de la page
+ Performances de la page dans GA4
+ Vérification par la base de connaissances de la marque
+ Signaux IA/GEO
+ Qualité des données
Le résultat ne se limite pas à une suggestion vague comme « optimiser cet article ». Il doit prendre la forme d’une tâche qui explique clairement :
Pourquoi cette page doit être mise à jour
Quelle partie de la page pose problème
Ce qu’il faut modifier
Qui doit prendre en charge la tâche
Quels indicateurs vérifier après la mise à jour
6. Exemple : fonctionnement de la chaîne complète de diagnostic sur une page
GSC montre que cette page commence à recevoir des impressions pour des requêtes liées aux « outils de suivi des mentions IA ».
Si nous ne consultons que GSC, nous pouvons voir qu’il existe une demande de recherche, mais nous ne pouvons pas encore déterminer si la page y répond.
Étape 2 : le regroupement des requêtes identifie une intention de sélection d’outil
Le système regroupe ces requêtes dans un groupe correspondant à l’intention de sélection d’outil.
Cela signifie que les utilisateurs ne cherchent pas seulement à comprendre un concept. Ils recherchent une catégorie d’outils, comparent les fonctionnalités des outils et peuvent même être prêts à commencer un essai ou un processus d’achat.
Étape 3 : l’analyse du DOM met en évidence une faible adéquation avec l’intention
Le système analyse le DOM de la page et constate que l’introduction et la structure des H2 expliquent encore principalement le concept.
La page ne propose pas de critères clairs pour choisir un outil, de dimensions de comparaison ni de cas d’usage.
Autrement dit, l’intention côté recherche a évolué vers la sélection d’outils, mais la page reste construite comme un article d’explication de concept.
Étape 4 : GA4 ajoute des éléments de preuve comportementaux
GA4 montre que l’engagement sur la page est relativement élevé, mais que les clics sur les CTA sont peu nombreux.
Cela signifie que les utilisateurs sont prêts à lire, mais que la page ne les guide pas efficacement vers une action liée au produit.
Étape 5 : La base de connaissances de la marque vérifie les informations sur le produit
La base de connaissances de la marque révèle que les captures d’écran du produit présentes sur la page sont obsolètes et que certaines descriptions des fonctionnalités n’ont pas été mises à jour vers la dernière version.
Si ces éléments ne sont pas corrigés, le LLM risque de continuer à s’appuyer sur des informations obsolètes sur le produit pour générer des recommandations d’optimisation.
Étape 6 : Les journaux des robots d’exploration de l’IA vérifient l’accessibilité technique
Les journaux des robots d’exploration de l’IA montrent que GPTBot peut explorer la page normalement.
Cela signifie que le problème prioritaire n’est pas l’exploration technique. Les problèmes les plus urgents sont de savoir si le contenu est suffisamment facile à citer, si les informations sur le produit sont exactes et si le CTA correspond aux besoins des utilisateurs qui sélectionnent un outil.
Ébauche de la tâche finale
Le système génère une ébauche de tâche comme celle-ci :
markdownCopy
Page : /blog/top-tools-to-track-ai-mentions-in-llms

Type de problème :
- Faible adéquation à l’intention de recherche
- Faible conversion
- Contenu obsolète

Éléments déclencheurs :
- Les requêtes de sélection d’outils génèrent des impressions dans les résultats de recherche
- La section d’introduction et la structure des H2 restent axées sur l’explication des concepts
- L’engagement est élevé, mais les clics sur le CTA sont faibles
- La base de connaissances de la marque révèle que les captures d’écran du produit sont obsolètes
- L’exploration par GPTBot fonctionne normalement

Actions recommandées :
- Ajouter un module présentant les critères de sélection d’un outil
- Ajouter un tableau comparatif des outils
- Mettre à jour les captures d’écran du produit
- Remplacer le CTA générique d’inscription par « Voir la solution de suivi des mentions de l’IA »
- Ajouter une FAQ
- Ajouter du contenu étape par étape, plus facile à citer pour les LLM

Indicateurs à suivre après la mise à jour :
- CTR
- Sessions issues de la recherche organique
- Clics sur le CTA
- Clics sur la démo
- Événements clés
- Trafic provenant de l’IA
- Statut d’exploration
Ainsi, un article passe d’une « performance des données difficile à interpréter » à une tâche concrète.
L’équipe sait :
Pourquoi l’article doit être modifié
Où se situe le problème
Quels éléments doivent être mis à jour
Qui doit s’en charger
Quels indicateurs examiner ensuite
7. Suivi et évaluation des performances
Une véritable boucle de croissance du contenu doit également réinjecter dans le système les données de performance après la mise à jour d’un article.
La version actuelle peut déjà exécuter le flux de travail principal, de l’ingestion des données au diagnostic de la page et à la génération d’une ébauche de tâche.
L’étape suivante consiste à ajouter le suivi des performances après exécution, afin de relier chaque mise à jour de contenu aux évolutions ultérieures des indicateurs.
Le système enregistrera :
L’heure de génération de la tâche
Les modules mis à jour
L’heure de mise en ligne
Le responsable
Le statut de la tâche
Les données de performance de suivi
Cela permet aux équipes d’évaluer si chaque action d’optimisation produit réellement des résultats.
8. Ce qu’il reste à développer
À ce stade, le système peut déjà exécuter la principale chaîne de diagnostic. Cependant, plusieurs fonctionnalités doivent encore être améliorées.
8.1 Regroupement des intentions des requêtes
La version actuelle s’appuie principalement sur la similarité textuelle et des règles prédéfinies. Dans les secteurs spécialisés, cette méthode couvre déjà la plupart des requêtes courantes.
Cependant, les requêtes de longue traîne, les termes émergents et les requêtes sémantiquement similaires mais correspondant à des intentions différentes peuvent encore être regroupés à tort.
À l’avenir, le système combinera la correspondance de mots-clés et l’analyse basée sur les LLM afin de classer les groupes de requêtes avec plus de précision.
Pour les groupes d’intentions présentant un faible niveau de confiance, le système indiquera automatiquement qu’une « confirmation manuelle est requise », afin d’éviter de générer des tâches incorrectes lorsque les éléments disponibles sont insuffisants.
8.2 Mise à jour automatique de la base de connaissances de la marque
La base de connaissances actuelle de la marque est encore principalement alimentée par importation manuelle. Cette méthode fonctionne bien pour centraliser initialement les informations essentielles, comme les fonctionnalités du produit, les tarifs, les captures d’écran, les réponses aux FAQ et les règles de communication concernant les concurrents.
Mais, à long terme, la base de connaissances ne peut pas reposer uniquement sur une maintenance manuelle.
L’étape suivante consiste à la connecter aux journaux des modifications du produit, aux données du CMS ou aux sources de documentation internes, afin que sa version puisse être mise à jour automatiquement au fil de l’évolution du produit.
Les vérifications de contenu obsolète dépendront ainsi moins d’un examen manuel. Le système pourra également repérer plus rapidement les fonctionnalités obsolètes, les anciennes captures d’écran, les tarifs erronés et les descriptions de produit qui ne correspondent plus au positionnement actuel.
8.3 Suivi des performances
Le système peut déjà déterminer quel article doit être mis à jour, pourquoi il doit l’être, quels éléments modifier et comment générer une tâche d’optimisation étayée par des éléments probants.
L’étape suivante consiste à ajouter le suivi des performances après l’exécution de la tâche et à relier chaque mise à jour de contenu aux évolutions ultérieures des indicateurs.
Une fois cette étape terminée, les équipes de contenu pourront comprendre :
Si une optimisation a réellement généré de la croissance
Quels types de mises à jour sont les plus efficaces
Quelles pages nécessitent encore d’autres améliorations
Conclusion
L’objectif de ce système de diagnostic de la croissance du contenu n’est pas de fournir un rapport SEO de plus.
Il vise à transformer l’optimisation du trafic organique en un processus :
Exécutable
Mesurable
Évaluable
Lié aux résultats commerciaux
Il relie les données de recherche, le contenu des pages, le comportement des utilisateurs, les informations sur la marque, la visibilité IA/GEO, les tâches d’optimisation et le suivi des performances au sein d’une même boucle fermée.
Ainsi, l’équipe de contenu ne reçoit plus de consigne vague comme « optimiser l’article ».
Si vous développez également un site indépendant destiné aux marchés internationaux et que vous vous intéressez à la croissance du contenu ou à la recherche par IA, vous pouvez ajouter WeChat : dudulhc pour discuter de cette solution ou en savoir plus sur les détails de mise en œuvre du système.
Dageno is the research and insights team at Dageno AI, publishing industry reports and expert analysis on AI Search Visibility, Generative Engine Optimization (GEO), and AI-powered search discovery.