Descubra la posición de su marca en el mercado de IA
Identifique las oportunidades de crecimiento que merecen ser priorizadas en función de la demanda del mercado, el panorama competitivo, las propuestas de valor de la marca y las fuentes de citación.
De GSC/GA4 a tareas de optimización: Cómo construir un sistema de diagnóstico de crecimiento de contenido
Un marco práctico para convertir datos de GSC, GA4, conocimiento de marca, referencias de IA y rastreadores en tareas de optimización de contenido accionables.
Explora más de 12,000 nichos de mercado sin necesidad de registrarte.
Actualizado por
10 lectura mínima•
Actualizado el Jun 29, 2026
En los últimos años, un cambio se ha vuelto cada vez más evidente: las operaciones de contenido están pasando de una mentalidad centrada en el tráfico a una mentalidad centrada en el crecimiento.
A medida que la búsqueda mediante IA y la distribución de contenido se vuelven más complejas, simplemente hacer SEO, publicar artículos y realizar un seguimiento de las impresiones o clics ya no es suficiente. Ahora se espera que los equipos de contenido comprendan el user journey completo: cómo llegan los usuarios, por qué permanecen, por qué no convierten y qué se debe optimizar en cada etapa.
En otras palabras, los roles de contenido están evolucionando gradualmente de ejecutores de contenido a participantes e incluso diseñadores de sistemas de crecimiento.
Esto me ha quedado muy claro mientras trabajaba en proyectos de crecimiento de contenido (content growth).
Métricas como las impresiones, los clics, el posicionamiento (rankings), el estado de indexación y el volumen de artículos siguen siendo importantes. Pero el verdadero motor de los resultados no es si un sitio tiene más contenido, sino si el contenido existente conecta con éxito la demanda de búsqueda con las acciones de negocio.
Esto es especialmente cierto para B2B SaaS, sitios web independientes, sitios de comercio electrónico y webs de fabricación. Muchos sitios no carecen de tráfico por completo; más bien, el tráfico llega pero no logra avanzar en el embudo. Los usuarios entran a través de la búsqueda, pero la página no satisface adecuadamente su intención. Los usuarios leen el artículo, pero no ven un CTA (call-to-action). Los usuarios hacen clic en un CTA, pero no completan una conversión clave.
El problema no es la falta de datos. El problema es la ausencia de una cadena de toma de decisiones que conecte:
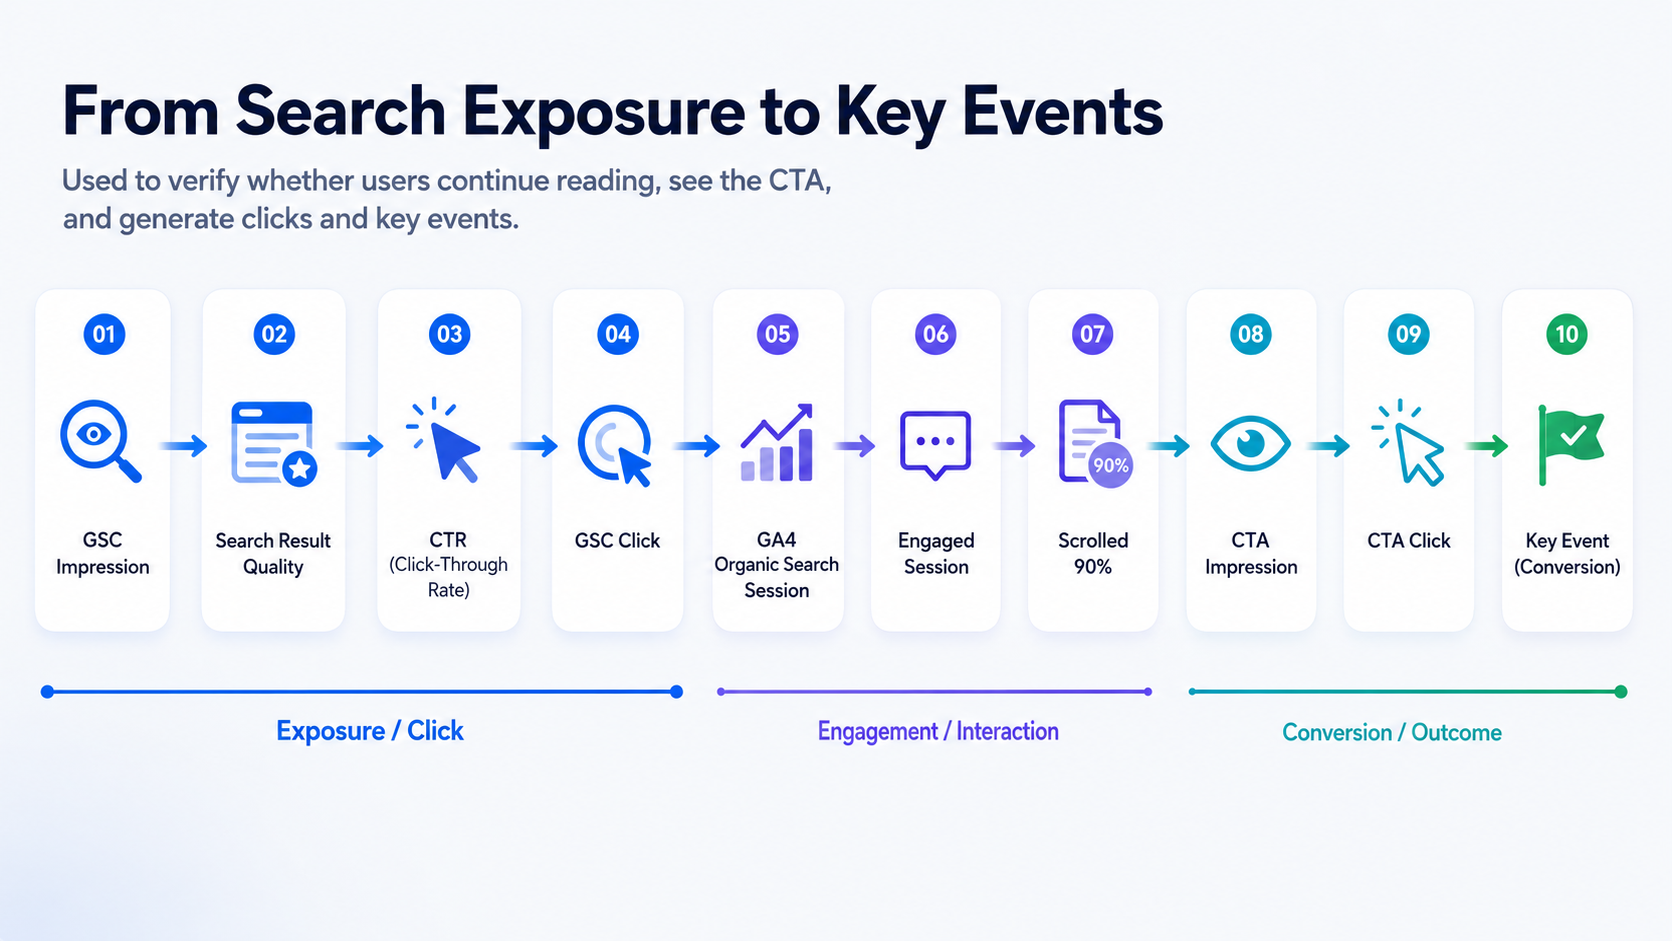
Demanda de búsqueda → Coincidencia de la intención de página → Comportamiento del usuario → Acción de negocio → Tarea de optimización → Feedback de rendimiento
Para resolver esto, construimos un sistema interno de diagnóstico de crecimiento de contenido y lo hemos validado en múltiples sitios web independientes de comercio electrónico, fabricación, electrónica de consumo y SaaS de IA.
Este sistema no es un informe de SEO estándar, ni tampoco es una herramienta que simplemente pide a la IA que genere sugerencias de optimización genéricas. En su lugar, conecta GSC, GA4, la base de conocimientos de la marca, referencias de IA y logs de rastreadores (crawlers) de IA en un flujo de trabajo de diagnóstico a nivel de página.
Ayuda a los equipos a responder las siguientes preguntas:
¿Qué consultas (queries) e intenciones atraen a los usuarios a la página?
¿La página coincide y satisface adecuadamente dicha intención?
Después de que los usuarios aterrizan en la página, ¿leen, ven los CTAs y hacen clic?
¿La información del producto en la página es precisa?
¿Los productos de IA generan visitas y pueden los crawlers de IA acceder a la página?
¿Cómo se puede convertir la evidencia en una tarea de optimización accionable?
¿Qué métricas deben seguirse después de actualizar la página?
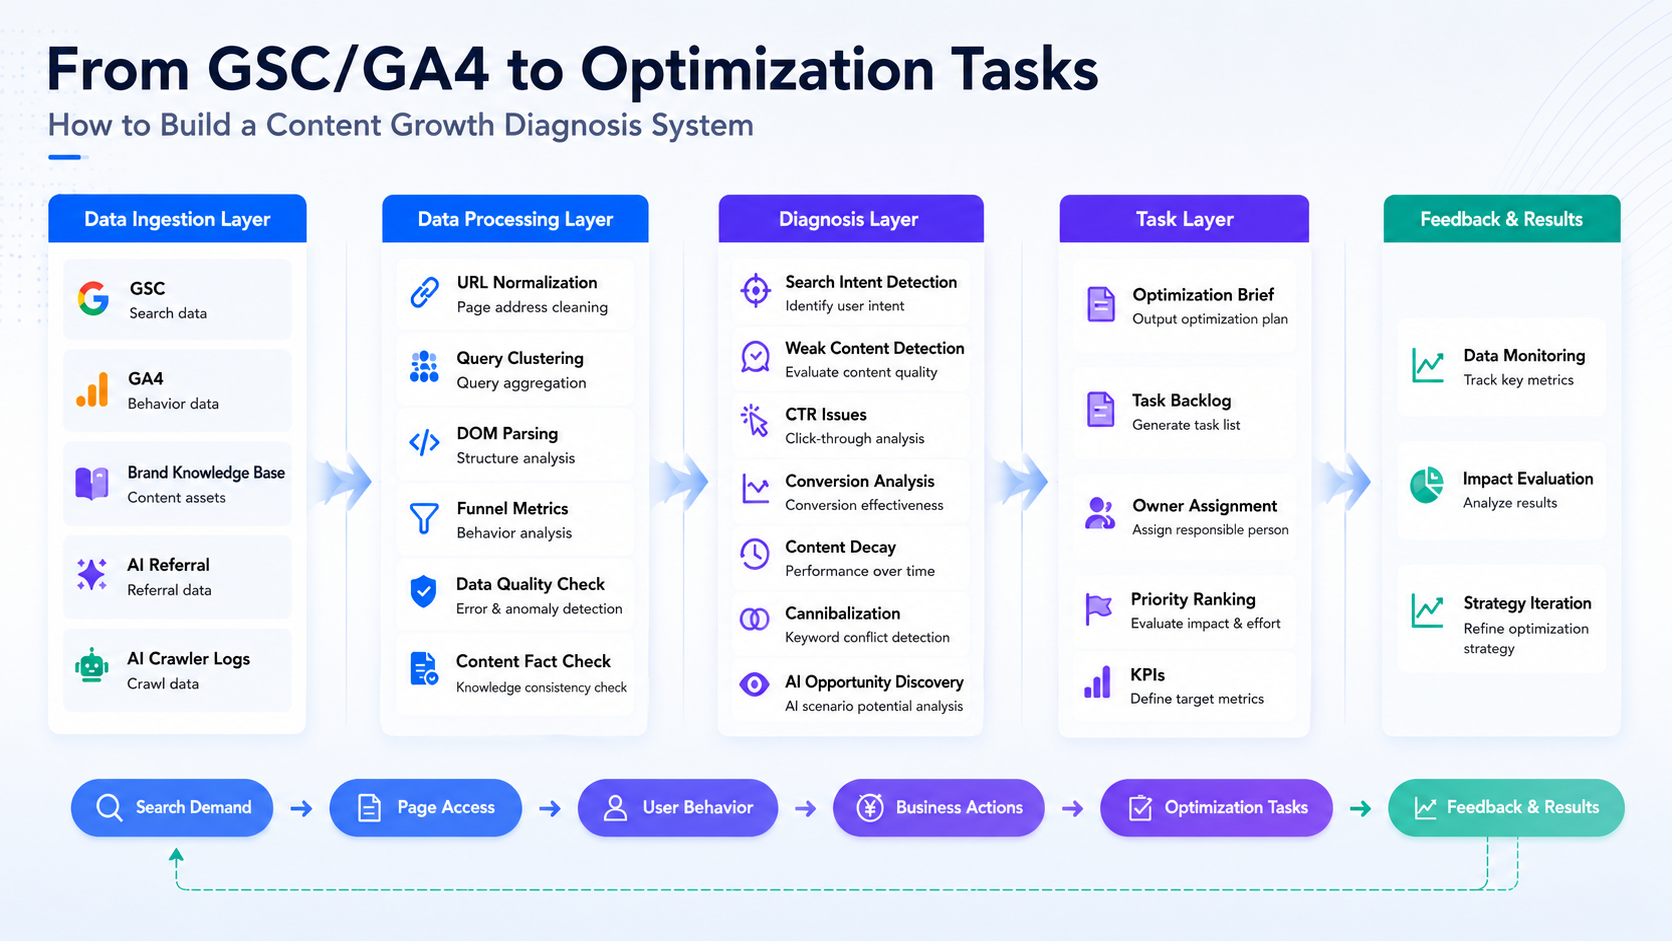
El flujo de datos general funciona así:
Primero, se conectan los datos. Luego, los datos de diferentes fuentes se alinean con la misma URL. Se utilizan clústeres de consultas para identificar la intención de búsqueda. El análisis del DOM de la página se utiliza para determinar si el contenido satisface esa intención. Se combinan los datos del embudo de GSC y GA4 para identificar dónde abandonan los usuarios. La base de conocimientos de la marca se utiliza para verificar la veracidad del contenido. Las señales de IA/GEO (Generative Engine Optimization) se utilizan para evaluar el tráfico de referencia de la IA y la accesibilidad de los rastreadores. Finalmente, toda la evidencia se convierte en tareas de optimización, y el rendimiento se rastrea continuamente tras la publicación de los cambios.
A continuación, se detalla el flujo de trabajo completo.
1. Ingesta de datos: Conectar la búsqueda, el comportamiento, los hechos y las señales de IA en una única cadena
La primera capa es la ingesta de datos. Conectamos principalmente cinco tipos de datos:
Google Search Console (GSC)
Google Analytics 4 (GA4)
Base de conocimientos de la marca
Sesiones de referencia de IA
Logs de rastreadores (crawlers) de IA
1.1 GSC y GA4
GSC es responsable del rendimiento desde el lado de la búsqueda. Proporciona impresiones, clics, CTR, posición media y rendimiento detallado a nivel de consulta.
A través de GSC, el sistema puede identificar qué consultas ayudan a los usuarios a descubrir una página y qué páginas aún reciben impresiones pero comienzan a perder tasa de clics (CTR).
GA4 es responsable del comportamiento en el sitio. Proporciona sesiones de aterrizaje desde búsqueda orgánica, tasa de interacción (engagement rate), comportamiento de scroll, impresiones de CTA, clics en CTA, registros y eventos clave.
A través de GA4, el sistema puede determinar si los usuarios continúan leyendo después de llegar a la página, si ven los puntos de entrada del producto, si hacen clic en los CTAs y si acceden a acciones críticas para el negocio.
GSC y GA4 solo se vuelven poderosos cuando se usan juntos.
Si solo observamos GSC, solo vemos qué sucede en los resultados de búsqueda. Si solo observamos GA4, solo vemos qué sucede después de que los usuarios llegan al sitio. Cuando ambos se conectan, el sistema puede identificar exactamente dónde se "atasca" un artículo.
Por ejemplo:
Altas impresiones pero bajo CTR
Priorizar el título, la meta descripción y la relevancia del resultado de búsqueda.
Altos clics pero baja interacción (engagement)
Priorizar la sección de apertura, la tabla de contenidos, la estructura de la página y la coincidencia entre contenido e intención.
Buena interacción pero pocos clics en CTA
Priorizar los módulos de producto, el copy del CTA y la ubicación del mismo.
Existen clics en la CTA, pero los eventos clave siguen siendo bajos
Continúa verificando el camino de registro, el camino de demostración o el flujo de la landing page.
1.2 Base de conocimiento de marca (Brand Knowledge Base)
La base de conocimiento de marca es responsable de la verificación de hechos del producto.
Los equipos pueden sincronizar las últimas funcionalidades del producto, planes de precios, versiones de capturas de pantalla, mensajes de marca, estándares de comparación con la competencia, respuestas a preguntas frecuentes (FAQ) y actualizaciones importantes del producto en la base de conocimiento.
El sistema luego compara el contenido de la página con la base de conocimiento para determinar si la información del producto en un artículo ha quedado obsoleta.
El propósito de este módulo es proporcionar al LLM una fuente de hechos de producto actualizada, unificada y confiable.
Sin una base de conocimiento de marca, el sistema solo puede inferir si el contenido podría estar desactualizado basándose en la fecha de publicación, la redacción relacionada con el año, capturas de pantalla o la vigencia en los SERP. Una vez conectada la base de conocimiento, el sistema puede generar tareas mucho más específicas, tales como:
Reemplazar capturas de pantalla de productos obsoletas
Corregir descripciones de planes de precios
Reescribir tablas de comparación de la competencia
Sincronizar las últimas respuestas de FAQ
1.3 Referencias de IA y registros de crawlers de IA
Los datos de IA/GEO se dividen en dos categorías:
Sesiones de referencia de IA (AI referral sessions)
Registros de crawlers de IA (AI crawler logs)
Las sesiones de referencia de IA provienen de GA4. Muestran si productos como ChatGPT o Perplexity generan visitas reales al sitio web y si esas visitas generan engagement o eventos clave.
Los registros de crawlers de IA provienen de registros del servidor, Cloudflare, registros de CDN o registros de borde (edge logs). Muestran si crawlers como GPTBot, PerplexityBot y ClaudeBot han accedido a una página, si el código de estado es normal y si el acceso se ve afectado por reglas de robots, WAF, configuración de CDN o registros faltantes.
Esta distinción es importante:
Los crawlers de IA no son fuentes de tráfico de GA4.
GA4 es adecuado para medir las sesiones de referencia de productos de IA. El acceso de los crawlers debe verificarse a través de los registros.
Una página puede haber sido rastreada por GPTBot pero no tener sesiones de referencia de ChatGPT. Otra página puede tener tráfico de referencia de Perplexity, pero registros de crawler incompletos. Solo cuando ambos indicadores se revisan en conjunto, el equipo puede determinar si una página necesita más contenido citable o si primero se debe verificar la accesibilidad técnica.
2. Procesamiento de datos: primero alinear las URLs y luego construir evidencia a nivel de página
Después de conectar los datos, el sistema no genera sugerencias de inmediato. Primero procesa los datos.
El objetivo de la capa de procesamiento es convertir datos dispersos en evidencia a nivel de página.
2.1 Alineación de datos a nivel de URL
El primer paso es la alineación de URLs.
GSC, GA4 y los registros del servidor suelen registrar las direcciones de página de manera diferente.
Por ejemplo, el mismo artículo puede aparecer en GSC como una URL completa, en GA4 con parámetros de seguimiento y en los registros del servidor solo como una ruta de página (page path). Si el sistema no estandariza estas direcciones primero, el mismo artículo se dividirá en múltiples registros: clics de búsqueda en un lugar, sesiones en el sitio en otro, clics de CTA en otra parte y acceso de crawlers en otra ubicación.
Por lo tanto, el sistema primero limpia las direcciones de las páginas eliminando parámetros UTM, parámetros de clics de anuncios, anclajes de página (page anchors) y otros elementos que no cambian el contenido de la página en sí. Luego, asigna el mismo artículo a una URL canónica única.
Solo después de este paso, las impresiones, clics, sesiones, CTA, eventos clave y registros de crawlers de IA pueden atribuirse correctamente al mismo artículo.
2.2 Clustering de consultas
Un cluster de consultas significa agrupar consultas de búsqueda similares basadas en la intención del usuario.
GSC suele contener una gran cantidad de consultas fragmentadas. Si el equipo de contenido analiza estas consultas una por una, es difícil entender qué es lo que los usuarios realmente intentan lograr.
El sistema agrupa las consultas por intención de búsqueda y las etiqueta con tipos de intención, tales como:
Intención de definición
Intención de selección de herramientas
Intención de comparación
Intención comercial
Intención de precios
Intención de soporte
Intención de navegación
En el futuro, esto también podrá mapearse a la intención del usuario en escenarios de marketing y búsqueda con IA.
Esto transforma la visión del equipo, pasando de miles de palabras clave dispersas a un número menor de necesidades de los usuarios.
También es importante clarificar el límite de esta funcionalidad:
Esta no es una atribución precisa de consulta a conversión.
El sistema no pretende saber que una consulta específica causó directamente un registro (sign-up) específico. En cambio, resuelve el problema de la intención de búsqueda y la concordancia de contenido: qué necesidades del usuario atraen a las personas a la página y si la página tiene el contenido correspondiente para atender esas necesidades.
2.3 Análisis (Parsing) del DOM de la página
El tercer paso es el análisis del DOM de la página.
El sistema rastrea y analiza la estructura de la página, incluyendo:
Título
H1
H2
H3
Secciones de FAQ
Tablas
CTA
Enlaces internos
Fragmentos de contenido del cuerpo (body content snippets)
Luego, determina si cada cluster de consultas tiene una posición de contenido correspondiente en la página.
Por ejemplo, si los usuarios buscan consultas de comparación de herramientas, pero la página solo explica conceptos, sin criterios de selección de herramientas, tablas comparativas o casos de uso, el sistema puede identificar una coincidencia de intención débil (weak intent matching).
2.4 Evaluación de la calidad de los datos
No todos los datos son adecuados para la generación automática de tareas.
El sistema también verifica si:
Faltan datos de GSC (Google Search Console)
Faltan datos de GA4
Las URLs están correctamente vinculadas
El tamaño de la muestra es suficiente
El seguimiento de eventos (event tracking) está completo
La base de conocimiento de la marca está disponible
Los registros del rastreador (crawler logs) de IA están conectados
La calidad de los datos determina directamente lo que el sistema tiene permitido hacer:
Calidad de datos
Comportamiento del sistema
Alta
Generar borradores de tareas
Media
Generar tareas solo después de confirmación manual
Baja
Mostrar solo diagnósticos, sin generación automática de tareas
Inválida
No evaluar ni generar tareas
Este paso es crítico.
Un sistema de diagnóstico de contenido no solo debe saber cómo generar recomendaciones; también debe saber cuándo las pruebas son insuficientes y no se debe utilizar la automatización.
3. Bucle de diagnóstico: De la intención de búsqueda a la coincidencia de página, el comportamiento del usuario y la acción empresarial
Una vez completado el procesamiento de datos, el sistema entra en la capa de diagnóstico.
3.1 Lado de búsqueda: ¿Qué consultas e intenciones atraen a los usuarios?
El sistema revisa primero las consultas de GSC y los clústeres de consultas (query clusters).
Para una misma página relacionada con la visibilidad en IA (AI visibility), la intención del usuario puede variar significativamente:
“¿Qué es la visibilidad de IA?” indica una comprensión conceptual.
“Mejores herramientas de visibilidad de IA para SaaS” indica selección de herramientas.
“Comparar plataformas de monitorización GEO” indica comparación de soluciones.
“Rastrear menciones de marca en ChatGPT” indica un flujo de trabajo (workflow) específico.
Si una página servía anteriormente principalmente para consultas basadas en definiciones, pero ahora recibe nuevas impresiones de consultas de selección de herramientas, comparación o flujos de trabajo, el sistema identifica que la demanda del usuario ha cambiado.
Este paso responde a una pregunta:
¿Qué tarea intenta completar el usuario al ingresar a la página?
3.2 Lado de la página: ¿La página coincide con la intención de búsqueda del usuario?
Después de identificar los clústeres de consultas, el sistema analiza el DOM de la página.
Diferentes intenciones requieren diferentes estructuras de contenido:
Tipo de intención
Contenido necesario
Intención de definición
Definición clara, explicación y preguntas frecuentes (FAQ)
Intención de selección de herramientas
Lista de herramientas, criterios de selección, casos de uso y CTA
Intención de comparación
Tablas, precios, diferencias y casos de uso
Intención de flujo de trabajo
Pasos, métricas, plantillas y errores comunes
Intención comercial
Módulos de producto, estudios de caso, CTA y ruta de siguientes pasos
El sistema verifica si estos elementos aparecen en el título, H1, H2, FAQ, tablas, CTAs, o si faltan por completo.
Si un clúster de consultas tiene impresiones de búsqueda pero la página cubre esa necesidad de forma superficial, el sistema lo marca como una brecha de contenido (content gap), una nueva oportunidad de consulta o una coincidencia de intención de búsqueda débil.
Este paso responde a:
¿La página recibió y satisfizo adecuadamente la necesidad del usuario?
3.3 Lado del comportamiento: ¿Los usuarios leen, ven los CTAs y hacen clic?
La coincidencia de contenido por sí sola no es suficiente. Se necesitan datos de comportamiento de GA4 para verificar si los usuarios realmente continúan realizando alguna acción.
El sistema construye un embudo de página (page funnel) desde la exposición en la búsqueda hasta la acción empresarial.
Esta es una de las perspectivas más importantes en el proceso de diagnóstico porque ayuda a localizar dónde están atascados los usuarios.
Por ejemplo:
Si los usuarios llegan a la página pero la interacción (engagement) es baja, el problema puede ser la sección de introducción, la tabla de contenido, la estructura del contenido o la experiencia de carga de la página.
Si los usuarios leen la página pero las impresiones de los CTA son bajas, el CTA puede estar colocado demasiado abajo.
Si las impresiones de los CTA son normales pero los clics son bajos, el copy del CTA, el módulo de producto o la intención del usuario pueden estar desalineados.
Si existen clics en el CTA pero los clics de registro, de demostración o de eventos clave son bajos, el problema puede estar en el registro posterior, en la demostración o en la ruta de la página de destino (landing page).
Este paso responde a:
¿Están los usuarios atascados en la lectura, la exposición al CTA, el clic en el CTA o la conversión empresarial?
3.4 Lado de los hechos: ¿Está el contenido desactualizado y la información del producto es precisa?
Para el contenido B2B SaaS, el contenido desactualizado no es solo una cuestión de fecha de publicación.
Un artículo publicado el año pasado aún puede ser preciso. Otro artículo actualizado el mes pasado ya podría contener precios, funcionalidades, capturas de pantalla o comparaciones de la competencia incorrectas.
La base de conocimiento de la marca alinea el contenido de la página con los hechos más recientes del producto. El sistema comprueba si:
Las funcionalidades mencionadas en la página todavía existen
Los precios siguen estando vigentes
Las capturas de pantalla están obsoletas
Las comparaciones con la competencia siguen el estándar actual
Las respuestas de las FAQ son coherentes con las respuestas oficiales
Este módulo evita dos problemas comunes:
Que artículos antiguos sigan dando a los usuarios información incorrecta sobre el producto.
Que el LLM genere recomendaciones engañosas basadas en contenido de página desactualizado.
Este paso responde a:
¿Se basan las recomendaciones del sistema en los hechos más recientes sobre el producto?
3.5 Lado de IA/GEO: ¿Puede la IA acceder y citar la página?
El módulo de IA/GEO realiza principalmente dos tipos de evaluaciones:
Primero, las sesiones de referencia de IA muestran si los productos de IA generan visitas reales. Por ejemplo, el sistema verifica si fuentes como ChatGPT, Perplexity y similares generan sesiones, y si dichas sesiones derivan en interacciones o eventos clave.
Segundo, los logs (registros) de rastreadores de IA muestran si los bots de IA pueden acceder a la página. El sistema comprueba si GPTBot, PerplexityBot, ClaudeBot y otros rastreadores similares han visitado la página, si devolvieron códigos 200, 304, 403 o 404, si existe algún motivo de bloqueo y si falta algún registro.
Estas dos señales determinan conjuntamente la acción a seguir:
Si la página tiene referencias de IA pero una conversión débil, prioriza la concordancia de contenido y la optimización del CTA.
Si el estado del rastreador es anómalo, prioriza las reglas de robots, WAF, CDN o las integraciones de logs.
Si el acceso del rastreador es normal pero a la página le faltan definiciones claras, pasos, secciones de preguntas frecuentes (FAQ) o resúmenes tipo respuesta, prioriza la creación de contenido citable.
Si las referencias de IA están creciendo pero los eventos clave son débiles, significa que hay tráfico de IA, pero que la correspondencia del contenido de la página a nivel de negocio aún necesita mejoras.
Este paso responde a:
En escenarios de búsqueda por IA y citas de LLM, ¿es el problema el tráfico, el contenido o la visibilidad técnica?
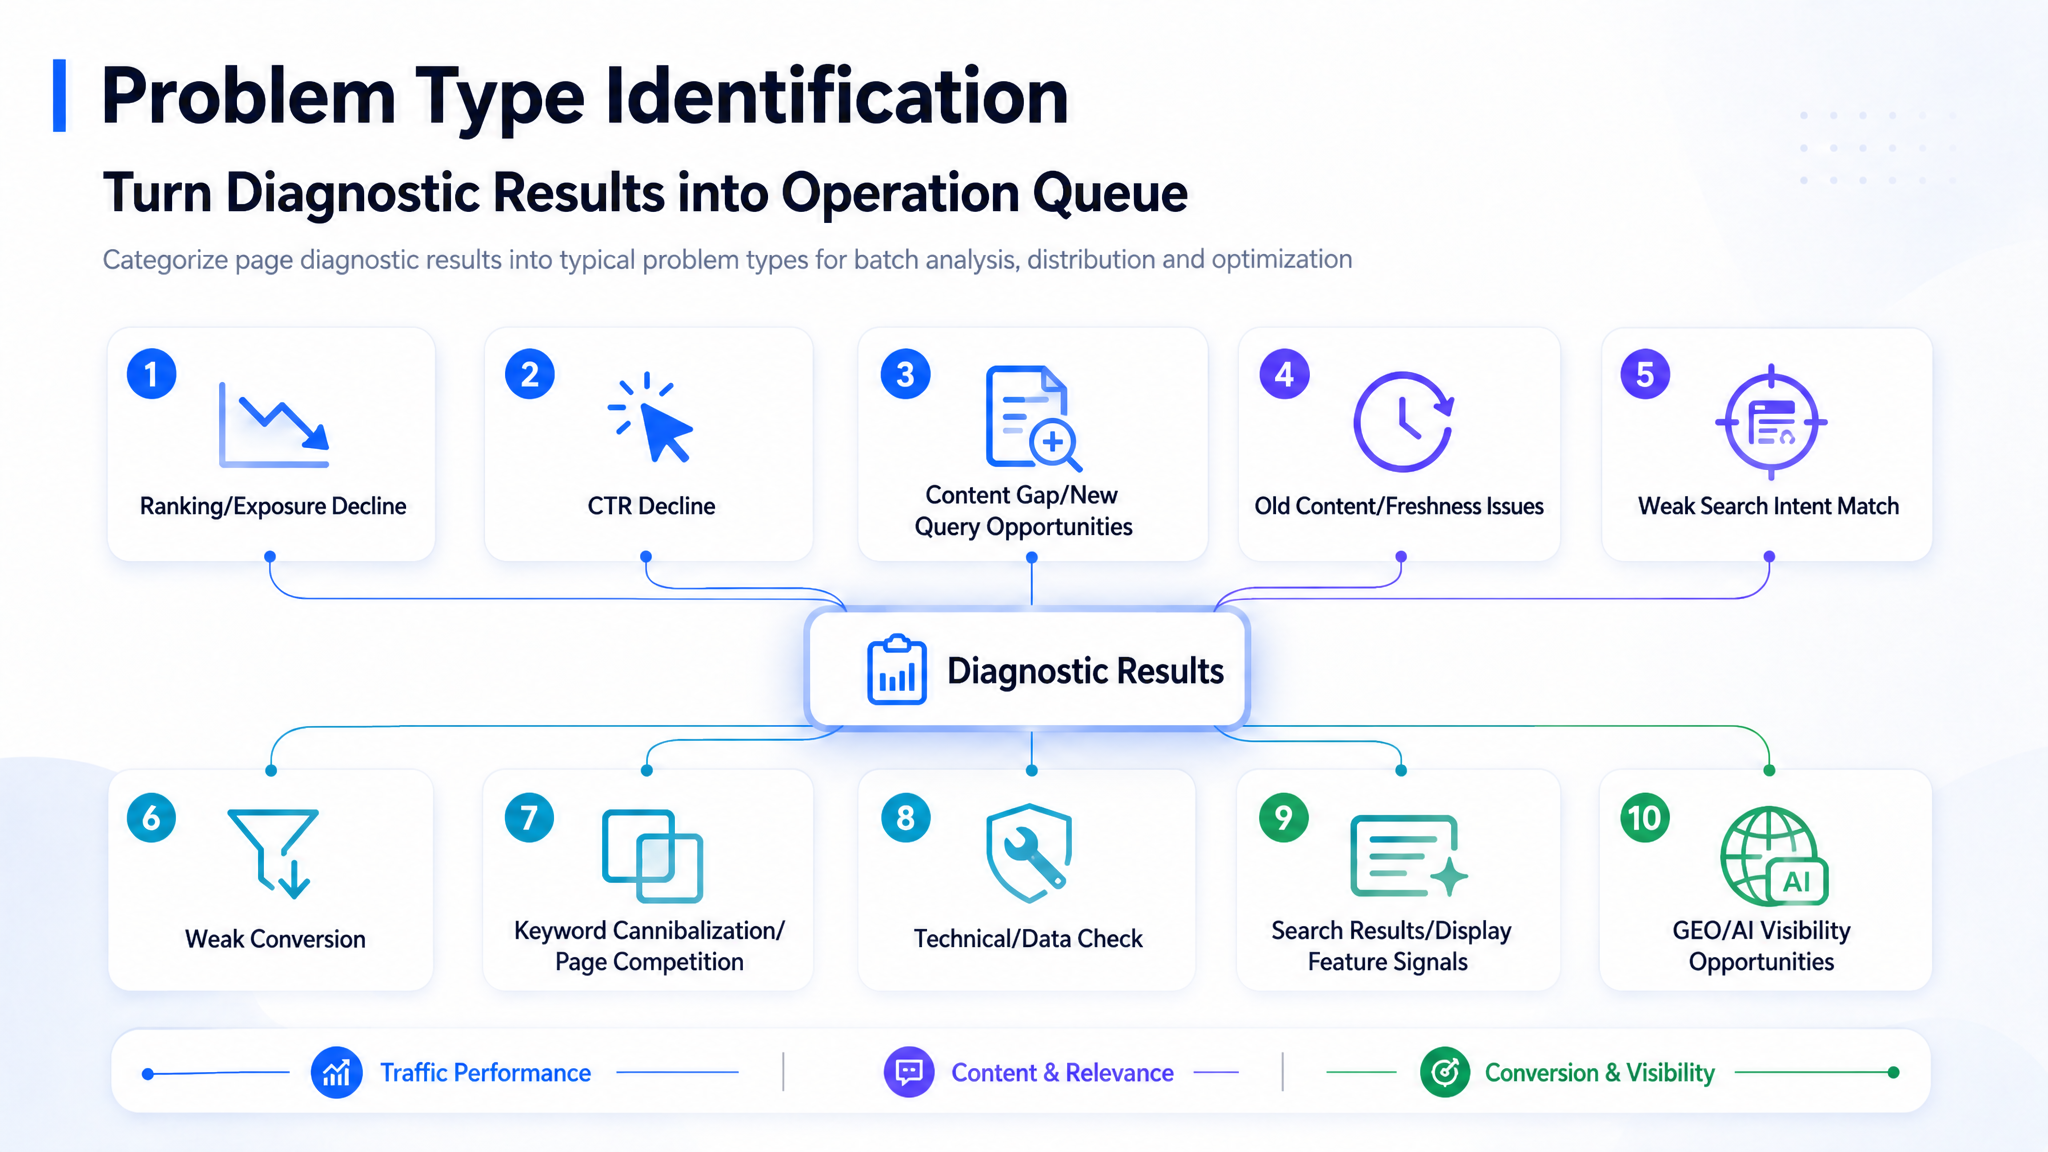
4. Identificación del tipo de incidencia: Convertir los resultados del diagnóstico en una cola operativa
Tras completar los pasos de diagnóstico anteriores, el sistema asigna a cada página un tipo de incidencia específico.
El valor de agrupar las incidencias radica en que la optimización de contenidos se convierte en una operación por bloques (batch) en lugar de una edición de artículos aislada.
Los grupos de incidencia comunes incluyen:
Caída de tráfico
Caída del CTR
Contenido deficiente o baja concordancia con la intención de búsqueda
Contenido obsoleto o desactualizado
Conversión débil
Páginas duplicadas o canibalizadas
Oportunidades de contenido perdidas
Problemas técnicos o de datos
Problemas de visibilidad GEO o IA
El grupo de páginas no solo muestra los nombres de las incidencias, sino también:
Evidencia del desencadenante
Instantánea del embudo de la página
Principales clústeres de queries afectados
Posiciones de contenido
Calidad de los datos
Resumen de acciones recomendadas
Responsable
Estado
Esto permite a los propietarios del contenido gestionar el trabajo por grupos de incidencia cada semana.
Por ejemplo:
Esta semana: gestionar la caída del CTR.
La próxima semana: gestionar la conversión débil.
La siguiente semana: gestionar el contenido obsoleto y la canibalización de páginas.
El equipo ya no edita aleatoriamente la página que parece tener un error; en su lugar, pueden avanzar en el trabajo de optimización según el tipo de incidencia y la prioridad.
5. Generación de tareas: El sistema arroja recomendaciones de optimización
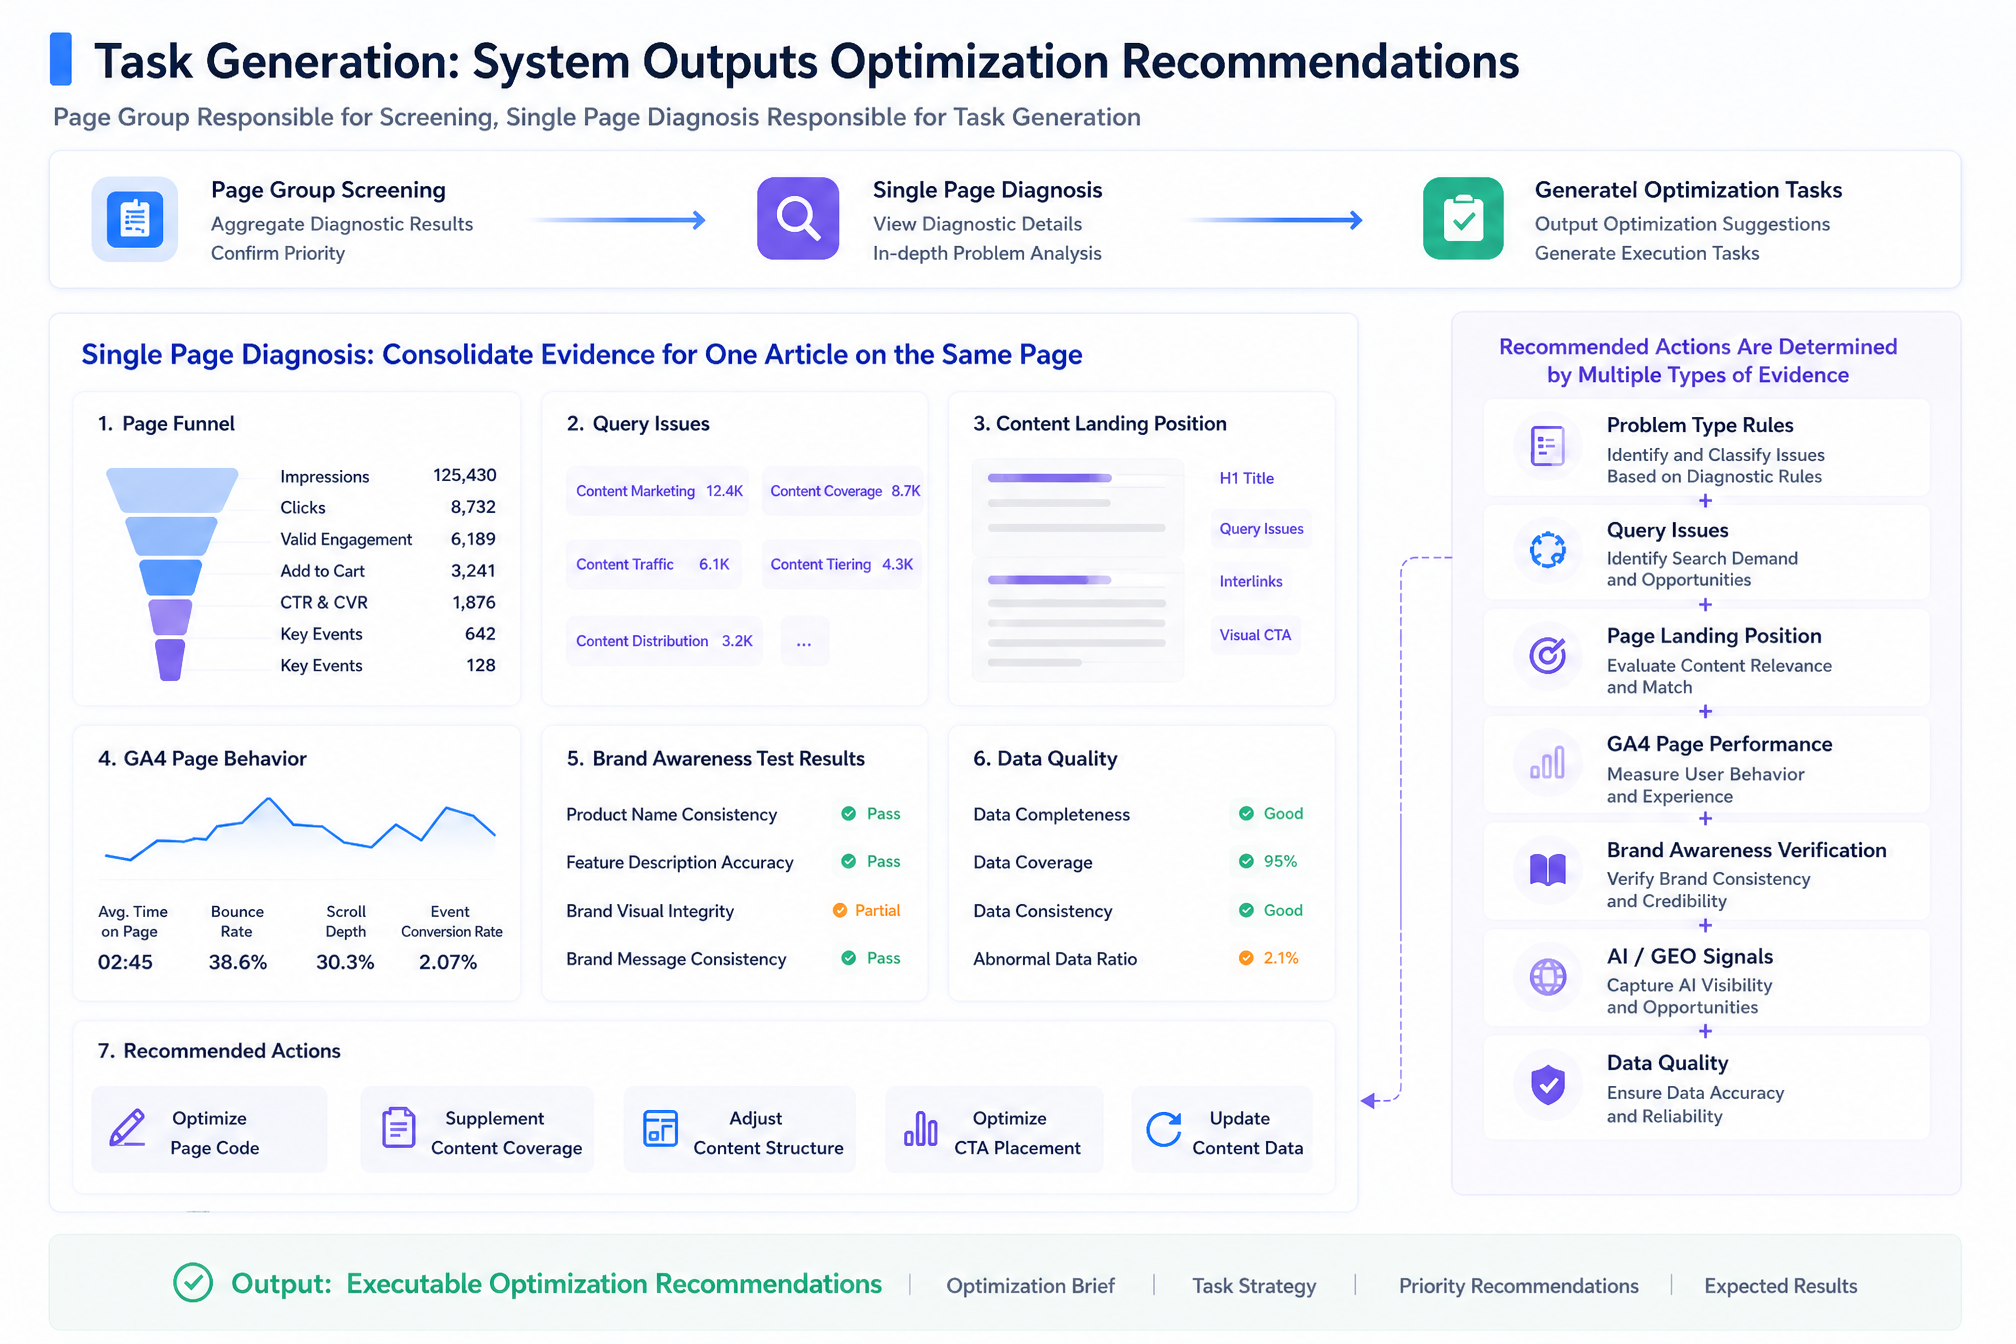
Los grupos de página se utilizan para filtrar. Los diagnósticos de página única se utilizan para la generación de tareas.
Al ingresar a la vista de diagnóstico de una página específica, el sistema coloca toda la evidencia del artículo en un solo panel:
Embudo de la página
Clústeres de queries
Posiciones de concordancia de contenido
Comportamiento en la página (GA4)
Resultados de verificación de la base de conocimientos de marca
Calidad de datos
Acciones recomendadas
Las acciones recomendadas se determinan principalmente mediante una combinación de tipos de evidencia:
textCopy
Reglas de tipo de incidencia
+ Clústeres de queries
+ Posiciones de concordancia de contenido de la página
+ Rendimiento de la página en GA4
+ Verificación de la base de conocimientos de marca
+ Señales de IA/GEO
+ Calidad de los datos
El resultado no es una sugerencia vaga como "optimiza este artículo", sino una tarea que explica claramente:
Por qué debe actualizarse esta página
Qué parte de la página presenta un problema
Qué cambios deben realizarse
Quién es el responsable de la tarea
Qué métricas deben revisarse tras la actualización
6. Ejemplo: Cómo funciona la cadena de diagnóstico completa en una página
GSC muestra que esta página está empezando a recibir impresiones de consultas relacionadas con "herramientas de seguimiento de menciones en IA".
Si solo miramos GSC, vemos que existe demanda de búsqueda, pero no podemos determinar si la página satisface dicha demanda.
Paso 2: El clúster de queries identifica la intención de selección de herramientas
El sistema agrupa estas consultas en un clúster de intención de "selección de herramientas".
Esto significa que los usuarios no solo están intentando comprender un concepto, sino que están buscando una categoría de herramientas, comparando capacidades y, posiblemente, preparados para iniciar una prueba o un proceso de compra.
Paso 3: El análisis del DOM detecta una concordancia de intención débil
El sistema analiza el DOM de la página y descubre que la introducción y la estructura de los H2 se centran principalmente en explicar el concepto.
La página no ofrece criterios claros de selección, dimensiones de comparación ni casos de uso.
En otras palabras, la intención de búsqueda ha cambiado hacia la selección de herramientas, pero la página sigue comportándose como un artículo explicativo conceptual.
Paso 4: GA4 añade evidencia conductual
GA4 muestra que la página tiene un engagement (interacción) relativamente alto, pero clics bajos en el CTA (llamada a la acción).
Esto significa que los usuarios están dispuestos a leer, pero la página no los guía de manera fluida hacia una acción relacionada con el producto.
Paso 5: La base de conocimientos de marca verifica los hechos del producto
La base de conocimientos de marca detecta que las capturas de pantalla del producto en la página están desactualizadas y que algunas descripciones de funcionalidades no se han actualizado a la versión más reciente.
Si esto no se corrige, es posible que el LLM continúe utilizando información obsoleta del producto al generar recomendaciones de optimización.
Paso 6: Los registros del rastreador de IA comprueban la accesibilidad técnica
Los registros del rastreador (crawler logs) de IA muestran que GPTBot puede rastrear la página con normalidad.
Esto significa que el problema prioritario no es el rastreo técnico. Los problemas más urgentes son si el contenido es lo suficientemente citable, si la información del producto es precisa y si el CTA se ajusta a los usuarios que buscan herramientas.
Borrador de la tarea final
El sistema genera un borrador de tarea como este:
markdownCopy
Página: /blog/top-tools-to-track-ai-mentions-in-llms

Tipo de problema:
- Ajuste deficiente a la intención de búsqueda (Search Intent)
- Conversión débil
- Contenido desactualizado

Evidencia desencadenante:
- Las consultas de selección de herramientas tienen impresiones de búsqueda
- La sección de introducción y la estructura H2 todavía se centran en la explicación de conceptos
- El engagement es alto, pero los clics en el CTA son bajos
- La base de conocimientos de marca detecta capturas de pantalla de producto obsoletas
- El rastreo de GPTBot es normal

Acciones recomendadas:
- Añadir un módulo de criterios de selección de herramientas
- Añadir una tabla comparativa de herramientas
- Actualizar las capturas de pantalla del producto
- Cambiar el CTA genérico de registro por "Ver solución de monitorización de menciones de IA"
- Añadir contenido de FAQ (Preguntas frecuentes)
- Añadir contenido paso a paso que sea más fácil de citar para los LLMs

Métricas a rastrear tras la actualización:
- CTR (Tasa de clics)
- Sesiones de búsqueda orgánica
- Clics en el CTA
- Clics en la demo
- Eventos clave
- Referencias de IA
- Estado del crawler
De esta manera, un artículo pasa de tener un "rendimiento de datos poco claro" a una tarea concreta.
El equipo sabe:
Por qué es necesario cambiar el artículo
Dónde está el problema
Qué necesita ser actualizado
Quién debe encargarse de ello
Qué métricas deben revisarse posteriormente
7. Seguimiento y revisión del rendimiento
Un verdadero ciclo de crecimiento de contenido también necesita retroalimentar el sistema con datos de rendimiento después de que se actualiza un artículo.
La versión actual ya puede ejecutar el flujo de trabajo principal, desde la ingesta de datos hasta el diagnóstico de la página y la generación del borrador de tareas.
La siguiente etapa es añadir el seguimiento del rendimiento posterior a la ejecución, conectando cada actualización de contenido con los cambios posteriores en las métricas.
El sistema registrará:
Tiempo de generación de la tarea
Módulos actualizados
Tiempo de lanzamiento
Responsable
Estado de la tarea
Datos de rendimiento de seguimiento
Esto permite a los equipos evaluar si cada acción de optimización realmente genera resultados.
8. Lo que aún queda por construir
En este punto, el sistema ya puede ejecutar la cadena de diagnóstico principal. Sin embargo, todavía es necesario mejorar varias capacidades.
8.1 Clustering de intención de consulta
La versión actual se basa principalmente en la similitud de texto y en juicios basados en reglas. En industrias verticales, esto ya cubre la mayoría de las consultas comunes.
Sin embargo, las consultas de cola larga (long-tail), los términos emergentes y las consultas que son semánticamente similares pero diferentes en cuanto a intención, podrían seguir agrupándose incorrectamente.
En el futuro, el sistema combinará la coincidencia de palabras clave y el juicio basado en LLMs para clasificar los clusters de consulta con mayor precisión.
Para los clusters de intención de baja confianza, el sistema los marcará automáticamente como "requiere confirmación manual", lo que evitará que se generen tareas incorrectas cuando la evidencia sea insuficiente.
8.2 Actualizaciones automáticas de la base de conocimientos de marca
La base de conocimientos de marca actual se mantiene principalmente a través de importación manual. Esto funciona bien al principio para centralizar información clave, como características del producto, precios, capturas de pantalla, respuestas a FAQ y estándares de mensajería de la competencia.
Pero a largo plazo, la base de conocimientos no puede depender solo del mantenimiento manual.
El siguiente paso es conectar los registros de cambios del producto (changelogs), los datos del CMS o fuentes de documentación interna, para que la versión de la base de conocimientos pueda actualizarse automáticamente a medida que el producto evoluciona.
Esto hará que las revisiones de contenido desactualizado dependan menos de la revisión manual. El sistema también podrá identificar con mayor rapidez funcionalidades obsoletas, capturas antiguas, precios incorrectos y descripciones de productos que ya no coinciden con la mensajería actual.
8.3 Seguimiento del rendimiento
El sistema ya puede determinar qué artículo debe actualizarse, por qué, qué partes deben cambiarse y cómo generar una tarea de optimización respaldada por evidencia.
El siguiente paso es añadir el seguimiento del rendimiento tras la ejecución de la tarea y conectar cada actualización de contenido con los cambios posteriores en las métricas.
Una vez que esto se complete, los equipos de contenido podrán comprender:
Si una optimización realmente generó crecimiento
Qué tipos de actualizaciones son más efectivas
Qué páginas aún necesitan más iteración
Conclusión
El objetivo de este sistema de diagnóstico de crecimiento de contenido no es proporcionar otro informe de SEO más.
Su objetivo es transformar la optimización del tráfico orgánico en un proceso que sea:
Ejecutable
Rastreable (Medible)
Revisable
Conectado con los resultados de negocio
Conecta los datos de búsqueda, el contenido de la página, el comportamiento del usuario, los hechos de la marca (brand facts), la visibilidad en IA/GEO, las tareas de optimización y la retroalimentación de rendimiento en un ciclo cerrado.
Como resultado, el equipo de contenido ya no recibe instrucciones vagas como "optimizar el artículo".
En su lugar, pueden entender claramente:
Por qué debe cambiarse la página
Dónde está el problema
Qué debe actualizarse
Quién debe ejecutar la tarea
Qué métricas deben verificarse después de la actualización
Si también estás construyendo un sitio web independiente para mercados extranjeros, centrado en el crecimiento de contenido o en la búsqueda por IA, y te gustaría discutir esta solución o conocer más sobre los detalles de implementación del sistema, puedes añadir WeChat: dudulhc.
Dageno is the research and insights team at Dageno AI, publishing industry reports and expert analysis on AI Search Visibility, Generative Engine Optimization (GEO), and AI-powered search discovery.