Descubra la posición de su marca en el mercado de IA
Identifique las oportunidades de crecimiento que merecen ser priorizadas en función de la demanda del mercado, el panorama competitivo, las propuestas de valor de la marca y las fuentes de citación.
Cuando los modelos de IA dan recomendaciones de marca opuestas para la misma pregunta, ¿cómo debe interpretarlas y actuar tu equipo?
Un modelo de IA menciona una marca y otro la deja fuera. Un caso de smartwatches muestra cómo preguntas distintas pueden crear un conflicto aparente y por qué el siguiente paso es ampliar las respuestas comparables.
Cuando los modelos de IA parecen dar recomendaciones de marca opuestas para la misma pregunta, comprueba primero si de verdad respondieron a la misma pregunta. Después decide si actuar. Que no haya respuesta en los registros, que una respuesta omita la marca y que haya muy pocas respuestas son situaciones distintas. Investiga las fuentes y plantéate optimizar solo cuando la marca falte repetidamente en respuestas comparables a la misma pregunta, en la misma región y el mismo alcance de observación, y los compradores usen ese modelo.
Un caso de smartwatches en Dageno muestra por qué un LLM coverage gap merece revisión, pero todavía no demuestra un conflicto entre modelos. Las respuestas de Google AI Overview sobre relojes de seguridad infantil en Australia no mencionaron a Apple. A juzgar por su contenido, las respuestas de ChatGPT y Gemini que mencionaron a Apple en la misma región trataban sobre smartwatches en general. La decisión es fijar la pregunta y ampliar primero la muestra comparable.
Para el seguimiento, convierte el modelo con la señal de ausencia en el modelo principal y los modelos con respuestas existentes en la misma región en modelos de comparación. Mantén en observación los modelos que no aparecieron en las respuestas registradas. La marca también debe decidir si los relojes de seguridad infantil forman parte de la demanda a la que quiere llegar.
1. Distingue tres tipos de ausencia: no hay respuesta registrada, no se menciona la marca y hay muy pocas respuestas
No hay respuesta registrada: comprueba si existe un registro en este segmento
Toma como ejemplo el mercado de smartwatches en el panel. Entre las respuestas registradas una a una en esta ocasión, no apareció ninguna respuesta de Google AI Mode ni de Copilot para esta subintención en Australia. El responsable de la investigación debería marcar esas celdas como "sin respuesta en este conjunto", y no como "Apple no aparece en estos modelos". Esta distinción afecta al seguimiento: solo en un modelo con respuesta se puede evaluar si la respuesta menciona la marca. Mantén los demás en una lista de observación hasta que haya registros que revisar.
Ve a Issues & opportunities, abre Opportunity overview y selecciona la tarjeta LLM coverage gap. Haz clic en View analysis y después en View related AI responses. El botón muestra 203, el total de respuestas de la subintención; la lista que abre contiene solo 9 respuestas, todas de Google AI Overview y sin mención de Apple. Para ver las 203 respuestas de todos los modelos y regiones, sigue Demand & insights → Search intents → Recommendations → See top recommendations → View AI responses. Al revisar Australia, lee las etiquetas de modelo y región que aparecen al principio de cada respuesta.
Hay respuesta: registra por separado las menciones y las recomendaciones
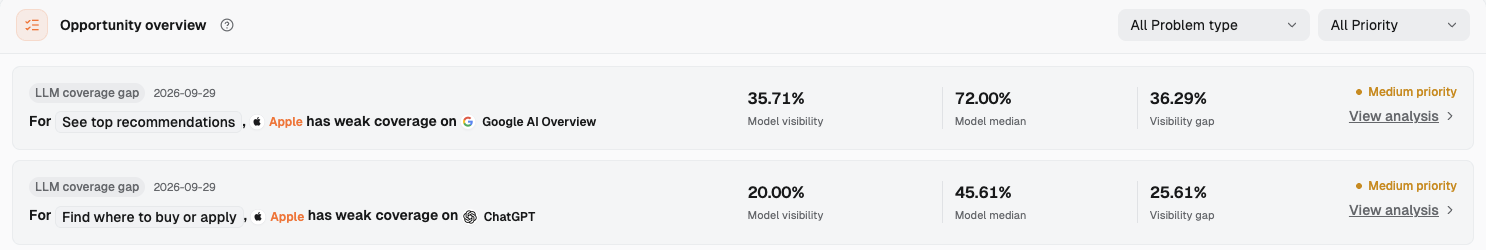
La tarjeta muestra la Model visibility de Apple en Google AI Overview en un 35,71 %, una Model median del 72,00 % y un Visibility gap del 36,29 %, con prioridad Medium. Esto le indica al responsable de la investigación dónde revisar la evidencia. No dice qué preguntas generaron la diferencia ni señala una página que el equipo deba cambiar.
Tarjetas LLM coverage gap en Opportunity overview: para See top recommendations, la Model visibility de Apple en Google AI Overview es del 35,71 %, la Model median es del 72,00 % y el Visibility gap es del 36,29 %, con prioridad Medium. La segunda tarjeta registra el mismo tipo de diferencia en ChatGPT.
Tras registrar una a una las 203 respuestas de esta subintención, Google AI Overview suma 14; 5 mencionan a Apple. La lista de respuestas relacionadas que abre la tarjeta contiene exactamente las otras 9, que hay que clasificar por necesidad y región. La marca no aparece en una respuesta describe esa única respuesta. Para decir que la marca falta en las recomendaciones de una pregunta concreta, también necesitas saber si la respuesta trataba una decisión de compra en la que la marca podría participar razonablemente. Una cita a una página de la marca es una observación aparte y no sustituye a una recomendación en el texto de la respuesta.
En Evidence preview, lee el Source answer y después Related citation analysis. Registra el modelo y la región del encabezado, el nombre de la marca en la respuesta y si fue recomendada, mencionada de pasada o solo apareció en una página citada. Así la "ausencia" tiene una unidad de análisis clara.
Hay muy pocas respuestas: conserva la señal y reúne respuestas comparables
Google AI Overview tiene 4 respuestas sobre relojes de seguridad infantil en Australia, y ninguna menciona a Apple. Es una señal para una necesidad concreta. Sin embargo, los demás modelos no tienen respuestas equivalentes sobre relojes infantiles en la misma región en los registros actuales, así que el equipo no tiene una muestra comparable en ninguno de los dos lados. Ni siquiera varias respuestas de un mismo modelo sustituyen a respuestas a la misma pregunta si las preguntas del grupo son distintas.
El responsable de la investigación puede acordar de antemano qué preguntas recopilar a continuación, cuántas respuestas completas conservar por modelo y cuándo revisarlas. La evidencia actual no ofrece una cifra universal a partir de la cual un equipo deba actuar. Primero comprueba si las respuestas tratan la misma pregunta en la misma región; después mira si la ausencia continúa en las respuestas nuevas.
2. Comprueba si el conflicto se repite: ¿cuántas respuestas tiene cada modelo para la misma necesidad y región?
Define la unidad de comparación antes de contar respuestas por modelo
La vista de mercado agrupa las respuestas por subintención, lo que ayuda a detectar anomalías en un tipo de demanda. Para comparar recomendaciones de marca, mantén fijos también la región, el idioma y la propia pregunta. "Elegir un smartwatch para quien usa cierto móvil" y "elegir un reloj de seguridad con localización para un niño" pueden estar ambos en Recommendations, pero los requisitos del comprador son distintos. Mezclarlos podría hacer que una diferencia entre preguntas parezca una diferencia entre modelos.
Para cada respuesta completa, registra el modelo, la región, la pregunta que parece responder, si menciona la marca y si la recomienda claramente. Indica el número de respuestas de cada modelo por separado. El total de la lista no es el denominador de ningún modelo. La lista no tiene filtro por modelo, así que una persona debe revisar y registrar una a una las etiquetas del encabezado de las respuestas. Cuenta cada respuesta una sola vez, aunque la vuelvas a abrir.
Caso práctico: qué contiene la diferencia señalada entre modelos
La tarjeta LLM coverage gap marca Google AI Overview con prioridad Medium. Muestra el 35,71 % de Apple por debajo de la Model median del 72,00 %, una diferencia del 36,29 %. Abre View analysis. En Where the problem occurs, el panel muestra What the user is doing, Sub-intents y Observed result; después abre las respuestas relacionadas. La tarjeta indica dónde debe empezar la investigación. Son las respuestas individuales las que determinan si esa pista exige actuar.
De las 14 respuestas de Google AI Overview, 5 mencionan a Apple. Al clasificar las otras 9 por su contenido salen cuatro grupos: 3 hablan de relojes Garmin en Bélgica o los Países Bajos, 1 habla de relojes Garett en Polonia, 1 explica qué es un smartwatch deportivo en un contexto en español y 4 tratan sobre relojes de seguridad y localización para niños en Australia. Las respuestas sobre marcas concretas y las de definición no son recomendaciones de compra abiertas y comparables en las que se haya omitido a Apple. El grupo australiano de relojes infantiles merece una revisión más detallada.
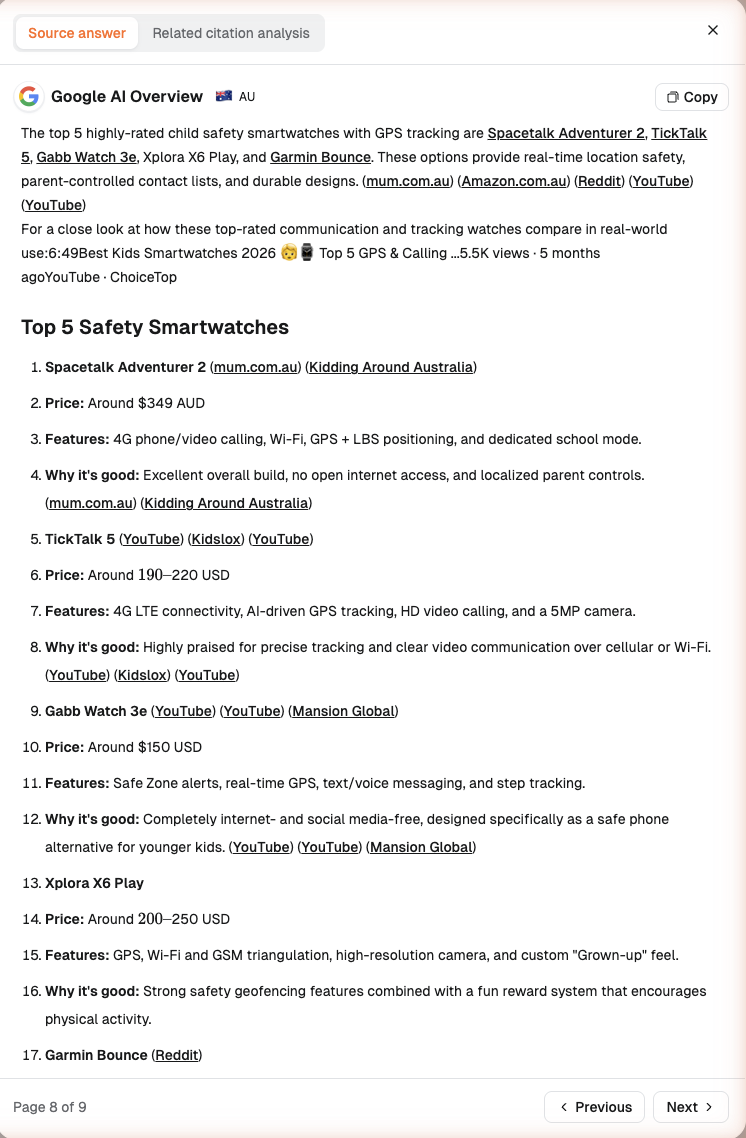
Una respuesta empieza así: "The top 5 highly-rated child safety smartwatches with GPS tracking are Spacetalk Adventurer 2, TickTalk 5, Gabb Watch 3e, Xplora X6 Play, and Garmin Bounce." (Los 5 smartwatches de seguridad infantil con localización GPS mejor valorados son Spacetalk Adventurer 2, TickTalk 5, Gabb Watch 3e, Xplora X6 Play y Garmin Bounce.) Otra empieza así: "Top kids smartwatches feature real-time GPS tracking combined with 4G LTE calling, geofencing "safe zones," and SOS buttons." (Los mejores smartwatches infantiles ofrecen localización GPS en tiempo real junto con llamadas 4G LTE, "zonas seguras" mediante geovallas y botones SOS.) Estas líneas originales muestran la necesidad que tratan las respuestas. Las marcas que nombran forman parte de las respuestas citadas.
La tarjeta abre 9 respuestas relacionadas. Esta es la octava: una respuesta de Google AI Overview de Australia (AU) que enumera relojes de seguridad y localización para niños sin mencionar a Apple.
En la misma subintención y región, las 5 respuestas de ChatGPT y las 3 de Gemini mencionan a Apple. A juzgar por su contenido, ninguna de estas 8 respuestas trata la pregunta sobre relojes de seguridad infantil. Las pocas que se leyeron en detalle hablan de smartwatches en general o de relojes deportivos. Una respuesta de ChatGPT dice: "If you're shopping for a smartwatch right now in 2026, these are the standouts. The biggest factor is your phone: Apple Watches are for iPhone …" (Si vas a comprar un smartwatch ahora, en 2026, estos son los más destacados. El factor más importante es tu móvil: los Apple Watch son para iPhone…) Trata la compatibilidad con el móvil, no la seguridad infantil ni la localización. Son preguntas distintas dentro de una misma subintención. Los registros actuales no incluyen una respuesta de otro modelo a la misma pregunta sobre relojes infantiles que recomiende a Apple.
Por tanto, la tarjeta ofrece una forma de encontrar respuestas que vale la pena revisar. Separa las preguntas que no guardan relación y luego decide qué muestra añadir. Aquí la muestra que falta son respuestas de distintos modelos a la misma pregunta sobre relojes de seguridad infantil en Australia. Una tarea de cambio de página vendría después.
3. Fija el prompt, el modelo, la región y el momento de ejecución: qué muestra el panel y qué debe aportar el cliente
Prompt: una subintención identifica un tipo de pregunta
Ni la lista View related AI responses ni la lista View AI responses tienen filtro por modelo, y Evidence preview no muestra el prompt original. El responsable de la investigación puede deducir por el contenido de qué trata aproximadamente una respuesta, pero no puede reconstruir la redacción exacta de cada pregunta a partir de estos registros. See top recommendations es una subintención que contiene respuestas sobre compras en general, marcas concretas y relojes de seguridad infantil. Para comprobar una diferencia real entre modelos, el cliente debe añadir a Monitored prompts la misma pregunta que quiere seguir y recopilar respuestas de los modelos seleccionados.
En Monitoring settings, la lista Monitored prompts muestra #, Prompt, Platforms, Regions, Answers, Brands, Details, Leading y Status. Este caso usa datos de mercado y no respuestas que el cliente haya seguido con una pregunta fija, así que la redacción de la pregunta no puede comprobarse palabra por palabra. En la siguiente ronda de seguimiento, guarda el texto del prompt y revisa las respuestas que realmente se devuelvan. No trates estas respuestas de mercado como si ya se hubieran ejecutado con la misma redacción.
Modelo y región: revisa las etiquetas de cada respuesta
Cada respuesta muestra en el encabezado un modelo y una región, por ejemplo Google AI Overview y AU. Usa esas etiquetas para agrupar las respuestas y comprueba después si cada modelo tiene realmente registros en la región elegida. Platforms & regions, en Market overview, ayuda a localizar el alcance; las respuestas completas que contiene siguen siendo la base del juicio. Compartir la etiqueta de región no basta: revisa el idioma y el contenido de las respuestas antes de agrupar respuestas sobre smartwatches.
Los registros australianos existentes sitúan a Google AI Overview, ChatGPT y Gemini en la misma lista de revisión regional. Un recuento entre modelos para una pregunta fija sobre relojes infantiles debe empezar con la siguiente ronda de respuestas. Google AI Mode y Copilot no aparecieron en las respuestas registradas para este alcance en esta ocasión, así que mantenlos en observación. El responsable de la investigación de mercado debe confirmar con evidencia del cliente qué modelos usan los compradores y si Australia es un mercado prioritario.
Momento de ejecución: crea registros nuevos sin tratar la fecha de revisión como fecha de recopilación
Evidence preview no muestra la hora de recopilación. Las listas de respuestas no muestran ni el prompt original ni la hora de recopilación. El día en que un investigador abre una tarjeta es la fecha de revisión, no la fecha en que se generó la respuesta. Los registros actuales tampoco establecen una ventana de recopilación común para estas respuestas antiguas. Empieza la siguiente nueva prueba con respuestas nuevas que se puedan guardar. En cada ronda, registra la pregunta, el modelo, la región, el idioma y cualquier dato temporal que el equipo pueda verificar. Si la hora de recopilación del sistema no está disponible, regístrala como "no se muestra".
La marca también debe decidir si los relojes de seguridad infantil encajan con las personas y los usos a los que se dirige su producto. El panel muestra respuestas y fuentes; la decisión de competir por esta pregunta corresponde a la marca. Si el producto no encaja con ese uso, el coverage gap por sí solo no es motivo para convertirlo en un objetivo de optimización.
4. ¿Qué fuentes usó el modelo que omitió la marca? Fíjate solo en la evidencia que pueda explicar la diferencia
Empieza por las fuentes citadas en las respuestas reales
Las 4 respuestas australianas de Google AI Overview sobre relojes de seguridad infantil muestran 23, 24, 25 y 19 fuentes citadas, respectivamente. Sus listas de citas suelen incluir safewise.com, harveynorman.com.au, reddit.com, youtube.com, forbes.com, kidslox.com, mum.com.au y garmin.com. Ninguna de las citas visibles en esas 4 respuestas apunta a apple.com. Se trata de observaciones sobre las respuestas y sus fuentes; no demuestran que la ausencia de un sitio haya hecho que se omitiera la marca. La guía oficial de Google sobre las funciones de IA y tu sitio web indica que AI Overview muestra enlaces relevantes para que los lectores sigan explorando. Esos enlaces visibles son un punto de partida para revisar las fuentes.
Aquí importan dos partes de la interfaz. Related citation analysis, en Evidence preview, muestra las citas de una respuesta concreta. En este caso, Sources used by the answers, en el panel de la tarjeta, muestra No data. Al comparar fuentes, usa las respuestas que realmente se han abierto y guarda cada URL citada junto con el texto de la respuesta correspondiente. Si el panel muestra No data, informa de ese resultado tal como aparece.
El mismo modelo también dio una respuesta sobre relojes infantiles en los Países Bajos que mencionaba el Apple Watch SE: "Voor oudere jeugd (Middelbare school): Een instapmodel zoals de Apple Watch SE of reguliere Samsung Galaxy Watch." (Para niños mayores, en secundaria, un modelo de entrada como el Apple Watch SE o un Samsung Galaxy Watch normal puede ser una opción.) Este registro muestra que, incluso con el modelo fijo, la región y el grupo de edad al que se dirige la respuesta pueden cambiar las opciones que se nombran. El registro neerlandés es una comparación entre regiones dentro de un modelo. La comparación entre modelos en Australia requerirá respuestas nuevas a la misma pregunta.
Si distintos modelos responden a la misma pregunta australiana sobre relojes infantiles en la siguiente ronda, compara los productos nombrados y las páginas citadas en cada respuesta. Revisa qué páginas enumeran productos relevantes, cuáles describen criterios de elección y qué información usan las respuestas. El método completo para comparar respuestas con páginas citadas se trata por separado; aquí los registros de fuentes se limitan a lo que guarda relación directa con esta señal de ausencia.
5. Decide si tratarlo como señal de optimización o ampliar primero la muestra
La decisión en este caso es ampliar primero la muestra. El coverage gap de la tarjeta merece investigarse. Sin embargo, las respuestas australianas sobre relojes de seguridad infantil no tienen respuestas equivalentes a la misma pregunta de otros modelos en los registros actuales. La diferencia le dice al equipo dónde mirar; el contenido de las respuestas le dice si se pueden comparar; y la marca decide si este uso entra en su alcance de seguimiento.
Lo que ves
Conclusión actual
Siguiente acción
Conclusión que aún no puedes sacar
La tarjeta LLM coverage gap muestra 35,71 %, 72,00 % y 36,29 %
Abrir las respuestas para revisarlas
Comprobar la pregunta, el modelo y la región de cada respuesta relacionada
Se ha encontrado una carencia de contenido que ya habría que corregir
Algunas respuestas que omiten a Apple tratan sobre marcas concretas o definiciones
No son respuestas de compra abiertas y comparables
Excluirlas de la comparación entre modelos; conservar los registros originales
Demuestran que Apple falta en las recomendaciones generales
Las 4 respuestas australianas sobre relojes de seguridad infantil omiten a Apple
Hay una señal para una necesidad concreta
La marca confirma la adecuación del producto; después, fijar la pregunta y recopilar respuestas de otros modelos
Se ha demostrado que distintos modelos dan recomendaciones de marca opuestas para la misma pregunta
Las respuestas existentes de ChatGPT y Gemini en la misma región mencionan a Apple, pero tratan smartwatches en general
Las respuestas tratan preguntas distintas; ampliar primero la muestra comparable
Hacer a ChatGPT y Gemini la misma pregunta sobre relojes infantiles que a Google AI Overview
ChatGPT o Gemini recomendarán a Apple para relojes infantiles
En los registros revisados esta vez no apareció ninguna respuesta de Google AI Mode ni de Copilot para esta región
Aún no hay base para juzgar la marca en estos dos modelos
Mantenerlos en la lista de observación; clasificarlos si aparecen respuestas nuevas
Apple no aparece en estos dos modelos
Cuando los modelos seleccionados hayan generado suficientes respuestas comparables a exactamente la misma pregunta, comprueba si la ausencia persiste en las siguientes ventanas de observación. Si los compradores usan el modelo en el que falta la marca, la marca confirma que su producto encaja con la pregunta y las respuestas y citas apuntan a una diferencia de información concreta, el equipo puede plantearse añadir datos a una página o facilitar materiales a terceros. Elige cualquier cambio de página a partir de información verificable sobre la necesidad y las fuentes. Estos registros todavía no han identificado ese objetivo de acción.
6. Elige los modelos que seguir y el alcance de la nueva prueba
Asigna funciones distintas a los modelos principales, de comparación y de observación
Los grupos sirven para la siguiente decisión. El modelo principal contiene la señal concreta de ausencia. Los modelos de comparación responden exactamente a la misma pregunta para que el equipo pueda hacer una comparación real lado a lado. Los modelos de observación no aparecieron con respuestas utilizables en los registros actuales; clasifícalos cuando aparezcan respuestas. El siguiente alcance de seguimiento es un método propuesto para este caso. Los nombres de los modelos y la evidencia existente proceden del panel; el cliente todavía debe confirmar los hábitos de los compradores, el periodo de observación y el responsable.
Grupo
Modelo
Evidencia existente
Alcance fijo y resultado que registrar a continuación
Principal
Google AI Overview
Las respuestas australianas sobre relojes de seguridad infantil omiten a Apple
Fijar una pregunta sobre relojes infantiles de seguridad y localización en AU; guardar las respuestas completas, las menciones de la marca, las recomendaciones claras y las fuentes citadas
Comparación
ChatGPT, Gemini
Sus respuestas sobre smartwatches en general en la misma región mencionan a Apple; no tienen respuestas equivalentes sobre relojes infantiles
Usar exactamente la misma pregunta y región que el modelo principal; comprobar el uso que trata cada respuesta y después registrar menciones, recomendaciones y fuentes
Observación
Google AI Mode, Copilot
No aparecieron respuestas para esta subintención australiana en los registros revisados esta vez
Cuando aparezcan respuestas para el mismo alcance, registrar cada una y decidir si el modelo pertenece al grupo principal o al de comparación
Si esta fuera tu marca, pregunta primero a los responsables de producto y mercado si los relojes infantiles de seguridad y localización encajan con los usuarios a los que se dirige el producto y qué modelos usan realmente los compradores. Cuando lo confirmen, el responsable de la investigación de mercado debe guardar un prompt, una región y un idioma, y acordar un periodo de observación, una frecuencia de nuevas pruebas, un responsable y unas condiciones de cierre. Las fechas y el número de ejecuciones corresponden al cliente. Fija esas reglas antes de que lleguen las nuevas respuestas para que las reglas de comparación no cambien después de ver los resultados.
En cada ronda, guarda las respuestas completas y sus citas. Registra el prompt, el modelo, la región, el idioma, si la marca fue mencionada o claramente recomendada y cualquier dato temporal que se pueda verificar. El grupo de comparación comprueba tanto si hay una recomendación comparable en la pregunta sobre relojes infantiles como si se pierden recomendaciones existentes en las respuestas de compra en general. Si de verdad se cambia una página, registra qué cambió y cuándo. Usa respuestas recién obtenidas para la siguiente prueba; volver a abrir un registro antiguo no es un resultado nuevo. El método para verificar si las recomendaciones de la IA han mejorado puede ayudar a planificar las siguientes ventanas y registros.
7. Conclusión
El responsable de la investigación de mercado ya puede dar al equipo una respuesta clara: el sistema encontró un coverage gap que vale la pena revisar. Al separar las respuestas, Australia mostró una señal de ausencia para una necesidad de relojes de seguridad infantil, mientras que los registros existentes entre modelos trataban preguntas distintas. En esta ronda, la marca debe decidir primero si esa necesidad encaja con su producto. Después, haz que los modelos principal y de comparación respondan a la misma pregunta y guarda las nuevas respuestas y citas. Decide si invertir en optimización de contenido después de confirmar el uso de los modelos por parte de los compradores, las observaciones repetidas y la evidencia de las fuentes.
Empieza a entender el rendimiento de tu marca en la búsqueda con IA
¿Se pueden comparar los modelos cuando tienen distinto número de respuestas?
Puedes presentar los recuentos lado a lado, pero antes asegúrate de que ambos conjuntos responden a la misma pregunta. Indica el número de respuestas de cada modelo y amplía primero la muestra del lado más pequeño. Mezclar respuestas a preguntas distintas no revelará una diferencia entre modelos, aunque los recuentos parezcan similares.
¿Cómo se registra una mención de la marca que no es una recomendación?
Regístrala como mención y conserva el texto que la rodea. Cuéntala como recomendación solo cuando la respuesta ofrezca claramente la marca como opción para esa necesidad. Registra por separado una cita a una página de la marca. Mantener los tres datos separados muestra si un cambio posterior aparece en el texto de la respuesta o en las fuentes.
¿Hay que cambiar una página de inmediato si la siguiente ronda sigue omitiendo la marca?
Primero comprueba que las respuestas nuevas usaron la misma pregunta, región e idioma. Después confirma si los compradores usan el modelo, si la marca encaja con la pregunta y qué citan las respuestas nuevas. Cuando esas condiciones estén claras, el equipo puede elegir la información concreta de la página o el material de terceros que trabajar y seguir haciendo nuevas pruebas dentro del mismo alcance.
¿Cómo se conserva la comparación original al añadir una región nueva?
Da a la región nueva su propio registro inicial y sigue observando la región original con la pregunta acordada. Registra la región y el idioma en cada ronda. Así el equipo puede comparar la evolución en el tiempo dentro de una región y revisar por separado las diferencias entre regiones.
¿Cómo eliges los modelos que seguir si no sabes cuáles usan los compradores?
Empieza por la lista de revisión que respalda la evidencia actual. Pide al responsable de la investigación de mercado que confirme el uso de los modelos por parte de los compradores con estudios de clientes o entrevistas existentes. Después decide qué modelos se quedan en el seguimiento principal y cuáles sirven para comparación u observación. Los recuentos de respuestas del panel no miden el uso por parte de los compradores.
Dageno is the research and insights team at Dageno AI, publishing industry reports and expert analysis on AI Search Visibility, Generative Engine Optimization (GEO), and AI-powered search discovery.
 Alexa for Shopping